Scopri Scribe
- Pubblicato
AscoltaAscolta questo articolo
Scribe, il nostro primo modello di Speech to Text, è il modello di trascrizione più accurato al mondo. Progettato per gestire l'imprevedibilità dell'audio reale, Scribe trascrive il parlato in 99 lingue, con timestamp a livello di parola, diarizzazione dei parlanti e tag degli eventi audio, il tutto fornito in una risposta strutturata per un'integrazione semplice.
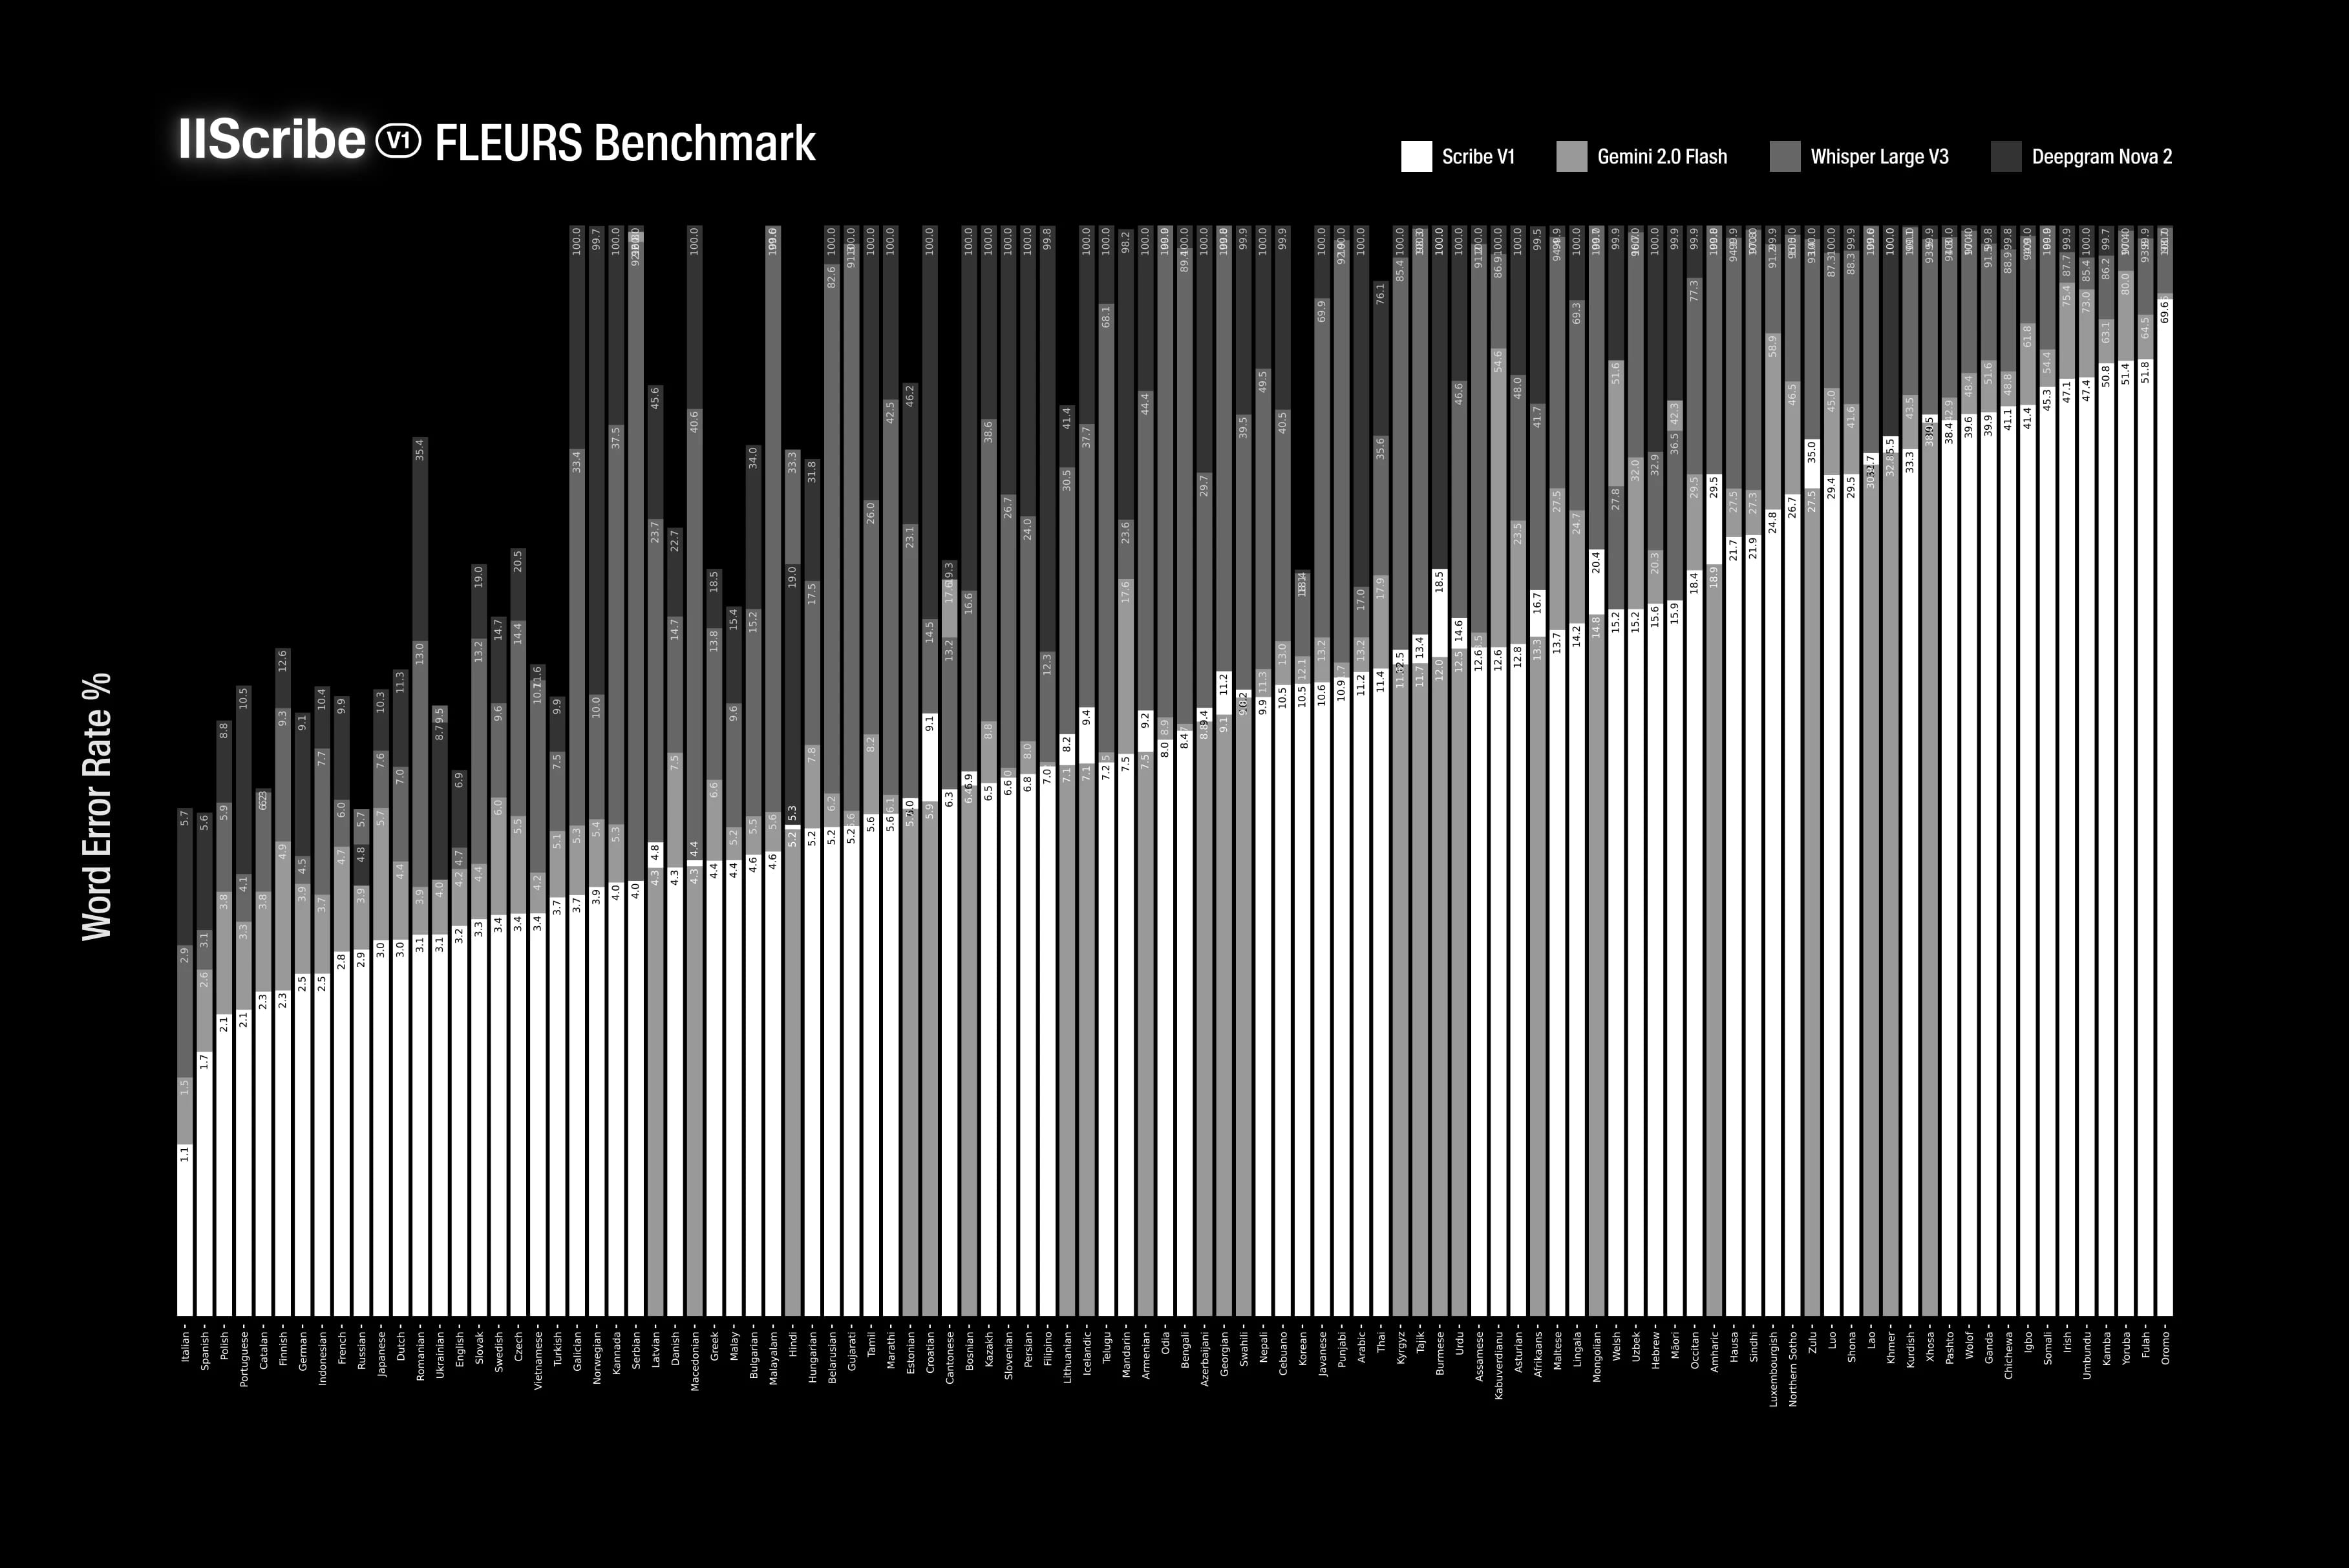
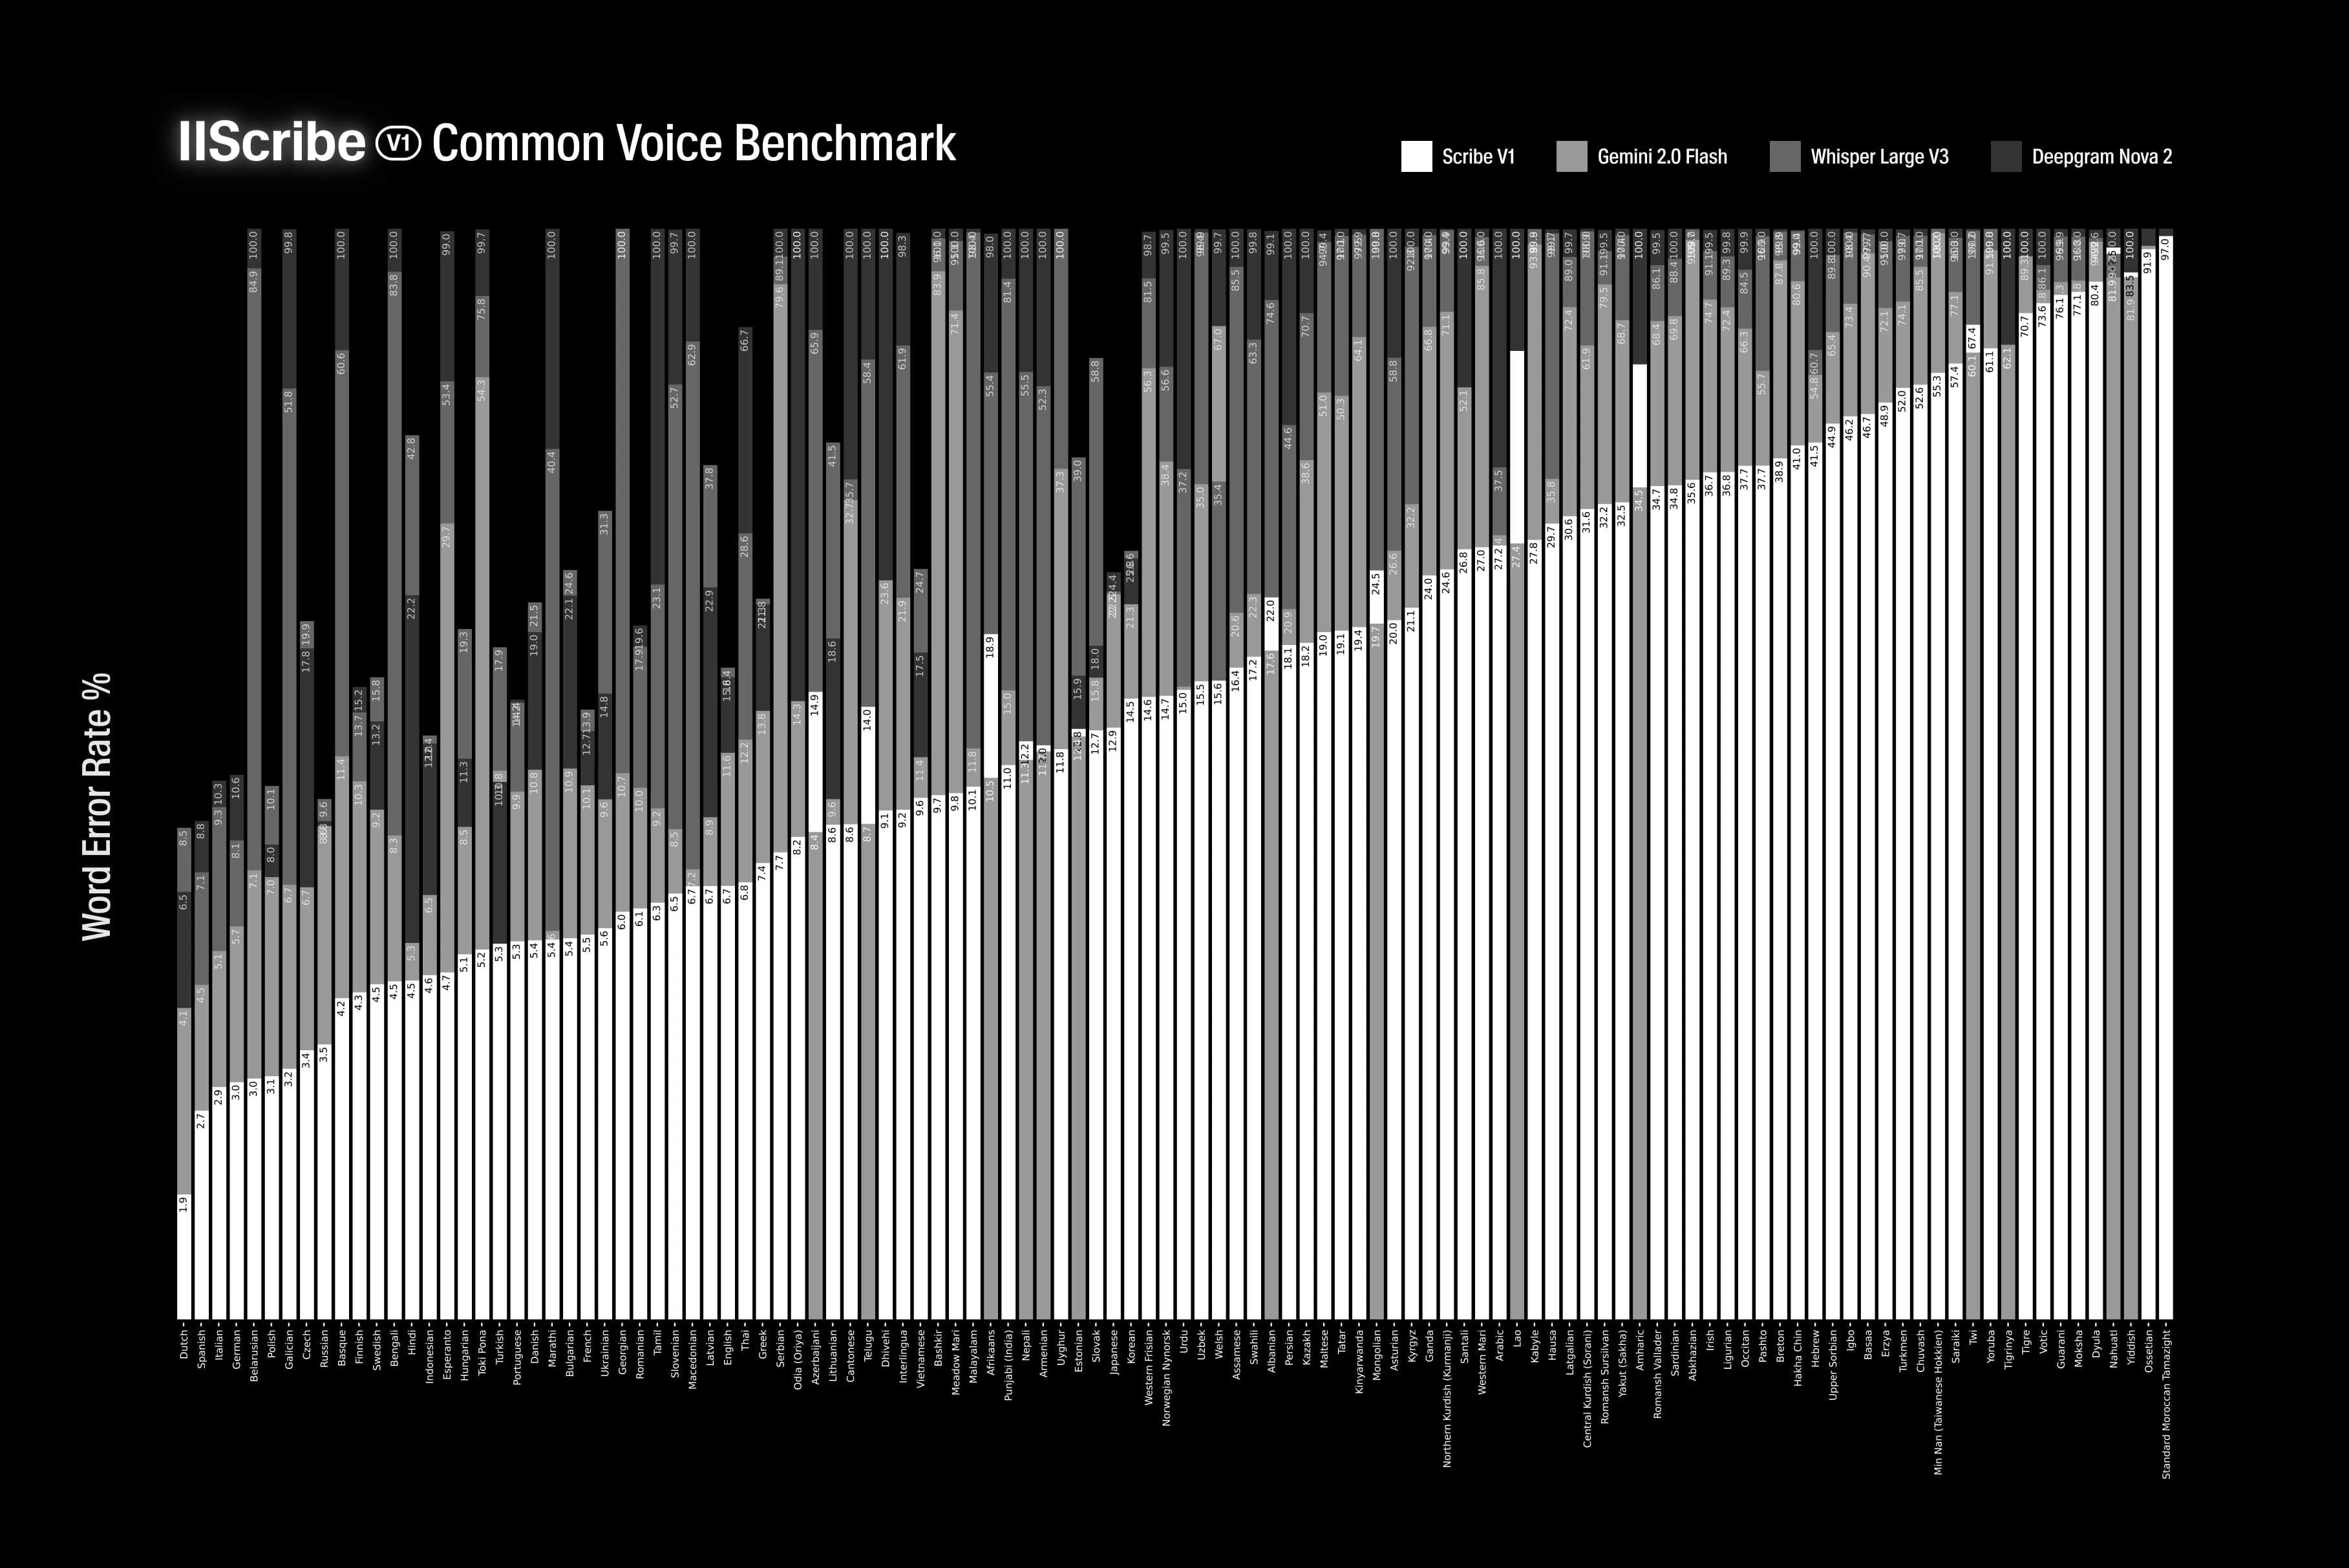
Scribe è progettato per la precisione. Nei benchmark FLEURS e Common Voice su 99 lingue, supera costantemente modelli leader come Gemini 2.0 Flash, Whisper Large V3 e Deepgram Nova-3. Che si tratti di riassunti di riunioni, sottotitoli di film o persino testi di canzoni, Scribe offre il tasso di errore sulle parole più basso nella trascrizione automatica in italiano (98,7%), inglese (96,7%) e altre 97 lingue.
Scribe rende l'ASR accessibile a tutti, riducendo drasticamente gli errori nelle lingue tradizionalmente meno supportate, come serbo, cantonese e malayalam, per le quali i modelli concorrenti superano spesso un tasso di errore sulle parole del 40%.
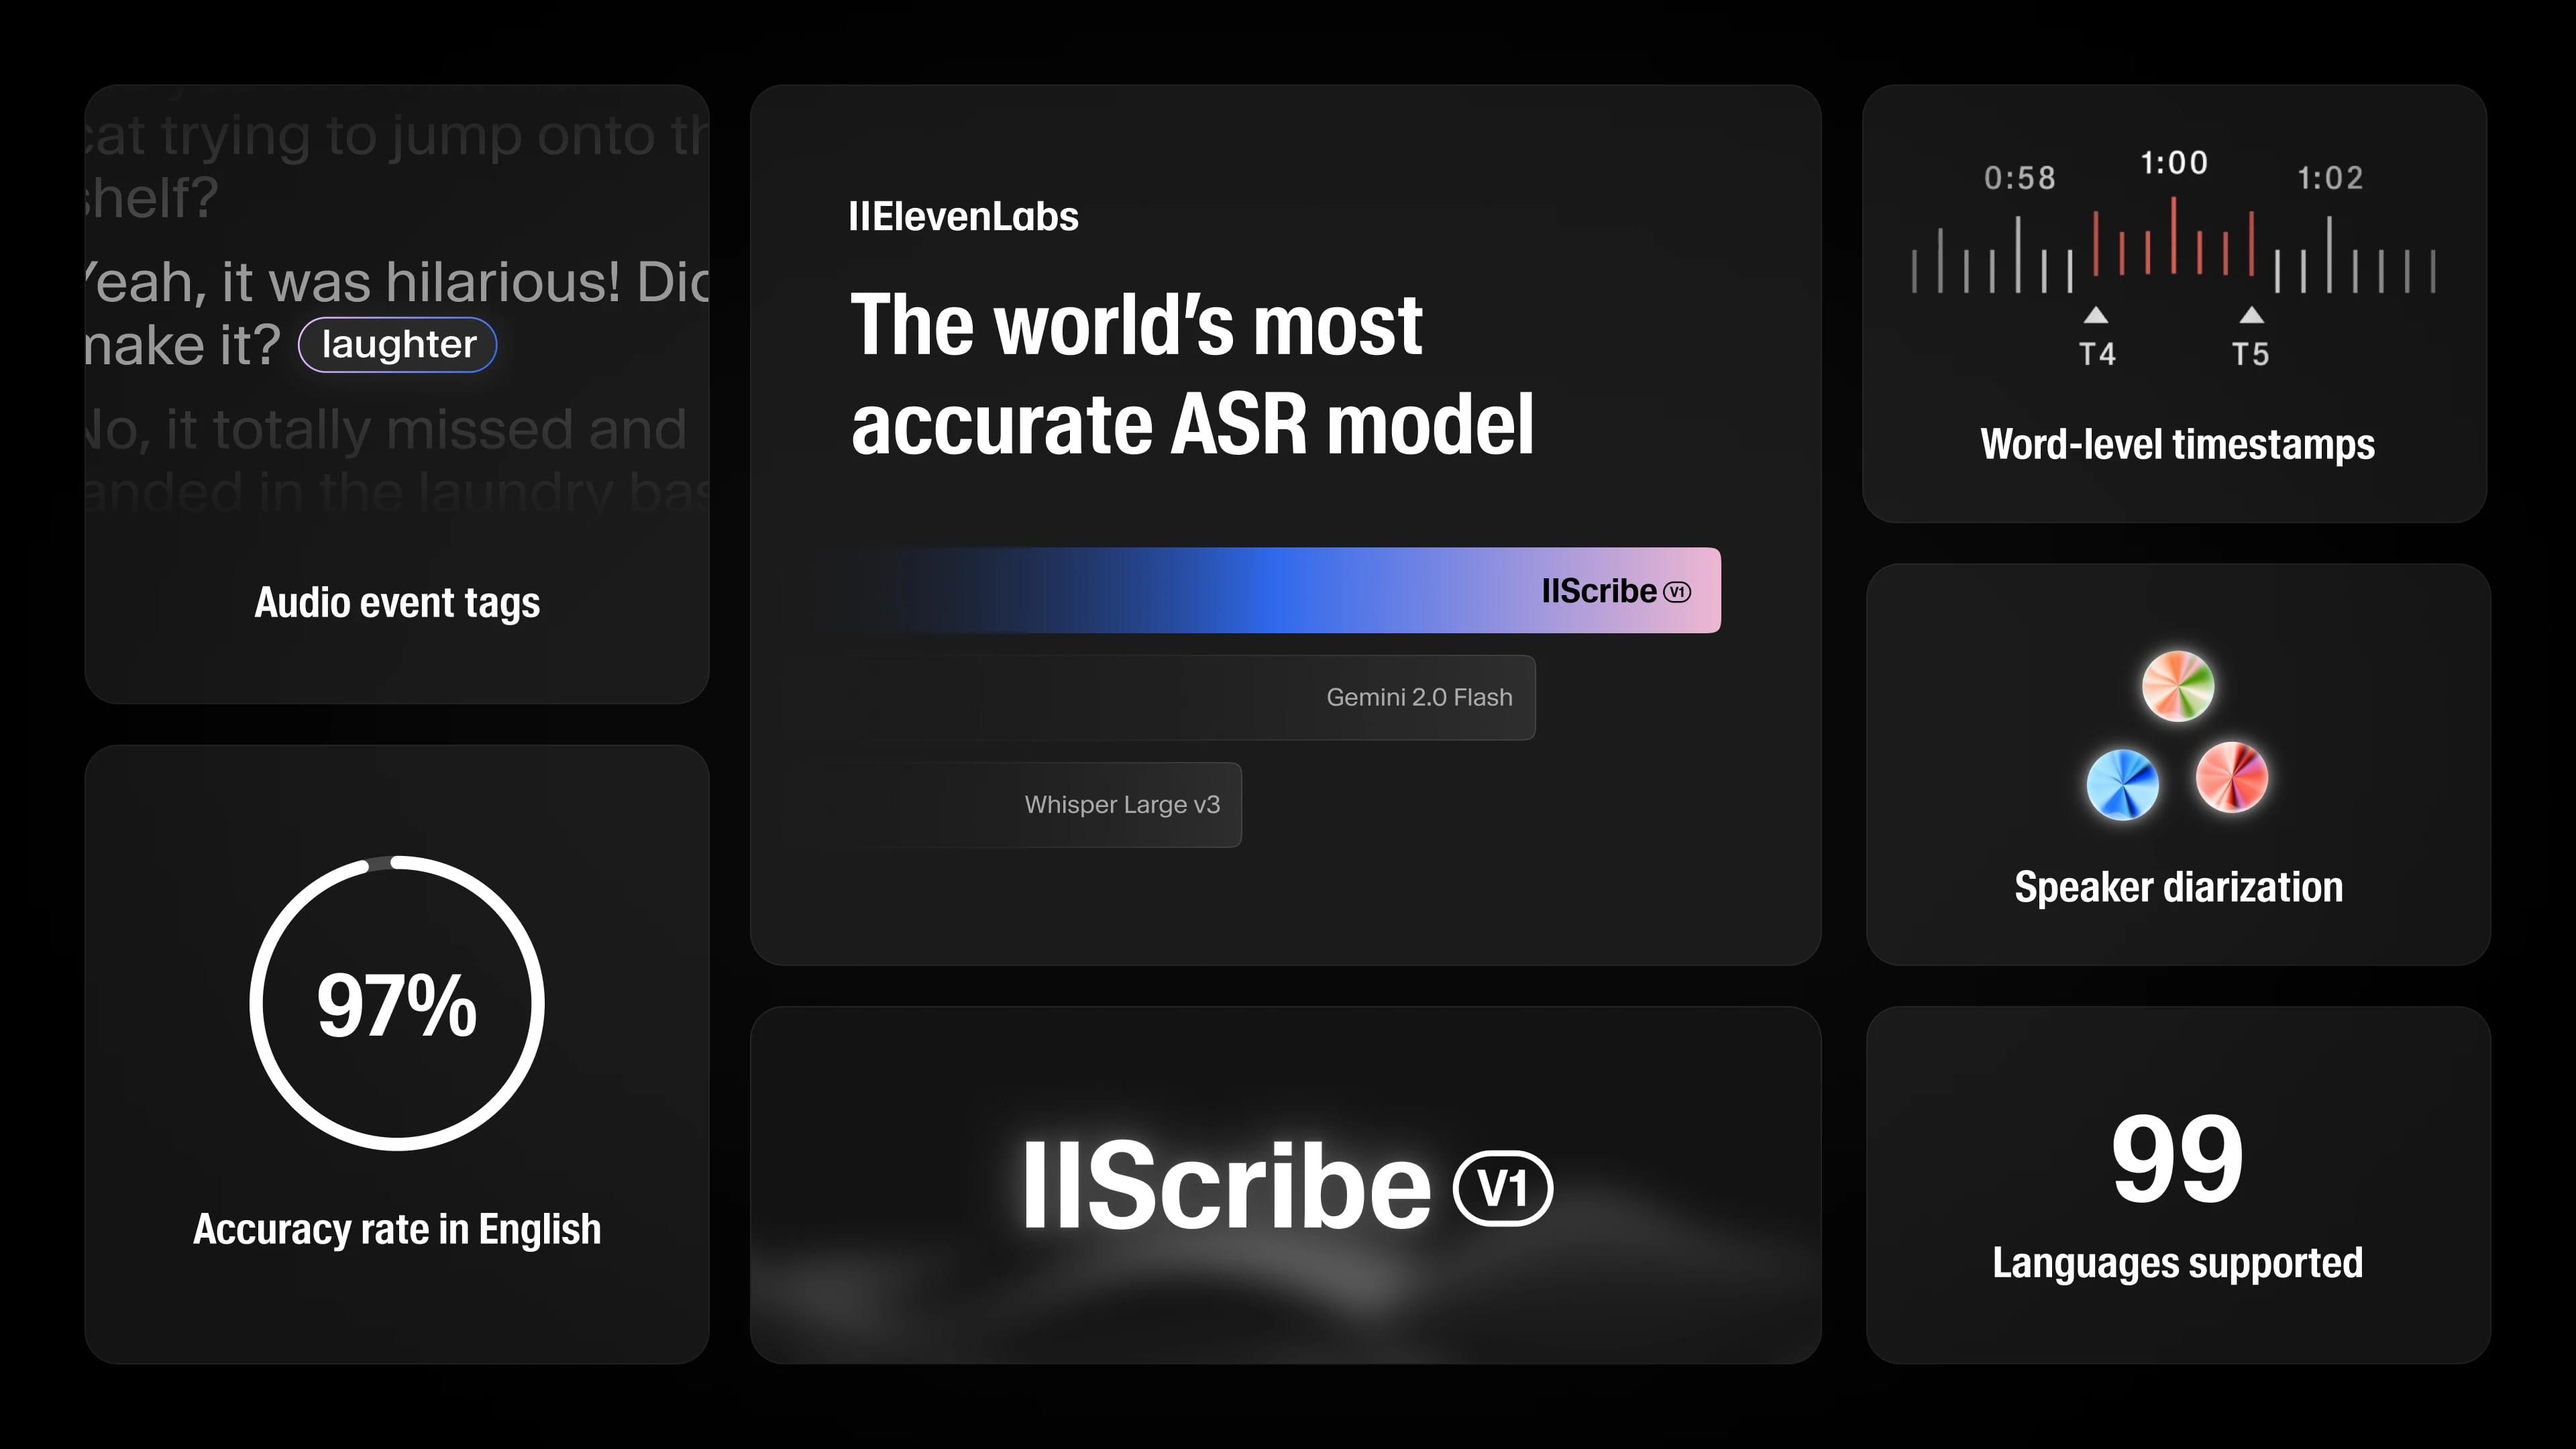
Gli sviluppatori possono integrare Scribe già da oggi tramite la nostra API Speech to Text per ottenere trascrizioni JSON strutturate con diarizzazione dei parlanti e timestamp a livello di parola, oltre a marcatori degli eventi non vocali, come le risate. Una versione a bassa latenza per le applicazioni in tempo reale sarà disponibile a breve.
Creator e aziende possono usare Scribe direttamente dalla dashboard di ElevenLabs per caricare file audio o video e generare trascrizioni formattate.
Inizia a sviluppare con Scribe:
Documentazione API | Provalo nella dashboard di ElevenLabs
Benchmark
FLEURS - Tasso di errore sulle parole % - 102 lingue
Common Voice - Tasso di errore sulle parole % - 102 lingue
Contributi
Responsabile della ricerca, addestramento, architettura
Flavio Schneider
Responsabile del progetto, dati di pre-addestramento, dati di fine-tuning
Tim von Känel
Inferenza, ottimizzazioni
Maximiliano Levi
Collaboratori alla ricerca
Johan Nordberg, Piotr Dabkowski
Frontend
Austin Malerba
Backend
Hristo Stoychev
Acquisizione dati
Alex George

Tim is on our research team and focuses on ASR and Music.