Presentazione di Eleven v4, il nostro modello più espressivo
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
Una frase può cambiare notevolmente a seconda di come viene pronunciata. “Ho bisogno che tu rimanga calmo” dovrebbe suonare in modo diverso a seconda di chi la dice: un medico che la rivolge con delicatezza a un paziente spaventato oppure un personaggio di un videogioco che urla alla sua squadra prima di lanciarsi in battaglia.
Oggi lanciamo Eleven v4, il nostro modello Text to Speech più espressivo di sempre, e la sua variante a bassa latenza, Eleven v4 Turbo.
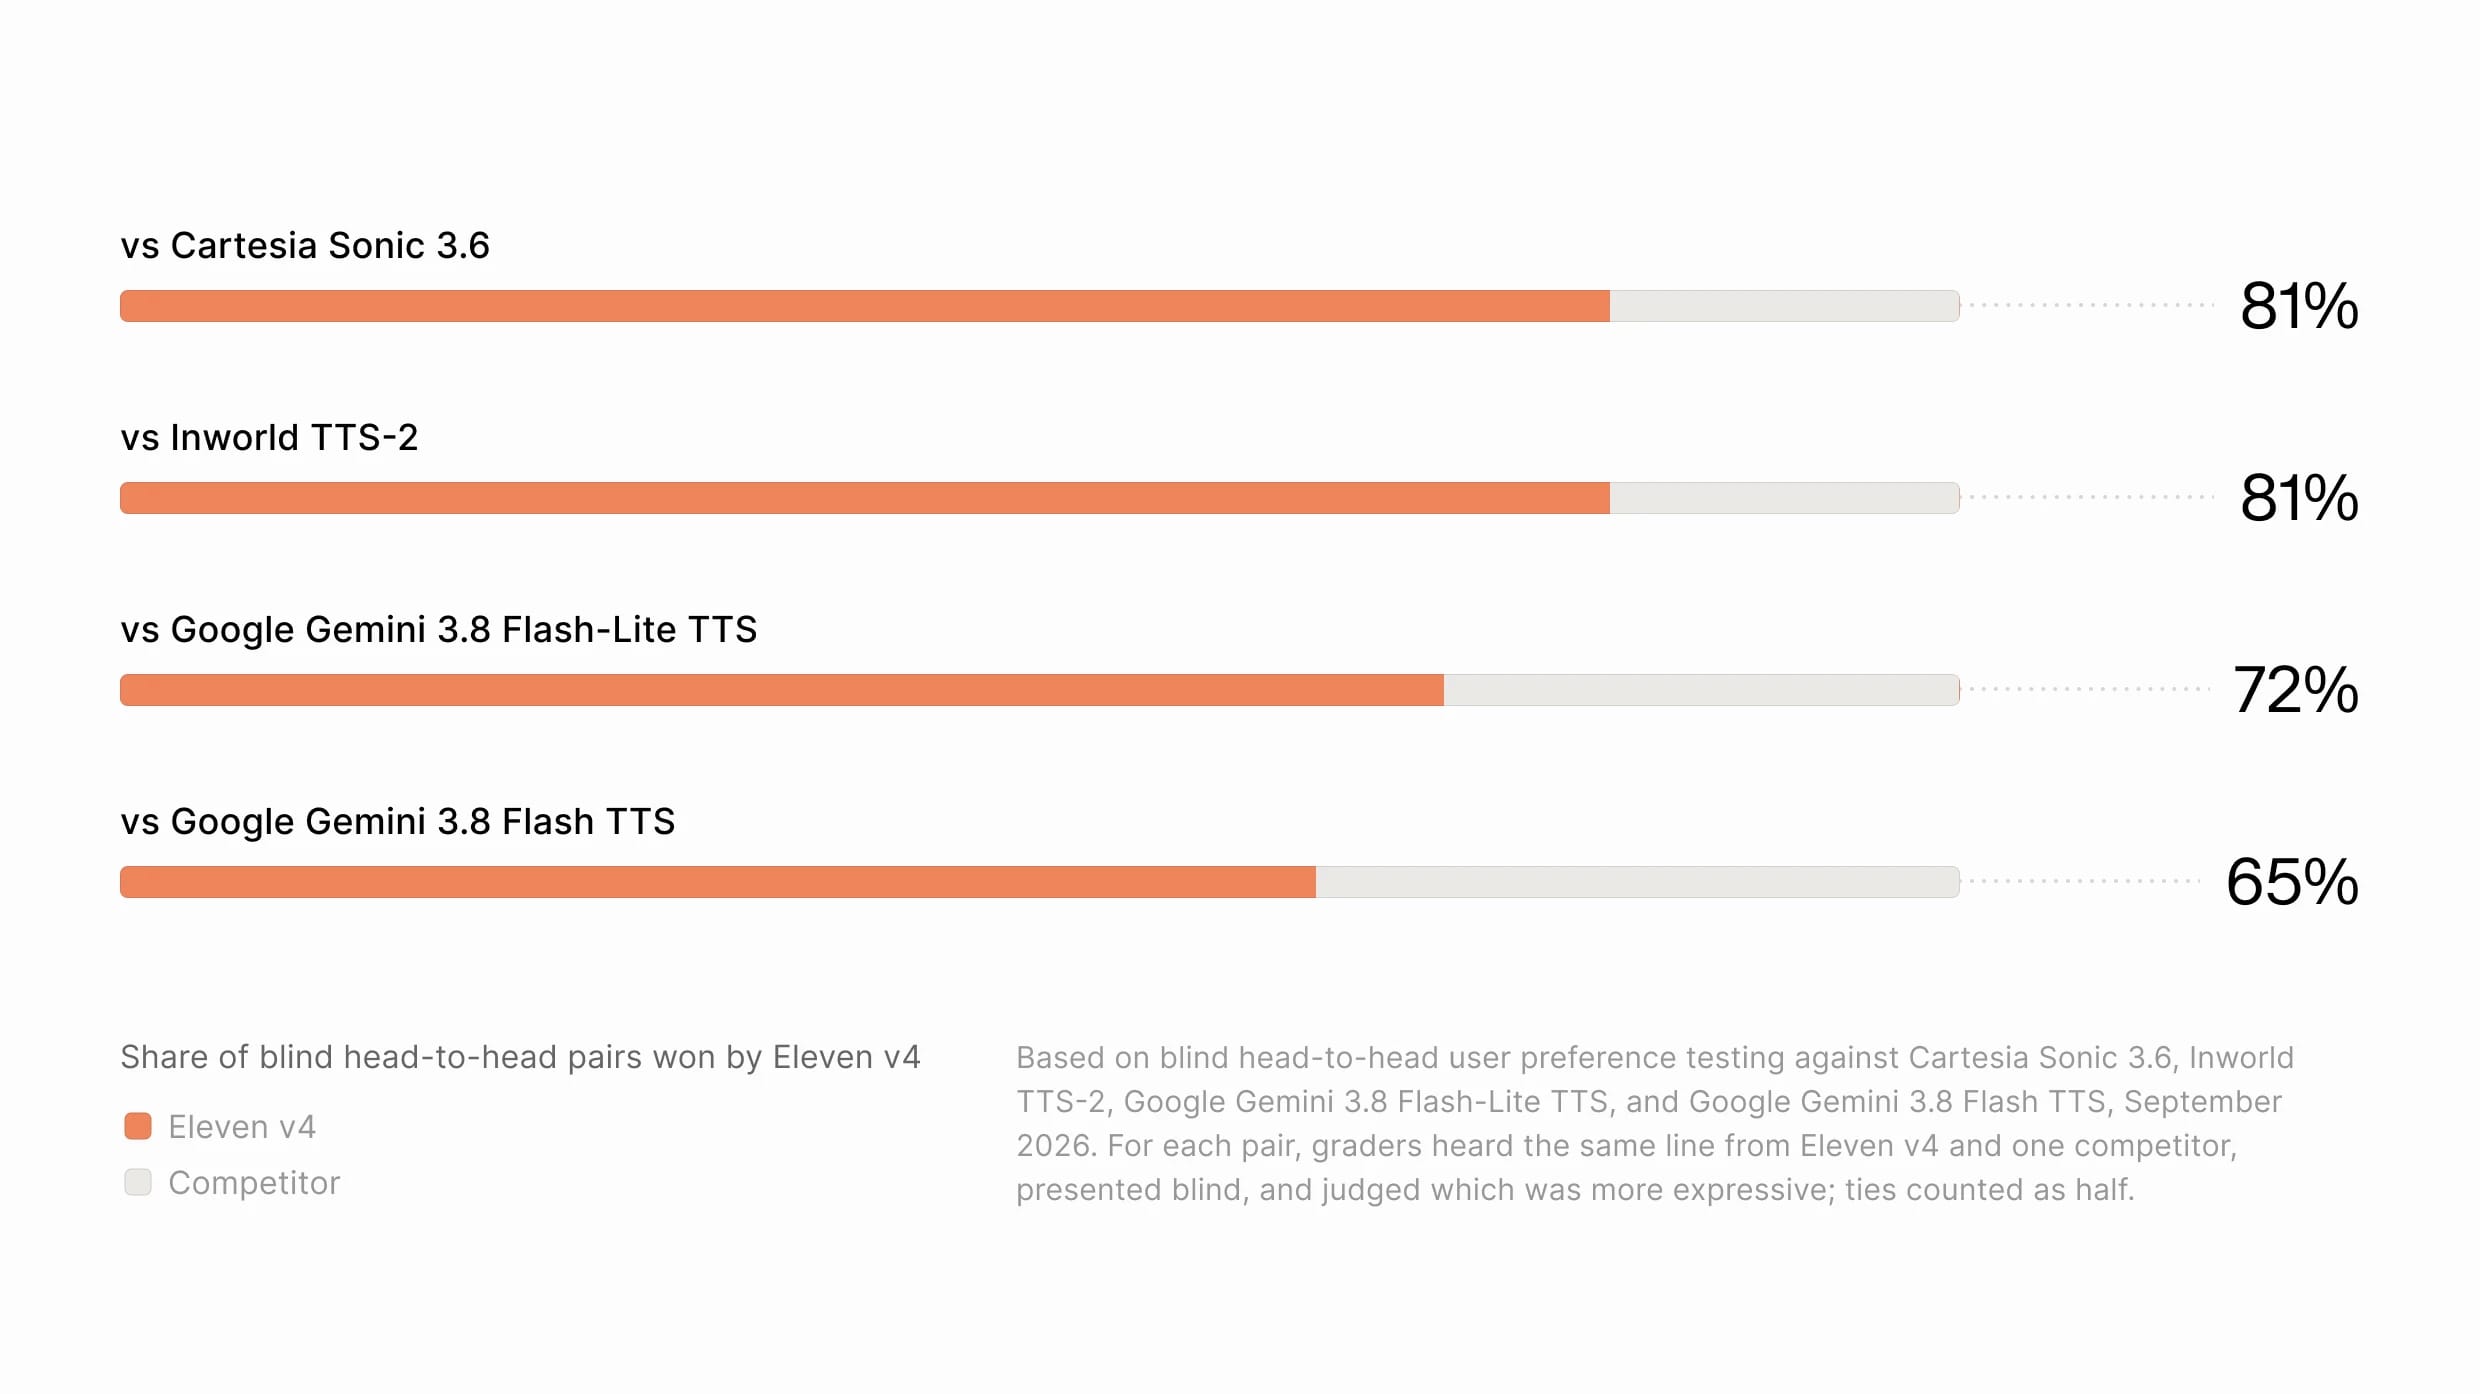
Classificato al primo posto da Artificial Analysis1, e preferito da circa il 75% degli ascoltatori nei test comparativi alla cieca rispetto ai modelli concorrenti2, Eleven v4 è stato progettato per interpretare tono, ritmo, emozione, carattere e contesto. Genera parlato che può essere drammatico, delicato, urgente, comico o conversazionale, mantenendo al tempo stesso l'identità di chi parla. Dinamiche più naturali tra più interlocutori rendono le conversazioni reattive, anziché simili a battute separate assemblate insieme. Gli interlocutori rispondono al contesto della conversazione, creando dialoghi e interazioni tra personaggi più naturali.
Una nuova architettura progettata per le prestazioni
Basato su un'architettura completamente nuova, Eleven v4 è il nostro modello Text to Speech più espressivo, classificato al primo posto da Artificial Analysis1. Eleven v4 Turbo porta la stessa tecnologia a casi d'uso a bassa latenza, come gli agenti. Con una latenza di inferenza mediana di circa 100 ms, può rispondere più rapidamente della pausa media tra due persone che parlano.
Entrambi i modelli possono generare parlato espressivo, anziché meccanico. La fedeltà audio di base è inoltre superiore sotto ogni aspetto, con un output più pulito e naturale.
Le generazioni precedenti di modelli Text to Speech possono leggere un testo ad alta voce, ma Eleven v4 conferisce al parlato una profondità emotiva molto più naturale. Il modello può interpretare il tono desiderato, il ritmo del parlato, il carattere della scrittura e il contesto del testo per offrire un parlato emotivamente coinvolgente.
Gli utenti hanno inoltre un controllo dettagliato sugli output e possono descrivere in linguaggio naturale come pronunciare una battuta. Possono anche aggiungere istruzioni specifiche su come dire determinate frasi, quale emozione devono trasmettere e perfino effetti sonori, usando tag inline come [laughs], [said angrily in French accent], [light rain] o [phone buzzing]. Eleven v4 segue questi tag audio e prompt di regia con maggiore precisione rispetto ai modelli precedenti, quindi ottieni l'interpretazione che descrivi. In questo modo è più facile dirigere una narrazione, sviluppare personaggi o i loro dialoghi e gestire altri contesti in cui l'interpretazione è importante.
La documentazione per sviluppatori di ElevenLabs descrive la sintassi completa dei tag e come applicarli tramite l'API. Anche il supporto per i fonemi dell'Alfabeto Fonetico Internazionale (IPA) è stato migliorato notevolmente, quindi le pronunce personalizzate funzionano in modo più affidabile.
Eleven v4 introduce anche miglioramenti nella coerenza e nelle conversazioni dinamiche tra più interlocutori. Grazie a un nuovo metodo per catturare l'identità di chi parla, Eleven v4 preserva le qualità uniche di ogni voce. Riesce a mantenere il parlato coerente nelle conversazioni degli agenti, negli audiolibri o nelle pubblicità. Poiché il modello comprende il contesto di un'intera scena, genera dialoghi naturali in cui gli interlocutori rispondono a quanto è stato appena detto, anziché unire battute isolate.
Un modello Turbo per casi d'uso a bassa latenza
I modelli vocali di alta qualità hanno tendenzialmente tempi di generazione più lunghi, costringendo gli utenti a scegliere tra agenti vocali veloci o espressivi. Molti hanno scelto agenti competenti ma monotoni, che possono sembrare robotici a un cliente agitato che vuole semplicemente risolvere il proprio problema. agenti vocali.
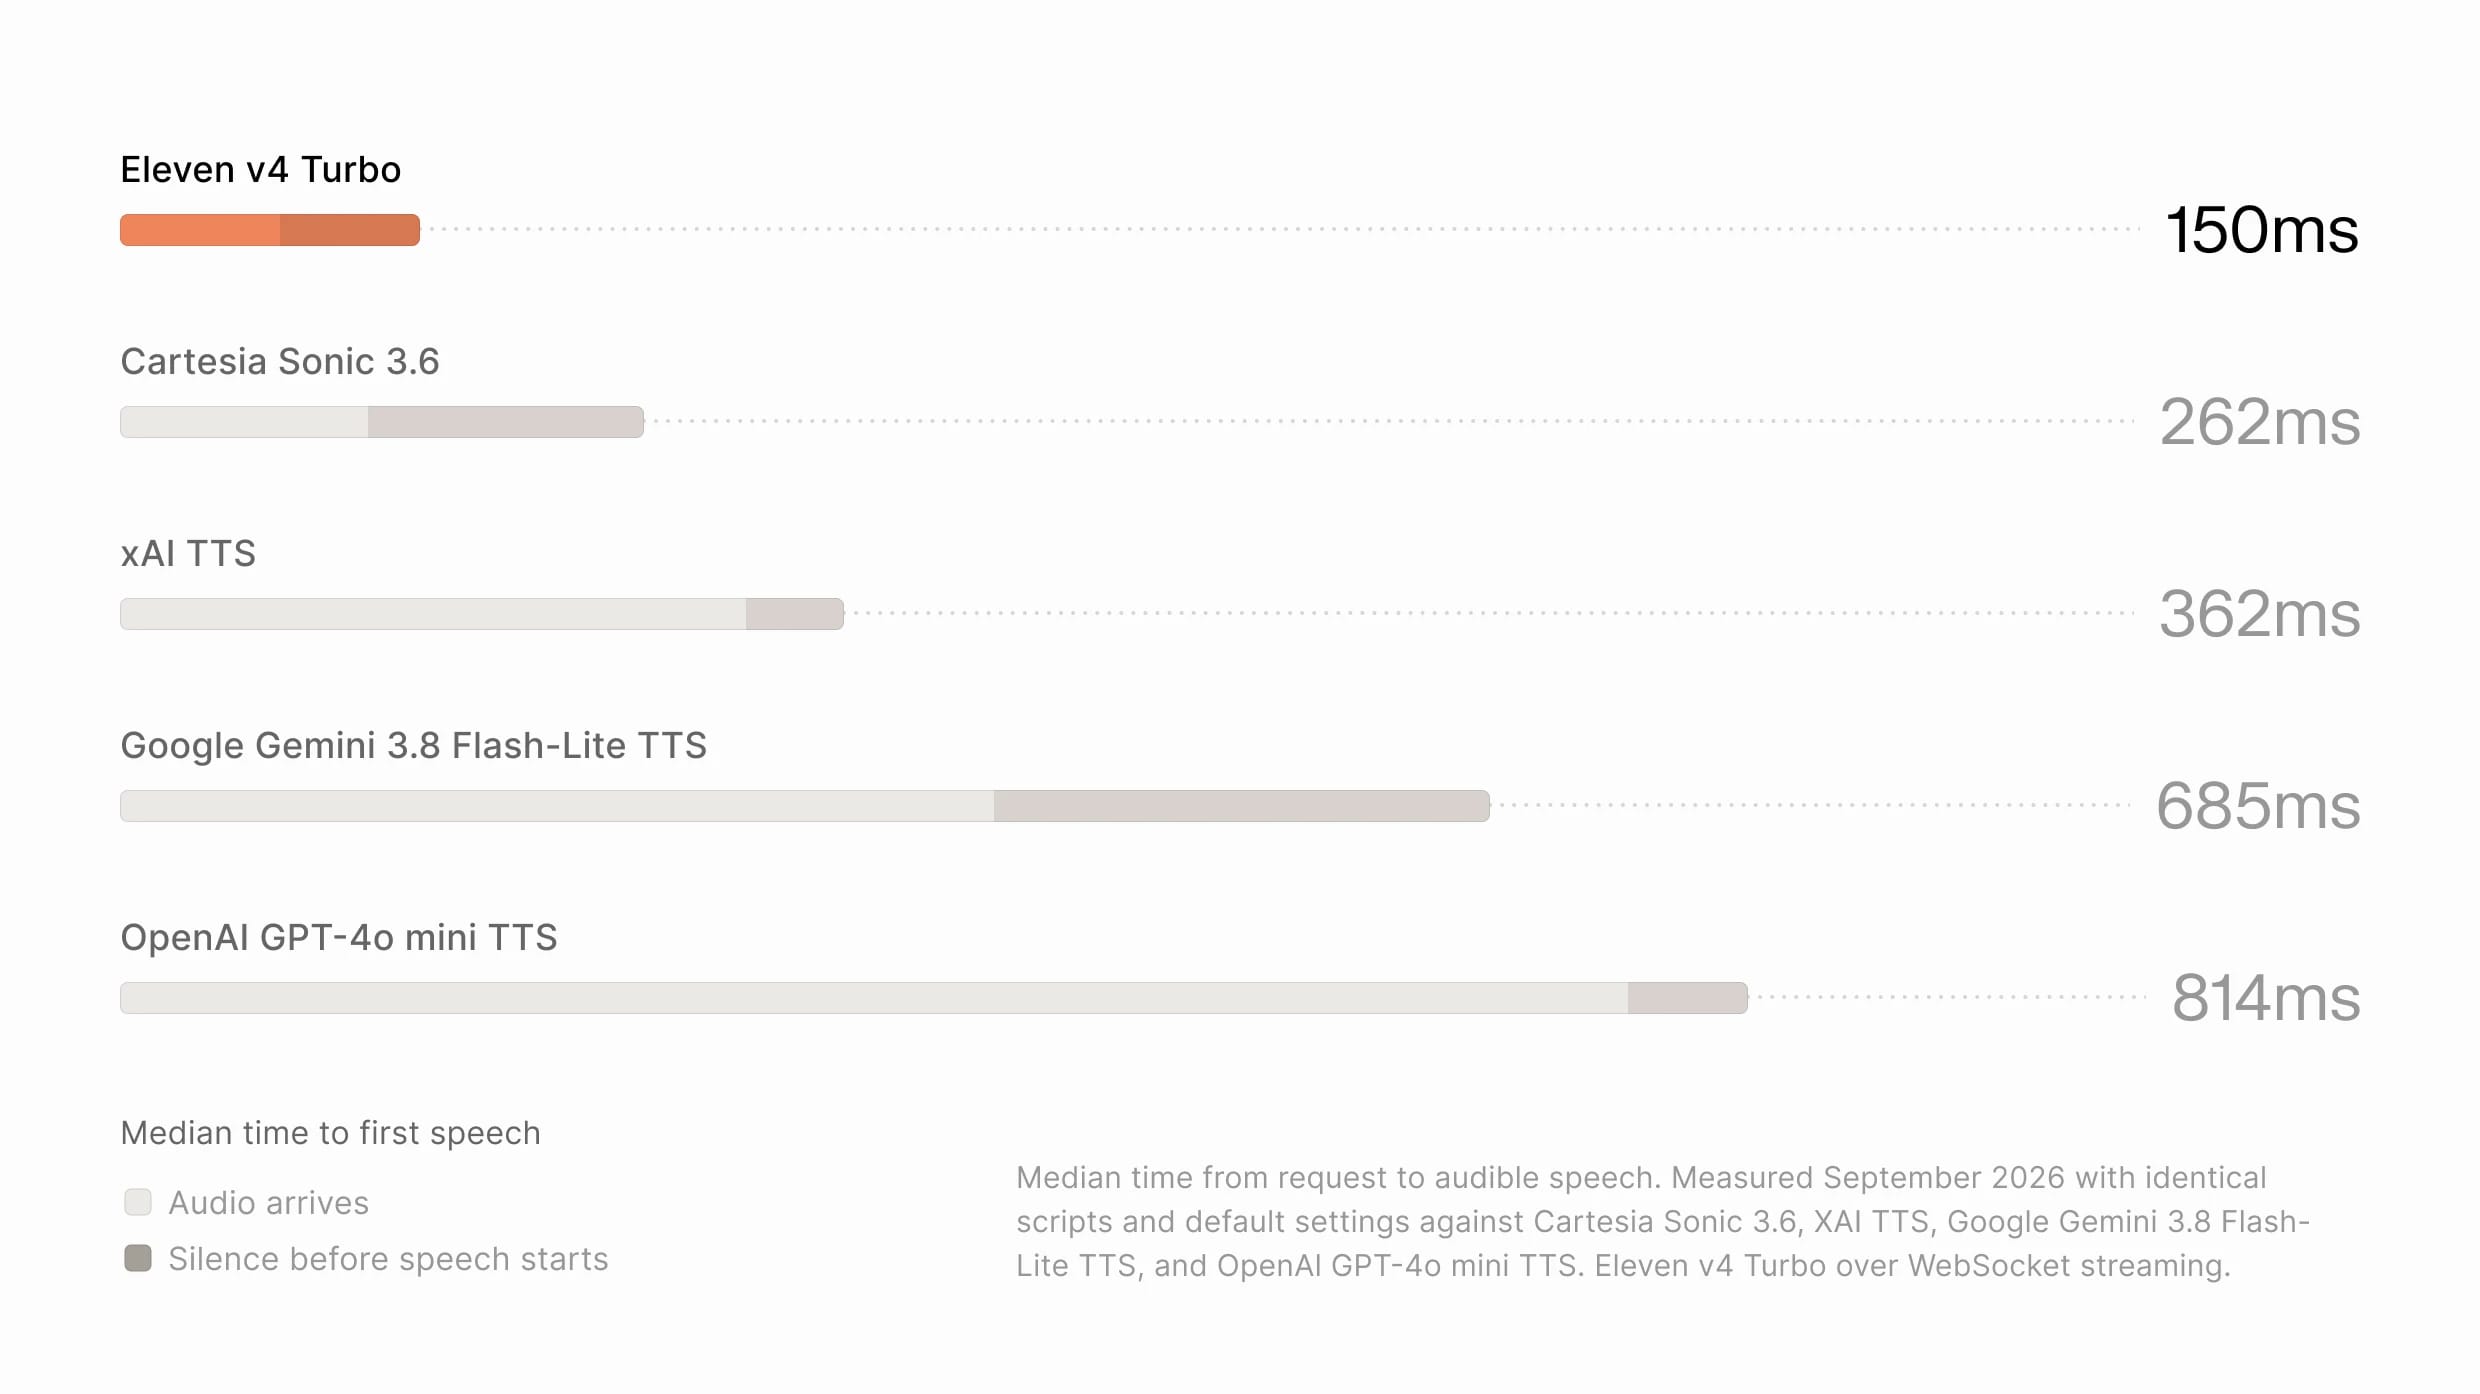
Eleven v4 Turbo combina velocità ed emozione con un tempo mediano al primo parlato di circa 150 ms3, consentendo di implementare agenti potenti in innumerevoli settori: da agenti cordiali e rassicuranti in grado di pronunciare con precisione termini medici in ambito sanitario, ad agenti che parlano velocemente e usano lo slang per intrattenere i giocatori nel gaming.
Il modello Eleven v4 Turbo è progettato per funzionare con la piattaforma di agenti conversazionali di ElevenLabs, ElevenAgents. Altri builder di agenti assemblano modelli e software di fornitori diversi, lasciando gli utenti senza un modo per perfezionare o migliorare gli output dei modelli per i propri casi d'uso. I team di ricerca e ingegneria di ElevenLabs hanno ottimizzato insieme Eleven v4 Turbo ed ElevenAgents come un unico sistema, offrendo agenti più espressivi, affidabili e a bassa latenza.
Una voce, innumerevoli lingue
Il modo in cui comunichiamo varia in base al contesto, al luogo e persino all'ora del giorno. Creare parlato espressivo che rispecchi queste differenze, in tutte le lingue, resta una delle sfide più difficili dell'audio IA.
Eleven v4 migliora tutti questi aspetti e i progressi vanno oltre il modo in cui il modello pronuncia le frasi. Eleven v4 coglie meglio ritmo, emozione e interpretazione nelle diverse lingue, aiutando i creator a produrre parlato naturale per la lingua e il contesto. Per esempio, il modo in cui parleresti a un anziano sconosciuto in Giappone è molto diverso da quello che useresti in Italia.
Sia Eleven v4 sia Eleven v4 Turbo supportano oltre 90 lingue. Ora una voce registrata in una lingua parla fluentemente anche qualsiasi altra, adottando l'accento di un madrelingua e mantenendo l'identità dell'originale. L'aderenza all'accento è sensibilmente più forte rispetto al passato, quindi la voce non torna più gradualmente verso il suo accento di origine nel corso di una generazione.
Catalano
Spagnolo
Per il doppiaggio e la localizzazione, questo significa che la voce del brand che hai scelto — che si tratti di un attore famoso con cui collabori o di un tono più adatto allo stile della tua azienda — suonerà al meglio in qualsiasi lingua supportata da Eleven v4.
Clonazione vocale più autentica e coerente
La clonazione vocale è più autentica, potente e coerente sia in Eleven v4 sia in Eleven v4 Turbo, con una somiglianza con la voce sorgente originale notevolmente migliore. Le Istant Voice Clone possono ora acquisire voci ad alta fedeltà usando appena 10 secondi di audio.
Voce reale
Eleven v4
Eleven v4 preserva inoltre l'identità di chi parla in modo più affidabile tra generazioni, dialoghi, narrazioni e battute rigenerate. Questo significa che, nei progetti di lunga durata, personaggi, narratori e voci clonate restano coerenti per l'intera produzione. Eleven v4 aggiunge anche il supporto per le Professional Voice Clones (PVC), per i casi d'uso di clonazione che richiedono la massima fedeltà.
Anche il request stitching — concatenare le generazioni per creare contenuti più lunghi — è notevolmente più affidabile in Eleven v4, migliorando l'esperienza di lavoro in ElevenLabs Studio e nell'app ElevenLabs Reader.
Ascolta la differenza in prima persona
Eleven v4 ed Eleven v4 Turbo sono il risultato delle nostre più recenti ricerche sulla generazione di parlato espressivo. Sono progettati per contenuti in cui l'interpretazione conta quanto le parole stesse, come audiolibri, interpretazioni di personaggi, voci fuori campo, doppiaggio o localizzazione di agenti conversazionali.
Entrambi i modelli sono già disponibili in ElevenAgents, ElevenCreative e tramite ElevenAPI. Crea un account gratuito per iniziare a generare oggi con Eleven v4 o Eleven v4 Turbo.
- Artificial Analysis, Provider Voice Arena Leaderboard, settembre 2026
- Basato su test alla cieca delle preferenze degli utenti in confronto diretto con Cartesia Sonic 3.6, Inworld TTS-2, Google Gemini 3.8 Flash-Lite TTS e Google Gemini 3.8 Flash TTS, settembre 2026. Per ogni coppia, i valutatori hanno ascoltato la stessa battuta di Eleven v4 e di un concorrente, presentate alla cieca, e hanno giudicato quale fosse più espressiva e quale suonasse più naturale; i pareggi contavano come metà.
- Tempo mediano dalla richiesta al parlato udibile. Misurato a settembre 2026 con script identici e impostazioni predefinite rispetto a Cartesia Sonic 3.6, xAI TTS, Google Gemini 3.8 Flash-Lite TTS e OpenAI GPT-4o mini TTS; la latenza di rete è stata misurata e rimossa per tutti i sistemi. Eleven v4 Turbo tramite streaming WebSocket.
Mati is the cofounder of ElevenLabs, where he leads teams building AI that can communicate at human level. Before ElevenLabs, Mati worked at Palantir where he embedded with enterprises and governments to help them deploy new technology. He grew up in Poland, before moving to the UK to study Mathematics at Imperial College London.