Cosa sono gli Audio Tags? La guida completa al TTS emozionale
- Scritto da
- Jack Limebear
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
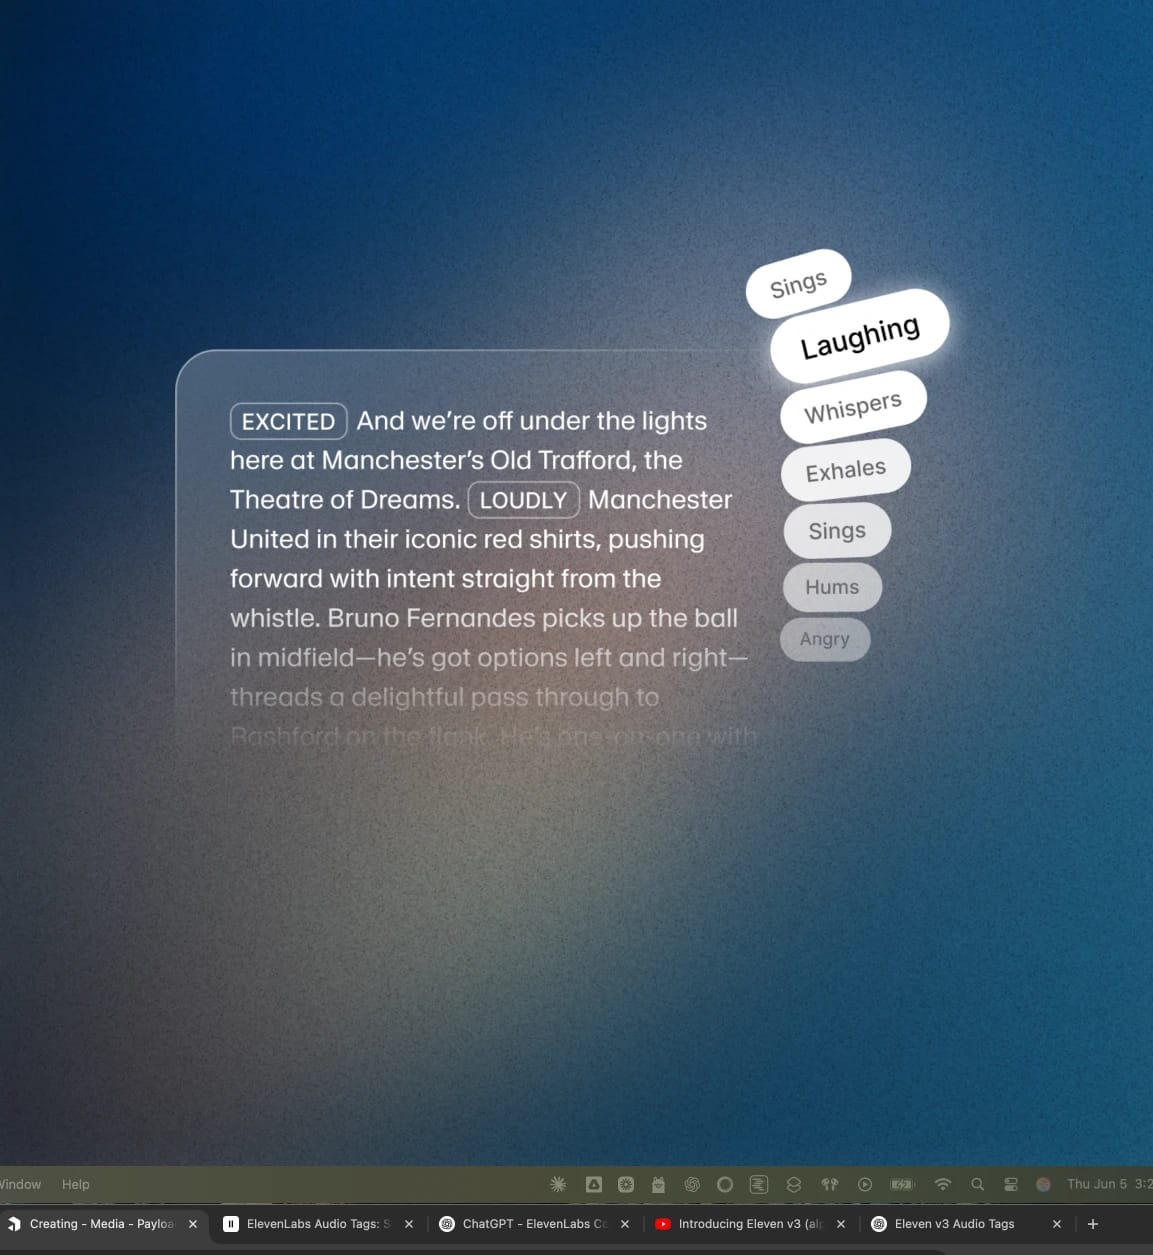
Gli Audio Tags sono indicazioni in linguaggio naturale tra parentesi quadre, come [laughs], [gasps], [excited] e [worried], che Eleven v3 ed Eleven v4 interpretano come istruzioni di recitazione anziché come parole da pronunciare. Quando scrivi un copione per un modello di text to speech, l'inserimento di questi Audio Tags ti offre un controllo preciso sulla resa emotiva del testo.
Eleven v3 è diventato disponibile al pubblico nel marzo 2026. Prima della v3, ottenere una resa emotiva specifica da un modello di Text to Speech richiedeva di rigenerare i contenuti sperando nel risultato migliore. Gli Audio Tags eliminano questa incertezza e ti offrono il pieno controllo di una resa text to speech emotiva. Eleven v4 va ancora oltre, offrendoti un controllo emotivo preciso.
Questa guida spiega cosa sono gli Audio Tags, come funzionano, tutte le categorie di tag disponibili e il loro confronto con SSML (Speech Synthesis Markup Language). Vedremo anche alcuni casi d'uso comuni, ciascuno con un link alla relativa guida dedicata.
In sintesi
- Gli Audio Tags sono indicazioni tra parentesi quadre come [shouts] o [excited] che definiscono emozione, ritmo, resa e tono del TTS in Eleven v3 ed Eleven v4.
- Eleven v3 ed Eleven v4 non supportano SSML, ma lo sostituiscono con gli Audio Tags per un'esperienza di scrittura più naturale.
- I tag rientrano in diverse categorie, tra cui emozioni, resa e ritmo, reazioni umane, accenti ed effetti sonori.
- La punteggiatura e le maiuscole nel testo ti permettono di definire il ritmo della resa di una voce IA.
- Puoi accedere agli Audio Tags su ElevenLabs dall'interfaccia utente o tramite l'API.
Come funzionano gli Audio Tags?
Gli Audio Tags si inseriscono direttamente nella trascrizione e sono racchiusi tra parentesi quadre. Ogni volta che vuoi modificare la resa, ad esempio da normale a [worried], devi semplicemente aggiungere un audio tag.
Puoi anche usare più di un tag nella stessa frase e combinarli per una resa più articolata, ad esempio [tired] È stata una lunga giornata… [upset] Quanti altri giorni riuscirò a sopportare?
L'architettura di Eleven v4 consente al modello di comprendere il contesto più a fondo rispetto ai modelli precedenti, seguendo indicazioni emotive, cambi di tono, passaggi tra parlanti e indizi contestuali senza bisogno di parametri o impostazioni separate. Devi semplicemente indicare al modello ciò che richiede il momento, e riprodurrà la battuta esattamente come l'hai immaginata.
Eleven v4 gestisce anche dialoghi con più parlanti dall'aspetto spontaneo, incluse interruzioni, cambi d'umore e il naturale scambio di una conversazione reale, tutto basandosi esclusivamente sui tag e sulla struttura del copione.
Audio Tags e SSML
Se hai lavorato con altri sistemi TTS, probabilmente hai già incontrato Speech Synthesis Markup Language. Piattaforme come Amazon Polly e Microsoft Azure Speech usano tag SSML quali <break> o <emphasis> per aggiungere ulteriore contesto a un copione TTS.
Eleven v4 non supporta i tag di interruzione SSML né il resto del set di tag SSML. Al loro posto, Audio Tags, la punteggiatura e la struttura stessa del testo ne assumono il ruolo, offrendo al contempo un controllo preciso sulla resa.
Puoi usare la tabella qui sotto per associare i tag SSML più comuni all'equivalente in Eleven v4.
Dal punto di vista di chi scrive, aggiungere [whispers] a una battuta richiede molto meno impegno che configurare una frequenza di prosody.
Le categorie di Audio Tags nella v3: dirigere la resa con gli Audio Tags
Puoi inserire gli Audio Tags in qualsiasi punto del copione per modellare la resa in tempo reale. Puoi anche usare combinazioni di tag in un copione o persino in una frase.
I tag rientrano nelle seguenti categorie principali.
Emozioni
Questi tag possono aiutarti a definire il tono emotivo della voce, che sia malinconico, intenso o allegro. Ad esempio, puoi usarne uno o combinarne più di uno tra [sad], [angry], [happily] e [sorrowful].
Resa e ritmo
Questi riguardano maggiormente il tono e la recitazione. Puoi usare questi tag per regolare volume ed energia nelle scene che richiedono moderazione o intensità. Alcuni esempi sono [whispers], [shouts] e [softly].
Reazioni umane
Il parlato davvero naturale include le reazioni. Ad esempio, puoi usarli per aggiungere realismo integrando nel parlato momenti naturali e non pianificati. Tag come [laughs], [clears throat] e [sighs] contribuiscono a creare un modello TTS capace di trasmettere emozioni umane.
Altri esempi di categorie di audio tag includono:
- Accenti e voci dei personaggi: i tag di accento trasformano la voce in una specifica regione o personaggio senza cambiare modello, come [French accent], [British accent] o [pirate voice]. Usali per trasformare una singola voce in un cast flessibile anziché in una sola resa fissa.
- Effetti sonori: i tag degli effetti sonori aggiungono audio non parlato direttamente alla generazione, come [gunshot], [explosion] e [clapping]. Funzionano bene per audio immersivi, giochi e narrazioni drammatizzate in cui la scena richiede più di una voce. In alternativa, usa il generatore di effetti sonori IA ElevenCreative.
Sebbene i tag ti offrano un alto livello di controllo, puoi usare anche la punteggiatura per definire ritmo ed enfasi. Ad esempio, aggiungi dei puntini di sospensione per una pausa naturale o usa le virgole per creare pause respiratorie naturali. Prova a scrivere una parola tutta in maiuscolo per enfatizzarla: “Lo voglio proprio ADESSO.”
Cosa puoi fare con gli Audio Tags?
Gli Audio Tags rendono accessibile in modo intuitivo la complessità emotiva dei copioni. Scrivi in modo naturale e aggiungi i tag man mano.
Ecco una rapida panoramica di alcuni casi d'uso del TTS emotivo con gli Audio Tags.
Consapevolezza situazionale nell'audio IA
Tag come [whisper] o [shouting] permettono a Eleven v4 di reagire al momento. Puoi integrare nel copione una consapevolezza situazionale dinamica, dall'attenuare un avvertimento al mantenere una pausa prolungata per creare suspense.
Per un'analisi completa, consulta la nostra guida sulla consapevolezza situazionale nell'audio IA.
Dirigere la resa dei personaggi nel parlato
Quando crei un copione con più personaggi, vuoi mostrare chiaramente in cosa ogni voce è diversa. Dalla sperimentazione con la loro personalità tramite [sarcastically] alla definizione del loro modo di parlare con [British accent], puoi catturare un'intera gamma di emozioni con il nostro motore TTS.
Scopri di più su come dirigere la resa dei personaggi nel parlato IA.
Esprimere il contesto emotivo nel parlato
Gli Audio Tags ti permettono di modellare la resa emotiva di una battuta mentre si sviluppa. Puoi sviluppare le emozioni nel corso di un discorso, fino a raggiungere un crescendo nel momento in cui immagini il tuo personaggio esprimersi al massimo delle sue potenzialità. Tag come [awe], [booming] e [big laugh] aiutano a integrare un'intera gamma emotiva nella resa della tua voce IA.
Leggi di più sull'uso del contesto emotivo nel parlato IA.
Dare vita ai dialoghi con più personaggi
Quando crei performance di dialogo con più personaggi, puoi iniziare ogni battuta con un audio tag per costruire discussioni ricche tra i personaggi.
Prendi come esempio il seguente: Tom: [coughing] [beginning to speak] scusa, oggi non sto molto bene— Emma: [interrupting] —Non stai bene? Sai quanto odio la tosse, Tom! Tom: [surprised] È solo un colpetto di tosse, non è niente di grave. Come ti sentiresti se— Emma: [overlapping] [annoyed] —Penso che tu debba andare a casa.
Scopri cos'altro puoi fare con i dialoghi con più personaggi su Eleven v3.
Controllo preciso della resa per il parlato IA
Puoi controllare il ritmo del parlato con Eleven v3 ed Eleven v4 usando gli Audio Tags o la punteggiatura. Tag come [pause], [rushed] o [drawn out] ti permettono di modellare attivamente la battuta con precisione. In alternativa, aggiungi puntini di sospensione, punti fermi e punti esclamativi per integrare naturalmente l'emozione nella tua resa TTS.
Abbiamo scritto una guida approfondita sul controllo preciso della resa su Eleven v3.
Il TTS emotivo è disponibile nell'API
Gli Audio Tags funzionano allo stesso modo tramite l'API Text to Speech e nell'interfaccia utente di ElevenLabs. Scrivi il tag direttamente nel testo del copione e l'API restituirà la resa con tag nell'audio generato, dalle pipeline per audiolibri alle voci fuori campo pubblicitarie.
Scopri di più su Eleven v4 o contatta le vendite per iniziare oggi.
FAQ sugli Audio Tags e sul TTS emotivo

Jack Limebear fa parte del team Growth e si occupa di scrivere contenuti e definire strategie per il blog e le pagine insights. Prima di arrivare in ElevenLabs, ha guidato la strategia dei contenuti per oltre dieci anni in realtà che vanno da startup SaaS in rapida crescita a grandi aziende Fortune 500. Ha conseguito un Master in Letteratura Inglese presso l’Università di Cambridge.