Audio Tag Eleven v3: consapevolezza del contesto per l’audio IA
- Scritto da
- Ryan Morrison
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
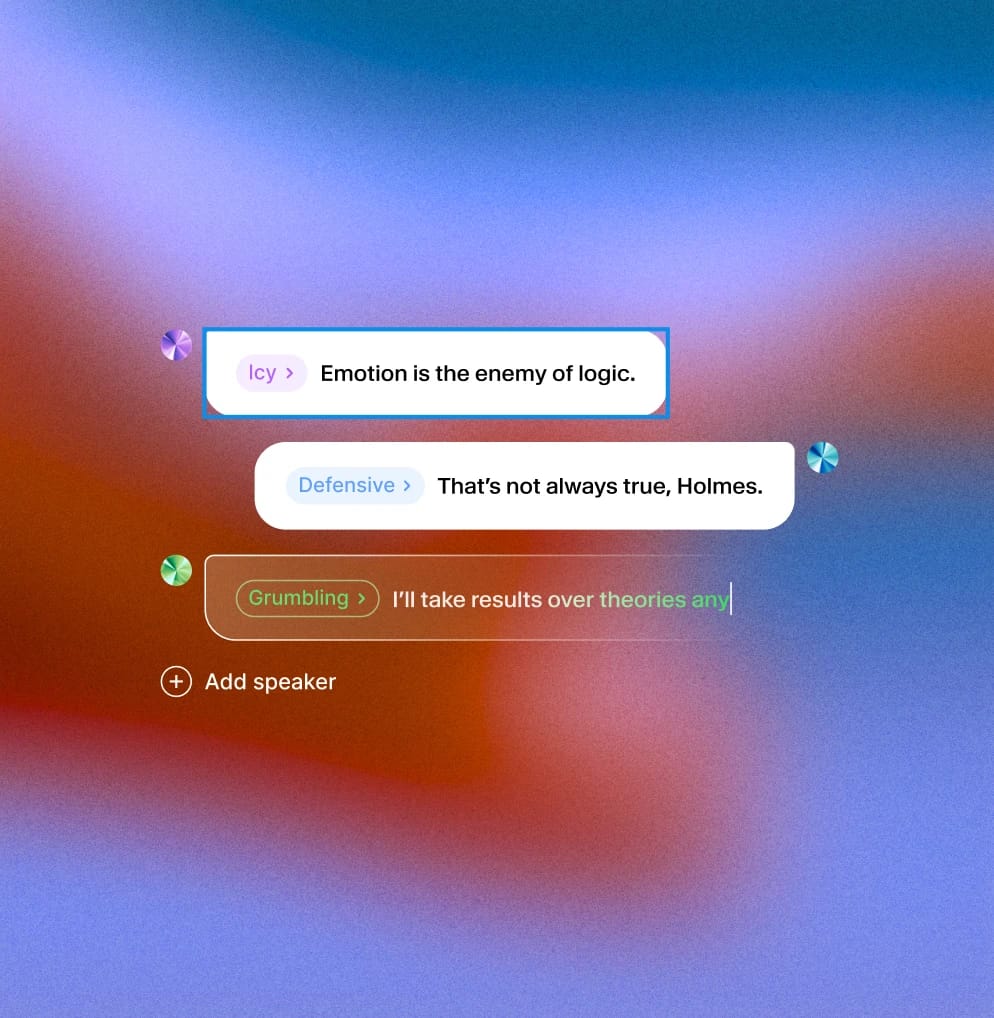
Gli Audio Tags sono una componente fondamentale del nuovo modello Eleven v3 (alpha) Text to Speech. Ti permettono di controllare come vengono pronunciate le battute, modificando tono, emozione e ritmo in base al contesto reale.
Nella loro forma più semplice, gli Audio Tags sono parole tra parentesi quadre. Il modello le interpreta come indicazioni di interpretazione. Puoi quindi modificare la resa a metà frase per riflettere passaggi emotivi o cambiamenti di situazione, dando all'IA un certo grado di consapevolezza del contesto.
Che cos'è la consapevolezza del contesto nella sintesi vocale IA?
La consapevolezza del contesto significa che l'IA adatta la sua resa al momento. Con gli Audio Tags, controlli non solo ciò che il modello dice, ma anche il modo in cui risponde.
Che tu voglia aggiungere urgenza con un tag [SHOUTING], attenuare un avvertimento con [WHISPER] o segnalare un'esitazione con [SIGH], i tag trasformano la narrazione in interpretazione. Sono particolarmente utili nelle scene ricche di contesto o dinamiche.
Interpretazione, non semplice lettura
Immagina di scrivere la sceneggiatura di un video di highlights con Veo 3 su una partita di calcio tra 11 United e 12 United. Vuoi che l'intensità cresca con l'azione: «Supera un difensore — [EXCITED] arriva il cross — [SHOUTING] GOOOOL!»
Oppure stai doppiando un momento di suspense in un audiolibro: «[WHISPERING] Credo che ci sia qualcuno in casa. [PAUSE] Stai zitto.»
Non sono semplici aggiunte stilistiche. Definiscono il momento e ne guidano le emozioni. Il modello non legge: interpreta.
Tag comuni per l'uso contestuale
Gli Audio Tags ti consentono di simulare una serie di segnali emotivi e fisici:
- Tono emotivo: [EXCITED], [NERVOUS], [FRUSTRATED], [TIRED]
- Reazioni: [GASP], [SIGH], [LAUGHS], [GULPS]
- Volume ed energia: [WHISPERING], [SHOUTING], [QUIETLY], [LOUDLY]
- Ritmo e cadenza: [PAUSES], [STAMMERS], [RUSHED]
Puoi combinare i tag per aggiungere sfumature: «[NERVOUSLY] Io... non sono sicuro che funzionerà. [GULPS] Ma proviamoci comunque.»
Un'interpretazione che puoi dirigere
Eleven v3 supporta questi tag con un modello contestuale più avanzato. Può cambiare tono a metà battuta, gestire le interruzioni e mantenere la fluidità, offrendoti una resa più naturale senza dover riscrivere il copione.
Per i voice designer, gli sviluppatori di videogiochi e gli storyteller, questo apre un nuovo livello creativo. Non ti limiti a scrivere battute: le dirigi.
Scegliere la voce giusta
Le Professional Voice Clones (PVC) al momento non sono completamente ottimizzate per Eleven v3, quindi la qualità del clone potrebbe essere inferiore rispetto ai modelli precedenti. In questa fase di anteprima di ricerca, se devi usare le funzionalità di v3 per il tuo progetto, è consigliabile trovare una Instant Voice Clone (IVC) o una voce progettata. L'ottimizzazione delle PVC per v3 arriverà a breve.
Ryan joined ElevenLabs after more than two decades in news and publishing, including roles at the BBC and Future Plc. He focuses on content strategy and storytelling, helping ElevenLabs shape and share its narrative.