
Tag SSML spiegati: come controllare pause, pronuncia e ritmo nella sintesi vocale
- Scritto da
- Jack Limebear
- Pubblicato
AscoltaAscolta questo articolo
Speech Synthesis Markup Language (SSML) è un linguaggio di markup basato su XML che racchiude il testo in tag per indicare a un modello di sintesi vocale come pronunciarlo, compresi i punti in cui fare una pausa, come pronunciare una parola e quale frase enfatizzare.
Questo livello di controllo è alla base di gran parte del parlato IA che ascolti già oggi. Un sistema di risposta vocale interattiva (IVR) che legge un numero di conferma e un audiolibro IA con un narratore che fa una pausa alla fine di un capitolo si basano entrambi su una sua versione. Se hai dedicato tempo a personalizzare il parlato generato dall'IA, probabilmente hai già incontrato SSML.
SSML fa parte della tecnologia TTS da oltre due decenni ed è ancora una componente importante del modo in cui molti provider offrono il TTS. Questa guida spiega cos'è SSML e dove si applica esattamente nella gamma di modelli ElevenLabs, insieme al sistema migliorato di Audio Tags che Eleven v3 e Eleven v4 usano per offrire una sintesi vocale naturale ai massimi livelli.
Scopri Eleven v4 in azione con gli Audio Tags
Scopri Eleven v4In breve
- SSML è un linguaggio di markup basato sugli standard W3C usato per controllare pause vocali, enfasi, pronuncia e ritmo del parlato sintetizzato.
- I modelli ElevenLabs, a eccezione di Eleven v3 ed Eleven v4, supportano il tag SSML <break> per pause fino a 3 secondi.
- Eleven Flash v2 ed Eleven Turbo v2 supportano il tag <phoneme> per una pronuncia inglese personalizzata.
- Eleven v3 ed Eleven v4 non supportano affatto SSML. Usano invece gli Audio Tags per istruzioni in linguaggio naturale tra parentesi quadre, come [whispering] e [sighs], così da controllare il flusso del parlato sintetizzato.
- La WebSocket API controlla l'analisi SSML tramite il parametro enable_ssml_parsing e invia i tag SSML come messaggi completi per evitare ulteriore latenza.
- Tag come <prosody>, <say-as>, <sub>, <lang>, <voice> e <audio> non sono supportati dai modelli ElevenLabs, ma ciascuno ha un equivalente: impostazioni vocali, normalizzazione del testo, dizionari di pronuncia, modelli multilingue, voci separate ed effetti sonori.
Cos'è SSML?
SSML è un linguaggio di markup che ti consente di annotare un testo scritto con istruzioni su come un motore di sintesi dovrebbe pronunciarlo. Il World Wide Web Consortium (W3C) lo ha sviluppato come standard per andare oltre i semplici modelli di sintesi vocale da testo. SSML offre indicazioni esplicite e leggibili dalla macchina su come pronunciare un passaggio, anziché affidarsi a modelli di interpretazione del testo semplice.
SSML non è un markup esclusivo di un singolo provider. Amazon Polly e Microsoft Azure Speech usano entrambi tag SSML, come <break> e <emphasis>, come meccanismo di controllo principale. La maggior parte delle piattaforme cloud di sintesi vocale accetta una versione dello standard. SSML è stato il modo predefinito per annotare il parlato molto prima dell'esistenza dei modelli vocali generativi.
SSML resta uno standard fondamentale, mentre nuovi controlli specifici per modello si sviluppano insieme alle moderne tecnologie vocali generative. Questa specifica indipendente dai provider consente di implementare tag principali comuni. I provider possono poi aggiungere le proprie estensioni e limitazioni a tali tag principali.
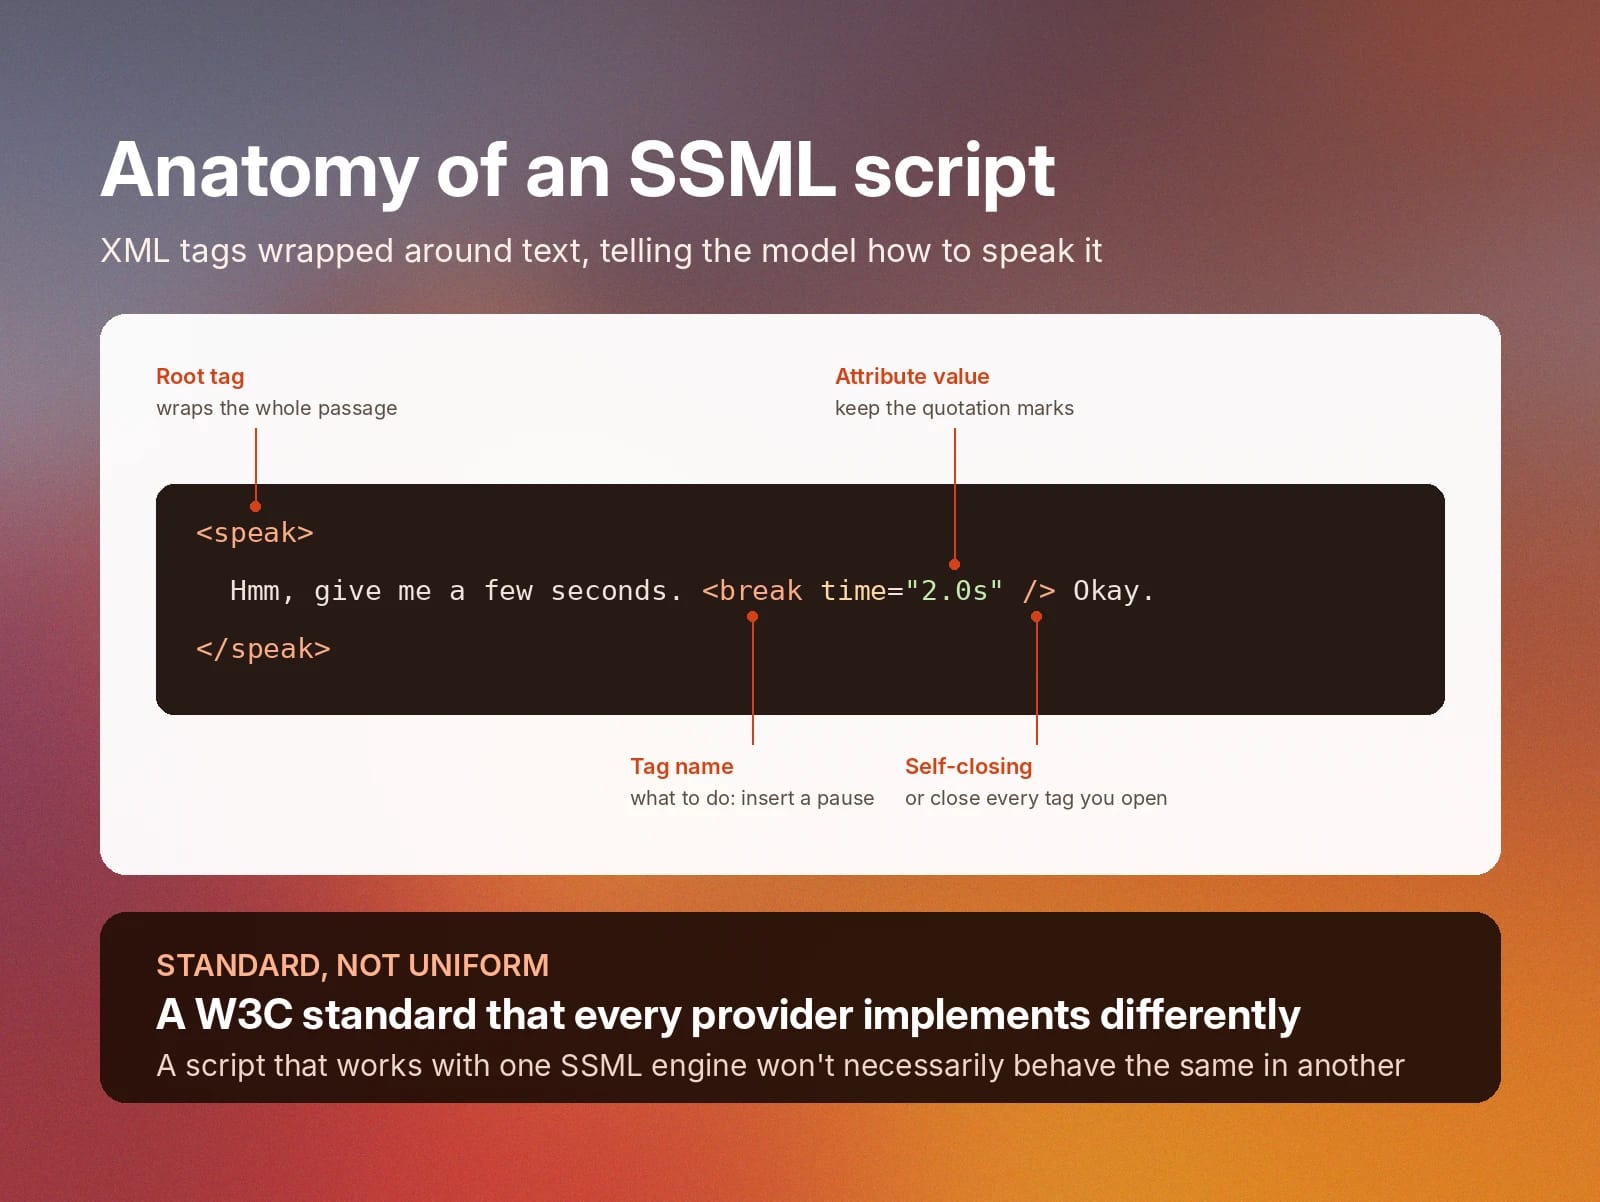
Tag SSML comuni per migliorare l'intonazione e a cosa servono
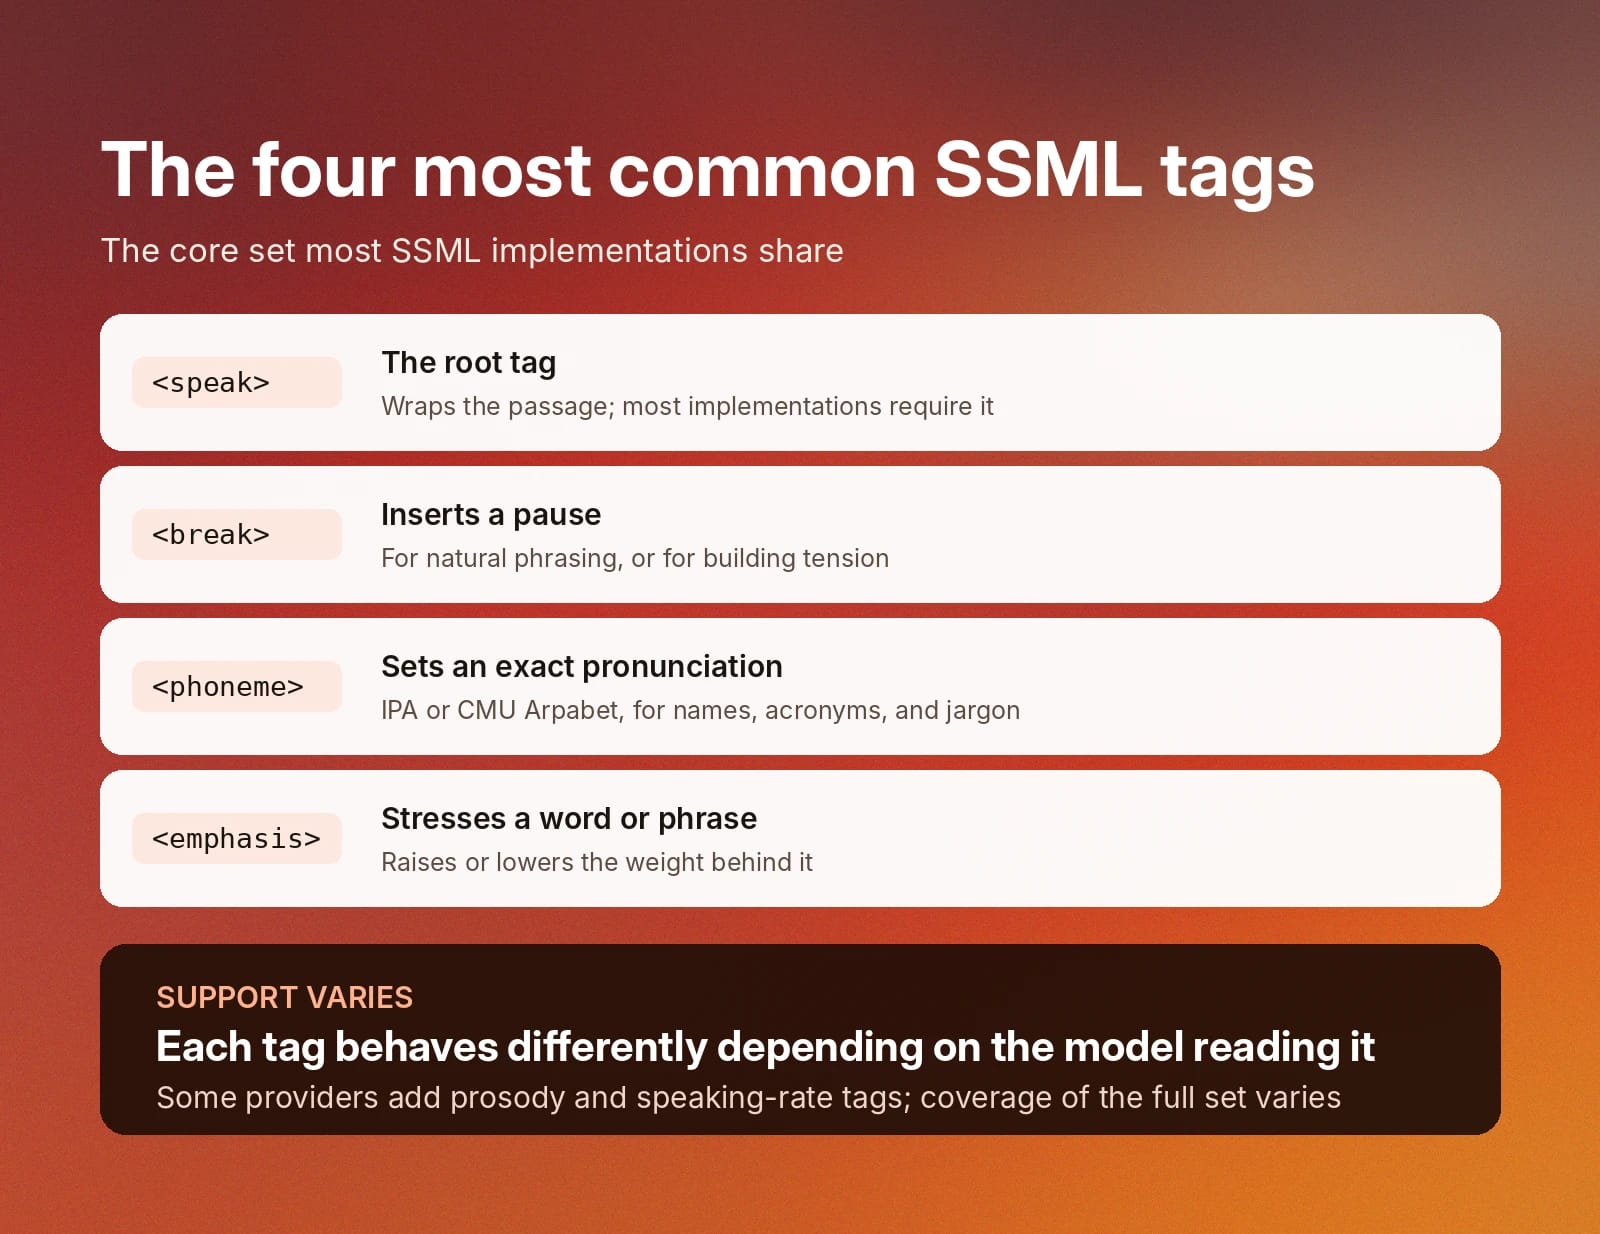
Le implementazioni SSML condividono una serie di tag principali che la maggior parte delle persone cerca quando vuole controllare il parlato sintetizzato.
Questi sono i tag SSML più comuni:
- <speak>: è il tag radice che racchiude l'intero passaggio. La maggior parte delle implementazioni lo richiede per riconoscere il contenuto incluso come SSML.
- <break>: inserisce una pausa di durata specificata, utile per creare una formulazione naturale tra proposizioni o frasi, oppure per creare suspense in un testo.
- <phoneme>: specifica l'esatta pronuncia di una parola usando un alfabeto fonetico come IPA o CMU Arpabet, utile per acronimi, nomi o termini tecnici.
- <emphasis>: enfatizza una parola o una frase, imitando il modo in cui un parlante aumenta o riduce naturalmente il peso del suo significato.
Ciascuno di questi quattro tag si comporta diversamente in base al modello TTS che lo legge. Alcuni provider supportano tag aggiuntivi per prosodia o velocità del parlato. Uno script scritto per un provider TTS non si comporterà come per un altro, anche se entrambi dichiarano di supportare SSML, perché la copertura dell'intero set di tag varia.
Ciò che varia maggiormente è quali tag un determinato modello di sintesi vocale elabori effettivamente, ed è qui che l'implementazione di ElevenLabs diventa specifica.
Usare SSML con ElevenLabs
Il supporto SSML di ElevenLabs non è completamente uniforme. Dipende dal modello selezionato per generare l'audio. Il tag <break> è l'elemento supportato più ampiamente, mentre <phoneme> è disponibile su una gamma più ristretta di modelli.
I modelli TTS meno recenti di ElevenLabs, come Multilingual v2, supportano il tag <break> per pause fino a tre secondi. Per esempio, un agente IA potrebbe dire: "Aspetta, fammi pensare", poi usare <break time="2.0s" /> per creare una pausa udibile prima di proseguire con "Va bene, so come aiutarti". È il tag più comune in molti workflow, perché aiuta a simulare uno stile di conversazione più naturale.
Quando usi tag SSML, è meglio limitarne il numero contemporaneamente. Usarne molti in una frase o in un paragrafo può far cambiare inaspettatamente velocità al modello o introdurre vari artefatti audio. Anche le diverse voci gestiscono le pause in modo diverso, specialmente quelle addestrate su campioni che includono intercalari come "ehm" o "mmm".
SSML in pratica con ElevenLabs
I modelli ElevenLabs Flash v2 e Turbo v2 fanno un passo in più e supportano anche il tag <phoneme> per pronunce personalizzate, limitatamente all'inglese. Questo rende il tag phoneme utile per correggere il modo in cui un modello pronuncia un nome, un acronimo, un termine tecnico o altra terminologia aziendale. Vale finché lo script viene eseguito su uno di questi due modelli.
Al contrario, Eleven v3 ed Eleven v4 si discostano completamente da questo schema. Usano gli Audio Tags per controllare la resa vocale. Inoltre, Eleven v4 introduce il supporto IPA inline nativo, che consente di leggere direttamente nel testo i simboli IPA racchiusi tra barre oblique. Vedremo di seguito cosa sostituisce il tag break e i controlli della resa vocale.
Per una panoramica completa dei controlli di sintesi vocale di ElevenLabs, inclusi i dizionari di pronuncia e la normalizzazione del testo, consulta la guida alle best practice.
Esempi di codice SSML con ElevenLabs
Gli esempi seguenti mostrano SSML in uno script e in una chiamata API. Ricorda che <break> funziona su tutti i modelli tranne Eleven v4 ed Eleven v3, mentre <phoneme> funziona solo su Flash v2 e Turbo v2 (solo in inglese).
Implementare SSML per il controllo vocale e aggiungere una pausa
Racchiudi il testo e il tag in un blocco <speak> e mantieni le virgolette attorno al valore dell'attributo:
Trovi maggiori informazioni sulle pause e sui tag phoneme SSML tramite ElevenAPI.
Correggi una pronuncia con <phoneme>
Usa IPA o CMU Arpabet per indicare esattamente il suono di una parola. Qui il nome "Siobhan" viene guidato con IPA, mentre "Madison" è indicato con CMU Arpabet:
Generare parlato con SSML in Python
Questa chiamata invia a un modello che lo supporta uno script contenente un tag break:
Generare parlato con SSML in JavaScript
Di seguito trovi un esempio simile per generare parlato con SSML, ma scritto in JavaScript.
SSML e la WebSocket API
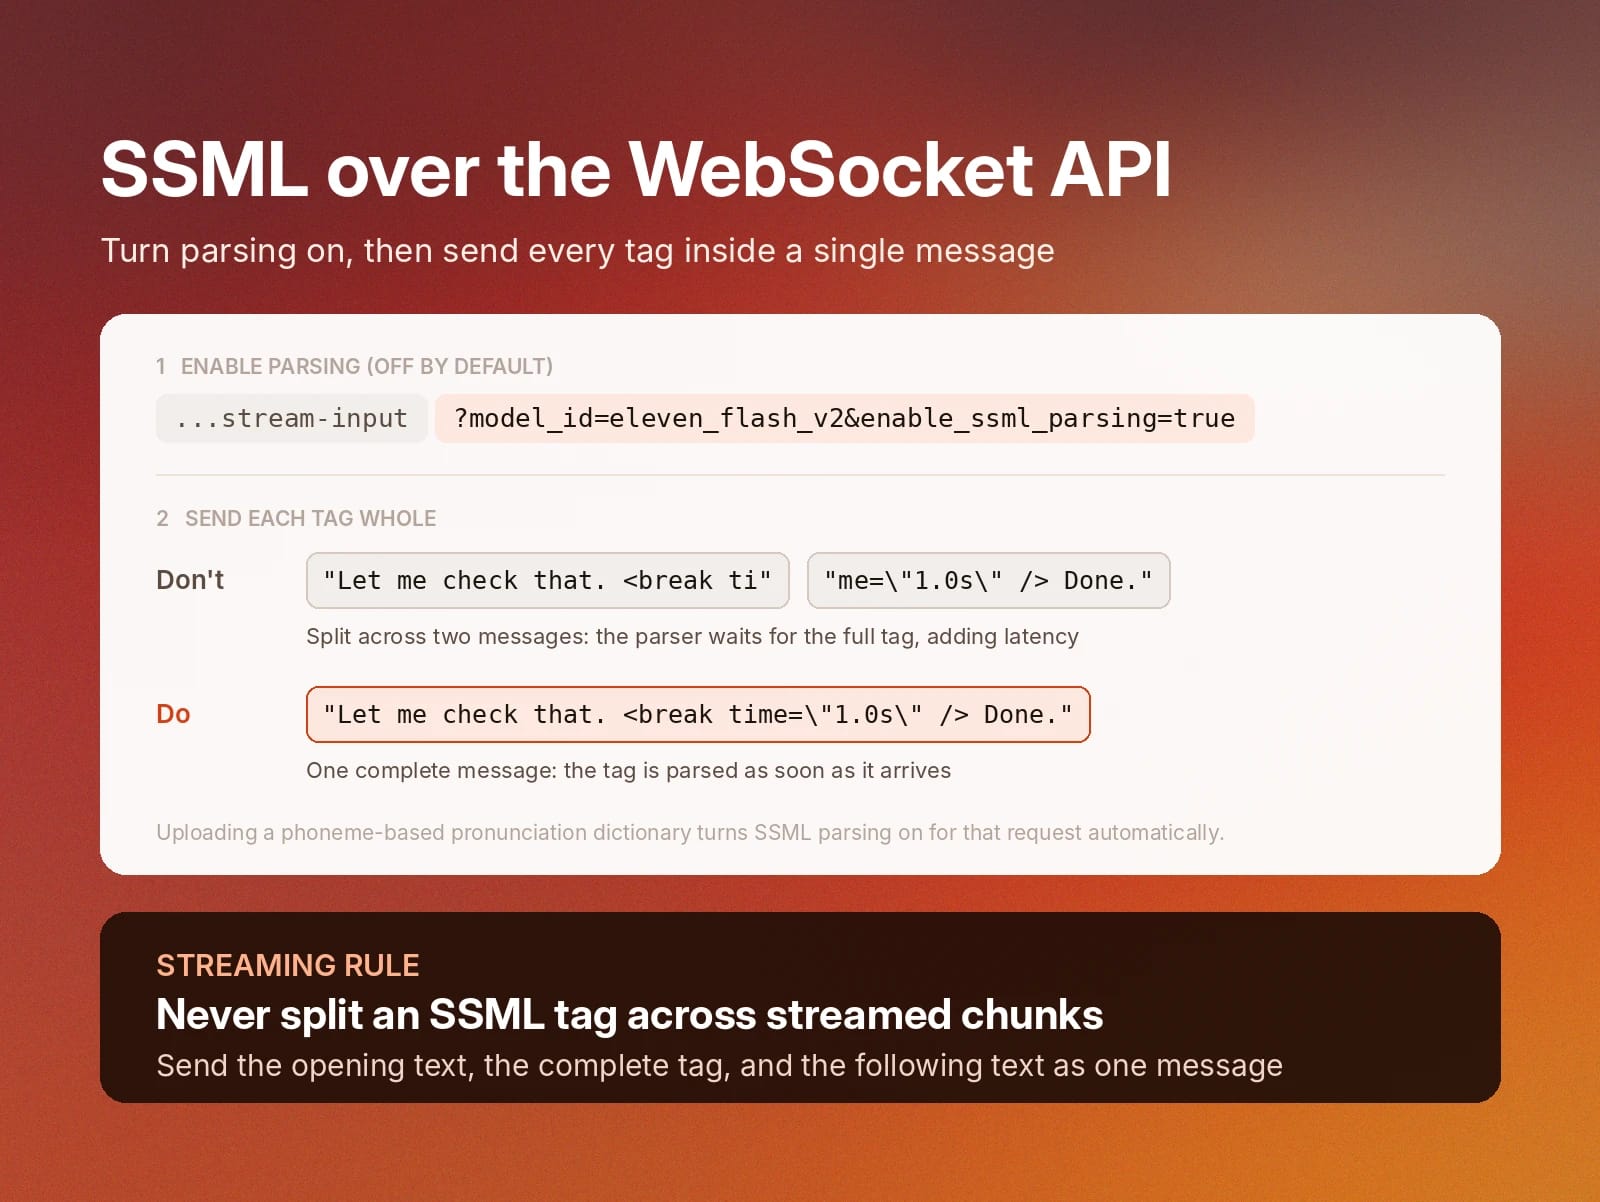
Lo streaming dell'audio tramite la WebSocket API di ElevenLabs anziché una richiesta HTTP standard richiede l'attivazione esplicita dell'analisi SSML. È disattivata per impostazione predefinita e può essere controllata con il parametro enable_ssml_parsing.
Per risultati ottimali, consigliamo di inviare ogni tag SSML come messaggio completo e autonomo, anziché suddividerlo in più chunk in streaming. Dividere un tag nel mezzo di un messaggio aumenta la latenza, perché il parser deve ricevere il tag completo prima di poter agire.
Caricare un dizionario di pronuncia basato su fonemi attiva automaticamente l'analisi SSML per la richiesta, anche quando il parametro enable_ssml_parsing non è stato impostato esplicitamente. Per tutti i dettagli sui parametri e sulla formattazione dei messaggi disponibili per la WebSocket API, consulta questa guida della documentazione su come generare audio in tempo reale.
L'esempio seguente attiva l'analisi SSML nell'URL di connessione e invia il tag break completo in un unico messaggio:
Tag SSML non supportati da ElevenLabs e cosa usare al loro posto
Con il passaggio al sistema Audio Tags, i modelli Text to Speech di ElevenLabs offrono agli utenti maggiore flessibilità e controllo granulare sugli output audio. Gli Audio Tags sono inoltre scritti interamente in linguaggio naturale, quindi è estremamente facile inserirli nei tuoi script.
Se lavori con un modello ElevenLabs precedente, può essere utile sapere quali tag SSML sono supportati. Grazie alle numerose alternative preferite, i modelli ElevenLabs meno recenti elaborano ora solo <break> e <phoneme>, mentre gli altri tag SSML sono coperti da altri metodi.
Altri tag SSML che potresti conoscere dalla specifica W3C non vengono letti come markup, quindi ciascuno richiede un approccio diverso. Ecco cosa usare al posto degli altri tag SSML in ElevenLabs:
Tag SSML
A cosa serve
Cosa usare invece
<prosody>
Imposta altezza, velocità del parlato e volume
Le impostazioni vocali di velocità e stabilità. Su Eleven v3 ed Eleven v4, Audio Tags per la resa vocale come [slowly] o [rushed]
<emphasis>
Enfatizza una parola o una frase
Maiuscole o punteggiatura per l'enfasi. Su Eleven v3 ed Eleven v4, tag come [shouts]
<say-as>
Controlla come vengono letti numeri, date e acronimi
Normalizzazione del testo, scrivere il valore in lettere o una regola del dizionario di pronuncia
<sub>
Sostituisce la forma pronunciata di una parola scritta
Una regola alias del dizionario di pronuncia
<lang>
Cambia la lingua di una frase
Un modello multilingue, con la frase scritta nella lingua di destinazione
<voice>
Cambia il parlante a metà script
Una generazione separata per voce o un dialogo con più parlanti su Eleven v3 ed Eleven v4
<audio>
Inserisce un file o un suono audio registrato
Audio Tags per effetti sonori su Eleven v3 e v4, lo strumento per effetti sonori di ElevenLabs o il mixing dell'audio dopo la generazione
Prosodia: altezza, velocità del parlato e volume con SSML
Il tag <prosody> di SSML regola altezza, velocità del parlato e volume per una porzione di testo. Sui modelli ElevenLabs precedenti, controlli il ritmo tramite l'impostazione vocale di velocità e l'espressività tramite l'impostazione di stabilità, entrambe applicate all'intera generazione anziché a una singola frase.
Per modificare il ritmo all'interno di uno script, dividi il testo in generazioni separate o aggiungi tag <break> tra le frasi. Su Eleven v3 e v4, usa gli Audio Tags nella tabella sopra, come [slowly], [rushed] e [whispers], inserendoli direttamente nella riga.
Pronuncia: <phoneme>, <say-as> e <sub> con SSML
ElevenLabs ti offre tre modi per controllare la pronuncia nei tuoi output TTS.
Ecco i metodi principali a cui puoi ricorrere:
- Usa <phoneme> per una correzione una tantum su Flash v2 o Turbo v2, come nell'esempio sopra.
- Usa un dizionario di pronuncia per i termini ricorrenti in molti script. Un dizionario può contenere regole fonemiche e regole alias che si comportano come <sub>, ad esempio mappando "UN" a "United Nations".
- Per ciò che gestisce <say-as>, come numeri, date, valute e numeri di telefono, affidati alla normalizzazione del testo, che converte i valori scritti in parole pronunciate. Quando un valore deve essere letto in un unico modo, come un numero di conferma, scrivilo in lettere o separa le cifre nello script.
Lingua e impostazioni locali
Il tag <lang> di SSML indica che una frase appartiene a un'altra lingua. I modelli TTS di ElevenLabs non leggono questo tag. Scegli invece un modello multilingue e scrivi la frase nella lingua in cui deve essere pronunciata.
Flash v2 e Turbo v2 sono solo in inglese, quindi gli script che combinano lingue richiedono un modello multilingue come Multilingual v2, Flash v2.5, Eleven v3 o Eleven v4. Eleven v4 e v3 supportano anche tag di accento come [French accent] e la trascrizione IPA in oltre 70 lingue.
Audio ed effetti sonori
Il tag <audio> di SSML riproduce una clip registrata all'interno di una risposta parlata. È un tag SSML non supportato da ElevenLabs, poiché i nostri modelli TTS possono generare nuovi effetti sonori dai tuoi prompt in linguaggio naturale.
Per aggiungere un suono al parlato stesso, scrivi semplicemente il tag dell'effetto sonoro, come [applause] o [door slamming], e guarda Eleven v4 ed Eleven v3 dargli vita. Per una progettazione sonora più lunga o dettagliata, genera l'effetto sonoro separatamente e mixalo con la traccia vocale nel tuo editor o workflow di produzione.
Best practice SSML con ElevenLabs
Se lavori con uno dei modelli TTS ElevenLabs meno recenti, i tag SSML sono ancora parzialmente supportati. Ricorda che puoi passare a Eleven v4 in qualsiasi momento per sfruttare appieno gli Audio Tags, senza più dover cercare la formulazione esatta di un tag SSML.
Quando lavori con SSML in ElevenLabs, ecco alcuni suggerimenti per iniziare:
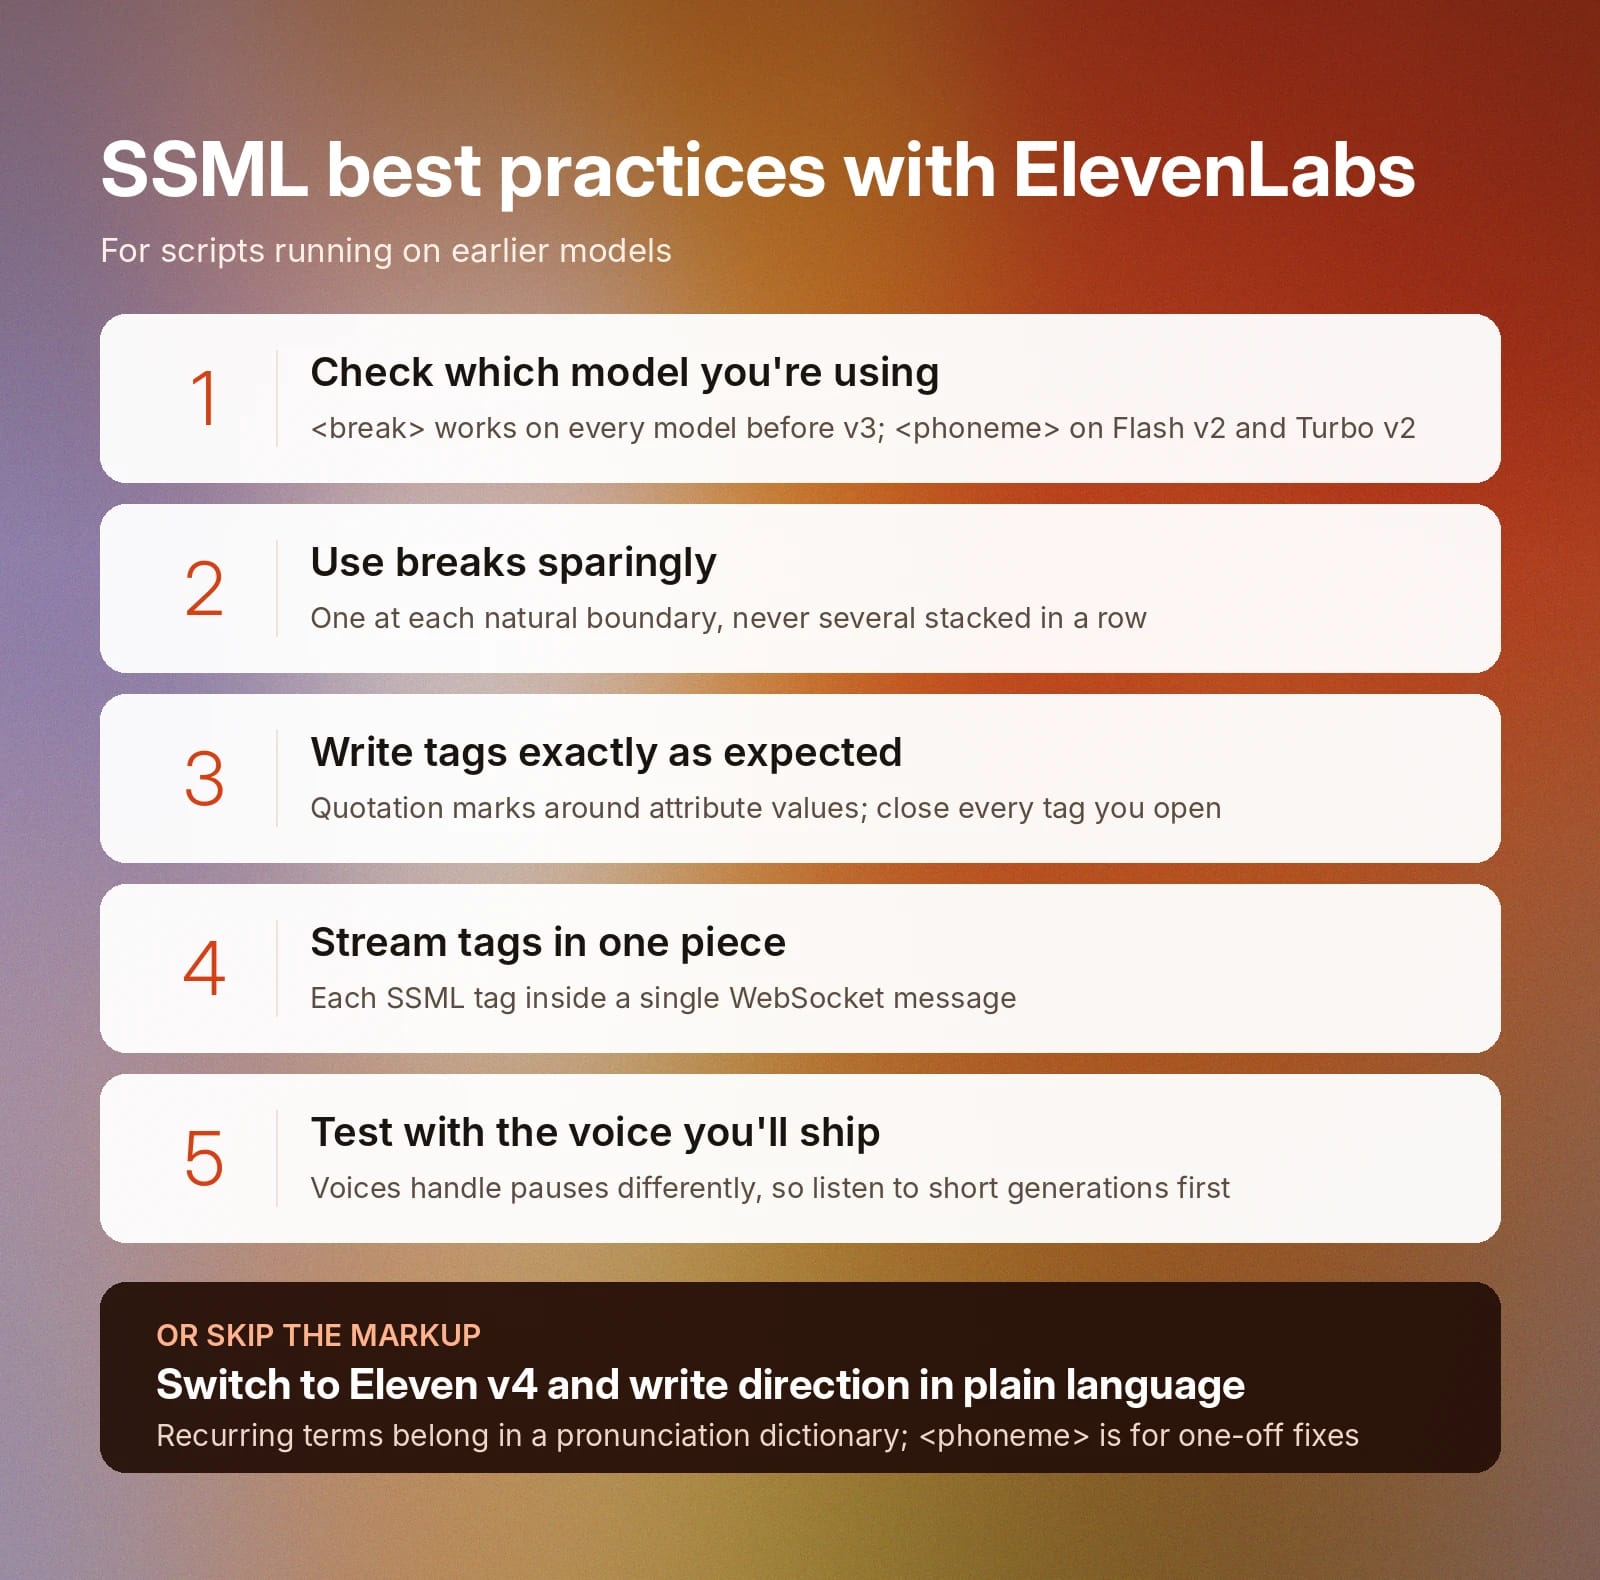
- Controlla quale modello stai usando: <break> funziona su tutti i modelli tranne Eleven v3, <phoneme> funziona solo su Flash v2 e Turbo v2, mentre gli Audio Tags funzionano solo sui modelli più recenti, come Eleven v4 ed Eleven v3.
- Usa le pause con moderazione: inseriscine una in ogni punto naturale, anziché accumularne diverse di seguito.
- Scrivi i tag SSML correttamente: mantieni le virgolette attorno ai valori degli attributi, ad esempio <break time="2.0s" />, e chiudi ogni tag che apri.
- Trasmetti i tag in un unico pezzo: invia ciascun tag SSML in un unico messaggio WebSocket.
- Testa con la voce che pubblicherai: le voci gestiscono le pause in modo diverso, quindi ascolta brevi generazioni prima di eseguire uno script completo. ElevenLabs offre oltre 17.500 voci nella nostra Voice Library.
Oltre a queste best practice per SSML, è consigliabile usare un dizionario di pronuncia per i termini che ricorrono spesso. Per correzioni una tantum, <phoneme> è l'opzione migliore.
Quali sono i principali casi d'uso di SSML?
Speech Synthesis Markup Language viene usato principalmente per controllare o perfezionare il modo in cui un motore TTS produce una clip audio. È uno strumento utile per inserire pause, perfezionare la pronuncia di una parola specifica e aggiungere un senso di prosodia al parlato generato dall'IA.
Ecco alcuni casi d'uso in cui lo standard SSML si rivela utile:
- Sistemi di risposta vocale interattiva (IVR): utili quando un sistema IVR deve fare una pausa tra un prompt e un menu o leggere chiaramente i numeri.
- Agenti conversazionali: aggiungere una breve pausa prima di una risposta affinché lo scambio suoni naturale.
- Audiolibri e narrazione di lunga durata: fare una pausa alla fine dei capitoli e tra le scene per segnalare chiaramente la conclusione di un momento e l'inizio del successivo.
- E-learning e formazione: correggere la pronuncia di nomi di prodotti, termini tecnici, acronimi e termini specifici dell'azienda.
- Notifiche e avvisi: controllare come vengono lette date, orari e codici di riferimento.
Sebbene SSML offra una serie di casi d'uso, puoi ottenere tutti questi risultati usando gli Audio Tags, senza dover memorizzare e inserire nei tuoi script tag SSML spesso complessi. Eleven v4 ed Eleven v3 hanno creato il sistema Audio Tag per offrire agli utenti il controllo completo sui propri output vocali generati dall'IA senza le complicazioni di SSML.
Perché Eleven v4 usa gli Audio Tags invece di SSML
Eleven v4 usa gli Audio Tags come meccanismo diverso per controllare la resa vocale e perfezionare la pronuncia. Legge istruzioni inline tra parentesi quadre provenienti direttamente dal testo dello script, consentendoti di scrivere in linguaggio naturale per creare un determinato output. Questi Audio Tags comprendono un'ampia gamma di istruzioni, tra cui:
- Emozioni o sentimenti, come [sad] o [excited]
- Resa vocale e ritmo, come [whispers] o [rushed]
- Reazioni umane, come [sighs] o [laughs]
- Accenti e voci di personaggi, come [French accent]
- Effetti sonori, inclusi [applause] o [door shutting]
Il motivo di questa progettazione dipende dal modo in cui il modello legge il contesto in una conversazione. L'architettura di Eleven v4 legge il contesto più in profondità rispetto ai modelli precedenti, consentendogli di seguire segnali emotivi, cambiamenti di tono, transizioni tra parlanti e indizi contestuali senza parametri o impostazioni separati.
SSML fornisce istruzioni specifiche in un punto fisso del testo, facendo apparire la resa vocale rigida e frammentata. SSML è una delle ragioni principali per cui il testo IA suona robotico, nonostante l'alta qualità dei modelli sottostanti.
Un'indicazione come [whisper] offre a Eleven v4 una direzione interpretativa che viene applicata all'intera riga circostante, modellata dalla prosodia di tutto ciò che la circonda.
La maggior parte degli elementi SSML ha un equivalente diretto in v4:
Tag SSML
A cosa serve
Equivalenti in Eleven v4
<break time="1s">
Inserisce una pausa
[pause], puntini di sospensione o un'interruzione di riga
<prosody rate="slow">
Rallenta il parlato
[drawn out] o [slowly]
<prosody rate="fast">
Accelera il parlato
[rushed]
<emphasis>
Enfatizza una parola specifica
[shouts] o scrivere una parola in maiuscolo
<prosody pitch="high">
Alza il tono
Tag emotivi come [excited]
<prosody pitch="low">
Abbassa il tono
Tag emotivi come [sorrowful]
La pronuncia segue lo stesso schema di sostituzione. IPA è incluso come supporto nativo per Eleven v4, con trascrizione in oltre 90 lingue. Questo consente ai team di controllare la pronuncia senza i tag XML richiesti, aggiungendo direttamente nel testo la trascrizione tra barre oblique.
Inizia a creare parlato naturale con ElevenCreative
Gli Audio Tags aggiungono agli script le pause, l'emozione, il ritmo e lo stile vocale che un doppiatore leggerebbe direttamente dal testo. Eleven v4 porta questa espressività in un workflow di produzione completo, abbinando i modelli vocali ElevenLabs a modelli di immagini e video, così uno script diventa un contenuto audio o video finito in un unico workspace.
Scopri come gli Audio Tags diventano audio finito con Eleven v4 oppure crea un account gratuito per sperimentare oggi SSML e Audio Tags sui tuoi script.
Domande frequenti

Jack Limebear fa parte del team Growth e si occupa di scrivere contenuti e definire strategie per il blog e le pagine insights. Prima di arrivare in ElevenLabs, ha guidato la strategia dei contenuti per oltre dieci anni in realtà che vanno da startup SaaS in rapida crescita a grandi aziende Fortune 500. Ha conseguito un Master in Letteratura Inglese presso l’Università di Cambridge.



