

Genera audio in tempo reale
Lo streaming WebSocket è un metodo per inviare e ricevere dati tramite un’unica connessione persistente. È utile per le applicazioni in tempo reale in cui devi trasmettere dati audio non appena diventano disponibili.
Se vuoi testare rapidamente la latenza (time to first byte) di una connessione WebSocket all’API Text to Speech di ElevenLabs, puoi installare elevenlabs-latency tramite npm e seguire le istruzioni qui.
I WebSocket sono disponibili per Text to Speech e la piattaforma Agents. Questa guida tratta il WebSocket Text
to Speech (/v1/text-to-speech/{voice_id}/stream-input). Questo endpoint non supporta i modelli
eleven_v3 o eleven_v4. Per dialoghi con Eleven v3 o Eleven v4 tramite WebSocket, consulta
Text to Dialogue in tempo reale
e WebSocket Text to Speech e Text to Dialogue
a confronto.
Requisiti
- Un account ElevenLabs con una chiave API (ecco come trovare la tua chiave API).
- Python o Node.js (o un altro runtime JavaScript) installato sul tuo computer
Configurazione
Installa le dipendenze necessarie:
Poi, crea un file .env nella directory del progetto e aggiungi la tua chiave API:
Avvia la connessione WebSocket
Dopo aver scelto una voce dalla Voice Library e il modello Text to Speech che vuoi usare, avvia una connessione WebSocket all’API Text to Speech.
Invia il testo di input
Una volta aperta la connessione WebSocket, configura prima le impostazioni della voce. Poi invia il messaggio di testo all’API.
Salva l’audio in un file
Leggi il messaggio in arrivo dalla connessione WebSocket e scrivi i chunk audio in un file locale.
Esegui lo script
Puoi eseguire lo script con il seguente comando nel terminale. Un file audio mp3 verrà salvato nella directory output.
Configurazione avanzata
L’uso dei WebSocket include alcune impostazioni avanzate che puoi usare per ottimizzare la generazione audio in tempo reale.
Buffering
Quando generi audio in tempo reale, devi considerare due concetti importanti: Time To First Byte (TTFB) e buffering. Per produrre audio di alta qualità e dedurre il contesto, il modello richiede una certa soglia di testo di input. Più testo viene inviato tramite una connessione WebSocket, migliore sarà la qualità dell’audio. Se la soglia non viene raggiunta, il modello aggiunge il testo a un buffer e genera l’audio quando il buffer è pieno.
In termini di latenza, il TTFB è il tempo necessario per inviare il primo byte di audio al client. È importante perché influisce sulla latenza percepita dell’audio. Potresti quindi voler controllare la dimensione del buffer per bilanciare qualità e latenza.
Per gestirlo, puoi usare il parametro chunk_length_schedule quando inizializzi la connessione WebSocket o quando invii il testo. Questo parametro è un array di interi che rappresentano il numero di caratteri inviati al modello prima di generare l’audio. Ad esempio, se imposti chunk_length_schedule su [120, 160, 250, 290], il modello genererà audio dopo l’invio rispettivamente di 120, 160, 250 e 290 caratteri.
Ecco un esempio di come funziona con le impostazioni predefinite di chunk_length_schedule:
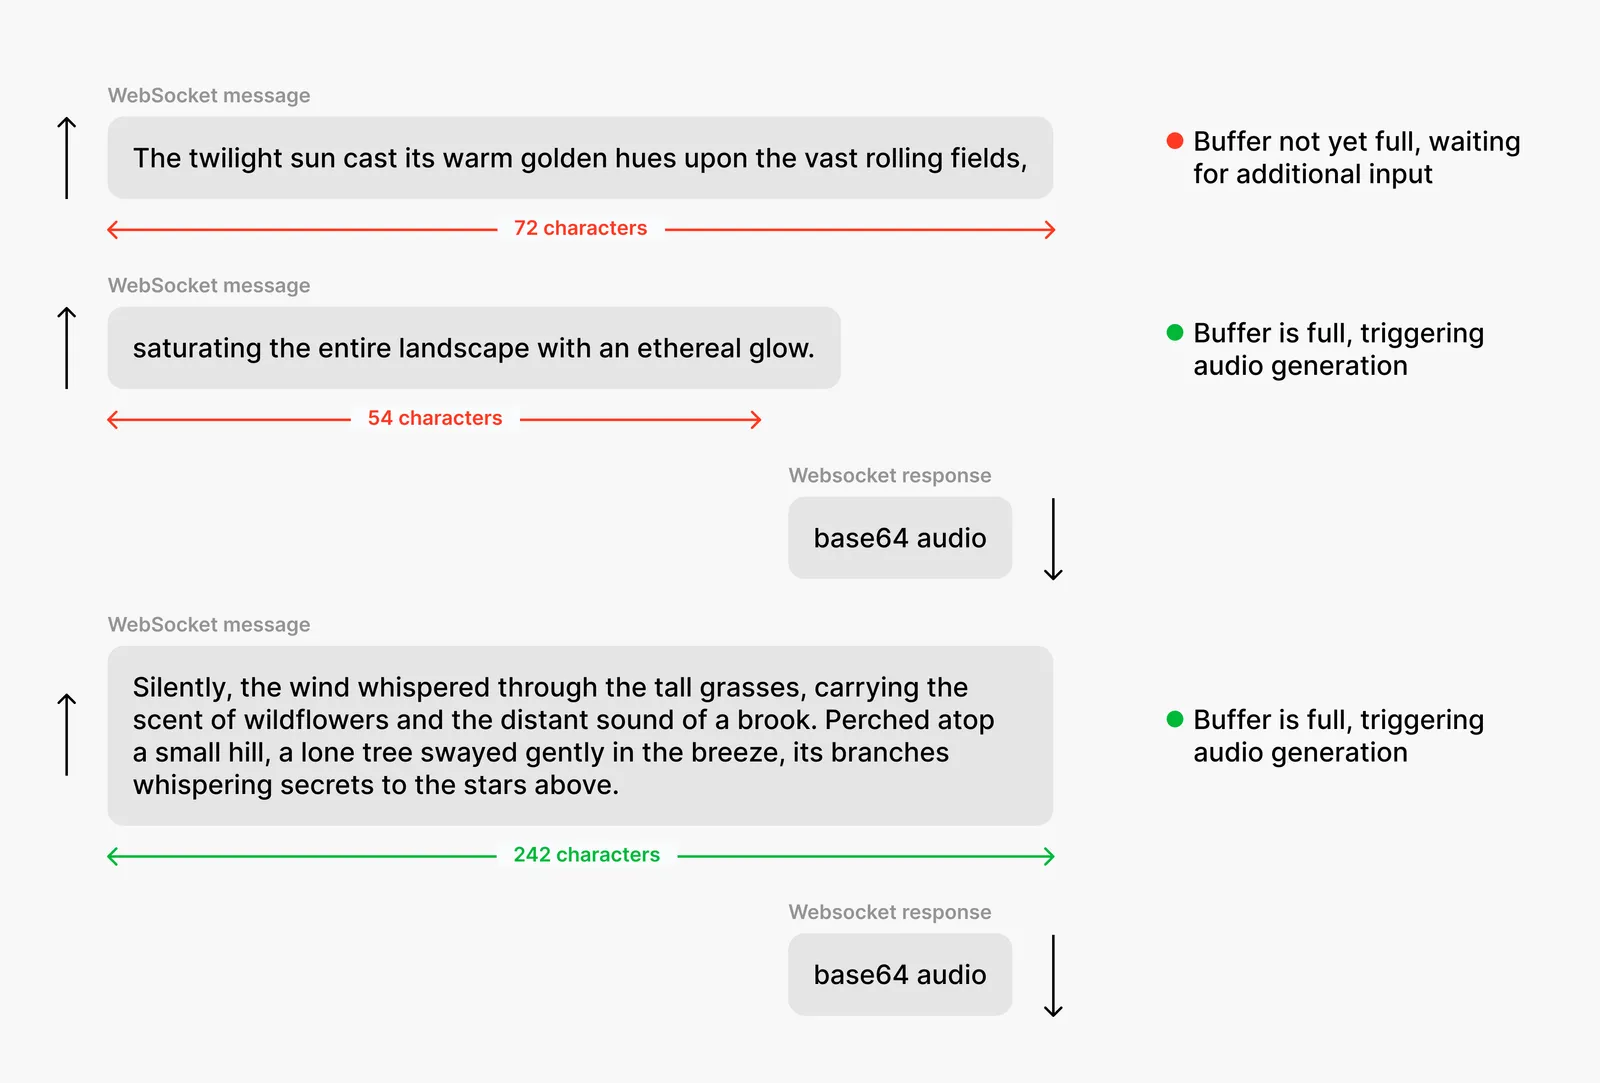
Nel diagramma qui sopra, l’audio viene generato solo dopo l’invio del secondo messaggio al server. Questo perché il primo messaggio è sotto la soglia di 120 caratteri, mentre il secondo porta il numero totale di caratteri oltre la soglia. Il terzo messaggio supera la soglia di 160 caratteri, quindi l’audio viene generato immediatamente e restituito al client.
Puoi specificare un valore personalizzato per chunk_length_schedule quando inizializzi la connessione WebSocket o quando invii il testo.
Se vuoi forzare la restituzione immediata dell’audio, puoi usare flush: true per svuotare il buffer e forzare la generazione del testo memorizzato nel buffer. Questo può essere utile, ad esempio, quando hai raggiunto la fine di un documento e vuoi generare l’audio per la sezione finale.
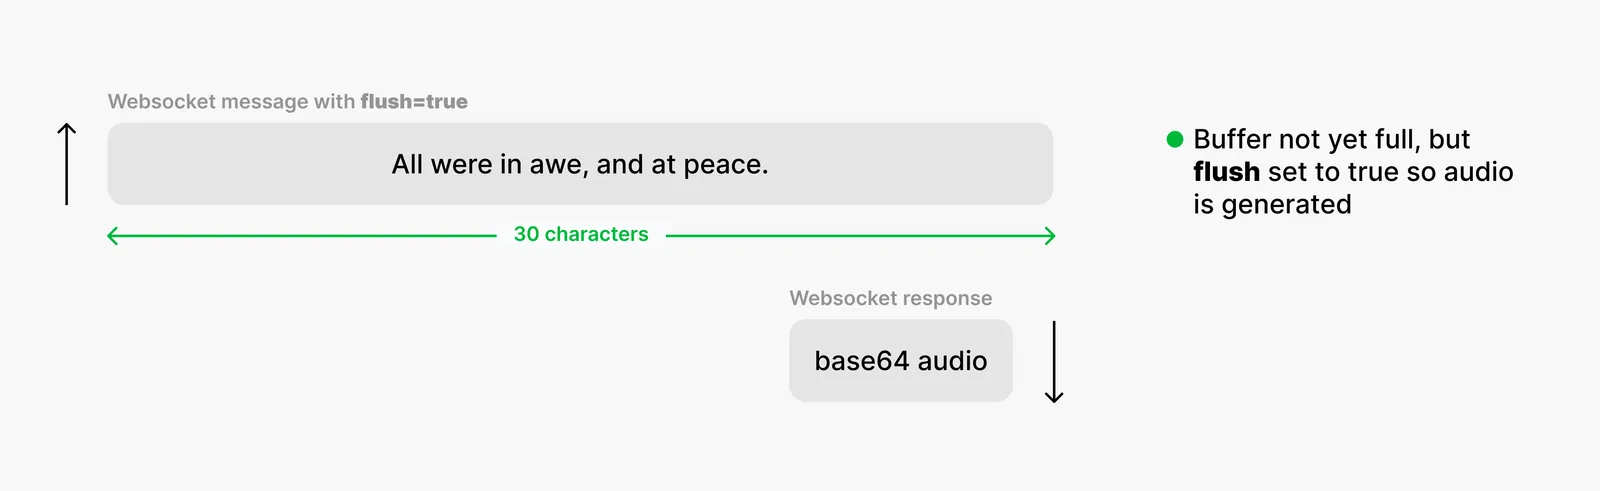
Puoi specificarlo per ogni messaggio impostando flush: true nel messaggio.
Inoltre, chiudendo il WebSocket verrà automaticamente forzata la generazione del testo nel buffer.
Impostazioni della voce
Quando inizializzi le connessioni WebSocket, puoi specificare le impostazioni della voce per le generazioni successive. Ciò ti consente di controllare la velocità, la stabilità e altre caratteristiche vocali dell’audio generato.
Puoi sostituirle per ogni messaggio specificando voice_settings diversi nel messaggio.
Dizionari di pronuncia
Puoi usare i dizionari di pronuncia per controllare la pronuncia di parole o frasi specifiche. Questo può essere utile per assicurarti che determinate parole siano pronunciate correttamente o per aggiungere enfasi a parole o frasi specifiche.
A differenza di voice_settings e generation_config, i dizionari di pronuncia devono essere specificati nel messaggio “Initialize Connection”. Per maggiori informazioni, consulta il Riferimento API.
Quando usi dizionari di pronuncia basati su fonemi con i WebSocket, devi aggiungere enable_ssml_parsing=true come parametro query all’URI del WebSocket. Ad esempio:
Buone pratiche
- Ti consigliamo di usare l’impostazione predefinita per
chunk_length_scheduleingeneration_config. - Quando sviluppi un’applicazione di agente conversazionale in tempo reale, ti consigliamo di usare
flush: trueinsieme al testo alla fine del turno di conversazione per garantire una generazione audio tempestiva. - Se l’impostazione predefinita non offre una latenza ottimale per il tuo caso d’uso, puoi modificare
chunk_length_schedule. Tieni però presente che ridurre la latenza con questa modifica può compromettere la qualità.
Suggerimenti
- La connessione WebSocket si chiude automaticamente dopo 20 secondi di inattività. Per tenerla aperta, puoi inviare un singolo carattere spazio
" ". Tieni presente che questa stringa deve includere uno spazio, poiché l’invio di una stringa completamente vuota,"", chiuderà il WebSocket. - Invia una stringa vuota per chiudere la connessione WebSocket dopo aver inviato l’ultimo messaggio di testo.
- Puoi usare
alignmentper ottenere i timestamp a livello di parola per ogni parola nel testo. Può essere utile per allineare l’audio al testo in un video o per altre applicazioni che richiedono una temporizzazione precisa. Per maggiori informazioni, consulta il Riferimento API.