Come fa la trascrizione a sapere quando viene pronunciata ogni parola
- Scritto da
- Mike Murphy
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
Se ti è mai capitato di guardare un film in TV con problemi di trasmissione, in cui i dialoghi degli attori sono completamente fuori sincrono con i sottotitoli, sai quanto possa essere fastidioso e quanto possa farti uscire dalla storia. Video e software che usano modelli vocali hanno lo stesso problema: un sottotitolo che appare con un secondo di ritardo o una trascrizione che evidenzia la parola sbagliata possono sembrare altrettanto difettosi.
«Gli esseri umani sono piuttosto bravi ad allineare i contenuti multimediali, almeno a livello di parola», afferma Danila Kozlov, ricercatore di ElevenLabs che si occupa di allineamento. «Spesso percepiamo intuitivamente dove inizia una parola, ma a livello di carattere e con precisione inferiore al millisecondo è molto più difficile».
Oggi ElevenLabs condivide maggiori dettagli su Cue, un modello di forced alignment che posiziona ogni carattere di un file audio su una timeline precisa. Cue è alla base della famiglia di modelli Scribe di ElevenLabs e, sulle registrazioni reali, è più accurato di tutti gli aligner testati da ElevenLabs, in tutte le 29 lingue del benchmark. Gestisce inoltre registrazioni di qualsiasi durata in un unico passaggio e allinea un'ora di audio in meno di un secondo.
Che cos'è il forced alignment?
Immagina che qualcuno ti consegni un video e una trascrizione e ti chieda di associare ogni parola al momento in cui viene pronunciata. Questo è il forced alignment. Quando fai clic su una parola in una trascrizione di ElevenLabs e il player salta a quel punto esatto, è un aligner a svolgere il lavoro.
Il forced alignment, però, è diverso dal concetto più nebuloso di AI alignment. Quest'ultimo riguarda la progettazione di sistemi di IA il cui comportamento sia in linea con i sistemi di valori e le preferenze aziendali delle persone. Con il forced alignment parliamo semplicemente di sincronizzare testo e audio.
Cue rappresenta l'ultima fase della pipeline speech-to-text. Scribe, il modello Speech to Text di ElevenLabs, trascrive l'audio, mentre l'aligner ne stabilisce la tempistica. Ogni richiesta a Scribe passa attraverso Cue. Lo stesso modello è alla base anche di sottotitoli, doppiaggio e sincronizzazione dei testi musicali, ed è disponibile separatamente tramite la Forced Alignment API.
Poiché molti prodotti dipendono da un aligner, deve essere preciso in ogni lingua supportata, estremamente veloce e in grado di gestire molte richieste contemporaneamente.
Dove gli aligner tradizionali non bastano
Prima del nuovo modello, il team aveva creato l'aligner usato fino ad allora in tutti i prodotti ElevenLabs. Per quanto fosse potente, sapevano di poter realizzare una versione migliore. Quando Kozlov è entrato nel team, lui e i suoi colleghi hanno iniziato intervistando clienti e utenti interni di ElevenLabs per capire cosa li frustrasse nell'uso dell'aligner precedente. Le loro lamentele coincidevano con i limiti degli strumenti open source testati dal team.
La durata è il primo grande problema. Oggi molti aligner funzionano bene con clip di circa 30 secondi, ma i file più lunghi devono essere suddivisi in segmenti. Ogni nuovo segmento può introdurre un piccolo errore di tempistica, e ricucire i punti di giunzione tra i segmenti può aggiungerne altri. Sulle registrazioni complete, l'errore medio di tempistica di Cue è di appena 179 millisecondi, mentre gli strumenti open source variavano da 283 ms a oltre 6.000 ms.
L'audio registrato nel mondo reale è ancora più impegnativo. Rumore di fondo, parlato sovrapposto e musica ambientale fanno perdere a molti strumenti il punto mentre associano il testo all'audio. Eppure sono proprio questi i tipi di file che molte persone vogliono trascrivere, dato che tendiamo tutti a vivere in luoghi non perfettamente silenziosi. Nelle registrazioni in inglese con problemi di fondo, l'errore medio di Cue è di 57 ms, rispetto ai 65-920 ms degli altri strumenti.
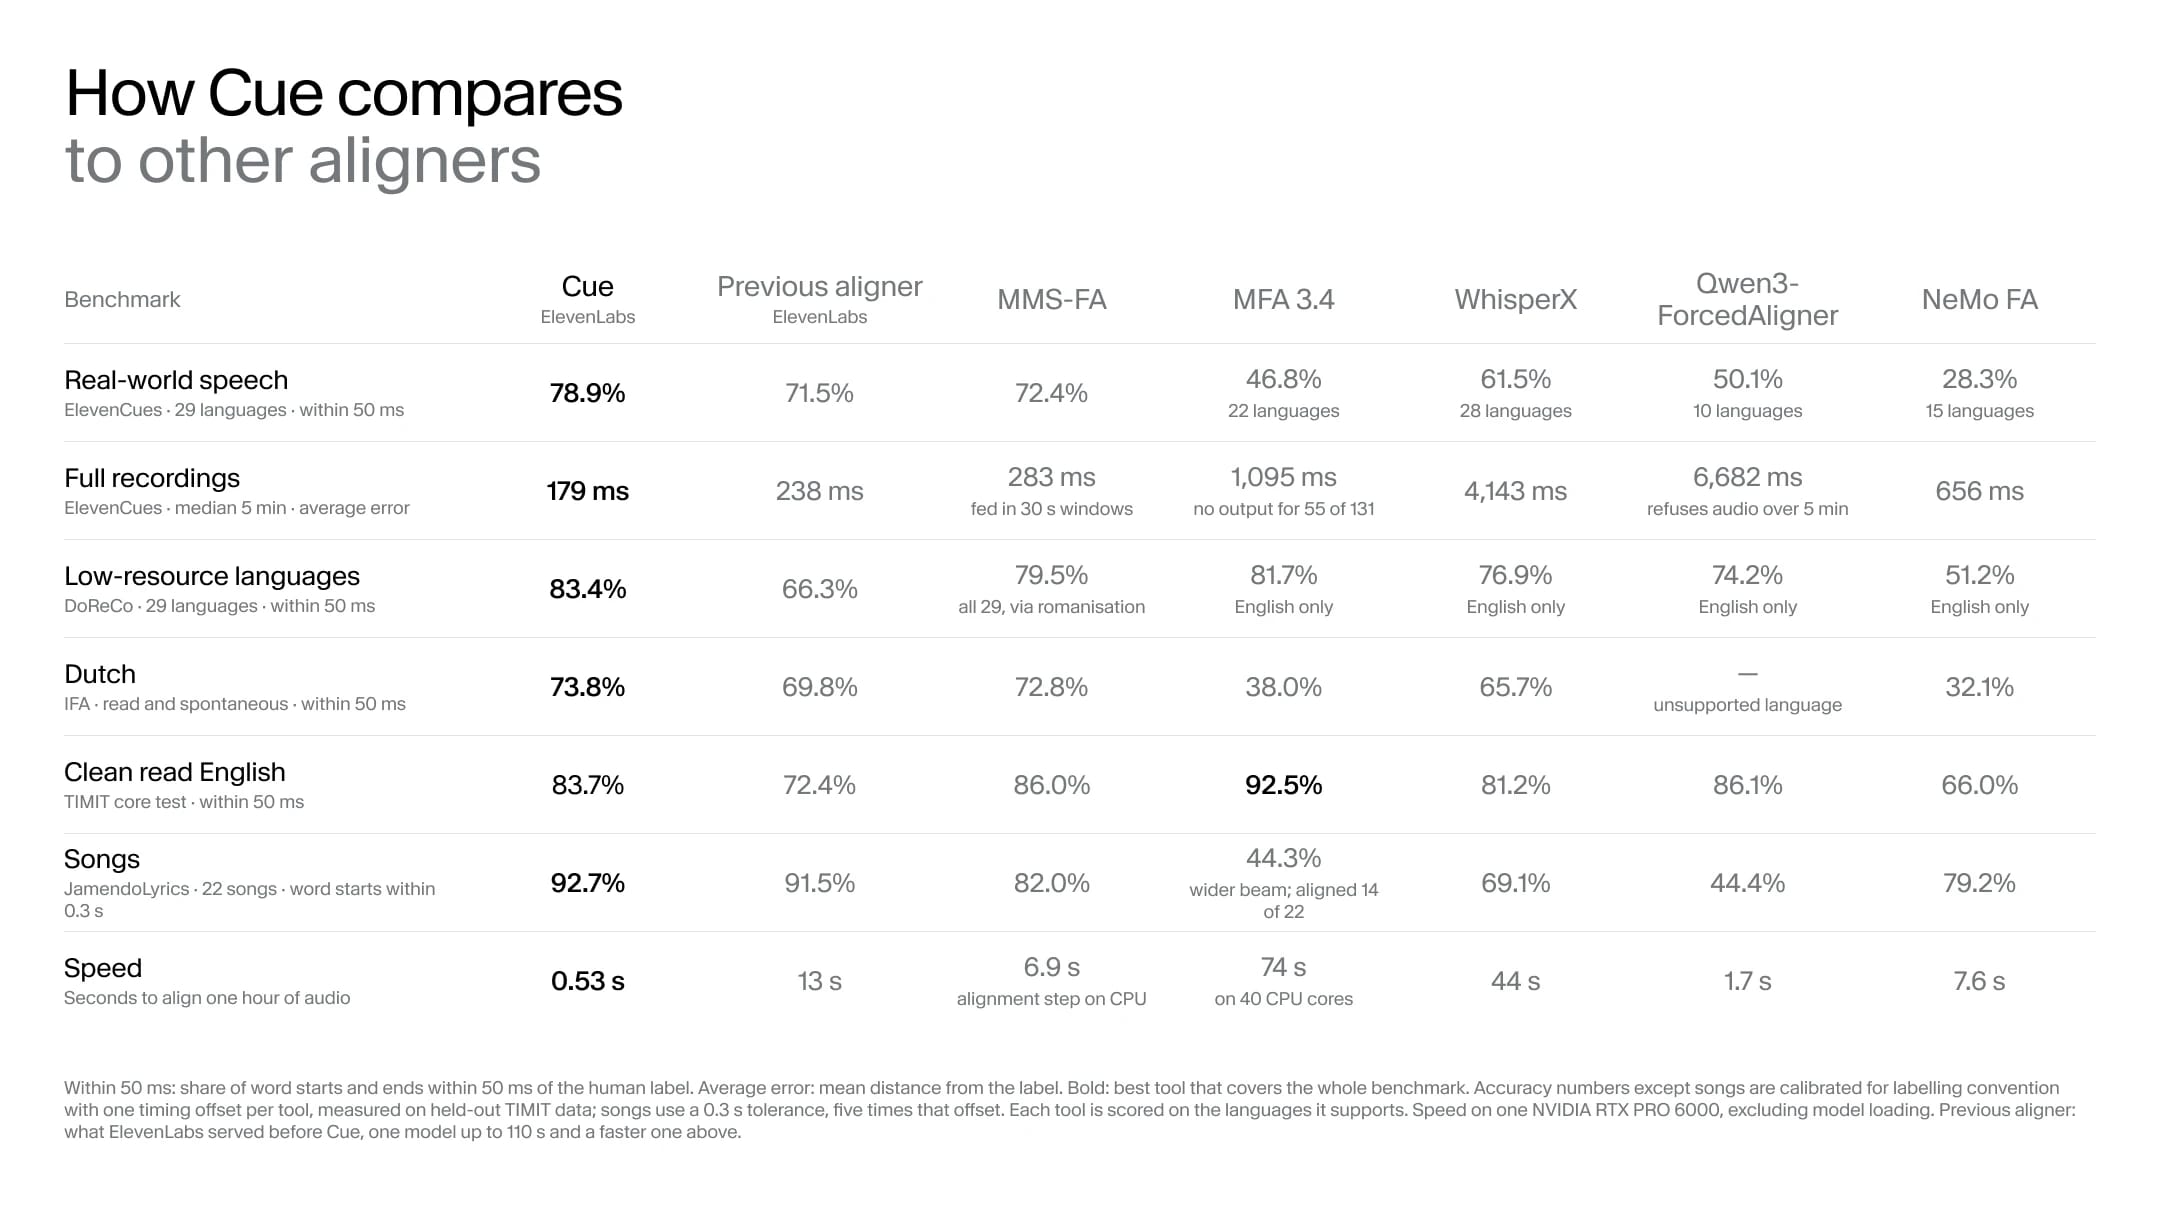
Il supporto linguistico è un altro vincolo. La maggior parte degli aligner open source richiede un modello separato per ogni lingua supportata, quindi le lingue con meno dati di addestramento spesso hanno prestazioni inferiori o non sono affatto supportate. MMS-FA è l'unico altro strumento che gestisce tutte le 29 lingue del benchmark e, in confronto, Cue è risultato generalmente più rapido nell'individuare i confini tra le parole.
Anche la velocità è un problema per questi modelli, perché allineare grandi volumi di audio può diventare rapidamente costoso. Cue può allineare un'ora di audio in circa mezzo secondo sulla nostra GPU di produzione. Lo strumento immediatamente successivo per velocità, Qwen3-ForcedAligner, impiega quasi 2 secondi, mentre il più lento tra quelli testati impiega ben oltre un minuto.
Cosa rende Cue diverso
A differenza della maggior parte dei concorrenti, Cue è un unico modello che copre più di 90 lingue del benchmark. Può inoltre elaborare registrazioni di qualsiasi durata in un unico passaggio, evitando la suddivisione in segmenti che fa accumulare errori di tempistica nei file lunghi.
Avvicina o scorri tenendo premuto Ctrl per ingrandire. Scorri orizzontalmente o tieni premuto Maiusc mentre scorri per spostarti. Quando una parola è selezionata, usa più e meno per ingrandire o Maiusc e la freccia sinistra o destra per spostarti.
Seleziona una parola per vederne i caratteri
Mentre la maggior parte dei modelli è diventata più grande con l'aumentare delle prestazioni, Cue è più piccolo del precedente aligner di ElevenLabs, afferma Kozlov. Funziona comunque su una GPU, ma allinea un'ora di audio in circa mezzo secondo.
Il team ha progettato Cue attorno ai tipi di audio che le persone caricano davvero. Usando l'aligner precedente come riferimento, ha creato un benchmark basato su richieste reali e valutato ogni strumento allo stesso modo, contando come errore ogni parola che uno strumento non riusciva a posizionare. Cue opera a livello di carattere, più granulare delle etichette a livello di parola usate dalla maggior parte dei benchmark, quindi questi punteggi probabilmente ne sottostimano la precisione.
«A un certo punto si raggiunge il livello delle capacità umane», dice Kozlov a proposito dei modelli di allineamento. «Il nostro aligner attuale va oltre quel livello, quindi diventa molto più difficile verificare se sia del tutto corretto o quanto sia preciso, perché non esiste un benchmark di riferimento. Abbiamo dovuto usare benchmark a livello di parola per valutare un sistema a livello di carattere, che non mostra necessariamente tutto il potenziale di Cue».
La qualità di Cue riflette anche la rapidità con cui ElevenLabs può agire sul feedback degli utenti. Poco dopo il rilascio di Cue, un cliente ha segnalato al team che il georgiano e un paio di altre lingue con meno risorse offrivano prestazioni inferiori alle aspettative. ElevenLabs mantiene la ricerca a stretto contatto con i team e i clienti che usano i suoi prodotti: questo ha permesso di individuare rapidamente il problema, svolgere ricerche su possibili miglioramenti del modello, addestrarne una nuova versione e rilasciarla, il tutto in meno di 24 ore da quando il cliente ha segnalato il problema per la prima volta.
Allineare le canzoni
La musica è difficile perché il canto allunga e sfuma le parole, e pochi modelli riescono a gestirlo bene. Il team non si aspettava che Cue fosse in grado di farlo così bene. Cue ha potuto allineare un sottoinsieme di brani del dataset JamendoLyrics MultiLang con licenza Creative Commons. È riuscito a farlo in inglese, francese, spagnolo e tedesco — in un unico passaggio — con una precisione sorprendente. Ha posizionato il 92,7% delle parole entro 0,3 secondi dall'etichetta, rispetto all'82,0% dello strumento immediatamente successivo.
L'errore medio di inizio di Cue era di 0,82 secondi, circa la metà di quello del concorrente più vicino. È stato più accurato di ogni altro strumento in almeno 19 delle 22 canzoni. Il potenziale di poter cantare al karaoke le tue nuove canzoni preferite il giorno stesso della loro uscita è enorme.
Prova Cue oggi
Cue è già alla base di ogni trascrizione Speech to Text su ElevenLabs. Per usarlo direttamente, prova la API di allineamento forzato.
Ringraziamenti
Il lavoro sui modelli di allineamento di ElevenLabs non sarebbe stato possibile senza molte persone in tutta l'azienda. Il team desidera ringraziare tutti coloro che hanno lavorato alla versione precedente e a quella nuova del modello, tra cui il cofondatore e CTO Piotr Dąbkowski, i ricercatori Danila Kozlov, Luca Lanzendörfer, Flavio Schneider, Max Levi, Tim von Känel e Angelos Perivolaropoulos; Ani Janelidze del team Data Operations, i nostri team Forward Deployed Engineer e Support; e Lorenzo Dossi per il suo lavoro sulla visualizzazione in questo blog.
Mike Murphy è il caporedattore e autore del blog di ElevenLabs, dove trasforma ricerche e tecnologie complesse in storie chiare e coinvolgenti. Prima di entrare in ElevenLabs, ha lavorato per anni come giornalista specializzato in tecnologia, anche per Quartz, e ha diretto i contenuti di IBM Research. Ha conseguito un master in giornalismo presso la Northwestern.