
Tutorial sul riconoscimento vocale in JavaScript: crea una UX vocale
- Scritto da
- Jack Limebear
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
Integrare il riconoscimento vocale in siti web e app basate su browser è ora più semplice, grazie alle API di Speech to Text (STT) native del browser, come la Web Speech API. Gli sviluppatori possono trasmettere facilmente l'input del microfono in streaming, analizzare dati audio ed elaborare trascrizioni effettuando chiamate API, senza dover creare un server locale per il riconoscimento vocale automatico.
La Web Speech API è una comune API di riconoscimento vocale per implementare comandi vocali in JavaScript. Espone metodi, argomenti e proprietà che consentono di eseguire trascrizioni in tempo reale in un browser web. Tuttavia, gli sviluppatori potrebbero trovare la Web Speech API limitante per client web complessi.
Questa guida spiega come configurare una semplice app web JavaScript per il riconoscimento vocale con la Web Speech API, illustrandone limiti e alternative per creare client di trascrizione in tempo reale più affidabili.
In sintesi
- La Web Speech API è un'API di Speech to Text nativa del browser che invia l'audio del microfono a un servizio cloud backend per l'elaborazione.
- Gli sviluppatori usano la classe API SpeechRecognition per creare applicazioni JavaScript con comandi vocali.
- Quando crei un'app di riconoscimento vocale, tieni conto della privacy degli utenti indicando che la registrazione audio è in corso.
- La Web Speech API presenta diverse limitazioni, tra cui incoerenze nella trascrizione, dipendenza dal browser e assenza di comprensione dell'intento.
- ElevenLabs offre API di Speech to Text estremamente accurate e adatte alla produzione, con supporto per lo streaming sia lato client sia lato server.
Come funziona la Web Speech API
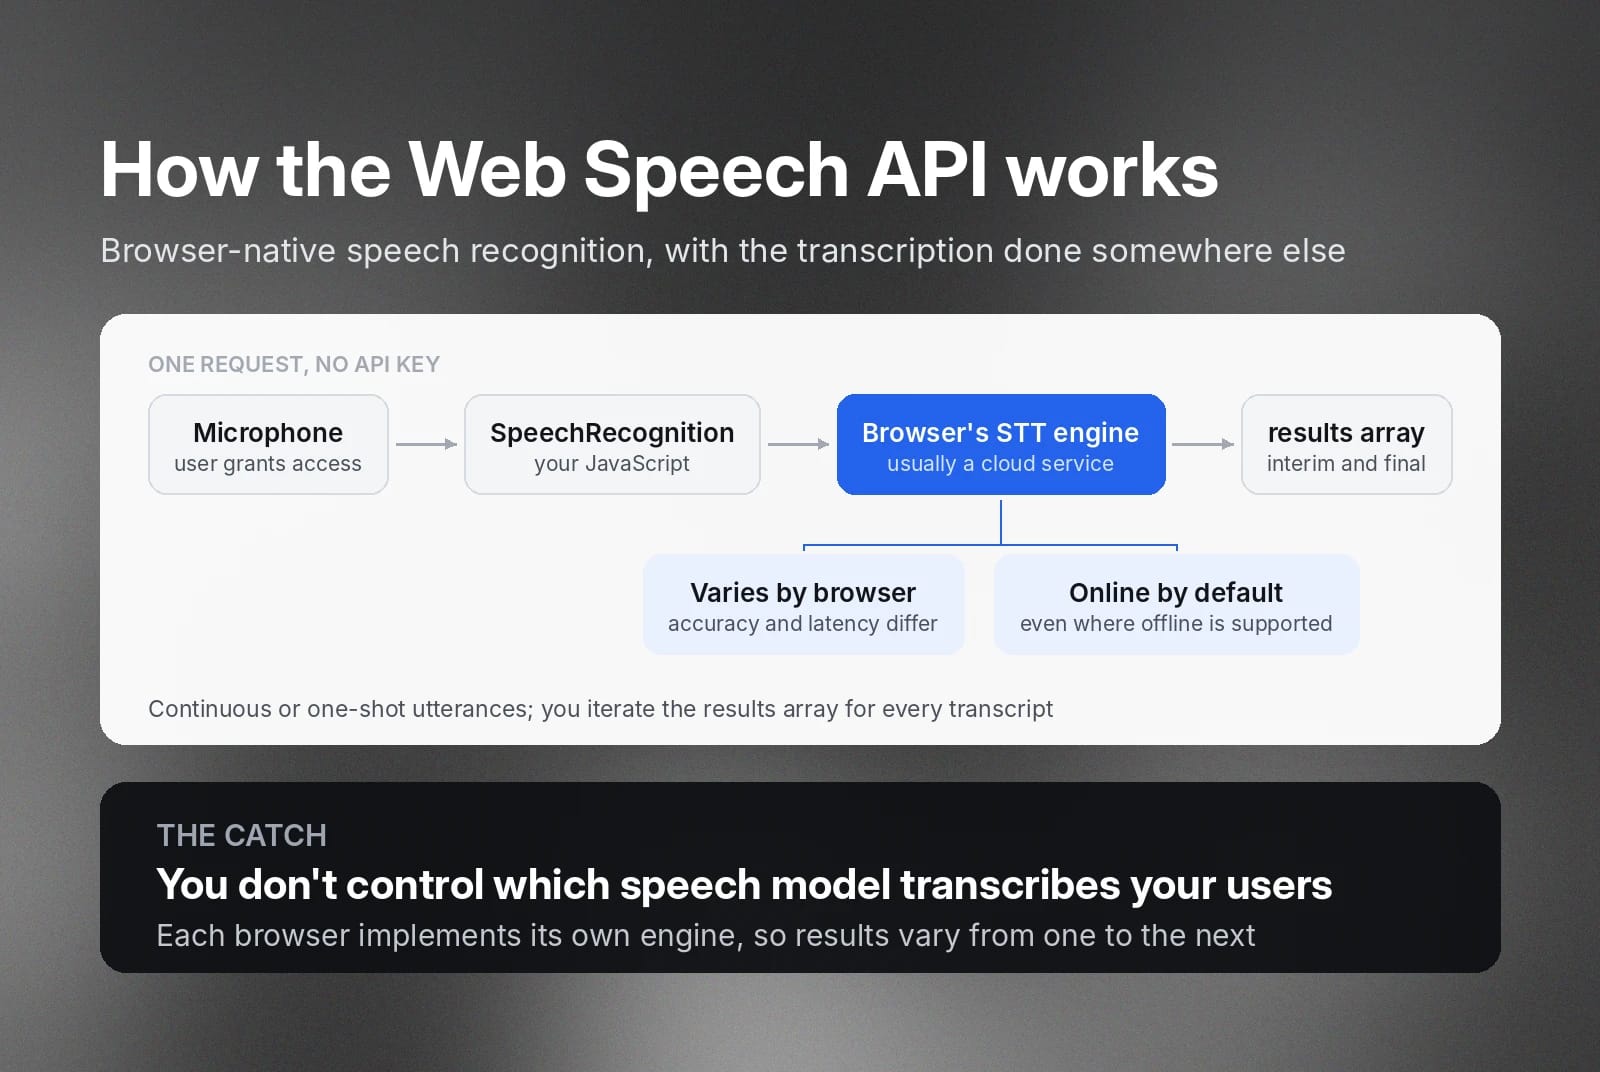
La Web Speech API offre agli sviluppatori web il riconoscimento vocale nativo del browser senza richiedere un server locale. In pratica, invia un flusso audio dal browser web a un servizio cloud backend per elaborarlo, analizzarlo e convertirlo in trascrizioni. Poiché si basa sul motore backend del browser per eseguire la trascrizione, i risultati variano a seconda del browser.
In genere, la Web Speech API richiede una connessione online attiva per trascrivere flussi audio, in particolare se sviluppi per Chrome e Safari. Tuttavia, alcuni browser ora supportano la trascrizione offline. Per la trascrizione offline, il browser agisce da motore di Speech to Text, identifica i fonemi e li trasforma in testo coerente.
Indipendentemente dal browser utilizzato, i principi fondamentali dell'API sono gli stessi.
- Non ti serve una chiave API per effettuare una richiesta API.
- La Web Speech API supporta enunciati continui o singoli.
- Restituisce trascrizioni sia provvisorie sia finali.
Tuttavia, poiché ogni browser può implementare il motore STT in modo diverso, accuratezza e latenza possono variare.
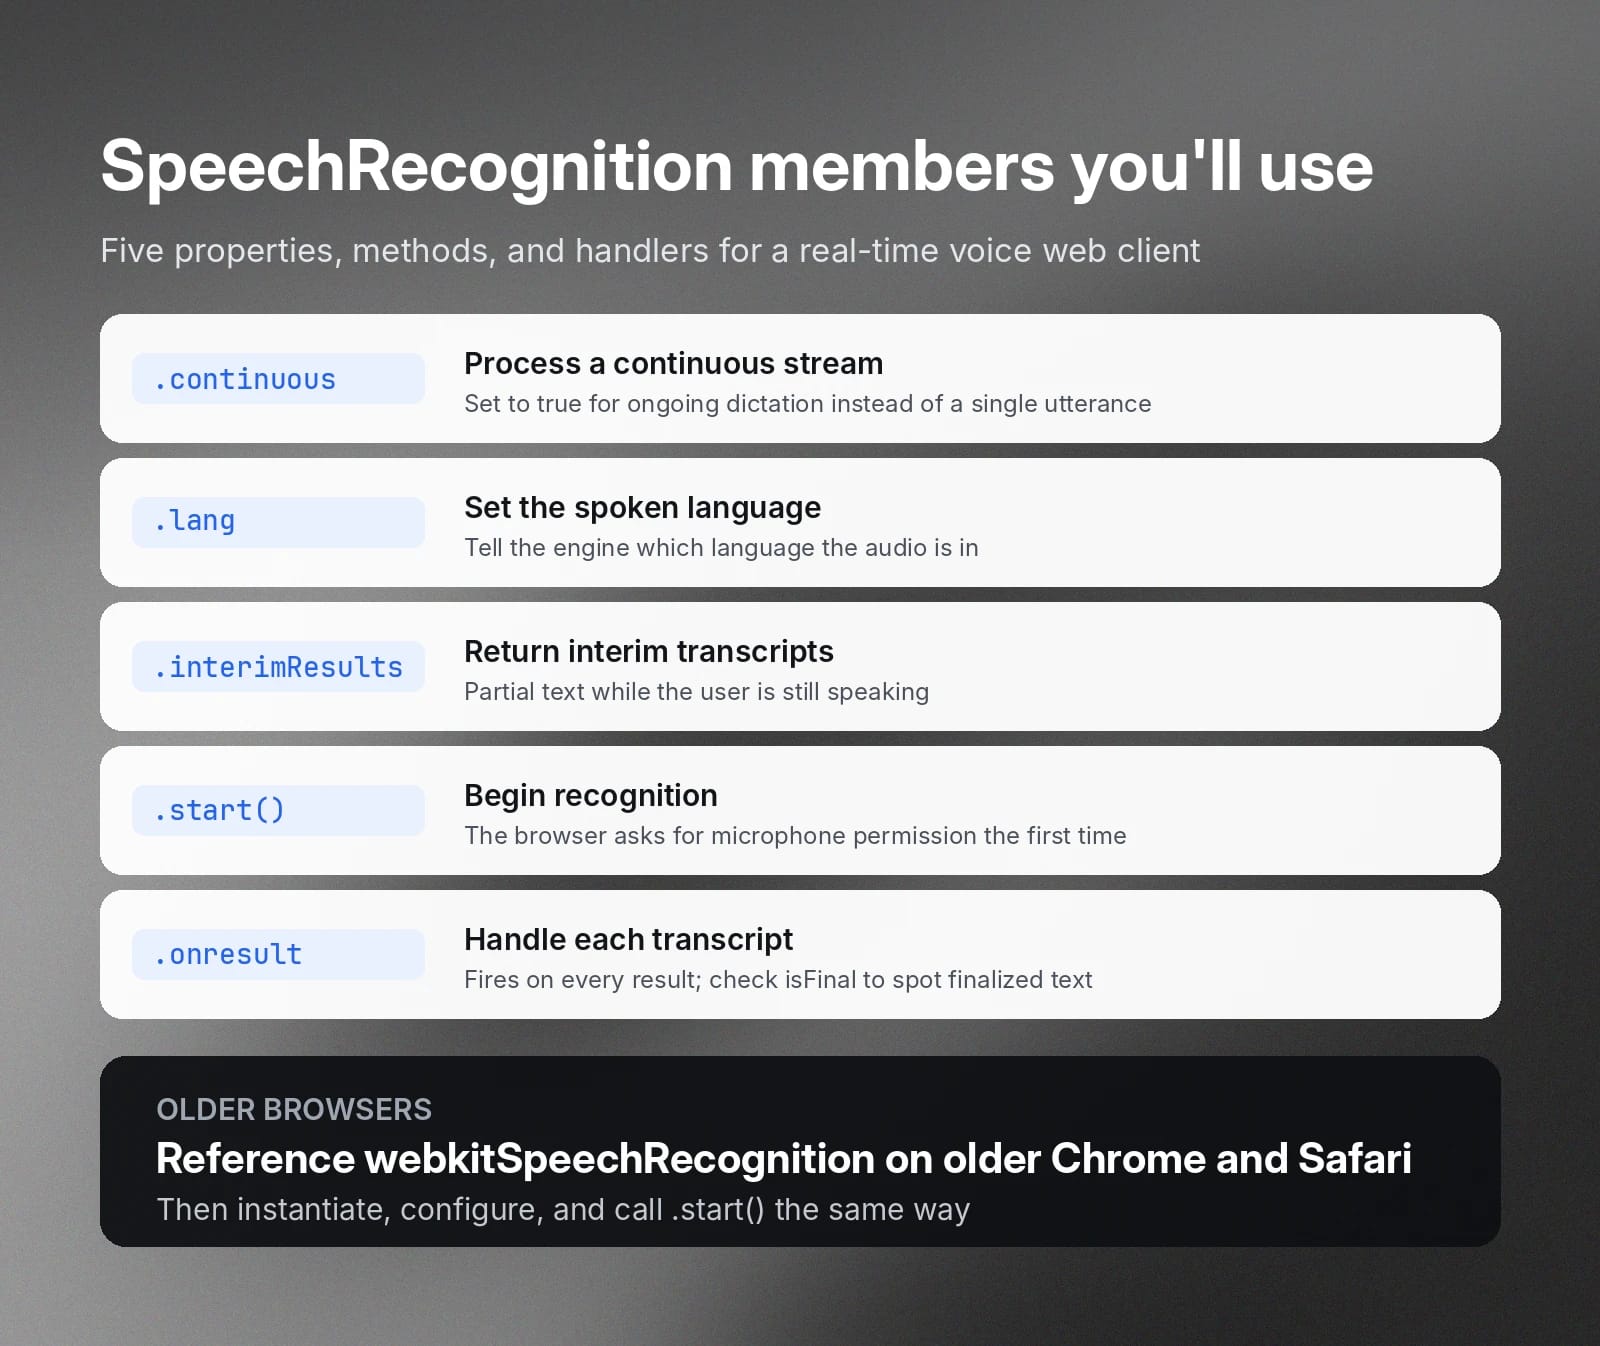
Per usare la Web Speech API, inizializza l'interfaccia SpeechRecognition nel codice JavaScript. Poi accedi a metodi, attributi ed event handler durante lo sviluppo. Ecco alcuni elementi che utilizzerai per creare un client web di ricerca vocale.
- SpeechRecognition.continuous: Consente al motore vocale di elaborare un flusso continuo quando è impostato su true.
- SpeechRecognition.lang: Imposta la lingua dell'audio.
- SpeechRecognition.interimResults: Indica al motore di restituire trascrizioni provvisorie.
- SpeechRecognition.start(): Avvia il processo di riconoscimento vocale.
- SpeechRecognition.onresult: Accetta un event handler, che l'API attiva al termine della trascrizione.
La Web Speech API restituisce la trascrizione in un array di stringhe. Quando il motore STT restituisce una trascrizione, provvisoria o finale, puoi trovarla nell'array results. Può restituire una o più stringhe. Devi quindi iterare tra le stringhe del risultato per recuperare tutto il testo trascritto.
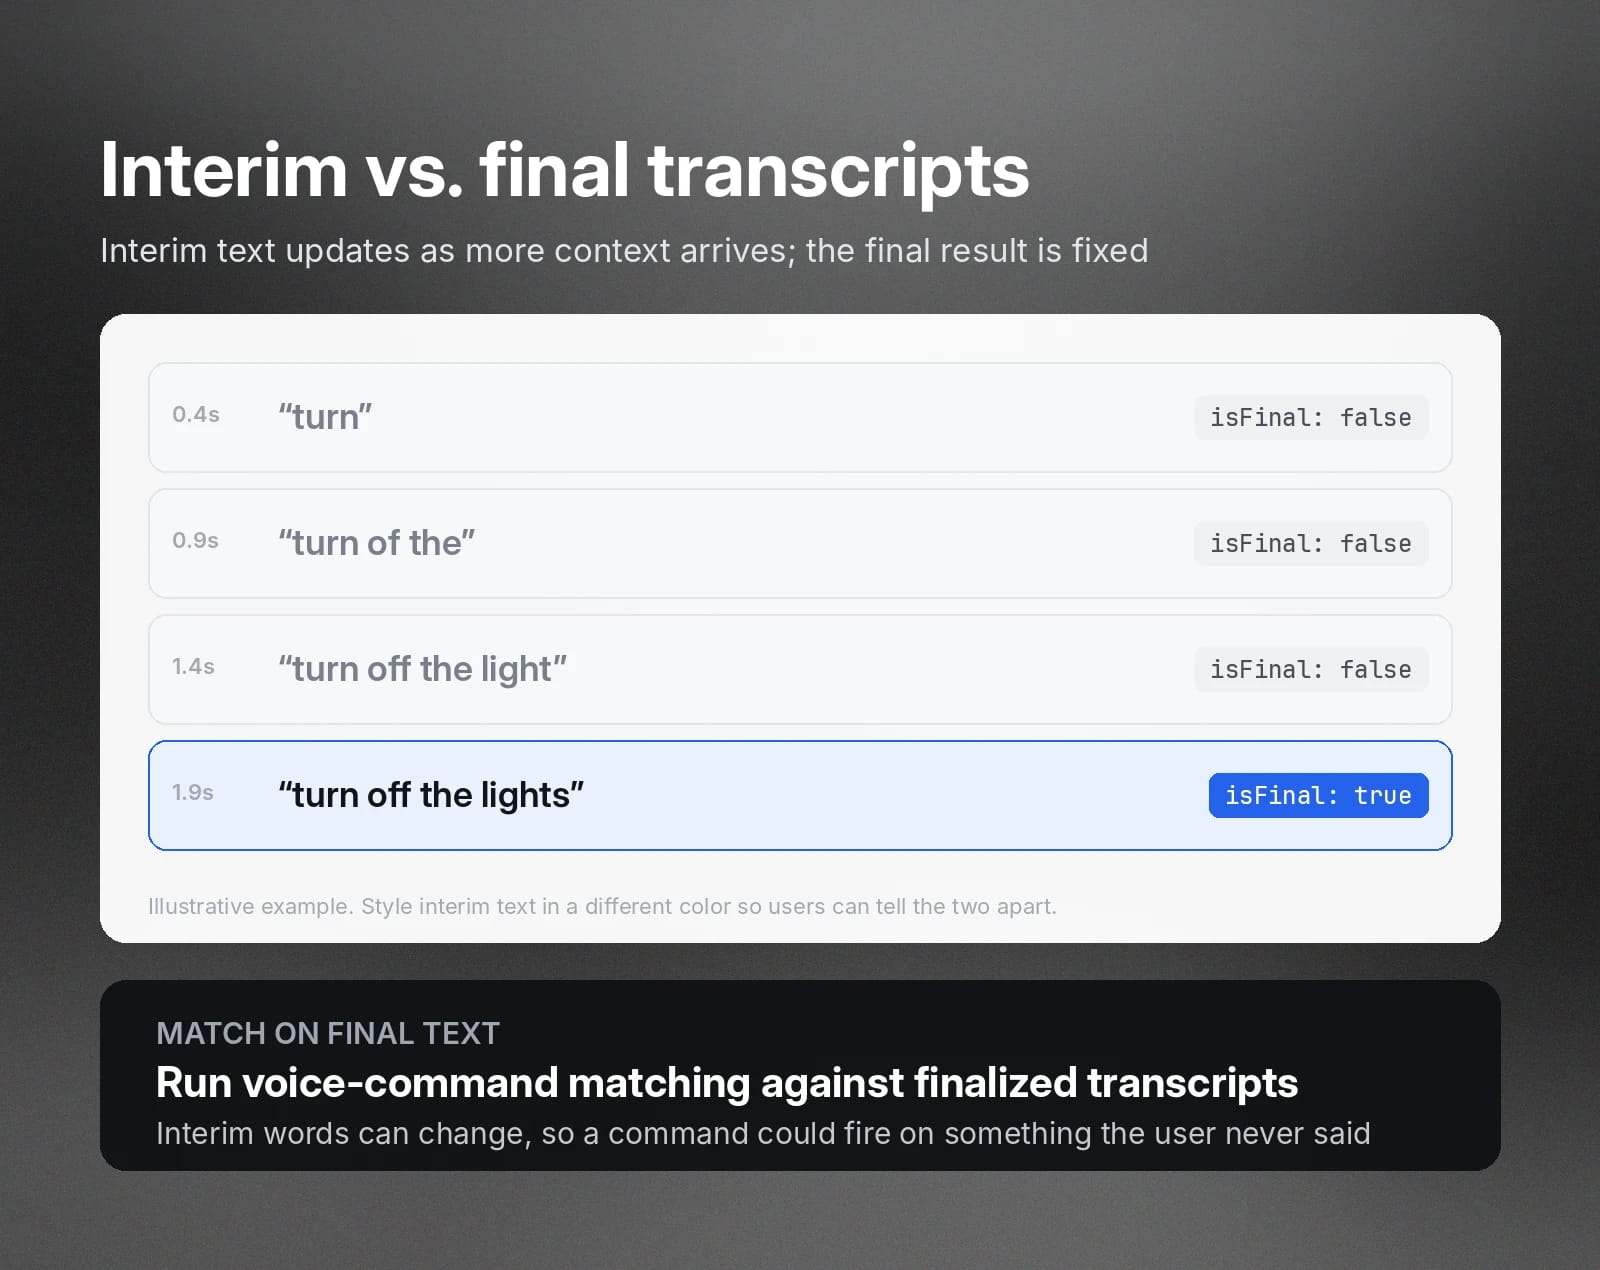
Nota: Se hai attivato la trascrizione provvisoria, controlla la proprietà isFinal per stabilire se il testo è una trascrizione finalizzata.
Crea un esempio di riconoscimento vocale in JavaScript
Questo esempio usa l'interfaccia JavaScript SpeechRecognition per creare un'app web di trascrizione in tempo reale. Lo screenshot seguente mostra la pagina completata.
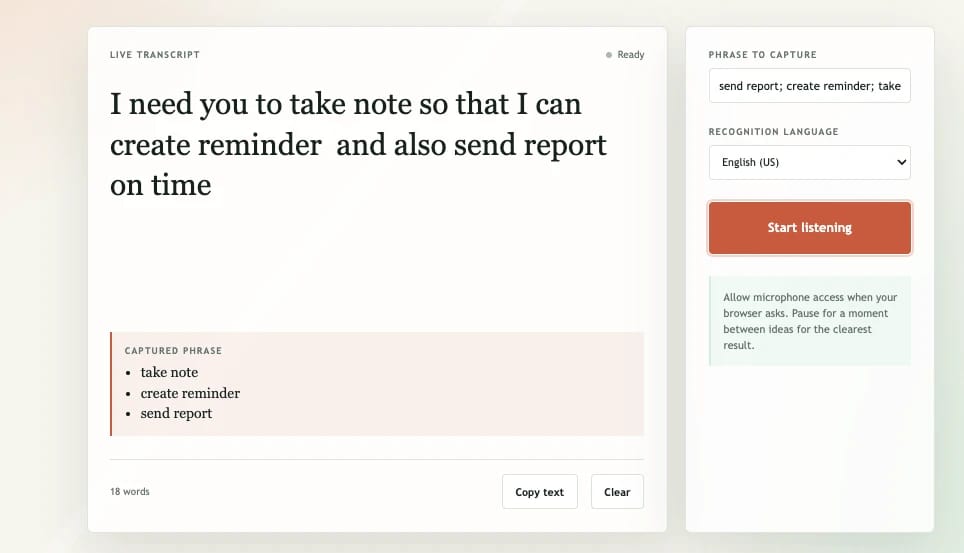
Nella pagina di esempio, un pulsante Avvia ascolto avvia la registrazione. Mentre l'utente parla, il browser invia l'audio al motore STT, attende la trascrizione e visualizza sia il testo provvisorio sia quello finale.
L'esempio include anche una funzionalità di comando vocale, che acquisisce termini specifici elencati dall'utente. Confronta la trascrizione con un elenco di frasi predefinito nel tuo codice, diversamente dal prompting di termini chiave in un'API di Speech to Text.
Gli snippet seguenti mostrano le parti principali di questo esempio.
Configura l'API SpeechRecognition e richiedi l'accesso al microfono
Per usarla nel tuo codice, devi prima istanziare la classe SpeechRecognition. Se usi una versione precedente di Chrome o Safari, fai riferimento a webkitSpeechRecognition.
Poi crea un'istanza di SpeechRecognition e configura la modalità di streaming, il supporto alla trascrizione provvisoria e la lingua parlata.
Puoi quindi avviare la trascrizione richiamando il metodo .start().
Quando avvii per la prima volta il processo di riconoscimento vocale, il browser chiederà l'autorizzazione all'utente. Per avviare la trascrizione, l'utente deve fare clic su Consenti. Altrimenti, l'API restituirà un valore "not-allowed” nell'handler SpeechRecognitionErrorEvent .
Visualizza trascrizioni in tempo reale e risultati finali
In questo esempio, visualizziamo la trascrizione mentre l'utente parla nel microfono. Per farlo, aggiungiamo una funzione all'evento onresult.
Le trascrizioni provvisorie non sono definitive. Perciò, il testo visualizzato potrebbe non corrispondere esattamente alle parole pronunciate. Quando il motore STT riceve più contesto dalle parole successive, corregge la trascrizione e la restituisce nella stringa.
Puoi anche applicare al testo provvisorio uno stile di colore diverso, così da distinguerlo dalla trascrizione finale. Questo CSS lo fa:
Aggiungi comandi vocali in JavaScript
Aggiungi una casella di testo in cui gli utenti inseriscono le frasi da rilevare, separate da punto e virgola. In alternativa, puoi salvare le frasi in un file JSON e caricarle nel tuo codice.
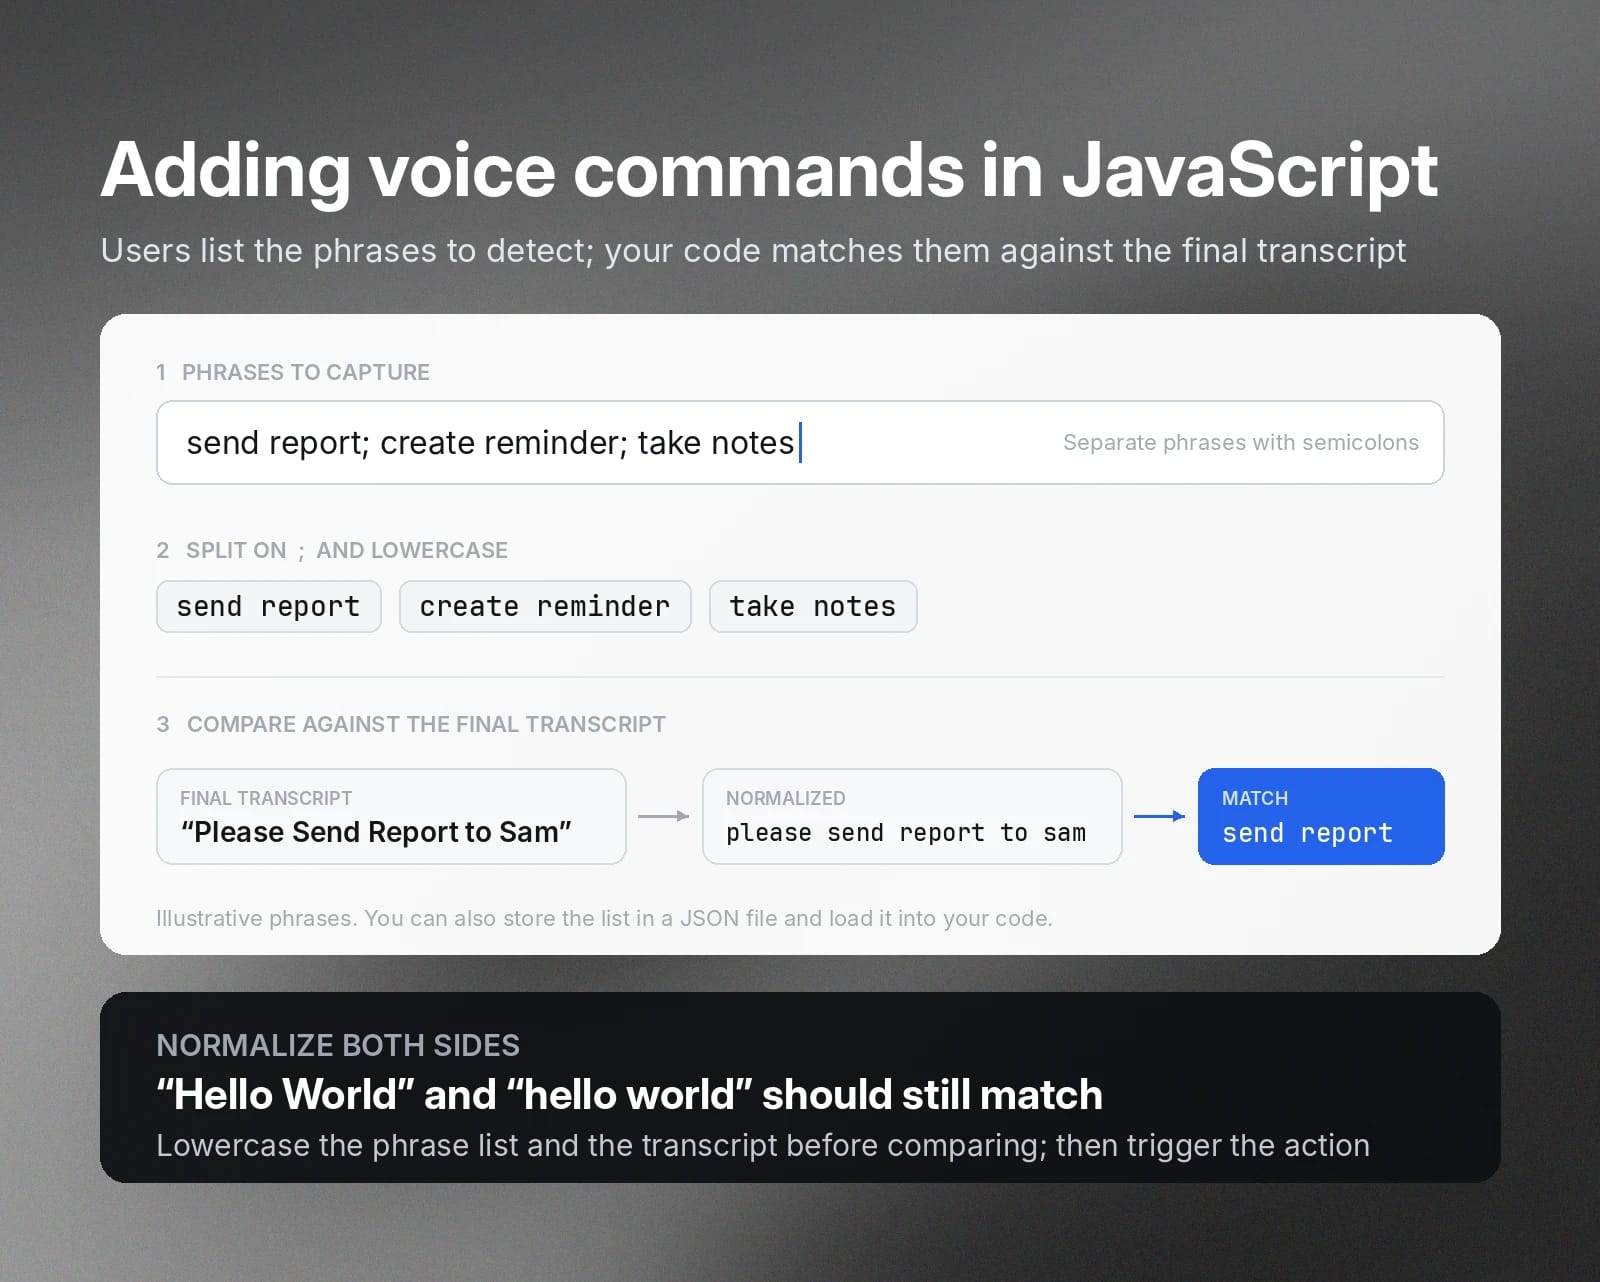
Poi crea una funzione che confronta la trascrizione finale con l'elenco delle frasi. Quando esegui il text matching, normalizza entrambi gli elenchi convertendoli in minuscolo. Questo perché gli utenti potrebbero scrivere le parole con la maiuscola, causando una mancata corrispondenza anche se si tratta della stessa parola. Ad esempio, “Hello World” e “hello world” dovrebbero corrispondere, anche se uno usa le maiuscole.
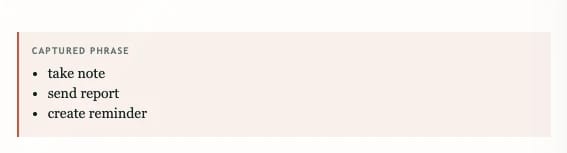
Ogni volta che il codice riceve una trascrizione, itera nell'elenco delle frasi. Se trova una corrispondenza, attivi un'azione, come l'avvio di un'applicazione o, in questo caso, la visualizzazione della frase corrispondente in un pannello separato.
Gestisci il supporto dei browser, le autorizzazioni e gli errori di riconoscimento
La Web Speech API rende accessibile il riconoscimento Speech to Text in JavaScript, ma non è sempre priva di problemi. Gli utenti potrebbero usare un browser con supporto backend limitato o assente per l'API SpeechRecognition. In alcuni casi, problemi di rete causano l'interruzione della trascrizione.
Il tuo codice deve quindi gestire queste condizioni e avvisare gli utenti di conseguenza.
Ad esempio, puoi invitare gli utenti a usare Chrome o Edge, browser in cui è comprovato il funzionamento dell'API SpeechRecognition.
Per gestire gli errori, invece, associa una funzione di gestione degli errori all'event handler onerror ed elabora il rispettivo codice di errore.
Ad esempio:
Codice di errore
Azione
not-allowed
Visualizza un testo che invita l'utente a controllare le impostazioni del browser.
no-speech
Invita l'utente a parlare più vicino al microfono
network
Chiedi all'utente di controllare la connessione internet
aborted
Informa l'utente che il processo di riconoscimento vocale è stato interrotto.
Rendi il riconoscimento vocale JavaScript accessibile e attento alla privacy
Quando integri la Web Speech API, tieni presente la privacy. Mostra sempre un indicatore visivo o verbale prima che il client web inizi a registrare. Ad esempio, mostra un'icona di ascolto come segnale visivo mentre il codice di riconoscimento vocale JavaScript invia attivamente il segnale del microfono al motore di Speech to Text.
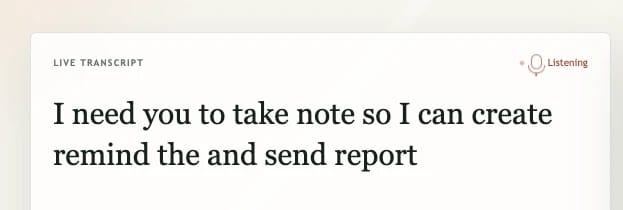
Un altro aspetto a cui gli sviluppatori dovrebbero prestare attenzione è la privacy dei dati. Quando trascrivi con l'API SpeechRecognition, l'API esegue la trascrizione online per impostazione predefinita. Anche se il browser supporta lo Speech to Text offline, l'API tenterà prima la trascrizione online.
Queste specifiche tecniche sono fondamentali quando crei servizi di trascrizione in cui la residenza dei dati, la governance e la conformità normativa sono strettamente regolamentate.
Scopri quando il riconoscimento vocale nel browser non è sufficiente per la produzione
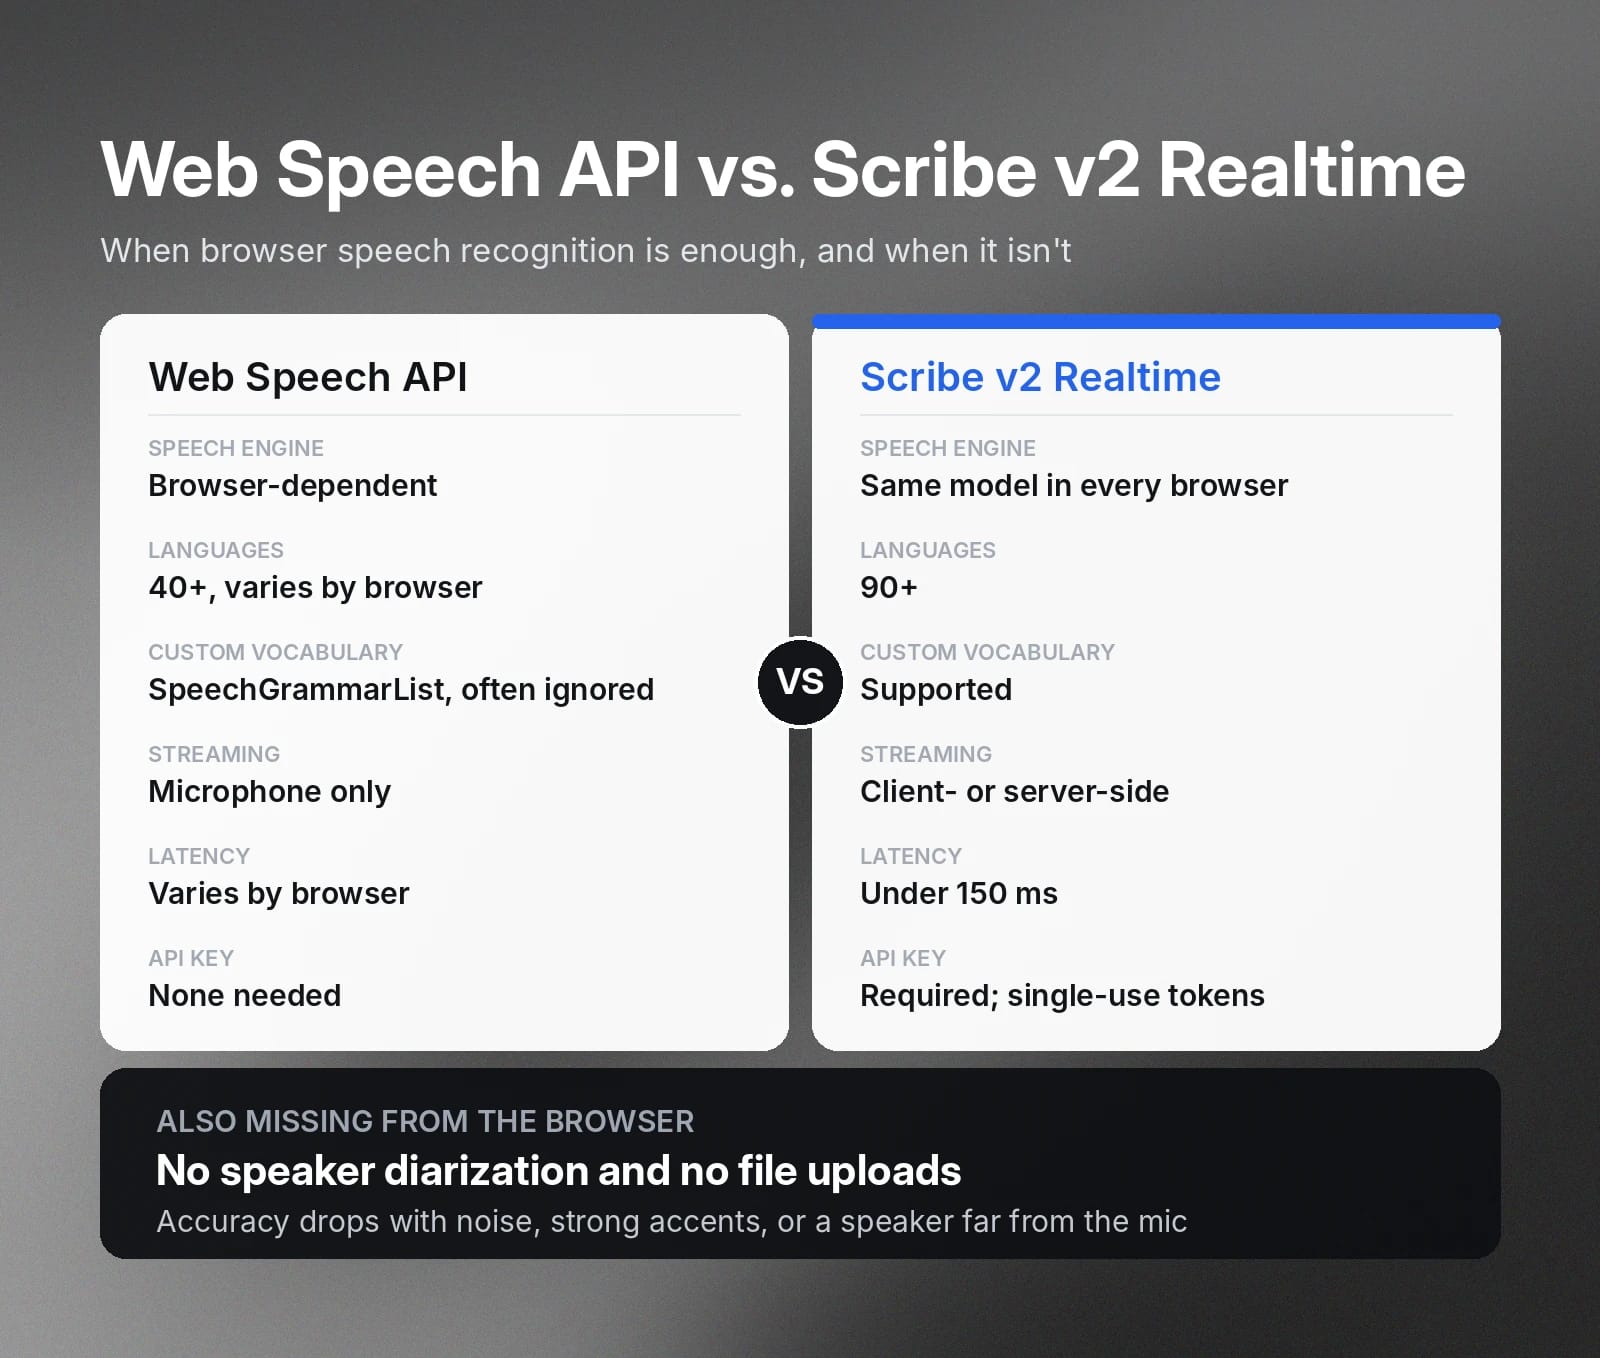
Abbiamo illustrato i passaggi per creare il riconoscimento vocale automatico per app vocali basate su browser con la Web Speech API. L'API rende le funzionalità di Speech to Text accessibili agli sviluppatori JavaScript. Tuttavia, diverse limitazioni ne restringono i casi d'uso, soprattutto per i prodotti web commerciali.
- Dipendenza dal browser: La trascrizione dipende fortemente dal browser dell'utente. Gli sviluppatori non hanno alcun controllo sui modelli vocali specifici utilizzati, con conseguenti prestazioni di trascrizione incoerenti.
- Supporto linguistico limitato: L'API supporta oltre 40 lingue, ma il numero esatto può variare tra i browser.
- Diarizzazione dei parlanti: Non puoi rilevare chi sta parlando né distinguere i singoli parlanti nella trascrizione.
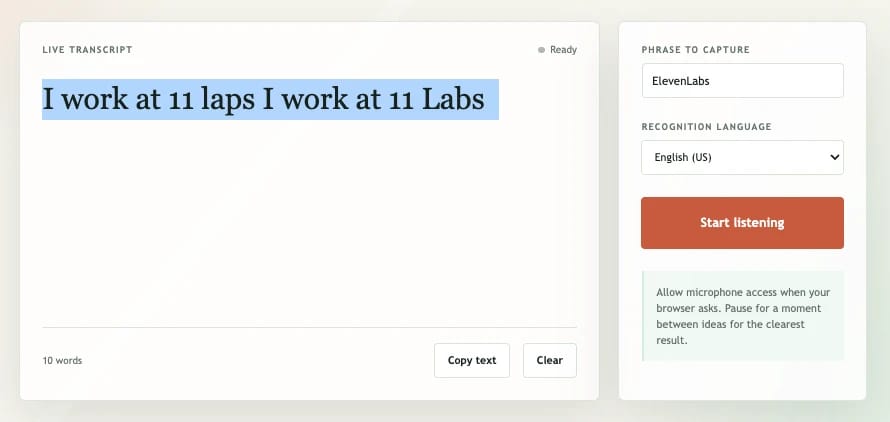
- Vocabolari personalizzati: L'API SpeechRecognition non offre un supporto affidabile per i vocabolari personalizzati. Ad esempio, non riesce a trascrivere accuratamente “ElevenLabs”. L'API ufficiale SpeechRecognition fornisce un'interfaccia per vocabolari personalizzati tramite SpeechGrammarList, ma i browser moderni spesso la ignorano.
- Accuratezza: L'accuratezza della trascrizione diminuisce quando il parlante si trova in un ambiente rumoroso, ha un accento marcato o è lontano dal microfono.
- Streaming lato server: Puoi eseguire lo streaming soltanto dal microfono, poiché la Web Speech API non supporta lo streaming dal server né il caricamento manuale di file audio.
Se queste limitazioni ti impediscono di commercializzare il tuo prodotto di riconoscimento vocale, ti consigliamo di usare ElevenLabs Scribe v2 Realtime.
ElevenLabs Scribe v2 Realtime è un modello di riconoscimento vocale che offre trascrizioni in tempo reale ad alta accuratezza con latenza inferiore a 150 ms. Supporta più di 90 lingue, coerenza indipendente dal browser e vocabolari personalizzati. Con ElevenLabs Scribe v2 Realtime puoi eseguire lo streaming lato client o lato server per adattarlo all'architettura della tua app web.
Tutorial sul riconoscimento vocale JavaScript con ElevenLabs Scribe v2 Realtime
Creare un comando vocale in JavaScript con ElevenLabs segue un approccio simile. Tuttavia, dovrai creare una chiave API ElevenLabs per autorizzare le richieste API. Di seguito trovi i passaggi rapidi per creare un client web che trasmette in streaming dal microfono.
- Installa l'SDK ElevenLabs
- Crea un token monouso per passare la chiave API senza esporla
- Configura e connettiti al modello Scribe v2 Realtime con i parametri desiderati
- Crea event handler per elaborare le trascrizioni e gestire le eccezioni
Per una guida completa su Scribe v2 Realtime, consulta la nostra documentazione ufficiale.
Inizia a usare ElevenAPI per lo Speech to Text in produzione
ElevenAPI offre modelli di livello professionale per Speech to Text per lo sviluppo di client web e server. Oltre al riconoscimento vocale in tempo reale, gli sviluppatori usano i modelli Speech to Text di ElevenAPI per abilitare la trascrizione batch con diarizzazione dei parlanti, timestamp a livello di parola ed elaborazione asincrona.
Invece di interrogare continuamente il motore di Speech to Text, puoi creare un webhook nella dashboard di ElevenLabs e fornire un URL di callback, a cui l'API recapita la trascrizione completata.
Che tu voglia creare un client web o un'app server con riconoscimento vocale automatico, ElevenAPI offre modelli audio che puoi integrare facilmente nel tuo codice.
Ottieni la tua chiave API ElevenLabs ed esplora la documentazione API per iniziare a sviluppare.
Domande frequenti

Jack Limebear fa parte del team Growth e si occupa di scrivere contenuti e definire strategie per il blog e le pagine insights. Prima di arrivare in ElevenLabs, ha guidato la strategia dei contenuti per oltre dieci anni in realtà che vanno da startup SaaS in rapida crescita a grandi aziende Fortune 500. Ha conseguito un Master in Letteratura Inglese presso l’Università di Cambridge.


