
Tutorial sul riconoscimento vocale in Python: dal file audio alla trascrizione
- Scritto da
- Jack Limebear
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
In passato, aggiungere funzionalità di riconoscimento vocale a un'app Python era complesso. Gli sviluppatori Python dovevano gestire direttamente il processo di trascrizione, inclusi il pre-elaborazione dell'audio, l'estrazione delle caratteristiche e l'integrazione del modello. Inoltre, i team di ingegneria dovevano affrontare la gestione audio di basso livello, una qualità di trascrizione insufficiente e ritardi tra le parole pronunciate e i sottotitoli in tempo reale.
I progressi nei modelli audio e negli SDK per il riconoscimento vocale cambiano tutto questo.
In questo tutorial sul riconoscimento vocale in Python, scoprirai come integrare i modelli audio Speech to Text di ElevenLabs nel tuo progetto Python per creare app di trascrizione pronte per l'uso commerciale.
Riepilogo
- I modelli Speech to Text commerciali offrono funzionalità come la diarizzazione dei parlanti, timestamp a livello di parola e keyterm prompting, assenti nei modelli base di riconoscimento vocale.
- ElevenAPI aggiunge funzionalità di riconoscimento vocale al tuo codice Python con Scribe v2 e Scribe v2 Realtime.
- Gli sviluppatori possono installare le skill di ElevenLabs su una piattaforma di coding IA per generare codice Python accurato in base alla documentazione API ufficiale.
- Puoi provare gratuitamente l'API ElevenLabs prima di sottoscrivere un piano a pagamento per lo sviluppo commerciale.
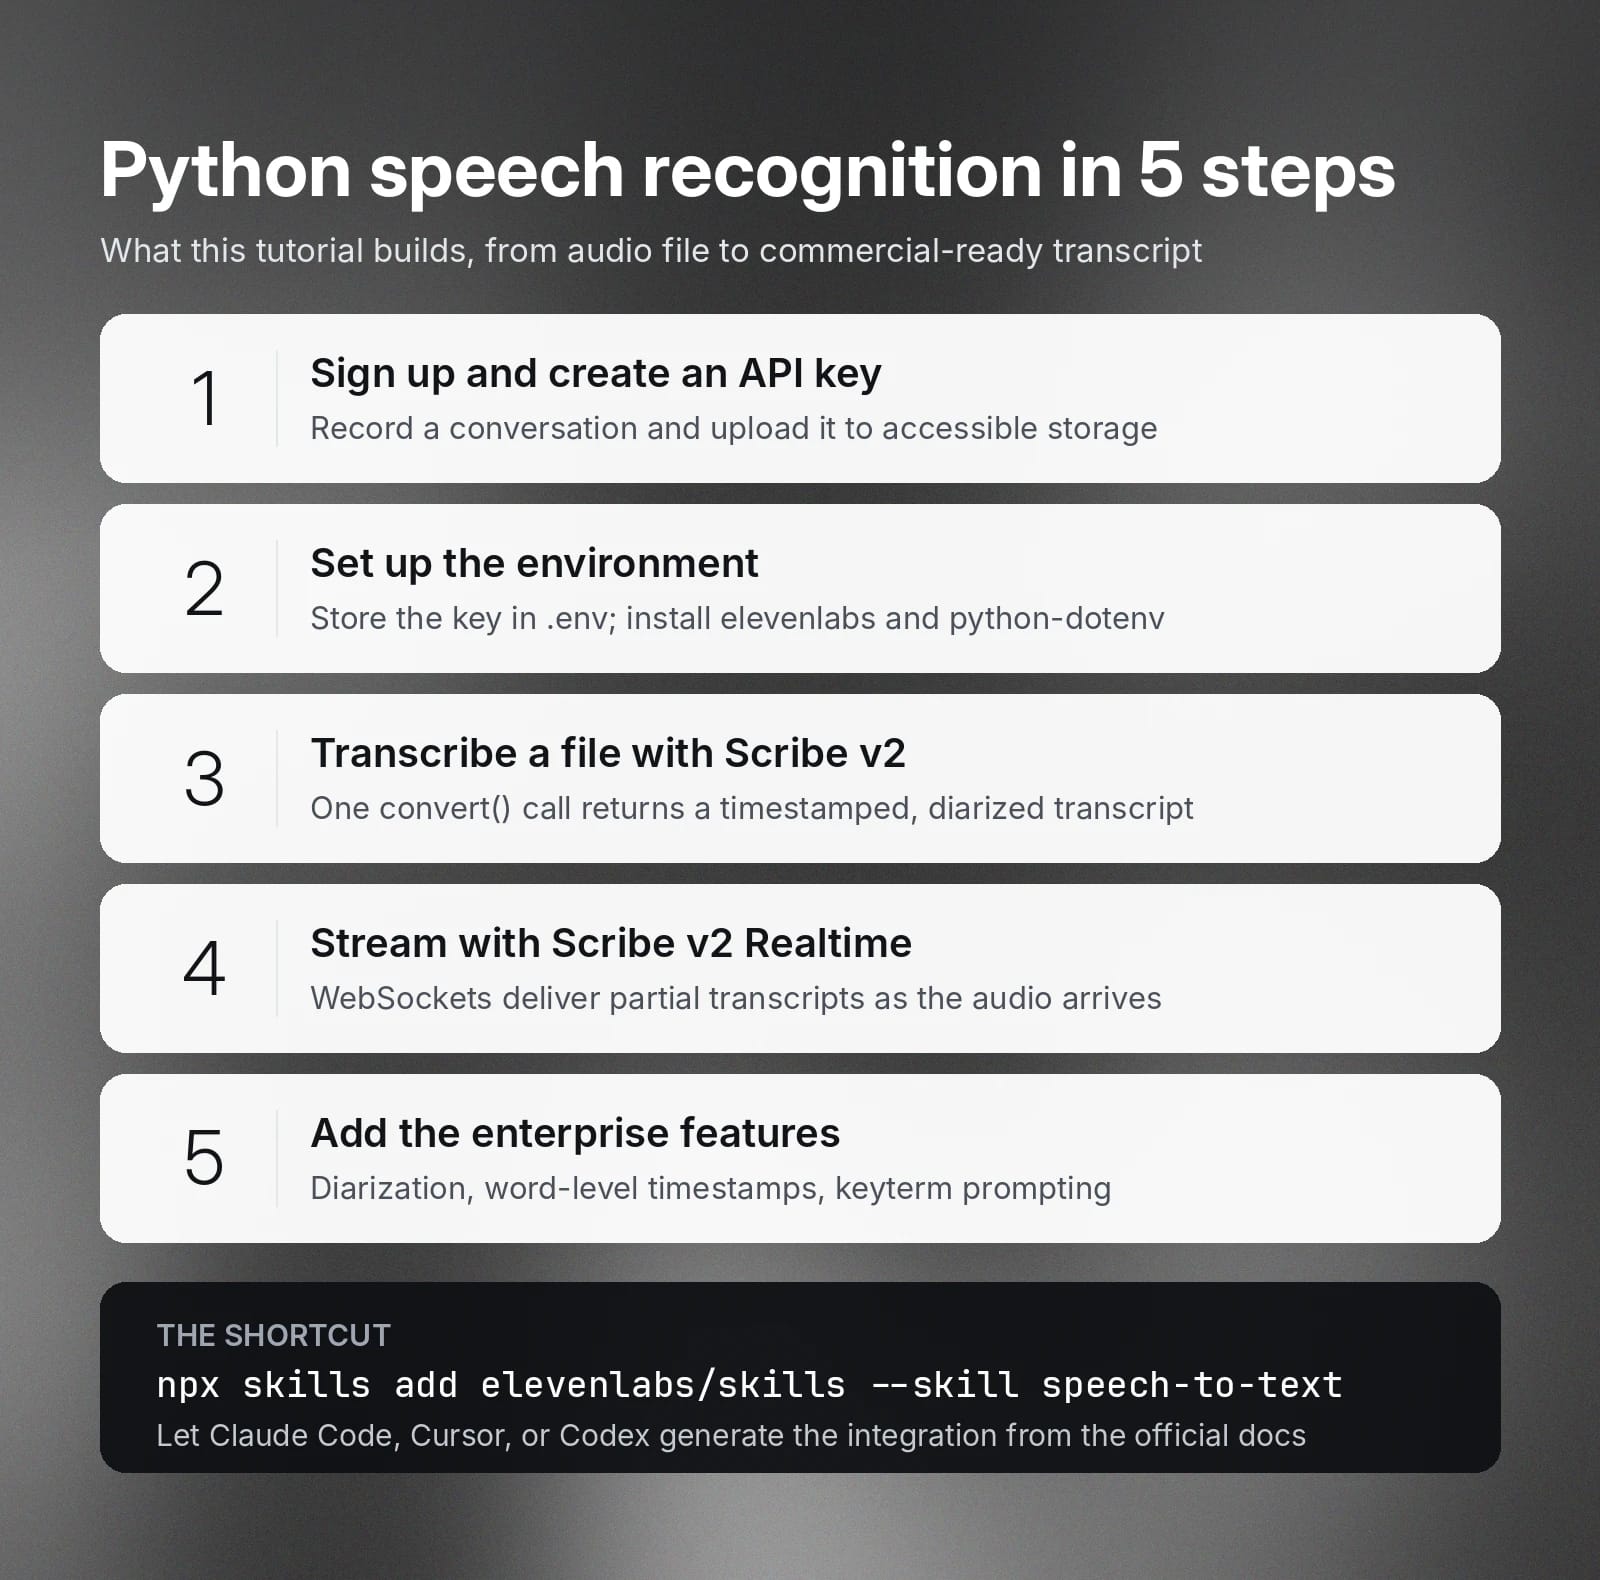
Cosa include questo tutorial sul riconoscimento vocale in Python
Questo tutorial illustra i prerequisiti, l'integrazione API e le funzionalità di trascrizione avanzate che ti aiutano a creare un'app Python di riconoscimento vocale per casi d'uso aziendali.
Il riconoscimento vocale è maturato negli ultimi anni, soprattutto perché i modelli linguistici di grandi dimensioni e le reti neurali di deep learning hanno cambiato il modo in cui gli sviluppatori Python usano gli SDK di trascrizione. Molti tutorial mostrano come creare app di trascrizione di base, ma pochi trattano le funzionalità necessarie a un prodotto pronto per l'uso commerciale.
Abbiamo scritto questo tutorial per colmare questa lacuna.
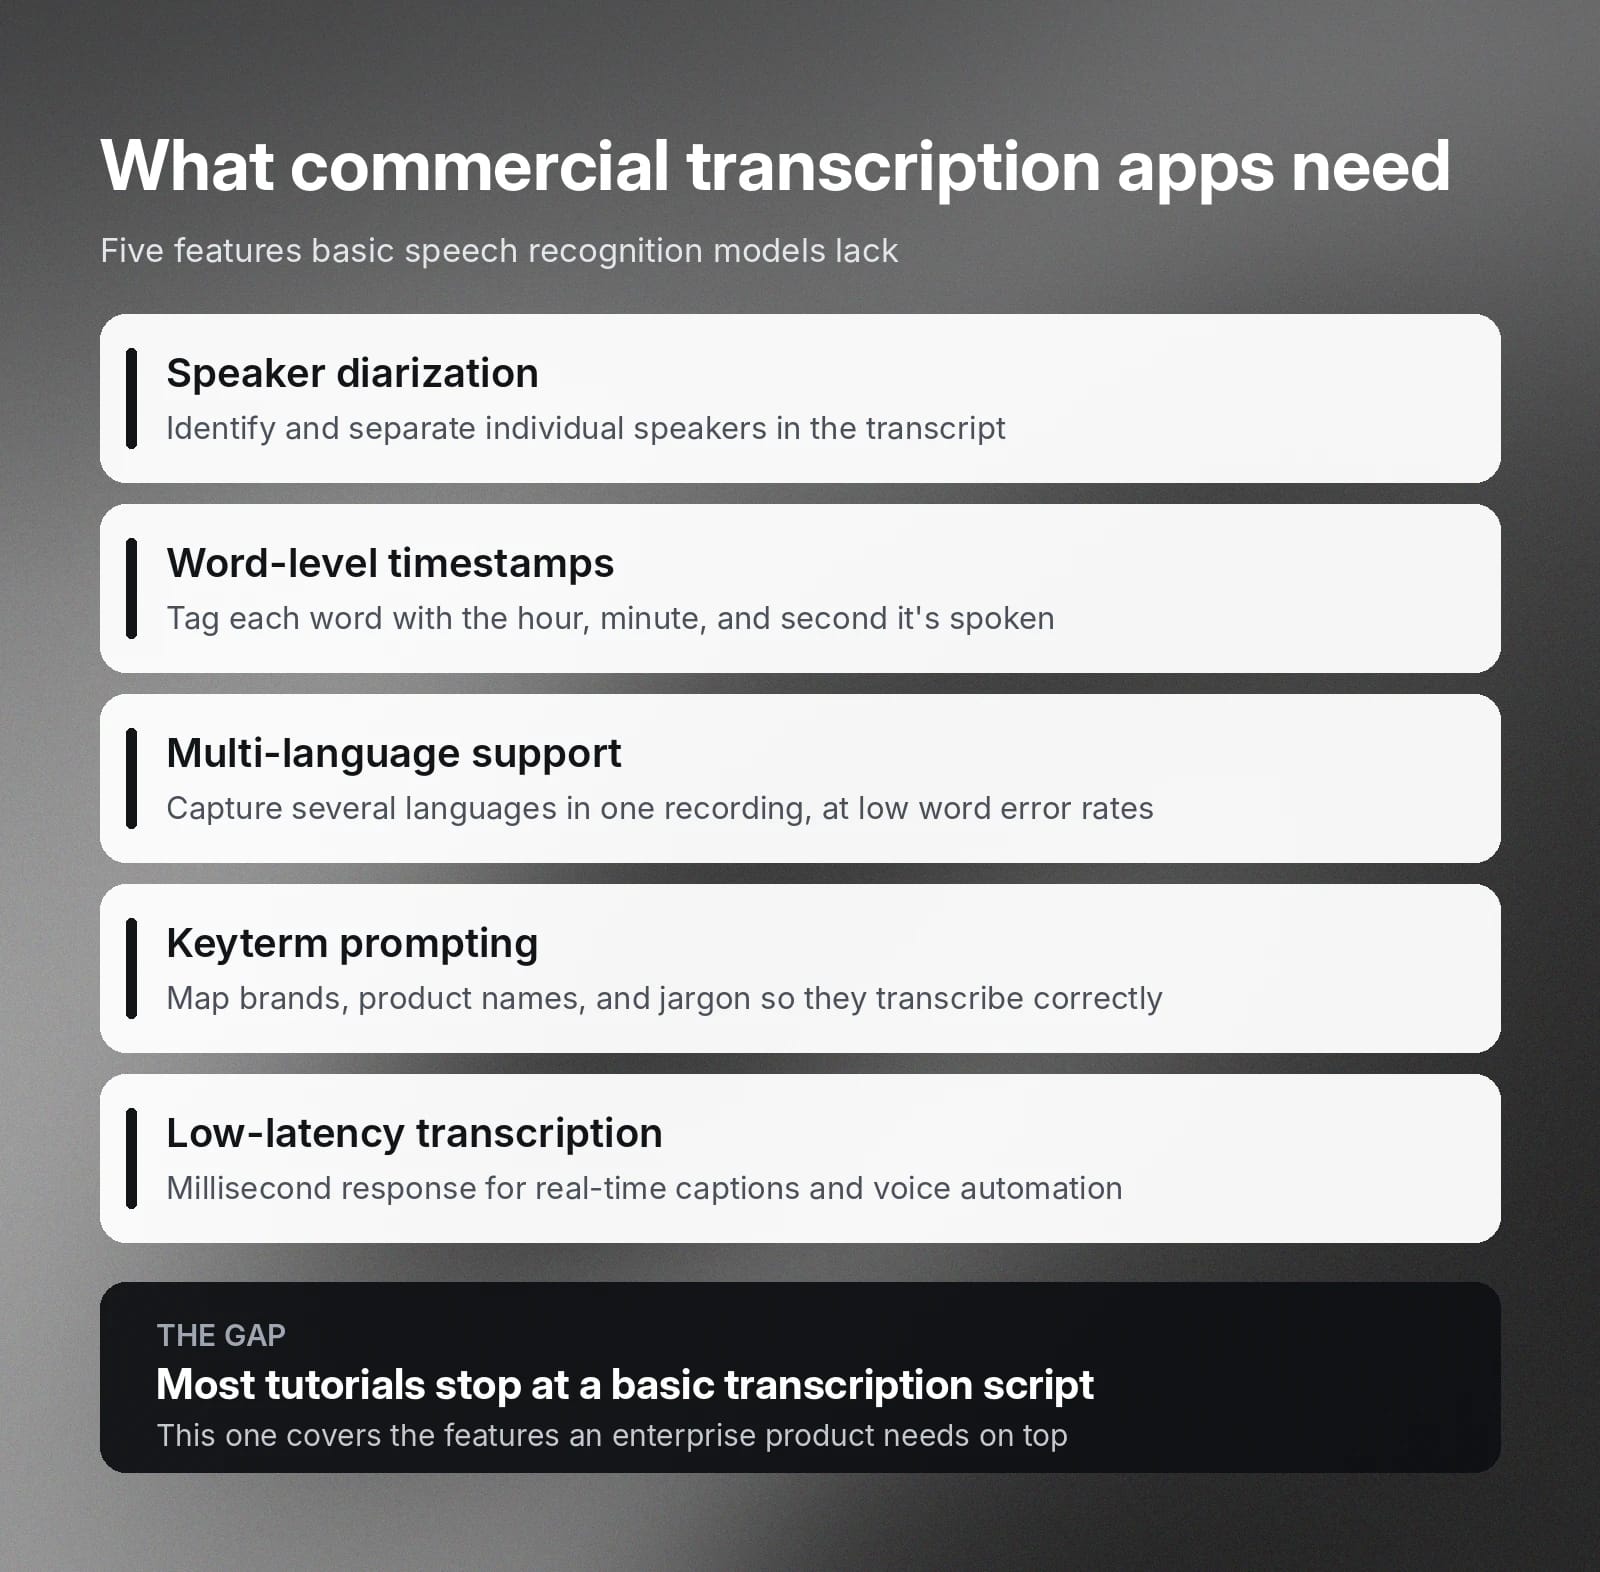
Ad esempio, molte soluzioni di trascrizione aziendali richiedono queste funzionalità:
- Diarizzazione dei parlanti: la capacità di identificare e separare i singoli parlanti nella trascrizione.
- Timestamp: l'associazione accurata di ogni parola alle ore, ai minuti e ai secondi relativi in cui viene pronunciata.
- Supporto multilingue: acquisisce discorsi in lingue diverse all'interno della stessa registrazione o stream live, con bassi tassi di errore sulle parole.
- Keyterm prompting: mappatura di parole speciali, come brand, nomi di prodotti e termini tecnici, per evitare errori di ortografia nelle trascrizioni.
- Trascrizione a bassa latenza: risposta speech-to-text nell'ordine dei millisecondi, che abilita le app di trascrizione in tempo reale.
Nota: questo tutorial va oltre la creazione di semplici script personali per hobby o progetti personali. Non include la logica applicativa costruita sull'integrazione con l'API Speech to Text, poiché varia in base all'azienda.
Prerequisiti per l'integrazione del riconoscimento vocale in Python
Abbiamo progettato questo tutorial attorno a ElevenAPI, un'API di ElevenLabs pronta per la produzione che semplifica l'interazione con i modelli vocali nel tuo codice. Con ElevenAPI hai accesso a Scribe v2 e Scribe v2 Realtime, i nostri modelli vocali di punta per la trascrizione batch e in tempo reale.
Invece di accedere direttamente ai modelli Speech to Text di ElevenLabs, invii registrazioni audio, stream live e argomenti tramite chiamate API. Il modello audio converte quindi i dati audio in testo. Al termine, ricevi le trascrizioni nel codice o tramite webhook.
Per iniziare, segui questi passaggi preparatori.
- Registrati a ElevenLabs.
- Crea la tua chiave API.
- Registra una conversazione e caricala in uno storage accessibile pubblicamente.
Quando sei pronto, passa alla sezione successiva.
Configurare l'ambiente
Prima di integrare i modelli ElevenLabs, configura l'ambiente Python per proteggere la tua chiave API di ElevenLabs. Come per tutte le chiavi API, ti consigliamo di memorizzarla come variabile d'ambiente (un segreto gestito) nel file .env.
Quando effettui una chiamata API, passi la variabile d'ambiente. Così eviti di esporre accidentalmente la chiave API quando effettui richieste API tramite una rete pubblica.
Successivamente, esegui un comando Bash per installare elevenlabs, l'SDK di ElevenLabs, nel tuo ambiente Python. L'SDK ti consente di accedere a vari modelli vocali. In questo caso, scegli tra Scribe v2 e Scribe v2 Realtime.
Dovrai anche installare python-dotenv, che consente al codice Python di accedere alle variabili d'ambiente archiviate nel file .env.
Scrivere il tuo primo script di trascrizione
Dopo aver configurato l'ambiente Python, puoi trascrivere il file audio usando ElevenLabs Scribe v2.
ElevenLabs Scribe v2 è un modello di riconoscimento vocale leader del settore che ti consente di trascrivere file audio su larga scala. Rileva i fonemi con elevata accuratezza anche quando la registrazione audio presenta un rumore di fondo significativo. Per trascrivere l'audio, invii la registrazione al modello tramite l'API ElevenLabs e recuperi la trascrizione completata.
Di seguito trovi uno snippet di codice Python che converte un file audio in una trascrizione con timestamp e diarizzazione.
Il codice carica le librerie necessarie, che forniscono le funzioni richieste. Carica inoltre nell'ambiente del programma le variabili d'ambiente che hai dichiarato.
Crea quindi un client ElevenLabs usando la chiave API memorizzata nella variabile d'ambiente. Successivamente scarica il file audio e lo converte in dati binari.
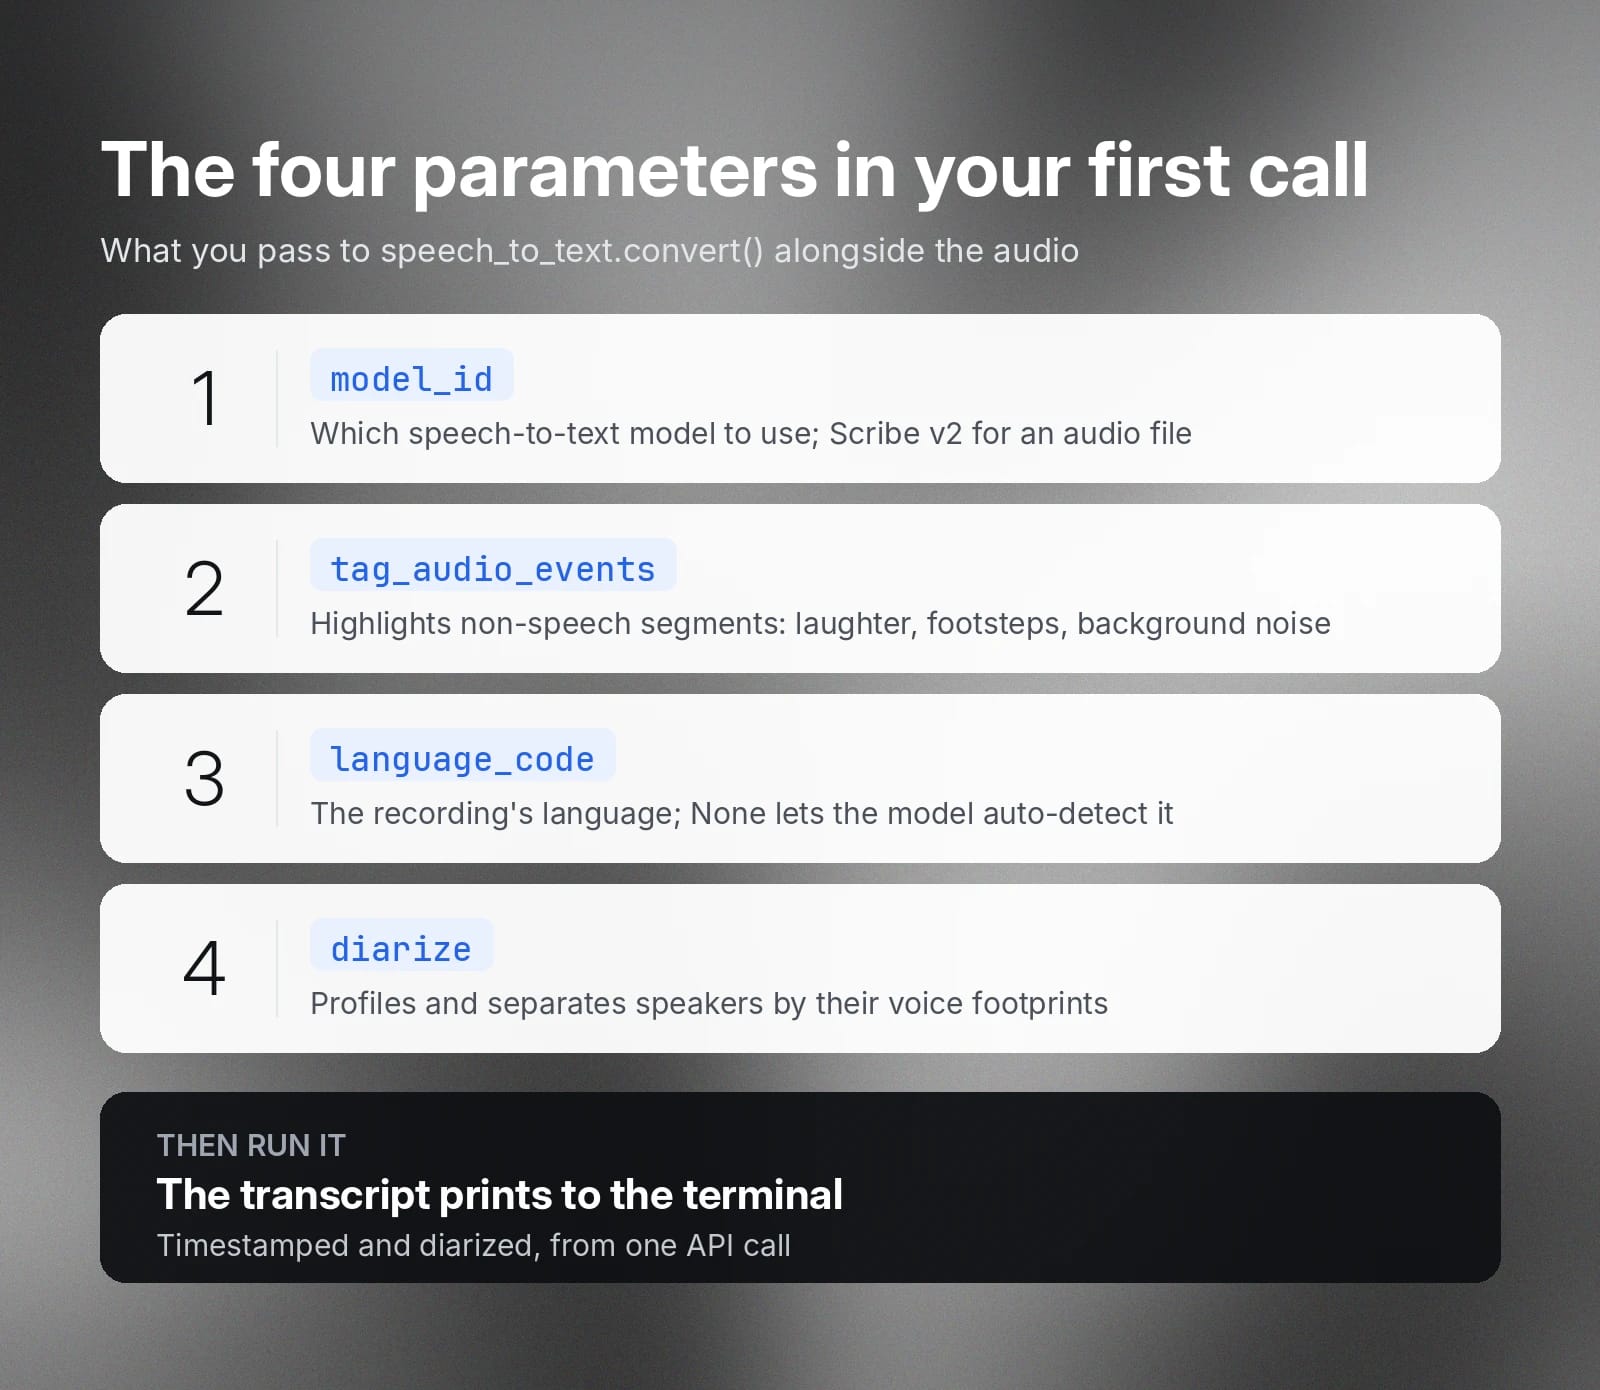
Una volta ottenuti i dati audio grezzi, li invii all'API ElevenLabs insieme a diversi parametri.
- model_id indica il modello speech-to-text che vuoi usare. Poiché stai passando un file audio, Scribe v2 è l'opzione migliore.
- tag_audio_events ti consente di evidenziare segmenti non vocali, come risate, passi e altri rumori di fondo.
- language_code rappresenta la lingua delle conversazioni nel file di registrazione. Se impostato su None, il modello rileverà automaticamente la lingua.
- diarize indica se vuoi che il modello identifichi e separi i diversi parlanti in base alle loro impronte vocali.
Infine, esegui il codice e vedrai l'audio trascritto nel terminale.
Riconoscimento vocale in streaming in Python
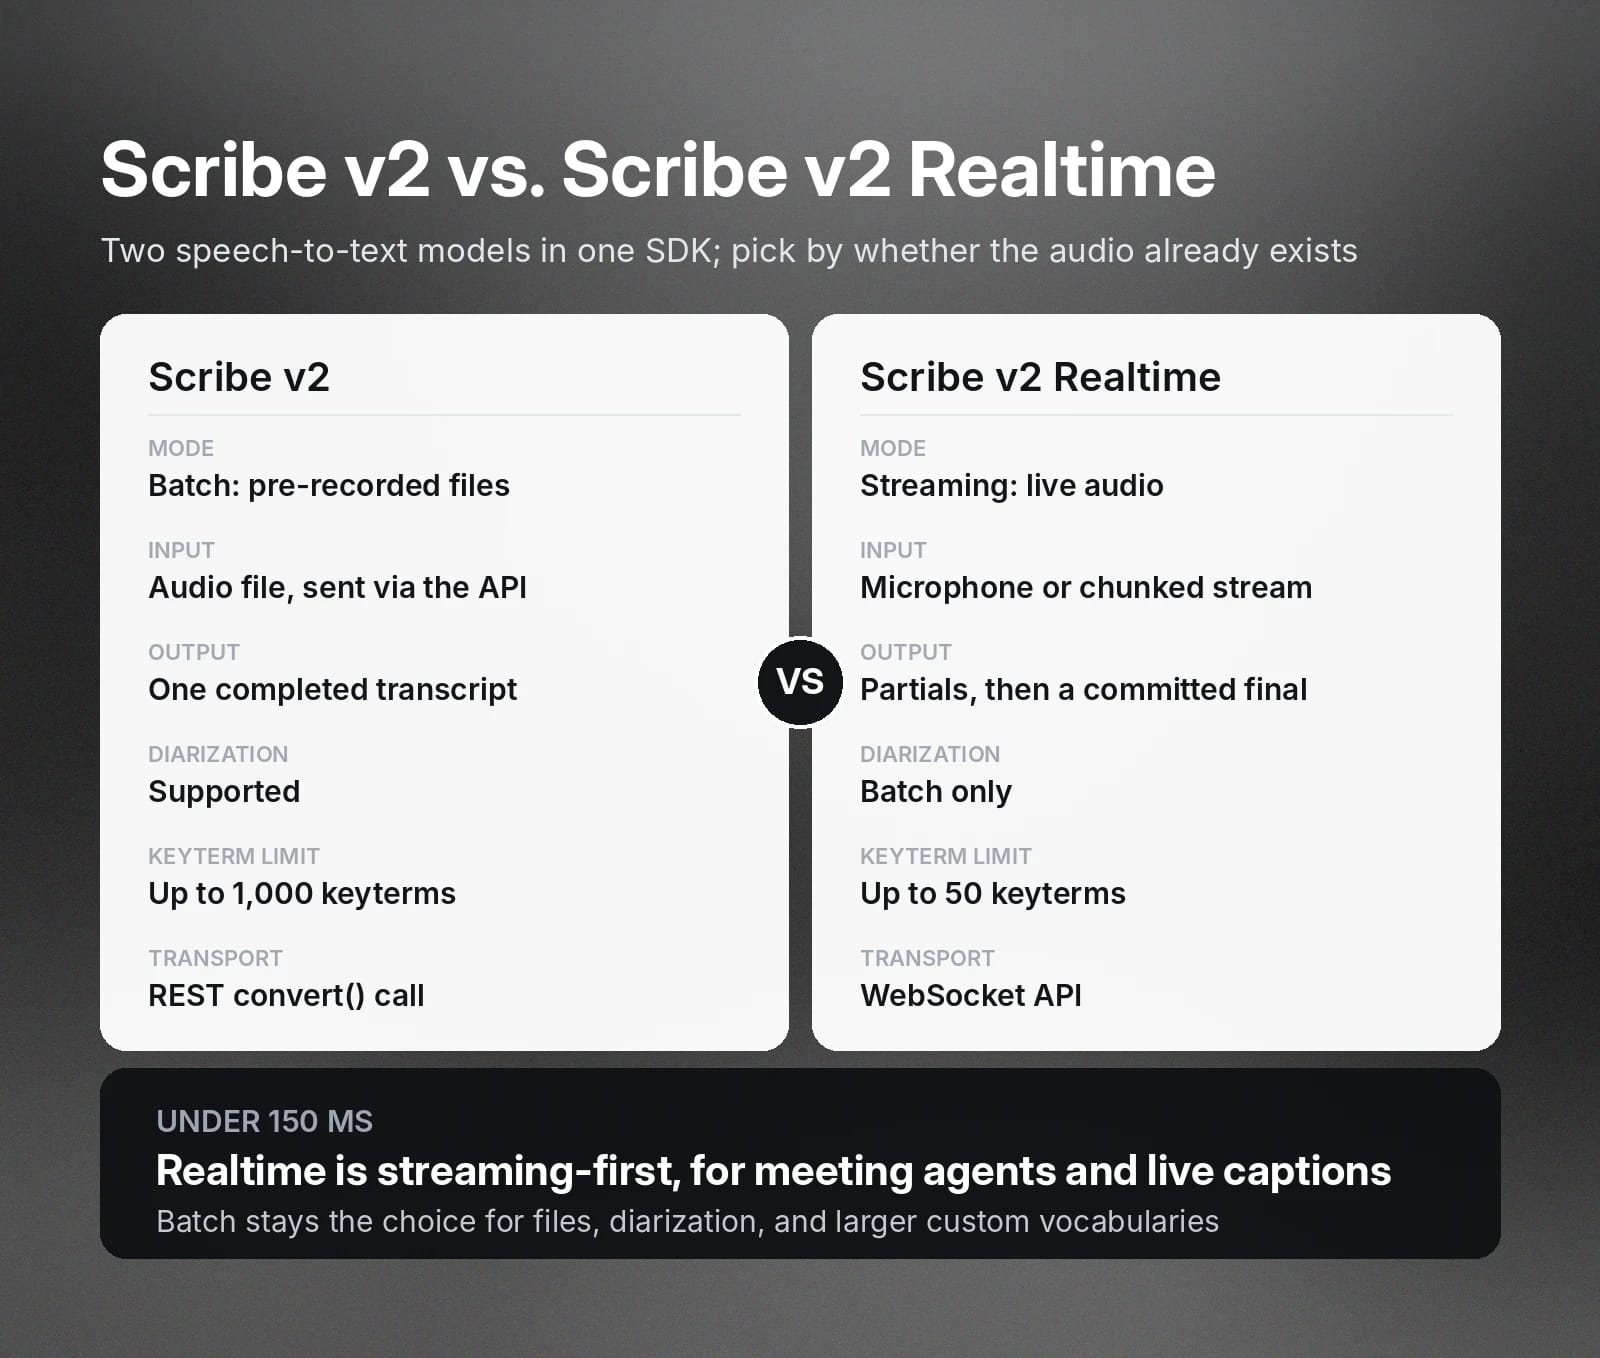
L'esempio precedente tratta la trascrizione batch, adatta ai file preregistrati. Tuttavia, ElevenLabs offre anche API che ti consentono di creare il riconoscimento vocale in streaming. A differenza dell'elaborazione batch, questa modalità esegue il riconoscimento vocale in tempo reale per generare trascrizioni mentre avviene la conversazione.
Per farlo, colleghi il tuo codice Python al modello Scribe v2 Realtime usando l'API WebSocket.
Scribe v2 Realtime offre un'architettura pensata per lo streaming, con una latenza di trascrizione inferiore a 150 ms. Puoi usare Scribe v2 Realtime per creare applicazioni come agenti per riunioni, strumenti di accessibilità e automazioni attivate dalla voce. Il modello restituisce una trascrizione parziale durante l'elaborazione dello stream audio. Restituisce quella finale soltanto quando il codice conferma un segmento audio, automaticamente o manualmente.
In base alla sorgente audio e al tipo di applicazione, integri il riconoscimento vocale con l'API ElevenLabs lato server o lato client.
- Streaming lato client ti consente di trasmettere direttamente dal microfono o tramite stream audio suddivisi manualmente in blocchi.
- Streaming lato server inoltra i dati audio da un URL o da una sorgente audio al modello vocale.
Sia lo streaming lato client sia quello lato server ti consentono di usare un workflow asincrono. Invece di interrogare continuamente l'API, usa WebSocket per gestire i risultati. Nel codice, devi creare handler che ricevano trascrizioni parziali e finalizzate.
Approfondimento: diarizzazione, timestamp e vocabolario personalizzato
Oltre al riconoscimento vocale automatico, i modelli Speech to Text di ElevenLabs supportano la diarizzazione, i timestamp e il vocabolario personalizzato.
- Diarizzazione: soltanto la trascrizione batch supporta la diarizzazione dei parlanti. Puoi abilitare la diarizzazione impostando l'argomento diarize. Tuttavia, la trascrizione multicanale, una modalità della trascrizione batch, non supporta la diarizzazione.
- Timestamp: durante la trascrizione batch, puoi scegliere tra timestamp a livello di parola o di carattere. Per farlo, imposta il parametro timestamps_granularity quando usi il metodo convert.
- Vocabolario personalizzato: sia la trascrizione in tempo reale sia quella batch supportano il keyterm prompting. Questa funzionalità orienta il modello verso la trascrizione di keyterm specifici inclusi in un elenco. Scribe v2 Realtime supporta fino a 50 keyterm, mentre Scribe v2 ne supporta 1.000.
Usare la skill ElevenLabs negli assistenti di coding IA
Gli assistenti di coding IA accelerano lo sviluppo. Se usi strumenti come Claude Code, Cursor, Codex o strumenti di coding IA simili, puoi aggiungere le skill di ElevenLabs al tuo ambiente di coding.
Ti basta eseguire questo comando nel terminale della tua piattaforma:
L'agente di coding IA scaricherà la skill speech-to-text dal repository GitHub di ElevenLabs e la installerà nella directory locale delle skill. Questo ti consente di generare automaticamente codice Python per il riconoscimento vocale in base alla documentazione ufficiale di ElevenLabs, invece di scrivere da zero l'intera integrazione API.
Una volta installata, puoi generare codice Python per il riconoscimento vocale semplicemente descrivendo in modo conversazionale cosa deve fare. In base alla descrizione, l'assistente di coding genera automaticamente codice usando la skill speech-to-text, con il modello e i parametri corretti.
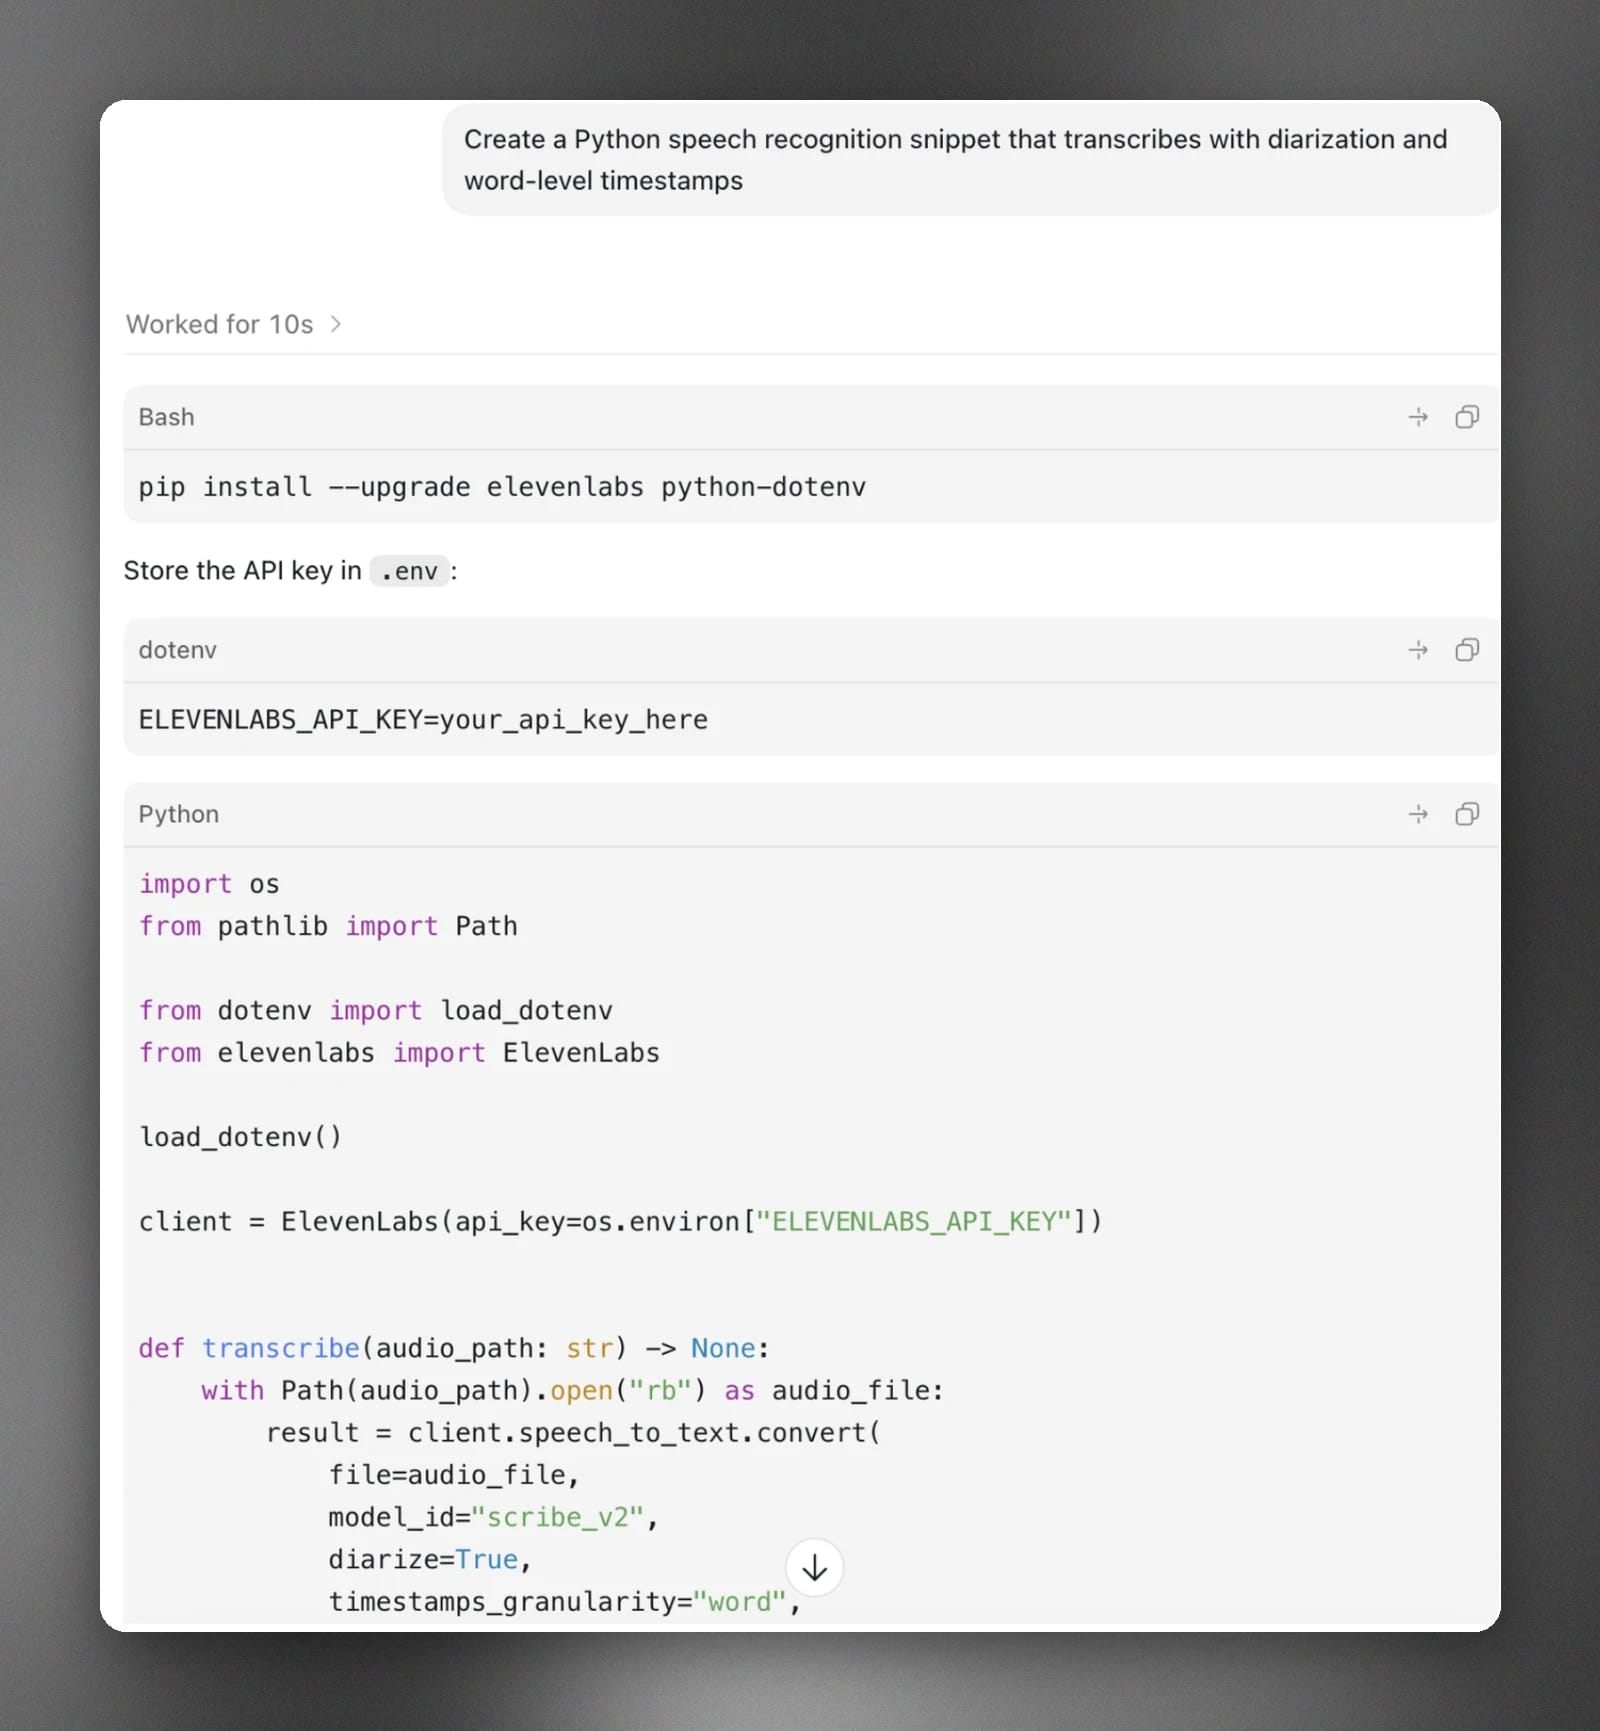
Ad esempio, se digiti in Codex “Crea uno snippet Python di riconoscimento vocale che trascriva con diarizzazione e timestamp a livello di parola”, otterrai uno snippet simile a quello riportato di seguito.
Inizia con ElevenAPI per il riconoscimento vocale
ElevenAPI ti consente di accedere a modelli Speech to Text avanzati per creare app di riconoscimento vocale in Python.
Usando ElevenAPI, eviti di scrivere il codice di integrazione da zero, un'attività che rallenta l'innovazione di prodotto. Puoi invece usare SDK che espongono servizi Speech to Text in grado di soddisfare requisiti di livello commerciale, come keyterm prompting, diarizzazione e timestamp.
Ottieni subito la tua chiave API ElevenLabs ed esplora la nostra documentazione ufficiale per scoprire come funziona l'API.
Domande frequenti

Jack Limebear fa parte del team Growth e si occupa di scrivere contenuti e definire strategie per il blog e le pagine insights. Prima di arrivare in ElevenLabs, ha guidato la strategia dei contenuti per oltre dieci anni in realtà che vanno da startup SaaS in rapida crescita a grandi aziende Fortune 500. Ha conseguito un Master in Letteratura Inglese presso l’Università di Cambridge.


