
Cos'è la diarizzazione dei parlanti? Come funziona e casi d'uso
- Scritto da
- Jack Limebear
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
La diarizzazione dei parlanti prende un flusso audio con un numero sconosciuto di parlanti e produce una timeline di segmenti etichettati: parlante A da 0:00 a 0:42, parlante B da 0:42 a 1:15, poi di nuovo parlante A da 1:15 in avanti. Il sistema non sa chi siano i parlanti, ma sa che sono persone diverse e mantiene coerenti le loro etichette per tutta la registrazione.
Questo processo rende utilizzabile l'audio con più parlanti. I verbali delle riunioni, le analisi dei call center, le trascrizioni di interviste, l'editing di podcast e i registri legali dipendono tutti dal sapere non solo cosa è stato detto, ma anche chi l'ha detto.
Questa guida spiega come funziona la diarizzazione, in cosa differisce da tecniche correlate come la segmentazione e l'identificazione, quali strumenti open source la gestiscono e come misurare le prestazioni di un sistema di diarizzazione.
In sintesi
- La diarizzazione dei parlanti segmenta una registrazione audio in base a chi parla, producendo turni di parola etichettati senza identificare nessuno per nome.
- La diarizzazione dei parlanti differisce dalla segmentazione dei parlanti, che individua quando cambiano i parlanti, e dall'identificazione dei parlanti, che associa le voci a nomi reali.
- Le prestazioni della diarizzazione si misurano con il tasso di errore di diarizzazione (DER) per l'accuratezza complessiva e il tasso di errore di Jaccard (JER) per verificare che l'accuratezza si mantenga per ogni parlante.
Cos'è la diarizzazione dei parlanti e come funziona?
La diarizzazione dei parlanti è il processo di suddivisione di un flusso audio in segmenti in base a chi sta parlando. Una trascrizione con diarizzazione dei parlanti etichetta ogni segmento audio con l'identità di un parlante. In poche parole, risponde alla domanda: "Chi ha parlato e quando?"
La trascrizione grezza di una riunione ti fornisce le parole, mentre una trascrizione diarizzata ti dice che il parlante 1 ha posto la domanda, il parlante 2 ha risposto e il parlante 3 ha interrotto a metà.
La maggior parte dei sistemi di diarizzazione dei parlanti segue una pipeline in quattro fasi:
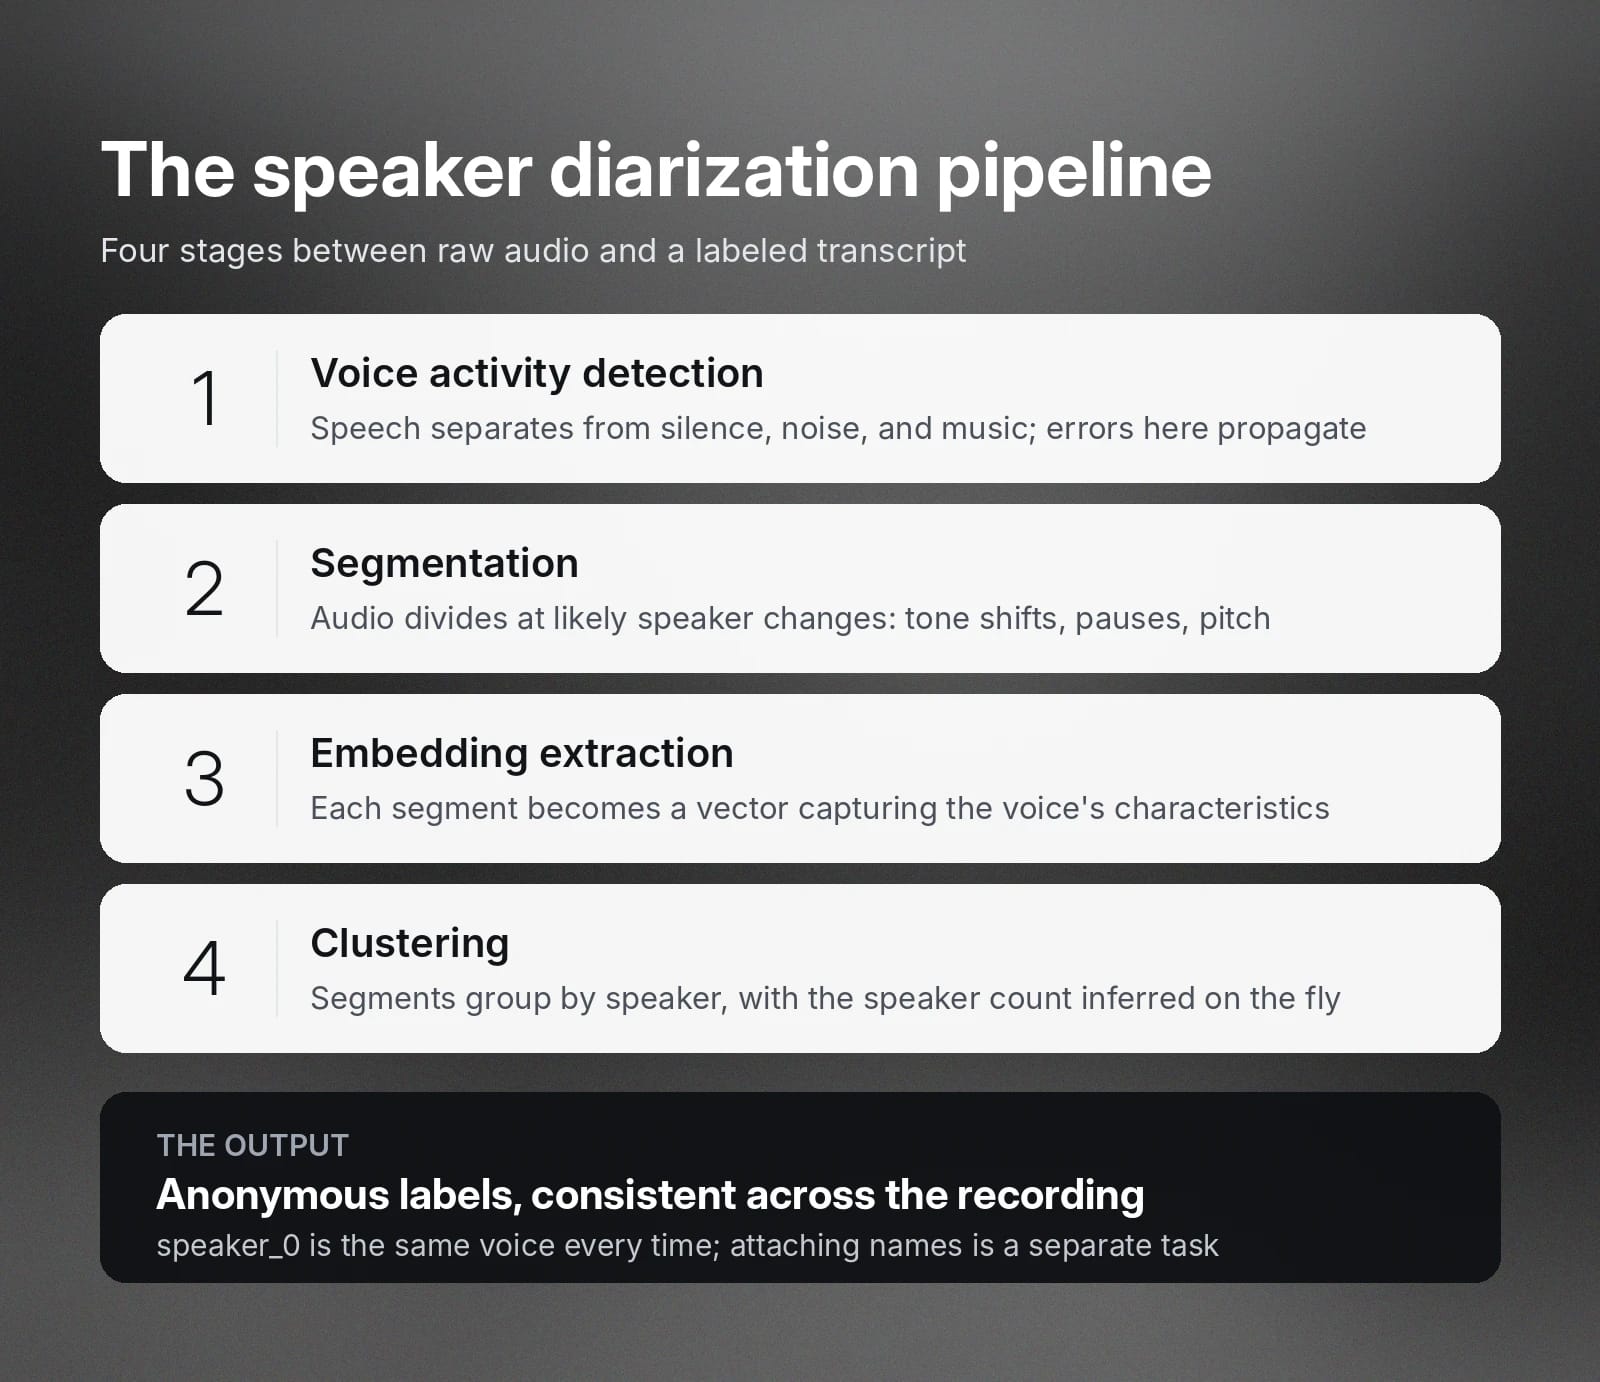
Analizziamo queste fasi più nel dettaglio.
Rilevamento dell'attività vocale (VAD)
Il rilevamento dell'attività vocale separa il parlato da tutto il resto: silenzio, rumore di fondo, musica, o clic della tastiera. Solo i segmenti audio che contengono parlato effettivo passano alla fase successiva.
Eventuali errori in questa fase si propagano a tutte le fasi successive.
Segmentazione
I segmenti contenenti parlato vengono quindi divisi nei punti in cui è probabile un cambio di parlante, ad esempio un cambiamento nel tono vocale, una pausa tra i turni di parola o una variazione nell'andamento dell'altezza. La maggior parte dei sistemi rileva direttamente questi punti di cambiamento confrontando le caratteristiche acustiche ai due lati di un potenziale confine.
Alcuni strumenti di segmentazione dividono l'audio in brevi finestre uniformi, come blocchi di due secondi, e si affidano poi alla fase di clustering per unire le finestre adiacenti appartenenti allo stesso parlante.
Estrazione degli embedding
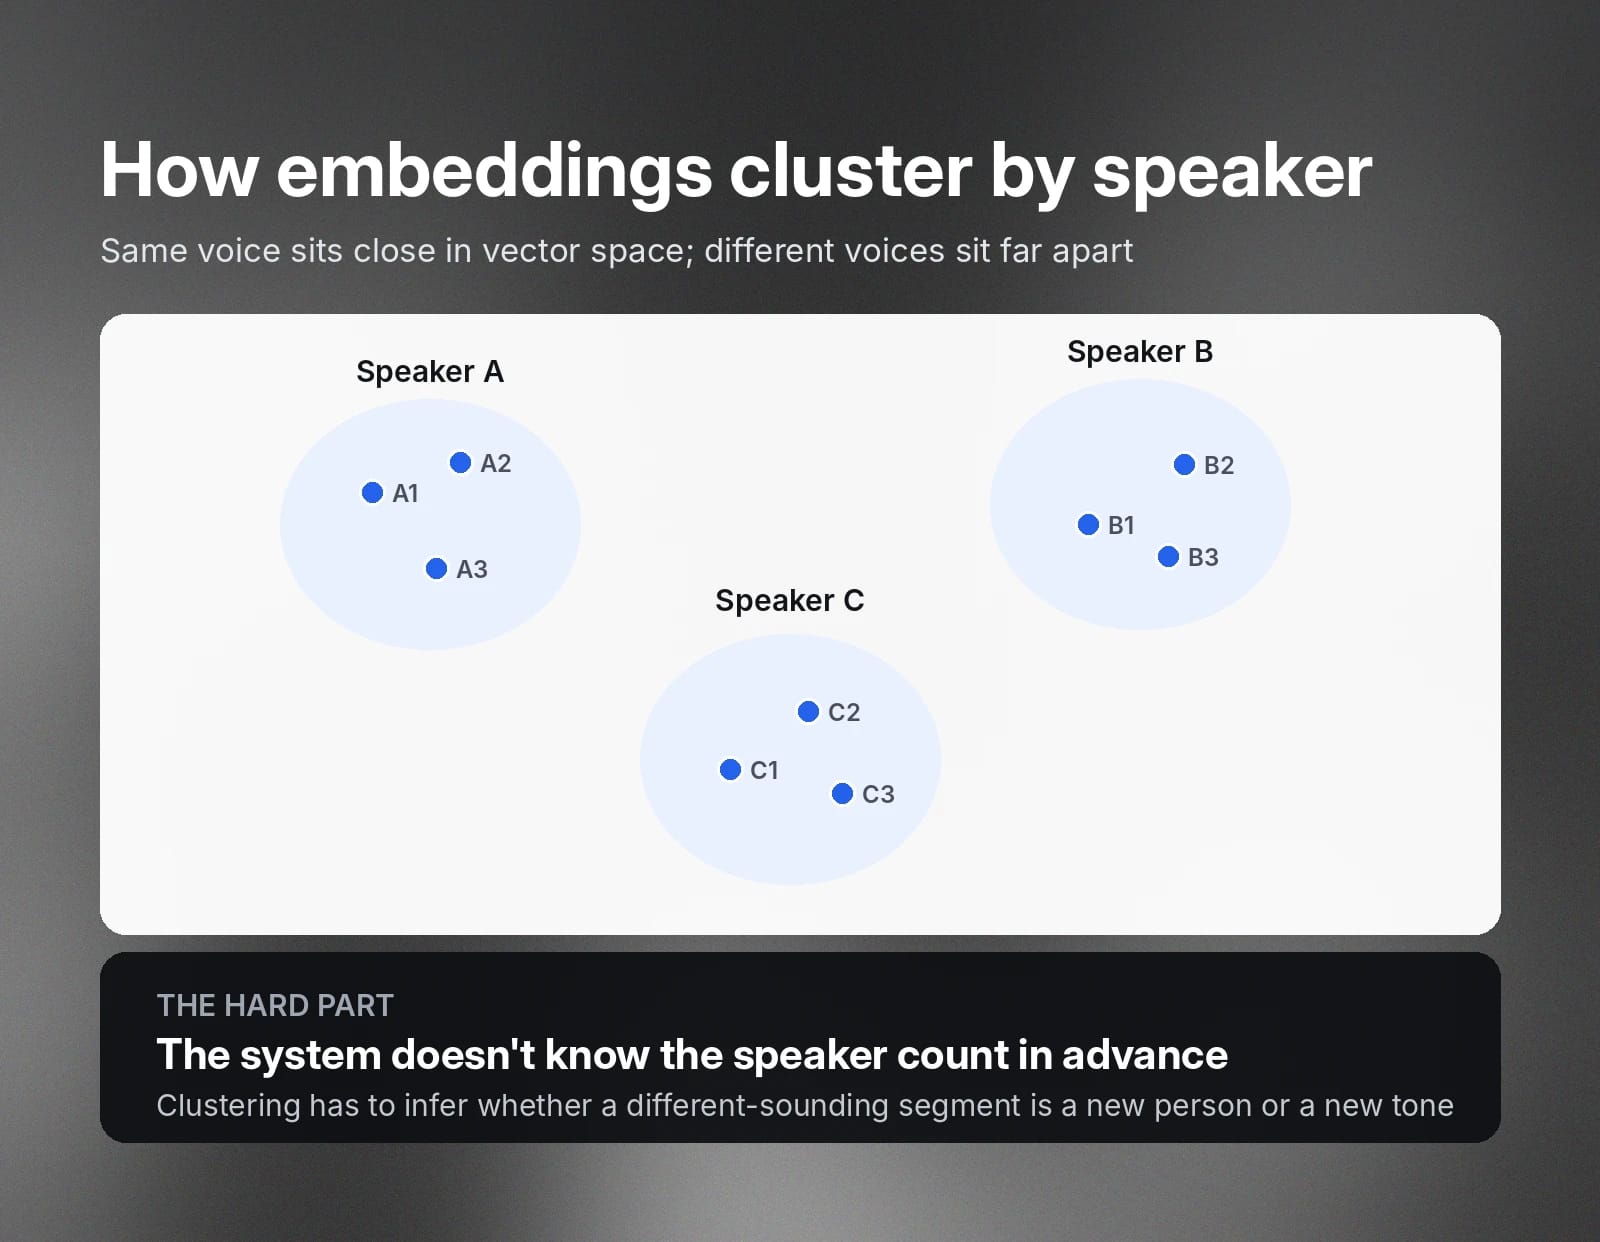
Ogni segmento di parlato viene convertito in un embedding del parlante, ovvero un vettore numerico che cattura le caratteristiche vocali di chi parla in quel segmento. Gli embedding dello stesso parlante si raggruppano nello spazio vettoriale, mentre quelli di parlanti diversi si trovano più distanti.
Clustering
Gli embedding vengono poi raggruppati affinché i segmenti dello stesso parlante condividano un'etichetta. In genere il sistema non conosce in anticipo il numero di parlanti, quindi l'algoritmo di clustering deve dedurlo, stabilendo se quel segmento dal suono leggermente diverso appartiene a un nuovo parlante o alla stessa persona che parla con un tono diverso.
L'output è un insieme di etichette dei parlanti associate a intervalli temporali, solitamente abbinato a una trascrizione. Ad esempio, una trascrizione diarizzata di una chiamata tra due persone appare così:
- [speaker_0] Grazie per aver chiamato. Come posso aiutarti?
- [speaker_1] Ciao, chiamo per la mia fattura del mese scorso.
- [speaker_0] Certo, controllo subito.
Le etichette sono anonime e coerenti internamente. Speaker_0 è la stessa voce ogni volta che compare, ma il sistema non sa che speaker_0 si chiama Fergal. L'associazione di identità reali è un'attività diversa, che vedremo più avanti.
Differenze principali tra segmentazione e identificazione dei parlanti
La segmentazione e l'identificazione dei parlanti si sovrappongono strettamente alla diarizzazione, perciò spesso le tre vengono confuse tra loro.
Ognuna risolve un problema leggermente diverso, quindi è importante comprenderne la distinzione quando si valutano gli strumenti.
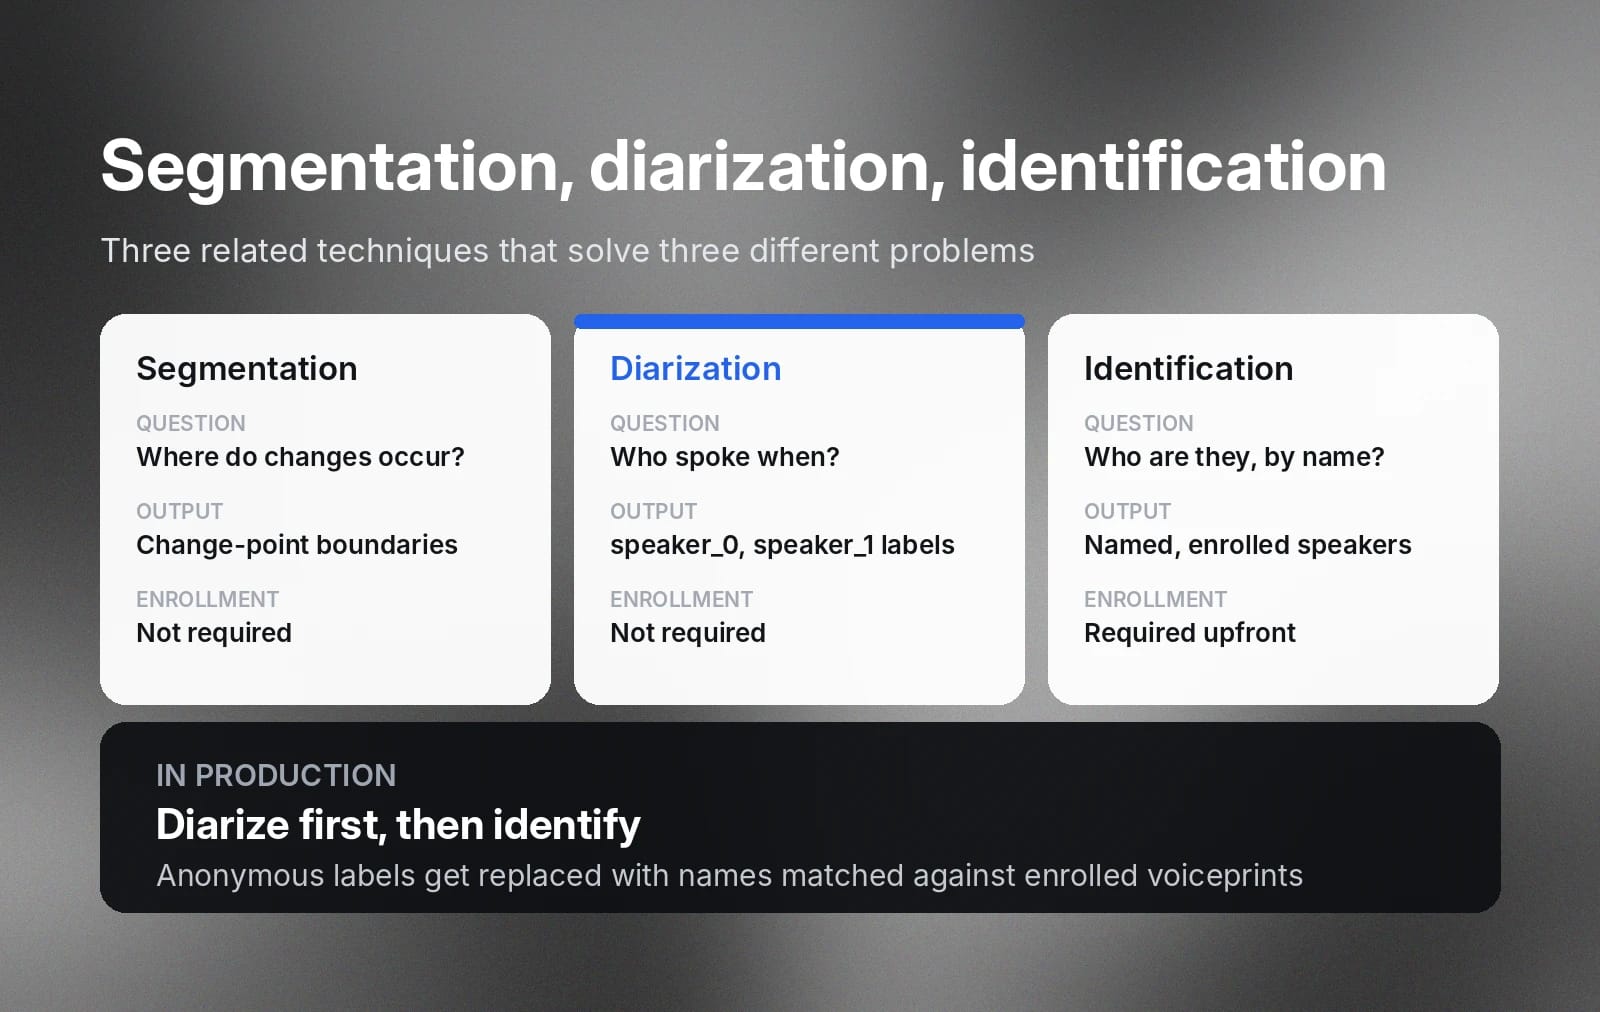
Come spiegato in precedenza, la segmentazione dei parlanti è una fase della diarizzazione che avviene all'inizio della pipeline. Individua i confini in cui si passa da una voce a un'altra, senza assegnare etichette. La segmentazione ti indica che si è verificato un cambiamento a 0:42. La diarizzazione si basa su questo raggruppando i segmenti risultanti e producendo un output completamente etichettato, così sai che la voce a 1:15 è la stessa che ha parlato all'inizio della registrazione.
L'identificazione dei parlanti è una funzionalità distinta dalla diarizzazione, ma spesso viene combinata con essa. L'identificazione determina chi siano effettivamente quei parlanti. Un sistema di identificazione confronta le voci con impronte vocali registrate, usando un riferimento di parlanti noti per restituire le identità. Dopo l'identificazione, speaker_0 e speaker_1 diventano "Fergal" ed "Eric".
Molti prodotti combinano questi strumenti per produrre una trascrizione finale più completa. Uno strumento per riunioni potrebbe farlo automaticamente, magari recuperando anche informazioni come il nome impostato da una persona su Teams o Meet, così che il contributo di ogni partecipante venga attribuito per nome senza alcuna revisione manuale.
Strumenti e librerie open source popolari per la diarizzazione dei parlanti
Vale la pena considerare gli strumenti open source per la diarizzazione dei parlanti quando hai bisogno di controllo, flessibilità o deployment locale. La scelta migliore dipende dal tipo di audio che gestisci, come chiamate telefoniche, riunioni, podcast o trasmissioni, dai tuoi requisiti di latenza e dal tempo di sviluppo che puoi investire.
Ecco alcune delle opzioni più popolari.
Pyannote.audio
Pyannote.audio è un toolkit basato su PyTorch creato specificamente per la diarizzazione dei parlanti e una delle opzioni open source più usate. Offre pipeline preaddestrate che coprono l'intero stack di diarizzazione, tra cui VAD, segmentazione, embedding e clustering, oltre ai componenti necessari per addestrare o sottoporre a fine-tuning i modelli sui tuoi dati.
I suoi modelli preaddestrati sono distribuiti tramite Hugging Face e vengono comunemente usati come livello di diarizzazione in progetti di trascrizione più ampi.
WhisperX
WhisperX combina Whisper di OpenAI ASR con la diarizzazione e l'allineamento forzato. Whisper da solo produce trascrizioni di qualità, ma non assegna etichette ai parlanti e i suoi timestamp sono solo approssimativi. WhisperX aggiunge l'allineamento dei timestamp a livello di parola e integra la diarizzazione basata su pyannote, producendo trascrizioni in cui ogni parola ha sia un timestamp accurato sia un'etichetta del parlante.
NVIDIA NeMo
NVIDIA NeMo include la diarizzazione nell'ambito del suo più ampio framework di IA conversazionale. Fornisce modelli di diarizzazione addestrabili, inclusi approcci end-to-end che gestiscono il parlato sovrapposto, ed è pensato per team che sviluppano sistemi vocali personalizzati su larga scala con infrastruttura GPU.
Ognuno di questi strumenti richiede di gestire l'infrastruttura di diarizzazione, inclusi deployment dei modelli, scalabilità, monitoraggio e aggiornamenti. Per i team che non vogliono questo sovraccarico operativo, le API gestite per la diarizzazione del parlato offrono un'alternativa più semplice. Possono integrarsi nei workflow esistenti oppure gestire l'intera pipeline di diarizzazione, risultando adatte a casi d'uso in produzione, come le analisi del supporto clienti, la trascrizione di riunioni e l'elaborazione di podcast.
Diarizzazione in tempo reale: sfide e casi d'uso
La diarizzazione in tempo reale è molto più difficile della diarizzazione di una registrazione completata, perché il sistema deve prendere decisioni con un contesto incompleto.
Un sistema offline visualizza l'intera registrazione prima di prendere qualsiasi decisione. Può confrontare una voce al minuto 2 con una al minuto 40 e stabilire con sicurezza che appartengono allo stesso parlante, perché ha entrambi i momenti a disposizione contemporaneamente. Un sistema in tempo reale non ha mai questo vantaggio: deve etichettare il parlato nell'istante in cui arriva, senza accesso a ciò che viene detto dopo e con poche o nessuna possibilità di rivedere una decisione una volta presa.
La mancanza di questo contesto futuro rende molto più difficili da risolvere in tempo reale tre problemi specifici:
- Latenza e accuratezza: Senza la possibilità di analizzare l'intera conversazione avanti e indietro, rispettare tempi di risposta più stretti va direttamente a discapito dell'accuratezza.
- Parlato sovrapposto: Quando le persone parlano una sopra l'altra, un sistema in grado di rielaborare l'audio potrebbe separarle. Un sistema in tempo reale deve forzare l'assegnazione a un'unica etichetta o affidarsi al volo a modelli specializzati nella gestione delle sovrapposizioni.
- Enunciati brevi: Un rapido "sì" o "vai pure" fornisce a malapena al sistema abbastanza voce su cui lavorare e, senza contesto circostante a cui affidarsi, deve comunque assegnare subito un'etichetta.
Nonostante la difficoltà, alcune applicazioni non possono aspettare che una registrazione finisca. Sottotitolazione in tempo reale per riunioni e trasmissioni richiede etichette dei parlanti mentre le persone parlano. Software per call center che fornisce indicazioni agli agenti durante una chiamata deve sapere in tempo reale quali parole usa il cliente. Gli agenti vocali che gestiscono chiamate con più partecipanti devono tracciare senza ritardi chi chiede cosa. In ogni caso, un sistema leggermente meno accurato ma immediato è preferibile a uno più accurato ma in ritardo.
Per i carichi di lavoro che non richiedono realmente etichette in tempo reale, come analisi, revisioni di conformità normativa e generazione di trascrizioni, la diarizzazione batch resta la scelta migliore perché è significativamente più accurata.
Come valutare le prestazioni della diarizzazione dei parlanti
Quando misuri l'accuratezza della diarizzazione, le due metriche più importanti sono il tasso di errore di diarizzazione (DER), che rileva l'accuratezza complessiva, e il tasso di errore di Jaccard (JER), che verifica se tale accuratezza si mantiene per ogni parlante.
Il DER calcola specificamente la frazione del tempo di parlato totale attribuita in modo errato. Combina tre tipi di errore:
- Falso allarme di parlato: Il sistema ha etichettato un segmento come parlato quando nessuno stava parlando.
- Parlato non rilevato: Qualcuno stava parlando, ma il sistema lo ha etichettato come silenzio.
- Confusione tra parlanti: Il parlato è stato rilevato ma attribuito al parlante sbagliato.
DER = (falsi allarmi + parlato non rilevato + confusione tra parlanti) / durata totale del parlato
Un DER del 10% significa che gli errori equivalgono a un decimo del tempo di parlato totale, considerando questi tre tipi. Più basso è, meglio è, e i punteggi sono confrontabili solo se misurati sugli stessi dati nelle stesse condizioni. Il DER varia enormemente in base alla qualità dell'audio, al numero di parlanti e alla quantità di sovrapposizioni nella registrazione.
Il tasso di errore di Jaccard (JER) misura separatamente l'accuratezza della diarizzazione per ogni parlante, quindi calcola la media del risultato su tutti i parlanti. Per ciascun parlante di riferimento, il valutatore associa l'etichetta del parlante più vicina del sistema e confronta il tempo in cui coincidono correttamente con il tempo totale assegnato a uno dei due parlanti.
Ad esempio, immagina una riunione di 60 minuti in cui il parlante A parla per 50 minuti e il parlante B per 10. Un sistema di diarizzazione etichetta correttamente 48 dei 50 minuti del parlante A, ma solo 4 dei 10 minuti del parlante B. Il suo DER complessivo potrebbe comunque sembrare relativamente buono, perché la maggior parte della riunione appartiene al parlante A. Il JER attribuisce uguale peso al risultato scarso del parlante B, perché valuta i parlanti A e B in modo indipendente prima di calcolare la media dei loro punteggi.
JER_speaker = 1 - (correct_overlap / (ref_time + sys_time - correct_overlap))
Il JER finale è la media di questi tassi di errore per parlante:
JER = (1 / N) * Σ[JER_speaker_i] per i = 1..N
Monitorare sia DER sia JER offre un quadro più completo dell'accuratezza della diarizzazione: il DER per l'accuratezza complessiva, il JER per verificare che tale accuratezza si mantenga per ogni partecipante, incluse le persone che parlano meno spesso.
Test su audio rappresentativo della produzione
Quando valuti un sistema di diarizzazione dei parlanti, calcola sia DER sia JER su audio che corrisponde alle tue effettive condizioni di deployment: il numero tipico di parlanti, la qualità dell'audio e la quantità di conversazioni sovrapposte.
I punteggi benchmark pubblicati possono essere misurati su dataset puliti e controllati, come registrazioni in studio, che raramente corrispondono al suono di vere registrazioni di chiamate o riunioni dal vivo. Un sistema con buoni risultati nei benchmark può comunque avere prestazioni significativamente inferiori su audio del mondo reale rumoroso e sovrapposto. Testalo sui tuoi dati prima di scegliere un prodotto di diarizzazione.
Inizia con ElevenAPI per la diarizzazione dei parlanti
Se sei pronto a creare una funzionalità di trascrizione con supporto per più parlanti, Scribe v2 di ElevenLabs rende la diarizzazione dei parlanti disponibile tramite una singola API di Speech to Text. Invia l'audio all'endpoint con diarize=true e la risposta JSON etichetta ogni parola con un ID del parlante, per un massimo di 32 parlanti, in oltre 90 lingue e su file fino a 10 ore.
Due opzioni estendono l'output standard della diarizzazione. Per le registrazioni delle chiamate, detect_speaker_roles=true etichetta i parlanti come agente e cliente anziché con numeri anonimi. Se il tuo workspace ha profili di parlanti registrati, use_speaker_library=true può associare i parlanti rilevati alle voci registrate, unendo diarizzazione e identificazione in un'unica richiesta.
Un parametro di soglia per la diarizzazione ti consente di regolare il compromesso tra un'eccessiva suddivisione e l'unione dei parlanti. E quando i parlanti sono già isolati su canali audio separati, come nelle registrazioni stereo delle chiamate, la trascrizione multicanale assegna i parlanti in base al canale e ignora completamente la diarizzazione.
La guida rapida a Speech to Text illustra passo dopo passo la prima integrazione. Per i deployment regolamentati, la piattaforma è conforme a SOC 2, ISO 27001, PCI DSS L1 e HIPAA, con residenza dei dati nell'UE e modalità senza conservazione dei dati disponibili.
Vuoi integrare la diarizzazione dei parlanti nei tuoi sistemi? Inizia ottenendo la tua chiave API oppure dai un'occhiata alla documentazione di ElevenLabs per saperne di più.
FAQ

Jack Limebear fa parte del team Growth e si occupa di scrivere contenuti e definire strategie per il blog e le pagine insights. Prima di arrivare in ElevenLabs, ha guidato la strategia dei contenuti per oltre dieci anni in realtà che vanno da startup SaaS in rapida crescita a grandi aziende Fortune 500. Ha conseguito un Master in Letteratura Inglese presso l’Università di Cambridge.


