Modelli a cascata vs modelli fusi: come l’architettura determina se il tuo agente vocale è pronto per l’enterprise
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
La maggior parte delle persone pensa che gli agenti vocali siano costruiti con un'architettura a cascata o fusa. In pratica, gli agenti vengono progettati lungo uno spettro tra le due, con cinque architetture comunemente utilizzate a seconda dell'applicazione.
L'architettura dell'agente determina la sua capacità di operare in modo affidabile in produzione, adattarsi a requisiti aziendali specifici e suonare naturale nelle conversazioni. Un'architettura basata sulla fusione, come il modello Realtime di OpenAI, può risultare sorprendentemente realistica negli scambi brevi. Ma quando i team devono applicare guardrail di conformità, eseguire il debug di una risposta non riuscita o sostituire l'LLM con uno più potente quando ne viene lanciato uno il mese prossimo, una singola rete fusa offre poche possibilità.
In ElevenLabs utilizziamo un'architettura avanzata basata su cascata. Sfruttiamo componenti specializzati per il riconoscimento vocale, il ragionamento e la generazione del parlato, per offrire alti livelli di intelligenza e affidabilità. Aggiungiamo prosodia contestuale, ottimizzazione per bassa latenza e gestione intelligente dei turni di parola affinché le conversazioni risultino naturali. L'abbiamo progettata così perché le aziende e le istituzioni pubbliche con cui lavoriamo richiedono agenti che suonino realistici e siano affidabili in produzione anche per attività complesse.
In questo articolo esaminiamo le cinque principali architetture, i loro punti di forza, i loro limiti e il modo in cui concepiamo la base per gli agenti impiegati in workflow critici.
Cosa valutano i team nella scelta di un'architettura
Le domande che i team si pongono rientrano in genere in tre categorie.
Può gestire attività complesse?
- Ragionamento e flessibilità del modello: puoi scegliere i modelli migliori per il tuo caso d'uso, inclusi gli LLM disponibili più potenti, e aggiornarli quando diventano disponibili opzioni migliori?
- Logica dell'agente: puoi definire e controllare i flussi conversazionali, le regole decisionali e i percorsi di escalation seguiti dal tuo agente?
- Uso degli strumenti: l'architettura può supportare tool calling in più passaggi e integrazioni con sistemi esterni?
Suonerà e sembrerà umano?
- Prosodia: l'agente offre ritmo, intonazione e tono emotivo naturali?
- Latenza: le risposte sono abbastanza rapide da rendere la conversazione naturale?
- Gestione dei turni: l'agente sa quando parlare, fare una pausa o cedere il turno?
Posso fidarmi in produzione?
- Affidabilità: l'agente si comporta in modo prevedibile e coerente o tende a peggiorare nel tempo?
- Guardrail: l'architettura può applicare protezioni contro risposte indesiderate o utenti ostili?
- Trasparenza: l'architettura produce output intermedi o è una scatola nera?
I compromessi tra architetture a cascata e fuse
Le architetture basate su cascata vengono create concatenando componenti specializzati: Speech to Text (STT), un modello linguistico di grandi dimensioni e Text to Speech (TTS). Ogni fase può essere ottimizzata, testata e aggiornata in modo indipendente.
Architettura a cascata
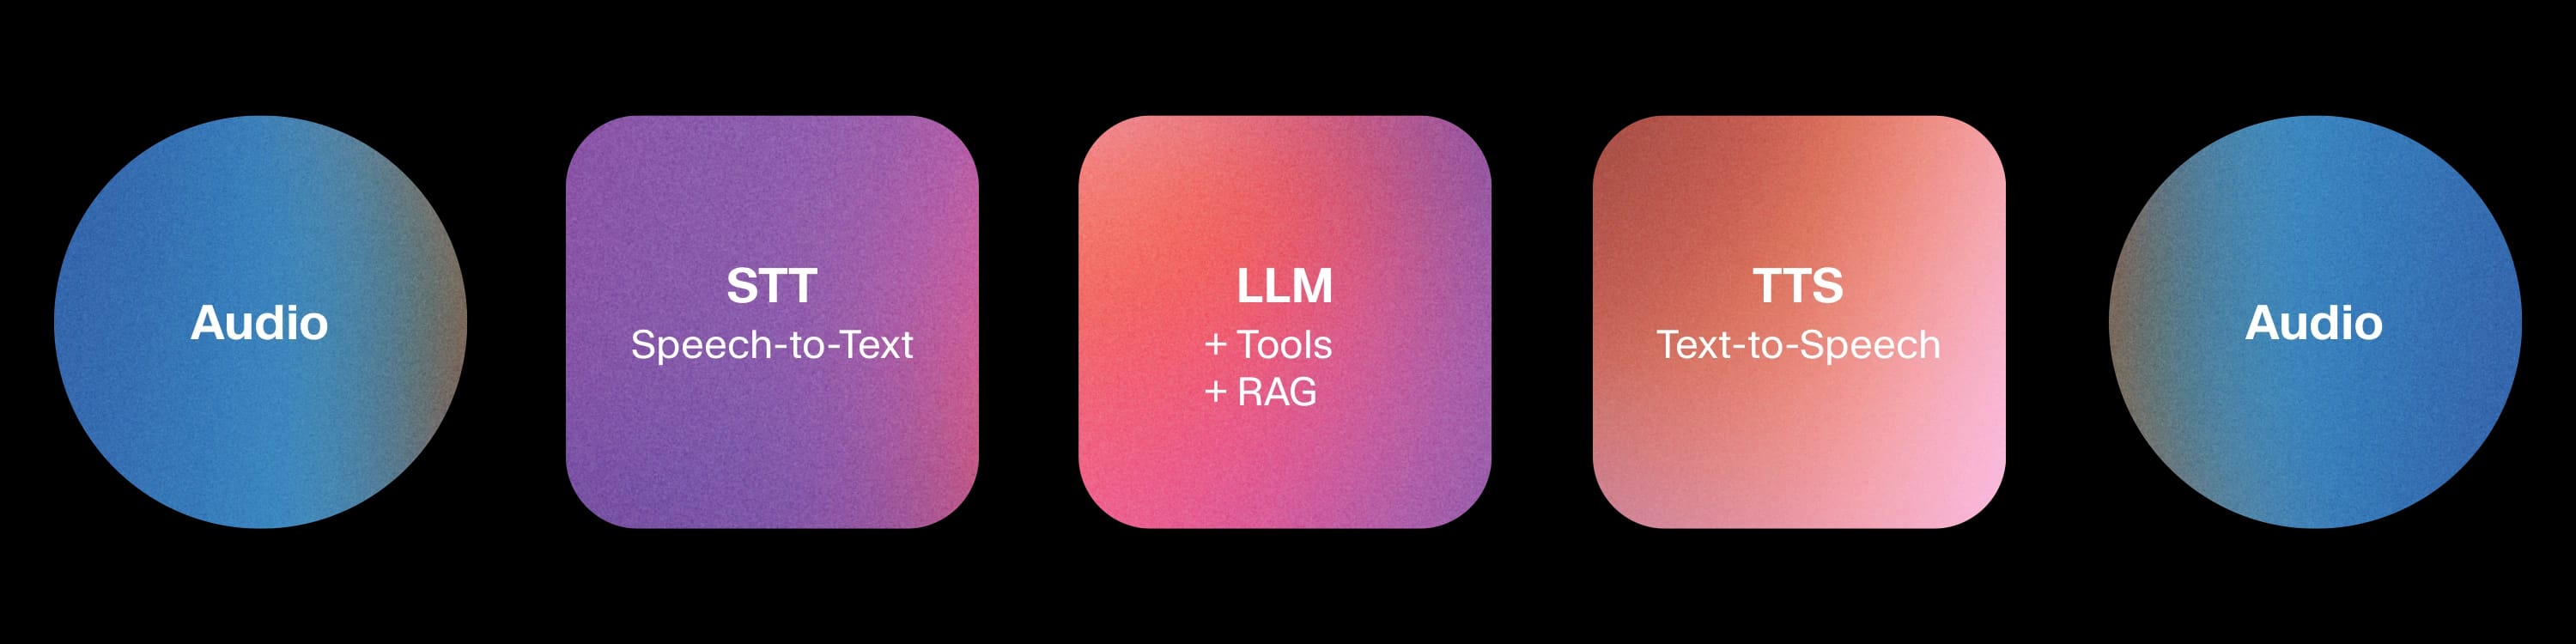
Questa modularità è ciò che rende le architetture a cascata la base della maggior parte degli agenti di livello enterprise. Ogni fase produce output ispezionabili: testo leggibile tra STT e LLM, e tra LLM e TTS. I guardrail possono essere applicati a livello testuale, l'ultimo LLM di frontiera può essere integrato senza modificare i modelli vocali e, quando qualcosa non funziona, in genere è possibile identificare l'origine del problema.
La critica di lunga data alle architetture a cascata è che perdono i segnali prosodici. Il parlato viene ridotto a testo e intonazione, ritmo ed emozione devono essere ricostruiti in fase di output. Questi segnali possono essere recuperati in parte tramite modellazione esplicita, ma non vengono acquisiti con la stessa naturalezza degli approcci fusi. Altre dimensioni, come latenza e gestione dei turni, possono in genere essere ottimizzate fino a livelli di prestazioni comparabili in entrambi gli approcci.
Modello fuso
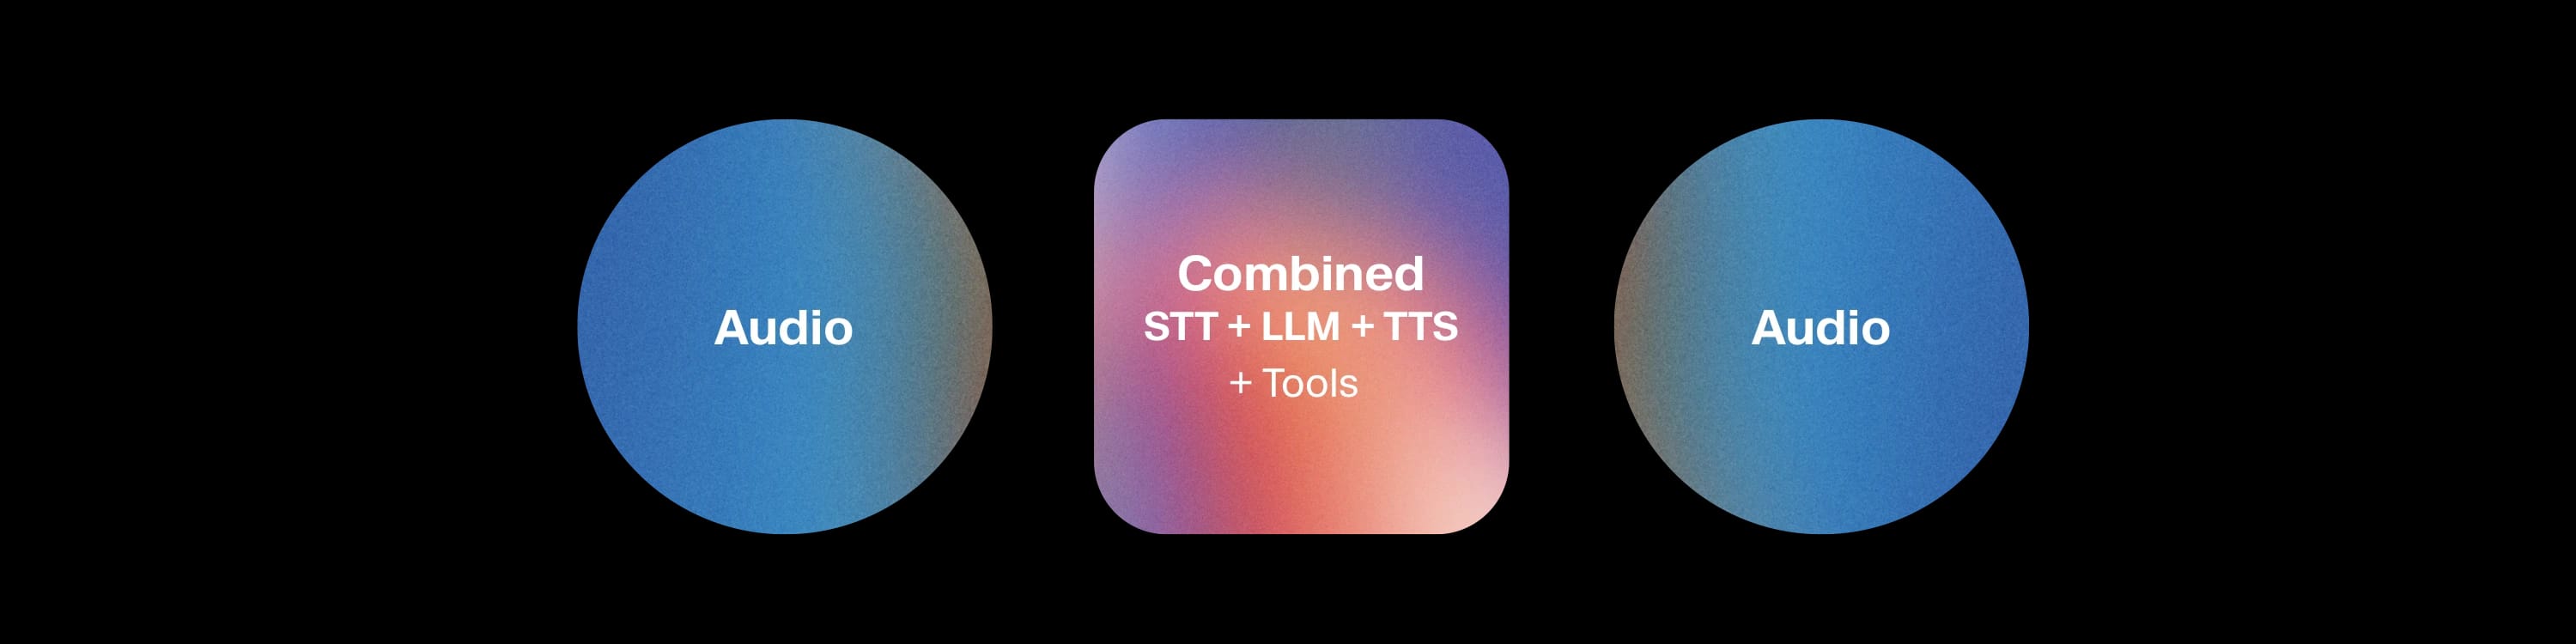
Le architetture fuse adottano un approccio profondamente diverso. Riconoscimento, ragionamento e generazione avvengono tutti all'interno di un'unica rete multimodale. L'audio entra e l'audio esce, senza alcun livello ispezionabile nel mezzo.
L'assenza di fasi intermedie è al tempo stesso il vantaggio e il limite. Un'architettura fusa può preservare naturalmente i segnali prosodici, perché il parlato non viene mai scomposto in testo. Tuttavia, la capacità di applicare guardrail, sostituire singoli componenti o ispezionare gli output intermedi per il debug è limitata. Esistono inoltre vincoli sul fine-tuning dell'STT per la terminologia specifica di un settore o sull'integrazione di un LLM diverso per un ragionamento e un tool calling più efficaci. Il sistema è una sola rete e i team sono vincolati alle capacità di ragionamento con cui viene fornita, che oggi significa core più leggeri, incapaci di eguagliare gli LLM di frontiera nelle attività complesse.
Le cinque architetture
1. Cascata di base
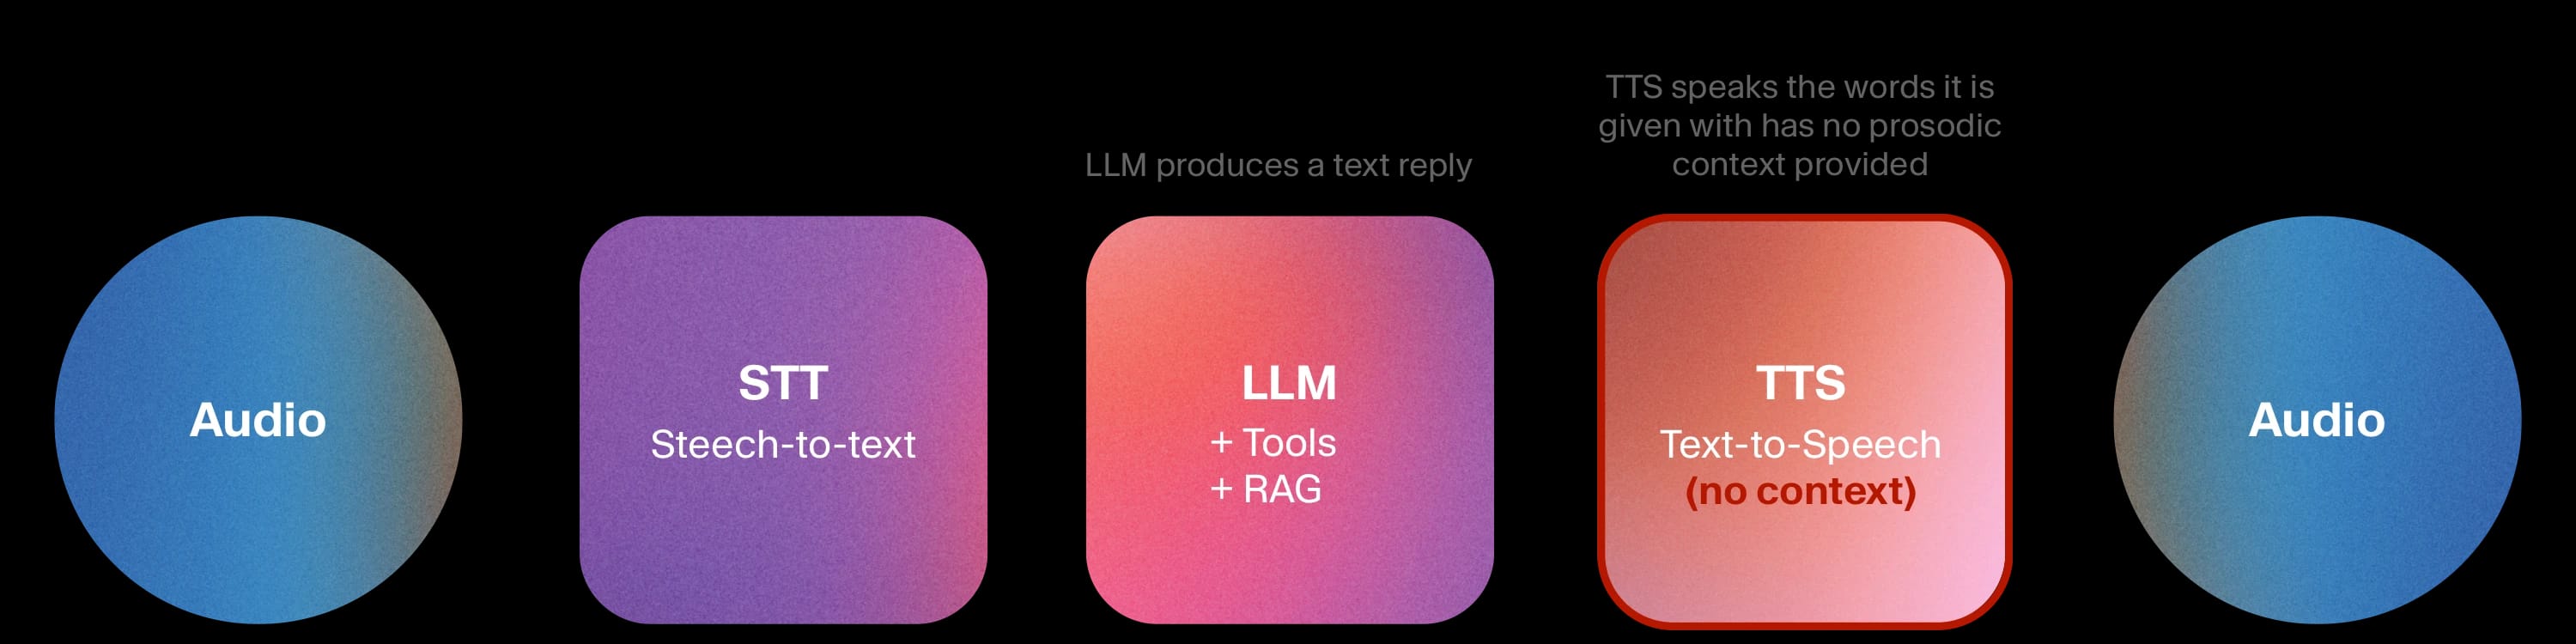
L'audio viene trascritto, l'LLM genera una risposta testuale e il TTS la pronuncia. Ogni fase opera su testo semplice, quindi puoi vedere, testare e controllare tutto.
I vantaggi in termini di affidabilità sono evidenti: guardrail a livello testuale, flussi conversazionali deterministici e tracce di audit complete. Poiché l'LLM è un componente autonomo, puoi abbinare l'agente al modello di frontiera che offre le migliori capacità di ragionamento o tool calling e aggiornarlo non appena ne viene lanciato uno migliore. Il punto debole è la qualità della conversazione: senza TTS contestuale, l'agente suona funzionale ma piatto. Non c'è adattamento emotivo né variazione prosodica, un aspetto accettabile per comunicare il saldo di un conto ma inadeguato per gestire un cliente frustrato.
Esempi di casi d'uso:
- Sostituzione dei sistemi IVR nelle telecomunicazioni e nei servizi di pubblica utilità
- Gestione delle FAQ per l'onboarding SaaS
- Notifiche in uscita, come conferme di appuntamenti, promemoria per prescrizioni e avvisi di consegna, dove la coerenza conta più del calore umano
2. Cascata avanzata
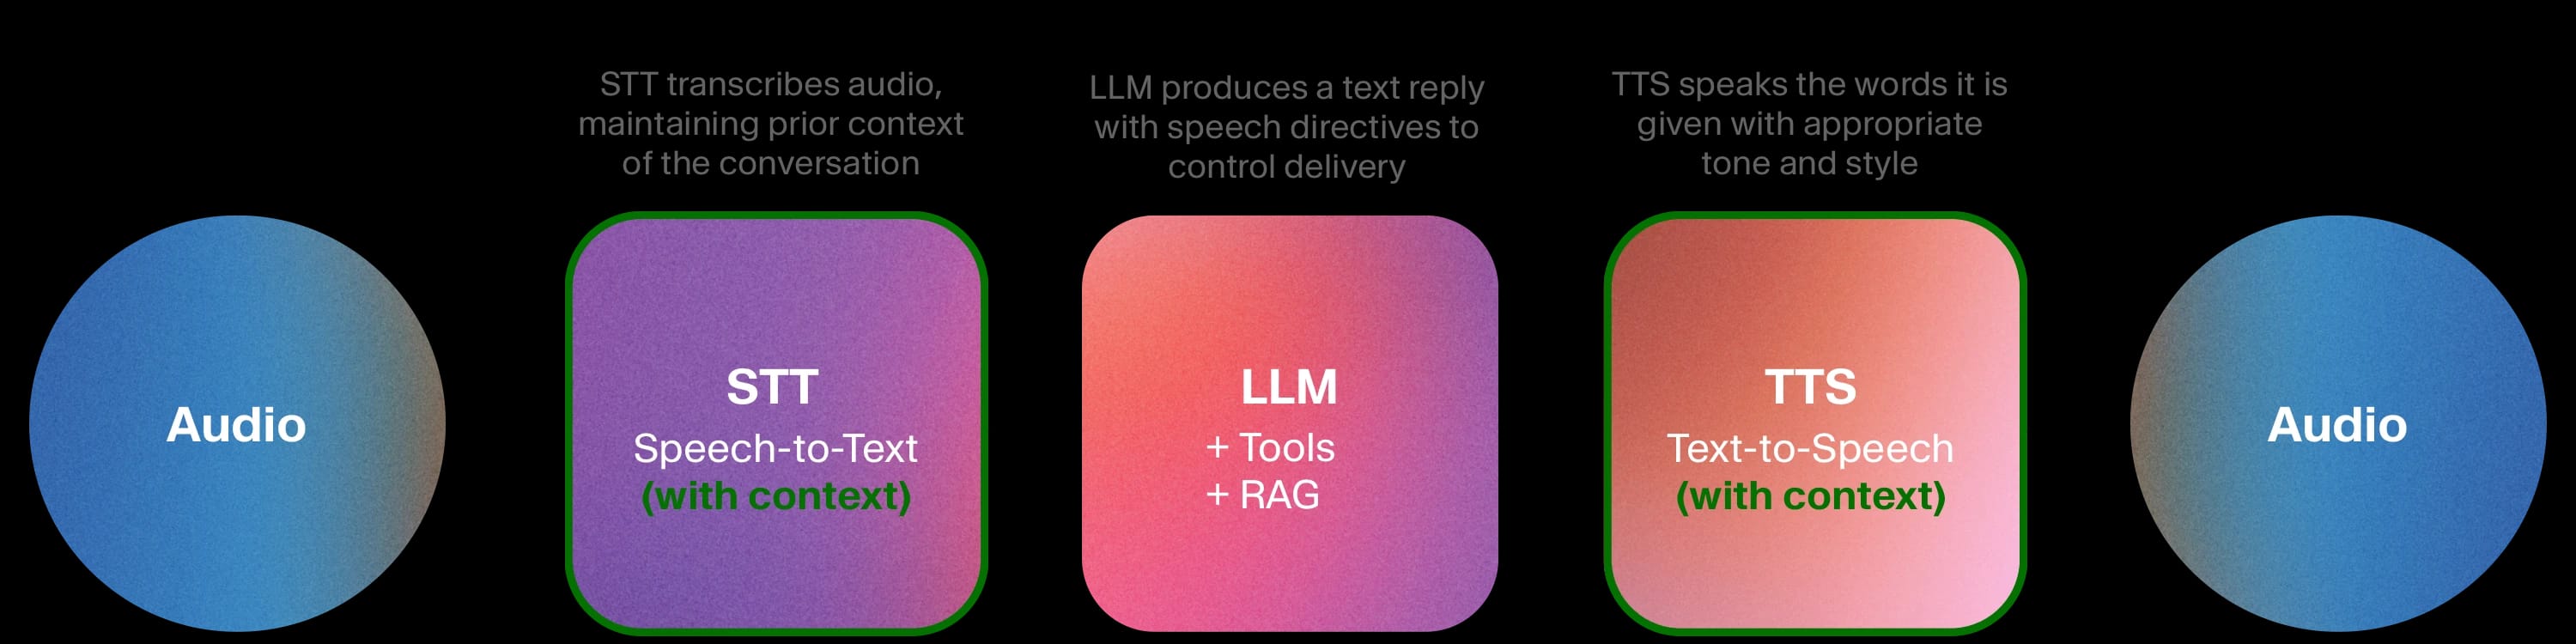
La stessa architettura modulare, ma ora più componenti operano con un contesto più ricco. È ciò che abbiamo realizzato con Expressive Mode in ElevenAgents.
Il modello STT Scribe v2 Realtime produce trascrizioni rapide e accurate, basandosi sul contesto precedente della conversazione. A partire dal testo, l'LLM indica al TTS come pronunciare il parlato, non solo cosa dire, ad esempio "in modo rassicurante", "con enfasi", "con urgenza", adattando dinamicamente il tono durante la conversazione. Il sistema di gestione dei turni utilizza gli stessi segnali, consentendo all'agente di stabilire quando rispondere e quando cedere il turno. I modelli vocali sono co-localizzati in un unico stack senza passaggi di rete tra i componenti, quindi la latenza rimane bassa.
L'architettura mantiene tutto ciò della cascata di base: piena trasparenza, guardrail a livello testuale, componenti sostituibili, ottimizzazione per dominio e accesso ai modelli di tool calling e ragionamento più potenti disponibili. Offre miglioramenti significativi nella prosodia, nella latenza e nella gestione dei turni. I team possono integrare un nuovo LLM di frontiera nella settimana del suo lancio oppure eseguire il fine-tuning di STT per il settore sanitario senza ricostruire nessun altro componente.
Esempi di casi d'uso:
- Assistenza clienti per i servizi finanziari, dove un tono empatico nelle chiamate relative a un addebito contestato si combina con rigorosi guardrail di conformità e la registrazione completa delle interazioni
- Addetti all'accoglienza in ambito sanitario che smistano le chiamate dei pazienti con la dovuta urgenza, flussi conformi all'HIPAA e riconoscimento vocale ottimizzato per il dominio della terminologia medica
- Assistenti alle vendite che mantengono un tono cordiale e persuasivo, seguendo al contempo un playbook strutturato e inviando aggiornamenti al CRM
3. Cascata e fusione ibride
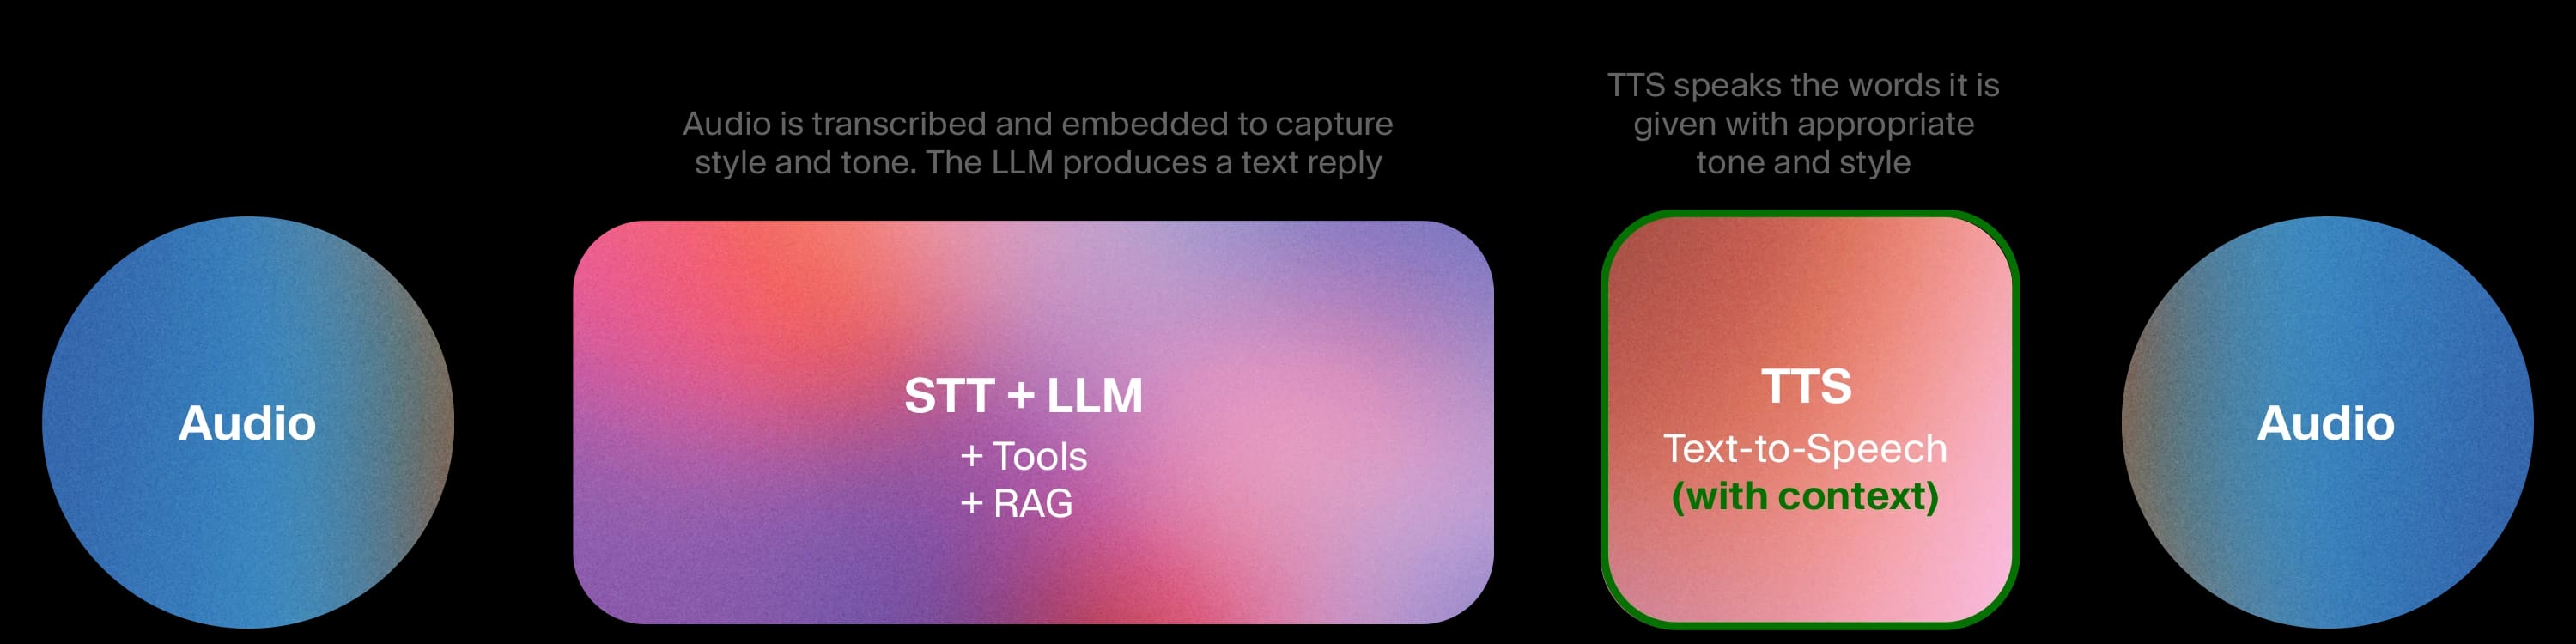
Alcune architetture inviano le caratteristiche acustiche del parlato in input, come pronuncia, emozione e tono, direttamente all'LLM sotto forma di embedding, anziché convertirle prima in testo. Il TTS rimane modulare.
Questo fornisce all'LLM informazioni più ricche su come è stato detto qualcosa, non solo su cosa è stato detto, un aspetto prezioso per applicazioni specifiche. Il blocco ASR+LLM fuso è più difficile da sottoporre ad audit rispetto a un chiaro passaggio di testo, perché la rappresentazione intermedia è un embedding, non qualcosa che un essere umano può leggere. Anche l'LLM non è più facilmente sostituibile, limitando le tue capacità di ragionamento e tool calling al modello su cui è stato costruito il blocco fuso.
Esempi di casi d'uso:
- Apprendimento delle lingue e coaching della pronuncia, dove ascoltare come parla uno studente è importante quanto ciò che dice
- Assistenza sensibile al tono e a bassa complessità, dove rilevare la frustrazione è importante ma l'attività stessa è semplice.
4. Fusione sequenziale
Un singolo modello multimodale gestisce riconoscimento, ragionamento e generazione in un unico passaggio, un turno alla volta.
La prosodia può essere efficace. Poiché il parlato non viene mai scomposto in testo, il modello preserva naturalmente ritmo, intonazione e segnali emotivi. Le conversazioni brevi possono suonare straordinariamente fluide.
Ma senza un livello testuale la capacità di applicare guardrail è limitata, così come gli output intermedi per il debug e la flessibilità di sostituire l'LLM con uno migliore o di eseguire il fine-tuning dell'STT per il tuo dominio. I core di ragionamento tendono a essere più leggeri degli LLM di frontiera, quindi il tool calling complesso e le attività in più passaggi ne risentono. Quando l'attività richiede di risolvere un problema complesso, la sola prosodia non basta.
Esempi di casi d'uso:
- Compagni virtuali personali, chatbot di intrattenimento e applicazioni in cui l'espressività favorisce il coinvolgimento e i requisiti di conformità sono minimi.
5. Fusione duplex
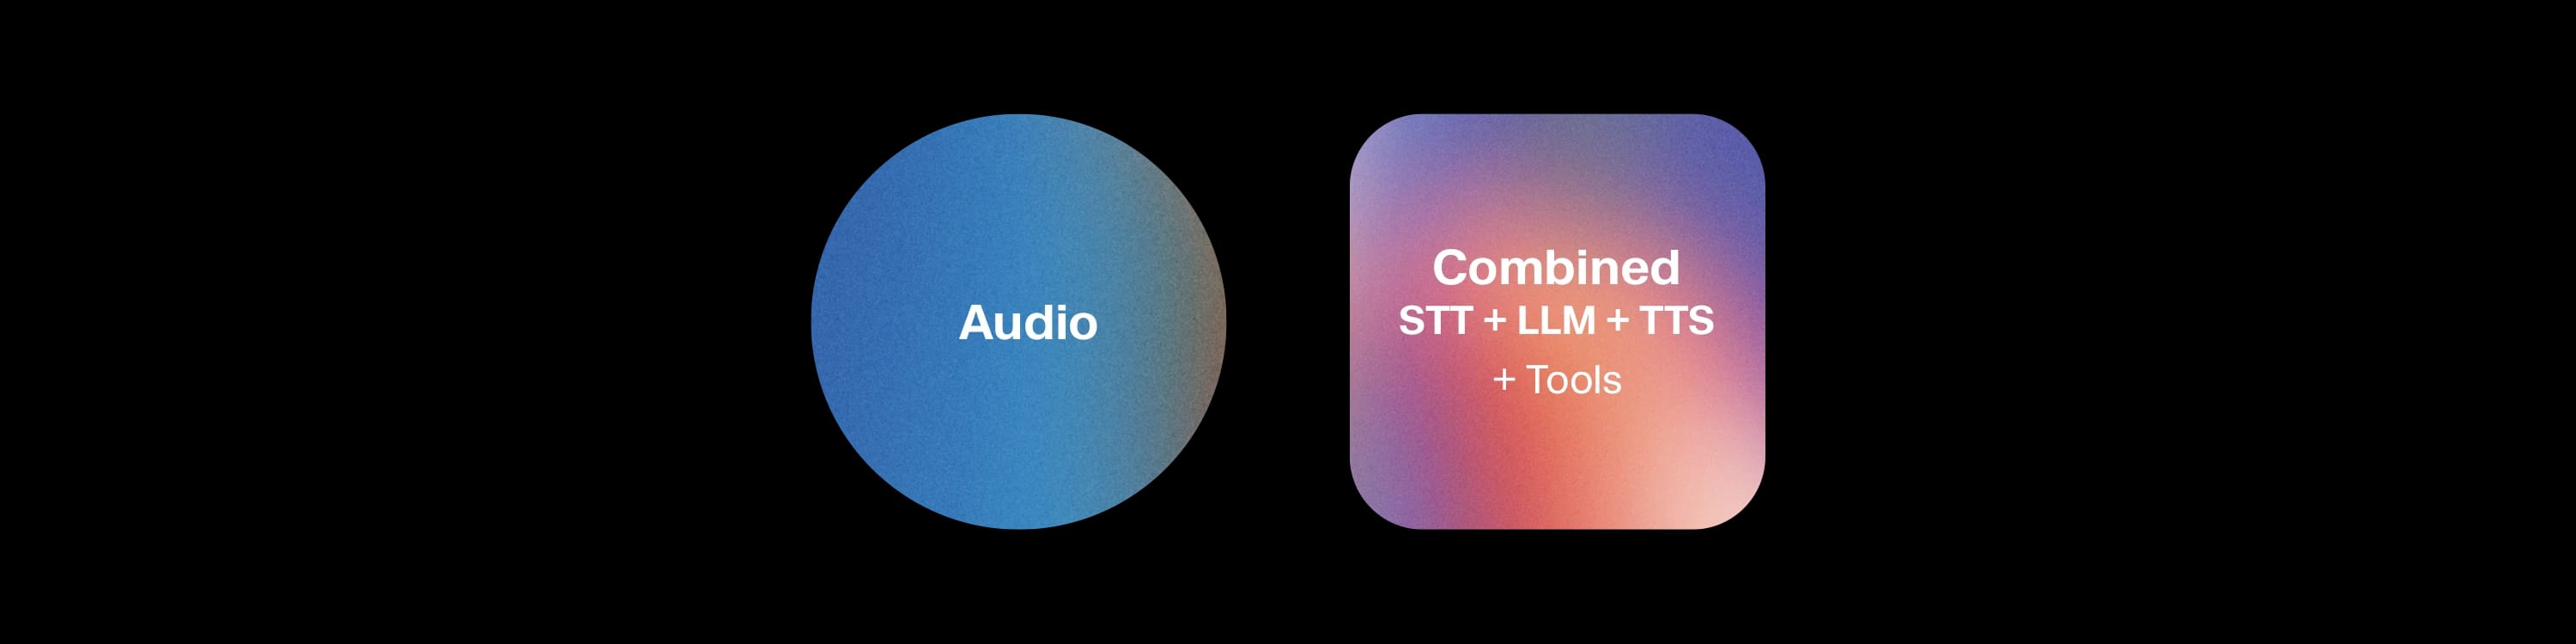
Input e output vengono elaborati simultaneamente, con il modello che ascolta e parla nello stesso momento. Questo può rendere gli scambi brevi sorprendentemente naturali, con sovrapposizioni vocali autentiche e passaggi di turno fluidi.
È anche l'architettura più difficile da controllare, i guardrail sono molto difficili da applicare e il crosstalk introduce errori imprevedibili. Ispezione, registrazione e debug sono estremamente difficili e il sistema è in gran parte chiuso, con possibilità minime di sostituire componenti, ottimizzare per dominio o personalizzare. Il ragionamento e l'uso degli strumenti sono ancora più limitati rispetto ai modelli a fusione sequenziale, perché l'elaborazione simultanea lascia meno capacità per una logica complessa. E la stessa elaborazione simultanea che rende naturali gli scambi brevi rende instabili le conversazioni più lunghe.
Esempi di casi d'uso:
- App sperimentali con compagni virtuali, piattaforme vocali social e demo di ricerca in cui un comportamento imprevedibile è accettabile.
Scegliere l'architettura giusta per il tuo caso d'uso
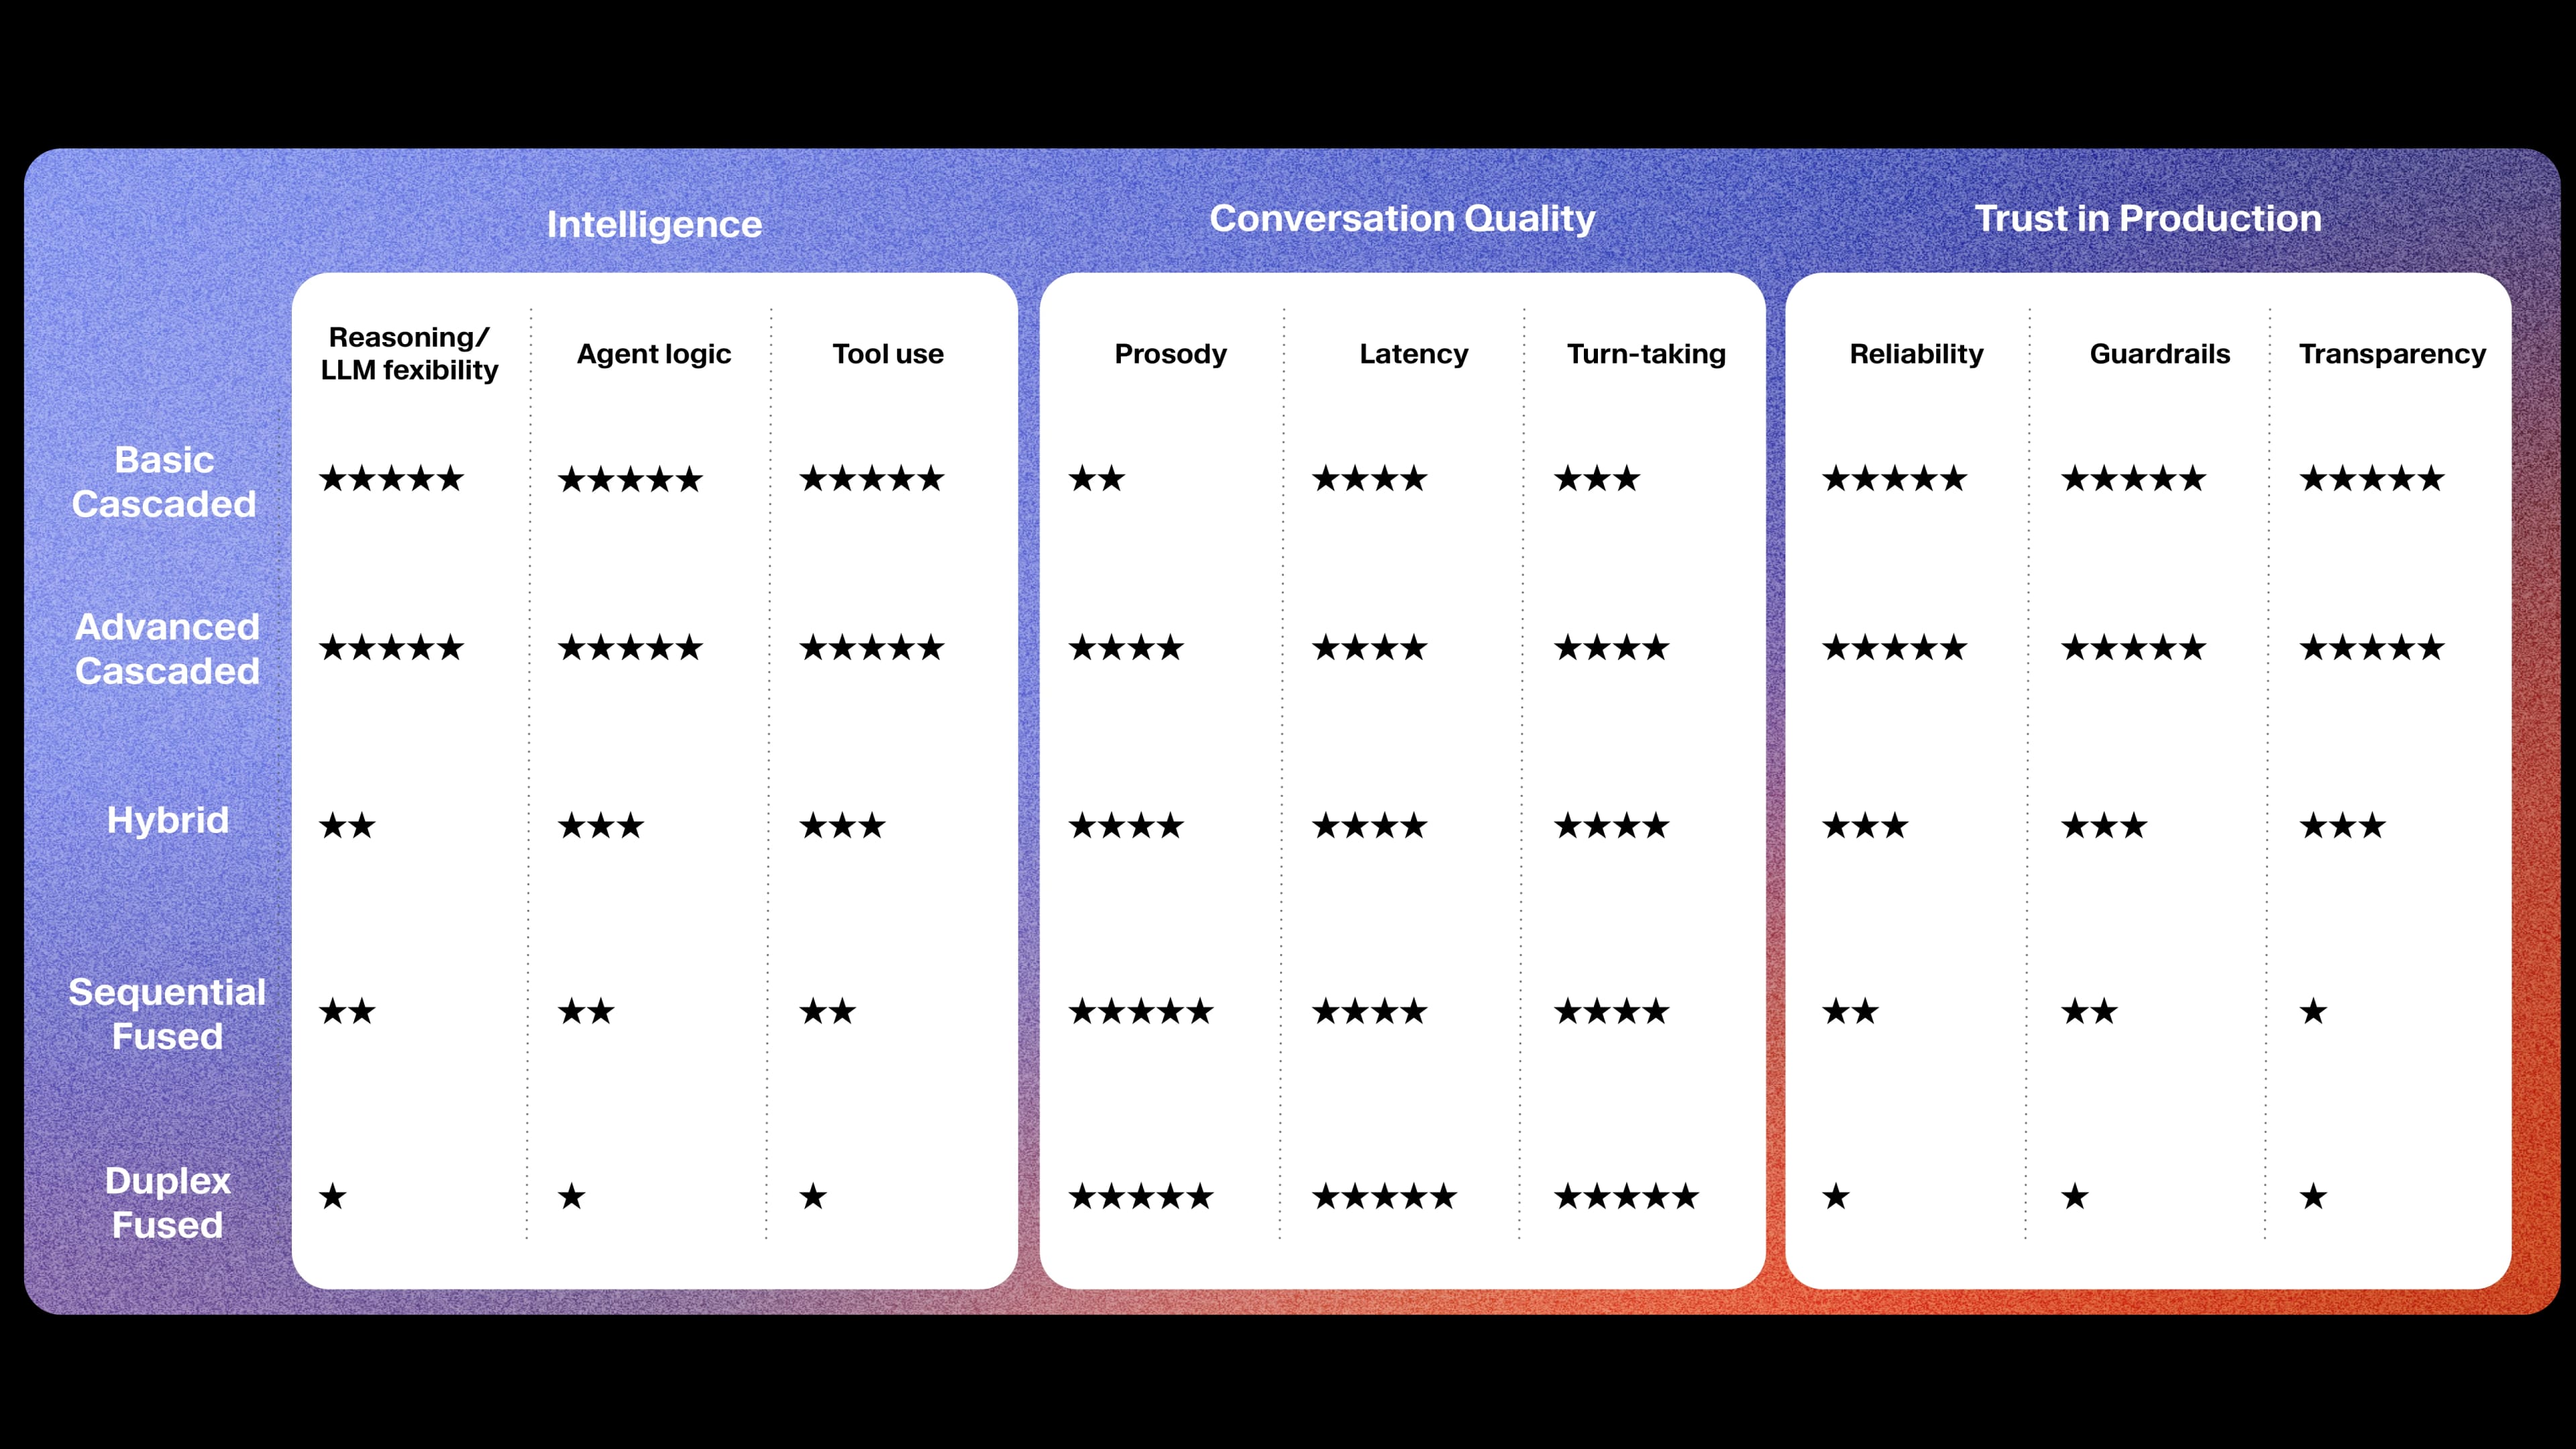
L'architettura giusta dipende dai requisiti di una determinata applicazione. Se stai creando un'esperienza in cui un parlato naturale è la funzionalità principale, le architetture fuse offrono vantaggi concreti, se sei disposto a scendere a compromessi su ragionamento di frontiera, guardrail e trasparenza. Sebbene i modelli fusi siano in vantaggio nella prosodia, i sistemi avanzati a cascata si avvicinano ogni trimestre, mentre i modelli fusi non hanno compiuto progressi significativi nel ragionamento complesso o nell'affidabilità a causa di limiti architetturali.
Per la maggior parte delle aziende e delle istituzioni pubbliche, l'architettura migliore è quella che suona bene ed è al contempo capace, personalizzabile, affidabile e pronta per il deployment su larga scala. Per questo abbiamo scelto di sviluppare ElevenAgents con un'architettura avanzata a cascata, investendo in Expressive Mode e in modelli best-in-class e co-ottimizzati per Speech to Text e Text to Speech. Questo consente ai team di creare agenti con alti livelli di intelligenza, affidabilità e controllo, uniti a un parlato naturale e simile a quello umano.
Man mano che gli agenti IA si diffondono nell'assistenza clienti, nell'istruzione, negli assistenti personali e in altri ambiti, quelli che avranno successo si baseranno su architetture adatte alle loro applicazioni specifiche.