Analisi del motore di orchestrazione di ElevenAgent
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
ElevenAgents si basano su un motore di orchestrazione a bassa latenza progettato appositamente per le conversazioni in tempo reale, con un sovraccarico inferiore a 100 ms. Questa architettura combina il meglio della ricerca di ElevenLabs con LLM di frontiera di fornitori leader come OpenAI, Google e Anthropic, oltre a modelli open source selezionati forniti da ElevenLabs. Utilizzando più modelli nelle varie fasi della pipeline di risposta, l'agente assicura conversazioni altamente reattive e consapevoli del contesto. Sfruttando dinamicamente e in modo combinato i punti di forza di ciascun modello, otteniamo prestazioni affidabili e scalabili per diverse attività aziendali e scenari conversazionali, ottimizzando al contempo l'equilibrio tra intelligenza, velocità e costi.
In questo articolo spieghiamo come questi modelli lavorano insieme per offrire le funzionalità essenziali di cui gli agenti hanno bisogno per operare in ambienti complessi e, più nello specifico, quale modello vede quali token e quando. Al centro c'è la gestione della cronologia della conversazione nei diversi punti dell'interazione. Vedremo di nuovo come e dove viene condivisa la cronologia della conversazione, per chiarirne il ruolo nell'orchestrazione sia per gli agenti indipendenti sia per i workflow multi-agente.
Agente indipendente
Iniziamo analizzando l'agente indipendente e i suoi componenti principali. È ragionevole considerare che un agente minimamente utile abbia un system prompt, accesso a diversi strumenti e a una knowledge base. I clienti dovrebbero preferire gli agenti indipendenti ai workflow quando il loro caso d'uso richiede una verifica limitata di una rigida sequenza di passaggi oppure quando è importante evitare silos informativi tra gli agenti. I silos informativi si creano quando alcuni strumenti, documenti o contesti storici sono accessibili ad alcuni sotto-agenti ma non ad altri. Sono intrinseci ai workflow multi-agente e comportano un compromesso tra flessibilità e determinismo.
Per gli agenti indipendenti di ElevenLabs, è importante capire come:
- Creano richieste di generazione efficaci
- Recuperano e integrano documenti pertinenti
- Generano ed eseguono chiamate di strumenti per informare le risposte dell'agente
- Producono risultati per la valutazione e la raccolta dati
Creare il contesto della conversazione
Una conversazione tra un cliente e un agente ElevenLabs è una serie di turni, ognuno dei quali è composto da uno scambio di messaggi tra le due parti. Questo elenco alternato di messaggi dell'agente e dell'utente costituisce il punto di partenza per creare il contesto della conversazione. Durante ogni turno, l'LLM sottostante riceve richieste di generazione contenenti una serie alternata di messaggi dell'agente e dell'utente, con un messaggio in più rispetto al turno precedente. Naturalmente, questa serie di messaggi è preceduta da un singolo messaggio di sistema che rappresenta il system prompt dell'agente.
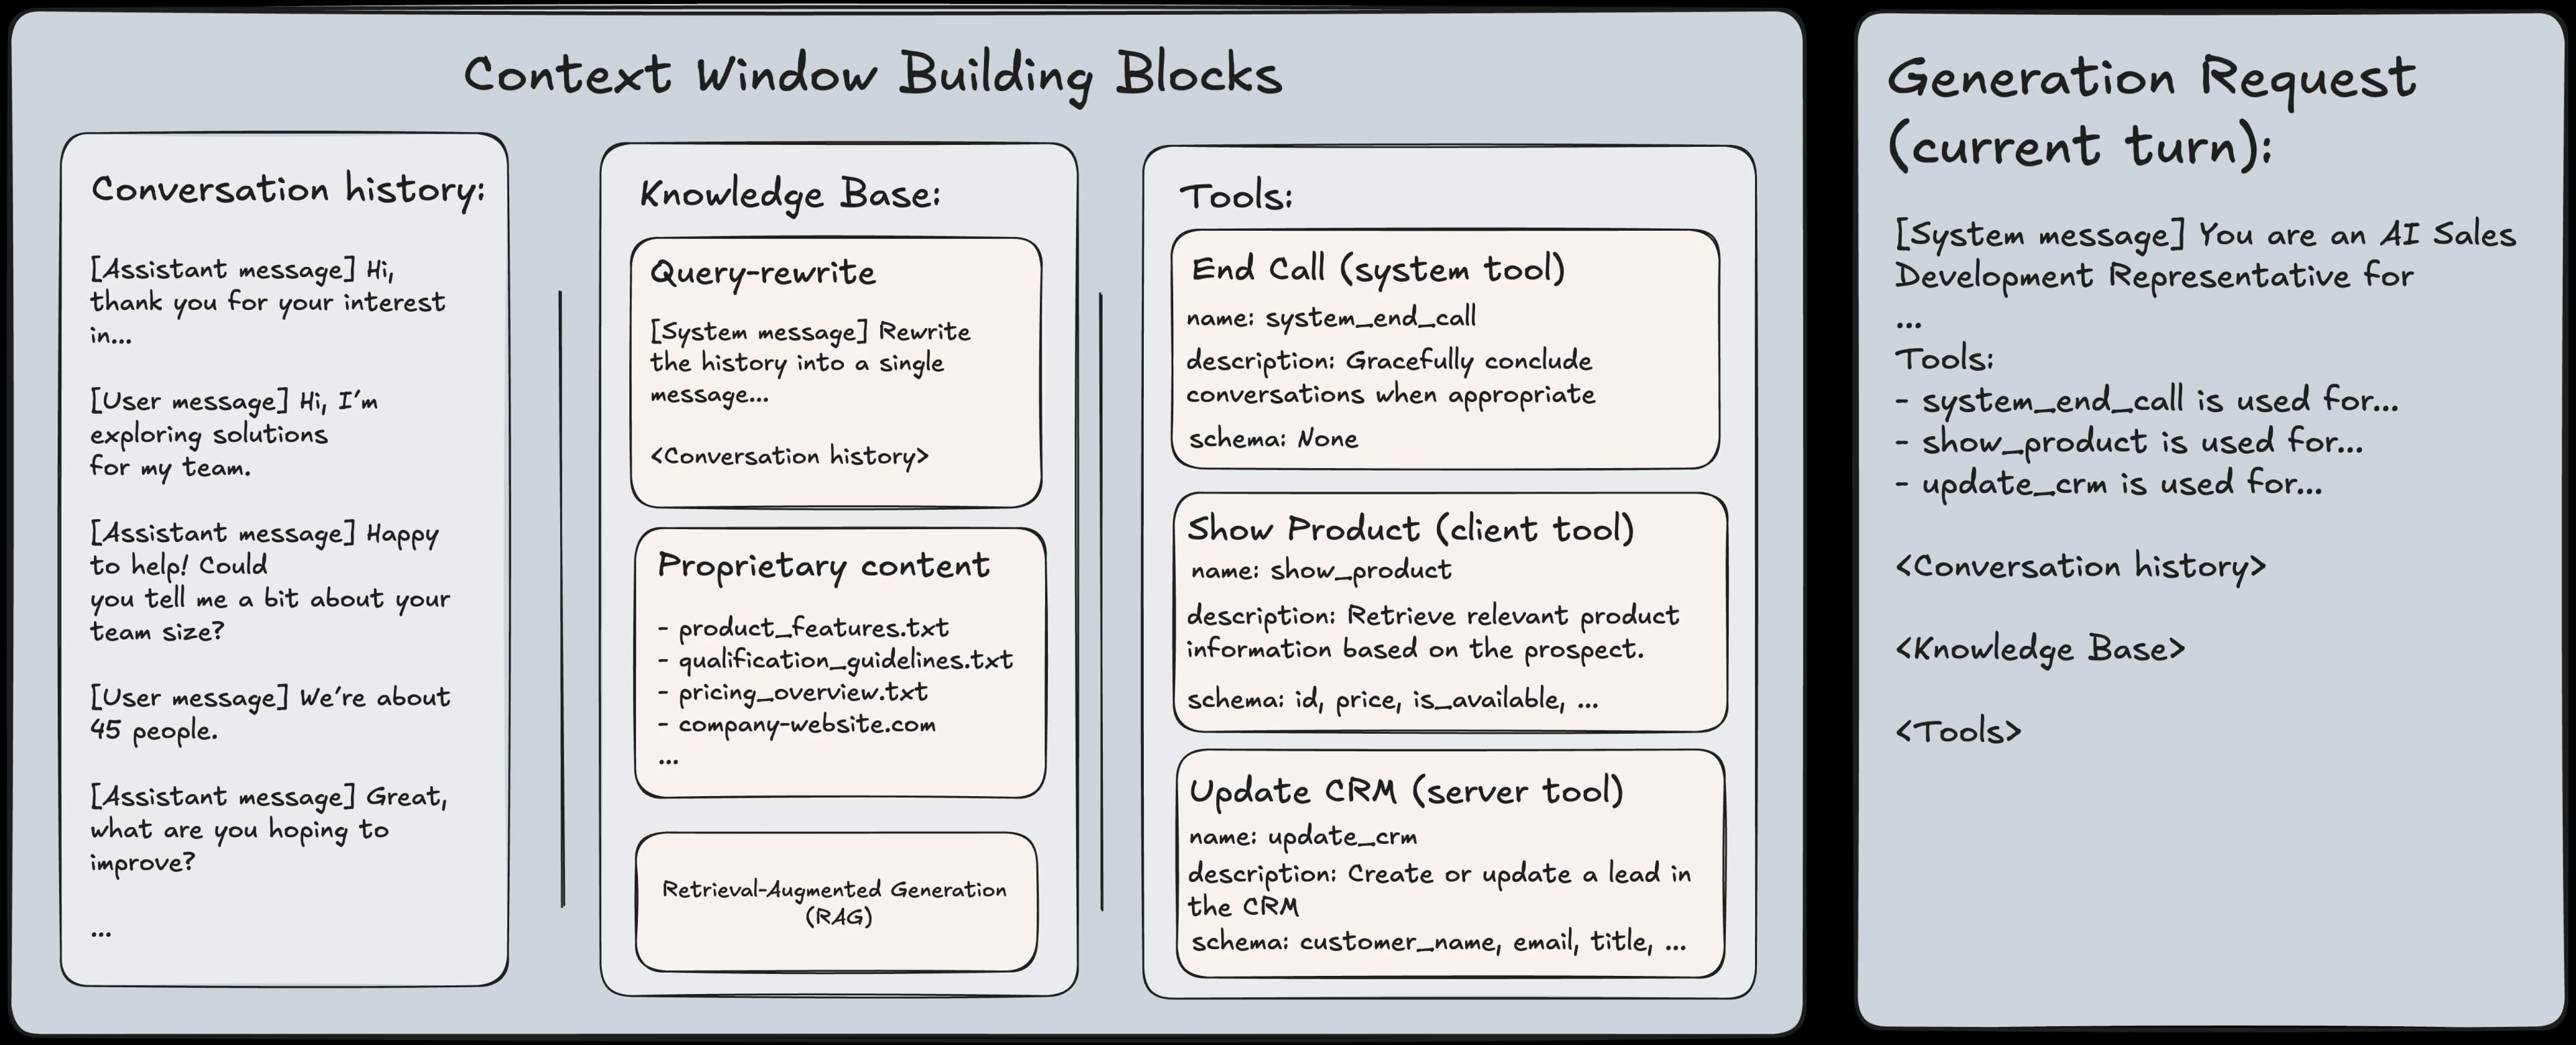
L'orchestratore di ElevenLabs riduce la latenza percepita dell'LLM prevedendo quando un utente ha finito di parlare. In alcuni casi, ciò può comportare più richieste di generazione all'LLM con lo stesso contesto della conversazione all'interno di un singolo turno. Sebbene l'orchestrazione ottimizzi la rapidità con cui gli agenti rispondono, la qualità delle risposte dipende altrettanto da come si accede alla conoscenza. Man mano che progrediscono, i clienti in genere iniziano a basare le risposte dei propri agenti su una combinazione di documentazione proprietaria e contenuti pubblici. Da diversi anni, la generazione aumentata dal recupero (RAG) è l'approccio standard per ottenere questo risultato. Knowledge Base di ElevenAgents si basano su RAG con un'architettura multi-modello ottimizzata, descritta in dettaglio in un articolo precedente. Questo consente di recuperare documenti in modo affidabile anche quando l'input più recente dell'utente è una domanda di follow-up, una conferma di un chiarimento o non contiene altrimenti una domanda esplicita.
Il recupero, tuttavia, è solo uno dei modi in cui gli agenti interagiscono con i sistemi esterni.
Eseguire azioni e recuperare informazioni con gli strumenti
Gli agenti ElevenLabs possono eseguire azioni nel mondo reale e recuperare informazioni in tempo reale durante una conversazione, grazie a un sistema di strumenti flessibile. Questa capacità comporta un'importante considerazione di progettazione: ogni strumento abilitato aumenta la dimensione del prompt serializzato, poiché il relativo nome, descrizione e schema dei parametri sono inclusi insieme al system prompt e alla cronologia della conversazione. Con l'aggiunta di più strumenti, aumenta anche il carico di ragionamento richiesto al modello per chiamare la sequenza corretta di strumenti. In Agent Builder, la descrizione dello strumento indica cosa fa e quali campi restituisce. Queste sono le informazioni che il modello linguistico usa per comprendere il contesto del suo utilizzo. Una volta definito lo strumento, le condizioni specifiche per invocarlo vanno inserite nel system prompt dell'agente. Ad esempio:
- Descrizione dello strumento lookup_order: “Recupera i dettagli dell'ordine di un cliente tramite l'ID dell'ordine. Restituisce lo stato dell'ordine, gli articoli acquistati, l'indirizzo di spedizione e il numero di tracciamento.”
- Istruzione del system prompt: “Dopo aver verificato l'identità del cliente, chiama lo strumento lookup_order per recuperare i dettagli del suo ordine.”
Questa separazione delle responsabilità mantiene le definizioni degli strumenti riutilizzabili tra gli agenti, consentendo al contempo al system prompt di ciascun agente di controllare il momento esatto in cui viene invocato uno strumento. Per aiutare i clienti a progettare efficacemente questi system prompt, forniamo indicazioni più approfondite nella nostra Guida al prompting. In questo framework, è possibile definire principalmente diversi tipi di strumenti:
- Strumenti webhook che chiamano API esterne.
- Strumenti client che inviano richieste di strumenti come eventi tramite il websocket della conversazione.
- Strumenti di sistema per azioni integrate come il trasferimento di chiamate.
- Strumenti MCP che si connettono a server Model Context Protocol.
Quando un agente decide di usare uno strumento, recupera dalla conversazione i dettagli necessari e invia una richiesta per eseguirlo. Quando lo strumento restituisce un risultato, questo viene aggiunto alla conversazione affinché il modello possa farvi naturalmente riferimento nella risposta successiva. Se necessario, l'output dello strumento può anche aggiornare le informazioni memorizzate dall'agente come variabile dinamica. Queste informazioni sono memorizzate come semplici coppie chiave-valore, estratte dalla risposta dello strumento tramite mapping predefiniti. Una volta impostate, queste variabili possono essere reintrodotte nell'agente tramite il suo system prompt, i parametri di strumenti futuri e le condizioni del workflow. Questo ciclo di feedback fornisce agli agenti una forma di memoria di lavoro che evolve durante le interazioni.
Sebbene questo descriva come gli strumenti si integrano nel ragionamento dell'agente, è possibile configurare anche la tempistica della loro esecuzione. Gli strumenti possono operare in una delle tre modalità di esecuzione, ciascuna adatta a una diversa esigenza conversazionale. In Modalità immediata, lo strumento viene eseguito non appena richiesto dall'LLM. È l'impostazione predefinita per ricerche rapide, in cui gli utenti si aspettano una risposta quasi istantanea, come la verifica dello stato di un ordine. Se combinata con il parlato prima dello strumento, l'agente genera innanzitutto una breve conferma, ad esempio “Fammi controllare”, e la restituisce all'utente mentre lo strumento viene eseguito in parallelo, riducendo al minimo i silenzi. Per gli strumenti più lenti, la piattaforma estende automaticamente questi messaggi di attesa in base al tempo di attesa previsto. Al contrario, la Modalità parlato dopo lo strumento ritarda l'esecuzione finché l'agente non ha finito di parlare. È essenziale per azioni con conseguenze nel mondo reale, come trasferire una chiamata, terminare una sessione o inviare un pagamento. L'utente ascolta il contesto completo, ad esempio “Ora ti trasferisco alla fatturazione”, e può interrompere prima che l'azione venga eseguita. La Modalità asincrona esegue lo strumento interamente in background senza interrompere la conversazione. Questa modalità è ideale per operazioni fire-and-forget, come inviare un'email, attivare un workflow esterno o registrare dati, per le quali l'agente non deve fare riferimento al risultato nella sua risposta.
Con l'esecuzione e l'orchestrazione configurate, il passo successivo è capire come misurare le prestazioni.
Misurare le prestazioni
Al termine di una chiamata con un Agent, i clienti potrebbero voler estrarre alcuni elementi della chiamata per ulteriori analisi e archiviazione, oppure determinare se la chiamata ha avuto successo. Qui entrano in gioco Raccolta dati e Criteri di valutazione. La Raccolta dati ti consente di estrarre informazioni strutturate dalla trascrizione di una chiamata per analisi e aggregazioni a valle. I clienti spesso esportano questi output nel proprio data lakehouse aziendale per attività di reporting o workflow di arricchimento. Ad esempio, un Sales Development Agent può estrarre automaticamente i dettagli di un potenziale cliente da una conversazione per creare o aggiornare un lead nel sistema di Customer Relationship Management (CRM). I Criteri di valutazione, invece, determinano se una chiamata è considerata riuscita. Se tutti i criteri configurati sono soddisfatti, la chiamata viene contrassegnata come riuscita; altrimenti, viene segnalata come non riuscita. Questo assicura che le conversazioni rispettino costantemente standard definiti di qualità e integrità, fornendo al tempo stesso un feedback rapido. Al termine di una chiamata, quando viene attivato il webhook post-chiamata, l'agente elabora la trascrizione definitiva, incluse eventuali esecuzioni di strumenti e metadati, tramite un LLM insieme a tutti i punti di raccolta dati e criteri di valutazione configurati. Il modello usa questo prompt combinato per determinare se ogni criterio di valutazione è soddisfatto e per estrarre i punti dati specificati per le analisi a valle. Poiché l'LLM interpreta queste configurazioni direttamente come parte del proprio prompt di input, è importante formattarle in modo chiaro e coerente affinché il modello possa comprenderle e applicarle con precisione. Consigliamo quindi le seguenti best practice per scrivere le descrizioni di Criteri di valutazione e Raccolta dati.
Criteri di valutazione
- Un obiettivo chiaro per criterio: una frase o un breve punto elenco è preferibile a più obiettivi in un unico criterio.
- Osservabile e basato sulla trascrizione: formula l'obiettivo in modo che sia possibile stabilire il successo o l'insuccesso dalla trascrizione (ciò che è stato detto, ciò che ha fatto l'agente, ciò che ha chiesto l'utente). Evita obiettivi che richiedono un contesto esterno di cui l'LLM non dispone.
- Esiti espliciti di successo/insuccesso/sconosciuto: l'LLM conosce già il contesto: per contrassegnare un risultato come riuscito, l'obiettivo deve essere soddisfatto; per contrassegnarlo come non riuscito, non deve esserlo; per contrassegnarlo come sconosciuto, non deve poterlo stabilire dalla trascrizione. L'obiettivo deve quindi essere scritto in modo che “soddisfatto” e “non soddisfatto” siano ben definiti; se è ambiguo, il modello potrebbe tendere verso classificazioni sconosciute o errate
- Mantienilo conciso: talvolta possono essere inviati insieme molti criteri di valutazione. Criteri troppo lunghi possono quindi aggiungere rumore e potenzialmente causare allucinazioni
- La lingua è importante: qualsiasi motivazione fornita dall'LLM sul fatto che un criterio di valutazione sia stato soddisfatto o meno sarà nella stessa lingua della descrizione del criterio, quindi è importante tenerne conto
Raccolta dati
- Descrivi esattamente cosa estrarre: la descrizione è il segnale principale per l'LLM. Indica cosa significa il campo, in quale situazione deve essere impostato e cosa fare quando non è chiaro (ad esempio, “Lascia null se il cliente non ha mai indicato una data preferita”).
- Corrispondenza con il tipo previsto: il valore fornito dall'LLM corrisponderà sempre al tipo di dati assegnato al punto di raccolta dati (ad esempio boolean, string, integer ecc.). La descrizione deve quindi essere coerente con tale tipo. Ad esempio, per integer puoi usare “Estrai il numero di articoli richiesti” e per boolean “Sì/no: il cliente ha accettato l'offerta”.
- Usa enum quando possibile: per il tipo string, se l'insieme di valori è fisso, usa enum nello schema; vincola il modello e riduce gli output non validi.
- Un obiettivo di estrazione per elemento: non inserire più informazioni non correlate nella descrizione di un elemento; suddividile in elementi separati, in modo che ogni chiamata abbia un unico obiettivo di estrazione chiaro.
- Mantieni brevi le descrizioni: le descrizioni possono contenere alcune frasi; non servono paragrafi lunghi. La trascrizione è già presente nel messaggio dell'utente, quindi sono sufficienti lo schema e una breve descrizione.
Attualmente, l'LLM utilizzato per questa fase di valutazione ed estrazione è fissato a un modello a bassa latenza per garantire un'elaborazione rapida. Nel prossimo futuro, prevediamo di introdurre opzioni per offrire ai clienti maggiore flessibilità.
Passiamo ora ai casi d'uso che richiedono orchestrazione strutturata, determinismo o specializzazione tra più ruoli conversazionali, per i quali i clienti possono invece usare i Workflow.
Workflow
I workflow offrono un'interfaccia visiva per progettare flussi di conversazione complessi. Producono l'oggetto logico che l'orchestratore usa per gestire più sotto-agenti, strumenti e trasferimenti sotto l'identificatore di un agente indipendente. I workflow introducono componenti aggiuntivi da considerare, oltre a quelli già descritti per gli agenti indipendenti, tra cui:
- L'interazione tra system prompt e obiettivi conversazionali dei sotto-agenti.
- La determinazione dell'attraversamento dei vari punti di transizione nel grafo.
Obiettivi conversazionali specializzati
I workflow riutilizzano le funzionalità degli agenti indipendenti per imporre comportamenti coerenti durante tutta l'interazione. Ciò include elementi condivisi come il system prompt di base, gli strumenti principali e le knowledge base globali, che devono essere sempre disponibili indipendentemente dalla parte attiva del workflow. Il system prompt generale è in genere responsabile della definizione del contesto conversazionale globale, del tono previsto, dei vincoli di sicurezza e di eventuali istruzioni specifiche del brand o valide per l'intero prodotto.
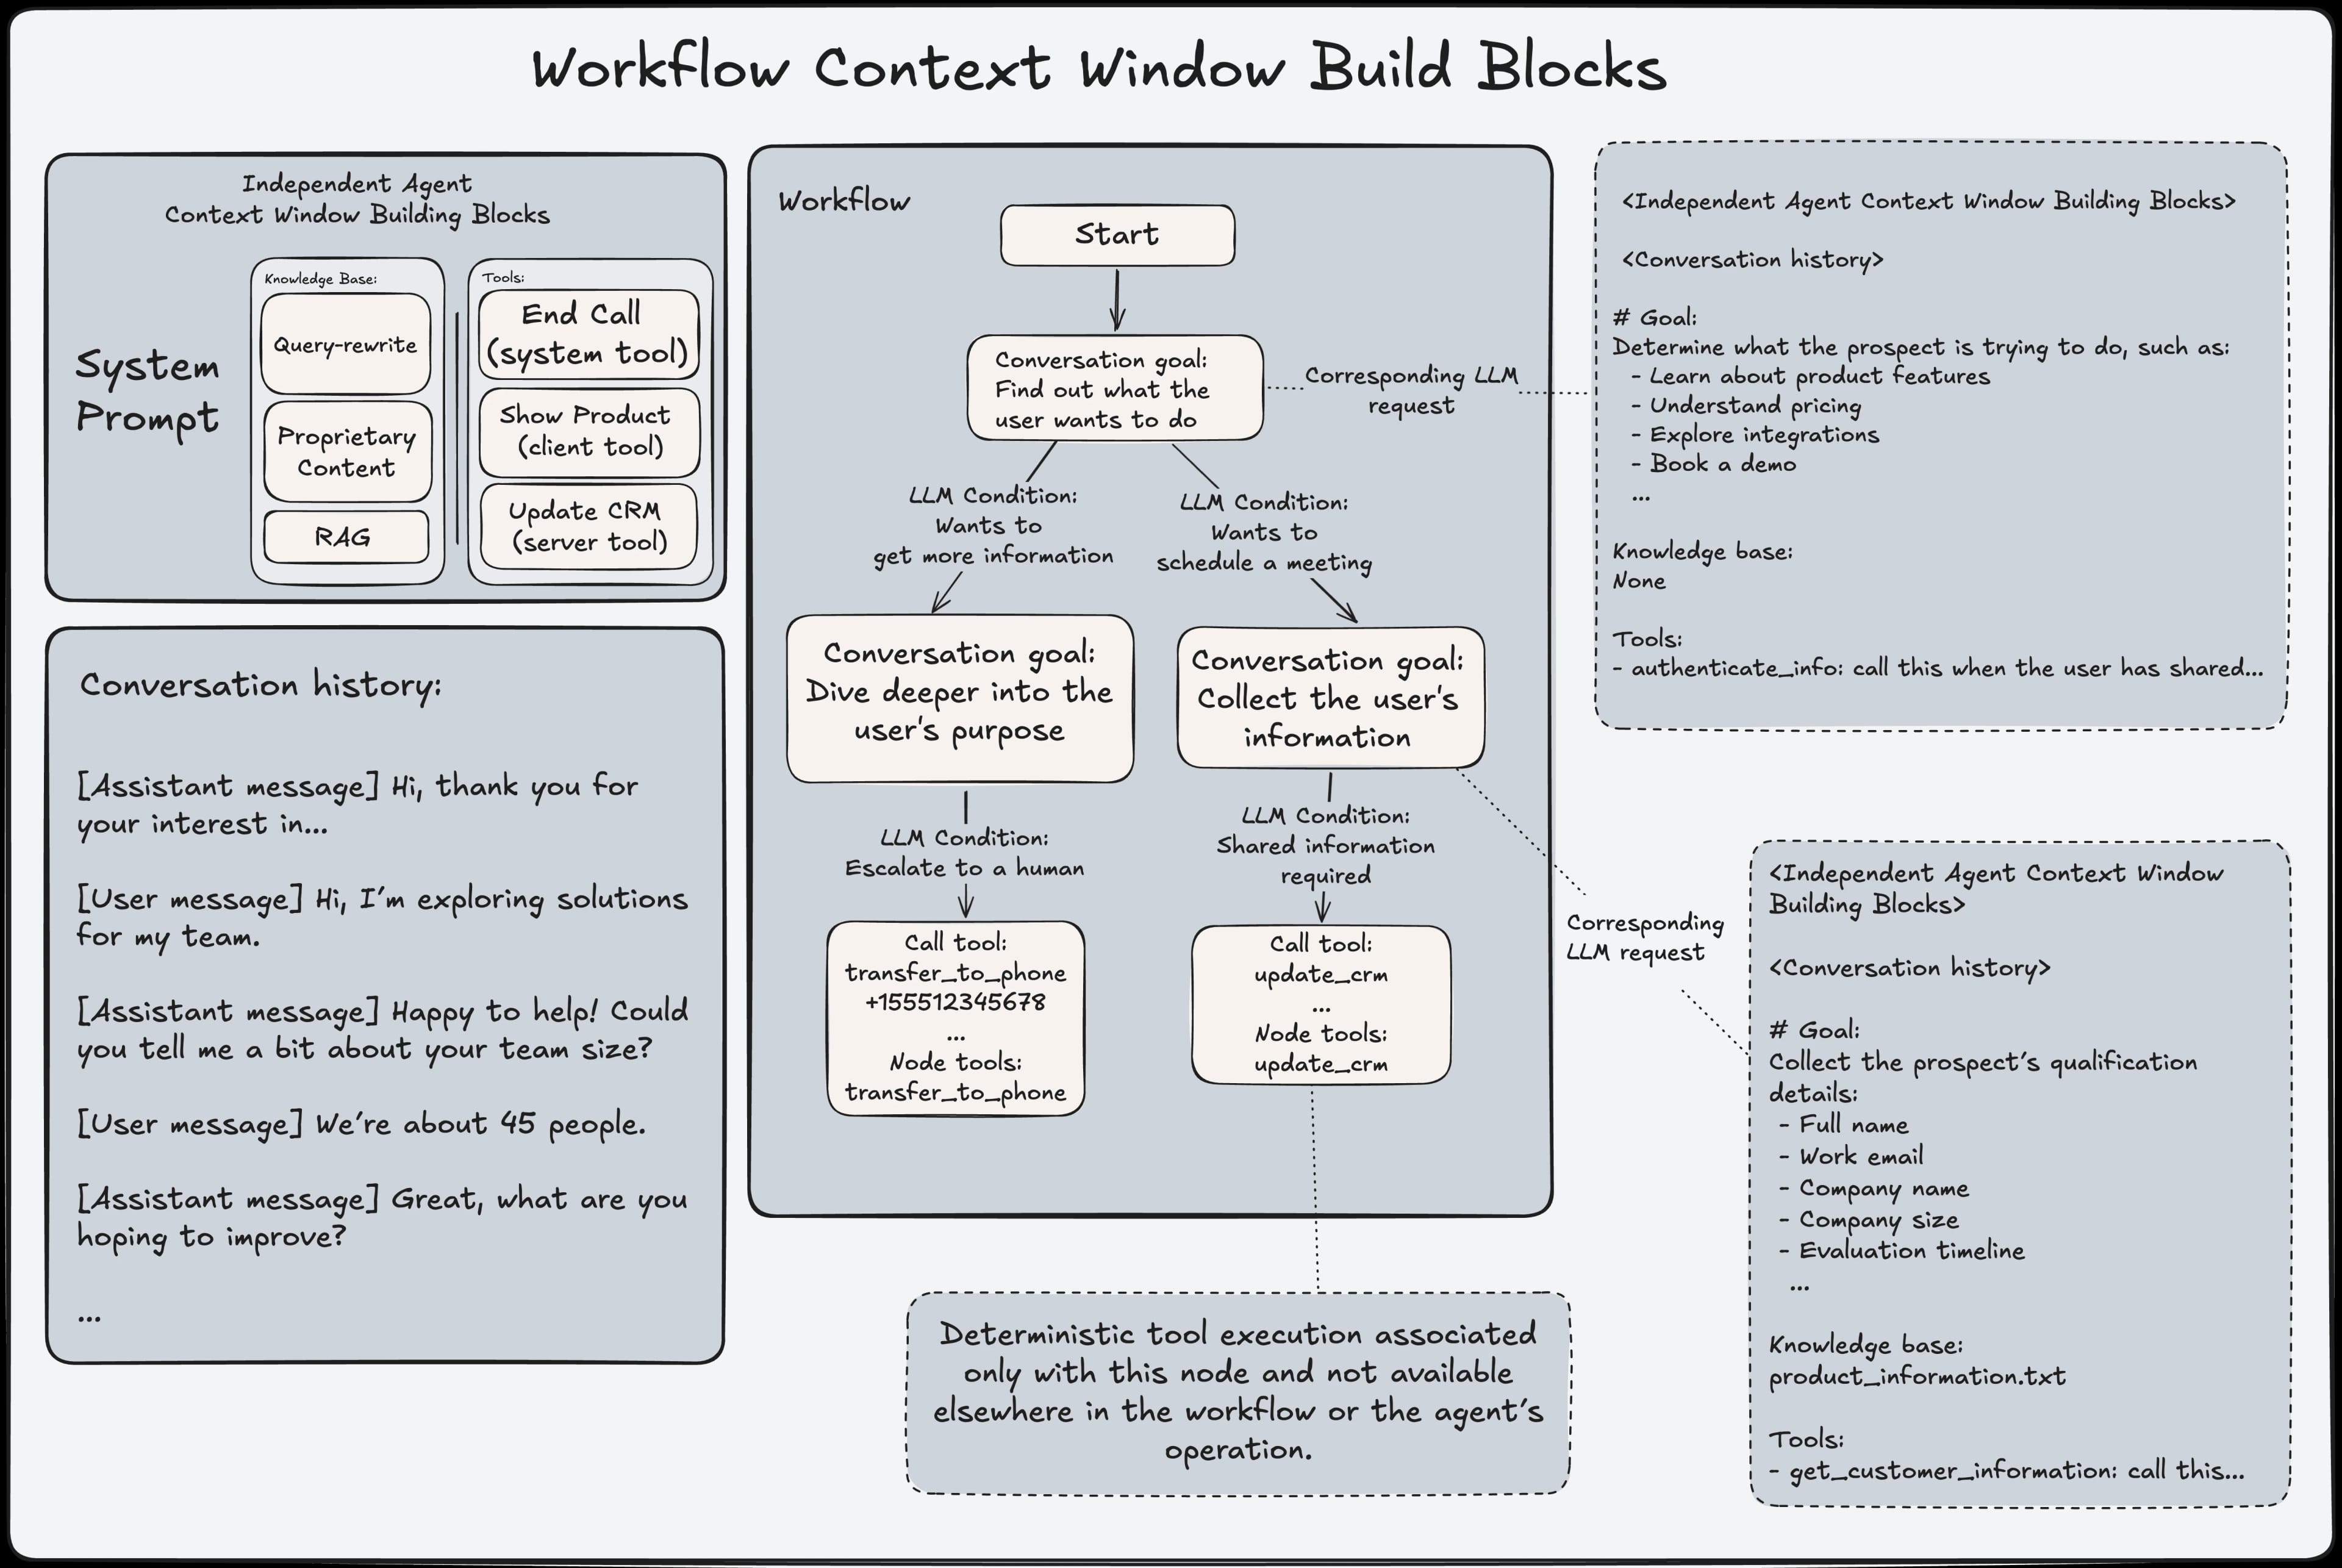
Su questa base condivisa, i workflow introducono sotto-agenti specializzati che operano all'interno di un grafo diretto. A ogni sotto-agente viene assegnato un obiettivo con ambito ristretto e la configurazione di base viene integrata con istruzioni aggiuntive nel prompt, strumenti e fonti di conoscenza pertinenti esclusivamente al suo ruolo. Anziché ridefinire l'intera configurazione conversazionale, i sotto-agenti sovrappongono il proprio intento all'agente di base tramite la composizione del prompt e un'estensione selettiva del contesto. Sebbene la cronologia della conversazione sia mantenuta durante le transizioni tra sotto-agenti per garantire continuità, ciascun sotto-agente opera con una visuale del sistema intenzionalmente limitata. Knowledge base e strumenti vengono esposti in modo selettivo, creando silos chiari che impediscono la dispersione tra responsabilità. Per rafforzare questo isolamento, l'oggetto dell'orchestratore viene ricostruito a ogni transizione come se fosse un agente indipendente. Questo garantisce che lo stato del prompt, la configurazione e le capacità disponibili del sotto-agente attivo rimangano completamente deterministici. Questo design consente ai workflow di mantenere coerenza globale supportando al tempo stesso la specializzazione locale, con comportamenti prevedibili, una chiara separazione delle responsabilità e un controllo preciso su come contesto, conoscenza e azioni vengono applicati in ogni fase dell'interazione.
Uno dei meccanismi chiave che rendono possibile questo controllo è la modalità di gestione delle transizioni tra sotto-agenti.
Gestire le transizioni del workflow con condizioni LLM
I workflow avanzano attraversando un grafo diretto di sotto-agenti, in cui le transizioni tra nodi sono controllate da condizioni esplicite. Queste condizioni determinano quando il controllo deve passare da un sotto-agente a un altro e consentono ai workflow di rispondere all'input dell'utente, agli esiti degli strumenti e alle variabili dinamiche. Le condizioni del grafo possono essere deterministiche oppure valutate dall'LLM. Le condizioni deterministiche, come le transizioni incondizionate, i controlli basati su espressioni di variabili dinamiche o le condizioni sui risultati degli strumenti, offrono solide garanzie sul flusso di controllo e sono adatte a imporre una progressione rigorosa in un workflow. Le condizioni basate su LLM, invece, consentono la valutazione semantica di criteri in linguaggio naturale, come rilevare l'intento dell'utente o riconoscere quando sono state fornite informazioni specifiche.
È importante sottolineare che le condizioni LLM vengono valutate al di fuori del system prompt dell'agente attivo e non influenzano il comportamento di generazione dell'agente. Vengono invece valutate in parallelo dall'orchestratore rispetto allo stato corrente della conversazione. Questa separazione assicura che la logica di transizione non contamini il prompt dell'agente né influisca sulla generazione delle risposte, consentendo comunque ai workflow di sfruttare il ragionamento dell'LLM per un attraversamento flessibile del grafo. Combinando condizioni deterministiche e valutate dall'LLM, i workflow possono ottenere prevedibilità e adattabilità, usando transizioni deterministiche dove la correttezza è fondamentale e transizioni basate su LLM dove è richiesta un'interpretazione semantica.
Quando una conversazione avanza a una nuova fase, il sistema attiva una versione dell'agente specificamente adattata a quel passaggio. Ogni fase opera con istruzioni mirate e accede soltanto alle conoscenze e agli strumenti pertinenti alla propria responsabilità. Ad esempio, una fase dedicata alla gestione dei rimborsi può fare riferimento alle relative policy senza ereditare contesti non pertinenti dall'onboarding o dal triage. Il passaggio tra le fasi è regolato da condizioni di transizione esplicite. Queste condizioni determinano quando deve cambiare la responsabilità e consentono che le decisioni di instradamento avvengano naturalmente man mano che la conversazione si sviluppa. Per mantenere la continuità, l'esperienza dell'utente rimane fluida durante le transizioni: ogni fase eredita il contesto conversazionale pertinente senza esporre i meccanismi del passaggio di consegne. Le misure di protezione monitorano inoltre le transizioni per evitare cicli di instradamento improduttivi, assicurando che il workflow rimanga stabile e orientato all'obiettivo.
Sicurezza e protezione
Per i casi che richiedono maggiori controlli di sicurezza e protezione, i clienti possono fare affidamento su componenti aggiuntivi dell'orchestratore.
Guardrail
Gli Agents di ElevenLabs implementano guardrail di sicurezza attraverso un sistema configurabile di moderazione e allineamento che valuta in tempo reale i messaggi dell'utente e dell'agente. I contenuti in entrata vengono classificati in più categorie di rischio, tra cui contenuti sessuali, violenza, molestie, incitamento all'odio e autolesionismo, ciascuna con soglie configurabili in modo indipendente. Quando viene attivato un guardrail, la conversazione viene terminata immediatamente e il client riceve una chiara motivazione dell'errore. Questo garantisce che le interazioni non sicure vengano bloccate tempestivamente e in modo coerente, senza basarsi esclusivamente su mitigazioni basate sui prompt. I guardrail operano al di fuori della logica del prompt dell'agente e forniscono un livello di applicazione affidabile che non può essere aggirato dal comportamento del modello o dall'input dell'utente. Questo approccio consente ai clienti di regolare la sensibilità della sicurezza in base al proprio dominio, mantenendo un'applicazione deterministica in runtime.
Gestione dei dati conforme
Talvolta, chi parla può condividere con un agente informazioni sensibili soggette a requisiti rigorosi di archiviazione ed elaborazione, ad esempio dati medici che richiedono una gestione conforme a HIPAA. Per supportare questi casi d'uso, offriamo la Modalità senza conservazione dei dati (ZRM) a livello di Agent o workspace. Quando è abilitata, tutti i dati delle chiamate vengono elaborati esclusivamente in memoria e non vengono mai scritti in uno storage persistente. Al termine della chiamata e dell'elaborazione, ElevenLabs non conserva alcuna informazione. Di conseguenza, trascrizioni, registrazioni audio e output di analisi non sono disponibili nella dashboard Agents; questa policy si applica sia ai sistemi rivolti ai clienti sia ai log interni. Sebbene i dati non vengano conservati, vengono elaborati durante la chiamata e tutti i webhook post-chiamata configurati ricevono gli output, consentendo ai clienti di memorizzare trascrizioni o risultati delle analisi nei propri sistemi, se necessario.
Quando ZRM è attiva, garantiamo inoltre che i sub-responsabili del trattamento non conservino i dati limitando gli LLM disponibili ai fornitori con impegni contrattuali che vietano l'addestramento sui dati dei clienti o la loro conservazione; attualmente, questo include i modelli Google Gemini e Anthropic Claude. I clienti che desiderano utilizzare un altro LLM con ZRM possono farlo stipulando un proprio accordo con il fornitore e configurandolo come LLM personalizzato usando API key coperte da tale accordo. Poiché questo estende la gestione dei dati oltre il nostro confine di fiducia standard, il nostro team Safety deve esaminare e approvare manualmente il caso d'uso prima di abilitarlo. Sebbene ZRM garantisca che ElevenLabs e i suoi sub-responsabili del trattamento non conservino i dati delle chiamate, i clienti restano responsabili di assicurare che gli strumenti esterni o i webhook utilizzati dal loro Agent rispettino i requisiti applicabili in materia di conservazione e normativa.
Prospettive future
In questo articolo abbiamo esplorato come gli Agents di ElevenLabs gestiscono il contesto conversazionale, gli strumenti, la valutazione e i workflow strutturati per offrire esperienze affidabili e in tempo reale su larga scala. Man mano che i clienti distribuiscono agenti in ambienti sempre più complessi, continuiamo ad ampliare la flessibilità del nostro motore di orchestrazione: dai modelli di valutazione configurabili e controlli di transizione più completi, fino a una maggiore osservabilità della composizione dei prompt e dell'utilizzo dei token nelle diverse fasi.
Il nostro team di Forward Deployed Engineering collabora a stretto contatto con i clienti per assicurare che queste funzionalità evolvano di pari passo con le implementazioni nel mondo reale. La prossima generazione di Agents offrirà ancora più trasparenza, determinismo e adattabilità, senza compromettere le prestazioni a bassa latenza che rendono possibili le conversazioni in tempo reale.

