Trascrizione in tempo reale e batch: differenze principali
- Scritto da
- Jack Limebear
- Pubblicato
AscoltaAscolta questo articolo
Quando scegli un modello di trascrizione basato sull'IA, hai due opzioni: la trascrizione in tempo reale o batch. Entrambe convertono il parlato in testo, ma adottano approcci diversi.
La trascrizione in tempo reale elabora l'audio mentre viene riprodotto, mentre quella batch elabora un'intera registrazione audio dopo la sua conclusione. La trascrizione in tempo reale offre risultati immediati, ma quella batch è spesso più accurata.
In questa guida confronteremo la trascrizione in tempo reale e batch per aiutarti a scegliere il modello giusto per il tuo prossimo progetto. Vedremo come funziona ogni modello, i suoi vantaggi e svantaggi e i casi d'uso più comuni.
In sintesi
- La trascrizione in tempo reale elabora l'audio mentre viene riprodotto.
- La trascrizione batch elabora un intero file audio in una sola volta.
- La trascrizione in tempo reale è più veloce, ma quella batch è più accurata perché il modello dispone del contesto bidirezionale dell'intero file audio.
- La trascrizione in tempo reale è ideale per applicazioni come agenti vocali, sottotitoli video in diretta o appunti delle riunioni, in cui la velocità è più importante dell'accuratezza.
- La trascrizione batch è più accurata e conveniente per trascrivere grandi quantità di audio dopo la registrazione.
Cos'è la trascrizione in tempo reale nello STT?
La trascrizione in tempo reale avviene quando un modello speech-to-text (STT) converte l'audio in testo scritto mentre viene riprodotto. Talvolta viene chiamata anche trascrizione streaming.
Con la trascrizione in tempo reale, il modello STT elabora l'audio in piccoli blocchi. Il testo scritto è disponibile pochi millisecondi dopo che le parole vengono pronunciate. Man mano che la conversazione procede, il modello STT raccoglie più dati e contesto e usa queste informazioni per perfezionare la trascrizione.
Questa forma di trascrizione funziona meglio nelle situazioni in cui la velocità è più importante dell'accuratezza. Ad esempio, questi modelli rendono più accessibili i flussi audio e video con sottotitoli in tempo reale. Un altro caso d'uso comune riguarda le piattaforme per prendere appunti in tempo reale.
Cos'è la trascrizione batch nello STT?
La trascrizione batch converte un'intera registrazione audio dal parlato al testo in una sola volta, dopo il termine della registrazione. Il processo può richiedere da pochi secondi a oltre 10 minuti, a seconda della durata e della complessità della registrazione.
I modelli di trascrizione batch usano il contesto dell'intera registrazione durante l'elaborazione. Il contesto completo aiuta il modello a interpretare accuratamente i passaggi con linguaggio complesso, rumore di fondo o interruzioni. I modelli di trascrizione batch aggiungono anche punteggiatura e formattazione, aspetti con cui alcuni modelli in tempo reale possono avere difficoltà.
La trascrizione batch funziona meglio nelle situazioni in cui l'accuratezza è la massima priorità. Molte organizzazioni usano modelli batch per trascrivere lunghe interviste, riunioni o podcast per i propri archivi.
Come le architetture batch e streaming influenzano la trascrizione
Confrontando l'elaborazione batch e stream per la trascrizione, i due modelli usano processi fondamentalmente diversi, che influiscono sull'output finale.
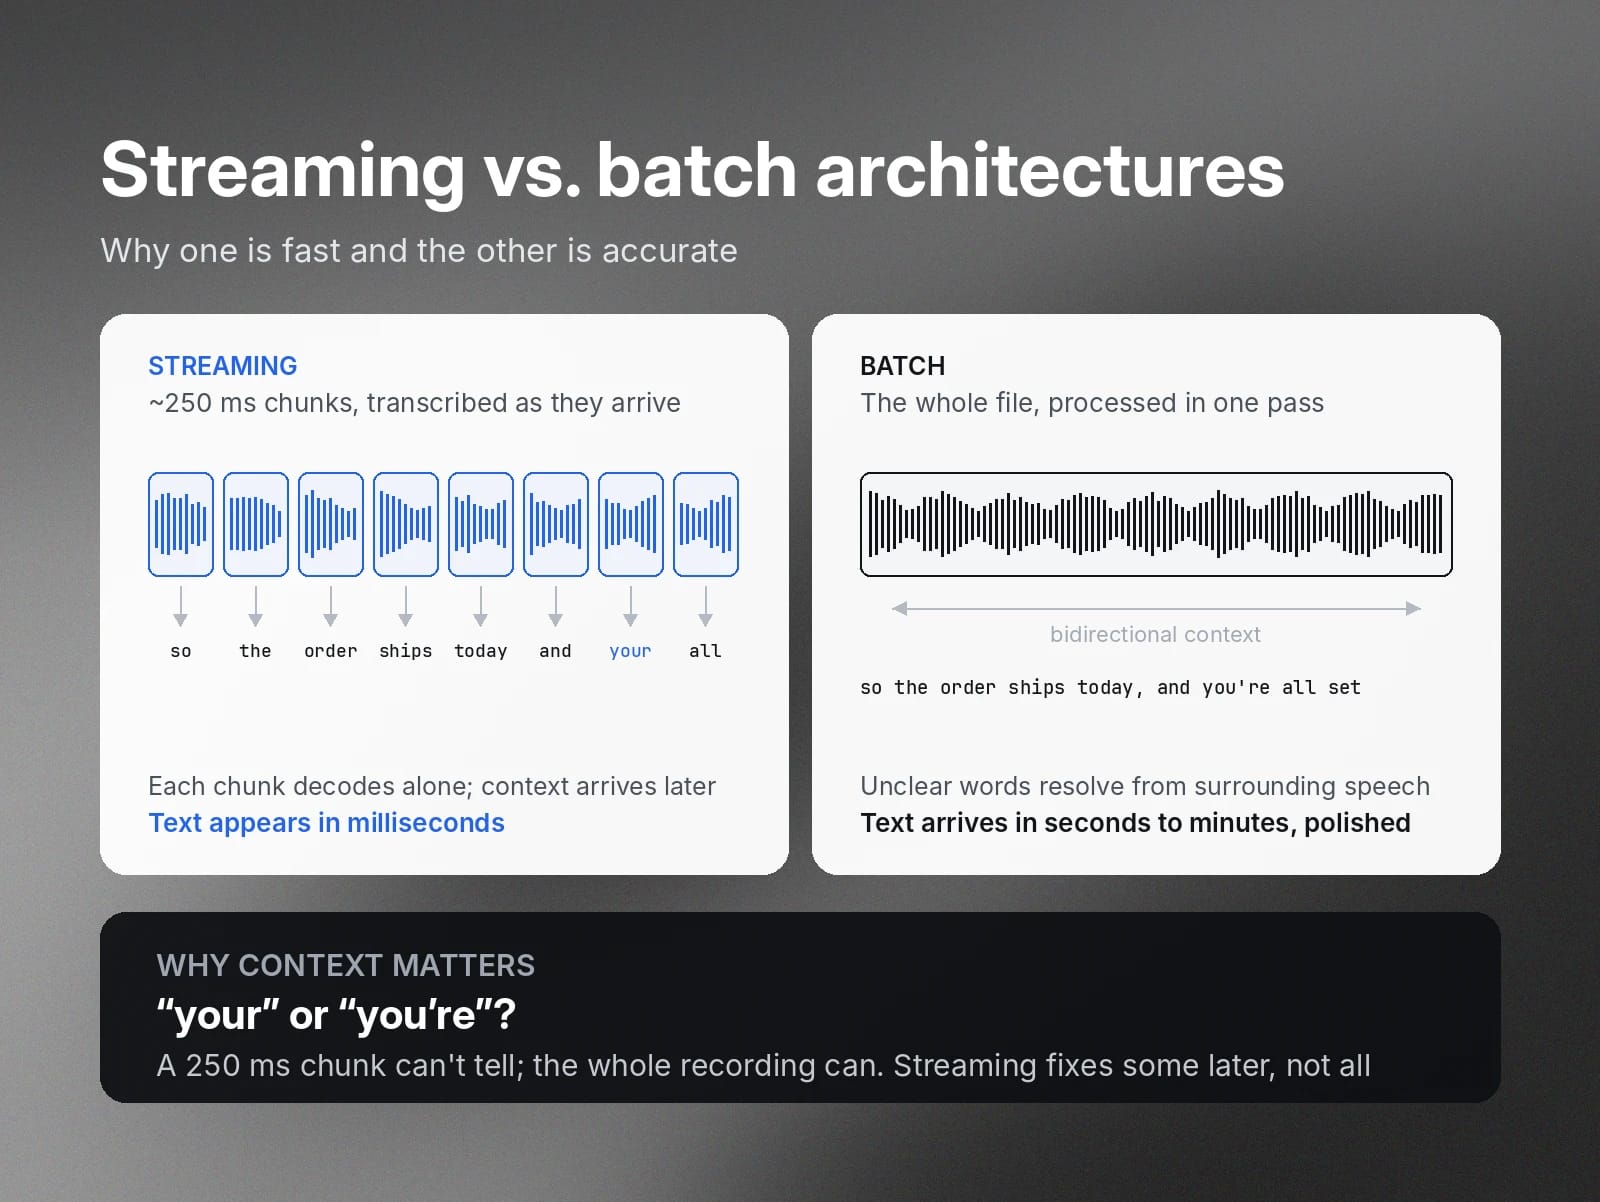
I modelli di trascrizione streaming suddividono l'audio in blocchi e trascrivono ciascuno mentre viene riprodotto. Questi blocchi sono molto piccoli, in genere di circa 250 millisecondi o meno. Elaborando l'audio in questo formato, il modello di trascrizione può lavorare rapidamente e far apparire il testo pochi secondi dopo la riproduzione dell'audio.
Poiché questi blocchi audio sono così piccoli, il modello Speech to Text non dispone del contesto completo della conversazione, e questo può causare errori. Ad esempio, il modello di trascrizione potrebbe usare una parola errata al posto di quella corretta.
Un modello di trascrizione in tempo reale corregge alcuni di questi errori man mano che la conversazione prosegue e il contesto diventa più chiaro. Tuttavia, di solito non c'è abbastanza tempo o contesto per correggere ogni errore, quindi la trascrizione finale non è sempre accurata al 100%.
I modelli di trascrizione batch, invece, elaborano l'intero file audio in una sola volta. Questo significa che il modello di trascrizione dispone del contesto bidirezionale della conversazione, che usa per risolvere parole o frasi poco chiare. Quando qualcosa non è chiaro nel file audio, il modello analizza le parole precedenti e successive per stabilire cosa è stato detto e trascriverlo accuratamente.
Questo contesto aggiuntivo rende i modelli di trascrizione batch più lenti di quelli in tempo reale. Tuttavia, il risultato finale è molto più accurato e rifinito.
Caratteristiche principali dei modelli di trascrizione in tempo reale e batch: latenza, accuratezza e costo
Sia i modelli in tempo reale sia quelli batch sono efficaci per la trascrizione: tutto dipende dal tipo di progetto su cui stai lavorando. Alcuni progetti richiedono risultati immediati, mentre altri necessitano di un'elevata accuratezza.
Ecco i fattori da considerare quando scegli tra trascrizione in tempo reale e batch:
Trascrizione in tempo reale | Trascrizione batch | |
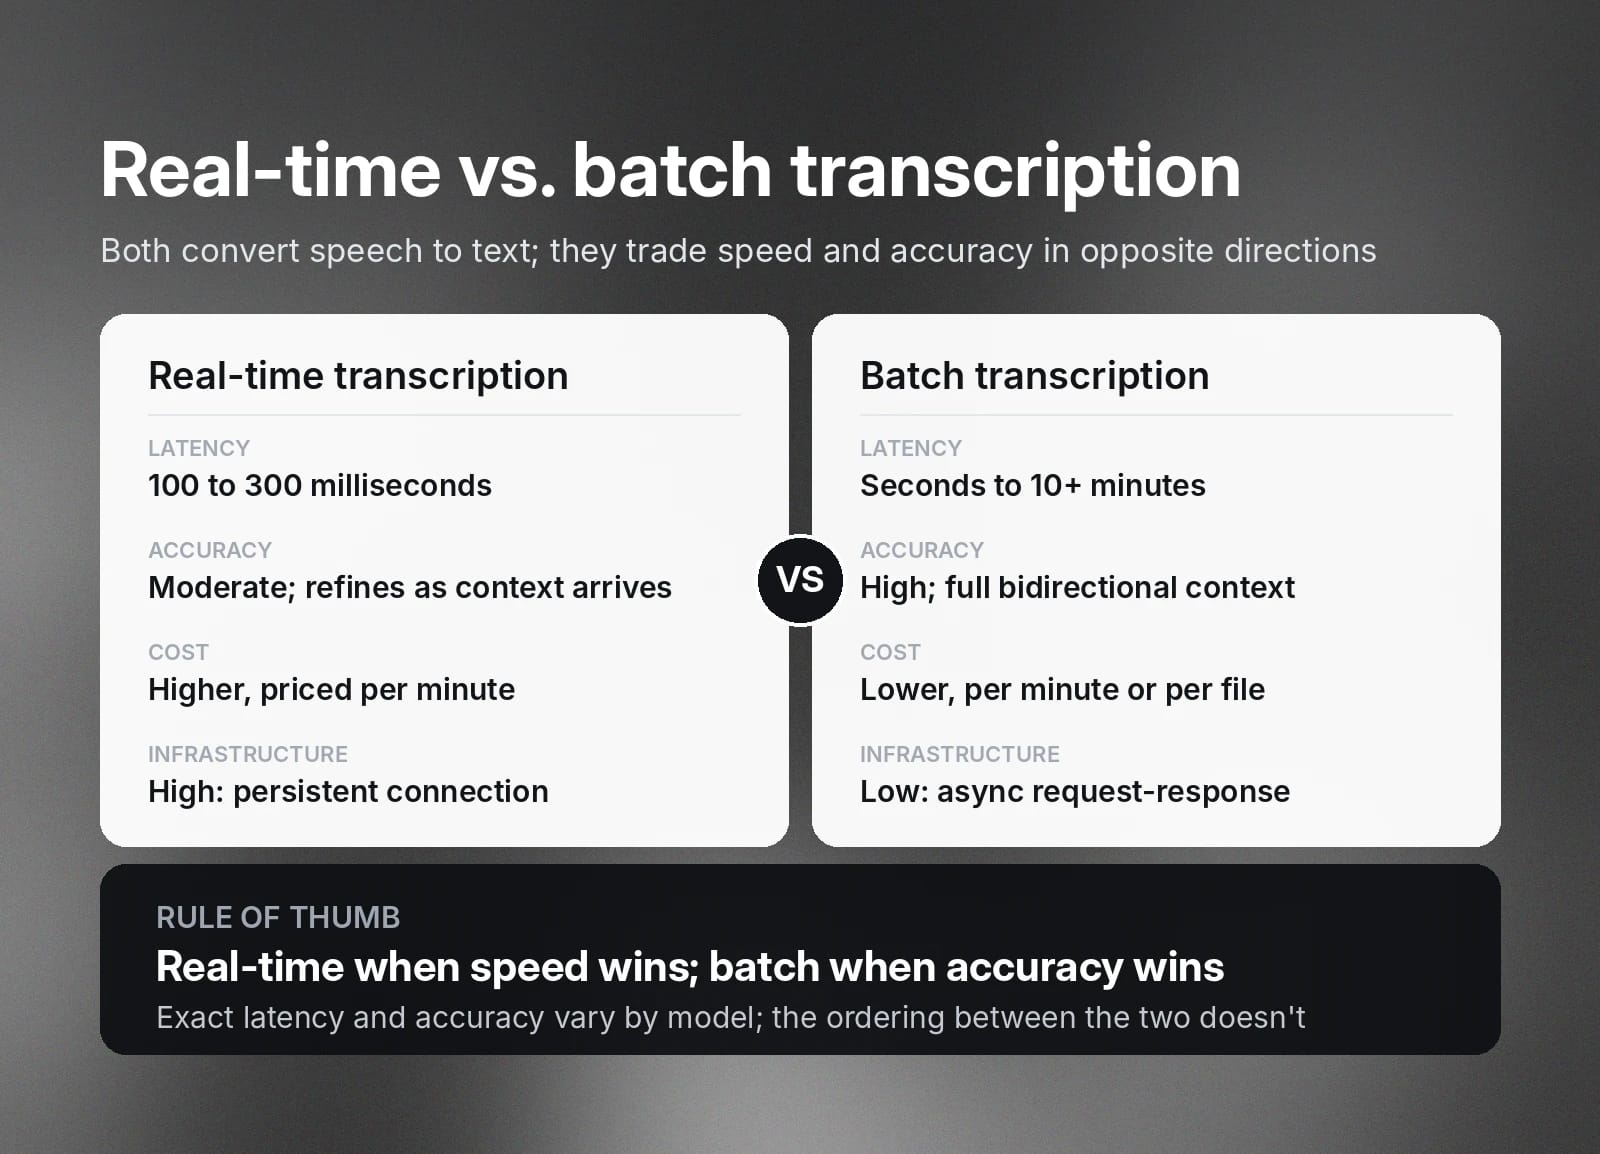
Latenza | Da 100 a 300 millisecondi | Da pochi secondi a oltre 10 minuti, a seconda della durata del file |
Accuratezza | Media | Elevata |
Costo | Elevato, a prezzo al minuto | Medio, a prezzo al minuto o per file |
Complessità dell'infrastruttura | Elevata, richiede una connessione stabile e il bilanciamento del carico | Bassa, usa una struttura asincrona di richiesta-risposta |
I valori esatti di latenza e accuratezza variano in base al modello di trascrizione specifico che usi. Tuttavia, la trascrizione in tempo reale è costantemente più veloce, mentre quella batch è più accurata.
La trascrizione in tempo reale costa più di quella batch perché richiede un'infrastruttura più complessa e presenta costi operativi più elevati. I modelli in tempo reale richiedono una connessione stabile per mantenere la loro velocità e richiedono più tempo per la configurazione e la manutenzione rispetto ai modelli batch.
I modelli in tempo reale valgono l'investimento per garantire l'accessibilità durante le conversazioni dal vivo. Tuttavia, usare la trascrizione batch consente di risparmiare denaro e tempo di configurazione nei progetti in cui la velocità non è una priorità.
Confronto tra API di trascrizione in tempo reale e batch: scegli la soluzione più adatta al tuo progetto
Prima di iniziare un nuovo progetto di trascrizione, devi valutare i vantaggi e gli svantaggi dei modelli batch e in tempo reale per capire quale sia più adatto ai tuoi obiettivi. Ecco come si presenta il processo decisionale in tre scenari reali.
Agente vocale dal vivo: Trascrizione in tempo reale
I modelli di IA conversazionale dal vivo richiedono una trascrizione quasi istantanea per garantire l'accessibilità, soprattutto quando gestiscono problematiche operative complesse o di assistenza clienti.
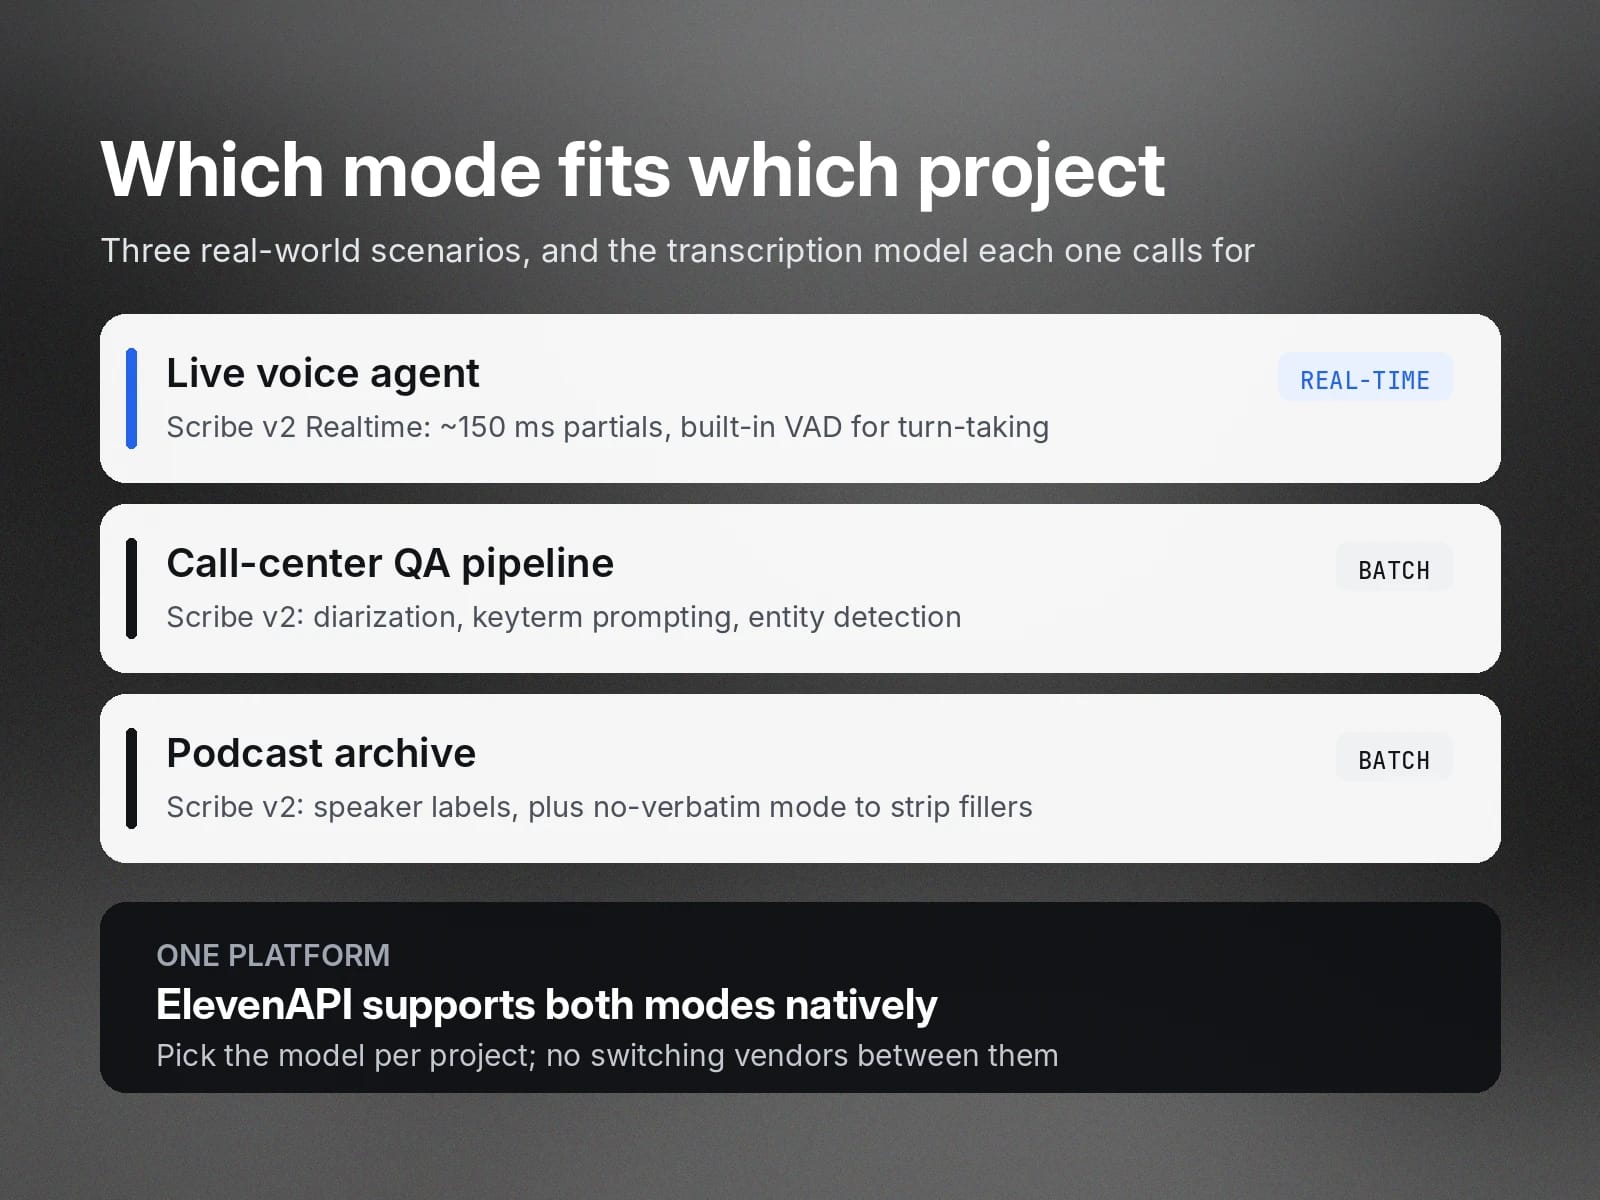
Un modello in tempo reale, come Scribe v2 Realtime, offre la bassa latenza necessaria per conversazioni fluide e naturali. Scribe v2 Realtime fornisce trascrizioni parziali in circa 150 millisecondi.
I modelli di trascrizione per agenti vocali dal vivo richiedono anche un'accurata gestione dei turni di parola. Ciò significa che devono poter rilevare quando un utente ha iniziato o finito di parlare e rispondere immediatamente. Una gestione efficace dei turni di parola e delle interruzioni aiuta a evitare che la trascrizione resti indietro rispetto alla conversazione.
I modelli di trascrizione in tempo reale danno priorità a una gestione accurata dei turni di parola per offrire risultati rapidi. Ad esempio, Scribe v2 Realtime integra Voice Activity Detection, quindi segmenta automaticamente la trascrizione quando rileva il silenzio tra i parlanti.
Pipeline QA per call center: Trascrizione batch
L'accuratezza è fondamentale nel controllo qualità, quindi un modello di trascrizione batch come Scribe v2 è la scelta più sensata in questo scenario.
Trascrizioni di call center spesso contengono nomi univoci e dettagli specifici del settore. Se non vengono trascritti correttamente, per gli analisti è difficile stabilire se una chiamata abbia avuto davvero successo. Poiché i modelli batch elaborano l'intera registrazione in una sola volta, dispongono del contesto necessario per una trascrizione e una formattazione accurate.
Scribe v2 offre diverse funzionalità per migliorare l'accuratezza della trascrizione. La diarizzazione dei parlanti assicura che agenti e clienti siano sempre etichettati correttamente, anche quando parlano contemporaneamente. Il keyterm prompting fornisce in anticipo al modello nomi di brand e termini di settore, affinché vengano trascritti correttamente.
Le trascrizioni dei call center possono contenere anche informazioni sensibili da oscurare, come numeri di previdenza sociale e numeri di carte di credito. Scribe v2 offre il rilevamento delle entità per trovare e associare un timestamp a questi dettagli sensibili, così puoi rimuoverli.
Archivio di podcast: Trascrizione batch
Quando crei un archivio di podcast, hai bisogno di trascrizioni curate che il tuo team e il tuo pubblico possano consultare in qualsiasi momento. Accuratezza e formattazione pulita sono essenziali, perciò la trascrizione batch è la scelta giusta.
Con la trascrizione batch, ottieni trascrizioni accurate con etichettatura e diarizzazione dei parlanti in tutti i file dei tuoi podcast. Scribe v2 offre anche la modalità no-verbatim, che rimuove automaticamente parole riempitive, balbuzie e ripetizioni. Così dedichi meno tempo all'editing manuale e puoi creare più velocemente il tuo archivio di podcast.
ElevenAPI supporta nativamente sia la modalità in tempo reale sia quella batch. Se gestisci più progetti di trascrizione contemporaneamente, puoi usare ElevenAPI per gestirli tutti sulla stessa piattaforma. Ti basta scegliere il modello appropriato per ogni progetto, senza l'inconveniente di passare continuamente da un fornitore di servizi all'altro.
Modelli di trascrizione ibridi: un ponte tra tempo reale e batch
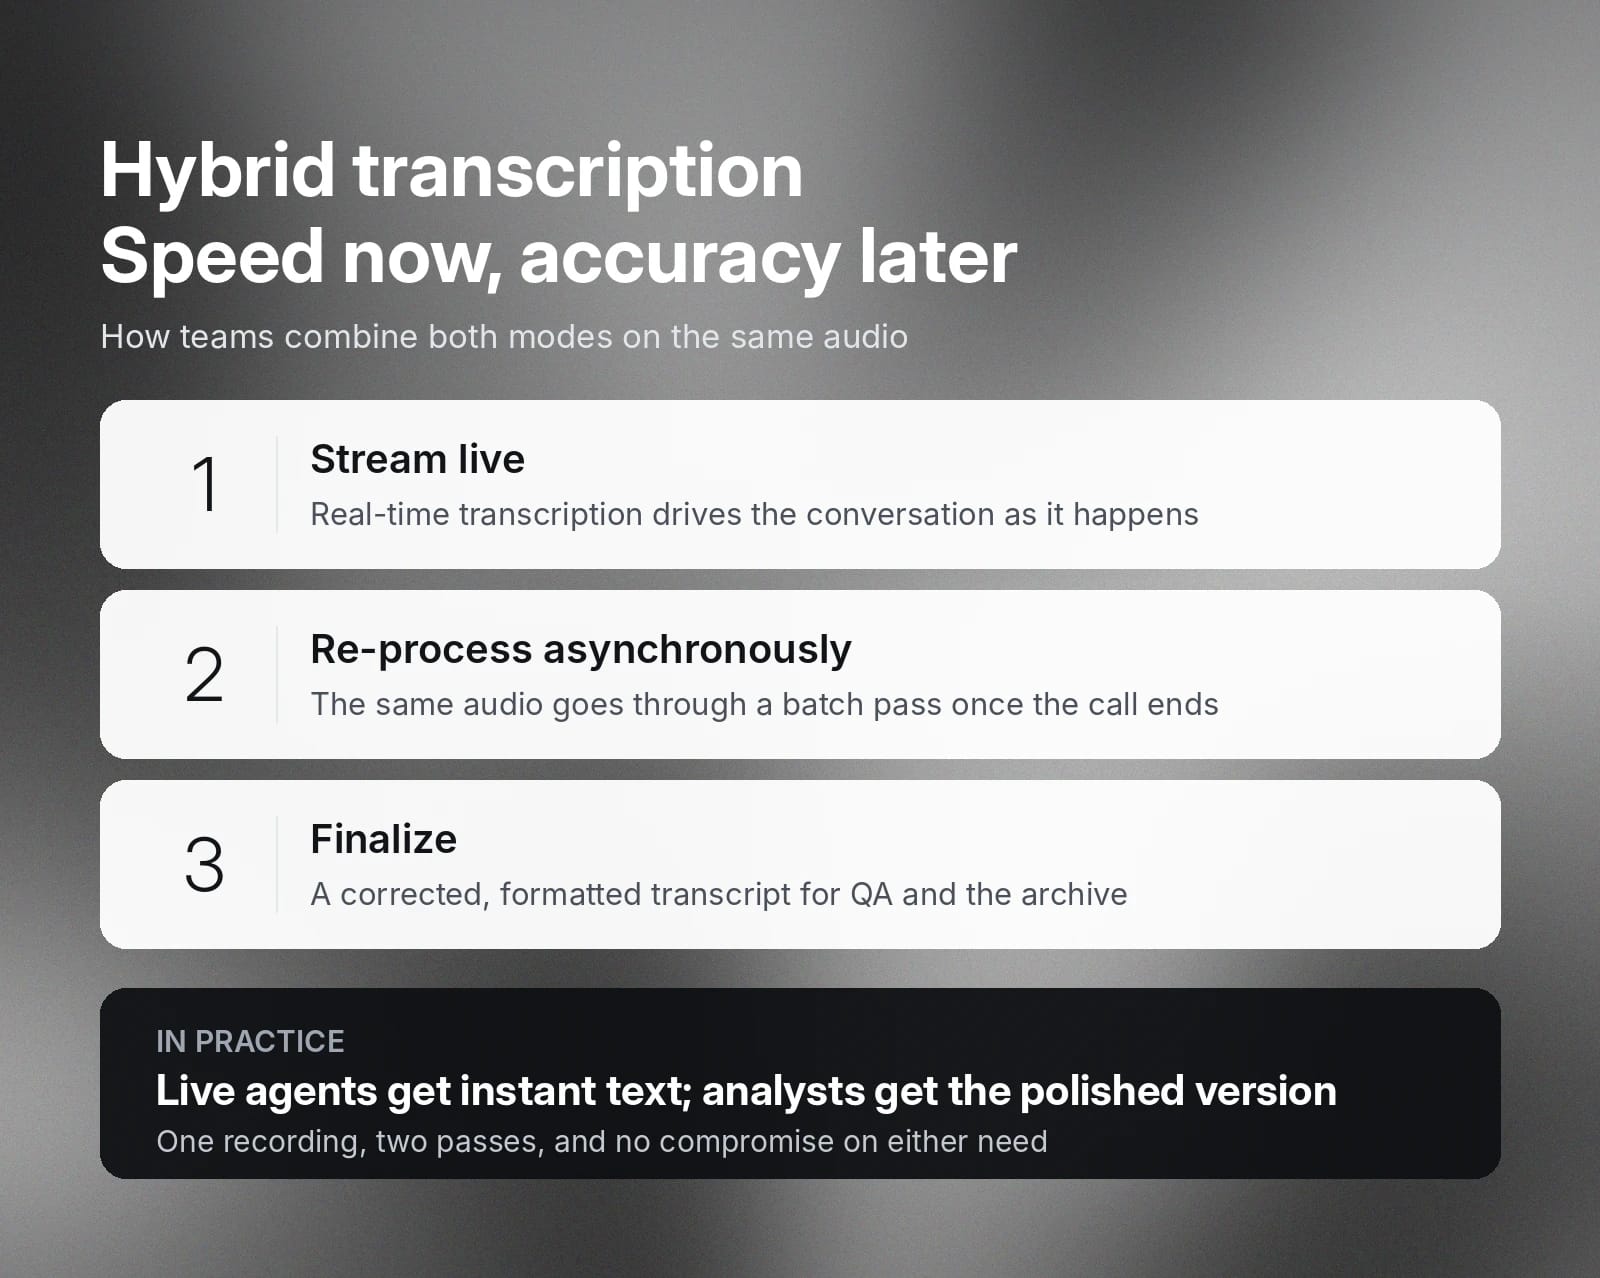
Le architetture di trascrizione ibride combinano modelli in tempo reale e batch per bilanciare velocità e accuratezza.
Ad esempio, un team di assistenza clienti potrebbe usare un modello ibrido per ottenere un output immediato durante le conversazioni dal vivo, quindi rifinire la trascrizione per il controllo qualità e l'archiviazione. Gli agenti dal vivo usano la trascrizione in tempo reale, poi inviano la trascrizione iniziale a un modello batch per una rielaborazione asincrona.
Ecco come funziona questo flusso:
Inizia con ElevenAPI per soluzioni di trascrizione flessibili
ElevenAPI offre modelli sia in tempo reale sia batch per trascrizioni rapide e accurate in oltre 90 lingue. I modelli di trascrizione di ElevenAPI, leader del settore, offrono risultati accurati anche con audio di bassa qualità, rumore di fondo o accenti marcati.
ElevenAPI offre modelli sia in tempo reale sia batch per trascrizioni rapide e accurate in oltre 90 lingue. Scribe v2 offre un'accuratezza di trascrizione leader nel settore, mentre Scribe v2 Realtime garantisce un'accuratezza eccezionale per i casi d'uso dal vivo; entrambi forniscono risultati affidabili anche con audio di bassa qualità, rumore di fondo o accenti marcati.
Entrambi i modelli sono disponibili sulla stessa comoda piattaforma per aiutarti a creare un'architettura di trascrizione adatta alle tue esigenze. Esplora API Speech to Text di ElevenLabs per vederla in azione oppure crea una chiave API per iniziare.



