
Modelli di interazione: creare dialoghi naturali tra umani e IA
- Scritto da
- Jack Limebear
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
Chiunque abbia provato a interrompere un agente vocale IA a metà frase sa cosa si prova quando un sistema non è progettato per una conversazione umana. Il ritmo è sbagliato, la voce è scollegata dal contenuto e, anche quando le informazioni sono corrette, l'interazione sembra innaturale: non è come parlare con una persona competente, ma come usare un software che per caso utilizza le parole.
La causa di questa sensazione innaturale è strutturale. Molti sistemi di IA vocale sono stati progettati per gestire i turni anziché il flusso reale della conversazione. Ascoltano, elaborano e rispondono a uno scambio alla volta. Questo funziona nelle demo semplici, ma non regge quando la conversazione diventa emotiva e imprevedibile.
I modelli di interazione sono sistemi di IA progettati per comunicare in tempo reale tramite audio e testo, cogliendo non solo cosa viene detto, ma anche quando viene detto e quale tipo di risposta emotiva richiede il momento. Questo articolo spiega cosa distingue un modello di interazione, perché è importante per le aziende che implementano l'IA vocale e come ElevenLabs sta lavorando per realizzarlo.
In sintesi
- La maggior parte delle IA vocali non funziona nelle conversazioni reali perché non sa gestire interruzioni, silenzi o il contesto che si mantiene tra un turno e l'altro.
- Lo stack di interazione di ElevenLabs è progettato per gestire interruzioni, pause e sovrapposizioni vocali senza perdere il contesto né interrompere il flusso della conversazione.
- ElevenLabs sta sviluppando veri modelli di interazione con un'architettura a cascata avanzata, Speech to Text (STT) sviluppato internamente e Text to Speech (TTS), oltre a uno stack ottimizzato per una bassa latenza e una conversazione naturale e fluida.
Perché la maggior parte della comunicazione vocale tra persone e IA non sembra naturale
La maggior parte delle IA vocali tratta una conversazione come una serie di input e output distinti: il sistema attende un blocco di parlato, lo converte in testo, elabora il testo e risponde. Funziona per le interazioni basate su comandi e risposte, ma una conversazione reale non è una sequenza ordinata di scambi testuali. È un dialogo continuo, fatto di pause e interiezioni.
Eliminare il flusso tra i turni e il contesto che si mantiene da uno all'altro provoca tre problemi specifici:
- Ti interrompe o ti fa aspettare: il sistema non sa distinguere una pausa per riflettere da un turno concluso, quindi interviene mentre stai ancora parlando oppure resta in silenzio dopo che hai finito. Se raccogli le idee a metà frase, ti interrompe; se concludi il tuo punto, devi aspettare un momento di silenzio.
- Non può reagire dopo che ha iniziato a parlare: nel momento in cui il sistema inizia a rispondere, smette di ascoltare. Se lo interrompi per cambiare argomento, continua a fornire la risposta a una domanda che hai ormai superato, perché non rileva che è cambiato qualcosa.
- Dimentica man mano che procede: ogni turno viene elaborato isolatamente, quindi il contesto di cinque scambi prima non viene mantenuto. Finisci per ripeterti oppure il sistema risponde come se la conversazione fosse appena iniziata.
Il risultato è una conversazione che può essere funzionalmente corretta e comunque sembrare sbagliata.
Cosa possono fare i modelli di interazione che l'IA vocale tradizionale non può fare
Mentre la tradizionale IA vocale gestisce un turno alla volta, un modello di interazione gestisce l'intera conversazione, prestando attenzione contemporaneamente a ciò che viene detto e a ciò che deve accadere dopo. La differenza funzionale è che un modello di interazione risponde allo stato effettivo dello scambio.
I modelli di interazione offrono:
- Risposta in tempo reale: il sistema è progettato per rispondere alla velocità di una conversazione, con un ciclo end-to-end che può richiedere meno di un secondo, a seconda della configurazione.
- Gestione naturale di interruzioni, silenzi e sovrapposizioni: distingue una pausa per riflettere da un turno concluso, quindi non interrompe le persone né lascia silenzi vuoti. E quando il cliente gli parla sopra per reindirizzare la conversazione, gestisce la sovrapposizione senza perdere il contesto né compromettere la conversazione.
- Continuità durante l'intero scambio: anziché reimpostare il contesto a ogni turno, il sistema mantiene la cronologia della conversazione, così ciò che dice al turno 10 riflette tutto ciò che è accaduto dal primo turno.
- Espressività adattiva: la voce può essere programmata per cambiare registro — più calma, diretta o rassicurante — in base al tipo di attività che sta svolgendo.
- Esecuzione parallela delle attività: il sistema recupera informazioni, esegue tool call e continua a parlare allo stesso tempo, anziché restare in silenzio mentre cerca qualcosa.
Il banco di prova per un modello di interazione è una chiamata che sta andando male. Nella registrazione qui sotto, un cliente chiama per la cancellazione di un volo. È teso e ha bisogno di risolvere il problema rapidamente.
L'agente riconosce subito l'urgenza e la frustrazione del cliente dalle parole che usa. Adatta il tono, gestisce l'interruzione senza perdere il filo e usa gli strumenti connessi per offrire soluzioni concrete per il volo cancellato. Alla fine, il cliente ottiene una soluzione senza dover ricorrere a un agente umano.
Confrontalo con i tipici agenti basati sui turni usati oggi. Questi sistemi attenderebbero ogni pausa, risponderebbero partendo da un tono neutro e non coglierebbero affatto la frustrazione del cliente. Dopo alcuni scambi che non affrontano ciò che il chiamante prova davvero, probabilmente la chiamata dovrebbe essere trasferita a una persona, lasciando il cliente più frustrato di quando ha iniziato.
Come ElevenLabs sta sviluppando i modelli di interazione
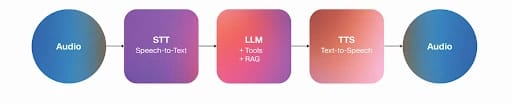
La nostra pipeline conversazionale usa un'architettura a cascata avanzata anziché un'architettura fusa: invece di affidare tutto a un unico modello, ogni fase dispone di un componente specializzato.
Il vantaggio di questo approccio è che possiamo ottimizzare ogni fase della pipeline in modo indipendente, sostituendo il modello di qualsiasi componente con uno migliore senza dover ricostruire l'intero sistema. Inoltre, dato che sviluppiamo internamente questi componenti, sono co-ottimizzati per scambiarsi un contesto ricco di informazioni. Questo significa che la pipeline continua a comportarsi come un'unica conversazione coerente, anziché come una catena di strumenti separati.
Struttura del modello a cascata
Struttura del modello fuso
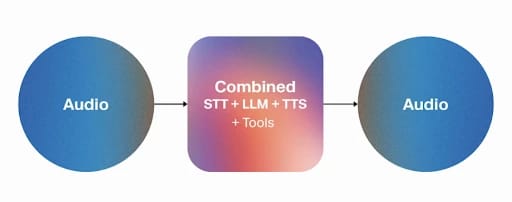
Immagini: modelli a cascata e fusi
Ecco le tecnologie che attualmente compongono la pipeline:
- Scribe v2 in tempo reale: il nostro modello STT sviluppato internamente trascrive il parlato in circa 150 ms in oltre 90 lingue, resistendo a rumore di fondo, accenti, interruzioni ed eventi non verbali come risate e pause. È progettato anche per gestire il vocabolario specifico di settore, dai termini medici al gergo finanziario.
- Gestione speculativa dei turni: questo sistema decide quando parlare, fare una pausa o attendere, interpretando il flusso della conversazione anziché basarsi su una soglia rigida di silenzio. I miglioramenti al nostro modello di rilevamento dell'attività vocale lo aiutano a filtrare meglio il parlato in sottofondo e le risposte brevi, rendendo l'alternanza dei turni più naturale.
- Eleven v3 Conversational: uno dei nostri modelli TTS più espressivi, progettato per dialoghi dal vivo e bidirezionali. Mantiene il tono emotivo della conversazione da un turno all'altro, così la resa dell'agente al decimo turno riflette tutto ciò che lo ha preceduto.
- Modalità Espressiva: basata su Eleven v3 Conversational e sul sistema di gestione dei turni, Modalità Espressiva controlla il modo in cui l'agente suona in quel momento. Riduce la tensione quando i clienti sono frustrati, rassicura quando sono confusi ed è diretto quando serve chiarezza. Legge anche i tag espressivi, quindi il modello può agire su segnali come [laughs], [whispers] o [sighs] per modellare specifici momenti dell'espressività vocale.
- Flash v2.5: Il nostro modello TTS a bassa latenza supporta 32 lingue e genera parlato in meno di 75 ms. Quando la latenza è prioritaria, mantiene il tempo di risposta entro i ritmi naturali della conversazione umana.
- Speech Engine: il livello di connessione che unisce lo stack, collegando il tuo server alla nostra ElevenAPI tramite WebSocket, con una connessione per conversazione. Noi gestiamo STT e TTS mentre il tuo server esegue l'LLM, così i team tecnici possono usare il proprio modello e mantenere la logica conversazionale sulla propria infrastruttura.
Questi modelli vengono migliorati costantemente e ne rilasciamo regolarmente nuove versioni. Ogni nuovo rilascio riduce la distanza tra parlare con un software e parlare con una persona, grazie a risposte più rapide, un riconoscimento emotivo più preciso, più lingue e un'espressività più fluida.
Parlare mentre si pensa
Non tutte le parti di un modello di interazione devono essere eseguite in una sequenza rigida. ElevenAgents può continuare a lavorare in background mentre la conversazione prosegue, anziché ricorrere al silenzio tra una domanda e una risposta.
Alcuni sistemi principali collaborano per permettere di parlare e pensare contemporaneamente:
- Tool call parallele: l'agente può interrogare un database, eseguire uno strumento, oppure controllare lo stato di un ordine mentre sta ancora parlando, così il recupero delle informazioni non sembra mai una pausa vuota nella conversazione.
- Timeout flessibile: se un LLM impiega più tempo del previsto per generare una risposta, l'agente pronuncia una breve frase riempitiva come «Fammi pensare» o «hmmm» anziché lasciare un silenzio imbarazzante. Il timeout flessibile aiuta a mantenere un flusso conversazionale naturale e riduce la probabilità di interruzioni.
- Termini da ignorare nelle interruzioni: anziché usare una soglia fissa di silenzio, il sistema cerca di interpretare il significato di ciò che viene detto per capire quando un turno è realmente terminato. Allo stesso modo, brevi conferme come «ok» o «mh-mh» possono essere configurate per passare senza attivare un'interruzione completa, così l'agente non perde il filo ogni volta che il chiamante interviene.
Insieme, questi sistemi evitano che l'agente sembri in attesa o stia caricando una risposta. Formano un motore conversazionale efficiente che colma naturalmente le pause come farebbe una persona, elaborando al contempo le informazioni e raccogliendo le idee in background.
Come funziona davvero una conversazione con ElevenLabs
I componenti descritti sopra non vengono eseguiti uno dopo l'altro in una sequenza ordinata. Si sovrappongono. Ecco come un agente ElevenLabs gestirebbe un chiamante che chiede: «Il mio ordine è già stato spedito o è ancora in elaborazione?», nel corso di una chiamata all'assistenza.
- Il chiamante parla: l'audio viene trasmesso in streaming a ElevenLabs tramite la connessione WebSocket e Scribe inizia a trascrivere in tempo reale, con un ritardo di circa 150 ms rispetto alla voce.
- Il sistema interpreta il flusso: mentre Scribe sta ancora trascrivendo, il sistema di gestione speculativa dei turni sta già valutando se il chiamante ha concluso o è a metà ragionamento. La frase finale «o è ancora in elaborazione?» viene interpretata come un passaggio di turno anziché come una pausa, quindi attiva il passaggio successivo invece di attendere in silenzio.
- L'LLM raccoglie il contesto e risponde: la domanda trascritta arriva all'LLM insieme alla cronologia della conversazione, al record dell'ordine recuperato dai sistemi dell'azienda tramite RAG, gli output degli strumenti usati in precedenza nella chiamata e il prompt di sistema. Elabora tutte queste informazioni e genera una risposta basata sull'ordine del chiamante.
- Il modello TTS sintetizza la risposta: il testo diventa audio dal suono naturale. Se la Modalità Espressiva è attiva, la risposta contiene indicazioni espressive adatte al momento, così un aggiornamento di routine risulta semplice e senza fretta, anziché piatto. Quando la priorità è la latenza, Flash gestisce la sintesi in meno di 75 ms.
- La risposta viene trasmessa in streaming: l'audio inizia a essere riprodotto prima che la sintesi sia terminata, così il chiamante sente l'inizio della risposta mentre il resto viene ancora generato.
- Il ciclo si ripete: ogni nuovo turno mantiene il tono, il contesto e la cronologia della conversazione.
In questo processo rapido, la conversazione sembra naturale. Il chiamante smette di adattarsi alla macchina: non rallenta, non scandisce eccessivamente le parole e non aspetta un segnale acustico. Parla e basta, come farebbe con una persona.
Implementa agenti vocali dal suono naturale in tutta la tua azienda
Tutto ciò che abbiamo descritto è già in produzione. Dall'architettura a cascata alla pipeline con latenza inferiore al secondo, aziende di tutto il mondo usano già ElevenAgents per gestire conversazioni reali con i clienti su larga scala.
Questo include ambienti regolamentati e ad alto rischio, perché l'architettura dei nostri agenti supporta guardrail, audit log e controlli di conformità normativa. ElevenLabs è certificata SOC 2 Type II, ISO 27001, HIPAA e PCI DSS Level 1, con Zero Retention Mode e residenza regionale dei dati per i team che devono mantenere i dati entro un confine specifico.
Pronto a mettere al lavoro un agente? Puoi creare un agente e iniziare a sviluppare nella console, oppure parlare con il nostro team commerciale di un'implementazione definita per il tuo ambiente.
FAQ sui modelli di interazione

Jack Limebear fa parte del team Growth e si occupa di scrivere contenuti e definire strategie per il blog e le pagine insights. Prima di arrivare in ElevenLabs, ha guidato la strategia dei contenuti per oltre dieci anni in realtà che vanno da startup SaaS in rapida crescita a grandi aziende Fortune 500. Ha conseguito un Master in Letteratura Inglese presso l’Università di Cambridge.


