Cos'è il RAG? Come funziona la Retrieval-Augmented Generation
- Scritto da
- Jack Limebear
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
I modelli di IA generano risposte in base a ciò che hanno appreso durante l'addestramento, quindi non conoscono automaticamente le policy, i prodotti o altre informazioni di un'azienda create dopo l'addestramento. RAG (Retrieval-Augmented Generation) risolve questo problema recuperando informazioni esterne pertinenti e fornendole al modello prima che risponda.
RAG basa le risposte dell'IA sui documenti effettivi di un'azienda. Un agente di assistenza clienti che usa RAG può recuperare la policy di reso o le specifiche del prodotto aggiornate prima di rispondere, riducendo il rischio di allucinazioni.
Questa guida spiega cosa significa RAG nell'IA, come retrieval e generazione lavorano insieme e in cosa RAG differisce da un LLM usato da solo. Vedremo anche i limiti di RAG, dove funziona bene nelle applicazioni di IA generativa e come supporta il recupero delle conoscenze negli agenti IA.
In sintesi
- RAG abbina un sistema di retrieval a un modello generativo, così il modello può usare informazioni che vanno oltre i suoi dati di addestramento.
- Le conoscenze recuperate da RAG risiedono all'esterno del modello, quindi puoi aggiornarle senza dover riaddestrare nulla.
- ElevenAgents usa automaticamente RAG quando una knowledge base è troppo grande per entrare direttamente nel contesto del modello, così le risposte rimangono rapide senza sacrificare l'accuratezza su knowledge base grandi e complesse.
Cos'è RAG nell'IA?
RAG è un'architettura di sistema basata su un LLM che gli fornisce informazioni esterne, come linee guida del brand, manuali di prodotto, articoli della knowledge base o database interni. Questo permette all'IA di lavorare con informazioni specifiche dell'azienda, così le risposte possono riflettere policy aggiornate, conoscenze private e dettagli aziendali su cui il modello non è mai stato addestrato.
Un LLM può inoltre considerare contemporaneamente solo una quantità limitata di informazioni, nota come finestra di contesto. Una grande knowledge base aziendale può superare rapidamente questo limite, quindi RAG mantiene le informazioni all'esterno dell'LLM e recupera solo i passaggi necessari per la domanda corrente.
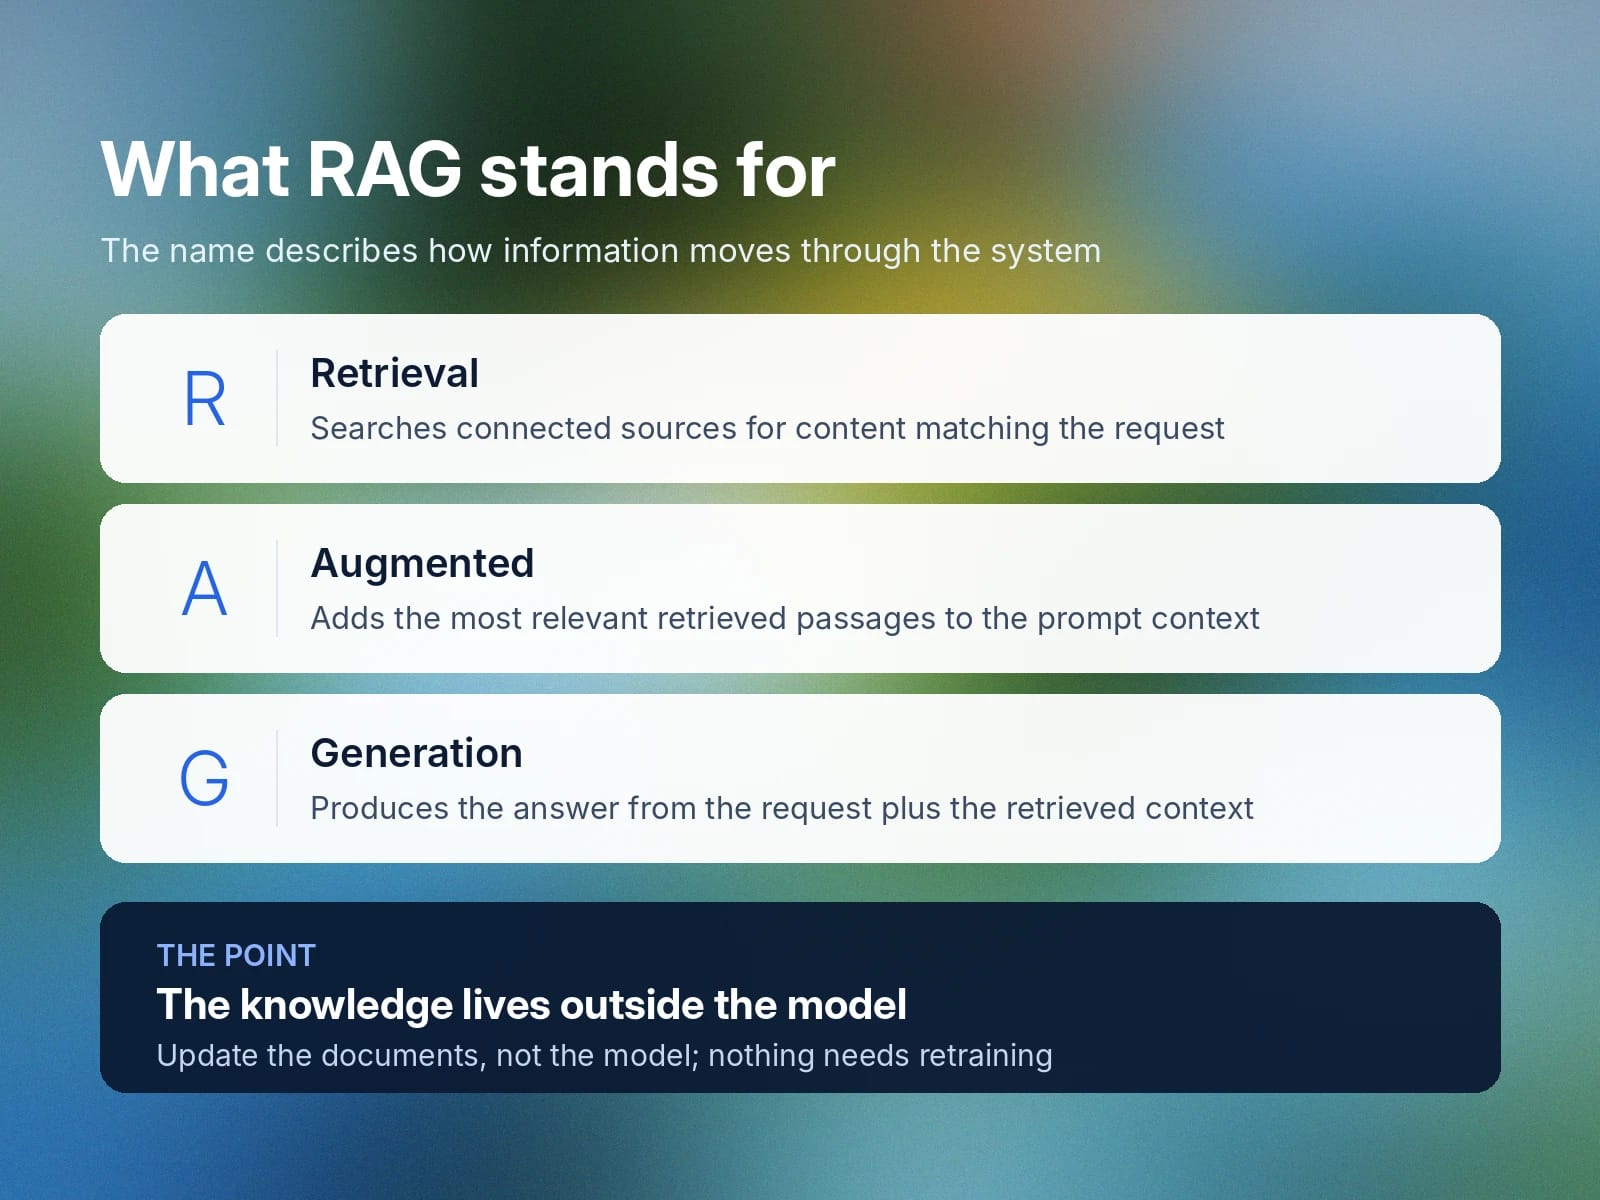
Il nome descrive come le informazioni si muovono nel sistema:
- Retrieval: cerca nei contenuti delle fonti collegate, come documenti sulle policy, log dell'help desk o file di inventario, quelli che corrispondono alla richiesta dell'utente.
- Augmented: aggiunge al contesto del prompt i passaggi recuperati più pertinenti.
- Generation: usa la richiesta dell'utente e il contesto recuperato per produrre la risposta.
RAG supporta anche il grounding, ovvero la pratica di collegare una risposta dell'IA a informazioni specifiche della fonte, fornendo all'LLM materiale pertinente da usare per generare una risposta. Ad esempio, se un cliente chiede informazioni su una policy di garanzia, il sistema RAG recupera i termini pertinenti dalla documentazione aziendale e li fornisce all'LLM affinché possa rispondere.
Come funziona Retrieval-Augmented Generation?
Un sistema RAG prepara le conoscenze esterne per la ricerca, recupera le informazioni più pertinenti alla domanda dell'utente e le fornisce all'LLM come contesto prima che generi una risposta.
Le implementazioni di RAG variano in complessità. Il RAG di base utilizza un semplice processo di recupero e generazione, mentre approcci più avanzati possono aggiungere riscrittura delle query, filtri, reranking o altre tecniche di retrieval.
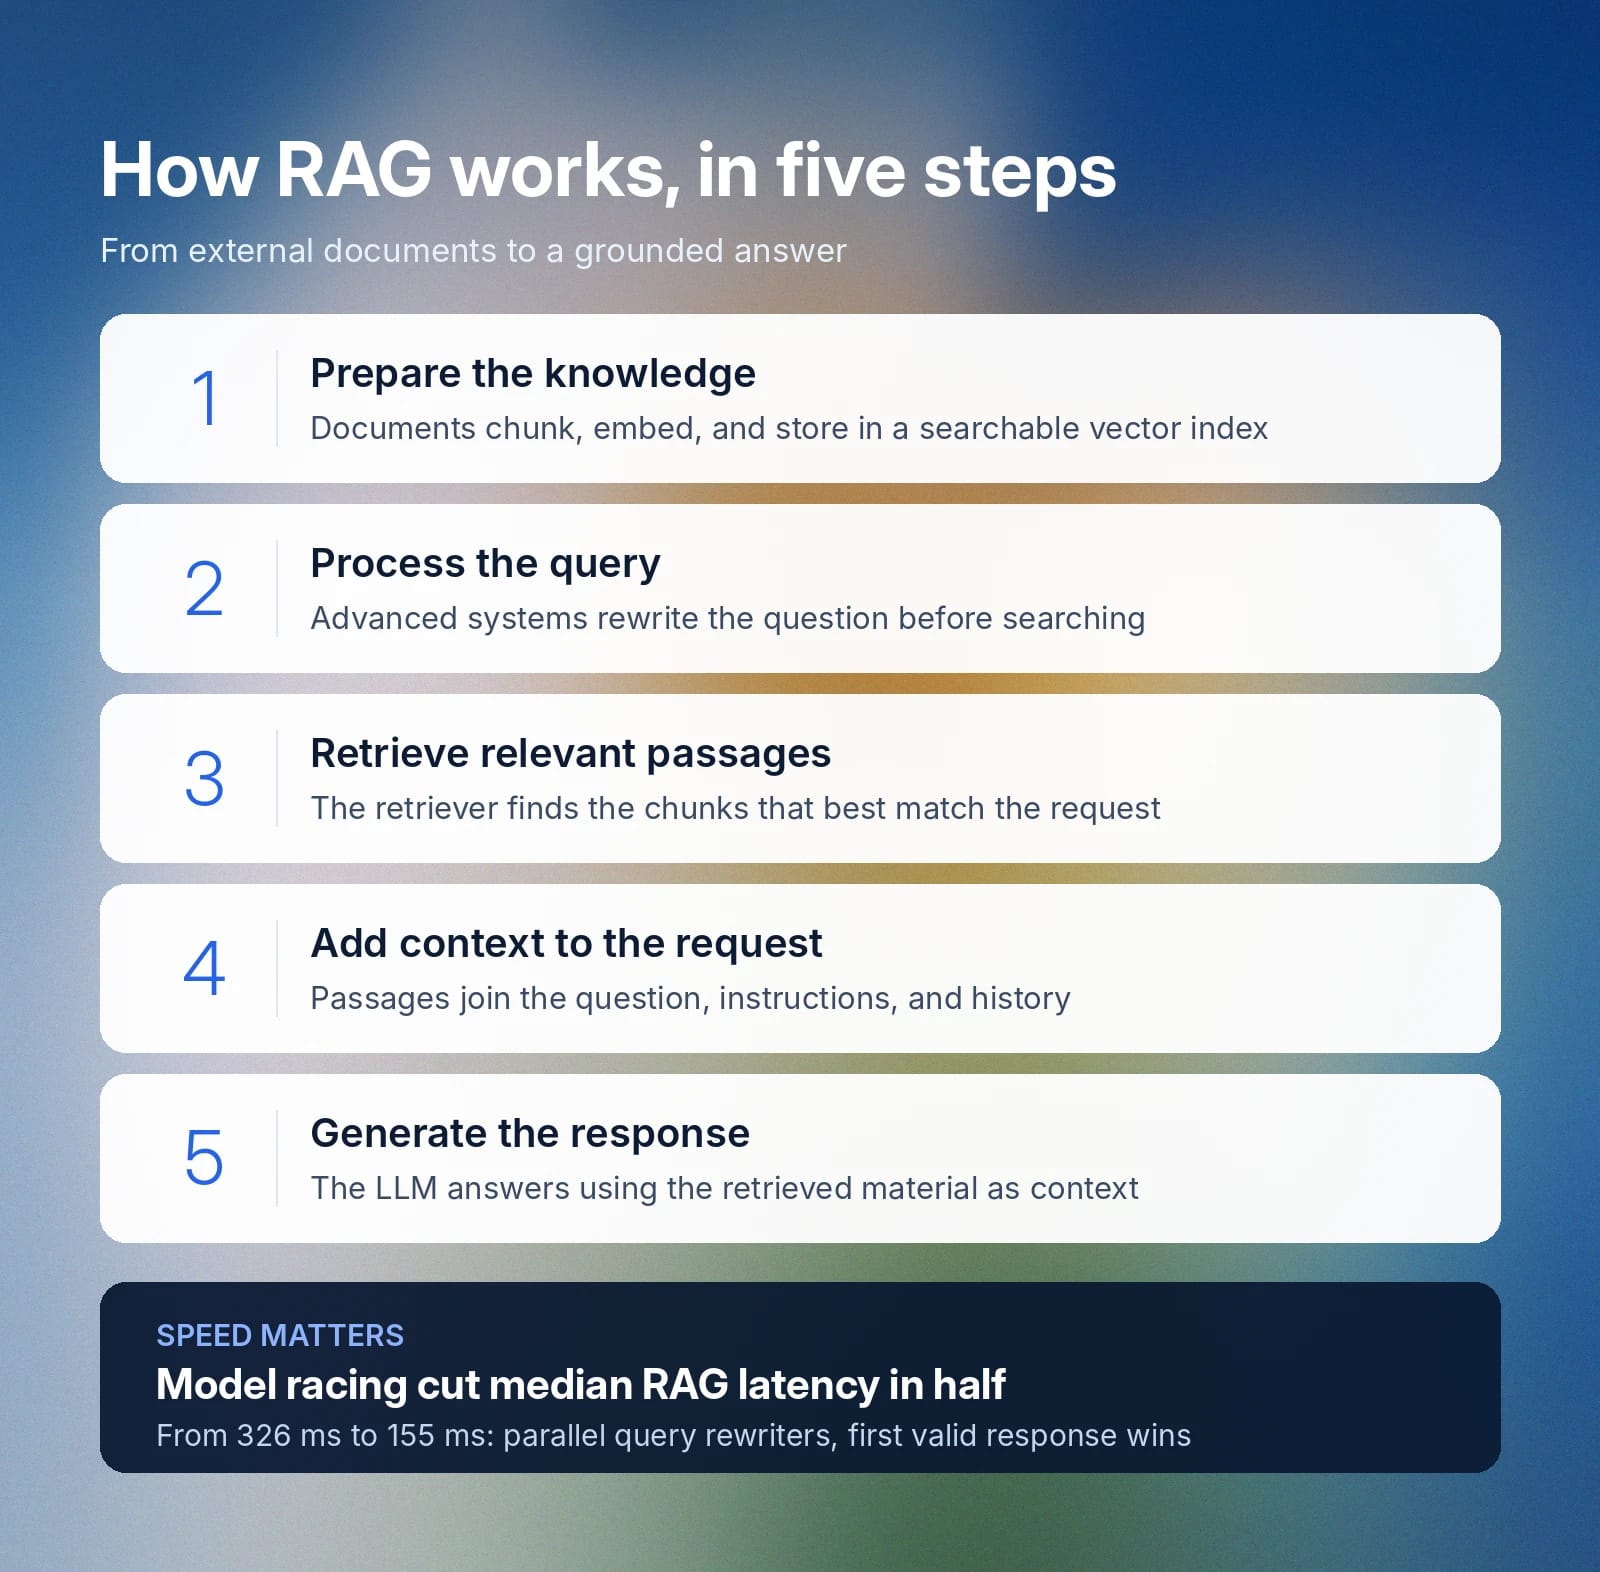
Il processo RAG segue solitamente cinque passaggi:
- Prepara le conoscenze: i documenti vengono suddivisi in passaggi più piccoli (un processo chiamato “chunking”), convertiti in rappresentazioni matematiche chiamate embedding e archiviati in un indice ricercabile o in un database vettoriale.
- Elabora la query: il sistema interpreta la domanda dell'utente e, nei sistemi RAG più avanzati, la riscrive o la affina prima della ricerca.
- Recupera i passaggi pertinenti: il retriever cerca nella knowledge base indicizzata i chunk di testo che corrispondono meglio alla richiesta.
- Aggiungi contesto alla richiesta del modello: i passaggi selezionati vengono inviati all'LLM insieme alla domanda dell'utente, alle istruzioni pertinenti e alla cronologia della conversazione.
- Genera la risposta: l'LLM produce una risposta usando il materiale recuperato come parte del suo contesto.
Molti sistemi RAG attivano il retrieval in modo selettivo come strumento esterno. ElevenAgents permette ai team di abilitare RAG per una knowledge base direttamente nelle impostazioni dell'agente e il sistema usa la riscrittura delle query per trasformare i dialoghi precedenti e riferimenti vaghi in una query di ricerca precisa e autonoma durante i follow-up conversazionali.
Per garantire risposte tempestive, ElevenLabs ha sviluppato anche un'architettura di model racing che invia ogni query a più modelli di riscrittura in parallelo e usa la prima risposta valida. Questo approccio ha dimezzato la latenza mediana di RAG, da 326 ms a 155 ms, mantenendo il retrieval abbastanza rapido da preservare un flusso conversazionale naturale anche quando viene attivato da una knowledge base di grandi dimensioni.
Qual è la differenza tra LLM e modelli RAG?
Un LLM è un modello che comprende e genera linguaggio. RAG è un'architettura attorno all'LLM che recupera informazioni esterne quando l'applicazione ne ha bisogno.
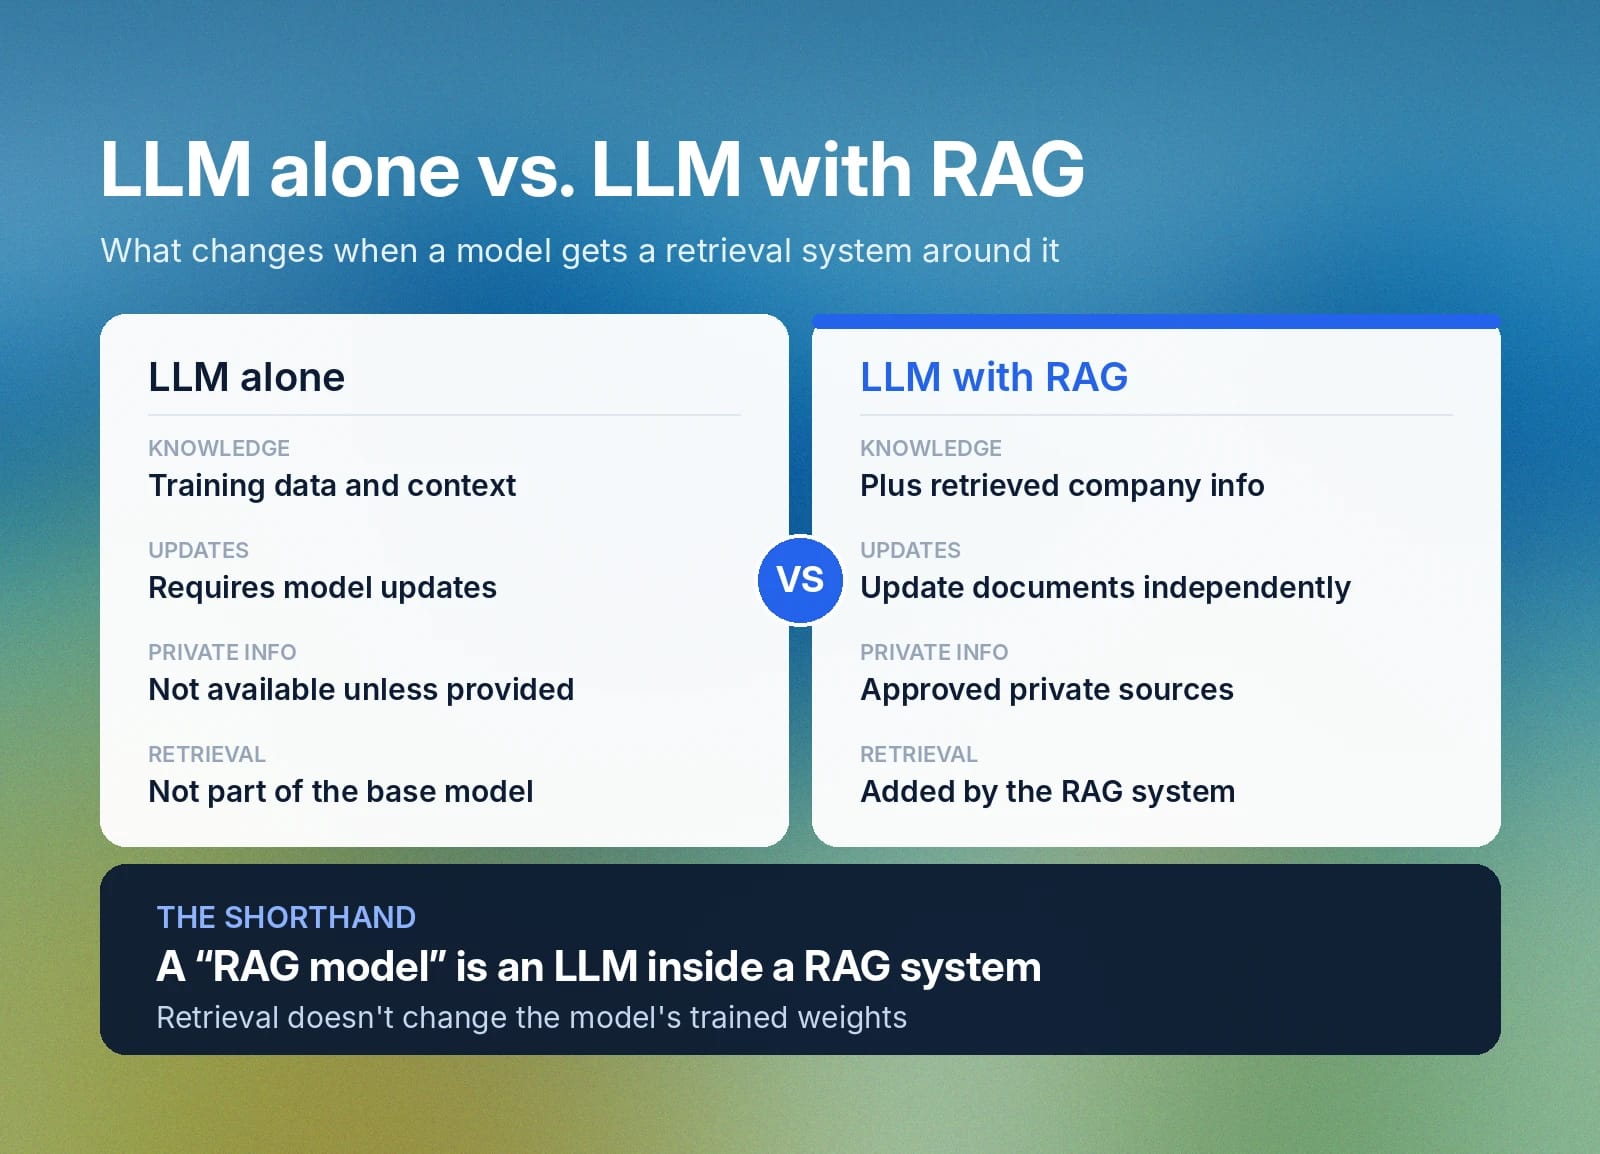
Ecco cosa cambia quando un LLM è abbinato a RAG:
Caratteristica | LLM da solo | LLM usato con RAG |
Conoscenze | Dati di addestramento e contesto attuale | Dati di addestramento, contesto attuale e informazioni aziendali recuperate, come policy, documentazione di prodotto o contenuti della knowledge base |
Aggiornamenti | Le nuove informazioni devono essere fornite nel contesto o tramite aggiornamenti del modello | Le conoscenze esterne possono essere aggiornate separatamente dal modello |
Informazioni private | Non disponibili, salvo se fornite | Può recuperarle da fonti private approvate |
Retrieval | Non fa parte del modello di base | Aggiunto dal sistema RAG circostante |
“Modello RAG” viene talvolta usato come abbreviazione per un LLM utilizzato all'interno di un sistema RAG. Ad esempio, un'azienda potrebbe dire di usare un “modello RAG” per l'assistenza clienti quando la configurazione effettiva è un LLM che recupera contenuti pertinenti del Centro assistenza o sulle policy prima di generare una risposta.
Limiti dei modelli RAG nelle applicazioni reali
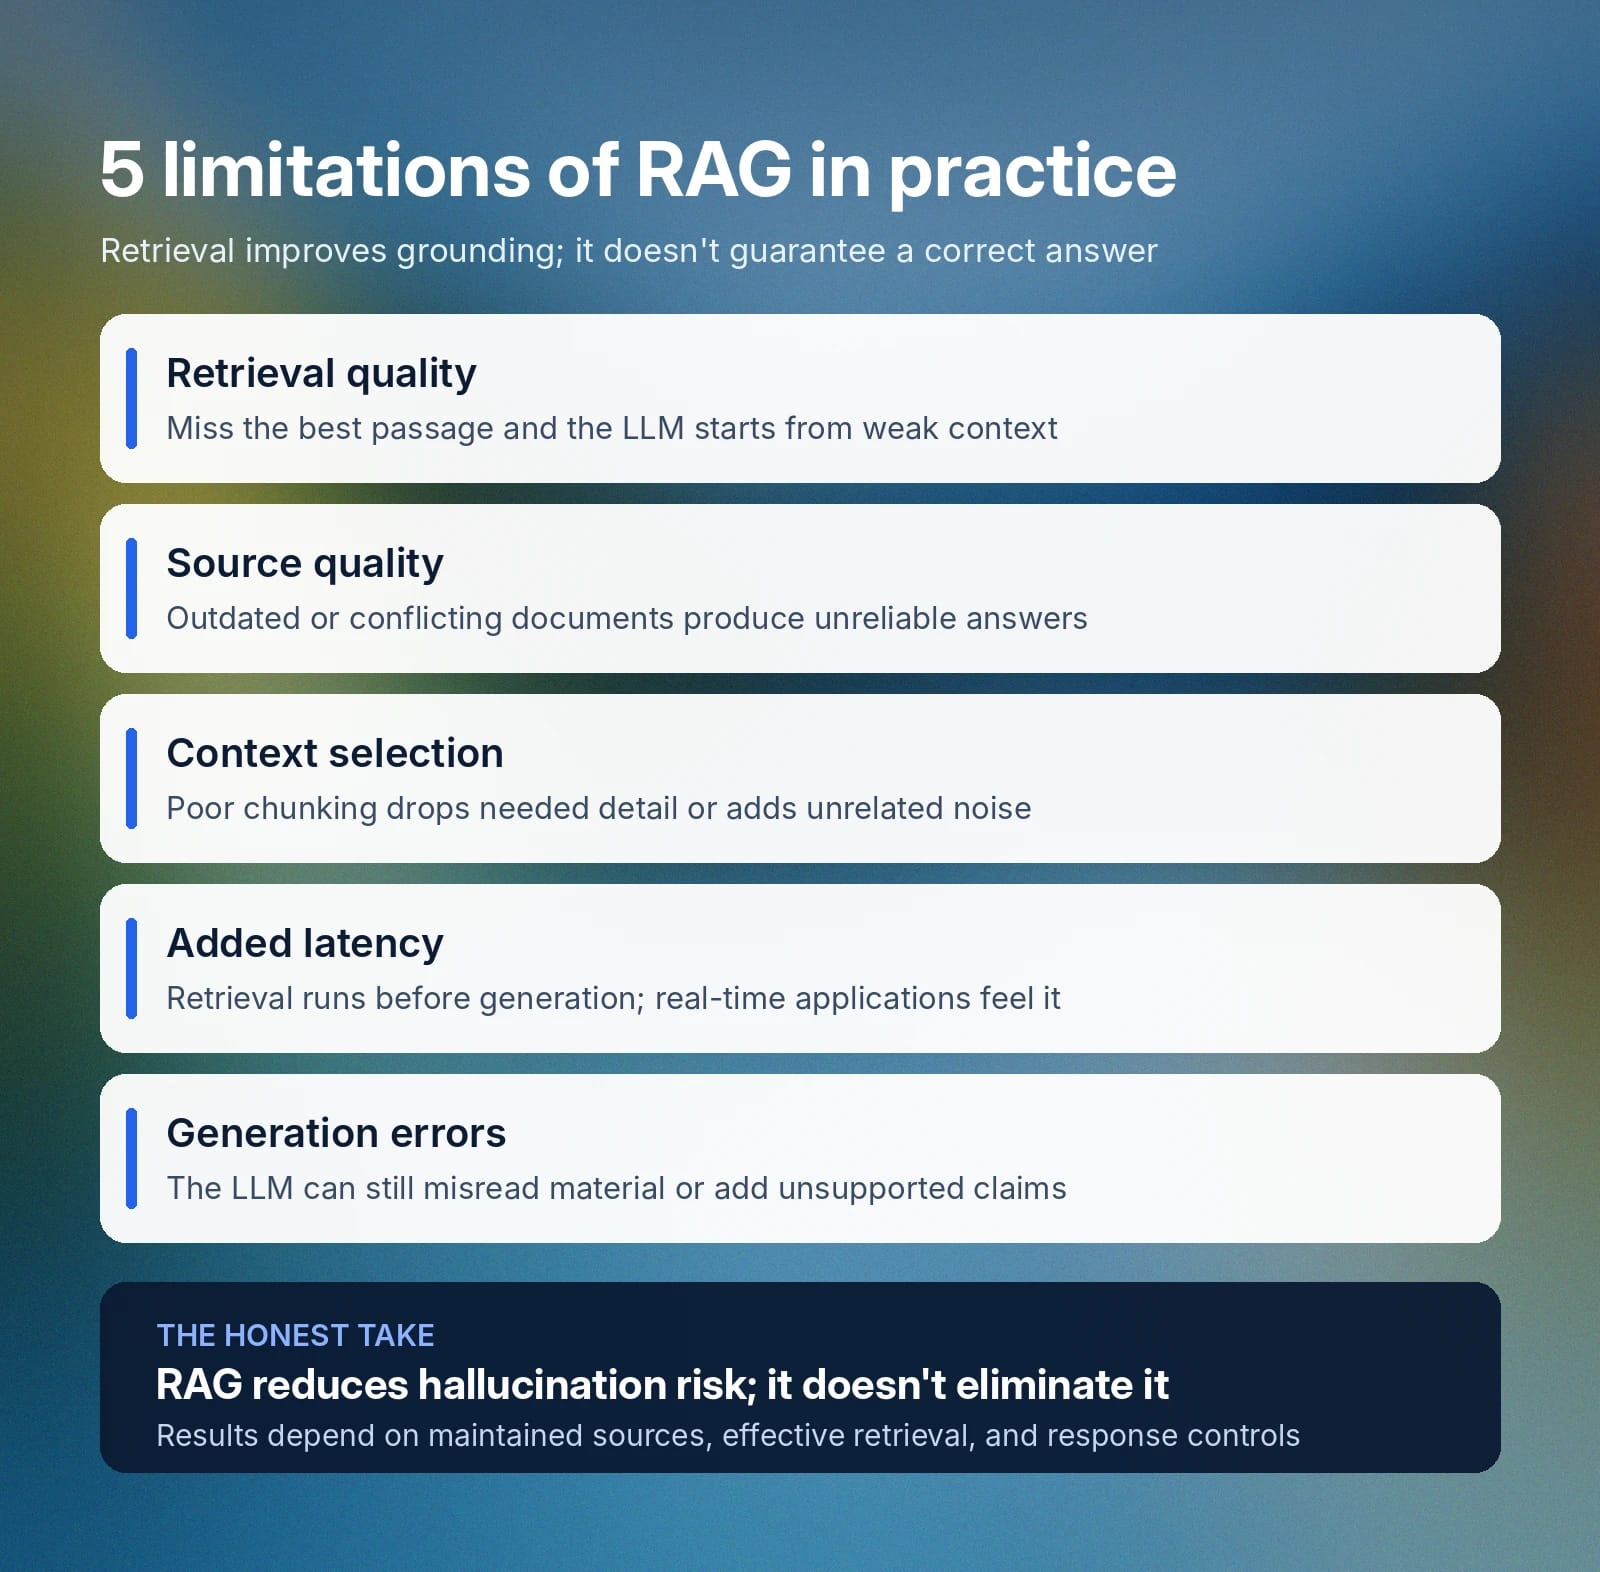
RAG migliora l'accesso alle conoscenze aziendali pertinenti archiviate fuori dall'LLM, ma il retrieval introduce limiti propri e non garantisce una risposta corretta. I principali limiti riguardano ciò che il sistema recupera, ciò che invia al modello e il modo in cui il modello risponde:
- Qualità del retrieval: se il sistema non trova il passaggio più pertinente, l'LLM parte da un contesto incompleto o debole. Query formulate male, corrispondenze semantiche deboli o formulazioni ambigue possono indirizzare il retrieval nella direzione sbagliata.
- Qualità delle fonti: documenti obsoleti, in conflitto tra loro o incompleti possono portare a risposte inaffidabili.
- Selezione del contesto: scelte inadeguate di chunking o retrieval possono eliminare dettagli necessari o introdurre informazioni non pertinenti.
- Latenza aggiuntiva: il retrieval e l'elaborazione delle query avvengono prima della generazione, e possono rallentare le risposte nelle applicazioni in tempo reale.
- Errori di generazione: l'LLM può comunque interpretare erroneamente le informazioni recuperate o introdurre affermazioni non supportate.
Sebbene RAG possa ridurre il rischio di allucinazioni, non lo elimina completamente. Risultati accurati dipendono comunque da fonti ben gestite, retrieval efficace e controlli sulla risposta finale.
RAG nell'IA generativa: casi d'uso pratici e vantaggi
RAG è particolarmente utile quando un'applicazione di IA ha bisogno di informazioni che cambiano spesso, appartengono all'organizzazione o sono troppo numerose per essere incluse in ogni richiesta al modello.
Ecco dove RAG fa la differenza maggiore:
Restare al passo con informazioni aggiornate di frequente
RAG aiuta i team a mantenere le risposte dell'IA allineate a dettagli di prodotto, prezzi, policy e inventario aggiornati. I team possono aggiornare le informazioni di origine in modo indipendente e RAG recupera la versione pertinente quando viene posta una domanda. Ad esempio, un agente di qualificazione dei lead può recuperare i prezzi o i dettagli dei piani più recenti quando qualifica un chiamante in entrata.
Usare conoscenze private o specializzate
Alcune conoscenze sono private o specializzate anziché pubbliche, come policy interne, documentazione tecnica o contenuti di assistenza destinati a un team specifico. RAG permette a un agente di recuperare direttamente da queste fonti, invece di basarsi solo su ciò che è disponibile pubblicamente o integrato nel modello.
Ad esempio, un agente di help desk IT o HR interno può recuperare informazioni da una knowledge base specifica per le risorse umane per rispondere a domande sui benefit dei dipendenti, invece di cercare nella documentazione pubblica che non conterrebbe queste informazioni.
Cercare in knowledge base di grandi dimensioni
RAG è utile quando un'azienda dispone di molta più documentazione di quanta un LLM possa considerare in una richiesta. Recupera solo i passaggi pertinenti alla domanda corrente invece di inviare l'intera raccolta al modello. In ambito commerciale, un assistente tecnico può cercare nei manuali di prodotto per trovare requisiti pertinenti durante una chiamata.
Inizia a usare ElevenAgents per soluzioni RAG avanzate
ElevenAgents offre ai team un modo per creare agenti vocali e chat basati sull'IA che usano RAG con fonti di conoscenza connesse, tramite la piattaforma web no-code oppure tramite API per i team che vogliono integrare gli agenti direttamente nei propri prodotti.
Per gli agenti abilitati a RAG, i team possono aggiungere documenti, URL o testo a una knowledge base e recuperare solo le informazioni pertinenti a ogni query.
ElevenLabs ha inoltre ottimizzato il retrieval per le conversazioni in tempo reale, riducendo la latenza mediana di RAG da 326 ms a 155 ms nella sua architettura ElevenAgents. I team che sviluppano con ElevenAgents ottengono queste funzionalità di retrieval già pronte, sia che configurino un agente dalla dashboard sia che lo sviluppino tramite API.
Inizia a creare con ElevenAgents oppure contatta il nostro team per trovare la configurazione giusta per la tua applicazione.


