
Che cos'è una finestra di contesto? Cosa dovrebbe sapere ogni utente di LLM
- Scritto da
- Jack Limebear
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
Una finestra di contesto è la quantità di informazioni che un modello linguistico di grandi dimensioni (LLM) può elaborare in una singola richiesta. Misurata in token, può includere il prompt, la cronologia della conversazione, le istruzioni di sistema, i documenti recuperati, i risultati degli strumenti e la risposta generata dal modello.
Una finestra di contesto più ampia consente a un modello di lavorare con più informazioni in un'unica richiesta. Ad esempio, un agente di coding che indaga su un bug potrebbe lavorare contemporaneamente con file sorgente pertinenti, documentazione, risultati dei test e modifiche recenti al codice, anziché analizzare ogni elemento separatamente e perdere contesto utile tra una richiesta e l'altra.
Tuttavia, una finestra di contesto più ampia non equivale a una memoria perfetta. I prompt più lunghi richiedono più calcoli, consumano più token e possono rendere più difficile per un modello identificare i dettagli davvero importanti. La ricerca sui modelli a contesto lungo, incluso lo studio Lost in the Middle e il benchmark RULER di NVIDIA, ha rilevato ripetutamente che, man mano che il contesto cresce, i modelli usano una parte minore delle informazioni disponibili, soprattutto quando quelle pertinenti sono nascoste tra contenuti meno utili.
Questo articolo spiega come funzionano le finestre di contesto, come vengono misurate, cosa accade quando si riempiono e come gli sviluppatori possono gestirle in modo efficace.
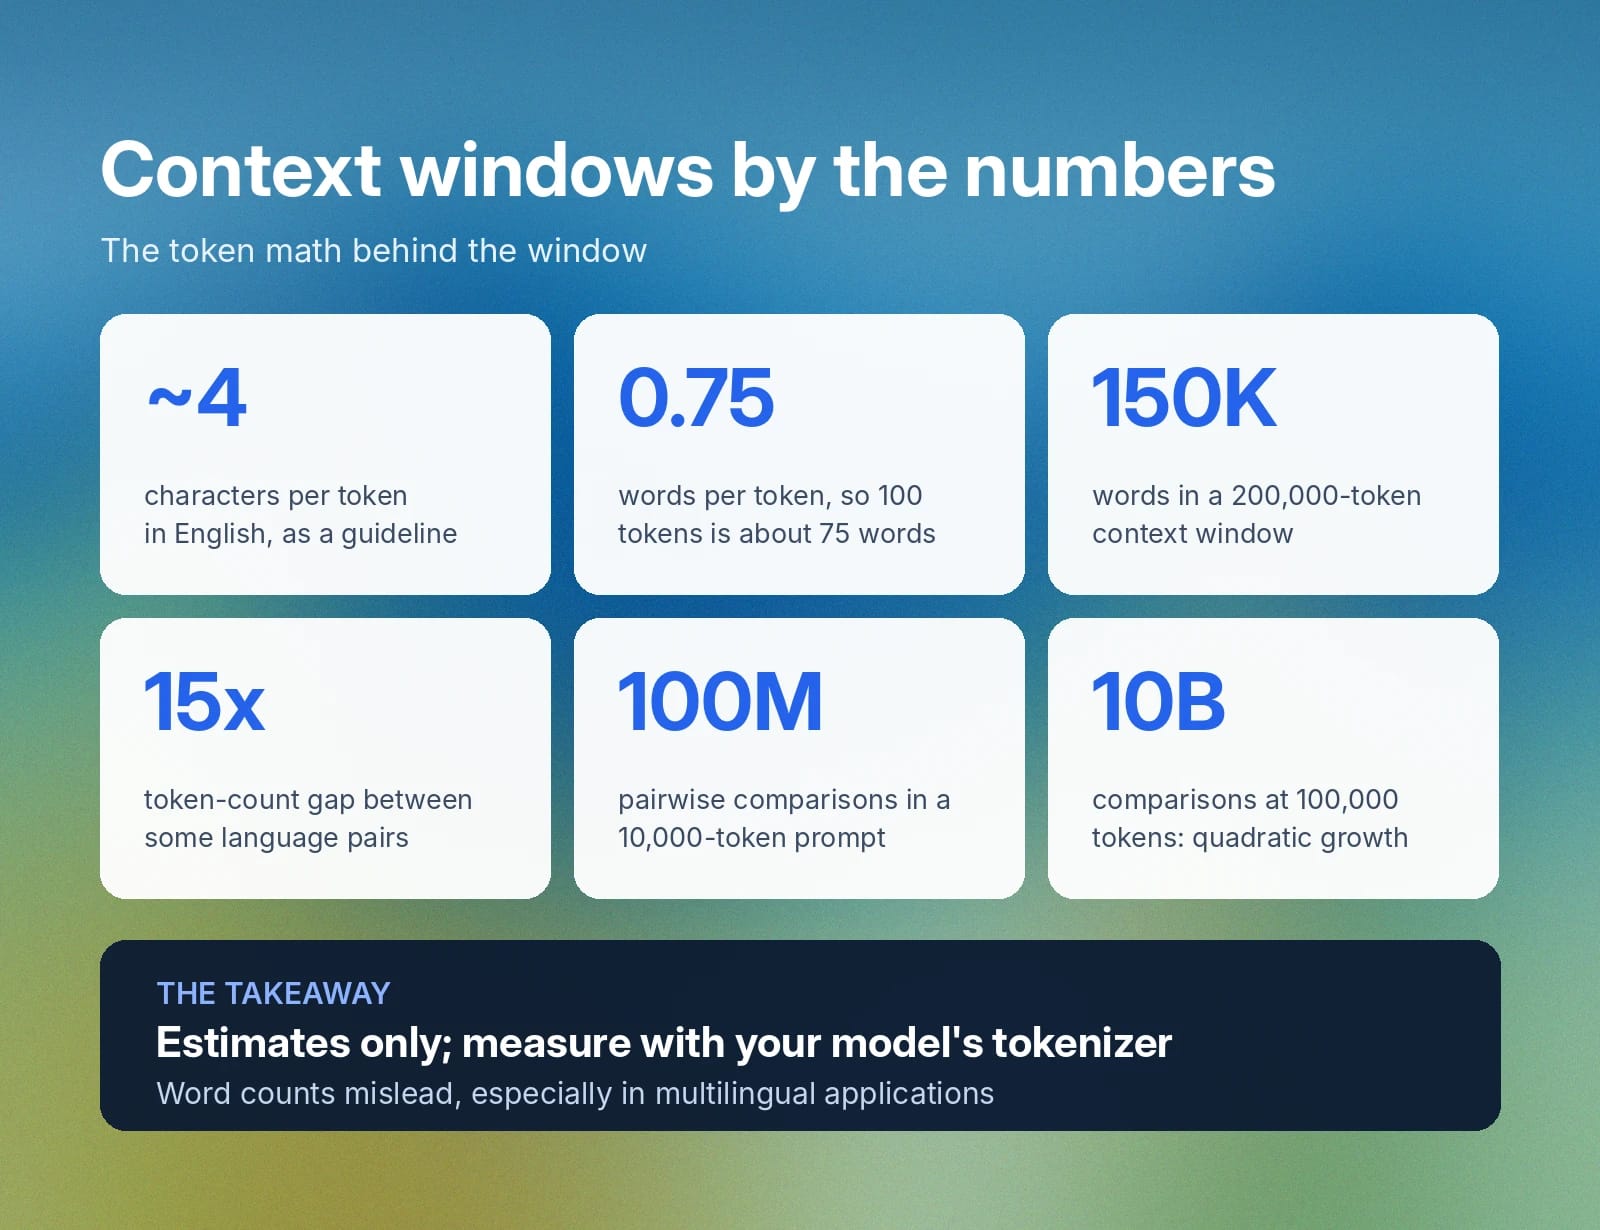
In sintesi
- Una finestra di contesto è il budget totale di token a cui un LLM attinge per una singola richiesta. Comprende il prompt dell'utente, la cronologia della conversazione, i contenuti recuperati e l'output.
- Finestre di contesto più ampie permettono di gestire documenti, codebase e conversazioni più lunghi, ma non garantiscono che il modello utilizzi bene ogni loro parte.
- I modelli recuperano le informazioni in modo meno affidabile dalla parte centrale dei prompt lunghi, un fenomeno documentato dallo studio Lost in the Middle e dal benchmark RULER.
- Una gestione efficace del contesto (recupero, riepilogo, caching) di solito è più utile che massimizzare semplicemente il numero di token inviati.
- La migliore strategia di contesto è quella adatta al tuo carico di lavoro effettivo, non quella che usa la finestra di contesto pubblicizzata più grande.
Cos'è una finestra di contesto in un modello IA?
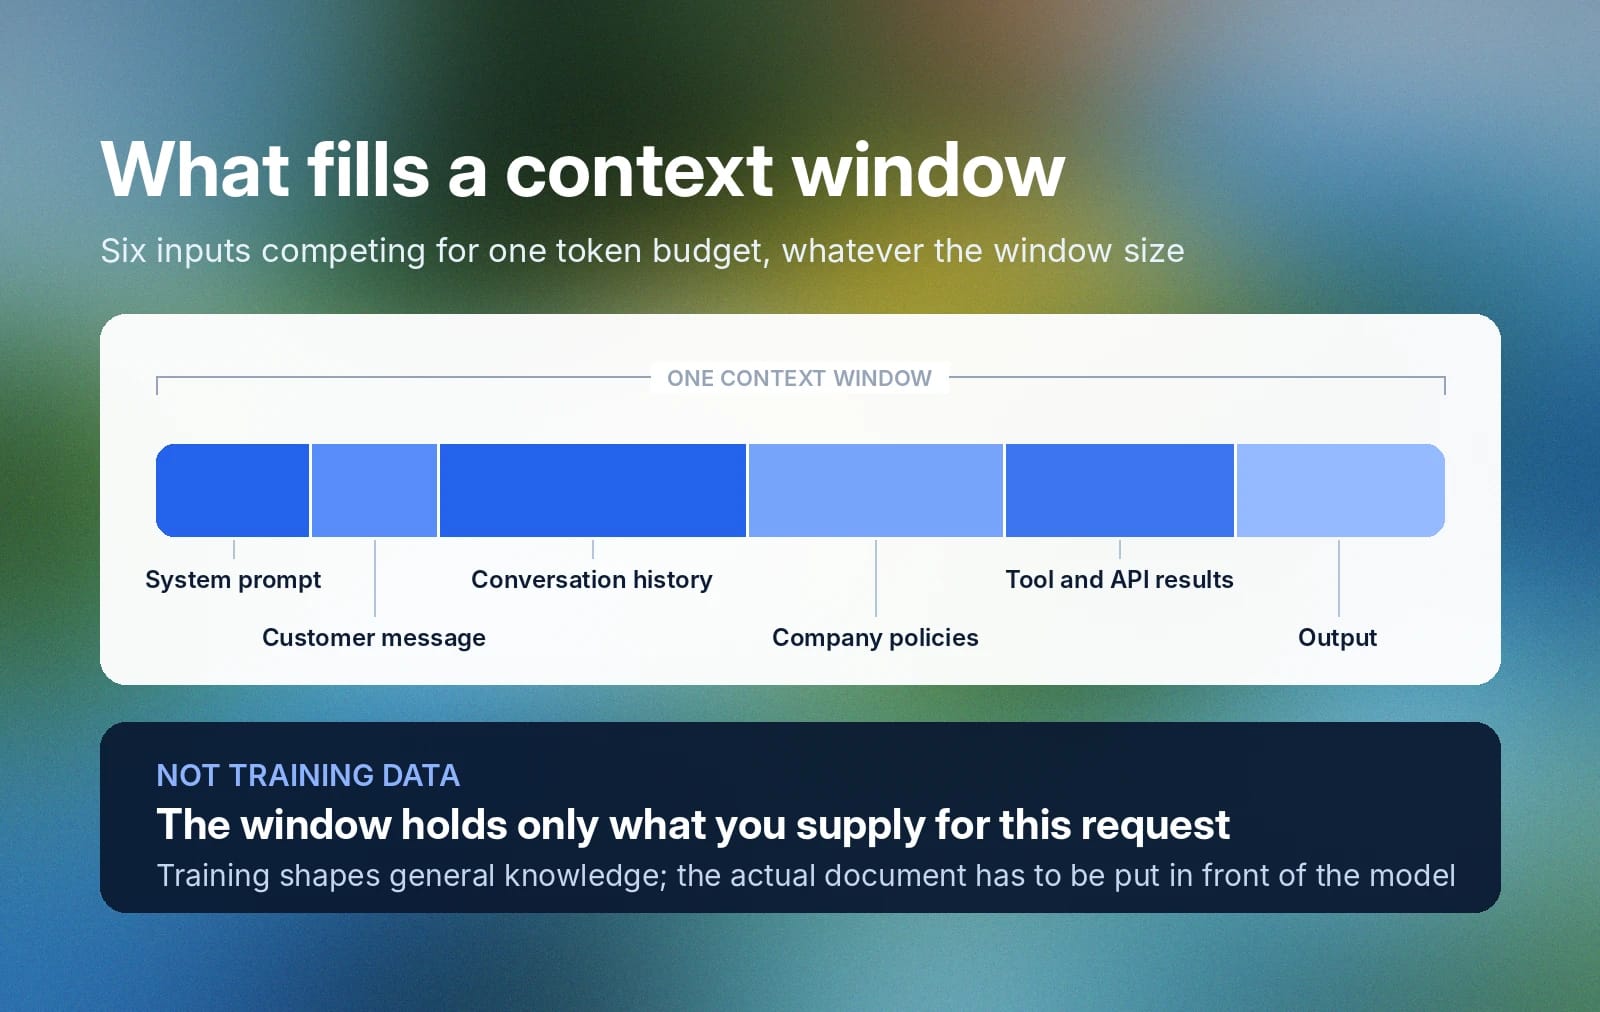
Una finestra di contesto è l'area di lavoro attiva di un modello, in cui confluisce tutto ciò che è rilevante per la richiesta corrente prima che il modello generi una risposta.
Prendi un agente IA che riepiloga una conversazione di assistenza clienti e consiglia una soluzione. Per farlo bene, il modello deve elaborare:
- Il prompt di sistema
- Il messaggio del cliente
- La cronologia della conversazione
- Le policy aziendali
- I risultati degli strumenti e delle API
- L'output
Tutto questo compete per lo spazio all'interno della stessa finestra di contesto, indipendentemente dalle sue dimensioni.
Le finestre di contesto non includono i dati di addestramento. L'addestramento incorpora permanentemente le informazioni nei parametri di un modello, plasmando ciò che “sa” in generale. Una finestra di contesto, invece, contiene soltanto le informazioni fornite per l'attività corrente.
Questa distinzione è importante nella pratica: se un'applicazione ha bisogno che un modello ragioni su una policy specifica, un record cliente o un documento tecnico, tali informazioni non sono disponibili soltanto perché il modello è stato addestrato su materiale simile. In genere devono entrare direttamente nel contesto di lavoro del modello tramite il prompt o attraverso un sistema di recupero o uno strumento, altrimenti il modello ragionerà sulla base di conoscenze generali anziché sul documento effettivo che ha davanti.
Tokenizzazione e finestre di contesto: come vengono elaborati i dati
Prima che un LLM elabori un testo, un tokenizzatore lo suddivide in unità più piccole chiamate token. Un token può rappresentare una parola intera, una parte di parola, un segno di punteggiatura o un altro breve frammento di testo.
Per l'inglese, un'indicazione utile è che un token rappresenti circa quattro caratteri, ovvero all'incirca tre quarti di parola. Secondo questa stima, 100 token corrispondono a circa 75 parole. Si tratta però soltanto di un'approssimazione. Considera la frase “Le finestre di contesto influenzano le prestazioni dell'applicazione.” Un tokenizzatore non la rappresenta necessariamente come cinque parole complete; a seconda del tokenizzatore, una o più parole possono essere divise in più token di sottoparole.
La tokenizzazione varia inoltre in modo significativo tra le lingue. Due frasi con significati e lunghezze visibili simili possono consumare numeri di token molto diversi a seconda della lingua e del tokenizzatore. La ricerca sull'equità dei tokenizzatori ha rilevato che alcune coppie di lingue possono differire fino a 15 volte nella lunghezza tokenizzata di un testo equivalente, anche con tokenizzatori progettati per il supporto multilingue. Gli sviluppatori che creano applicazioni multilingue dovrebbero misurare l'utilizzo dei token con il tokenizzatore effettivo del proprio modello, anziché stimarlo in base al conteggio delle parole.
Una finestra di contesto di 200.000 token può sembrare enorme, ma un'applicazione che aggiunge continuamente la cronologia della conversazione, documentazione recuperata, risposte degli strumenti e istruzioni di sistema può avvicinarsi a quel limite più rapidamente del previsto. Per questo, le applicazioni in produzione monitorano spesso l'utilizzo dei token e usano tecniche come il riepilogo, la rimozione della cronologia, il filtraggio del recupero e la compressione dei prompt per mantenere le informazioni più rilevanti nel contesto attivo.
Come funziona una finestra di contesto nei modelli linguistici?
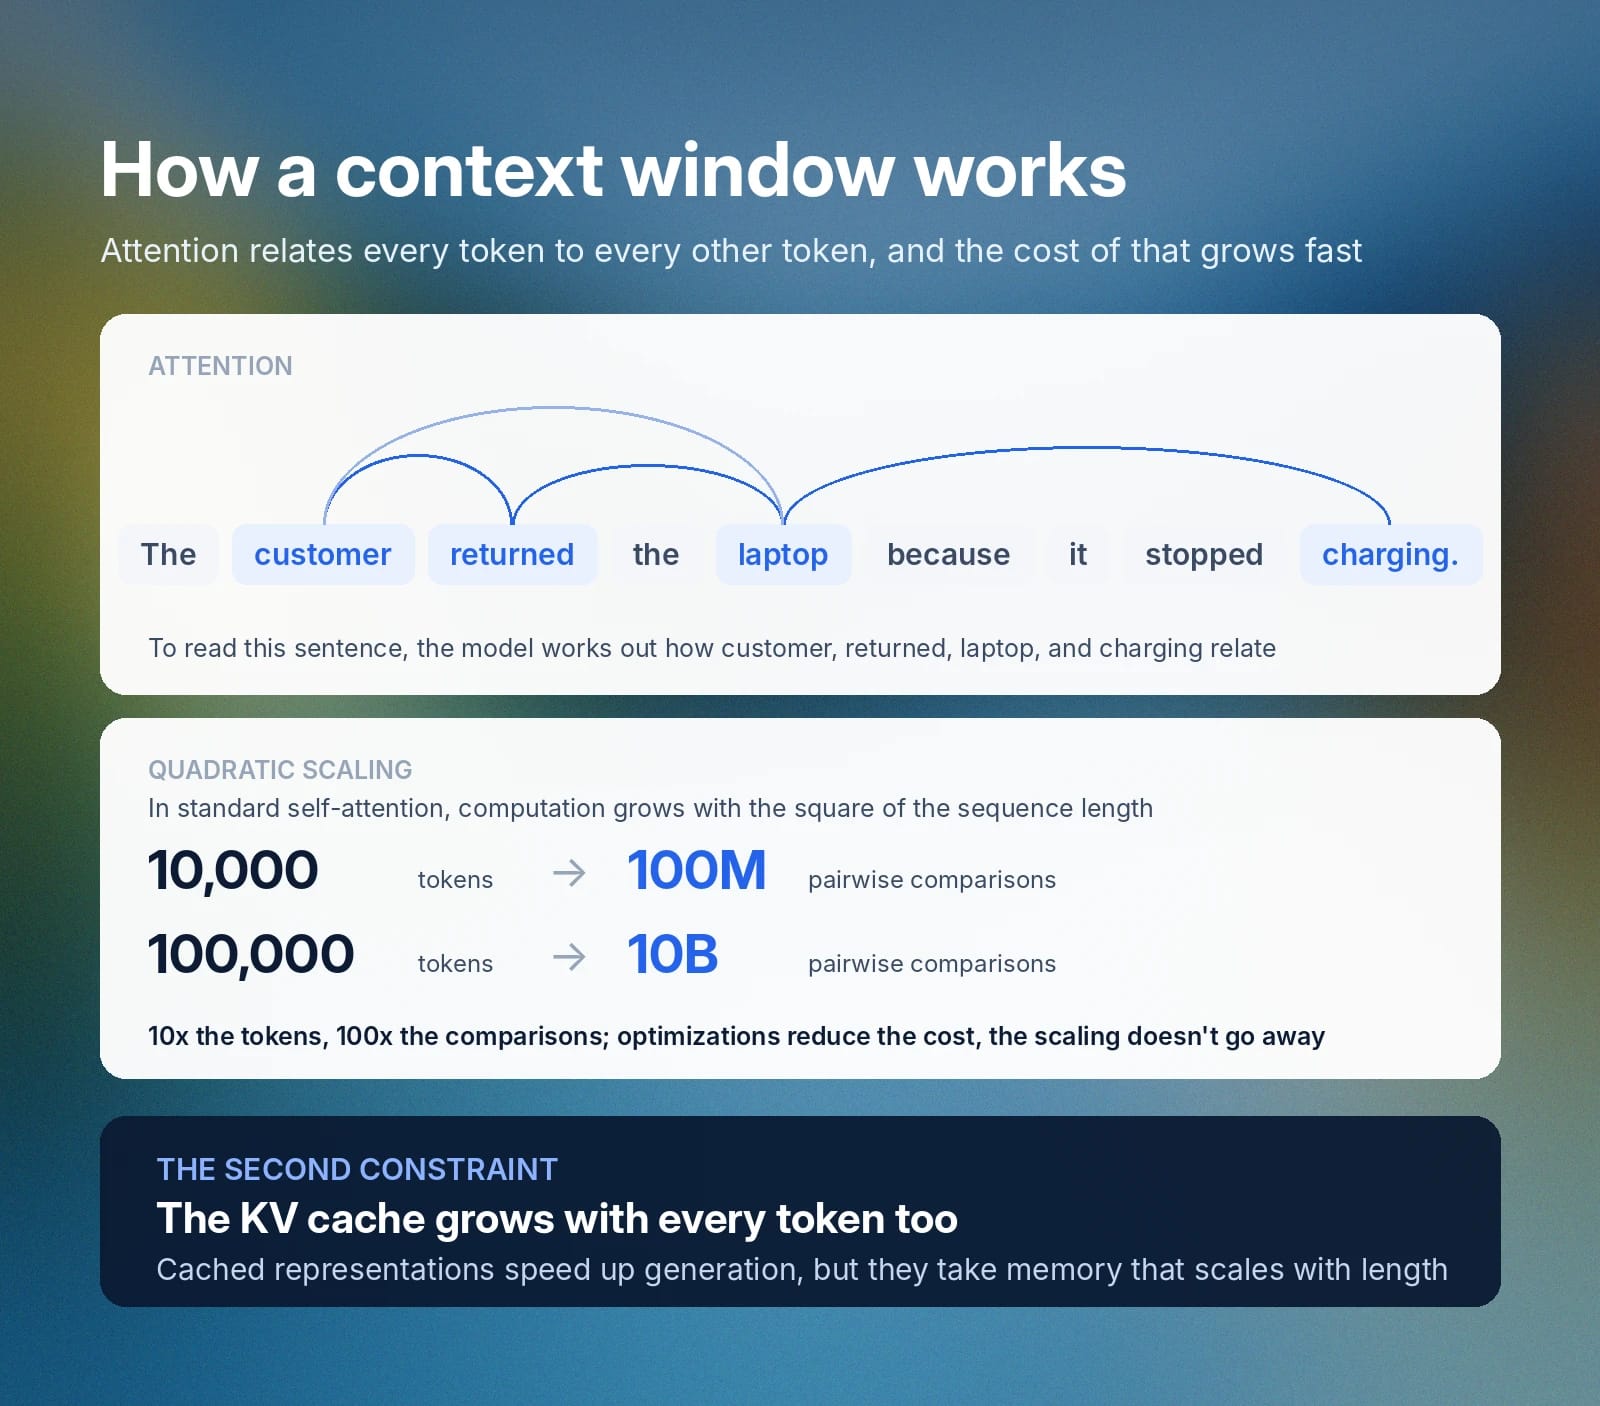
Una finestra di contesto funziona tramite il meccanismo di attenzione dell'architettura transformer, che calcola come ogni token di un input sia collegato a ogni altro token prima che il modello produca una risposta.
Considera la frase "Il cliente ha restituito il laptop perché ha smesso di caricarsi." Per interpretarla correttamente, il modello deve capire come cliente, laptop, restituito e caricarsi siano collegati tra loro. Man mano che una sequenza si allunga, il numero di queste relazioni cresce rapidamente.
Nella self-attention standard, il calcolo richiesto cresce approssimativamente con il quadrato della lunghezza della sequenza. Ad esempio, un prompt di 10.000 token richiede circa 100 milioni di confronti a coppie, mentre un prompt di 100.000 token ne richiede circa 10 miliardi. I modelli moderni usano varie ottimizzazioni dell'architettura e dell'infrastruttura per ridurre questo costo nella pratica, ma il problema di scalabilità di base non scompare.
Le conversazioni lunghe aggiungono un secondo vincolo: la cache key-value, o KV. Durante la generazione, i modelli conservano rappresentazioni intermedie dei token precedenti invece di ricalcolarle per ogni nuovo token, accelerando notevolmente l'inferenza. Tuttavia, la cache stessa occupa memoria e cresce man mano che la sequenza si allunga.
Lunghezza massima del contesto nei modelli IA e perché conta
La lunghezza massima del contesto di un modello definisce quante informazioni può accettare ed elaborare in una singola richiesta. Tuttavia, stabilire se il modello usi efficacemente una finestra di contesto ampia è una questione distinta.
Finestre di contesto più lunghe rendono possibili casi d'uso che erano difficili o poco pratici con gli LLM precedenti. Gli sviluppatori possono fornire a un modello un intero repository di codice, un lungo documento legale, un articolo di ricerca, la trascrizione di una riunione, oppure una cronologia sostanziale di conversazioni senza dover prima ridurre il materiale a poche migliaia di token.
Questo è importante perché preservare una parte maggiore del contesto originale può migliorare la capacità del modello di rispondere accuratamente alle domande, identificare relazioni tra elementi di informazione distanti e svolgere attività che dipendono dal documento nel suo insieme. Ad esempio, un assistente di coding potrebbe dover esaminare più file per capire come viene chiamata una funzione, mentre un assistente per documenti legali potrebbe dover confrontare le definizioni in una sezione con gli obblighi descritti molto più avanti nel documento.
Tuttavia, una finestra di contesto più ampia non produce automaticamente risultati migliori. Input molto lunghi possono aumentare costi e latenza, e i modelli potrebbero prestare meno attenzione alle informazioni nascoste al centro di un ampio contesto. Gli sviluppatori dovrebbero quindi includere selettivamente le informazioni pertinenti, organizzare chiaramente gli input lunghi e usare tecniche come il recupero, il riepilogo e la rimozione del contesto quando opportuno.
Confronto delle dimensioni delle finestre di contesto per modello
Le finestre di contesto variano molto tra le principali famiglie di modelli di oggi: da alcune centinaia di migliaia di token fino a 10 milioni. Ecco come si confrontano gli attuali modelli di punta:
Modello
Finestra di contesto
Note
10 milioni di token
Modello di Meta a pesi aperti; la finestra più grande disponibile pubblicamente al momento della stesura
1,05 milioni di token
L'attuale modello di punta di OpenAI per il coding e il ragionamento agentico
1 milione di token
L'attuale modello Google di livello Pro per l'analisi di documenti lunghi e più file
1 milione di token
L'attuale modello Anthropic di livello Sonnet; la finestra si applica per impostazione predefinita all'intera API Claude
I limiti dichiarati cambiano rapidamente quando i fornitori rilasciano nuovi modelli e alzano le soglie, quindi considera una tabella come questa un'istantanea anziché una classifica permanente. La dimensione del contesto è inoltre solo uno degli elementi da valutare nella scelta di un modello. Da sola non dice nulla sulla qualità del ragionamento, sui limiti di output, sulla latenza o sui costi.
Implicazioni di una finestra di contesto piccola o grande
Una finestra di contesto piccola costringe gli sviluppatori a essere selettivi. I documenti lunghi vengono suddivisi in chunk, la cronologia meno recente delle conversazioni viene riepilogata e la conoscenza esterna viene recuperata soltanto quando è realmente necessaria.
Una finestra di contesto grande rimuove alcuni di questi vincoli. Puoi fornire più esempi, mantenere una cronologia più estesa delle conversazioni o analizzare un insieme più ampio di documenti senza dover prima dividere tutto.
Tuttavia, una finestra più ampia introduce un problema diverso: la diluizione dell'attenzione. Quando un prompt contiene una grande quantità di informazioni, il modello può faticare a identificare i dettagli più pertinenti alla richiesta corrente. Istruzioni o prove importanti possono restare nascoste tra contenuti meno pertinenti, aumentando il rischio di risposte incomplete, incoerenti o meno precise.
Perché i modelli si perdono nel mezzo
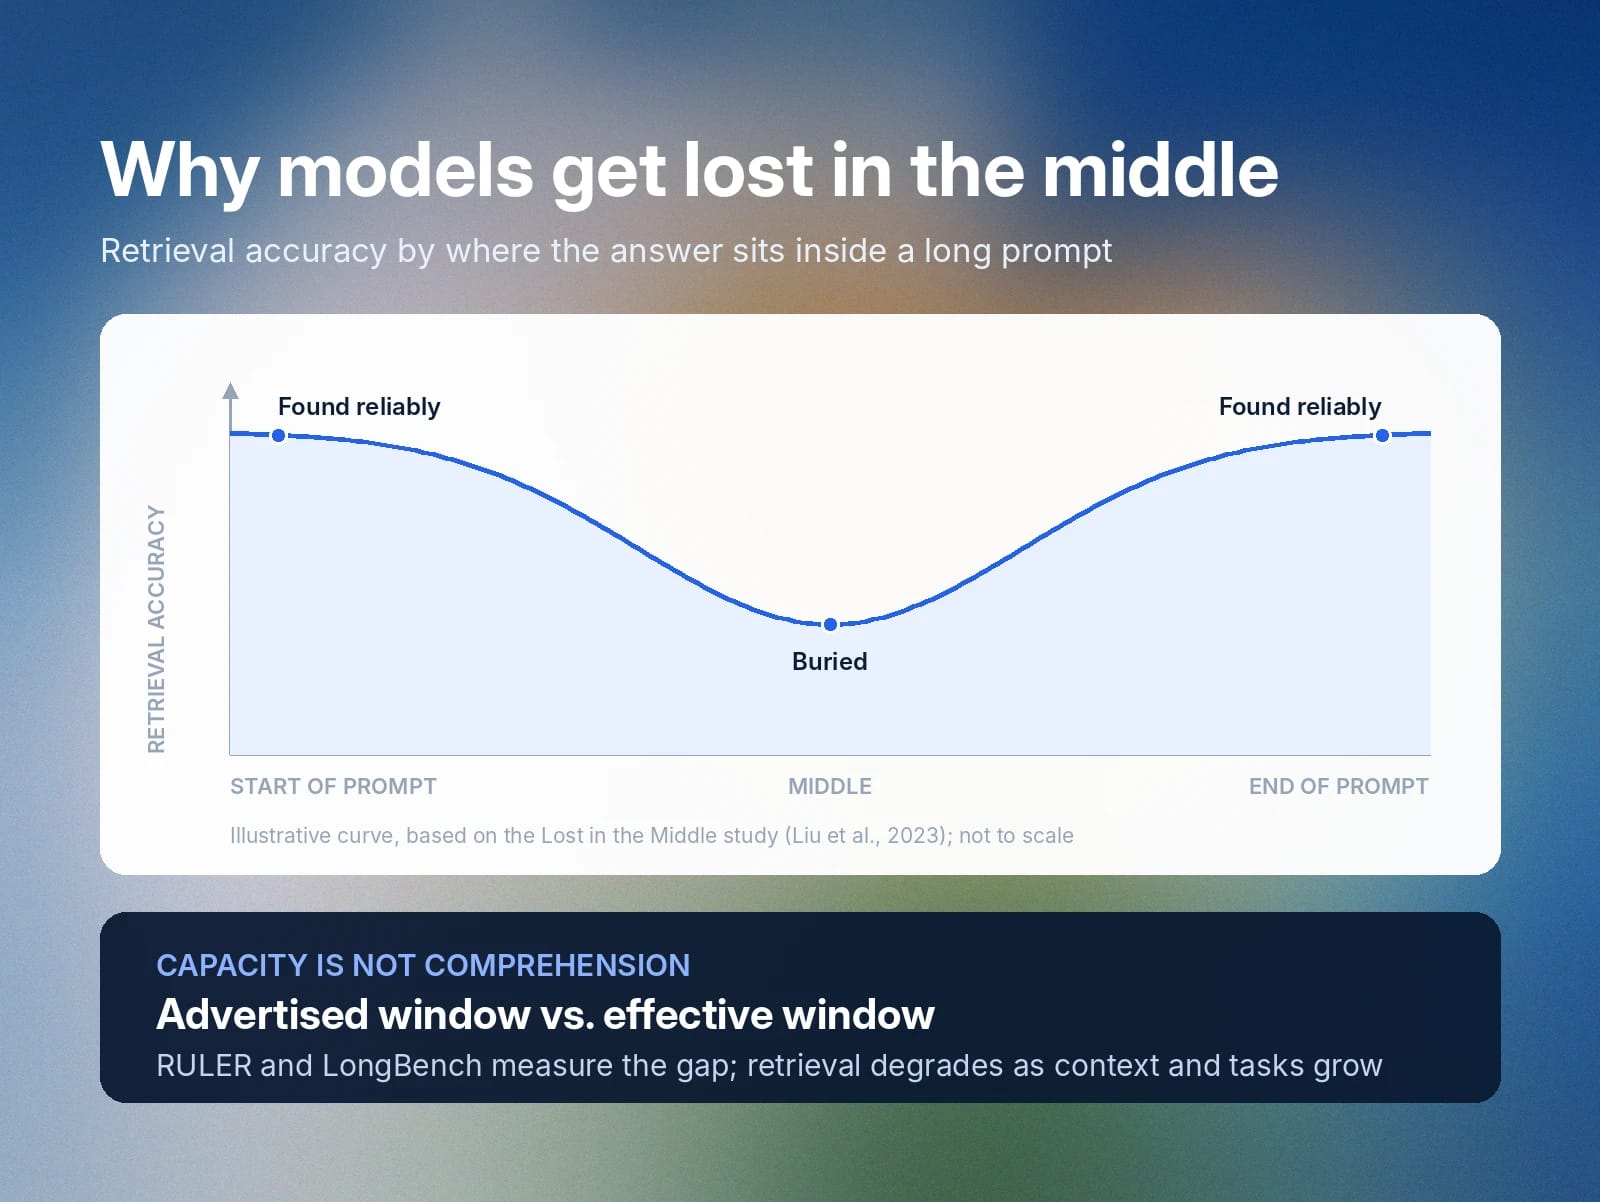
I modelli tendono a recuperare le informazioni più efficacemente quando si trovano all'inizio o alla fine di un prompt lungo, e meno efficacemente quando sono nascoste nel mezzo. L'influente studio Lost in the Middle lo ha testato direttamente, collocando la risposta a una domanda in posizioni diverse all'interno di un prompt lungo e misurando la frequenza con cui i modelli la trovavano. L'accuratezza era costantemente più alta all'inizio e alla fine del contesto, e più bassa nel mezzo.
Ciò significa che un modello può tecnicamente accettare un documento senza utilizzarne in modo affidabile ogni parte. Invia a un LLM 100 documenti di assistenza perché uno di essi contiene la risposta alla domanda di un cliente e una finestra di contesto più ampia potrebbe consentire di inserirli tutti e 100. Ma il modello deve comunque individuare un passaggio pertinente tra 99 irrilevanti, e una finestra più lunga non garantisce che ci riesca.
Vale quindi la pena distinguere tra la finestra di contesto pubblicizzata da un modello e la sua finestra di contesto effettiva per un determinato carico di lavoro. Benchmark come RULER e LongBench cercano di misurare questo divario. RULER ha rilevato che i modelli con punteggi quasi perfetti nei semplici test di recupero peggioravano comunque all'aumentare della lunghezza del contesto e della complessità dell'attività. LongBench valuta attività più ampie, tra cui domande e risposte sui documenti, ragionamento su più documenti, riepilogo, apprendimento few-shot e completamento del codice.
Il contesto lungo offre comunque un valore reale. Capacità e comprensione sono semplicemente proprietà diverse, ed entrambe contano nella scelta di un modello per una determinata attività.
Gestire i limiti di contesto: best practice per sviluppatori
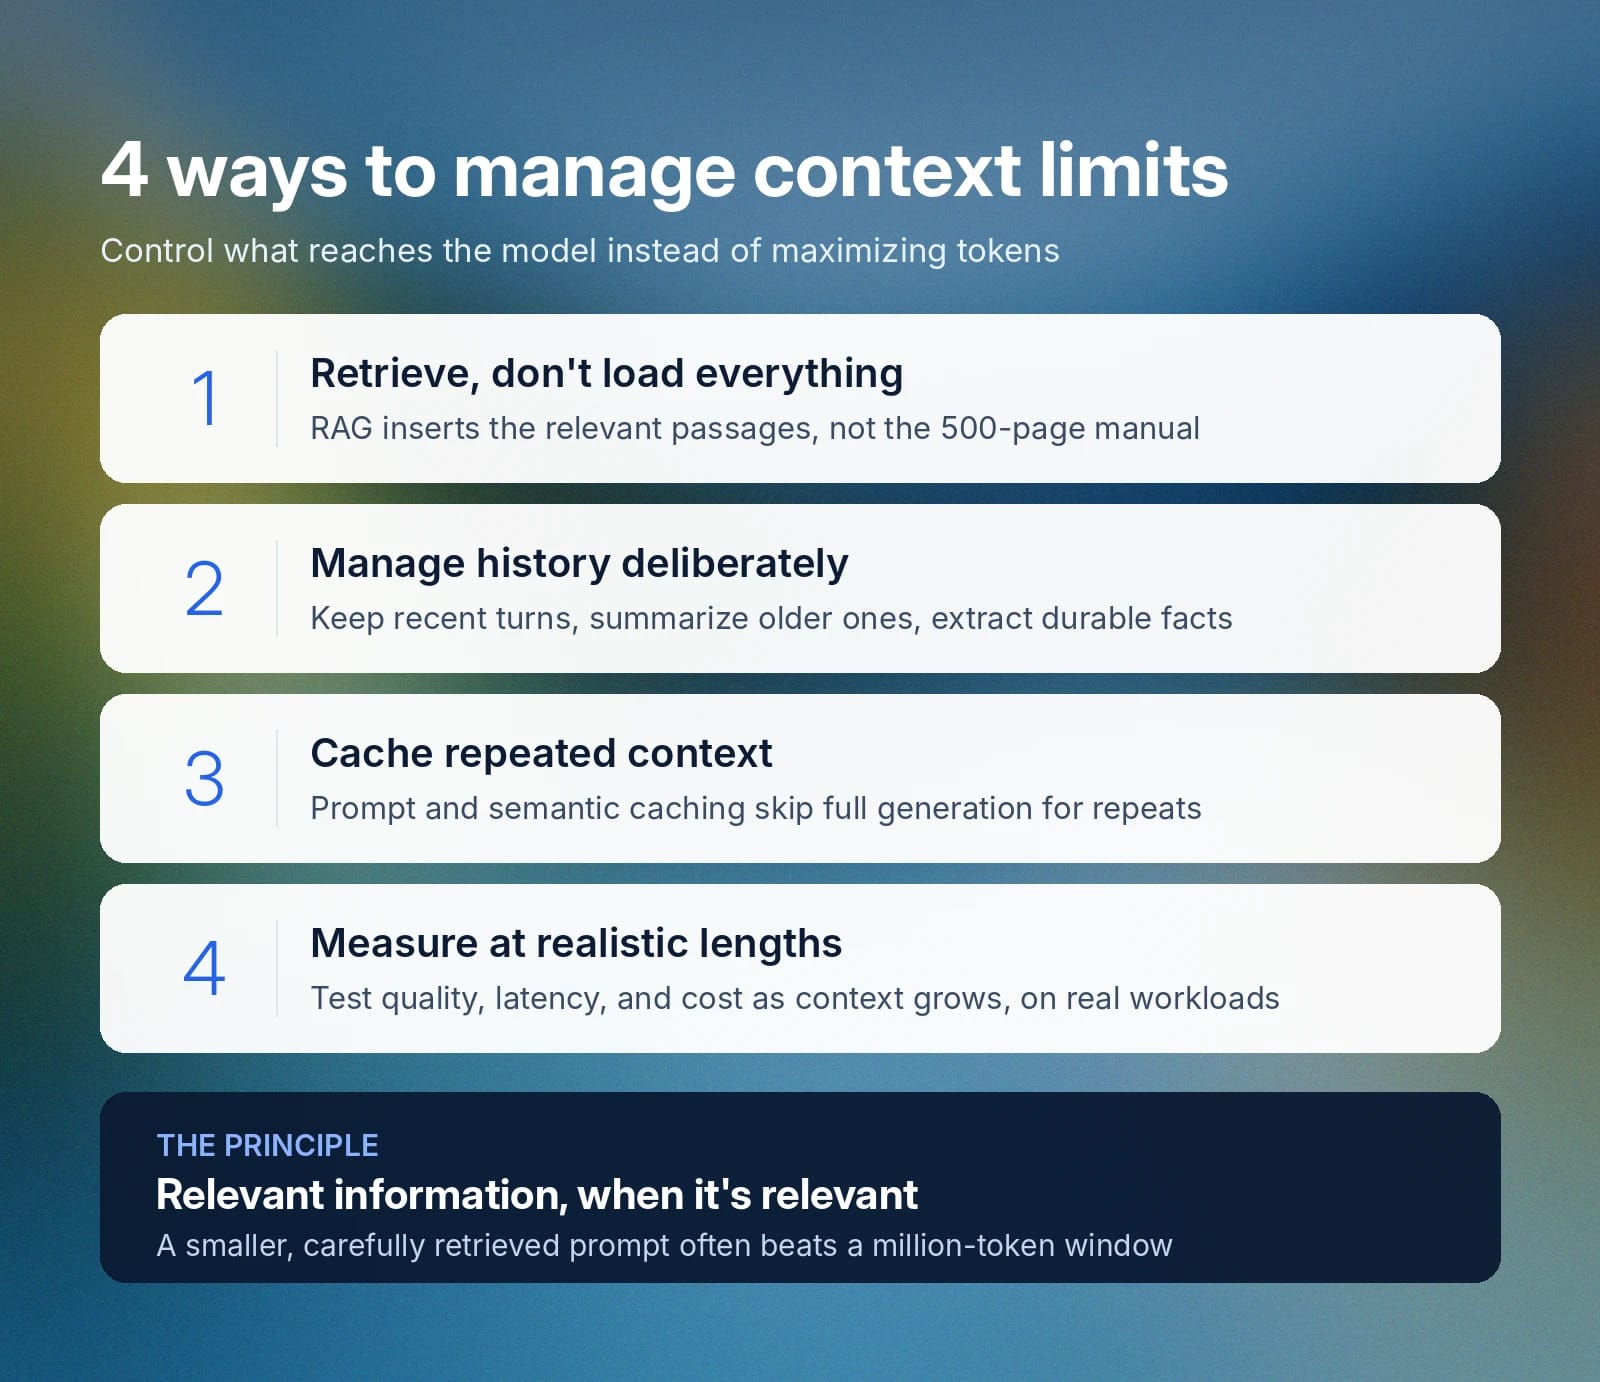
Gestire bene il contesto significa controllare ciò che raggiunge il modello: fornire le informazioni pertinenti all'attività nel momento in cui sono pertinenti, anziché cercare di massimizzare il numero di token in ogni richiesta. Le seguenti pratiche possono aiutare gli sviluppatori a ridurre il contesto non necessario, migliorare la qualità delle risposte e controllare costi e latenza.
1. Recupera le informazioni pertinenti anziché caricare tutto
La generazione aumentata dal recupero, o RAG, consente a un'applicazione di cercare in una knowledge base esterna e inserire nel contesto del modello soltanto i passaggi pertinenti. Anziché inserire un intero manuale di 500 pagine in ogni richiesta di assistenza, l'applicazione recupera i pochi passaggi più vicini alla domanda effettiva del cliente.
Questo riduce l'utilizzo di token e dà al modello un segnale molto più chiaro su ciò che conta. La qualità del recupero resta importante: i sistemi RAG in produzione migliorano tipicamente i risultati suddividendo con cura i documenti in chunk, recuperando vari passaggi candidati, riclassificandoli e filtrando tutto ciò che non è pertinente prima di creare il prompt finale. ElevenLabs, ad esempio, ha ricostruito la propria pipeline RAG per aggiungere la riscrittura delle query e chiamate parallele ai modelli, dimezzando la latenza mediana di recupero.
2. Gestisci intenzionalmente la cronologia della conversazione
Le applicazioni conversazionali accumulano rapidamente contesto. Aggiungere indefinitamente ogni messaggio precedente spreca token e può introdurre dettagli irrilevanti nei turni successivi.
Le applicazioni gestiscono questo aspetto mantenendo i turni più recenti, riepilogando gli scambi meno recenti, estraendo fatti duraturi in una memoria strutturata e recuperando i dettagli più vecchi soltanto quando tornano a essere pertinenti. Questo crea una separazione utile tra il contesto conversazionale a breve termine, che il modello necessita immediatamente, e la memoria dell'applicazione a più lungo termine, che può essere recuperata in seguito.
3. Usa il caching quando il contesto si ripete
Molte applicazioni inviano ripetutamente le stesse istruzioni di grandi dimensioni o rispondono a domande semanticamente simili a quelle già gestite. Il caching riduce questo overhead.
Il caching di prompt o contesto consente di riutilizzare più efficientemente gli input ripetuti, mentre il caching semantico fa un ulteriore passo avanti riconoscendo quando una nuova domanda ha approssimativamente lo stesso significato di una a cui il sistema ha già risposto. "Qual è la vostra policy di reso?" e "Quanto tempo ho per restituire un articolo?" sono stringhe diverse che una cache semantica può trattare come la stessa domanda, evitando una chiamata di generazione completa e riducendo sia la latenza sia i costi dei token.
4. Misura le prestazioni con lunghezze di contesto realistiche
Non scegliere una strategia di contesto basandoti soltanto sul limite di token pubblicizzato dal fornitore di un modello. Testa carichi di lavoro di produzione rappresentativi e misura la qualità delle risposte, l'accuratezza del recupero, la latenza, l'utilizzo dei token, i costi e i tassi di errore man mano che la lunghezza del contesto aumenta.
Confronta strategie come fornire più contesto, recuperare meno passaggi, riepilogare la cronologia della conversazione o combinare recupero e riepilogo. Un modello con una finestra di contesto da un milione di token può supportare tecnicamente la tua applicazione, mentre un prompt più piccolo e recuperato con cura può produrre risultati più rapidi e accurati a un costo inferiore.
Inizia con ElevenAgents per soluzioni linguistiche scalabili
La gestione del contesto è particolarmente importante negli agenti conversazionali, che devono combinare l'enunciato corrente con i turni precedenti, istruzioni aziendali, informazioni sui clienti, contenuti della knowledge base e risultati degli strumenti, rispondendo al tempo stesso abbastanza rapidamente da rendere naturale la conversazione.
ElevenAgents riunisce questi elementi in un'unica piattaforma per creare e distribuire agenti vocali IA. Il suo motore di orchestrazione coordina il riconoscimento vocale, un LLM e Text to Speech, mentre gli sviluppatori configurano prompt, knowledge base, strumenti, workflow e il modello linguistico sottostante. La resa espressiva, incluso il modo in cui un agente comunica il contesto emotivo nel parlato, dipende dallo stesso contesto che determina innanzitutto ciò che dice l'agente.
Per la gestione della conoscenza in particolare, ElevenAgents supporta sia documenti a contesto completo sia RAG, configurabile direttamente sulla piattaforma. I documenti piccoli vengono inseriti direttamente nel prompt di un agente, perciò il loro contenuto resta disponibile durante l'intera conversazione. Le knowledge base più grandi vengono invece indicizzate: RAG recupera i passaggi pertinenti per ogni query, anziché caricare tutto insieme nella finestra di contesto.
Inizia registrandoti a ElevenAgents oggi oppure parla con il nostro team per scoprire le opzioni di deployment disponibili.
FAQ: cos'è una finestra di contesto

Jack Limebear fa parte del team Growth e si occupa di scrivere contenuti e definire strategie per il blog e le pagine insights. Prima di arrivare in ElevenLabs, ha guidato la strategia dei contenuti per oltre dieci anni in realtà che vanno da startup SaaS in rapida crescita a grandi aziende Fortune 500. Ha conseguito un Master in Letteratura Inglese presso l’Università di Cambridge.

