Come vengono create le voci sintetiche per un parlato naturale?
- Scritto da
- Jack Limebear
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
I sofisticati modelli di IA odierni creano voci sintetiche che suonano come parlato naturale. Addestrati su enormi dataset di voci umane reali, questi modelli usano reti neurali avanzate per identificare e replicare schemi vocali autentici. La creazione di una voce sintetica è detta anche sintesi vocale o sintesi della voce, mentre l'audio prodotto è chiamato parlato sintetico.
Per creare una nuova voce sintetica, un utente registra la propria voce mentre parla. Nel frattempo, il modello di IA analizza i suoi schemi fonetici e la sua inflessione unici e usa questi dati per replicarne la voce. L'utente può poi regolare caratteristiche vocali come accento, tono e ritmo per creare il prodotto finale. Alcune voci sintetiche sono una clonazione diretta del parlato di una persona, mentre altre combinano più voci. Le voci possono anche essere progettate partendo da una descrizione testuale, senza alcuna registrazione.
Le voci sintetiche aprono molte possibilità creative per podcast, audiolibri, videogiochi e pubblicità. In questo articolo vedremo come vengono create, cosa le fa suonare naturali e come creare la tua voce sintetica con ElevenLabs.
In sintesi
- Le voci sintetiche vengono create con modelli neurali di IA che analizzano e replicano gli schemi del parlato umano.
- Le voci sintetiche sono utili per narrare audiolibri, generare dialoghi per videogiochi, creare podcast e voci fuori campo su larga scala, creare agenti IA per il servizio clienti o persino preservare voci a rischio di scomparsa.
- La clonazione vocale funziona analizzando le registrazioni della voce di una persona specifica e replicandone l'accento e gli schemi vocali unici.
- Le moderne voci IA suonano naturali perché replicano la prosodia umana e comprendono il contesto, anziché limitarsi a riprodurre singole parole o sillabe.
Come vengono create le voci sintetiche, passo dopo passo
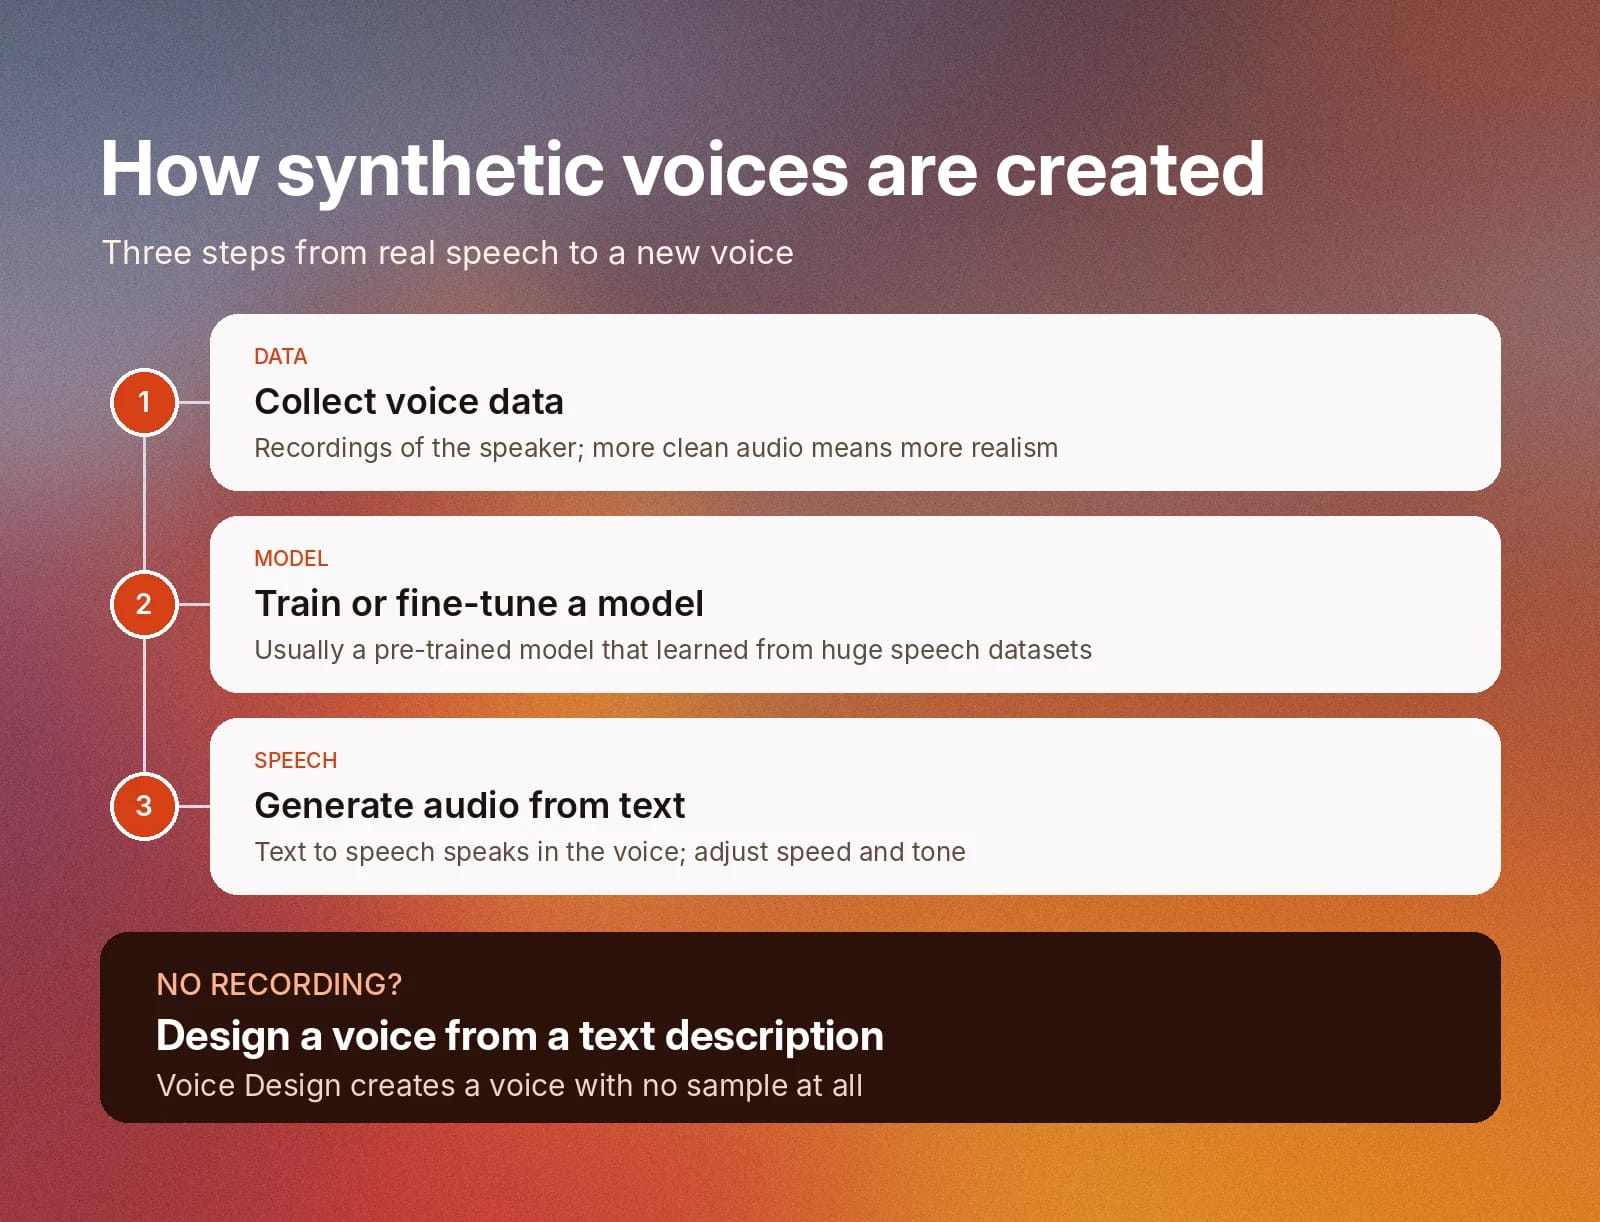
La creazione di una voce sintetica è un processo in tre passaggi.
Ecco come funziona nella pratica:
- Passaggio 1: raccogli i dati vocali: Le voci sintetiche partono dal parlato umano reale. Per creare una nuova voce, avrai bisogno di registrazioni audio delle persone che vuoi replicare. Più dati fornisci, più la voce finale sarà accurata e realistica. Ecco alcune best practice per la clonazione vocale.
- Passaggio 2: addestra o ottimizza un modello di IA: Per creare voci sintetiche, i modelli di IA analizzano prima ampi dataset con un'ampia varietà di registrazioni vocali. I modelli usano questi dati per comprendere gli schemi del parlato umano. Dopo essere stato addestrato, un modello di IA può clonare voci reali usando una singola registrazione vocale. Nella maggior parte dei casi, userai un modello preaddestrato anziché crearne uno da zero.
- Passaggio 3: genera audio dal testo: Le voci sintetiche usano la tecnologia Text to Speech per generare audio. Puoi modificare fattori come velocità e tono in base alle tue preferenze. Per approfondire, leggi la nostra guida su come funziona la tecnologia Text to Speech.
Dai dati vocali al text to speech neurale
I modelli neurali di Text to Speech vengono addestrati su numerosi dataset di registrazioni vocali reali. Questi dataset includono registrazioni in lingue diverse, con vari accenti, emozioni e livelli di tonalità. Oggi il Text to Speech neurale è una forma di sintesi vocale molto diffusa.
I modelli tradizionali assemblavano registrazioni esistenti di parole, sillabe e fonemi. I risultati erano molto robotici, poiché non riuscivano a replicare le variazioni di altezza, ritmo ed espressività che rendono umano il parlato.
Anziché limitarsi ad apprendere il suono di lettere e sillabe, i moderni modelli neurali di text to speech imparano i modelli di pronuncia naturale e i ritmi del parlato umano. Quando convertono il testo in parlato, questi modelli analizzano il testo, lo trasformano in caratteristiche acustiche e poi usano tali caratteristiche per generare forme d'onda.
Poiché caratteristiche acustiche come altezza, ritmo e tono sono integrate nei modelli neurali di IA, il parlato risultante suona molto più naturale e autentico rispetto ai modelli del passato.
I risultati sono anche personalizzabili: puoi modificare fattori come velocità, emozione e persino accento per ottenere esattamente la voce che cerchi. Per esempio, il tuo brand potrebbe usare la stessa voce sintetica sul sito web, ma adottare entusiasmo e urgenza nei contenuti di marketing e un tono calmo nelle interazioni con il servizio clienti.
Text to speech standard, neurale e generativo
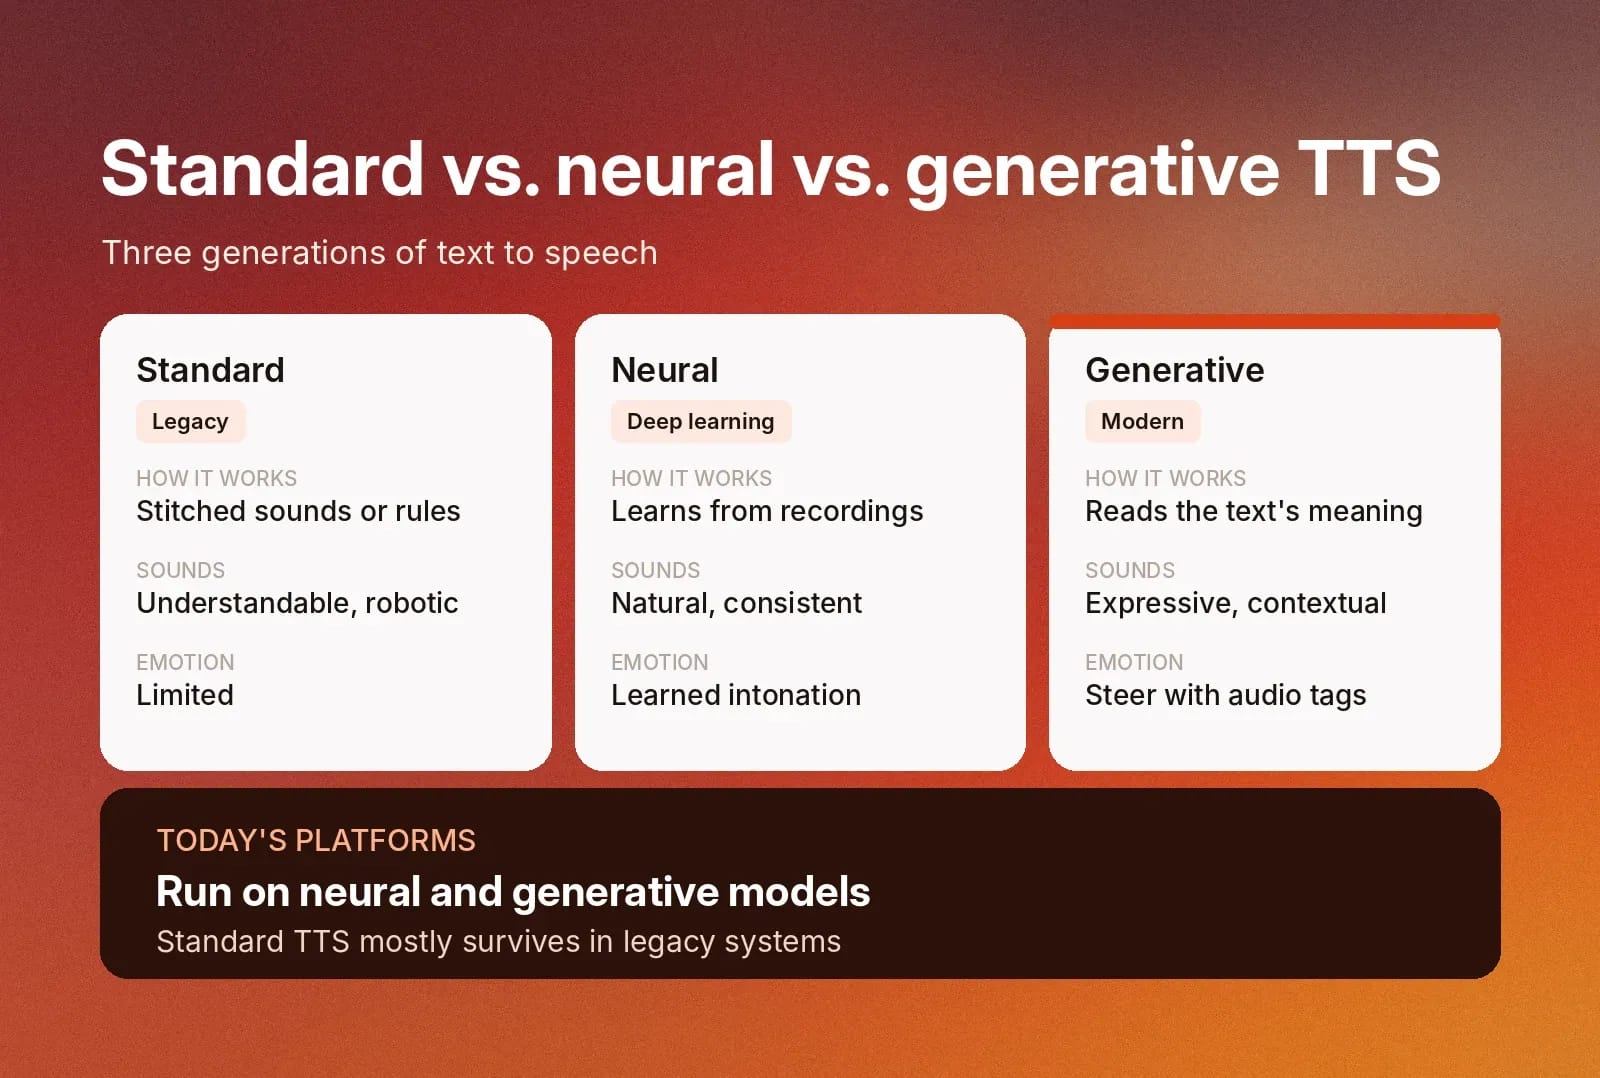
I modelli di text to speech rientrano in tre grandi generazioni.
Comprendere le differenze tra questi modelli aiuta a capire perché quelli moderni, come ElevenLabs Text to Speech, possono suonare così naturali.
- Text to speech standard: questi sistemi assemblano suoni preregistrati o seguono regole e modelli statistici per pronunciare il testo. Il risultato è comprensibile ma robotico, con un'espressività limitata.
- Text to speech neurale: i modelli di deep learning apprendono pronuncia, ritmo e intonazione da grandi raccolte di registrazioni e generano parlato molto più naturale e coerente.
- Text to speech generativo: i modelli generativi vengono addestrati su dati vocali ancora più ampi e diversificati e usano il significato del testo per decidere emozione, ritmo ed enfasi. Puoi guidarne l'interpretazione con istruzioni, come gli audio tag.
Le moderne piattaforme vocali si basano su modelli neurali e generativi, mentre il text to speech standard sopravvive soprattutto nei sistemi legacy.
Cosa fa suonare naturale la generazione di voci IA?
Le voci sintetiche generate dall'IA suonano molto simili alle voci umane. In effetti, può essere difficile distinguerle se non ascolti con attenzione.
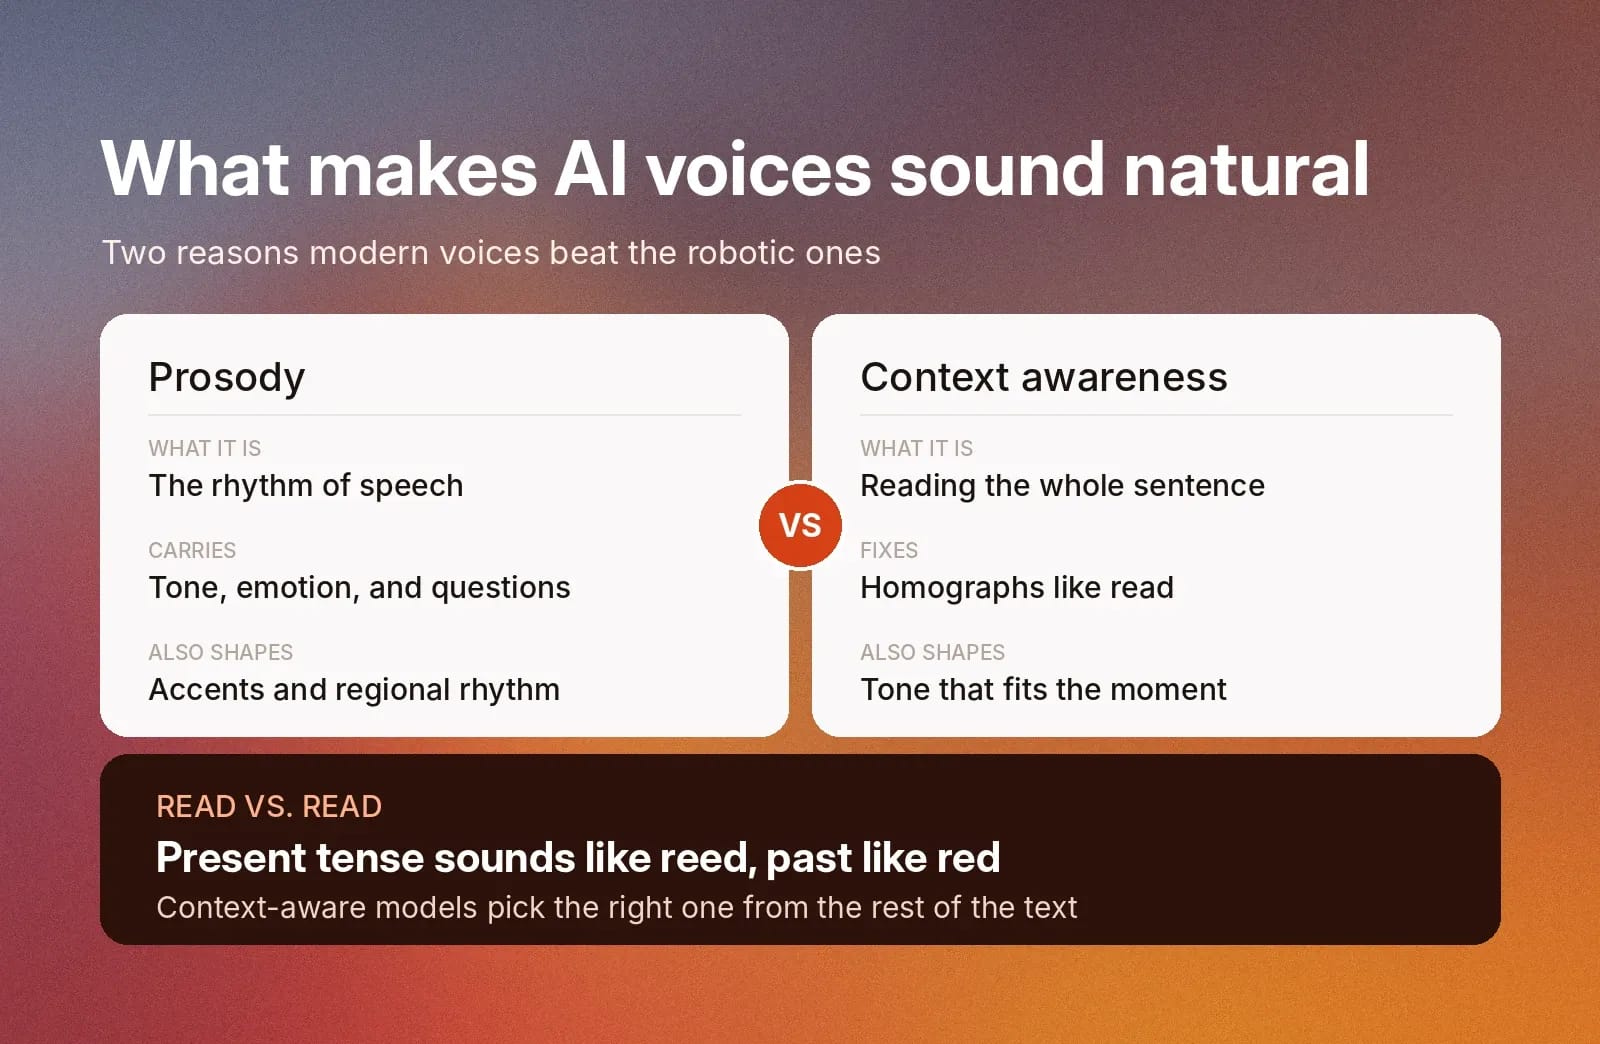
Le voci generate dall'IA suonano più naturali delle voci robotiche del passato per due motivi: la prosodia e la comprensione del contesto.
Prosodia
La prosodia è il ritmo del parlato umano naturale. Piccoli cambiamenti di intonazione e velocità trasmettono tono ed emozione mentre parliamo. Per esempio, parlare rapidamente può comunicare stress o entusiasmo, mentre alzare il tono alla fine di una frase trasforma un'affermazione in una domanda.
I modelli vocali di IA odierni sono addestrati per comprendere e replicare la prosodia. Ciò significa che il risultato riflette il fluire naturale della conversazione umana, anziché suonare rigido o piatto.
Se usi una voce sintetica per narrare un audiolibro o creare dialoghi per videogiochi, userà la prosodia per riflettere le emozioni del personaggio. Se invece crei una voce fuori campo per contenuti educativi o un agente IA per il servizio clienti, il modello di IA adatterà la prosodia per un'interpretazione calma ed empatica.
Comprendendo la prosodia, i modelli di IA possono anche replicare accenti unici. Per esempio, il ritmo dell'inglese nordamericano suona molto diverso da quello dell'inglese britannico, scozzese o irlandese, anche se si tratta della stessa lingua.
Comprensione del contesto
Anziché elaborare ogni parola singolarmente, i modelli TTS basati sull'IA analizzano l'intera frase, periodo o conversazione e adattano l'interpretazione in base al contesto.
Per esempio, molte parole si scrivono allo stesso modo ma vengono pronunciate diversamente a seconda del tempo verbale e del contesto. In inglese, per esempio, la parola “read” al presente si pronuncia come “reed”, mentre al passato si pronuncia come “red”.
Poiché comprendono il contesto, le voci IA identificano la pronuncia appropriata in base al resto del testo. Adattano inoltre l'interpretazione affinché tono ed emozione siano adeguati alla situazione.
Come funziona la clonazione vocale?
La clonazione vocale usa l'IA per analizzare la voce di una persona reale e applicarne le caratteristiche vocali al parlato sintetico.
Per prima cosa, la persona che clona la propria voce deve fornire un breve campione audio. Il modello di IA usa il campione per identificare accento, altezza, tono e cadenza della persona. Il modello usa queste caratteristiche per creare una replica digitale della sua voce. Gli utenti possono generare nuovo parlato con questa voce usando la tecnologia text to speech.
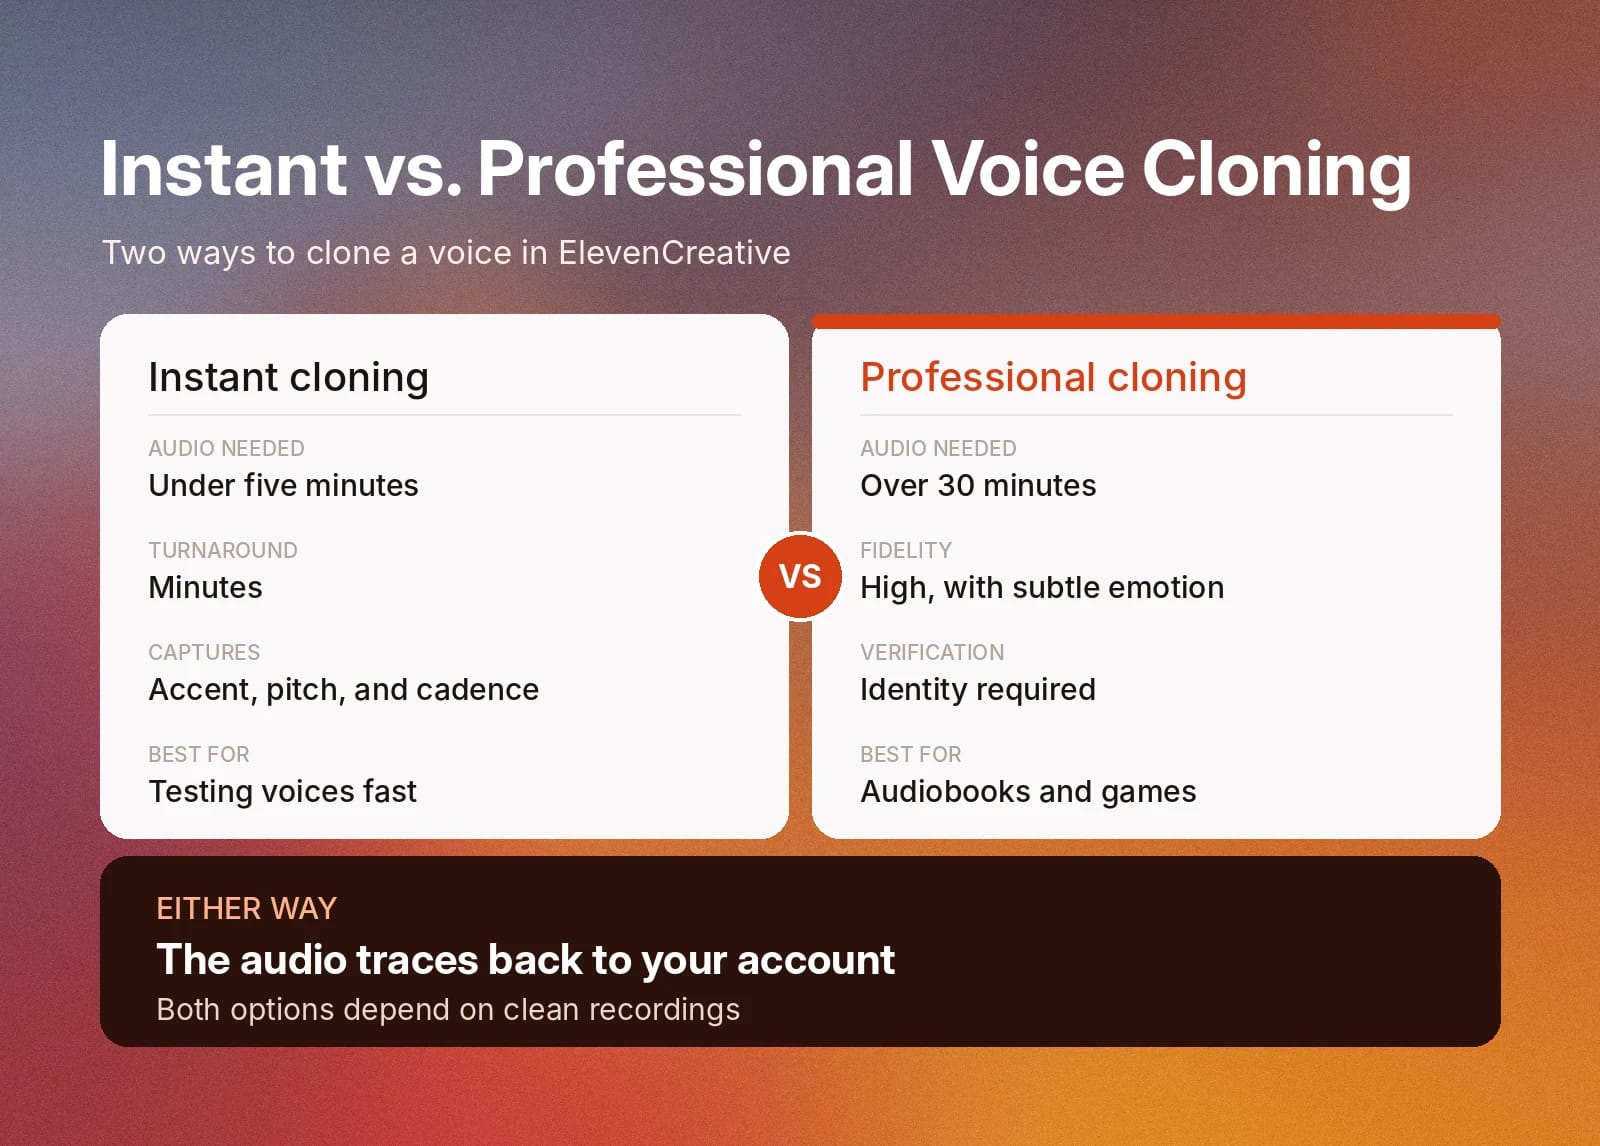
Esistono due tipi di clonazione vocale: Istantanea e Professionale. La clonazione Istantanea crea una replica vocale con meno di due minuti di audio campione. In questo modo è facile testare diverse opzioni vocali prima di impegnarsi in un progetto più grande.
La clonazione Professionale usa da 30 minuti a tre ore di campioni audio per creare un clone vocale ad alta fedeltà. I Cloni Vocali Professionali preservano dettagli sottili, come emozione e intonazione, che non sono presenti nei Cloni Istantanei. Richiedono inoltre la verifica dell'identità.
La clonazione vocale ha molti casi d'uso, dalla generazione rapida di voci fuori campo al preservare voci che altrimenti potrebbero andare perdute.
Come registrare buoni campioni vocali per la sintesi vocale
La qualità di un clone vocale dipende dalla qualità della registrazione. Anche senza costose attrezzature di registrazione, puoi fare molte piccole cose per migliorare il suono del tuo clone vocale.
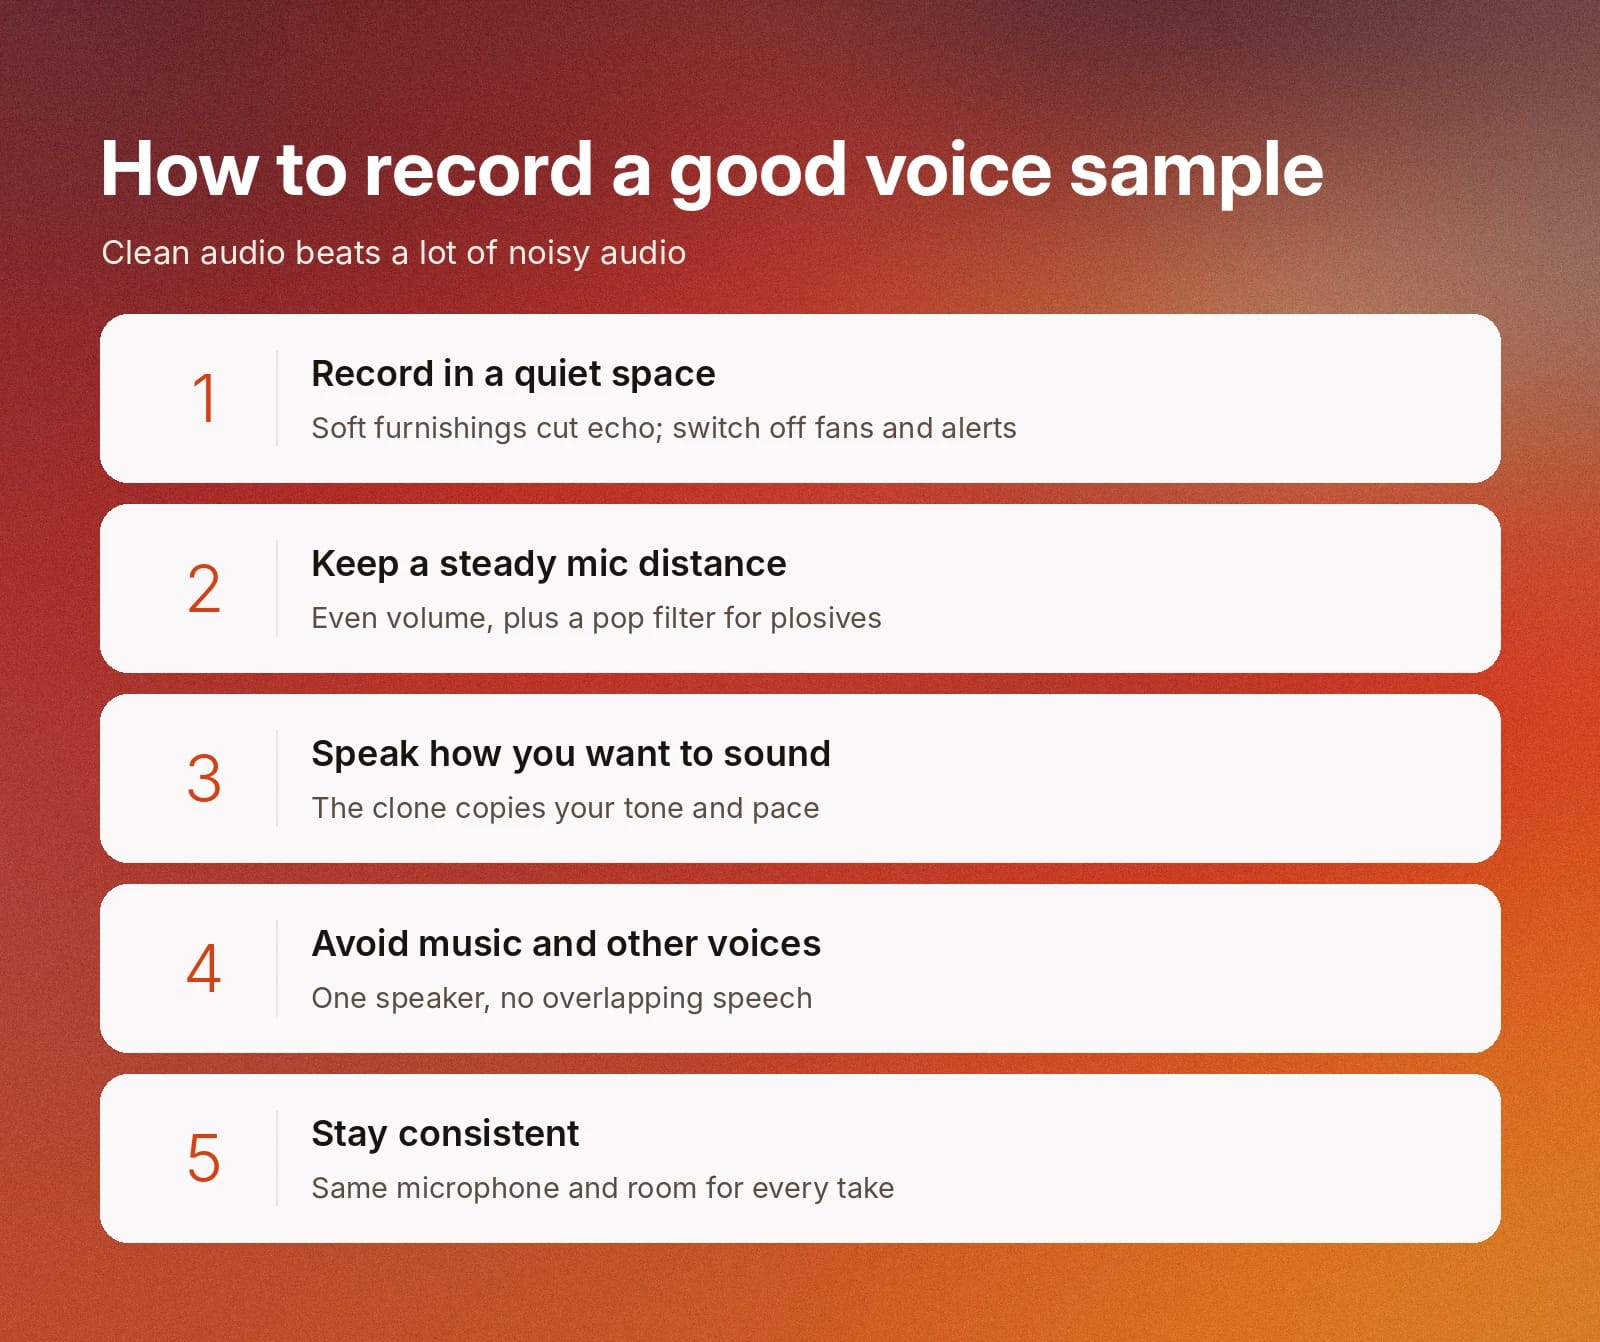
Queste abitudini ti aiutano a ottenere campioni puliti:
- Registra in un ambiente silenzioso: arredi morbidi, come tende e tappeti, riducono l'eco, mentre spegnere ventilatori e notifiche elimina il rumore di fondo.
- Mantieni il microfono a una distanza costante: una distanza uniforme mantiene stabile il volume e un filtro antipop riduce i suoni plosivi troppo marcati.
- Parla nel modo in cui vuoi che suoni il clone: il clone riproduce la tua interpretazione. Registra con il tono e il ritmo che intendi usare.
- Evita musica e altre voci: usa un solo parlante, senza musica di sottofondo né parlato sovrapposto.
- Sii coerente: usa lo stesso microfono e la stessa stanza per tutte le registrazioni.
La Clonazione Istantanea richiede meno audio, mentre la Clonazione Professionale ne richiede di più, ma entrambe dipendono da registrazioni pulite. Un audio pulito della giusta durata offre risultati migliori di una grande quantità di audio rumoroso.
Come creare una voce senza registrare: Voice Design
Non tutte le voci sintetiche partono da una registrazione. Con Voice Design, descrivi in un testo la voce che desideri, includendo dettagli come età, genere, accento, tono e ritmo, e il modello di IA genera opzioni vocali che corrispondono alla tua descrizione. Puoi ascoltare le opzioni, scegliere quella che preferisci e salvarla nella tua libreria vocale.
Voice Design è utile quando hai bisogno di una voce per un personaggio, un brand o un prodotto e non c'è una persona reale da clonare. Leggi la documentazione di Voice Design per scoprire come scrivere descrizioni vocali efficaci.
Come capire se una voce è generata dall'IA
Non esiste un singolo indizio che dimostri che una voce è generata dall'IA. Combinare un ascolto attento, strumenti di rilevamento e una verifica della provenienza dell'audio funziona meglio che affidarsi a uno solo di questi elementi.
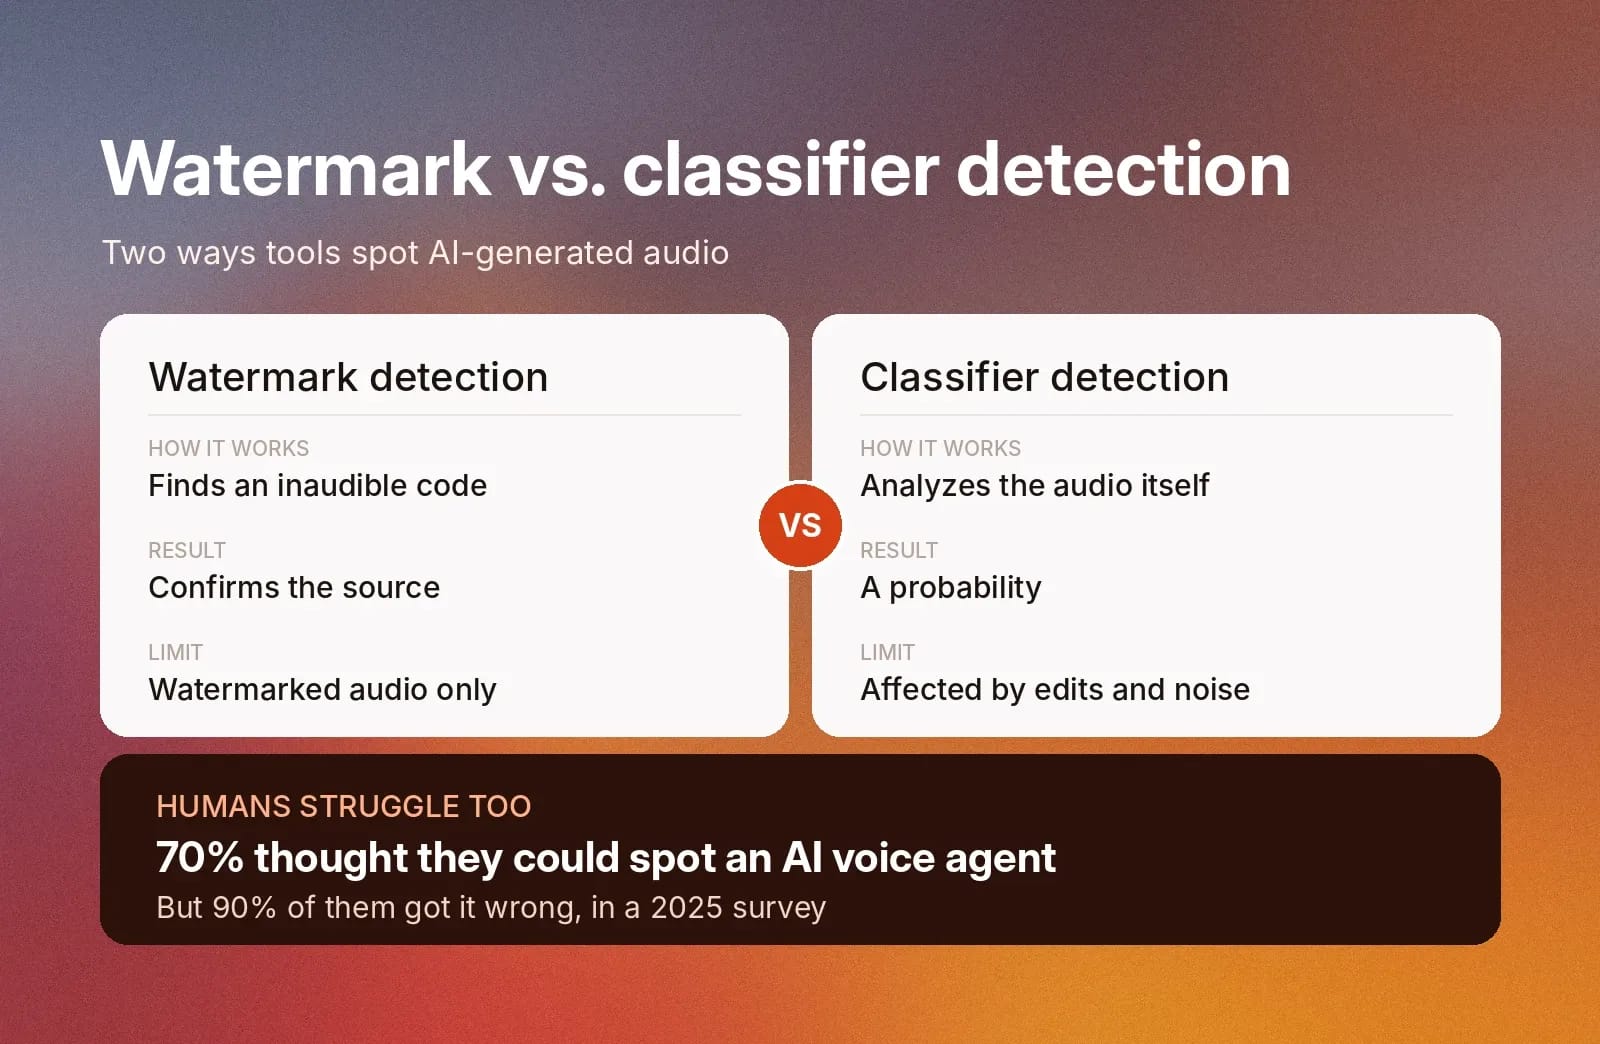
Molte persone pensano di saper distinguere una voce reale da una generata dall'IA, ma non sempre ci riescono. Un sondaggio del 2025 ha rilevato che il 70% dei consumatori pensava di poter identificare correttamente un agente vocale IA, ma il 90% di loro non ci è riuscito.
Invece di affidarti all'orecchio umano, puoi usare uno strumento di rilevamento. Questi strumenti funzionano principalmente in due modi:
- Rilevamento del watermark: alcuni fornitori di IA inseriscono nell'audio che generano un watermark, ovvero un codice non udibile dall'uomo. Un rilevatore può trovare il watermark e confermare la provenienza dell'audio. Funziona solo con l'audio che contiene un watermark.
- Rilevamento basato su classificatore: un classificatore analizza l'audio e stima la probabilità che sia stato generato dall'IA. Può segnalare audio privo di watermark, ma il risultato è una probabilità e può essere influenzato da compressione, rumore di fondo o modifiche.
Nessuno dei due metodi è perfetto. Considera il risultato del rilevamento come un elemento di prova e confrontalo con ciò che sai sulla fonte. Abbiamo scritto una guida al rilevamento di deepfake audio, che approfondisce l'argomento.
ElevenLabs Speech Classifier è uno strumento che identifica la probabilità che un campione audio sia stato generato con i modelli di voci IA di ElevenLabs. ElevenLabs collabora inoltre con Reality Defender a iniziative di rilevamento dei deepfake per identificare e prevenire le frodi vocali.
Cosa ascoltare
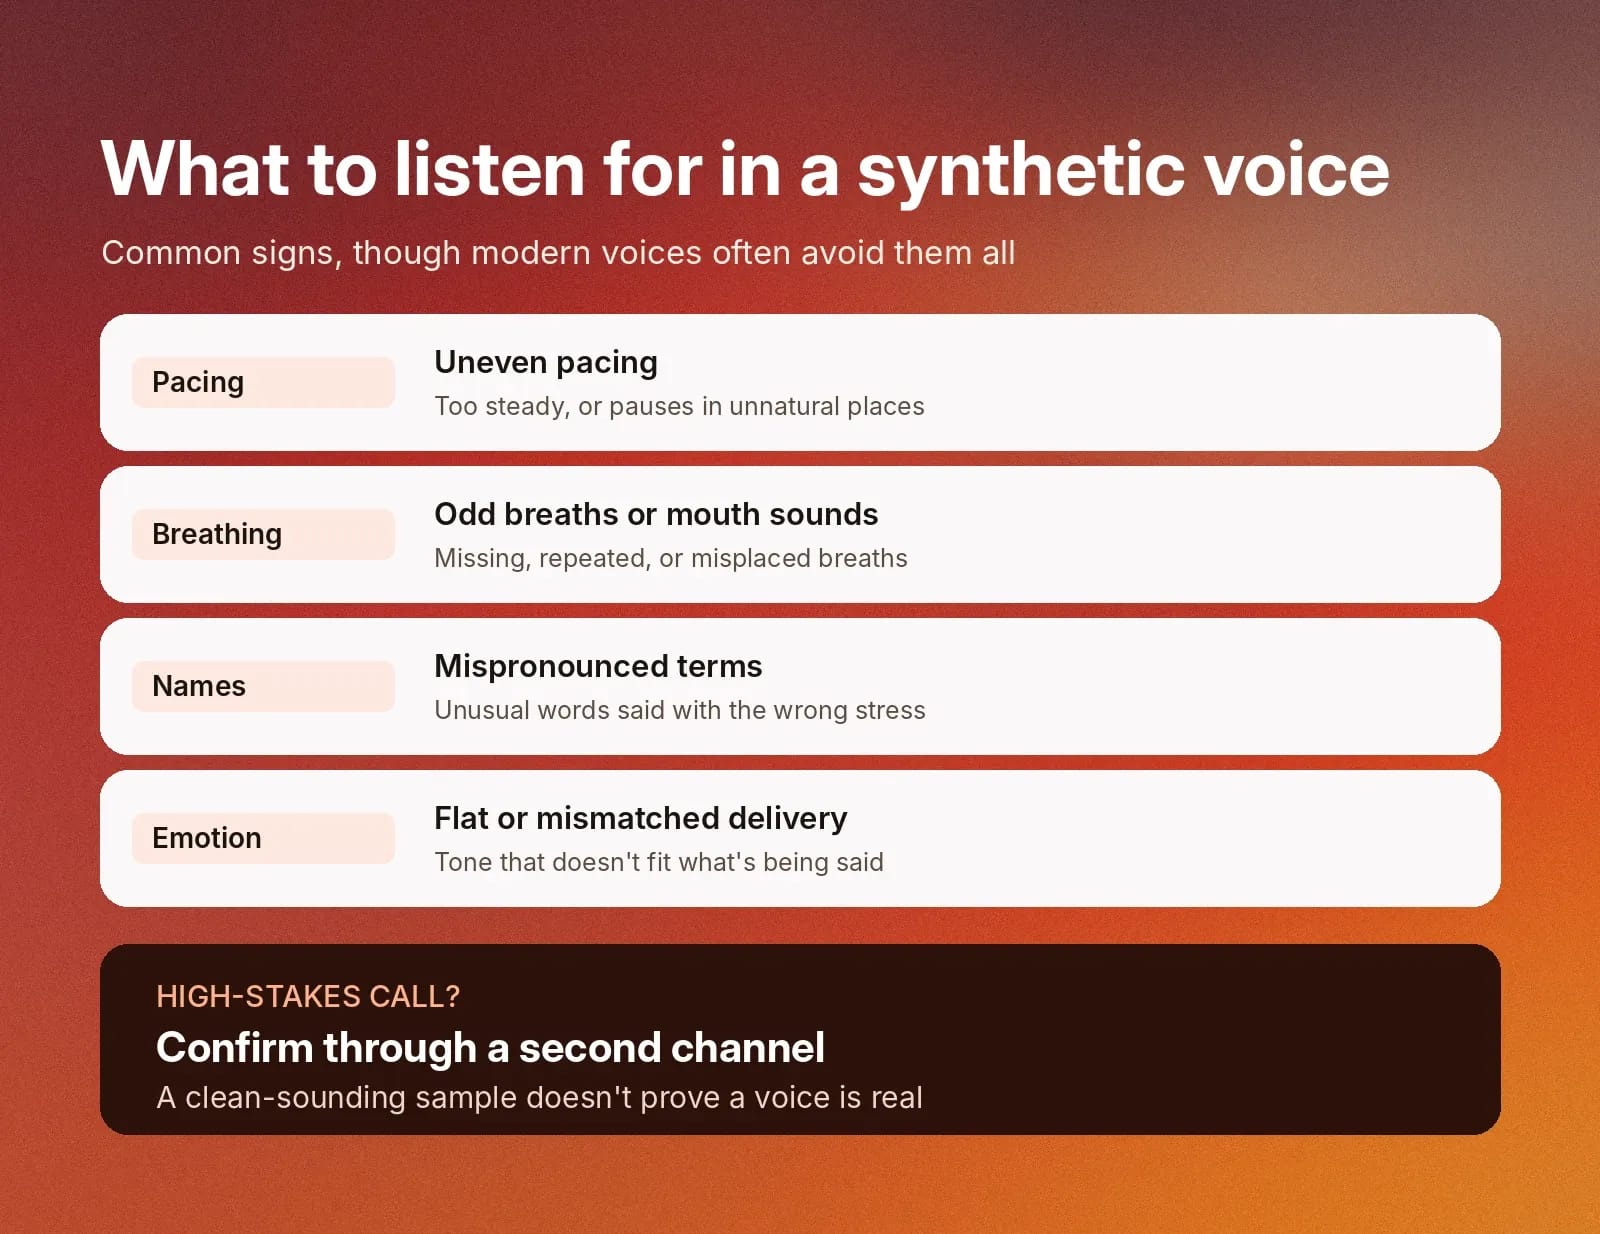
Gli strumenti di rilevamento non sono sempre a portata di mano, quindi è utile conoscere i segnali più comuni di una voce sintetica.
Presta attenzione a:
- Ritmo irregolare: un parlato troppo uniforme o con pause in punti innaturali.
- Suoni strani di respirazione o della bocca: respiri assenti, ripetuti o fuori posto. Potrebbero indicare artefatti audio generati involontariamente da un modello.
- Nomi o termini pronunciati male: parole insolite pronunciate con l'accento sbagliato. È ancora più comune nelle lingue che usano segni diacritici per enfatizzare determinate sillabe delle parole, come lo spagnolo.
- Emozione piatta o inappropriata: un'interpretazione che non corrisponde al significato delle parole. Questo dimostra una mancata comprensione del testo stesso, un problema comune nei modelli TTS legacy.
Le moderne voci sintetiche spesso evitano tutti questi segnali. Un campione dal suono pulito non dimostra che una voce sia reale. Per situazioni delicate, come una chiamata che chiede denaro, verifica attraverso un secondo canale.
Crea esperienze vocali personalizzate con ElevenCreative
ElevenCreative ti aiuta a creare esperienze vocali personalizzate per i tuoi progetti creativi. Scegli da un'ampia libreria di oltre 20.000 voci già pronte oppure crea la tua con una clonazione vocale accurata e sicura.
Usa ElevenCreative per replicare la tua voce con Instant Voice Cloning o Professional Voice Cloning. Instant Voice Cloning funziona in pochi minuti e ti aiuta a testare opzioni vocali o avviare rapidamente progetti personali. Professional Voice Cloning usa campioni audio più lunghi per creare voci di alta qualità, ideali per progetti più estesi come audiolibri, videogiochi o podcast. Qualunque opzione tu scelga, l'audio è riconducibile al tuo account per motivi di sicurezza.
La Voice Library personalizzabile di ElevenCreative e gli strumenti di clonazione vocale ti aiutano a dare vita ai tuoi progetti creativi. Registrati a ElevenCreative per esplorare voci iconiche o crearne una tua.
FAQ

Jack Limebear fa parte del team Growth e si occupa di scrivere contenuti e definire strategie per il blog e le pagine insights. Prima di arrivare in ElevenLabs, ha guidato la strategia dei contenuti per oltre dieci anni in realtà che vanno da startup SaaS in rapida crescita a grandi aziende Fortune 500. Ha conseguito un Master in Letteratura Inglese presso l’Università di Cambridge.