Come funziona la tecnologia Text to Speech: dal testo a una voce naturale
- Scritto da
- Jack Limebear
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
La tecnologia Text to Speech (TTS) trasforma le parole scritte in audio parlato. Il sistema prima comprende cosa dice il testo e come dovrebbe suonare, poi un modello di IA genera l'audio.
Inizialmente, un motore TTS normalizza il testo in input e lo converte in token matematici e rappresentazioni vettoriali che un sistema informatico può elaborare. Il modello trasforma poi questi costrutti matematici in rappresentazioni digitali del suono e, infine, in audio.
In questo articolo vedremo come funzionano i diversi strumenti Text to Speech e come l'ultima generazione di sintesi vocale neurale con IA generativa offra un parlato più naturale che mai.
In sintesi
- I sistemi Text to Speech convertono le parole scritte in audio in due fasi. Trasformano il testo in token, ovvero rappresentazioni matematiche del linguaggio. Poi convertono i token in una rappresentazione acustica riprodotta come suono.
- I più recenti motori TTS neurali usano modelli di IA per produrre un parlato dal suono naturale. I team aziendali li usano per la creazione di contenuti, i sottotitoli e per alimentare gli agenti di assistenza clienti.
- I dizionari di pronuncia e i tag fonetici sono due modi per ottimizzare l'output TTS affinché suoni il più naturale possibile e per garantire la corretta pronuncia di gergo tecnico e nomi.
- Una API Text to Speech ti consente di collegare le applicazioni aziendali a una generazione vocale di alta qualità.
Cos'è il TTS? Come funziona la tecnologia Text to Speech
Il Text to Speech analizza il testo scritto, decide come deve suonare ogni parola e usa poi un modello neurale e un vocoder per generare l'audio parlato.
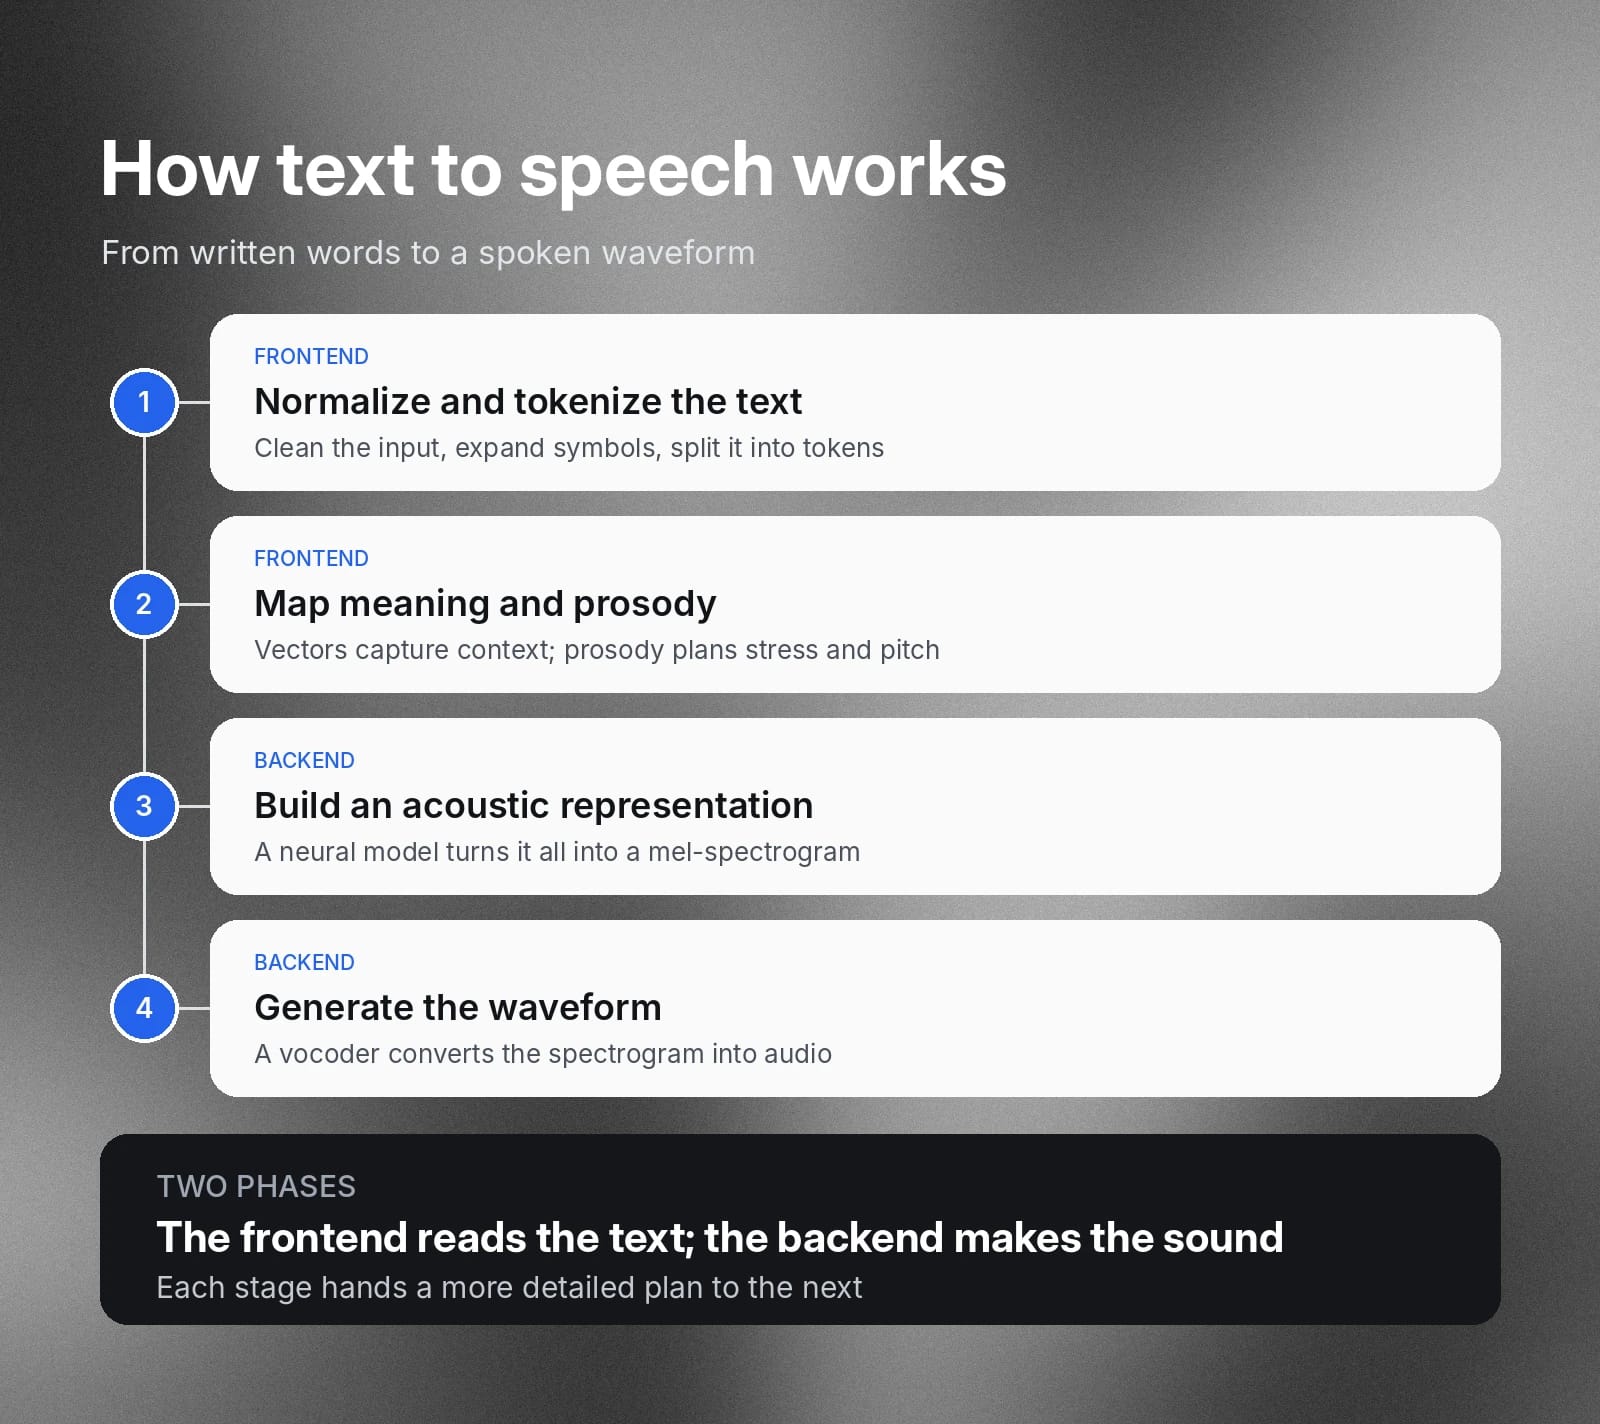
In linea generale, il TTS si divide in due fasi:
- Frontend: il sistema converte il testo in una forma matematica con cui il motore TTS può lavorare.
- Backend: il sistema prende l'output della prima fase e lo trasforma in forme d'onda che modellano il parlato.
Vediamo più nel dettaglio i componenti del funzionamento del TTS.
Normalizzazione del testo e analisi linguistica
Il primo passaggio di un processo TTS è l'elaborazione del linguaggio naturale (NLP): pulire, tokenizzare e disambiguare il testo grezzo in input. Il testo viene suddiviso in token, singole unità del linguaggio scritto che un motore TTS può manipolare. Un token può essere un'intera parola, un'unità di “sottoparola” o un segno di punteggiatura.
Il testo contiene spesso simboli diversi dalle parole complete, come abbreviazioni e numeri. Un motore TTS deve anche stabilire come pronunciarli. Ad esempio, il motore TTS legge “$11” e converte quel testo nei suoni corrispondenti a “undici dollari”.
Significato semantico e prosodia
La prosodia è l'intonazione e il ritmo del parlato, ciò che fa suonare naturale il TTS. Durante l'elaborazione del testo, il motore genera anche un livello di informazioni prosodiche che associa le variazioni di accento e intonazione al testo, rendendolo più naturale.
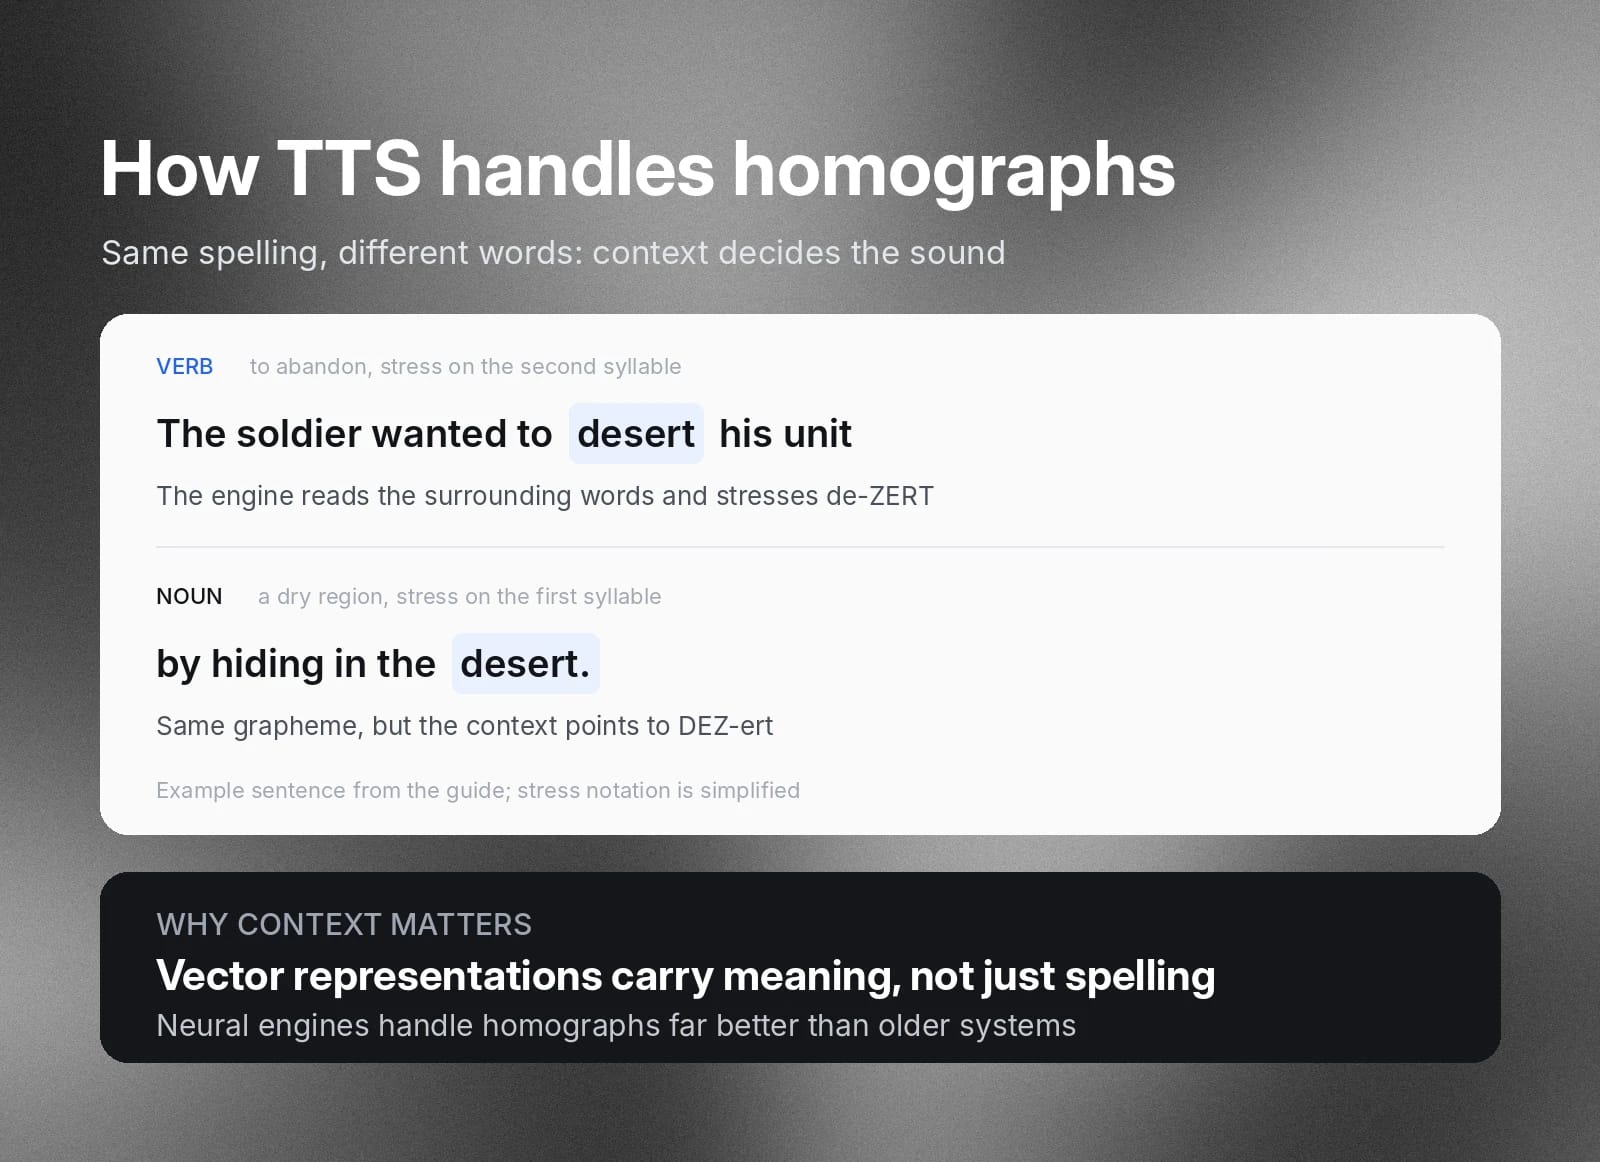
Un motore TTS deve anche adattare la pronuncia Text to Speech in base al contesto. Riunisce queste informazioni sotto forma di rappresentazioni vettoriali, dati numerici che mappano la somiglianza semantica tra parole e frasi. Immagina un grafico X-Y in cui una linea viene tracciata attraverso vari punti, ma in molte più di due dimensioni.
Un esempio specifico sono gli omografi. Gli omografi, ovvero parole diverse che hanno la stessa grafia, talvolta devono essere pronunciati in modo diverso. Il motore TTS deve identificare l'intonazione e l'accento da usare per ciascuno durante la lettura. Ad esempio, come pronunciare il grafema “desert” nella frase "The soldier wanted to desert his unit by hiding in the desert.”
Guarda come Eleven v4 dà vita a questo esempio.
Modellazione acustica e sintesi della forma d'onda (parlato)
Il motore TTS prende le informazioni tokenizzate e i vettori contestuali, ormai tutti dati numerici, e li converte in una rappresentazione acustica, come uno spettrogramma mel. Questa include diverse frequenze, livelli di energia e suoni che il cervello interpreta come emozioni. In passato sono stati usati molti sistemi diversi per svolgere questa funzione, ma oggi i modelli neurali sono tra i più efficaci.
Il passaggio finale usa un vocoder per convertire questi spettrogrammi in audio che gli ascoltatori umani riconoscono come parlato. Questo processo è chiamato generazione della forma d'onda.
Il TTS in pratica: un esempio concreto
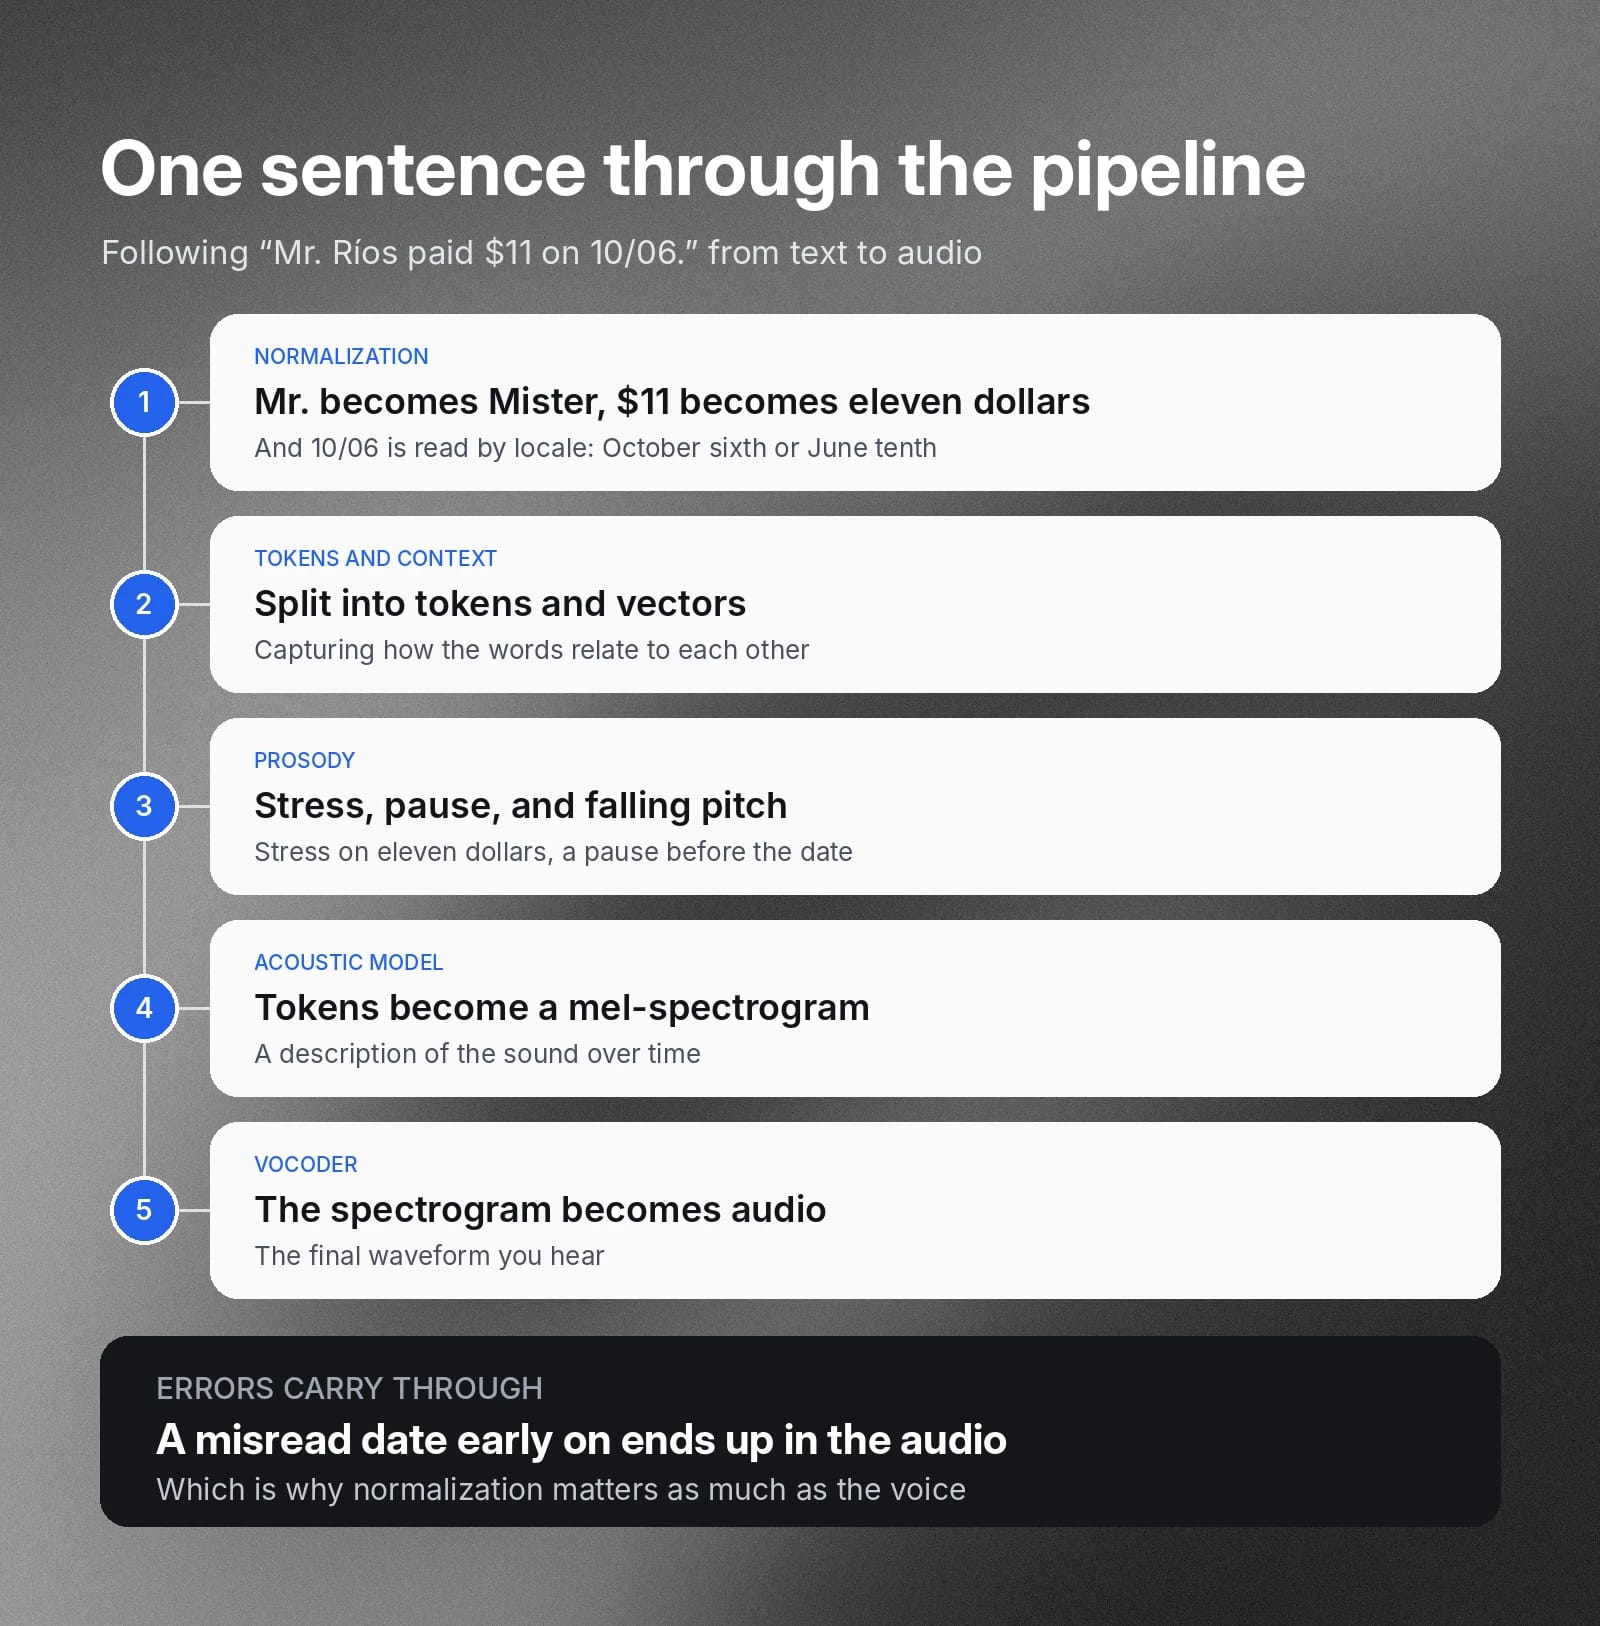
Il modo più semplice per vedere come si integrano le fasi del TTS è seguire una singola frase lungo la pipeline.
Prendiamo il testo “Mr. Ríos paid $11 on 10/06.”
- Normalizzazione: il motore espande “Mr.” in “Mister”, legge “$11” come “eleven dollars” e decide se “10/06” significa “October sixth” o “the tenth of June”, in base alle impostazioni locali e al contesto.
- Tokenizzazione e contesto: il testo pulito viene suddiviso in token e convertito in vettori che catturano le relazioni tra le parole.
- Prosodia: il motore pone l'accento su “eleven dollars”, aggiunge una breve pausa prima della data e fa scendere il tono alla fine della frase.
- Modello acustico: il modello neurale trasforma i token e il piano prosodico in uno spettrogramma mel che descrive il suono nel tempo.
- Vocoder: il vocoder converte lo spettrogramma nella forma d'onda audio finale che ascolti.
Ogni fase passa alla successiva un piano più dettagliato; per questo gli errori nelle prime fasi della pipeline, come una data letta male, si ripercuotono sull'audio finale.
Perché il Text to Speech neurale suona più umano?
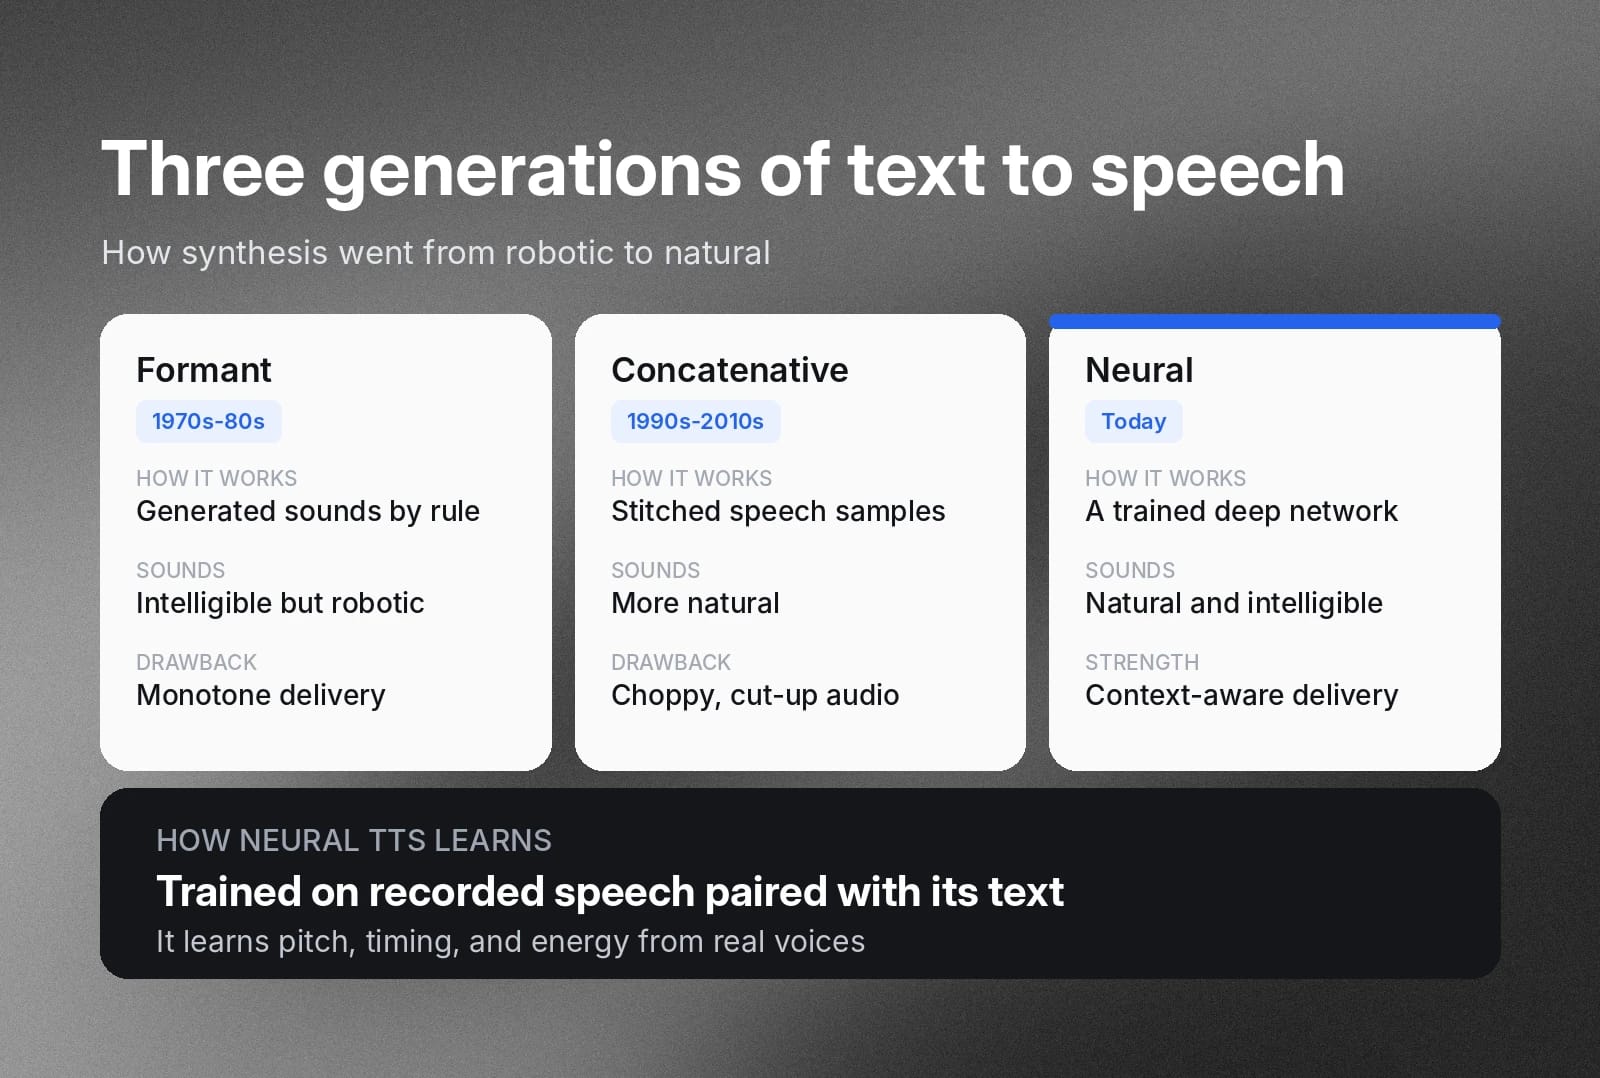
La sintesi vocale neurale eccelle nel produrre un parlato naturale e intelligibile, le due qualità che gli ingegneri usano per valutare i motori TTS. Il TTS neurale funziona addestrando una rete neurale profonda (DNN) a produrre parlato a partire da un testo in input. La DNN viene addestrata su grandi volumi di parlato registrato abbinato al testo corrispondente.
I motori di sintesi vocale neurale rappresentano soltanto l'ultima evoluzione del TTS di livello enterprise. Li hanno preceduti due generazioni di tecnologie di sintesi commerciale.
La sintesi a formanti era la modalità dominante negli anni '70 e '80. Invece di campionare il parlato umano per l'output a runtime, generava suoni sintetici che modellavano il parlato. Era intelligibile, ma monotona e dal suono robotico.
La sintesi concatenativa ha dominato dagli anni '90 fino agli anni 2010 e suonava più naturale dei precedenti sistemi a formanti. Invece di generare toni basati su regole matematiche, univa, ovvero concatenava, piccoli campioni di parlato umano. Questi sistemi usavano tabelle di ricerca linguistiche per associare il testo normalizzato ai suoni, quindi riproducevano piccole unità di audio parlato concatenato tratte da una libreria enorme, o “corpus”. Sebbene più naturale del parlato prodotto da un motore a formanti, la concatenazione può comunque far suonare il parlato frammentato o spezzato.
Qual è la differenza tra un generatore di voci IA e il Text to Speech?
“Generatore di voci IA” è un termine spesso usato nel marketing per descrivere un'ampia gamma di tecnologie vocali, incluso il Text to Speech. Il Text to Speech si riferisce specificamente ai sistemi che ricevono testo scritto in input, ne modellano semantica e prosodia e producono forme d'onda audio.
I generatori di voci IA sono un intero ecosistema di tecnologie vocali interconnesse, tra cui il TTS e altri sistemi generativi per il design vocale, la clonazione vocale e il trasferimento dello stile vocale. Sebbene nel marketing sia spesso usato come termine intercambiabile con Text to Speech, “generatori di voci IA” descrive più propriamente la categoria più ampia degli strumenti generativi per la voce, di cui il TTS fa parte.
Come usare il Text to Speech per contenuti, accessibilità e assistenza
I modelli Text to Speech sono diventati una parte centrale dei workflow in tutto il mondo, sia in ambito personale sia commerciale.
Ecco alcuni dei principali casi d'uso del Text to Speech.
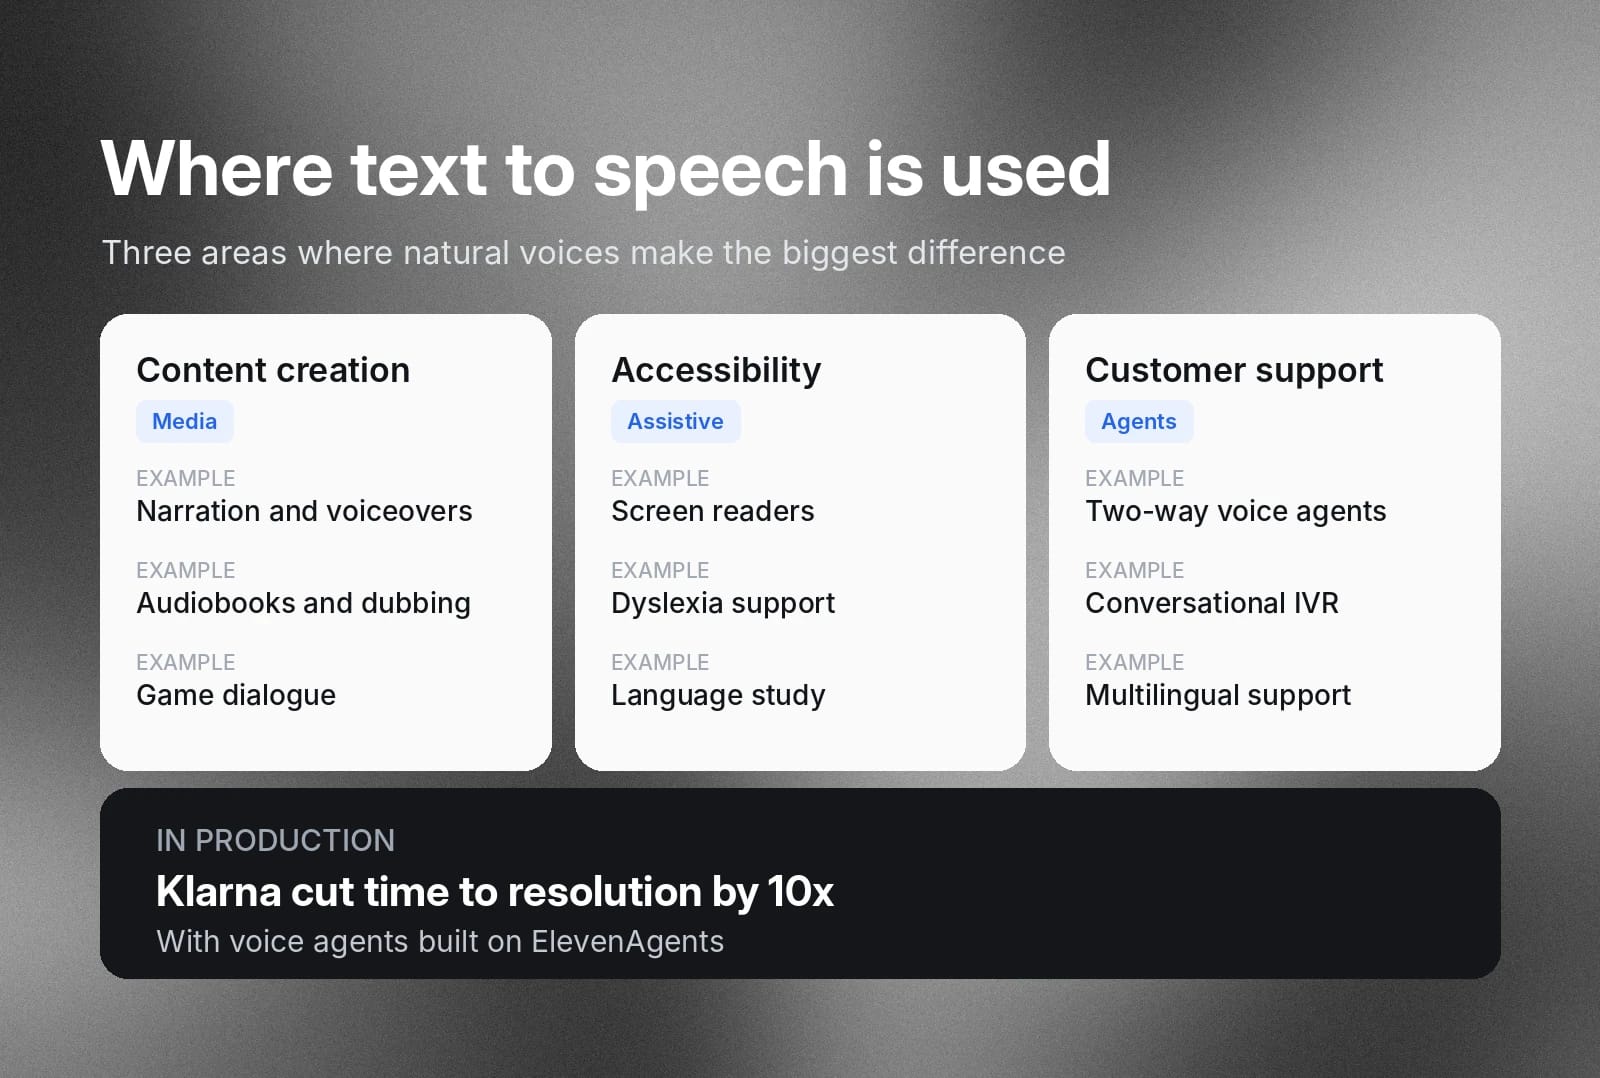
Creazione di contenuti
Gli strumenti Text to Speech possono contribuire a ridurre i costi della produzione media su larga scala e il tempo trascorso in studio per narrazione e correzioni in post-produzione.
Esempi di casi d'uso:
- Narrazione
- Voci fuori campo
- Doppiaggio
- Produzione di audiolibri
- Dialoghi nei videogiochi
Ad esempio, TAP ha usato ElevenLabs TTS per ampliare i contenuti educativi destinati alle scuole di tutta l'India.
Accessibilità
Il Text to Speech è una delle tecnologie assistive più utilizzate perché consente alle persone di fruire dei contenuti scritti ascoltandoli. Il parlato naturale migliora il coinvolgimento di chi ascolta e riduce l'affaticamento mentale durante l'ascolto di contenuti lunghi.
Tra gli usi più comuni del TTS per l'accessibilità rientrano:
- Screen reader: leggono intere pagine ad alta voce tramite uno screen reader e il TTS.
- Supporto per dislessia e alfabetizzazione: riduce il carico della lettura affiancando le sessioni di lettura a una voce TTS.
- Ipovisione e cecità: gli screen reader leggono ad alta voce gli elementi dell'interfaccia e i contenuti delle pagine, così le persone possono navigare in software e siti web senza vedere lo schermo.
- Differenze cognitive e dell'attenzione: ascoltare il testo può ridurre lo sforzo richiesto per leggere documenti lunghi e facilitare la concentrazione.
- Apprendimento e studio delle lingue: gli studenti ascoltano la pronuncia corretta del nuovo vocabolario e possono ascoltare i libri di testo mentre si spostano o studiano.
Gli screen reader sono strumenti di accessibilità completi che descrivono tutto ciò che appare su uno schermo, inclusi pulsanti e menu. Gli strumenti di lettura ad alta voce si concentrano invece sul contenuto stesso, di solito con un'evidenziazione che segue il testo, e beneficiano di voci più naturali perché vengono usati per periodi prolungati.
Assistenza clienti
La sintesi vocale neurale può offrire un'esperienza clienti di alta qualità se abbinata a un LLM capace di interazioni agentiche. Piattaforme come ElevenAgents combinano il livello vocale con il riconoscimento vocale, un LLM e strumenti connessi che consentono a un agente di comprendere le esigenze di chi chiama e rispondere con una voce naturale.
Gli agenti creati con ElevenAgents operano su telefono, web, WhatsApp, email e SMS, consentendo ai clienti di continuare una conversazione su più canali senza doversi ripetere. Esempi di casi d'uso:
- Agenti vocali IA bidirezionali: gestiscono conversazioni in tempo reale rispondendo a domande da una knowledge base o indirizzando i clienti verso flussi specifici, come rimborsi o acquisti.
- Sistemi di risposta vocale interattiva (IVR): sostituiscono i menu obsoleti del tipo “Premi 3 per le vendite” con conversazioni in cui i clienti possono parlare in modo naturale.
- Assistenza multilingue: servi i clienti nella loro lingua con una singola configurazione dell'agente.
Klarna, ad esempio, ha ridotto di 10 volte il tempo di risoluzione con ElevenAgents
Come controllano la pronuncia i motori Text to Speech?
I moderni motori di sintesi vocale neurale possono generare un parlato dal suono molto naturale, ma in qualcosa di ampio, profondo e dinamico come il linguaggio umano esisteranno sempre casi limite. Potresti voler mantenere accenti, slang o pronunce regionali nel parlato generato. Potresti produrre audio per un settore con pronunce specifiche per i termini tecnici. Oppure potresti semplicemente volere che il nome del tuo brand venga pronunciato in modo molto preciso e coerente.
Dizionari di pronuncia e sostituzioni di fonemi
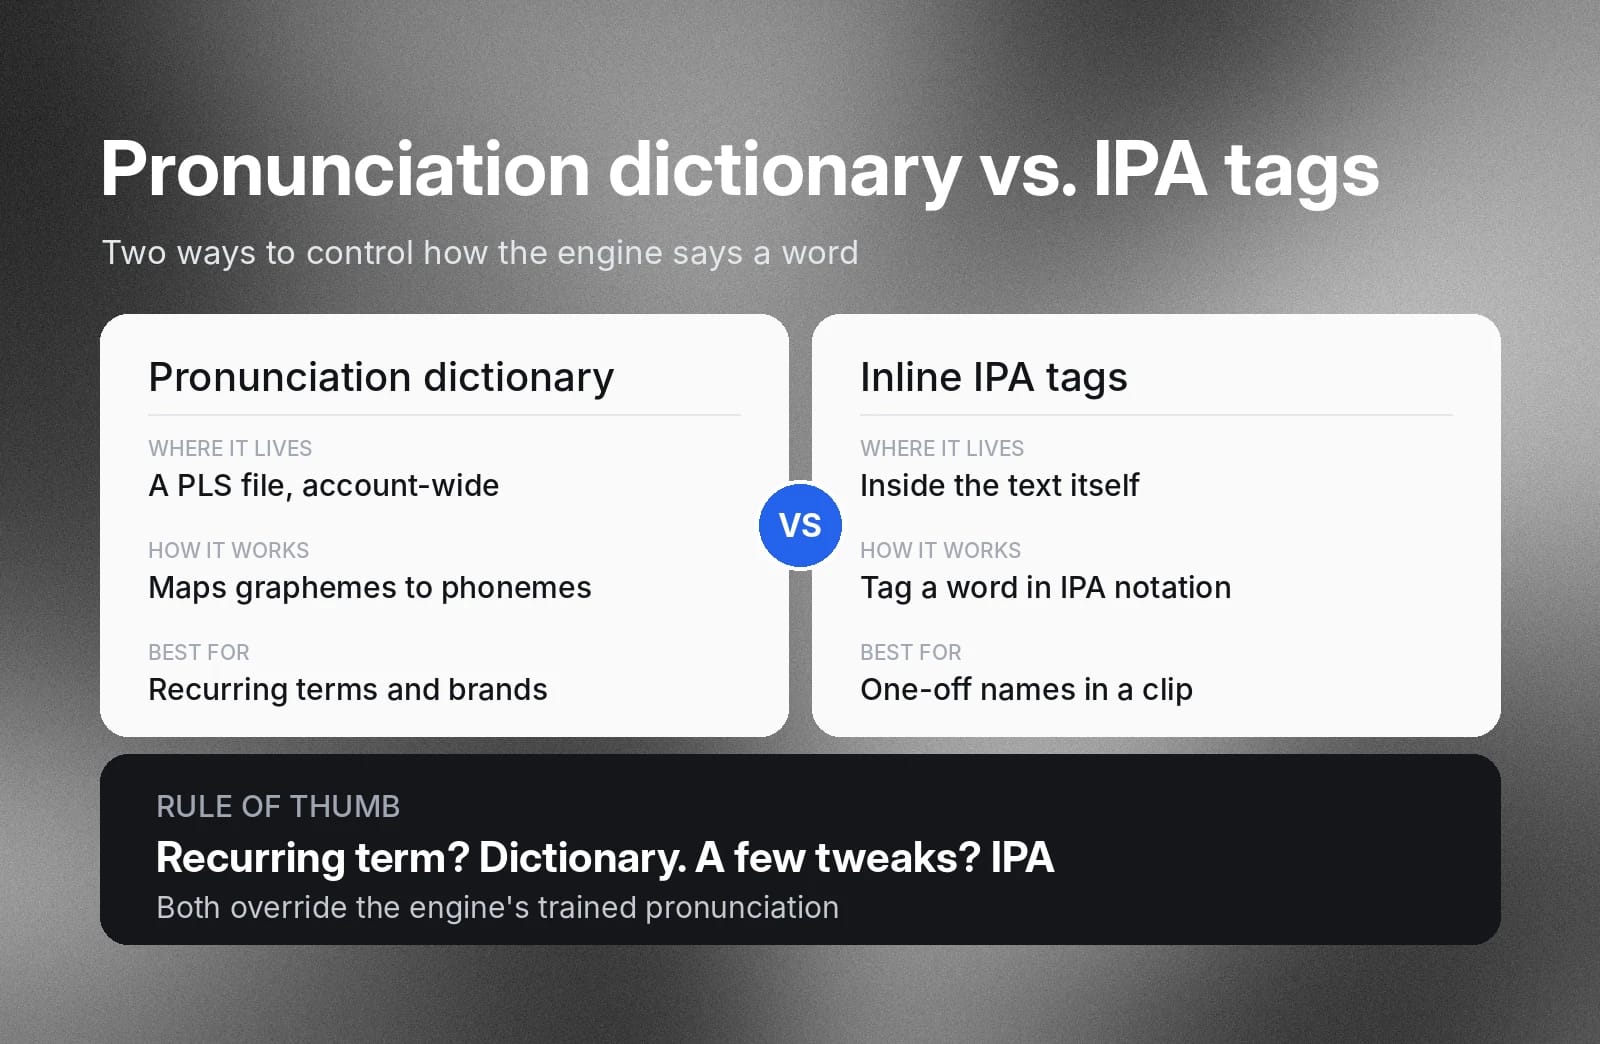
ElevenAPI di ElevenLabs include un dizionario di pronuncia che ti consente di personalizzare il modo in cui parla il motore. Puoi creare un dizionario in un file Pronunciation Lexicon Specification (PLS) conforme allo standard W3C, che associa i grafemi (simboli nel testo) ai fonemi (parole pronunciate scomposte in suoni). Quando il motore TTS incontra uno dei grafemi elencati, sostituisce la pronuncia appresa con quella fonetica del dizionario.
Puoi scoprire come creare un dizionario di pronuncia in ElevenAPI nella documentazione Uso dei dizionari di pronuncia.
IPA nativo e prompting fonetico
Alcuni modelli TTS possono anche riconoscere tag di pronuncia in linea incorporati direttamente nel testo in input. Quindi, invece di creare un dizionario valido per tutto l'account, se vuoi modificare la pronuncia in una o due clip audio, puoi taggare le parole nel testo usando la notazione IPA standard. Ad esempio, se stai registrando un audiolibro e vuoi che il nome di un personaggio fittizio venga pronunciato in un determinato modo.
Sfide comuni del Text to Speech e come affrontarle
Anche i modelli TTS più efficaci possono avere difficoltà con le sfumature del linguaggio umano. Due dei problemi più comuni sono la pronuncia errata di parole nuove e un parlato monotono. Ecco come affrontarli.
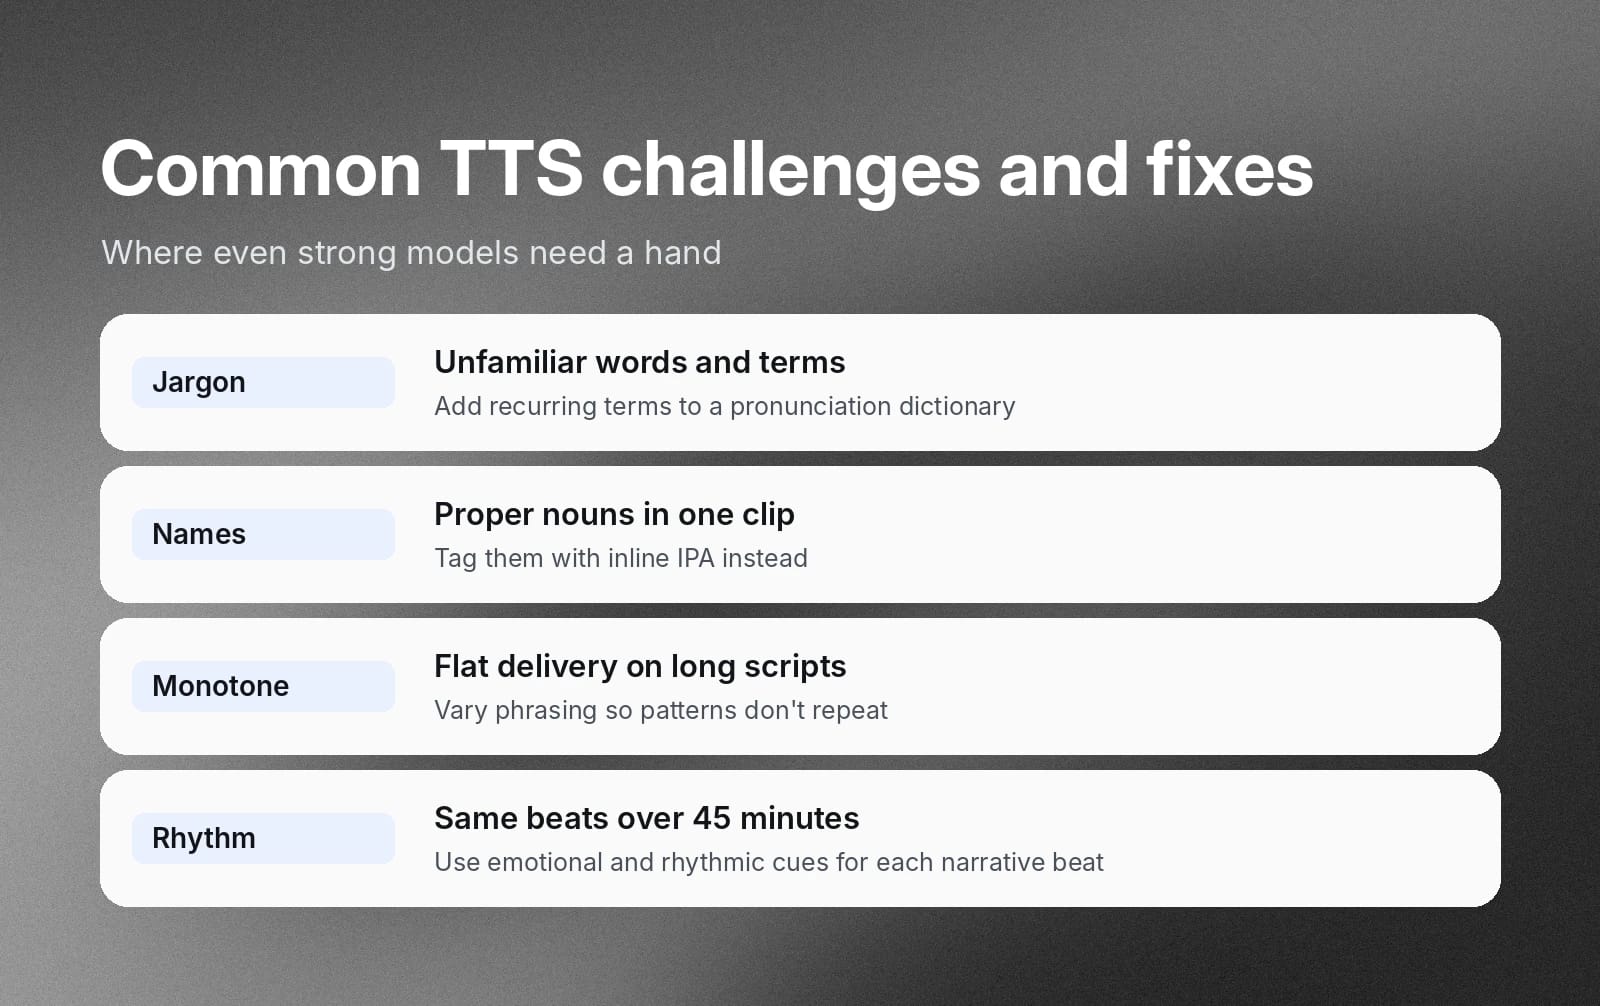
Pronunce errate di parole poco familiari, gergo e nomi propri
I motori TTS usano algoritmi per prevedere come debba essere pronunciato il testo normalizzato, in base a come i grafemi corrispondono ai fonemi nei dati di addestramento. Fanno la migliore previsione possibile in base al testo e al contesto acquisiti. Tuttavia, come abbiamo visto nella sezione precedente, ci saranno molti casi limite in cui desideri una pronuncia molto specifica.
I dizionari di pronuncia o i tag IPA mirati sono gli strumenti migliori per questi casi limite. Se hai un termine ricorrente che vuoi pronunciare sempre nello stesso modo, un dizionario è la soluzione migliore. Se devi apportare modifiche mirate a pochi termini, usa i tag IPA fonetici.
Tono monotono
Questi problemi sono più comuni durante l'elaborazione di script più lunghi, quando le stesse parole o frasi vengono ripetute continuamente. Il parlato sintetizzato di un motore può suonare bene in clip di 10 secondi, ma ascoltare gli stessi schemi di pronuncia meccanica e ritmo per una lezione di 45 minuti diventa rapidamente faticoso per chi ascolta.
Varia le formulazioni usate nei tuoi script e usa con giudizio i tag fonetici per variare periodicamente le pronunce. Usa indicazioni emotive e ritmiche per rendere l'output vocale più dinamico, con salite e discese che seguono i diversi momenti narrativi.
Crea esperienze vocali naturali con un'API Text to Speech
Gli strumenti web leggeri possono essere ottimi per produrre piccole clip audio, ma non si adattano bene a esigenze aziendali più ampie. Se devi gestire migliaia di interazioni con i clienti al minuto o generare contenuti audio lunghi e di alta qualità, avrai bisogno di strumenti TTS più robusti.
Un'API Text to Speech come ElevenAPI ti consente di collegare direttamente il tuo software ai modelli di sintesi vocale neurale. Puoi usare richieste REST o WebSocket persistenti per generare audio on demand per agenti o altri scopi su larga scala.
Come funziona una richiesta API Text to Speech
Sebbene i modelli siano complessi, il flusso per gli sviluppatori è facile da capire e da usare.
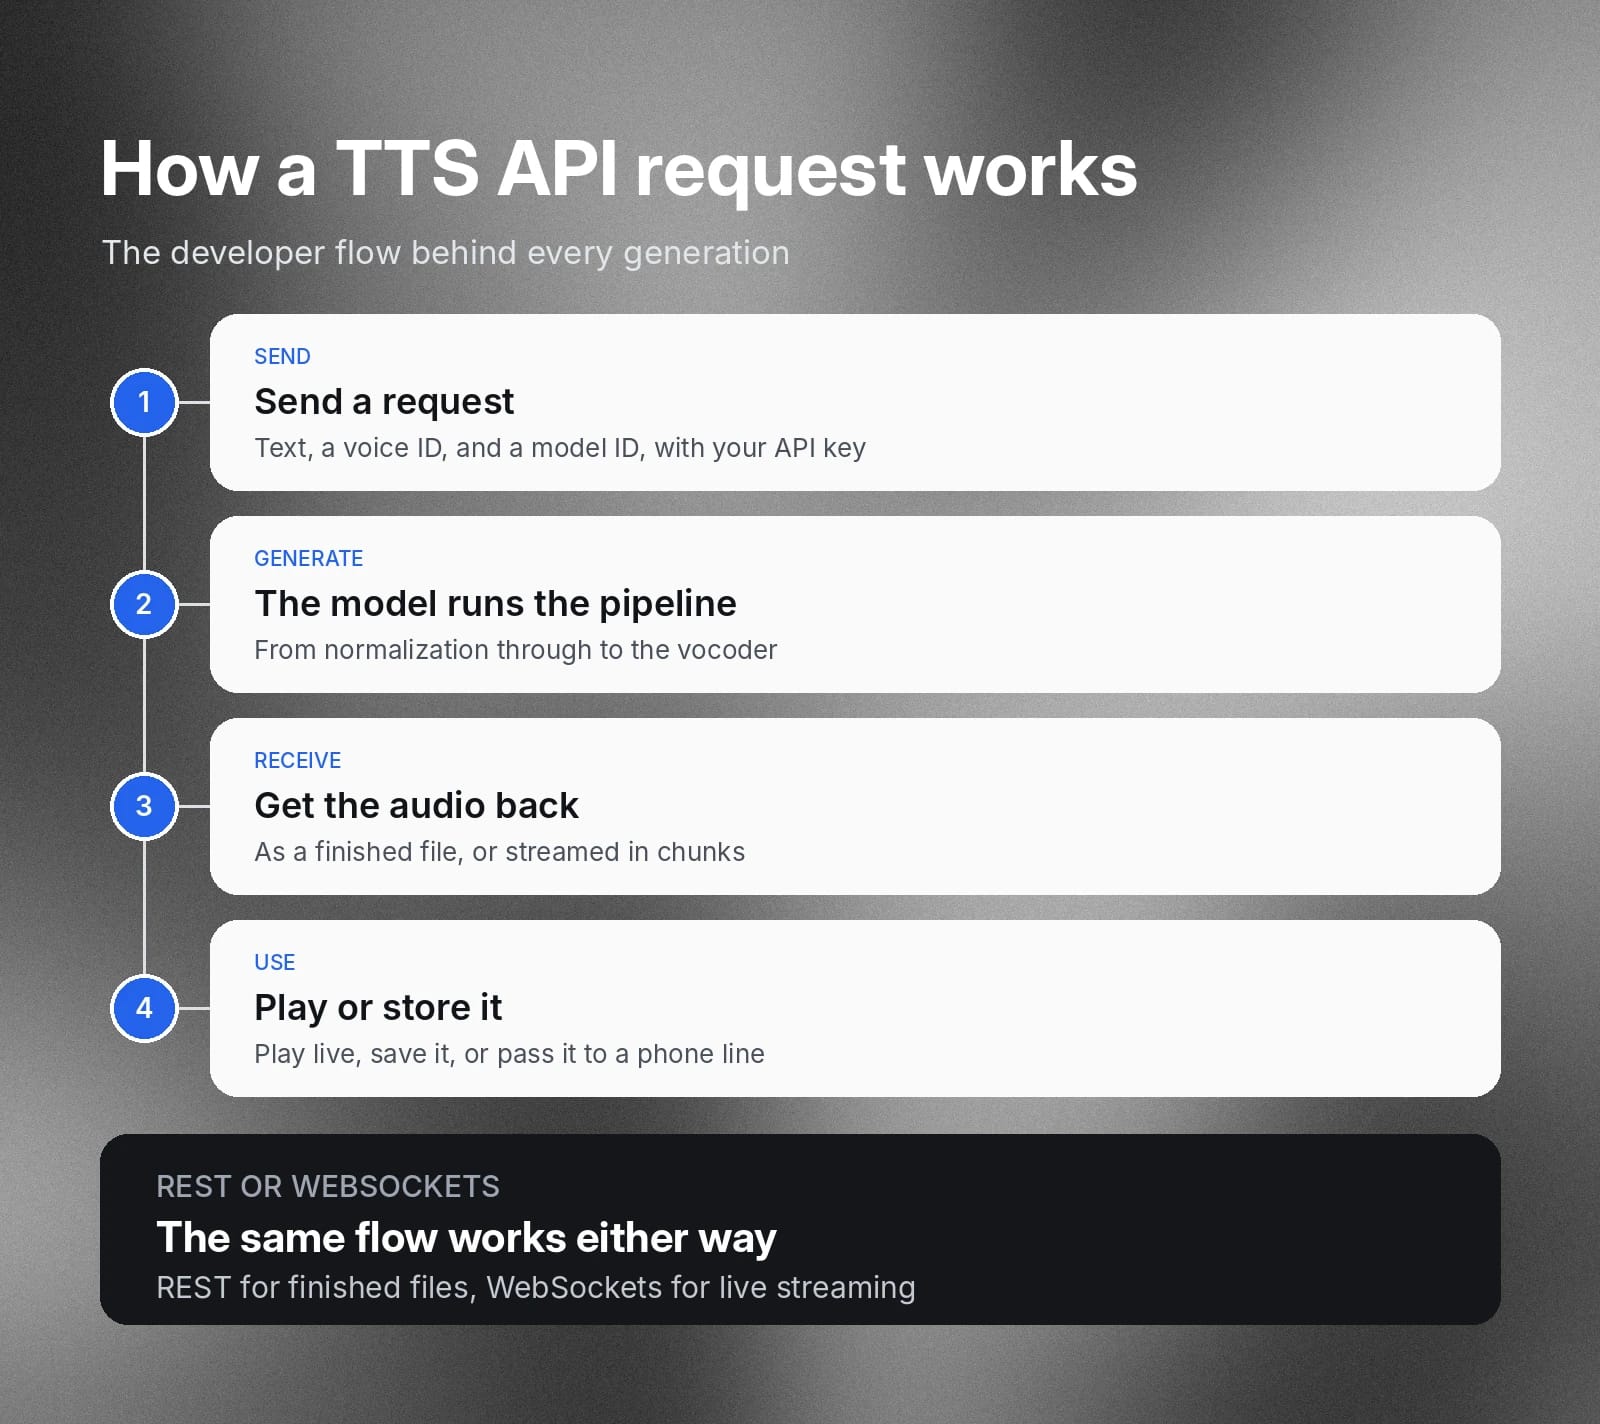
Con ElevenAPI, puoi integrare Text to Speech nelle tue applicazioni in pochi minuti:
- Invia una richiesta: la tua applicazione invia il testo, un ID della voce e un ID del modello all'API usando la tua chiave API.
- Genera: il modello esegue la pipeline descritta sopra, dalla normalizzazione fino al vocoder.
- Ricevi l'audio: l'API restituisce il file audio finito oppure lo trasmette in chunk, così la riproduzione può iniziare prima che la generazione termini.
- Riproduci o archivia: la tua applicazione riproduce l'audio in diretta, lo salva o lo inoltra a un altro sistema, come una linea telefonica.
Lo stesso flusso si applica sia se usi REST per i file completati sia WebSocket per lo streaming in diretta, e gli SDK descritti di seguito gestiscono queste chiamate per te.
Considerazioni architetturali per sviluppatori
In base al tuo caso d'uso, potrebbe essere necessario bilanciare i compromessi tra velocità di elaborazione, fedeltà audio, latenza e protocolli di rete e capacità di integrazione.
Latenza e fedeltà
Per far suonare naturali gli agenti conversazionali, punta a circa 100 ms per il primo audio, il che significa ridurre al minimo la latenza sulla rete e verso il motore TTS. L'aspetto da considerare è la qualità dell'output audio che l'architettura del tuo agente riesce a offrire entro questo vincolo.
Al contrario, la latenza è meno importante quando produci audio di lunga durata, come un podcast o una lezione. Invece di minimizzare la latenza, dovrai massimizzare un output ad alta fedeltà.
Protocolli di streaming
I protocolli usati per la connessione API possono influire anch'essi su latenza e prestazioni. I WebSocket consentono un vero streaming audio bidirezionale, ovvero puoi elaborare chunk di testo alla volta anziché attendere il rendering di un intero flusso. La riproduzione può iniziare con i primi chunk mentre il motore TTS elabora ancora quelli successivi.
SDK
Le API Text to Speech di livello enterprise, come ElevenAPI, offrono kit di sviluppo software (SDK) completi per Python e TypeScript/JavaScript, oltre alle API REST, per aiutarti a creare rapidamente una nuova architettura. Usali per ridurre il carico di integrazione per il tuo team di sviluppo.
Inizia a usare ElevenAPI per il Text to Speech
La sintesi TTS naturale di un modello vocale leader produce l'output audio di alta qualità di cui i tuoi agenti e le tue produzioni audio hanno bisogno per coinvolgere chi ascolta. Che tu stia cercando un agente conversazionale di alta qualità per supportare i workflow dei clienti o voglia integrare il TTS nella tua applicazione, ElevenLabs ha la soluzione giusta.
Inizia oggi a produrre il tuo audio ad alta fedeltà con ElevenAPI, oppure scopri di più su ElevenAgents.
Domande frequenti

Jack Limebear fa parte del team Growth e si occupa di scrivere contenuti e definire strategie per il blog e le pagine insights. Prima di arrivare in ElevenLabs, ha guidato la strategia dei contenuti per oltre dieci anni in realtà che vanno da startup SaaS in rapida crescita a grandi aziende Fortune 500. Ha conseguito un Master in Letteratura Inglese presso l’Università di Cambridge.