Text to Speech neurale (TTS) spiegato: come funzionano le voci IA
- Scritto da
- Jack Limebear
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
Il text to speech neurale (TTS) è la tecnologia alla base delle voci IA che senti ovunque. Il piccolo pulsante sul tuo sito di notizie che legge l'articolo ad alta voce. Le chiamate di assistenza automatizzate. La narrazione dei video su siti come TikTok e YouTube. E gli esempi non finiscono qui. Il TTS neurale ha sostituito le tradizionali forme robotiche di text to speech.
Il mercato del TTS ha superato 4,8 miliardi di dollari nel 2026 e cresce a un tasso di crescita annuale composto (CAGR) del 22,4%, aumentando di anno in anno con l'arrivo sul mercato di nuovi casi d'uso e la crescente adozione di questa tecnologia da parte di creator e aziende.
Questa guida spiega cos'è il text to speech neurale e perché è centrale per la rapida crescita di questo settore. Vedremo in cosa differisce dal TTS tradizionale e cosa cercare quando integri un'API TTS nelle tue applicazioni.
In sintesi
- Il text to speech neurale usa il deep learning per generare parlato da zero.
- Le voci neurali catturano la prosodia, l'intonazione, gli schemi di enfasi e il ritmo per comprendere come suona una voce umana.
- Il TTS concatenativo e parametrico tradizionale esiste ancora nei sistemi legacy, ma la sintesi neurale lo ha sostituito ovunque la qualità della voce sia importante.
- Gli sviluppatori possono integrare il TTS neurale tramite API, con una latenza di streaming ormai sufficientemente bassa per conversazioni in tempo reale.
Cos'è il text to speech neurale?
Il text to speech neurale (TTS neurale) è una forma di sintesi vocale che usa reti neurali profonde per produrre parlato dal suono umano. Nell'intelligenza artificiale, una rete neurale è composta da livelli di unità di elaborazione interconnesse, così chiamate perché ricordano, sia pure vagamente, la rete neurale del cervello umano.
I primi modelli di text to speech si basavano su regole scritte manualmente e frammenti audio registrati per rappresentare la lingua e sviluppare la capacità di produrre parlato da campioni di testo. Un modello TTS neurale ricava le proprie regole, imparando dal contesto ad affrontare gli aspetti più complessi del parlato, come capire dove fare una pausa o quale parola enfatizzare in una frase.
Elementi come la comprensione della prosodia e delle emozioni distinguono un TTS neurale dai modelli tradizionali.
Come funziona il TTS neurale: panoramica della tecnologia
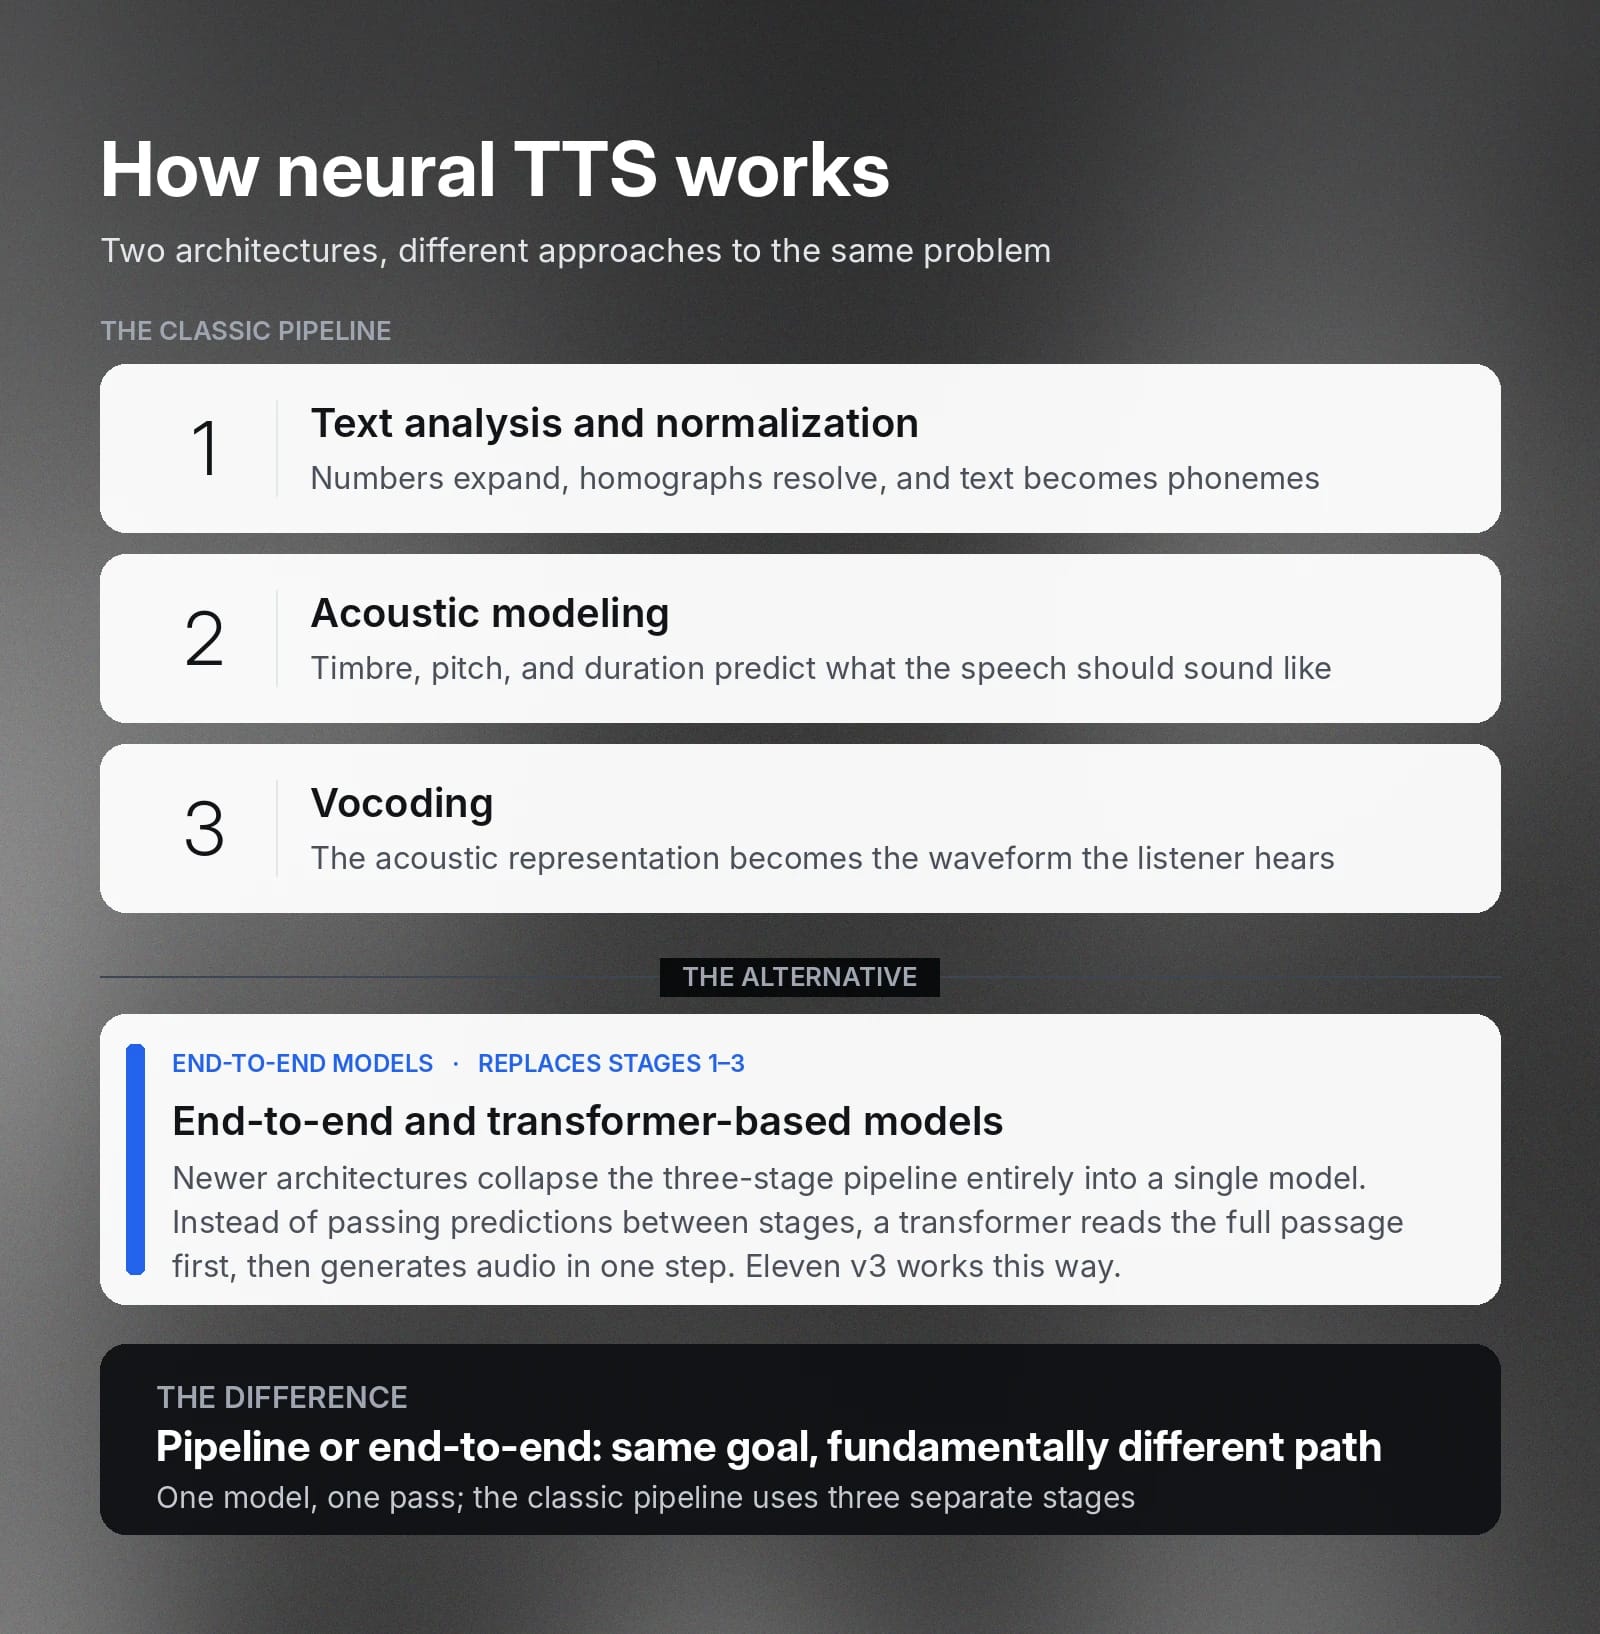
In apparenza, un TTS neurale converte il testo in audio preservando le caratteristiche che trasmettono significato: pronuncia, intenzione emotiva, ritmo, enfasi e tono. Dietro le quinte, una pipeline di modelli lavora insieme per trasformare il testo in parlato dal suono umano.
Sebbene le architetture esatte varino tra i diversi fornitori, un TTS neurale prevede in genere le seguenti fasi principali.
Analisi del testo
Il testo scritto è pieno di ambiguità. C'è una celebre frase di esempio in inglese in cui l'enfasi su una parola diversa cambia il significato: “I didn't say he stole the money.” Enfatizzando “I”, suggerisci che l'abbia detto qualcun altro. Enfatizzando “he”, suggerisci che abbia rubato qualcun altro. Enfatizzando “money”, improvvisamente è stato rubato qualcos'altro.
L'analisi del testo risolve questa ambiguità prima di generare l'audio. Espande le abbreviazioni e converte elementi testuali comuni, come date, numeri e simboli, nelle rispettive forme parlate. Omografi come “read”, “lead” e “bass” vengono identificati e pronunciati correttamente in base al contesto dell'intera frase. Prevede inoltre il markup prosodico, individuando le parole più rilevanti. Il modello acustico riproduce quel markup nella fase successiva.
Il testo normalizzato viene poi convertito in singoli fonemi mediante un processo chiamato conversione da grafema a fonema. Questo passaggio assicura che l'audio finale sia stabile e corretto, anche in lingue, come l'inglese, con regole di pronuncia notoriamente poco affidabili.
Abbiamo scritto una guida ai fonemi che approfondisce questo livello.
Modellazione acustica
Il modello acustico è il nucleo neurale del sistema: prende la sequenza di fonemi e prevede come dovrebbe suonare il parlato.
Lo strato acustico ha tre dimensioni principali:
- Timbro: La texture che rende una voce riconoscibile come appartenente a un determinato parlante, talvolta chiamata “impronta vocale” di una persona.
- Altezza: L'andamento tonale di una frase, inclusa l'intonazione di un'espressione e la salita di una domanda o la discesa di un'affermazione.
- Durata: Per quanto tempo il modello mantiene ciascun fonema: determina il ritmo di una frase e impedisce che una parola come “jump” diventi “jjjjump”.
Insieme, questi elementi determinano la prosodia di una frase. Un TTS neurale li usa per produrre una lettura meno robotica. Grazie all'addestramento su ore di parlato reale, il modello inserisce pause ed enfasi in modo simile al parlato umano. È un apprendimento basato sul contesto che ricava informazioni dai dati di addestramento anziché da regole specifiche implementate dagli sviluppatori.
Architetture come FastSpeech e Tacotron 2 sono pilastri di questa fase, note per la capacità di convertire una sequenza di fonemi in uno spettrogramma mel. Uno spettrogramma mel è una mappa delle frequenze audio nel tempo. Descrive il parlato, ma non è audio riproducibile: è semplicemente una rappresentazione digitale dei suoni.
Vocoding
Un vocoder è la rete finale di una pipeline classica. Converte la rappresentazione acustica descritta sopra in una forma d'onda effettiva, ovvero ciò che ascolta l'utente finale.
Un problema affrontato dal settore nello sviluppo e nell'uso dei vocoder era la loro tipica lentezza, eccessiva per l'uso in vere pipeline di produzione. Solo con iterazioni come HiFi-GAN, che ha migliorato i primi vocoder come WaveNet di DeepMind, le velocità sono diventate sufficienti per scenari di produzione reali.
Il TTS neurale in tempo reale è diventato possibile solo grazie alle innovazioni in questa parte della pipeline.
Modelli end-to-end e basati su transformer
I modelli TTS tradizionali attraversano le tre fasi sopra descritte per produrre audio dal testo. Le generazioni più recenti eliminano completamente questa pipeline. Un modello basato su transformer, che usa la stessa architettura dei modelli linguistici di grandi dimensioni, mappa il testo in audio in un unico processo end-to-end, anziché trasferire le previsioni tra reti acustiche e vocoder separate.
Un modello a pipeline deve elaborare una frase alla volta, mentre un transformer legge l'intero brano prima di decidere, con quel contesto più ampio, come dovrebbe suonare una battuta. La stessa frase può essere letta in modo completamente diverso in una commedia rispetto a un dramma.
I modelli ElevenLabs come Eleven v3 si adattano a queste sfumature e accettano audio tag inline come [whispers] o [nervous] per offrire agli utenti un maggiore controllo sul suono dei loro script.
Text to speech neurale e TTS tradizionale a confronto
Prima della diffusione delle reti neurali, i sistemi TTS adottavano uno di due approcci principali. Entrambi sono ancora presenti nei menu IVR legacy e nei lettori di schermo.
Questi sono i due tipi di TTS tradizionale:
- TTS concatenativo: Registrava un doppiatore o una doppiatrice che leggeva migliaia di frasi e le tagliava in piccoli frammenti. Quando doveva produrre parlato, univa i frammenti. Sebbene le singole parole potessero suonare umane, le giunzioni tra i frammenti creavano una cadenza spezzata e robotica che le persone associano ancora a una voce generata dal computer.
- TTS parametrico: Generava audio da un modello statistico di parametri del parlato anziché da registrazioni. Era più compatto e flessibile della sintesi concatenativa, ma l'audio aveva una qualità ovattata e ronzante perché il modello semplificato eliminava i dettagli fini del parlato reale.
Al contrario, il TTS neurale genera l'intera forma d'onda da un modello appreso del parlato, eliminando entrambi questi problemi in una volta sola.
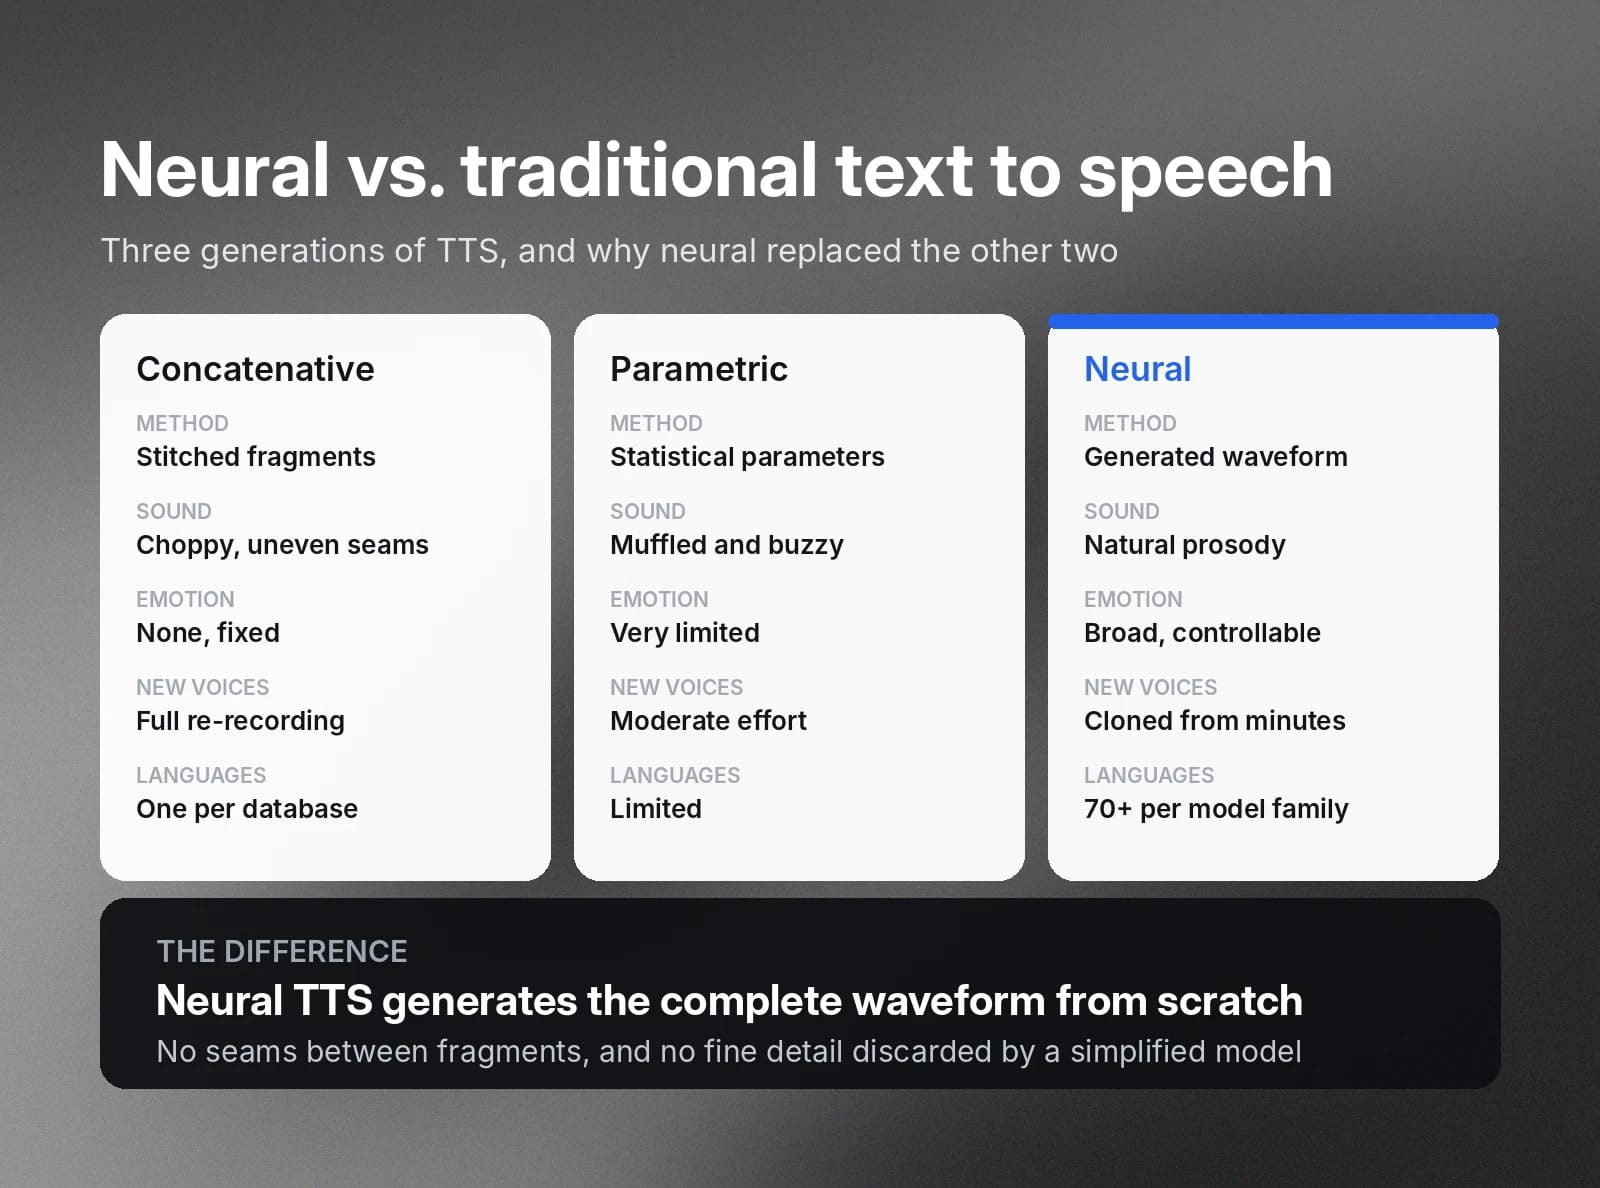
Ecco come il text to speech neurale si confronta con il TTS tradizionale sotto ogni aspetto.
Caratteristiche e vantaggi principali del TTS neurale
L'audio fluido e dal suono umano del TTS neurale abilita numerosi casi d'uso, mentre il salto di naturalezza apre nuove possibilità che il TTS tradizionale non offriva.
Ecco alcune delle principali caratteristiche e vantaggi del text to speech neurale:
- Prosodia naturale: Le voci collocano enfasi, pause e intonazione come farebbe un parlante umano, mantenendo coinvolti gli ascoltatori nei contenuti di lunga durata anziché frustrarli o affaticarli.
- Espressione emotiva: I modelli moderni possono offrire un parlato espressivo, dai monologhi drammatici alle letture pacate. Con Eleven v3, gli autori lo dirigono tramite audio tag scritti direttamente nello script.
- Clonazione vocale: Un modello neurale apprende il timbro e lo stile di un parlante specifico da un breve campione. Puoi usare Clonazione Vocale IA (Instant o Professional) per mantenere una voce coerente in tutte le tue implementazioni TTS.
- Copertura multilingue: Un modello neurale può parlare decine di lingue e un clone vocale mantiene la propria identità in ciascuna di esse. Un brand può così assicurarsi che la voce scelta suoni allo stesso modo a Londra e a Roma.
- Velocità in tempo reale: Un modello di text to speech neurale può sintetizzare il parlato più velocemente della sua riproduzione, con una latenza di streaming sufficientemente bassa per conversazioni dal vivo.
- Scalabilità: Dopo l'addestramento di un TTS neurale, una voce può narrare milioni di parole, inclusi nuovi nomi e descrizioni di prodotti, riducendo notevolmente i costi di registrazione in studio.
Sotto ogni aspetto, il text to speech neurale cambia radicalmente il funzionamento del TTS nel suo complesso. Questo cambiamento crea nuove opportunità per l'accessibilità, il business, la copertura e l'espressione emotiva.
Principali casi d'uso delle soluzioni TTS neurali
Modificando il funzionamento dell'architettura fondamentale di un modello di text to speech, i miglioramenti in velocità e resa consentono una serie di nuovi casi d'uso.
Ecco alcune delle applicazioni in cui oggi offre il massimo valore.
IA conversazionale e agenti vocali
Assistenza clienti , centralinisti virtuali, assistenti telefonici e SDR IA dipendono tutti da voci affidabili, che rispondano quasi all'istante.
L'IA conversazionale è il caso d'uso più esigente per il TTS neurale: combina i più alti requisiti di qualità con i budget di latenza più rigorosi.
Audiolibri ed editoria
La narrazione neurale rende conveniente produrre edizioni audio di titoli di catalogo che normalmente non giustificherebbero mai i costi di registrazione in studio. Puoi generare un audiolibro completo in poche ore con il Text to Speech neurale.
ElevenCreative semplifica al massimo questo processo: Character Casting trova automaticamente le voci migliori per un personaggio e assegna le relative battute in un intero manoscritto.
Gaming e media interattivi
Dialoghi dinamici, contenuti generati proceduralmente e conversazioni con NPC sono progetti enormi se registrati manualmente in studio. Il TTS neurale consente agli studi di dare loro voce su larga scala, correggendo gli errori modificando il testo anziché fatturando altre ore di studio.
Localizzazione e doppiaggio
Il TTS neurale combinato con la traduzione porta contenuti video e audio in nuovi mercati, preservando al tempo stesso l'identità vocale del parlante originale.
Il pubblico di un creator a Medellín sente la stessa voce riconoscibile di quello a Boston, solo che parla spagnolo.
Come integrare il text to speech neurale nella tua applicazione
Per gli sviluppatori, il TTS neurale è a una sola chiamata API di distanza.
Ecco un esempio completo che converte il testo in parlato con ElevenAPI usando l'SDK Python.
Lo stesso endpoint è disponibile tramite REST o SDK per Python, JavaScript e altri linguaggi. Esistono tre modelli di integrazione che coprono la maggior parte delle applicazioni:
- Sintesi batch: Invia il testo e ricevi un file audio completo. È adatta ai contenuti preprodotti di articoli, prompt IVR, audiolibri e video.
- Streaming HTTP: I chunk audio arrivano man mano che vengono generati, quindi la riproduzione inizia prima del termine della sintesi. Usalo per leggere documenti lunghi o generare contenuti in stile podcast on demand.
- Streaming WebSocket: Per gli agenti conversazionali, una connessione WebSocket persistente accetta testo in modo incrementale, ad esempio token in streaming da un LLM, e restituisce audio con la latenza più bassa possibile.
Le integrazioni in produzione richiedono inoltre una logica di retry, timeout delle richieste e una gestione degli errori adeguata. Per maggiori informazioni, abbiamo scritto una guida ai modelli di integrazione dell'API Text to Speech.
Scegliere un'API Text to Speech: cosa cercare
Le API Text to Speech possono sembrare simili, ma includono moltissime funzionalità che possono renderne una più adatta di un'altra al tuo caso d'uso specifico.
Pur non essendo un elenco esaustivo, ecco cosa dovresti cercare in un'API TTS:
- Qualità audio: Prima di tutto, se l'audio prodotto da un'API TTS neurale non suona bene, quel fornitore non fa per te. Esegui test di ascolto alla cieca, soprattutto con narrazioni di lunga durata, perché è lì che probabilmente emergeranno i difetti.
- Latenza: Per pipeline o applicazioni di IA conversazionale, valuta il time to first byte. Anche l'infrastruttura regionale conta. Abbiamo ridotto la latenza globale delle API fino al 40% instradando il traffico attraverso data center più vicini agli utenti.
- Supporto per lo streaming: Verifica che siano disponibili e documentati sia lo streaming HTTP sia quello WebSocket. Le API che supportano solo il batch escludono completamente i casi d'uso in tempo reale.
- Copertura di lingue e voci: Cerca API di text to speech neurale con un'ampia copertura linguistica, soprattutto nelle lingue che ti servono abitualmente nelle tue app.
- Controllo espressivo: Cerca strumenti di direzione che ti permettano di personalizzare in pratica il suono di un TTS neurale. Gli audio tag di ElevenLabs offrono un controllo granulare del parlato.
- Somiglianza con il parlante: Se usi la clonazione vocale, verifica quanto fedelmente il modello preserva la resa e la prosodia di una voce clonata in un brano più lungo. Gli script con più personaggi possono degradarsi nel tempo, facendo suonare la voce diversamente dal campione originale.
- Licenze ed etica: Verifica di ricevere i diritti commerciali sull'output e controlla come il fornitore gestisce aspetti quali il consenso vocale, la conservazione dei dati e la prevenzione degli abusi. Gli acquirenti enterprise dovrebbero chiedere informazioni sulla conformità a SOC 2 e sulle certificazioni di sicurezza IA di terze parti, come AIUC-1 e ISO 42001.
- Documentazione ed esperienza per gli sviluppatori: Un'ora passata a esaminare la documentazione per sviluppatori ti dirà tutto ciò che devi sapere sulla completezza di un prodotto. Affidati alla documentazione e ai consigli degli ingegneri, non alle proposte commerciali.
- Modello di prezzo: Molte API addebitano un costo per carattere o credito. Stima il tuo volume mensile e confronta i piani su quella base, anziché sul prezzo di ingresso.
Inizia con ElevenAPI per un TTS neurale di alta qualità
ElevenAPI offre agli sviluppatori accesso diretto ai modelli Text to Speech neurali di ElevenLabs, con oltre 70 lingue e migliaia di voci. Forniamo streaming HTTP e supporto WebSocket, oltre a una bassa latenza pensata per le conversazioni in tempo reale.
Esplora la pagina del prodotto API Text to Speech per ascoltare i modelli, oppure registrati e crea una chiave API gratuita per iniziare.