
Integrazione API Text to Speech: streaming, batching, retry
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
Integrare una API Text to Speech è semplice… cioè, dopo aver preso alcune decisioni concrete: quale modalità di trasferimento usare, come scegliere un modello e un formato di output, come eseguire lo streaming, come gestire volumi elevati senza superare il limite di concorrenza, come usare la cache e riprovare affinché non paghi mai due volte per generare lo stesso audio e come confrontare il tempo al primo byte con quello di un altro fornitore.
Per aiutarti con l'integrazione della API Text to Speech, abbiamo analizzato ciascuna di queste decisioni architetturali e cosa fare. Questa guida ti aiuterà a integrare la API Text to Speech di ElevenLabs e a scalarla, con snippet di codice che puoi inserire in produzione per iniziare subito.
Per una panoramica completa dei concetti citati qui, consulta le nostre guide su come comprendere lo streaming audio, come ottimizzare la latenza, e la panoramica dei modelli ElevenLabs.
Riepilogo
- Esiste un unico endpoint API Text to Speech di ElevenLabs, a cui puoi accedere in tre modi: conversione batch, streaming HTTP e WebSocket stream-input.
- Con HTTP, ogni richiesta in corso conta ai fini del tuo limite di concorrenza, mentre con WebSocket conta solo la generazione attiva.
- Limita il parallelismo appena sotto il limite del tuo piano e memorizza nella cache un hash di ogni parametro che influenza l'output, così non fatturerai mai due volte lo stesso testo.
- Riprova le richieste 429 e 5xx con backoff esponenziale e jitter completo, per ridurre il carico prima di raggiungere il limite di concorrenza.
Tre modi per integrare la API Text to Speech
Esiste un solo endpoint Text to Speech, ma il modo in cui lo integri determina latenza, complessità e costo.
La stessa chiamata POST /v1/text-to-speech/{voice_id} funziona in tre modalità, ciascuna adatta a un'attività leggermente diversa. Ecco una panoramica di tutti e tre i modi per integrare la API Text to Speech:
- Batch (convert) è l'integrazione più semplice: invii una richiesta e ricevi una risposta audio. È l'opzione meno complessa e presenta il tempo al primo audio più alto, perché l'intera clip viene sintetizzata prima che vengano restituiti byte.
- Lo streaming HTTP (stream) mantiene la stessa richiesta, ma suddivide la risposta in chunk: aggiungi /stream al path, chiami il metodo stream e l'audio viene restituito come risposta suddivisa in chunk. Il codice è quasi identico e la latenza percepita è molto inferiore.
- Il WebSocket (stream-input) mantiene una connessione persistente: invii il testo in modo incrementale e ricevi chunk audio man mano. È pensato per agenti interattivi e per inviare l'output di un LLM alla sintesi vocale mentre i token vengono prodotti, prima che la frase sia completata.
Lo streaming non fa generare l'audio più velocemente al modello; il tempo di inferenza non cambia. Ciò che cambia con lo streaming è quando ricevi il primo chunk: viene inviato prima che l'intera clip sia pronta, quindi l'attesa percepita dall'utente è più breve, anche se il lavoro totale è lo stesso.
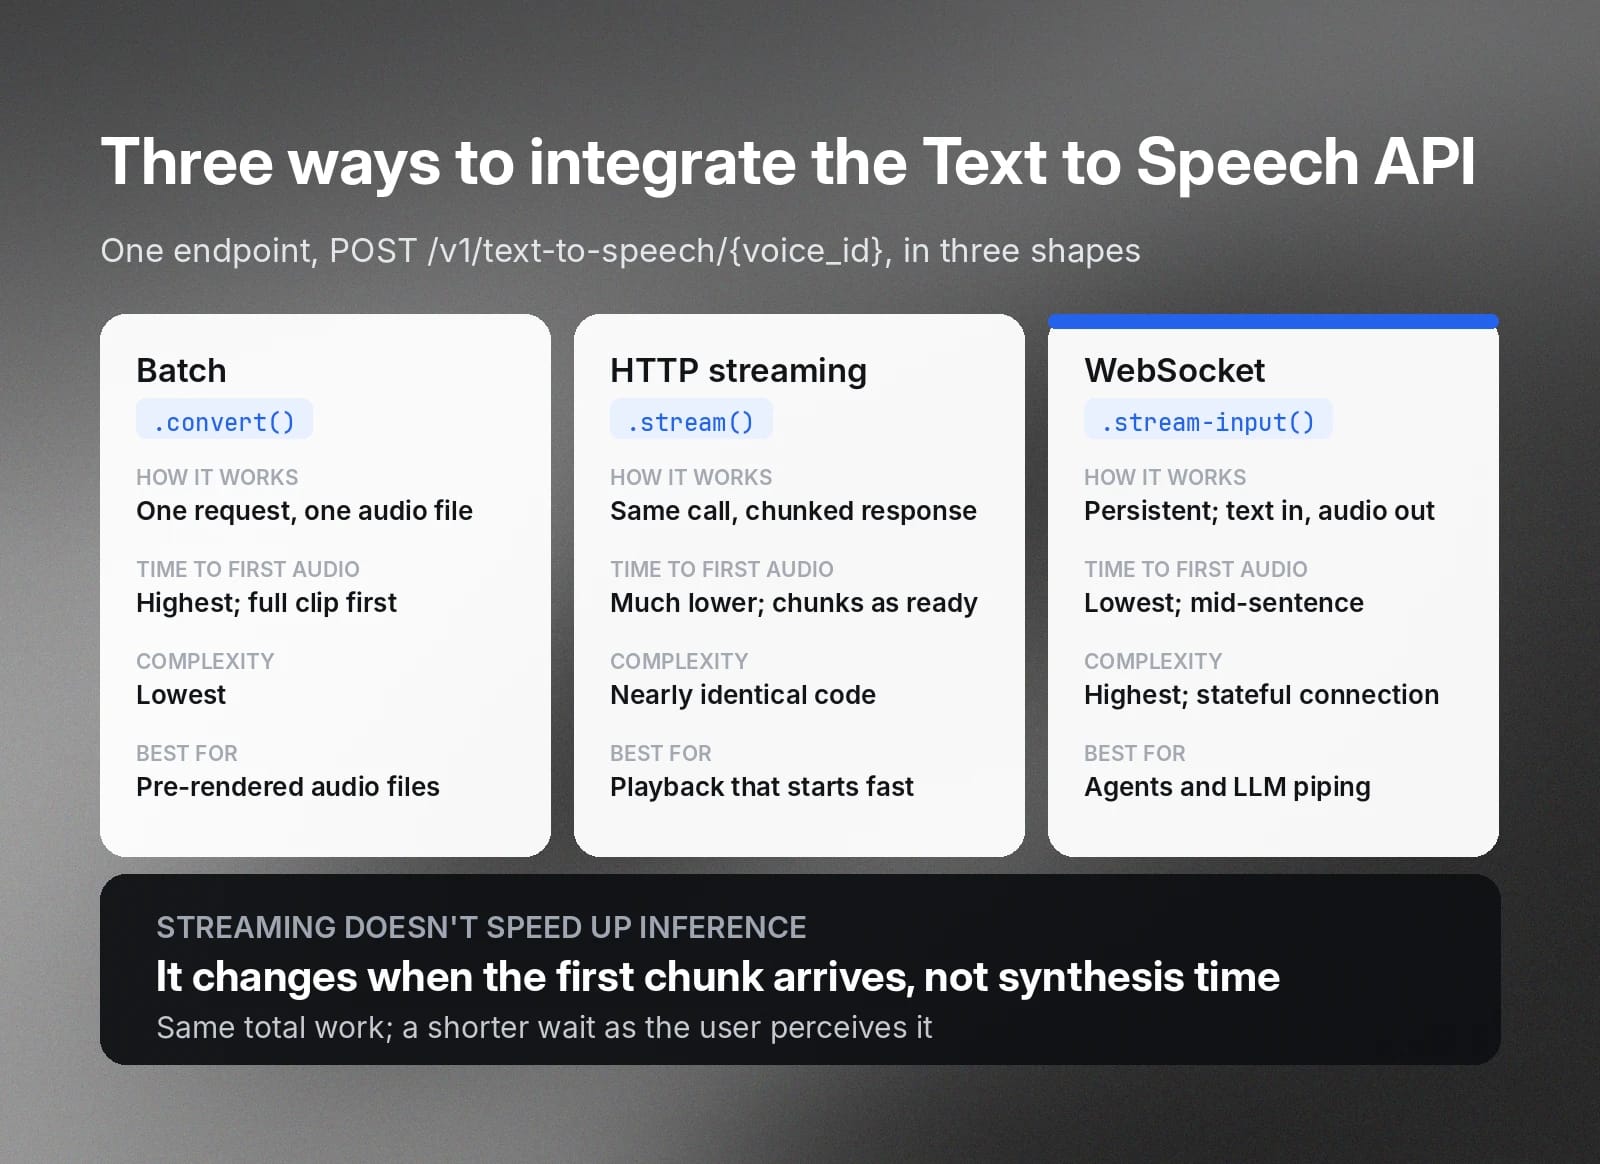
Tabella decisionale: batch, streaming e WebSocket
Quando decidi tra questi tre metodi, devi tenere conto di diversi fattori.
Come guida rapida: scegli batch per il rendering offline, lo streaming HTTP per testo noto che un utente sta aspettando e WebSocket per gli agenti e la sintesi vocale in tempo reale da LLM.
La tabella seguente illustra i compromessi nelle dimensioni che contano su larga scala.
Con HTTP, sia in batch sia in streaming, ogni richiesta in corso conta ai fini del limite di concorrenza del tuo piano per tutta la sua durata. Con un WebSocket, conta solo il tempo in cui il modello genera attivamente l'audio; un socket aperto ma inattivo non ha quasi alcun costo.
Per un agente vocale a cascata che mantiene aperta una connessione per un'intera conversazione ma genera audio solo durante i turni dell'agente, la differenza è notevole ed è il motivo principale per usare WebSocket quando crei agenti. Il protocollo completo è documentato nella guida WebSocket Text to Speech in tempo reale.
Scegliere un modello e un formato di output
Due scelte determinano l'audio che ricevi dalla tua integrazione API TTS. La prima è il modello, che stabilisce qualità e velocità. La seconda è il formato di output, che stabilisce container, bitrate e frequenza di campionamento.
Fare entrambe queste scelte correttamente fin dall'inizio garantisce che tutto ciò che viene dopo, come latenza e compatibilità con la telefonia, funzioni senza problemi.
Modelli
Forniamo diversi modelli Text to Speech. Non sono classificati dal migliore al peggiore; ciascuno offre compromessi diversi.
Nota: il valore di ~75 ms rappresenta l'inferenza del modello in condizioni rappresentative, esclusa la latenza di rete e dell'applicazione. Aumenta con input più lunghi e sotto carico. Misura sempre dalla tua applicazione, non basarti su un valore di benchmark.
I modelli Flash sono più piccoli e usano approssimazioni più aggressive per ridurre il tempo di inferenza. Eleven v4 e Multilingual v2 sono modelli più grandi che dedicano più tempo per carattere a produrre un output più ricco.
Per un percorso in tempo reale o per agenti, usa eleven_flash_v2_5: è l'opzione multilingue con la latenza più bassa. Per la narrazione, gli audiolibri o le voci fuori campo per il marketing, usa eleven_multilingual_v2 se vuoi un'alta fedeltà stabile oppure eleven_v4 se ti servono la massima espressività e gamma emotiva.
Quando la pronuncia è importante, ad esempio per numeri di telefono, date o valute, esegui tu stesso la normalizzazione dei numeri nella tua applicazione prima che il testo raggiunga l'API. Scrivi per esteso la forma parlata che desideri.
Eseguire tu stesso la normalizzazione mantiene la pronuncia prevedibile tra i vari modelli ed evita di affidarti a impostazioni predefinite specifiche del modello che potrebbero cambiare.
Formato di output
Il parametro output_format controlla il container, la frequenza di campionamento e il bitrate dell'audio che ricevi. I valori che userai più spesso sono:
Impostazioni della voce
Le seguenti impostazioni controllano come viene riprodotto il parlato generato:
- Stability: controlla la coerenza rispetto all'espressività. Valori più bassi producono un parlato più vario ed espressivo, mentre valori più alti producono una resa più stabile e prevedibile.
- SimilarityBoost: controlla quanto l'output segue la voce di riferimento.
- Style: esagera lo stile di parlato naturale della voce quando viene aumentato.
- useSpeakerBoost: aumenta la somiglianza con il parlante originale, con un lieve costo in termini di latenza.
- Speed: regola il ritmo di riproduzione attorno al valore predefinito di 1.0.
Tra queste impostazioni, Stability ha in genere l'impatto maggiore sulla qualità percepita. Valori più bassi creano un output più espressivo ma meno coerente, mentre valori più alti danno priorità a coerenza e prevedibilità.
Quando scegli una voce, la combinazione con la latenza più bassa è Flash abbinato a un'istantanea Clonazione Vocale IA o a una voce predefinita; le Clonazioni Vocali Professionali hanno un suono eccellente, ma aggiungono un overhead per generazione di cui devi tenere conto.
In questa guida, l'ID della voce di esempio è JBFqnCBsd6RMkjVDRZzb (George).
Integrazione dello streaming (HTTP e WebSocket)
In questa sezione affrontiamo il nucleo pratico dell'integrazione della API Text to Speech. Vediamo come installare l'SDK, aprire uno stream e consumare l'audio man mano che arriva. Il percorso HTTP copre la maggior parte della riproduzione su web e app, mentre il percorso WebSocket copre gli agenti e l'output LLM in tempo reale.
Entrambi questi percorsi presuppongono che tu abbia inizializzato il client ElevenLabs qui sotto.
Il percorso streaming apre uno stream e consuma i chunk man mano che arrivano. voiceId è il primo argomento posizionale, seguito da un oggetto di opzioni con chiavi camelCase (modelId, outputFormat, voiceSettings):
Per la variante WebSocket, connettiti a wss://api.elevenlabs.io/v1/text-to-speech/{voice_id}/stream-input, invia un primo messaggio contenente le impostazioni della voce e uno spazio iniziale, quindi invia messaggi di testo non appena disponibili e leggi i frame JSON il cui campo audio contiene chunk codificati in base64.
Batching e limiti di concorrenza per un throughput elevato
L'integrazione ad alto throughput è regolata dalla concorrenza, ovvero dal numero di richieste che generano audio nello stesso istante. Ogni piano prevede un limite per famiglia di modelli.
Ogni piano include un limite di concorrenza distinto:
- Free: 4 richieste Flash simultanee.
- Starter: 6 richieste Flash simultanee.
- Creator: 10 richieste Flash simultanee.
- Pro: 20 richieste Flash simultanee.
- Scale e Business: 30 richieste Flash simultanee, con limiti Enterprise personalizzati.
I limiti di Multilingual v2 sono circa la metà di quelli sopra indicati.
Un pool limitato attenua questo problema limitando il numero di richieste eseguite contemporaneamente:
Imposta MAX_CONCURRENCY leggermente al di sotto del limite del tuo piano, anziché esattamente sul limite. Questo margine assorbe altro traffico che condivide la stessa chiave e ti mantiene sotto la soglia alla quale viene restituito un 429.
Limiti di caratteri e suddivisione di testi lunghi
Ogni modello limita il numero di caratteri che accetta in una singola richiesta. Qualsiasi integrazione per contenuti lunghi deve suddividere il testo e ricomporre l'audio.
Ecco i limiti di caratteri per richiesta di ogni modello:
- Flash v2.5: accetta fino a 40.000 caratteri per richiesta.
- Flash v2: accetta fino a 30.000 caratteri per richiesta.
- Multilingual v2: accetta fino a 10.000 caratteri per richiesta.
- Eleven v3: accetta fino a 5.000 caratteri per richiesta.
- Eleven v4: accetta fino a 10.000 caratteri per richiesta.
Tutto ciò che è più lungo deve essere suddiviso in più richieste. Cerca di suddividere il testo ai confini delle frasi, affinché la prosodia si mantenga tra un chunk e l'altro.
Genera i chunk nell'ordine corretto e concatena l'audio. Per una narrazione lunga in cui ogni chunk è indipendente, i due elementi si combinano direttamente: inserisci l'output di splitText nel pool limitato sopra e lascia che gestisca il resto.
Caching e idempotenza
L'output di Text to Speech è sufficientemente deterministico da rendere inefficiente rigenerare lo stesso testo con la stessa voce, lo stesso modello e le stesse impostazioni. Memorizza il risultato nella cache usando come chiave un hash degli input che influenzano l'audio; la stessa chiave può fungere anche da token di idempotenza nei tentativi ripetuti.
Ecco come fare entrambe le cose.
La regola che rende possibile questo approccio è che la chiave deve includere ogni parametro che modifica l'audio, compresi outputFormat e le impostazioni della voce. Se fatto correttamente, la stessa chiave funge anche da token di idempotenza. Quando un client riprova una richiesta già riuscita, restituisci i byte dalla cache invece di generare di nuovo l'audio.
Gestione degli errori e limiti di velocità (429)
Un client di produzione richiede tentativi ripetuti con backoff e jitter, oltre a una gestione che varia in base al codice di stato, perché alcuni errori meritano un nuovo tentativo e altri no.
La tabella seguente associa ogni stato all'azione corretta e la sezione spiega perché un 429 è un limite flessibile, non una barriera invalicabile.
Un 429 non è una barriera invalicabile, ed è utile comprenderne il meccanismo. Quando superi il limite di concorrenza, le richieste vengono prima messe in coda per priorità, il che in genere aggiunge circa 50 ms. Ricevi un 429 solo se anche dopo questo sei ancora oltre la capacità.
La risposta include anche gli header current-concurrent-requests e maximum-concurrent-requests, che mostrano il margine disponibile in tempo reale: puoi quindi leggerli e ridurre il carico prima di raggiungere il limite.
Quando ti serve più margine anziché una migliore strategia di tentativi, passa a un piano superiore. I clienti Enterprise possono richiedere limiti più elevati tramite il proprio account manager.
Benchmark di latenza e tempo al primo byte
La latenza dipende dalla tua regione, dal tuo input e dal carico corrente: perciò l'unico valore di latenza su cui vale la pena fare affidamento è quello che hai misurato nel tuo ambiente.
Questa sezione ti offre il tempo al primo byte (TTFB) per l'endpoint di streaming Flash ed è strutturata per consentirti di puntare lo stesso harness a un altro fornitore e confrontarli in condizioni identiche.
Consideralo una metodologia, non un risultato pubblicato. Una singola esecuzione non garantisce nulla.
Ecco alcune avvertenze importanti quando esegui il benchmark della latenza di un'integrazione API Text to Speech:
- Includi il round-trip di rete: il TTFB dipende dalla tua posizione geografica e dal cluster più vicino del fornitore, quindi esegui il test da dove vengono generalmente eseguiti i tuoi server.
- Scarta un'esecuzione di warmup: la prima richiesta su una connessione fredda è più lenta e può alterare i valori.
- Mantieni fissi gli input: lunghezza dell'input, voce, modello e carico influenzano tutti il risultato, quindi mantienili identici tra i fornitori.
- Riporta una distribuzione: i valori variano da un'esecuzione all'altra, quindi pubblica la mediana e il p95 invece di un singolo valore.
Tenendo conto di questi aspetti, sei pronto per eseguire il benchmark.
Per confrontare un altro fornitore, scrivi una funzione con la stessa struttura. Quindi esegui entrambe con un piccolo runner che scarta una chiamata di warmup, raccoglie circa 20 campioni temporizzati e distanziati per evitare che interferiscano tra loro, e riporta mediana e p95 in millisecondi.
Un confronto equo dipende dal controllo delle variabili.
Esegui entrambi i fornitori dalla stessa macchina e rete, idealmente da un server nella regione in cui esegui effettivamente il deployment anziché da un laptop su una connessione residenziale a banda larga. Usa lo stesso testo di input e mantieni l'audio breve, così il valore dipenderà soprattutto dall'inferenza del modello anziché dalla durata della generazione. Riporta mediana e p95 su molte esecuzioni, perché una singola misurazione è rumore.
Tieni presente che il TTFB su Internet pubblico include 20-200 ms di round-trip di rete, che non hanno nulla a che vedere con il modello. Forniamo il servizio da cluster in Nord America, Europa e Sud-est asiatico e instradiamo verso quello più vicino: colloca quindi il client di test di conseguenza, altrimenti misurerai principalmente la distanza dal data center.
Punti chiave per l'integrazione della tua API Text to Speech
Un'integrazione API Text to Speech pronta per la produzione dipende da alcune decisioni importanti.
Se le fai correttamente, tutto il resto andrà al suo posto:
- Scegli il modello in base all'attività: usa Flash v2.5 per tutto ciò che è interattivo e un modello a fedeltà più alta come Multilingual v2 o Eleven v4 per il rendering offline, dove la latenza conta meno.
- Usa lo streaming ogni volta che un utente aspetta: usa lo streaming HTTP per testo noto e un WebSocket per gli agenti, così il tempo di inattività non incide sul tuo budget di concorrenza.
- Limita il parallelismo al limite del tuo piano: limita le richieste simultanee appena sotto il limite del tuo piano e usa una cache basata su un hash di ogni parametro che influenza l'output, così lo stesso audio non verrà mai fatturato due volte.
- Riprova le richieste 429 e 5xx con backoff esponenziale e jitter completo: riduci il carico in caso di 429 e 5xx usando jitter completo e monitora gli header di concorrenza per capire quanto sei vicino al limite.
- Suddividi i testi lunghi ai confini delle frasi: suddividi il testo ai confini delle frasi entro il limite di caratteri di ciascun modello, affinché la prosodia si mantenga tra i chunk.
Se vuoi approfondire ulteriormente, dai un'occhiata alla guida pratica allo streaming, al concetto di streaming audio, all'autenticazione e ai token monouso per l'uso lato client.
Crea la tua integrazione Text to Speech con ElevenAPI
Dopo aver letto questa guida, hai a disposizione tutti i pattern necessari per un'integrazione API Text to Speech pronta per la produzione. Tra streaming, batching, caching, tentativi ripetuti e persino benchmark, sei pronto a metterla in pratica.
Inizia scoprendo di più sulla API Text to Speech oppure registrati per effettuare oggi la tua prima chiamata con ElevenAPI.
FAQ sull'integrazione della API Text to Speech

Tadas Petra è Developer Relations Engineer e aiuta gli sviluppatori a creare con la suite di prodotti ElevenLabs. È anche il fondatore di Hungrimind, una piattaforma di formazione per sviluppatori. In passato è stato Lead Developer Advocate in Agora e docente presso Zero To Mastery.



