
Framework di valutazione degli agenti vocali: spiegati i 6 pilastri
- Scritto da
- Jack Limebear
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
Gli agenti vocali devono orchestrare una sinfonia di strumenti quasi simultanei. È un delicato equilibrio tra la registrazione dei commenti di un cliente con la trascrizione vocale (STT) in tempo reale, l'elaborazione del contesto e la produzione di una risposta con un modello linguistico di grandi dimensioni (LLM), seguita dalla generazione di un file audio con un software di sintesi vocale (TTS).
Con così tante componenti in gioco, come puoi valutare con precisione le prestazioni di un agente vocale?
In questo articolo proponiamo un framework di valutazione degli agenti vocali basato su sei pilastri, che descrive esattamente cosa misurare per valutarne il successo. Vedremo anche perché i diversi settori dovrebbero attribuire un peso differente a questi pilastri e quali errori comuni evitare durante la valutazione.
In sintesi
- I sei principali pilastri per valutare gli agenti vocali sono qualità vocale TTS, qualità della conversazione, utilizzo degli strumenti e completamento delle attività, intelligenza, conformità e sicurezza, e affidabilità.
- Gli obiettivi di produzione più importanti sono un MOS di 4,3, un TSR superiore all'85% e un tempo al primo audio inferiore a 500 ms.
- I diversi settori attribuiscono un peso distinto a ciascun pilastro e alcune implementazioni ne privilegiano uno rispetto agli altri.
- Tra gli errori di test più comuni vi sono valutare solo audio pulito e ignorare i picchi di latenza P99.
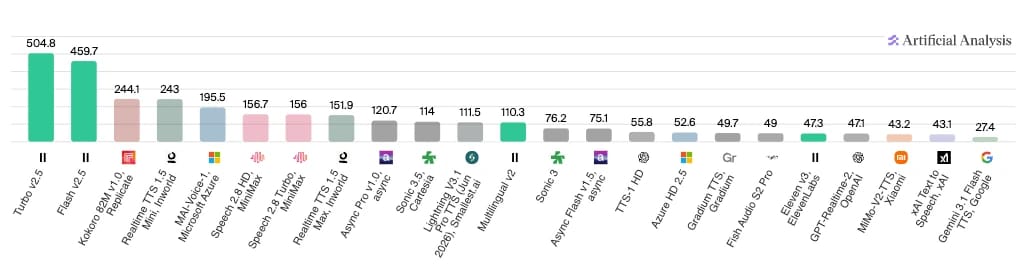
- ElevenLabs eccelle nelle metriche più importanti: Scribe v2 raggiunge il WER più basso del settore, pari al 2,2% (Artificial Analysis, giugno 2026), Flash v2.5 e Turbo v2.5 sono tra i migliori modelli per velocità (Artificial Analysis, giugno 2026) e ElevenAgents offre una latenza di inferenza del modello di circa 75 ms.
Cos'è un framework di valutazione degli agenti vocali?
Un framework di valutazione degli agenti vocali IA è un sistema strutturato che ti consente di testare le prestazioni in più dimensioni. Un framework completo include metriche per valutare tutto, dalla fedeltà audio al flusso della conversazione, fino alla conformità normativa.
A differenza di un chatbot testuale, un agente vocale instrada ogni interazione attraverso almeno tre tecnologie sovrapposte: il riconoscimento vocale automatico (ASR), che converte le parole dell'utente in testo; un LLM che formula una risposta; e un sistema TTS che riconverte la risposta in audio. Se anche solo uno di questi sistemi fallisce, l'intera esperienza ne risente.
Questa complessità è proprio il motivo per cui le aziende devono valutare gli agenti vocali prima di scegliere un fornitore e procedere all'implementazione. Una latenza aggiuntiva o risposte imprecise possono avere conseguenze concrete, come la perdita di clienti o, nel peggiore dei casi, sanzioni normative e danni reputazionali.
Un framework per valutare gli agenti vocali usa benchmark e dati misurabili per stabilire se un agente è adatto o meno a determinati casi d'uso. Dal punto di vista aziendale, poter valutare diversi modelli vocali ti consente di scegliere quello più adatto ai tuoi clienti.
I sei pilastri da valutare negli agenti vocali
Sebbene creare e implementare un agente IA non sia mai stato così semplice, i processi attivi dietro le quinte sono piuttosto complessi. Diverse componenti agiscono insieme per ascoltare un utente, capire cosa desidera, trasmettere queste informazioni a un LLM e poi produrre una risposta audio: molte azioni avvengono quasi simultaneamente.
Per collaborare con il miglior agente vocale possibile, le aziende hanno bisogno di un framework rigoroso con cui confrontarsi.
Se ti interessa di più vedere i risultati dei test, Artificial Analysis offre diversi confronti tra agenti basati su componenti differenti. Qui sotto puoi vedere i risultati del confronto tra modelli per velocità, in cui ElevenLabs Turbo v2.5 e Flash v2.5 sono nettamente in testa per caratteri elaborati al secondo.
Per sviluppatori e aziende che desiderano condurre i propri esperimenti, ecco i sei pilastri di un framework di valutazione degli agenti IA da usare:
- Qualità vocale TTS: quanto il parlato sintetizzato risulta naturale, chiaro ed espressivo per gli utenti finali. I migliori modelli del settore, come Eleven v4, offrono una resa espressiva e simile a quella umana in oltre 70 lingue.
- Qualità della conversazione: un modello comprende il parlato umano, ne elabora il significato e risponde prontamente nel contesto attraverso più turni di dialogo?
- Utilizzo degli strumenti: la misura in cui un agente IA completa attività usando le risorse disponibili senza richiedere l'intervento umano.
- Intelligenza: quanto bene un modello ragiona, gestisce input nuovi ed evita di produrre risposte inesatte o allucinate.
- Conformità e sicurezza: oltre a tutte le capacità, gli agenti vocali IA devono rispettare tutti i requisiti normativi e di conformità, comprese le protezioni attive.
- Affidabilità: componenti quali uptime totale e prestazioni costanti sotto carico, per determinare se un agente di IA conversazionale può scalare in base alla domanda.
Sebbene ciascuno di questi pilastri sia indipendente, sono interconnessi e offrono all'utente un'esperienza finale di alta qualità. Per esempio, se un modello migliorasse la qualità vocale ma mantenesse una latenza elevata, il cliente sperimenterebbe tempi di attesa innaturali prima che il modello iniziasse a parlare.
Esploriamo più a fondo ciascuno di questi pilastri per la valutazione dell'IA vocale.
Qualità vocale TTS
Partiamo dalla qualità vocale, probabilmente la prima cosa che una persona nota quando interagisce con un agente IA conversazionale. Se il suono è robotico o inquietante, l'esperienza soggettiva con l'agente sarà sensibilmente peggiore.
Una delle metriche di valutazione originali, definita dal Telecommunication Standardization Sector dell'International Telecommunication Union (ITU-T), è il Mean Opinion Score (MOS). Il MOS usa una scala da 1 a 5, dove 1 è inutilizzabile e 5 è eccellente. Essendo una misurazione soggettiva, coinvolge ascoltatori umani e raccoglie il loro feedback dopo una chiamata.
Qualsiasi valore inferiore a MOS 3,5 su questa scala è piuttosto mediocre, soprattutto secondo gli standard moderni, e probabilmente inciderà sulla soddisfazione dei clienti.
Sebbene il MOS sia una metrica incentrata sulle persone, diversi requisiti tecnici contribuiscono a determinarlo:
- Coerenza dell'intonazione e jitter: l'intonazione e il jitter sono due elementi linguistici che le persone percepiscono naturalmente mentre ascoltano. Per “intonazione” si intende la variazione dell'inflessione durante il parlato, come quando alzi spontaneamente la voce per fare una domanda. Il jitter si verifica quando la comprensione dell'intonazione da parte di un modello vocale varia, impedendogli di mantenere una prosodia coerente nell'arco di una frase. Il riferimento di settore per il jitter è 30 ms.
- Espressività emotiva: una voce chiara e precisa risulta comunque sbagliata se il tono non corrisponde al registro emotivo previsto dalla frase. Senza segnali tonali accurati, gli ascoltatori umani instaureranno meno sintonia con gli agenti IA conversazionali e li valuteranno peggio. ElevenAgents offre un'espressività quasi umana per associare a ogni risposta una chiara intenzione emotiva.
- Rumore di fondo: il rumore di fondo negli agenti vocali presenta due dimensioni distinte da valutare. In uscita, un rumore ambientale viene aggiunto in modo discreto alle risposte per rendere gli agenti più naturali. In ingresso, il filtro per il rumore di fondo nel livello STT è un'opzione che migliora l'accuratezza. Quando valuti un agente, prova entrambi gli aspetti: verifica se il rumore ambientale suona naturale e valuta l'accuratezza STT con il filtro attivo e disattivo.
Nel calcolare il MOS, dovresti puntare a 4,3-4,5, un intervallo che dimostra punteggi elevati in tutte queste categorie percettive. Per prevedere il MOS su larga scala senza ricorrere a panel umani, puoi usare strumenti come UTMOS e NISQA.
Qualità della conversazione
La qualità della conversazione è un pilastro composito, a metà tra qualità vocale e completamento delle attività. Misura quanto efficacemente un agente vocale comprende le esigenze dell'utente, lo interrompe nel contesto e porta avanti il dialogo su più turni fino al completamento.
La metrica principale è l'accuratezza della classificazione dell'intento, che in genere va dall'85% al 92%, mentre i migliori risultati superano il 96%. L'85% può sembrare alto, ma significa comunque che il 15% di tutto il traffico in entrata viene classificato erroneamente e instradato verso risorse sbagliate.
Gli elementi tecnici che contribuiscono a un'elevata accuratezza nella classificazione dell'intento sono:
- Gestione dei turni: la gestione dei turni determina quanto bene un agente vocale gestisce il flusso naturale della conversazione. Valuta se sa quando ascoltare, rispondere o attendere ulteriori input. Include anche la gestione delle interruzioni, in cui un modello annulla una risposta in corso e ne genera una nuova in base al nuovo input. ElevenLabs usa un websocket multi-contesto per gestire senza interruzioni queste sospensioni della conversazione.
- Latenza: La latenza descrive il ritardo end-to-end tra il momento in cui un utente termina la frase e quello in cui l'agente inizia la risposta audio. Gli agenti vocali pronti per la produzione dovrebbero puntare a un tempo al primo audio inferiore a 500 ms, mentre meno di 300 ms è ancora meglio. I modelli Flash di ElevenLabs offrono un tempo di inferenza del modello leader nel settore, di circa 75 ms, per aiutarti a eccellere in questa categoria.
- Tasso di fallback: il tasso di fallback misura la frequenza con cui un agente IA non riesce a comprendere un utente e chiede un chiarimento o una ripetizione. È in gran parte una conseguenza dell'accuratezza STT: se il livello di riconoscimento vocale interpreta male o rappresenta in modo errato ciò che ha detto un cliente, l'LLM riceve un input corrotto. Il tasso di fallback si calcola con la formula: Tasso di fallback (%) = (Numero di fallback / Numero totale di interazioni) * 100.
ElevenLabs Scribe V2 ha il WER più basso, pari al 2,2%, nella valutazione dei modelli speech to text di Artificial Analysis
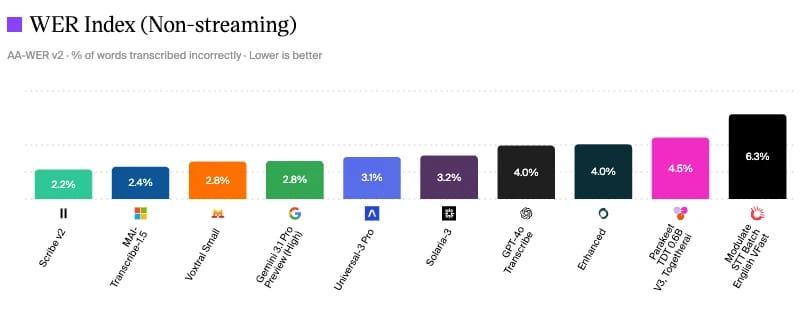
Valutazione dei modelli speech to text di Artificial Analysis
Un modo per misurare la qualità della conversazione è osservare gli standard di benchmark del settore per i vari componenti. Come puoi vedere, Scribe v2 di ElevenLabs ha il Word Error Rate più basso, pari al 2,2% a giugno 2026, il che significa meno errori di ascolto, meno fallback e una classificazione dell'intento più accurata.
Le aziende possono scoprire che la qualità conversazionale dipende anche dal workflow in cui opera un agente vocale. Per esempio, nel servizio clienti, un'altra considerazione potrebbe essere la qualità del trasferimento in escalation o la risoluzione delle FAQ.
Utilizzo degli strumenti e completamento delle attività
Mentre la qualità misura come è stata percepita una conversazione, il completamento delle attività misura se ha portato a un risultato positivo. Le aziende dovrebbero prestare grande attenzione a questa parte del framework di valutazione degli agenti vocali, perché è direttamente collegata ai risultati aziendali.
Una misura dell'utilizzo degli strumenti è l'accuratezza del riempimento degli slot, che determina quanto bene gli agenti IA riescono a completare attività piuttosto routinarie, come compilare un modulo con le informazioni del cliente. Un'elevata accuratezza dimostra che l'agente può passare senza difficoltà dalla conversazione all'azione senza perdere informazioni.
Il Task Success Rate (TSR) è una misura percentuale delle attività end-to-end completate con successo da un agente. Il completamento dipende dalla capacità dell'agente sia di comprendere una richiesta sia di usare gli strumenti connessi corretti (API, database, Retrieval-Augmented Generation (RAG) e knowledge base interne) come supporto.
La formula del TSR è:
TSR = (Attività completate interamente / Totale attività tentate) x 100
Gli agenti vocali pronti per la produzione dovrebbero puntare a un TSR superiore all'85%, monitorando l'accuratezza e l'affidabilità delle chiamate agli strumenti. Per evitare cali del TSR, assicurati di eseguire regression test per qualsiasi modifica ai prompt o ai modelli connessi. Anche una piccola deviazione potrebbe avere conseguenze significative sul TSR.
Intelligenza
L'intelligenza comprende le capacità di ragionamento e di ordine superiore di un agente vocale. È questo pilastro a distinguere chiaramente un IVR (Interactive Voice Response) a guida vocale da un agente vocale IA.
Le dimensioni principali da valutare includono:
- Rischio di allucinazioni: le allucinazioni, in cui un agente produce informazioni inesatte o incoerenti con i documenti aziendali, sono particolarmente dannose nell'IA vocale perché possono essere espresse con sicurezza. Studi recenti suggeriscono che le allucinazioni frequenti danneggiano significativamente la soddisfazione dei clienti nei confronti degli agenti vocali.
- Gestione delle richieste fuori ambito: gli agenti intelligenti capiscono quando una domanda esce dal loro dominio contestuale e riescono a rispondere in modo appropriato. Anziché allucinare una risposta, rifiutano o reindirizzano la conversazione verso un ambito mappato contestualmente.
- Mantenimento del contesto: nel corso di più turni, l'agente riesce a tenere traccia delle entità e degli impegni presi in precedenza? Senza questa capacità, i clienti potrebbero dover ripetersi o ricevere risposte contraddittorie.
- Ragionamento e logica a più passaggi: l'agente riesce a gestire correttamente la logica condizionale o concatenare inferenze su più turni? Soprattutto nei casi d'uso più tecnici, come i servizi finanziari, la capacità di ragionare all'interno di un contesto predefinito è essenziale per il successo.
Esistono diversi benchmark di terze parti per queste dimensioni e componenti. Per esempio, il benchmark Holistic Evaluation of Language Models (HELM) di Stanford valuta le prestazioni degli LLM in diverse categorie. Per le allucinazioni, TruthfulQA offre un'analisi solida della frequenza con cui risposte false si insinuano nelle risposte.
Un vantaggio di ElevenAgents è che, a differenza di alcune piattaforme vocali che ti vincolano a un unico modello sottostante, puoi sostituire interamente il livello LLM. In pratica, puoi integrare il modello che ottiene i migliori risultati nei benchmark di ragionamento per il tuo caso d'uso specifico.
Conformità e sicurezza
Le aziende devono implementare protezioni attive per prevenire output dannosi o in violazione delle policy. A differenza delle istruzioni dei prompt a livello di sistema, che potrebbero essere aggirate o sovrascritte, i controlli indipendenti delle protezioni operano come livello separato, esterno al modello stesso. Valutano gli output prima che raggiungano l'utente e interrompono la conversazione se devia verso territori pericolosi.
La verificabilità è un requisito correlato: gli agenti in produzione devono conservare log dettagliati di decisioni e output in un formato che supporti la revisione a posteriori. Soprattutto nei settori altamente regolamentati, dimostrare la conformità dopo il fatto è importante quanto ottenerla in primo luogo.
Le normative specifiche che la tua azienda deve rispettare variano in base al settore. Alcuni dei framework più comunemente applicabili sono:
- HIPAA: per i dati sanitari protetti nei contesti sanitari statunitensi.
- PCI-DSS: per qualsiasi agente che gestisca dati delle carte di pagamento.
- GDPR: obblighi di privacy dei dati per l'UE e le aziende con clienti nell'UE.
Per le aziende che valutano il proprio livello di conformità, ElevenLabs è conforme agli standard AICPA SOC Type II e GDPR, oltre ad aver ottenuto la certificazione AIUC-1. Lo standard AIUC-1 è progettato specificamente per la sicurezza degli agenti IA.
Affidabilità
L'affidabilità è l'ultimo pilastro del nostro framework di valutazione degli agenti vocali e riguarda la capacità di un agente di garantire prestazioni costanti in tempo reale.
Quando valuti un agente vocale, cerca le seguenti caratteristiche:
- Uptime: qualsiasi implementazione rivolta ai clienti richiede un uptime del 99,9% per evitare interruzioni. Soprattutto nei casi d'uso sempre attivi, come l'assistenza in entrata, un uptime affidabile è un fattore importante.
- Degrado controllato: vista la complessità intrinseca degli agenti vocali, se un componente inizia a non funzionare, l'agente dovrebbe gestire il degrado in modo controllato. In pratica, significa inoltrare la conversazione a una persona anziché continuare a funzionare sotto maggiore pressione o restituendo errori.
- Prestazioni sotto carico: prima della messa in produzione, i load test dovrebbero simulare almeno 2 volte il picco di concorrenza previsto. I test sotto forte stress possono individuare aumenti della latenza o degradi delle prestazioni che emergono solo su larga scala.
Anche un modello di alta qualità che soddisfa tutti gli altri requisiti può essere inutilizzabile se non scala in base alla domanda dei tuoi clienti. ElevenAgents gode della fiducia di 1.000.000 di creatori e aziende leader, dimostrando la capacità della piattaforma di fornire implementazioni su scala enterprise senza compromettere i benchmark di prestazione.
Come misurare il MOS per gli agenti vocali (guida passo passo)
Se la tua azienda vuole misurare manualmente il MOS, avrai bisogno di un ampio gruppo di ascoltatori umani e di una selezione di clip audio tratte da conversazioni reali. È un processo strutturato che prevede la raccolta dei feedback, il calcolo delle medie e l'interpretazione dei dati.
Ecco come misurare il MOS per gli agenti vocali nella pratica:
- Prepara il set di test: seleziona un campione rappresentativo degli output audio del tuo agente, con almeno 100 clip distribuite su diverse conversazioni.
- Esegui la sessione di valutazione: chiedi agli ascoltatori umani di valutare ogni clip su una scala da 1 a 5, in base alla qualità dell'esperienza di comunicazione.
- Aggrega le valutazioni e calcola i punteggi: calcola la media delle valutazioni per ogni clip, quindi la media di tutte le clip del campione per ottenere un MOS complessivo. Un MOS pari o superiore a 4,3 indica che il tuo agente vocale è pronto per la produzione.
Anche se richiede molto lavoro manuale, questo processo ti fornirà un MOS affidabile per l'agente vocale scelto. Se vuoi eseguire il test su larga scala, puoi sostituire gli ascoltatori umani con strumenti automatizzati come NISQA, che prevedono i punteggi MOS in modo programmatico. Puoi integrare questi sistemi nelle pipeline attive per monitorare continuamente il MOS nel tempo.
Benchmark di test IA e umani: FCR, AHT e CSAT
Sebbene calcolare ripetutamente il MOS nel tempo permetta di rilevare miglioramenti o regressioni del modello, puoi aggiungere contesto confrontandolo con le prestazioni umane. Osservare ciò che le persone ottengono realmente in ruoli simili mostra se il tuo agente vocale opera vicino a un livello ideale.
Ecco alcune metriche da considerare per i benchmark di test tra IA e umani.
Gli agenti IA dovrebbero essere in grado di eguagliare FCR e CSAT degli agenti umani, migliorando significativamente l'AHT. Questo miglioramento deriva dal fatto che gli agenti IA gestiscono in genere conversazioni più generiche rispetto agli agenti umani. Molte aziende implementano un workflow in cui gli agenti IA sono il primo punto di contatto e trasferiscono le chiamate agli agenti umani soltanto se sono troppo complesse da gestire autonomamente.
I dati del 2025 di Poe, un aggregatore di confronti tra IA, rivelano che ElevenLabs ha mantenuto la più alta capacità complessiva di soddisfare le richieste, completando il 74,4% di tutte le richieste in entrata. Il suo successo si è tradotto in una crescita rapida dell'utilizzo: Eleven v3 e v2.5-Turbo rappresentano oltre il 60% dei messaggi inviati ai modelli IA nel tempo.
Per un'esperienza migliore, usa Eleven v4 per il nostro modello TTS più espressivo.
Messaggi inviati ai modelli IA nel tempo: ElevenLabs guida il framework di valutazione degli agenti vocali di Poe
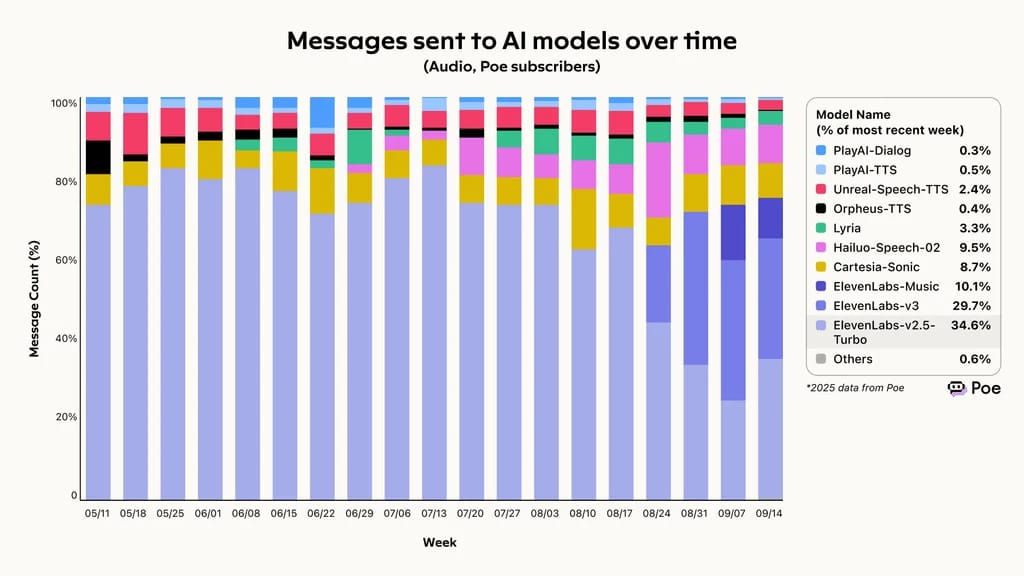
Messaggi inviati ai modelli IA nel tempo, secondo i benchmark di Poe
Errori comuni nei test degli agenti vocali
Quando segui un framework di valutazione degli agenti vocali, è facile lasciarsi tentare da scenari ottimali. In realtà, l'esperienza quotidiana dei clienti che interagiscono con i tuoi sistemi di IA vocale non avverrà in condizioni ideali.
Ecco tre errori comuni nei test degli agenti vocali e come risolverli:
- Testare il percorso più semplice: soprattutto quando selezioni clip audio per il MOS, assicurati di includere casi d'uso limite. Le clip con rumore di fondo o parlato con accento sono estremamente comuni nella vita reale, quindi testare solo file audio “puliti” porta a calibrare erroneamente il MOS.
- Privilegiare il contenimento rispetto alla risoluzione: ottimizzare i modelli per mantenere gli utenti all'interno del sistema dell'agente aumenta i tassi di contenimento senza migliorare i risultati. Se il tuo FCR è basso nonostante un alto tasso di contenimento, l'agente intrappola gli utenti in un ciclo frustrante. Predisponi procedure che permettano agli utenti di parlare con agenti umani, se lo desiderano.
- Ignorare i percentili di latenza: gli SLA spesso definiscono la latenza al livello P95. Sebbene questa metrica sia importante per offrire un'esperienza coerente alla maggior parte dei clienti, non dimenticare che anche il 5% finale è composto da clienti reali. Su larga scala, il 5% di un sistema che gestisce 10.000 chiamate al giorno equivale comunque a 500 persone che sperimentano una conversazione lenta. Punta al P99 come obiettivo SLA principale, non solo alla mediana o al P95.
Tenendo presenti questi aspetti, puoi stabilire valori di riferimento equi e rappresentativi invece di basarti su medie idealizzate.
Perché servono valutazioni specifiche per caso d'uso
Sebbene i sei pilastri descritti in questo framework indichino le aree da esplorare, il peso di ogni pilastro dipenderà dal tuo settore. Per esempio, un'azienda di servizi finanziari può dare priorità alla conformità e all'utilizzo degli strumenti, mentre un brand consumer può considerare la qualità vocale TTS il principio guida.
Ecco due esempi di valutazioni specifiche per caso d'uso e di come possano modificare l'equilibrio tra i vari pilastri.
Assistenza clienti
In alcuni settori, come i call center, altre metriche di completamento delle attività, quali la Risoluzione al primo contatto (FCR), sono una parte importante della valutazione. Riuscire a gestire con successo una chiamata in entrata senza intervento umano riduce significativamente la domanda rivolta agli operatori umani del servizio clienti. McKinsey stima che i call center che usano agenti vocali possono ridurre il volume delle interazioni fino al 50%.
Pur essendo meno importante del tasso di successo delle attività, un'altra dimensione da considerare è il tasso di contenimento. Il tasso di contenimento è una metrica che esamina la durata totale di una chiamata. Se il tuo tasso di contenimento è molto alto ma l'FCR è basso, gli agenti tengono le persone in linea senza offrire una soluzione al cliente. In pratica, il cliente potrebbe vivere la frustrante esperienza di girare in tondo.
Altre metriche da monitorare sono l'AHT, dato che gli agenti IA mirano a risolvere rapidamente i problemi di routine. Per questo, il settore dell'assistenza clienti darebbe priorità alla qualità della conversazione, in particolare alla gestione dei turni e al tasso di fallback, rispetto ad altre aree.
Sanità
La sanità è un settore altamente regolamentato, con requisiti di conformità rigorosi che rendono estremamente delicato l'uso degli agenti vocali. La conformità è una preoccupazione centrale e sposta significativamente il peso del pilastro della sicurezza verso questo aspetto e l'intelligenza, più di ogni altro.
I chatbot per la sanità devono gestire la pianificazione degli appuntamenti, i percorsi di accesso alla telemedicina, il triage dei sintomi e le domande sulle assicurazioni. Tutto questo richiede un alto livello di intelligenza e utilizzo degli strumenti, confermando ancora una volta che le esigenze specifiche del settore o del ruolo influenzano quale pilastro sia più importante.
Qualunque sia il settore in cui opera la tua azienda, comprendere i pilastri fondamentali della valutazione degli agenti vocali e applicarli in modo equilibrato ti aiuterà a trovare gli agenti più adatti a te.
Crea con ElevenAgents per alte prestazioni e bassa latenza
La piattaforma su cui scegli di creare influisce direttamente sulle prestazioni dei tuoi agenti vocali nei workflow reali. Soprattutto quando interagiscono con i tuoi clienti, devi poter contare sul fatto che il tuo agente eccellerà in ogni categoria.
ElevenAgents è progettato per implementazioni vocali in produzione e combina TTS leader nel settore tramite Eleven v4, STT in tempo reale tramite Scribe v2, e un livello di orchestrazione degli agenti progettato per la scala enterprise. Ogni componente è realizzato per soddisfare i benchmark definiti in questo framework, consentendoti di offrire esperienze di alta qualità ai tuoi clienti.
Che tu stia valutando le opzioni o sia pronto a iniziare a creare, ElevenLabs ha un percorso per te. Esplora la piattaforma ElevenAgents per vedere come si adatta al tuo caso d'uso, oppure registrati e inizia a creare oggi stesso.
Domande frequenti sulla valutazione degli agenti vocali

Jack Limebear fa parte del team Growth e si occupa di scrivere contenuti e definire strategie per il blog e le pagine insights. Prima di arrivare in ElevenLabs, ha guidato la strategia dei contenuti per oltre dieci anni in realtà che vanno da startup SaaS in rapida crescita a grandi aziende Fortune 500. Ha conseguito un Master in Letteratura Inglese presso l’Università di Cambridge.


