Rilevamento dei deepfake audio: come funziona e come verificare l'audio di ElevenLabs
- Scritto da
- Jack Limebear
- Pubblicato
AscoltaAscolta questo articolo
Il rilevamento dei deepfake audio è il processo di analisi dell'audio vocale per determinare se il parlato è autentico. I sintetizzatori vocali IA che generano deepfake sono sempre più accessibili. È diventato importante, sia nella vita pubblica sia nel mondo aziendale, identificare rapidamente se il parlato che senti è autentico o è stato manipolato da un malintenzionato.
In questo articolo esploreremo come funziona il rilevamento dei deepfake audio, i diversi tipi di rilevamento, i rispettivi punti di forza e debolezza e come integrare il rilevamento dei deepfake in sistemi di rilevamento delle frodi su larga scala.
Riepilogo
- Il parlato sintetizzato tramite deepfake sta diventando sempre più difficile da rilevare a orecchio. Rappresenta un rischio significativo sia nella vita pubblica sia nel mondo aziendale.
- Esistono diversi tipi di software per il rilevamento dei deepfake. Gli strumenti convenzionali usano l'analisi statistica per valutare la probabilità che un campione audio sia generato dall'IA.
- La nuova tecnologia di watermarking consente di ottenere una risposta definitiva, sì o no, sul fatto che un campione vocale sia stato sintetizzato.
- Il watermarking è molto accurato, ma i rilevatori funzionano solo sull'audio del proprio provider. Ad esempio, Audio Detector di ElevenLabs può identificare con elevata precisione i watermark generati dai suoi prodotti, ma non quelli di altre aziende.
- Il watermarking è una risorsa importante per le organizzazioni che necessitano del rilevamento dei deepfake su larga scala, ma dovrebbe essere solo uno dei tanti strumenti del loro stack di rilevamento dei deepfake.
Che cos'è il rilevamento dei deepfake audio?
Il rilevamento dei deepfake audio è il processo che determina se l'audio vocale è stato generato o manipolato dall'intelligenza artificiale.
Un deepfake è qualsiasi forma di contenuto multimediale (più comunemente immagine, video o audio) creata da un'applicazione di IA generativa con lo scopo di rappresentare in modo ingannevole ciò che una persona dice o fa. I deepfake audio hanno molti utilizzi dannosi. Possono essere usati per frodi, per tentare di accedere ad account personali, come propaganda politica o per impersonare segretamente un coniuge o un familiare nelle controversie domestiche.
In base alle tendenze attuali, le vittime delle truffe basate su deepfake audio sono più probabilmente:
- Politici e altre figure pubbliche: le persone con numerosi campioni vocali disponibili online per l'addestramento potrebbero vedere la propria voce riprodotta tramite deepfake da avversari o terze parti per ingannare il pubblico.
- Familiari: un malintenzionato potrebbe tentare di usare registrazioni vocali trovate online per truffare familiari anziani con richieste di denaro generate tramite deepfake.
- Dirigenti aziendali: interviste, presentazioni e conference call sui risultati finanziari falsificate potrebbero essere usate per danneggiare il brand di un'azienda.
- Team del servizio clienti: i truffatori potrebbero usare campioni vocali raccolti per indurre i team del servizio clienti a concedere l'accesso ad account privati.
Purtroppo, gli esseri umani non sono rilevatori affidabili di deepfake. In contesti di ricerca controllati, la capacità delle persone di identificarli non è migliore del caso, e quella ricerca risale al 2024. Da allora, i contenuti generativi sono diventati notevolmente più sofisticati.
L'educazione e la legislazione contribuiranno molto a proteggere la società dall'influenza dei deepfake, ma restano necessari metodi di rilevamento affidabili.
Come funziona il rilevamento dei deepfake audio?
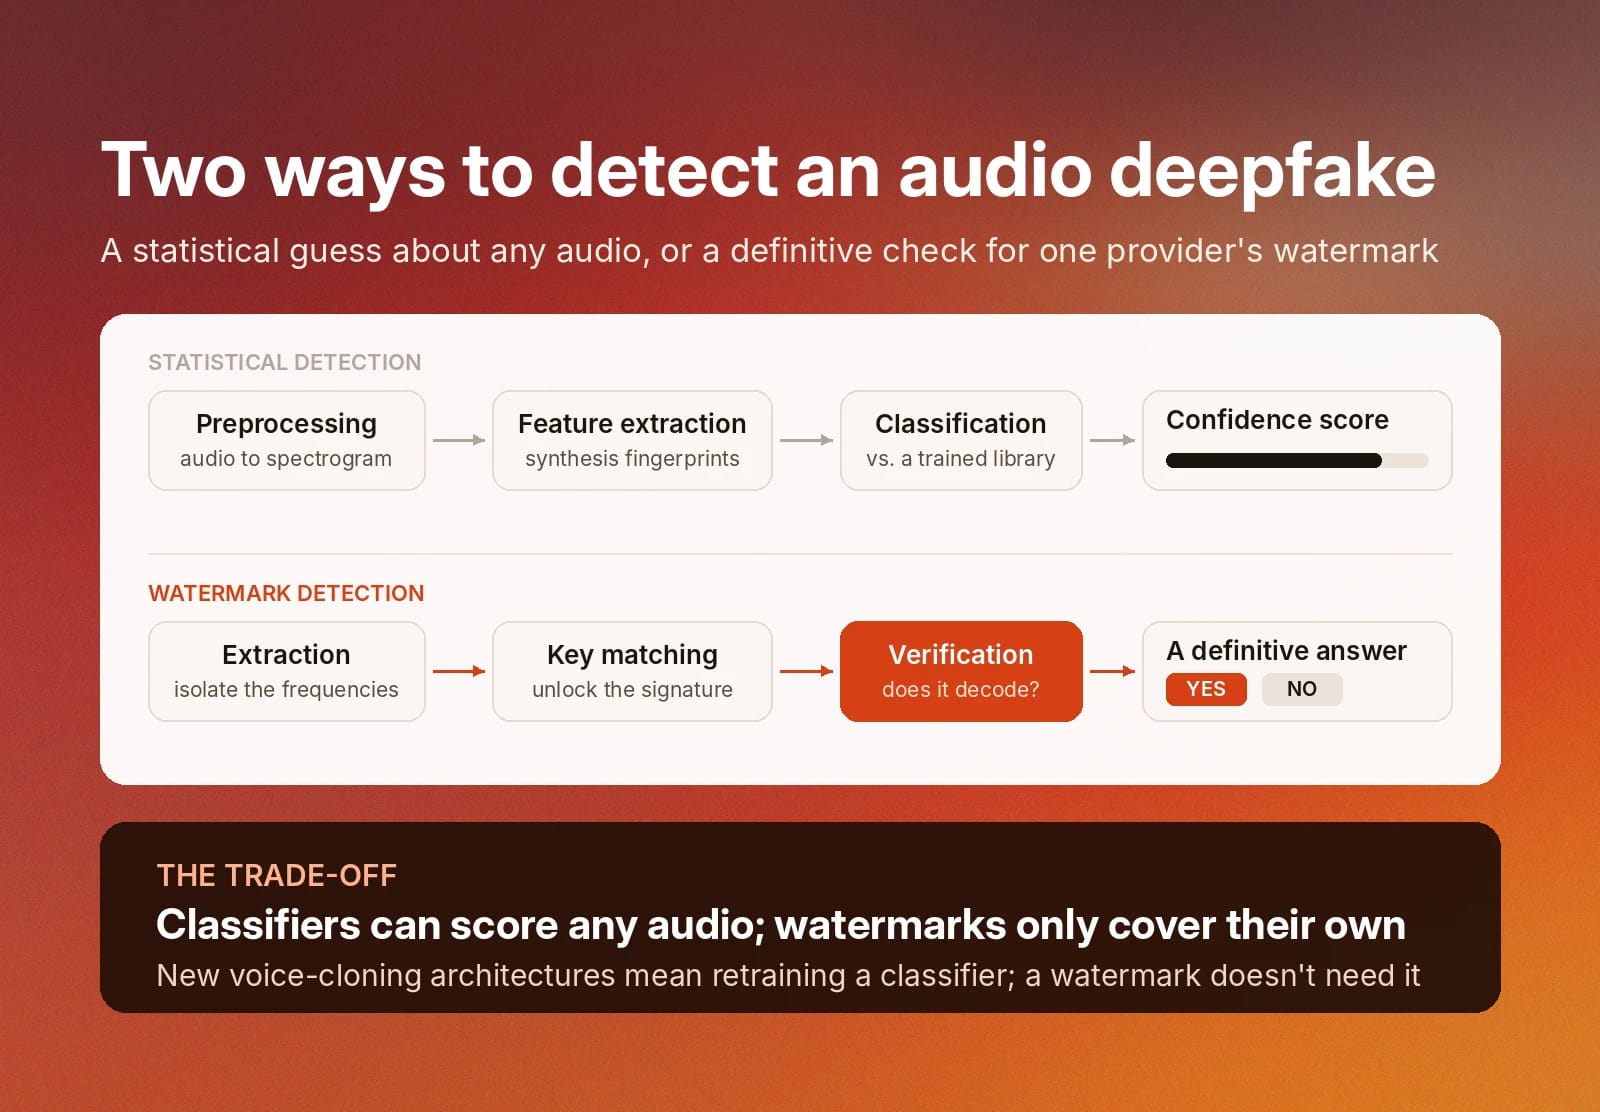
Il rilevamento convenzionale dei deepfake usa l'analisi statistica per misurare la probabilità che un contenuto sia stato generato dall'IA. Uno strumento di rilevamento utilizza tecniche di machine learning per riconoscere i pattern sottostanti in diversi tipi di parlato sintetizzato.
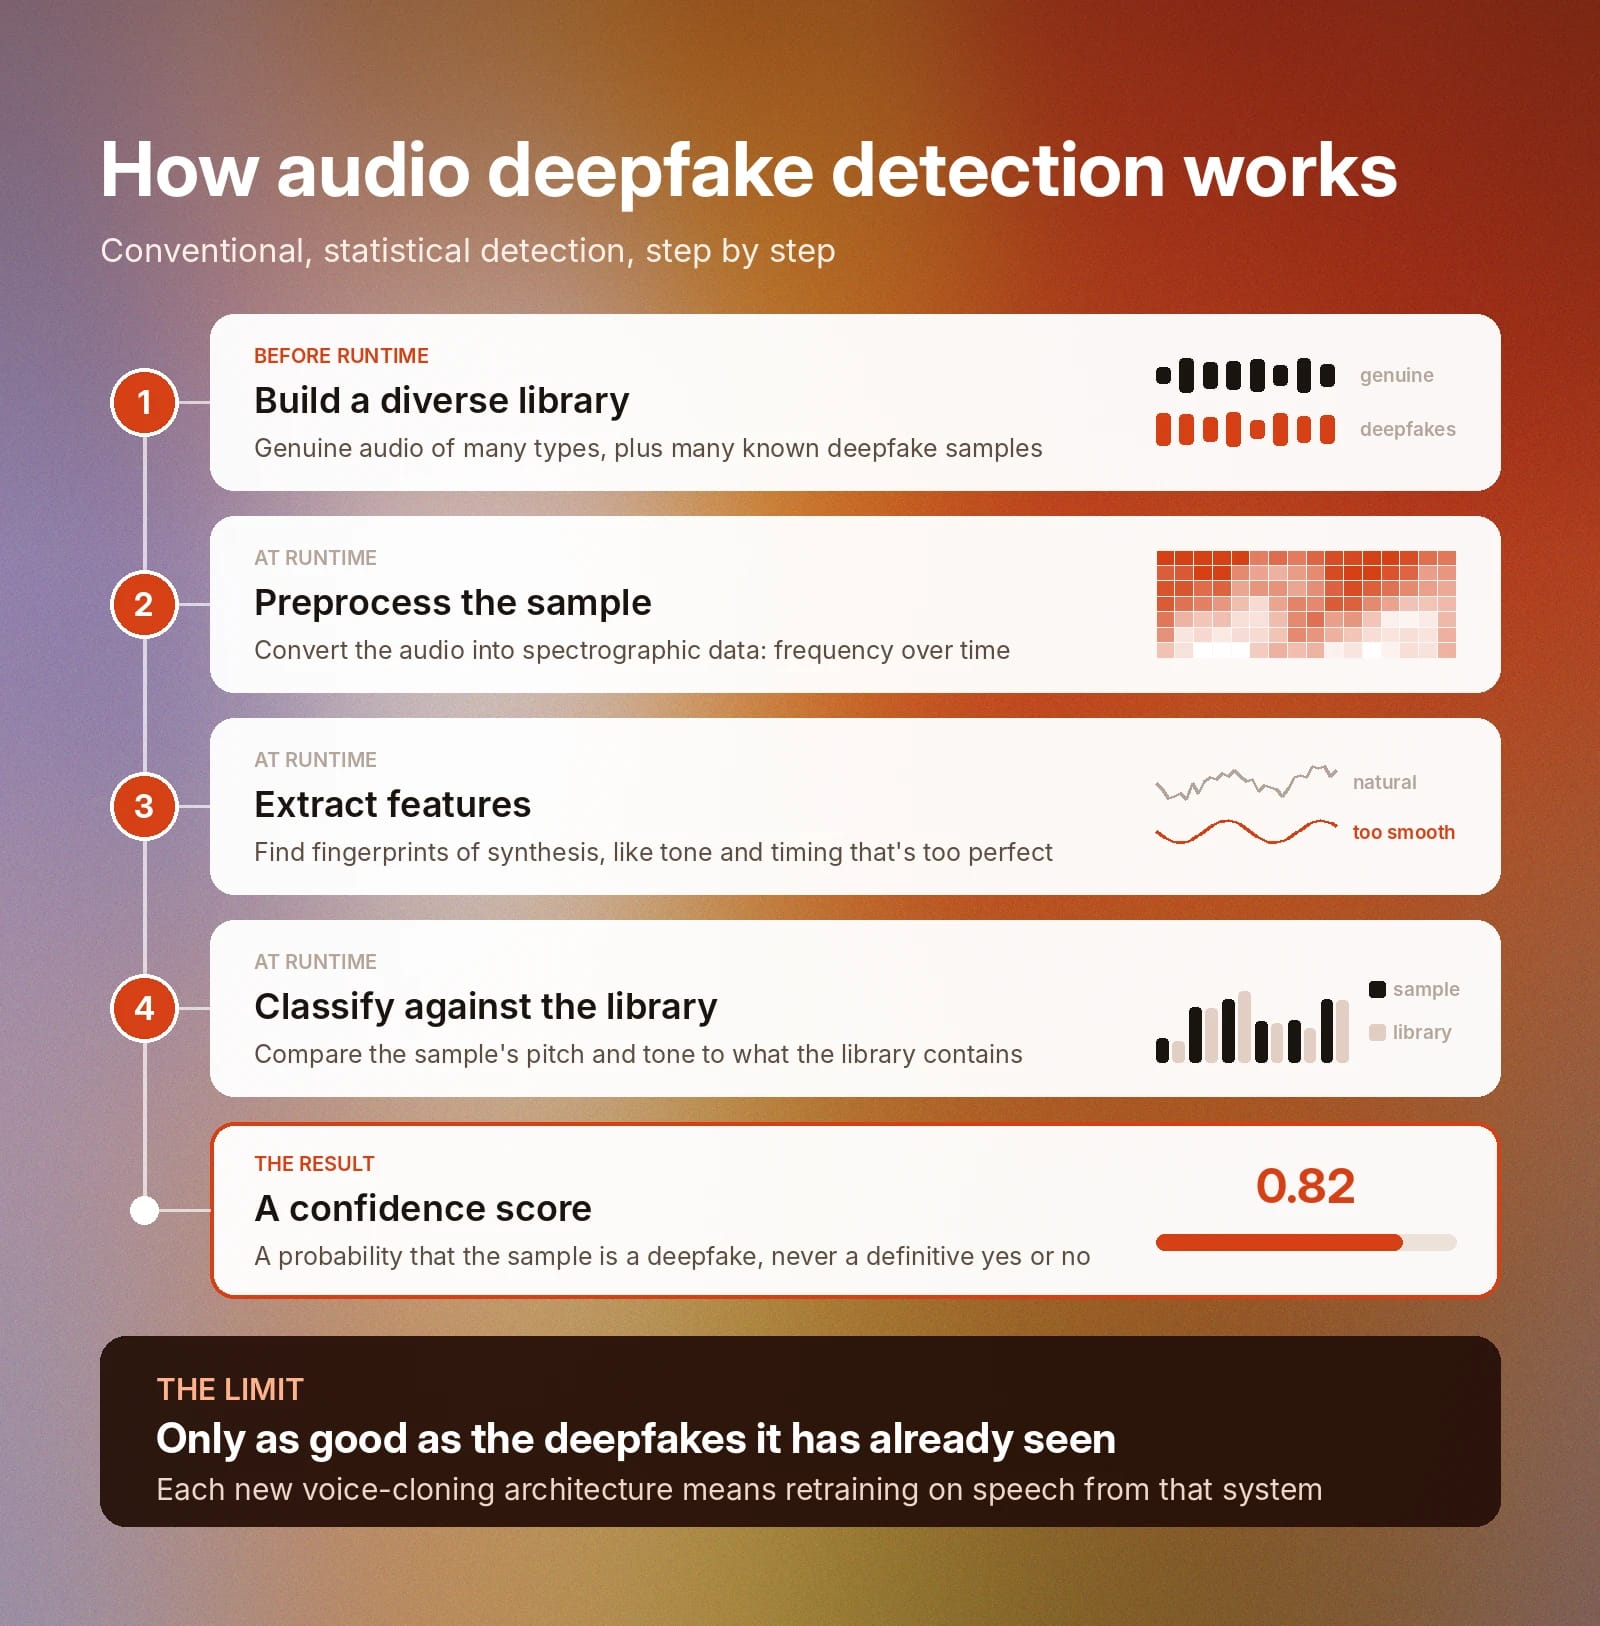
Il primo passo consiste nel creare una libreria di contenuti audio con cui confrontare i sospetti deepfake. Deve trattarsi di un set di dati diversificato, che includa campioni audio autentici di vari tipi e molti campioni di deepfake noti per contribuire a effettuare rilevamenti positivi.
In fase di runtime, segue un processo in tre fasi: pre-elaborazione, estrazione delle caratteristiche e classificazione.
Pre-elaborazione dell'audio
Quando fornisci un campione audio a uno strumento di rilevamento addestrato, lo converte in dati spettrografici, ovvero una rappresentazione matematica delle variazioni di frequenza nel tempo.
Estrazione delle caratteristiche
Successivamente, lo strumento di rilevamento estrae dai dati del campione caratteristiche simili a impronte digitali del parlato sintetizzato. Ad esempio, il parlato IA a volte è troppo perfetto e manca delle irregolarità di tono e tempistica presenti nel parlato naturale. Confrontare altezza e tono della voce con la propria libreria aiuta inoltre lo strumento a identificare altri segnali d'allarme.
Classificazione
Poiché il rilevamento convenzionale dei deepfake avviene tramite analisi statistica, non può darti una risposta definitiva, “sì” o “no”, alla domanda se un campione sia un deepfake. Genera invece un punteggio di confidenza, ovvero la probabilità che il campione sia un deepfake.
Poiché misurano le somiglianze tra un campione e una libreria audio esistente, gli strumenti convenzionali sono limitati dai campioni di deepfake noti di cui dispongono. Ogni volta che qualcuno rilascia una nuova architettura di clonazione vocale, devi riaddestrare lo strumento di rilevamento sul parlato sintetizzato con quel nuovo sistema per rilevarlo accuratamente.
Qual è la differenza tra il watermarking e il rilevamento statistico?
Watermarking è un approccio completamente diverso alla classificazione del parlato. Un classificatore di machine learning formula una stima probabilistica sull'autenticità di un campione in base a ciò che ha appreso dai dati di addestramento sul parlato naturale, ad esempio come appaiono il reale peso emotivo e l'enfasi nei dati spettrografici e quali tipi di variazioni di tono e tempistica sono naturali.
Il watermarking è deterministico. Un watermark è una firma matematica incorporata nei dati audio dal sintetizzatore a livelli non percepibili dall'orecchio umano. Un rilevatore di watermark verifica, con un sì o un no, se trova quella firma nascosta.
Un rilevatore opera in tre semplici fasi:
- Estrazione: lo strumento estrae dati spettrografici e isola le frequenze in cui prevede di trovare un watermark.
- Corrispondenza della chiave: tenta di sbloccare la firma con una chiave.
- Verifica: se il segnale viene decodificato correttamente, lo strumento conferma che il generatore di voci IA in questione ha generato l'audio.
Il processo di rilevamento dei watermark di ElevenLabs
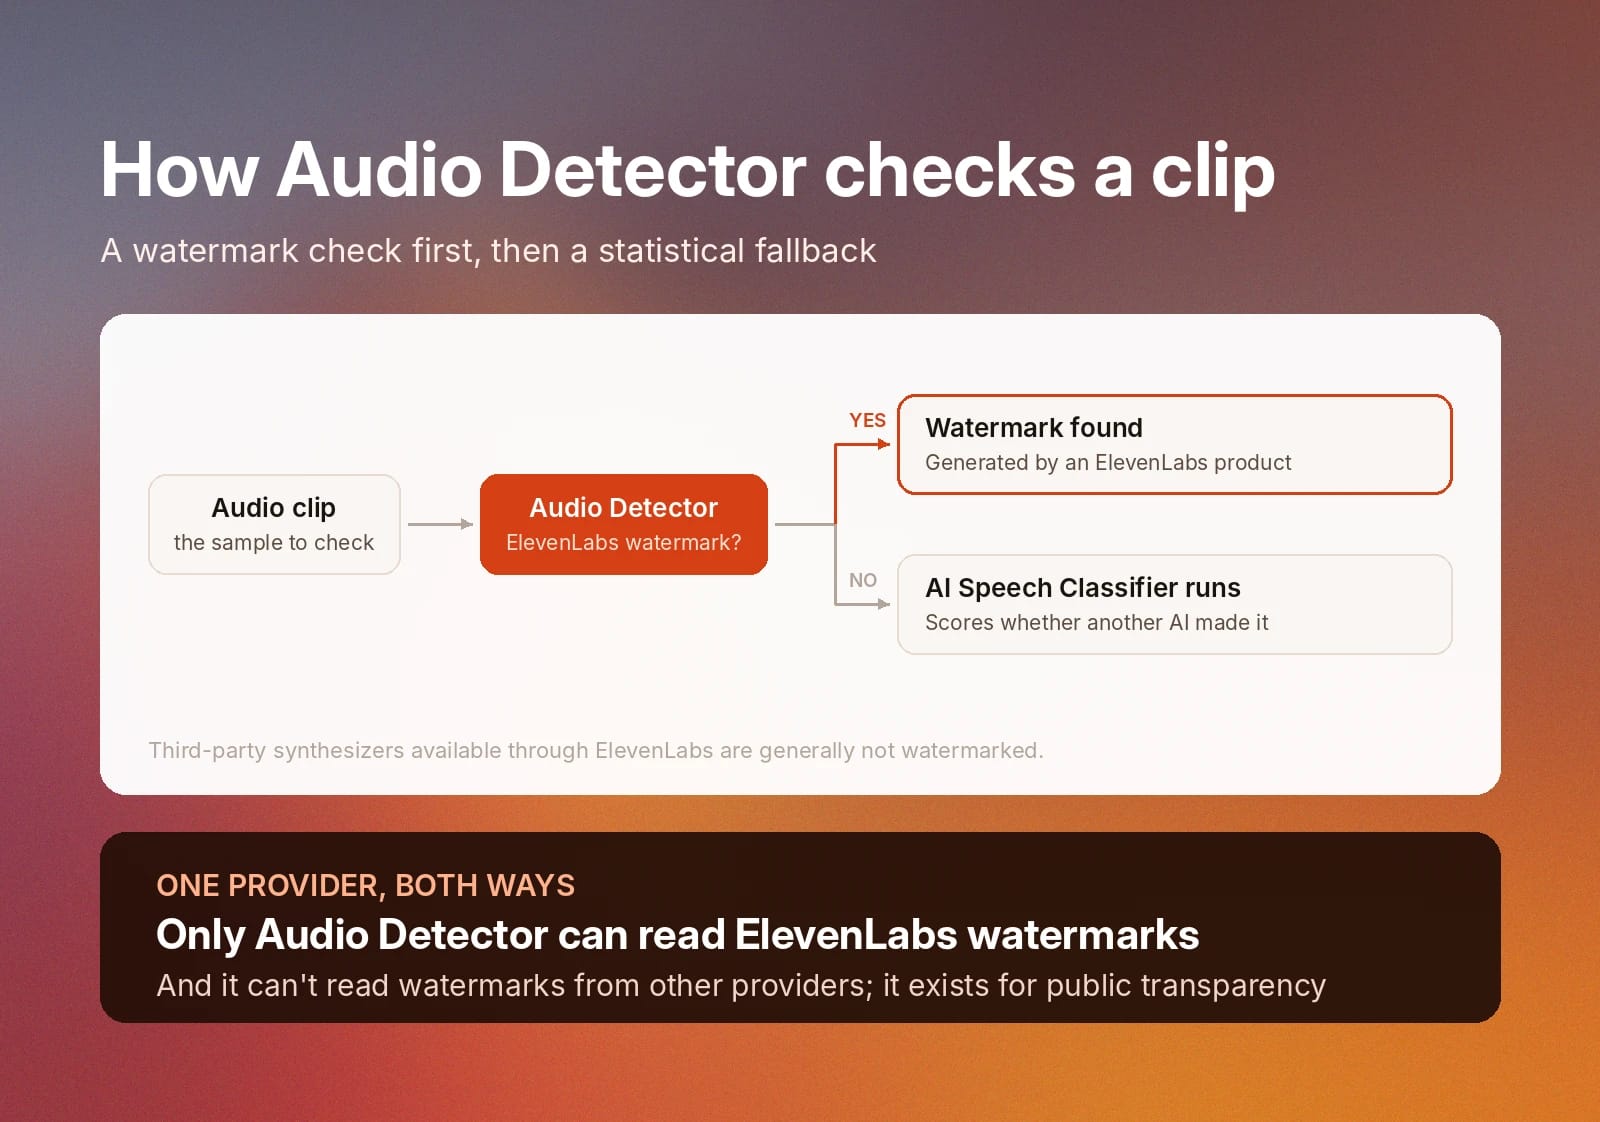
Lo strumento di watermarking di ElevenLabs è Audio Detector. Analizza i campioni audio e verifica se il contenuto è stato generato da un prodotto ElevenLabs. Se non trova un watermark, esegue quindi l'analisi statistica di AI Speech Classifier per valutare se l'audio è generato dall'IA da un'altra fonte.
Per il modo in cui funziona il watermarking, Audio Detector di ElevenLabs rileva solo audio generato da ElevenLabs. Al momento non può identificare i watermark di altri provider di voci IA.
Viceversa, solo Audio Detector di ElevenLabs può rilevare i watermark di ElevenLabs.
Tieni inoltre presente che i contenuti generati da sintetizzatori di terze parti disponibili tramite ElevenLabs generalmente non includono watermark.
Altre opzioni per rilevare l'audio generato da ElevenLabs
Il ElevenCreative AI Speech Classifier è disponibile gratuitamente e senza accesso. Analizza il primo minuto di un campione audio e fornisce un punteggio di confidenza sulla probabilità che l'audio sia stato generato da un modello ElevenLabs.
Tieni presente che non può classificare in modo affidabile l'audio di Eleven v3. È più efficace nella classificazione dell'audio generato dai precedenti modelli ElevenLabs TTS. La sua accuratezza diminuisce anche quando analizza contenuti vocali molto compressi o modificati.
Come rilevare le voci sintetiche su larga scala?
Alcuni team aziendali devono poter rilevare deepfake su larga scala e quasi in tempo reale. Prendiamo l'esempio del team del servizio clienti di una banca nazionale. I suoi rappresentanti interagiscono con migliaia di clienti al giorno. I membri del team devono condividere e aggiornare regolarmente dati riservati degli account.
La dirigenza di quel team attribuisce grande importanza alla rapidità con cui può sia identificare un chiamante fraudolento sia rispondere ai clienti legittimi. Ha bisogno di uno stack di rilevamento vocale in grado di identificare in diretta l'audio proveniente da tutti i principali motori di generazione vocale durante le chiamate dei clienti.
Creare uno stack completo di rilevamento vocale
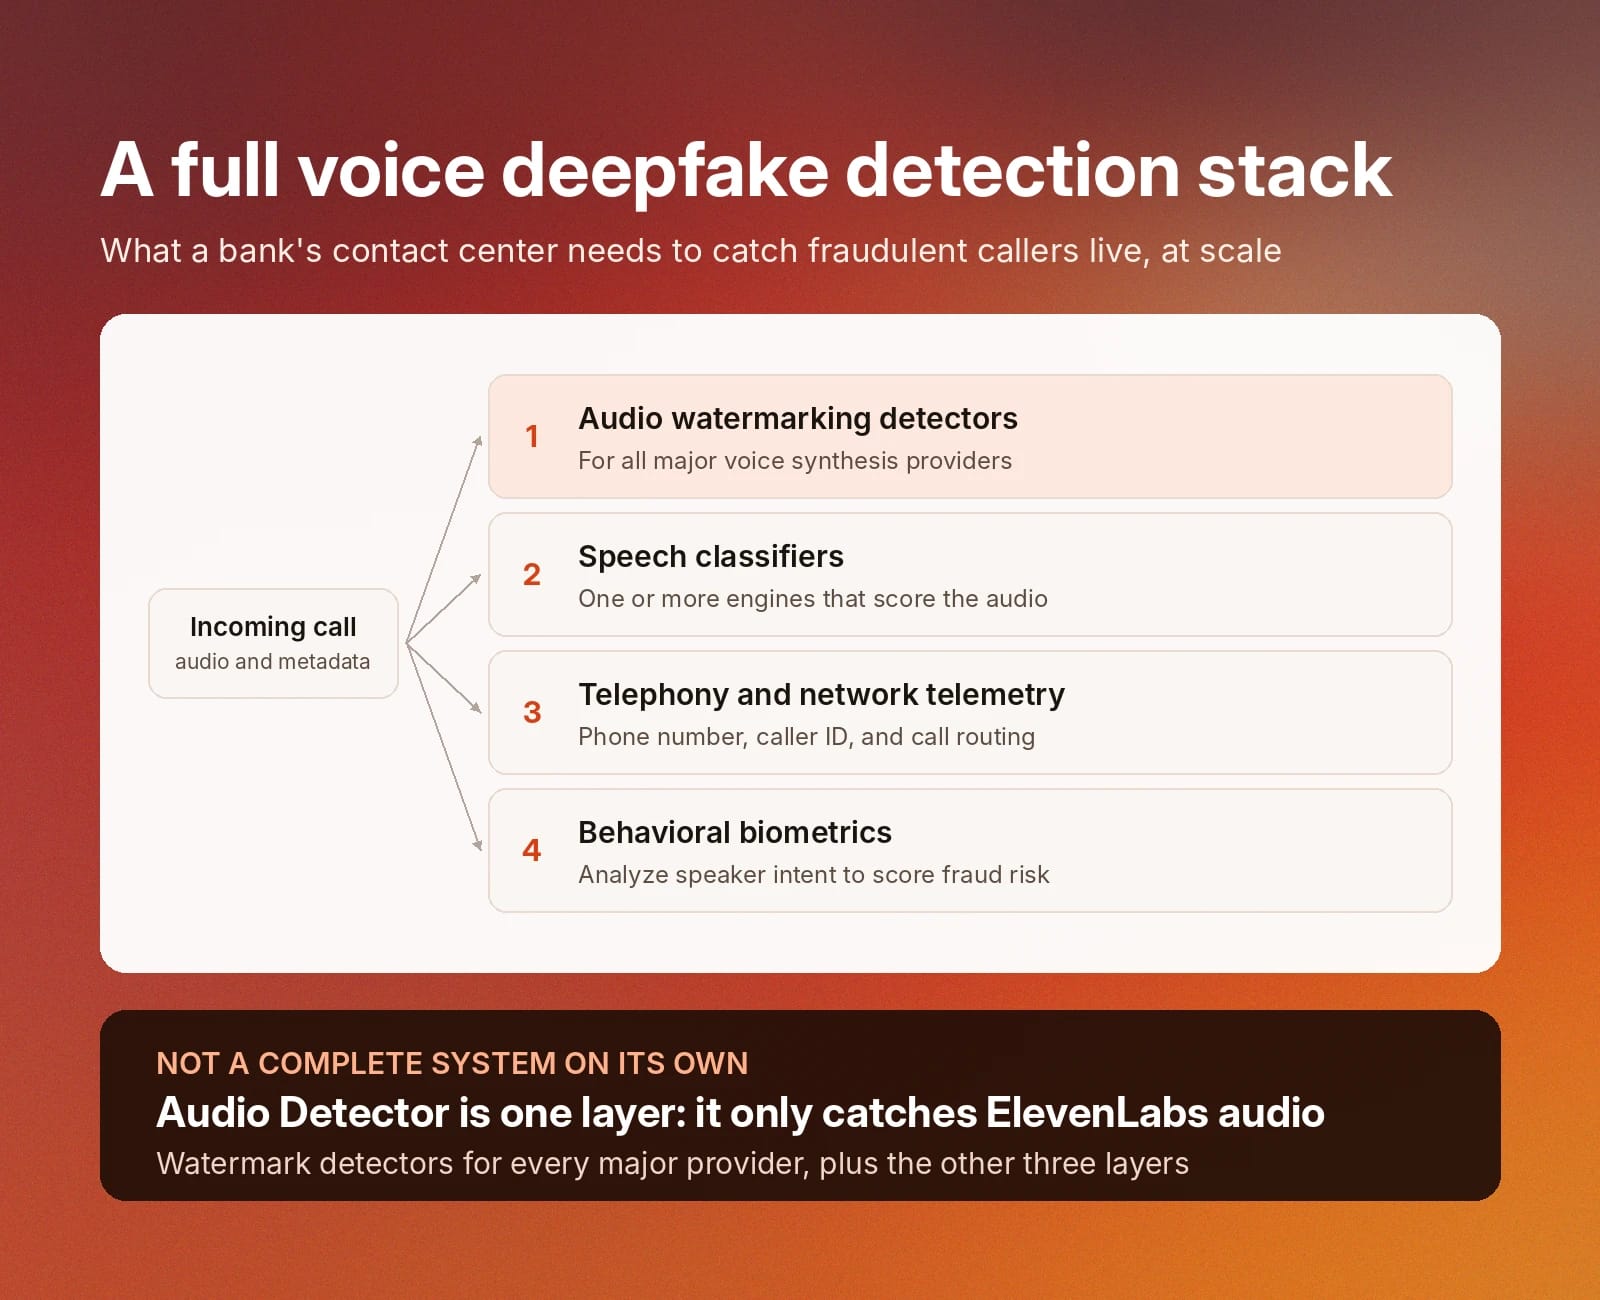
Audio Detector di ElevenLabs svolge qui un ruolo importante, ma è importante ribadire che rileva solo l'audio con watermark di ElevenLabs. Da solo non è un sistema completo di rilevamento vocale. Le organizzazioni che desiderano capacità complete di rilevamento vocale devono assemblare diversi tipi di strumenti:
- Rilevatori di watermark audio: per tutti i principali provider di sintesi vocale.
- Classificatori del parlato: uno o più motori di classificazione in grado di valutare i dati audio.
- Telemetria della telefonia e della rete: analisi dei metadati delle chiamate, come numero di telefono, ID chiamante e instradamento delle chiamate.
- Biometria comportamentale: software per analizzare l'intento del parlante e valutare il rischio di frode.
Inizia con il rilevamento dei deepfake di ElevenLabs
ElevenLabs si impegna a dare un contributo positivo alla vita pubblica, sia attraverso servizi di generazione vocale utili sia offrendo al pubblico gli strumenti necessari per identificare deepfake e altri usi dannosi dell'audio generato dall'IA.
Hai un clip audio che vuoi testare per rilevare deepfake? Registrati per provare ElevenLabs Audio Detector o inizia a usare AI Speech Classifier oggi stesso.
FAQ

Jack Limebear fa parte del team Growth e si occupa di scrivere contenuti e definire strategie per il blog e le pagine insights. Prima di arrivare in ElevenLabs, ha guidato la strategia dei contenuti per oltre dieci anni in realtà che vanno da startup SaaS in rapida crescita a grandi aziende Fortune 500. Ha conseguito un Master in Letteratura Inglese presso l’Università di Cambridge.