Scribe v2 Medical è ora disponibile per tutti
- Scritto da
- Min Kim
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
L'audio clinico è una delle prove più difficili per il riconoscimento vocale accurato. I nomi dei farmaci sono lunghi, rari e facili da confondere (idrossizina e idralazina differiscono per una sola sillaba percepita erroneamente). Il vocabolario è fitto, con dosaggi, unità di misura e termini di anatomia e patologia che possono susseguirsi rapidamente. Inoltre, la posta in gioco è più alta perché un errore di trascrizione potrebbe finire nella cartella clinica di un paziente.
Per questo oggi ElevenLabs lancia Scribe v2 Medical, il nostro modello Speech to Text ottimizzato per l'audio clinico, ora disponibile a livello generale su ElevenAPI. Nelle valutazioni riportate di seguito, ottiene costantemente uno dei tassi di errore per parola (WER) più bassi tra i modelli confrontati e riduce il WER sull'audio clinico di circa il 35% rispetto al nostro modello Scribe v2 base.
I modelli per uso generale sono ottimi per gestire il parlato quotidiano, ma possono perdere prestazioni proprio dove i workflow clinici ne hanno più bisogno. Abbiamo addestrato un fine-tuning medico di Scribe v2 incentrato sui nomi dei farmaci e sulla dettatura clinica, su benchmark pubblici riproducibili da chiunque.
Scribe v2 Medical è ottimizzato per i casi d'uso clinici
Dettatura clinica (MedDictate)
MedDictate di Corti testa la trascrizione di note cliniche dettate, che includono nomi di farmaci, dosaggi e unità di misura in rapida successione in inglese, francese e tedesco. Nella nostra valutazione, Scribe v2 Medical registra il WER complessivo più basso tra i modelli testati e un WER inferiore di circa il 35% rispetto a Scribe v2 base.
Modello
EN
FR
DE
WER complessivo
Scribe v2 Medical
3.0%
8.3%
7.2%
4.9%
OpenAI GPT Transcribe
3.9%
7.8%
9.6%
5.9%
Scribe v2 (base)
5.0%
10.7%
11.7%
7.6%
Muse Voice Transcribe 1.0
4.5%
11.0%
13.3%
7.8%
Deepgram Nova-3 Medical*
5.5%
-
-
-
*Solo inglese (24 clip) - Deepgram Nova-3 Medical non supporta il francese né il tedesco.
Terminologia medica (MedTerm)
MedTerm è un dataset pubblicato anch'esso da Corti e include un benchmark di terminologia clinica di 600 campioni nelle stesse tre lingue, con i termini medici annotati in ogni campione. Questa annotazione consente di valutare i modelli su due dimensioni oltre al WER dell'intera trascrizione. Il richiamo dei termini è la percentuale di termini medici annotati che compaiono correttamente nella trascrizione (più alto è meglio). Il Term-WER è il tasso di errore calcolato solo su questi termini, ignorando il parlato ordinario circostante (più basso è meglio).
Scribe v2 Medical supera ogni modello testato in entrambe le dimensioni e ogni altro fornitore in tutte e tre le lingue:
Modello
Richiamo dei termini ↑
WER dei termini ↓
Scribe v2 Medical
77.7%
10.4%
Scribe v2 (base)
77.1%
10.7%
OpenAI GPT Transcribe
74.0%
12.3%
Muse Voice Transcribe 1.0
73.4%
12.9%
Deepgram Nova-3 Medical*
72.5%
13.6%
Benchmark Eka Medical ASR
Il benchmark Eka Medical ASR contiene 3.619 campioni di audio clinico in inglese — inclusi nomi isolati di farmaci e patologie, frasi cliniche e conversazioni tra medici e pazienti — con annotazioni per termine e una classifica pubblicata nella scheda del dataset.
Poiché il dataset pubblicato include modelli meno recenti come Gemini 2.5 Flash e GPT-4o, abbiamo eseguito la valutazione su modelli più recenti. SemWER (WER semantico) valuta se il modello ha riconosciuto il contenuto corretto, indipendentemente dalla formattazione ("mg" e "milligrammi" sono considerati la stessa risposta), mentre kwWER (WER delle parole chiave) applica lo stesso punteggio solo alle parole chiave mediche annotate.
Modello
semWER
kwWER
Scribe v2 Medical
6.50%
6.02%
Scribe v2 (base)
7.35%
7.04%
Deepgram Nova-3 Medical
7.79%
7.65%
Muse Voice Transcribe 1.0
8.85%
8.99%
OpenAI GPT Transcribe
13.90%
13.20%
Eka annota i termini medici in ogni campione, rendendo possibile valutare in modo più granulare i miglioramenti di Scribe v2 Medical rispetto al modello base, considerando solo i termini medici. Scribe v2 Medical commette il 15% di errori in meno rispetto al modello base (9,5% contro 11,1%) e i miglioramenti sono maggiori quando i termini compaiono in frasi cliniche complete (7,5% contro 9,9%).
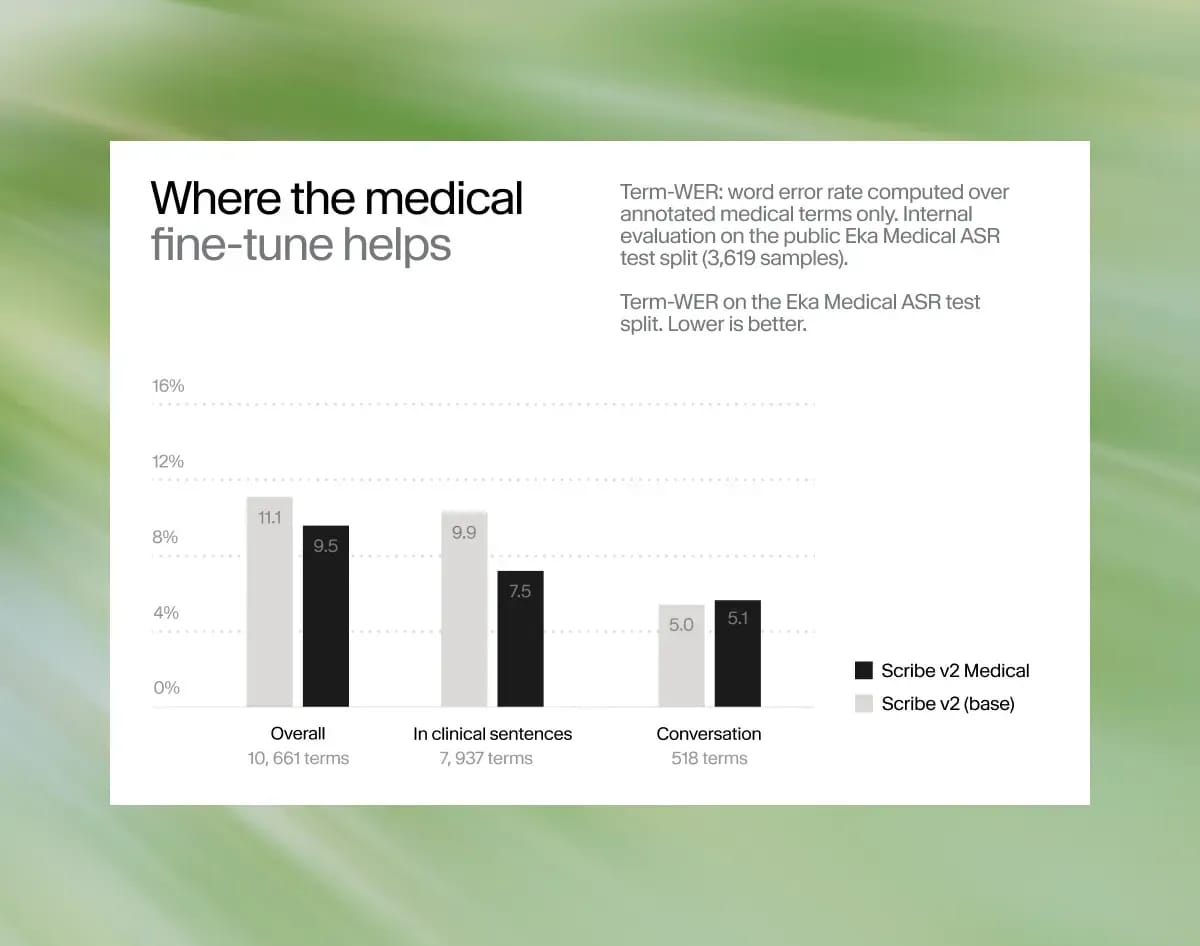
Un aspetto da notare, emerso dagli stessi dati, è che i clip isolati di una sola parola (il nome di un farmaco pronunciato senza contesto) restano il caso più difficile per ogni modello in classifica, incluso Scribe v2 Medical. Ha ottenuto un WER del 14,3% sui termini isolati, rispetto al 7,5% quando tali termini compaiono in frasi. Senza alcun contesto, una sillaba percepita erroneamente può produrre errori memorabili:
- etodolac (un FANS) → "It'll do the luck"
- levomilnacipran (un antidepressivo) → "Leave me alone now, Sephora."
- methdilazine (un antistaminico) → "Let's play our scene."
Un modo per ridurre questi errori è usare il prompting per termini chiave, che ti consente di evidenziare nomi di farmaci o frasi mediche per indirizzare il modello verso una trascrizione corretta.
Clienti in produzione
I clienti stanno già usando Scribe v2 Medical in produzione e riscontrano miglioramenti nell'audio clinico.
"Da quando siamo passati da Deepgram a ElevenLabs Scribe v2 Medical, riscontriamo un'accuratezza molto più elevata nella terminologia clinica, e questo ha cambiato il modo in cui lavora il team", ha dichiarato Mendel Erlenwein, CEO e fondatore di CareCo. "Quando i nostri coordinatori si fidano delle trascrizioni, possono dedicare meno tempo a correggere le note e più tempo al telefono con i pazienti. I nostri pazienti seguono terapie complesse, e la nota letta dal team di assistenza deve essere corretta."
Prestazioni elevate sul parlato generale
Il team ha inoltre verificato che il fine-tuning medico non riduce le prestazioni in altri ambiti. Su 6.000 campioni di parlato quotidiano non medico derivati da Common Voice, Scribe v2 Medical ottiene, con l'arrotondamento, lo stesso punteggio di Scribe v2 base: un WER del 5,3% in entrambi i casi. Con v2 Medical, quindi, ottieni i vantaggi di un modello medico specializzato senza rinunciare all'accuratezza in questo benchmark.
Progettato per le informazioni sanitarie protette
Scribe v2 Medical è idoneo per HIPAA per i clienti enterprise con Business Associate Agreement in vigore e Modalità Zero Retention (ZRM) abilitata.
Con ZRM abilitata per le richieste alla API Speech to Text, l'input audio e l'output di testo vengono eliminati immediatamente al termine di ogni richiesta. ElevenLabs non conserva nessuno dei due e la tua applicazione riceve la risposta API completa e controlla la modalità di conservazione delle trascrizioni.
Come iniziare
Scribe v2 Medical è disponibile sulla API Speech to Text. Ti basta passare il nuovo ID del modello: scribe_v2_medical
Il modello funziona sull'endpoint batch Speech to Text.