
Cos'è il rilevamento dell'attività vocale e come funziona?
- Scritto da
- Jack Limebear
- Pubblicato
AscoltaAscolta questo articolo
Il rilevamento dell'attività vocale classifica se brevi frame audio, della durata di millisecondi, contengono parlato umano. Viene utilizzato in molte applicazioni di elaborazione audio digitale, tra cui trascrizione, telefonia e agenti vocali.
In questo articolo esploreremo cosa fa il rilevamento dell'attività vocale, cosa non fa e come si inserisce nelle principali applicazioni aziendali.
In sintesi
- Il rilevamento dell'attività vocale (VAD) è un componente fondamentale dei moderni workflow audio. Analizza continuamente un flusso audio e determina, con un sì o un no, se ogni frame audio della durata di millisecondi contiene parlato umano.
- Il VAD indica agli strumenti audio a valle quando attivarsi e quando restare in attesa. Viene usato da LLM, servizi di trascrizione e altre pipeline audio aziendali.
- Gli algoritmi di rilevamento dell'attività vocale operano in un ciclo continuo di cinque fasi: acquisizione dell'audio, suddivisione in frame, estrazione delle caratteristiche vocali, valutazione della probabilità che contenga parlato e invio di una decisione ai servizi a valle.
- In origine il VAD si basava sull'elaborazione matematica dei segnali per stabilire con un sì o un no la presenza di parlato. I moderni sistemi basati sull'IA usano reti neurali per svolgere la stessa funzione, ma con una migliore comprensione contestuale del rumore di fondo e degli indizi semantici.
- I sistemi VAD classificano soltanto se un frame audio contiene parlato. Non indicano quando una persona ha finito di parlare. I sistemi di endpointing usano il VAD e altri strumenti di analisi euristica per decidere se chi parla ha concluso il proprio pensiero.
- In ambito aziendale, il VAD aiuta gli agenti vocali a conversare in modo naturale con i clienti senza interromperli, ottimizza l'utilizzo della larghezza di banda VoIP, riduce i costi della trascrizione IA speech to text (STT) e offre altri casi d'uso.
- Testa i sistemi VAD in condizioni reali. Le registrazioni perfette in studio non sono un metodo efficace per determinarne le capacità.
Cos'è il rilevamento dell'attività vocale (VAD)?
Il rilevamento dell'attività vocale (VAD) è un processo software che classifica se piccoli segmenti di audio, chiamati frame, contengono parlato. Gli algoritmi VAD vengono eseguiti da decine a centinaia di volte al secondo su un flusso audio e restituiscono una risposta binaria, “sì” o “no”, sulla presenza di parlato.
Vengono utilizzati in pipeline audio digitali più ampie, come le telecomunicazioni o la trascrizione vocale. Indicano ad altri sistemi a valle, come ASR/STT, LLM e pianificatori dei turni, se ascoltare attivamente il flusso audio o restare in attesa.
Il VAD non coincide con il Riconoscimento Automatico del Parlato (ASR). Un sistema VAD si limita a restituire una risposta probabilistica, sì o no, sulla rilevazione del parlato. Non restituisce parole effettive. La sua funzione principale è indicare ai sistemi a valle se elaborare un determinato frame audio.
Come funzionano gli algoritmi di rilevamento dell'attività vocale?
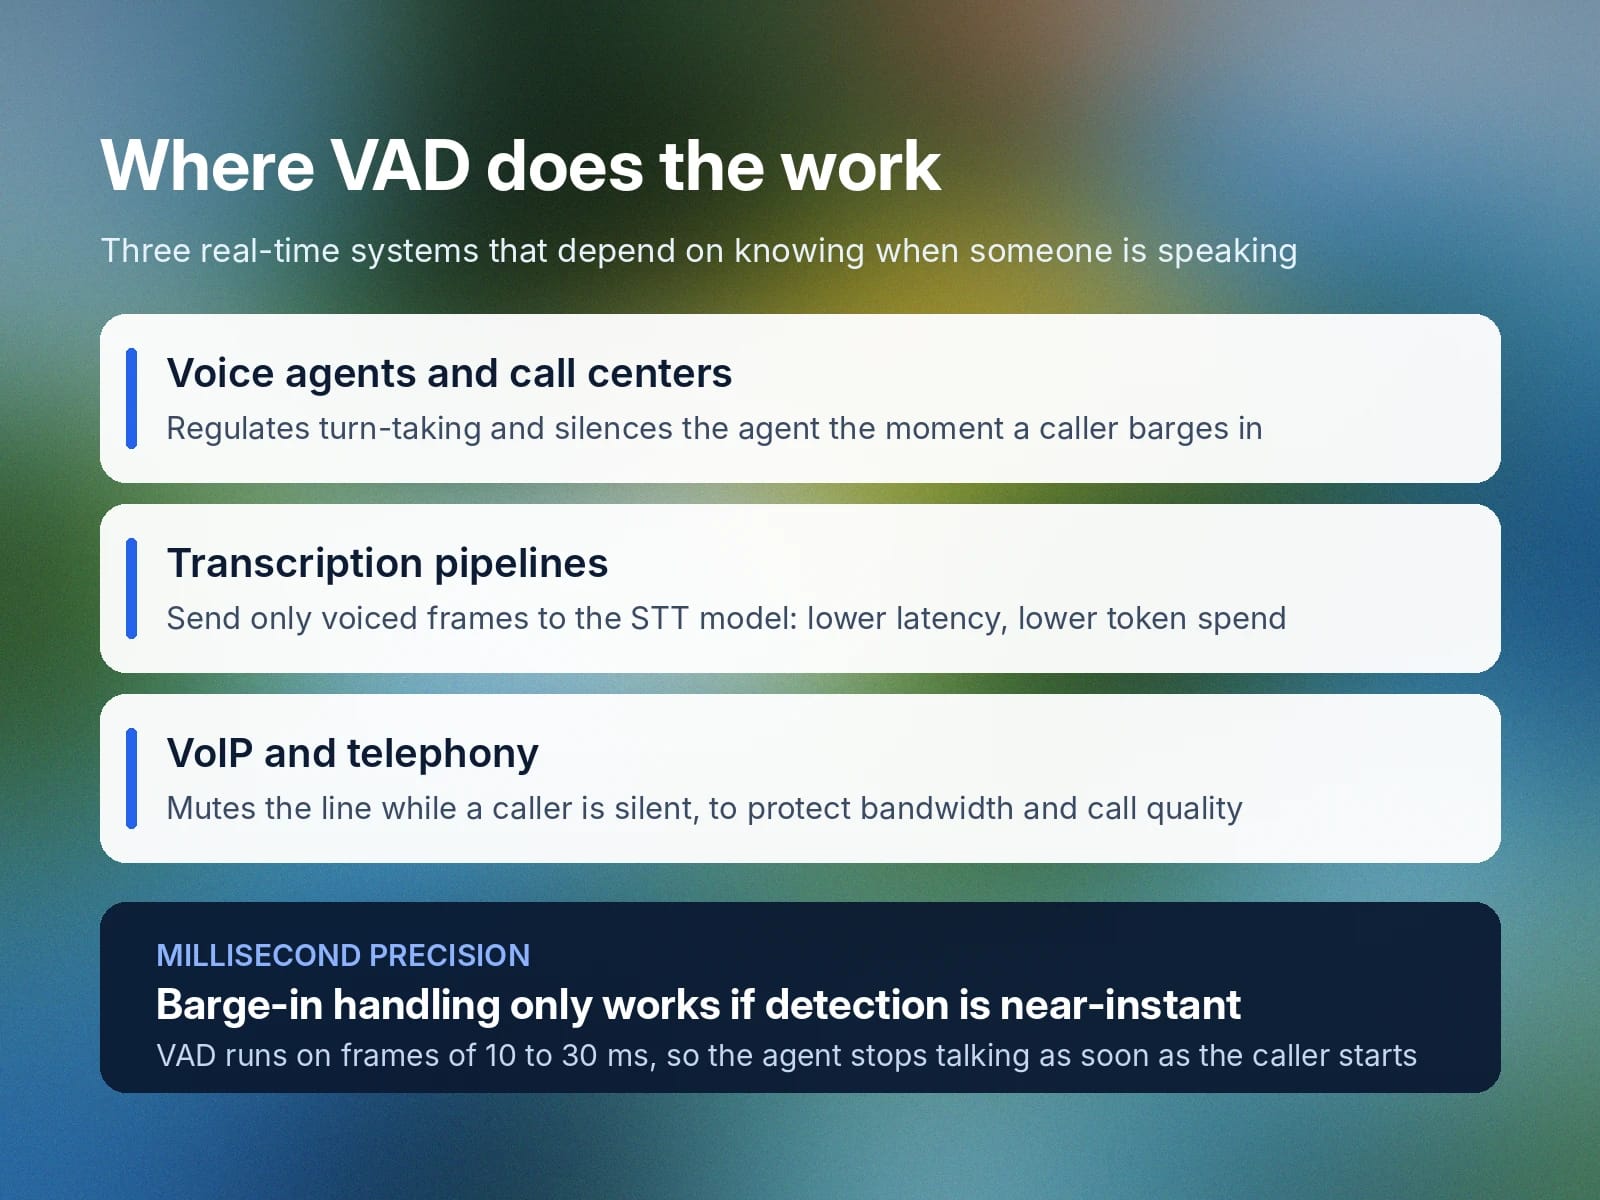
Un algoritmo VAD opera su un flusso audio e decide con un sì o un no se un determinato frame audio, in genere di 10-30 millisecondi, contiene parlato.
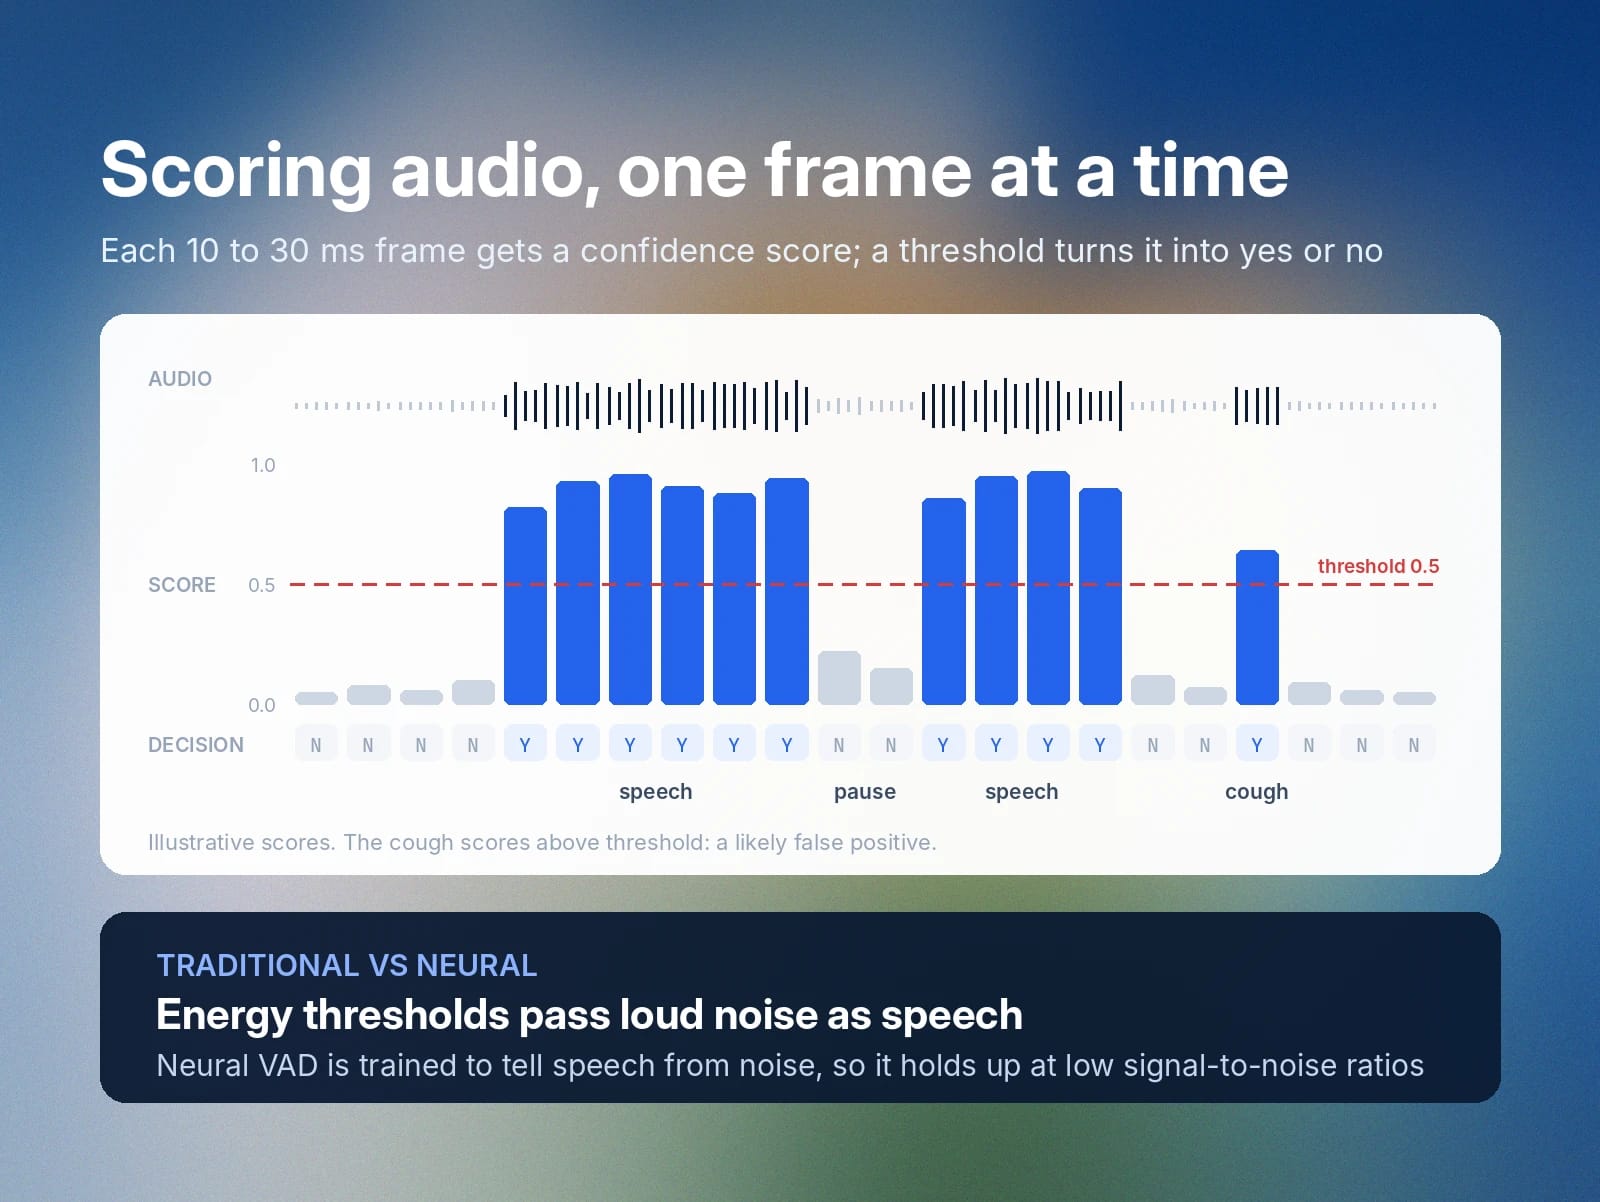
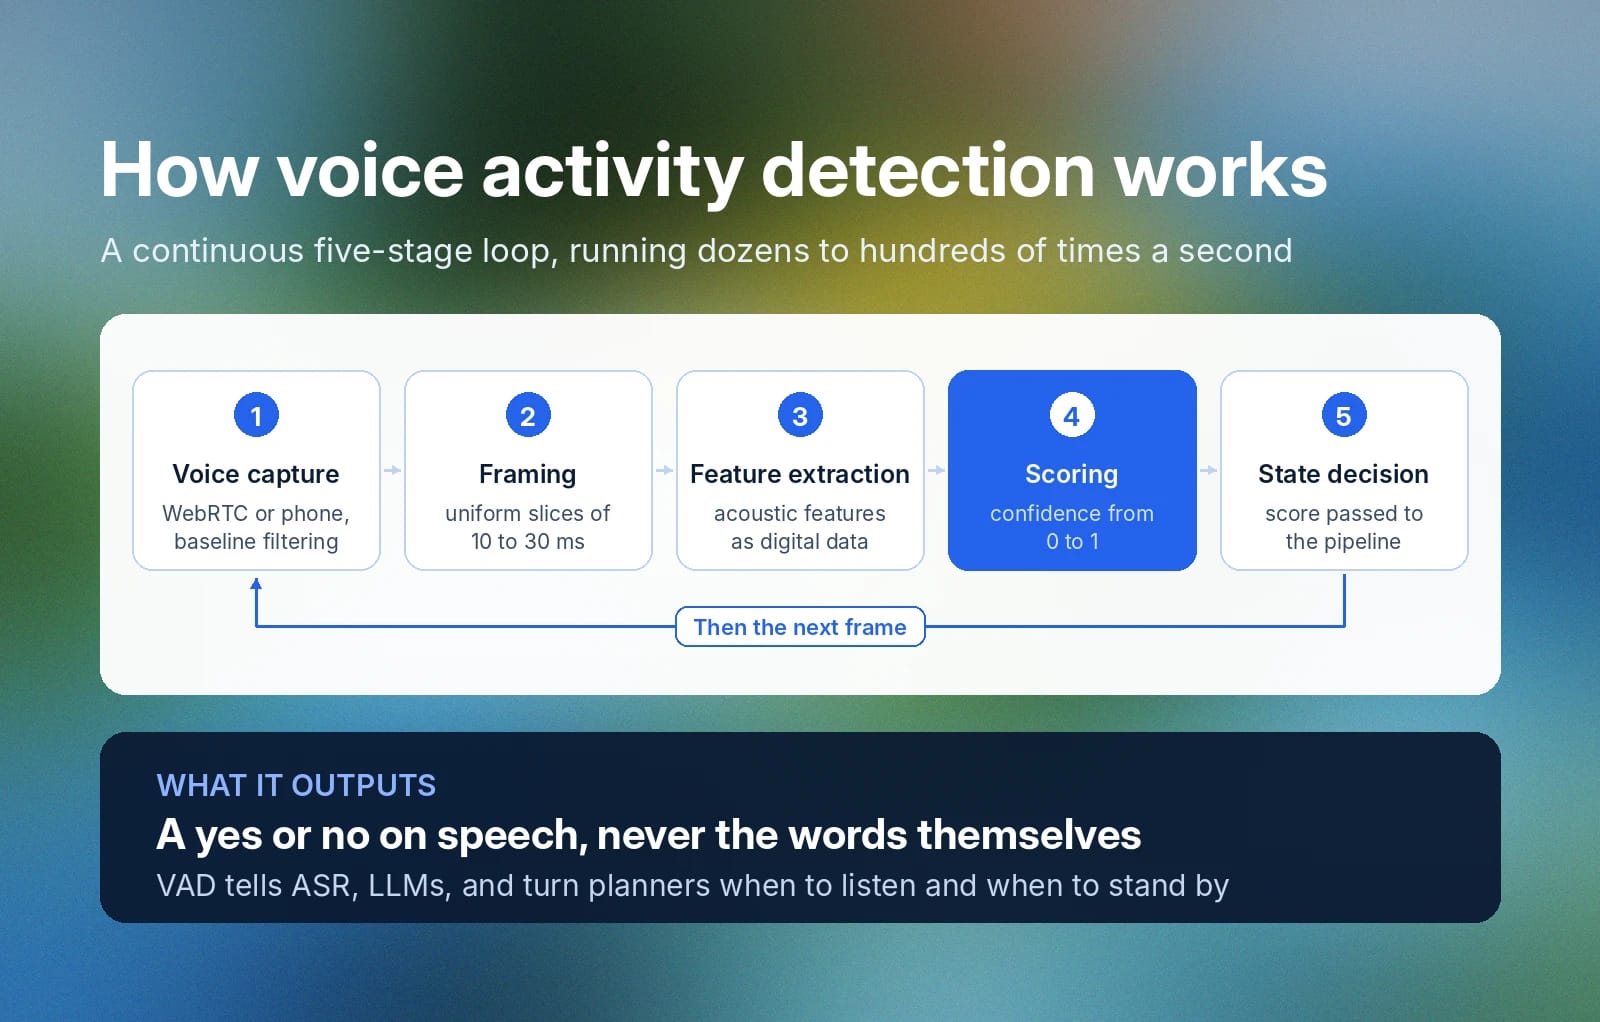
Operano continuamente in un ciclo di cinque fasi:
- Acquisizione vocale: il sistema che esegue il VAD riceve un flusso audio tramite WebRTC o telefonia e applica ai dati un filtro antirumore di base.
- Suddivisione in frame: l'algoritmo divide il flusso audio grezzo in frame uniformi.
- Estrazione delle caratteristiche: l'algoritmo estrae dal flusso caratteristiche acustiche che può rappresentare matematicamente come dati digitali.
- Valutazione: il sistema elabora le caratteristiche estratte di un frame tramite l'algoritmo VAD per generare un punteggio di confidenza tra 0 e 1 (0 = “nessun parlato” e 1 = “parlato”) sulla probabilità che contenga parlato.
- Decisione sullo stato: il sistema VAD passa il punteggio di confidenza alla pipeline audio in cui opera, affinché possa decidere come gestirlo.
Rilevamento dell'attività vocale tradizionale e basato sull'IA
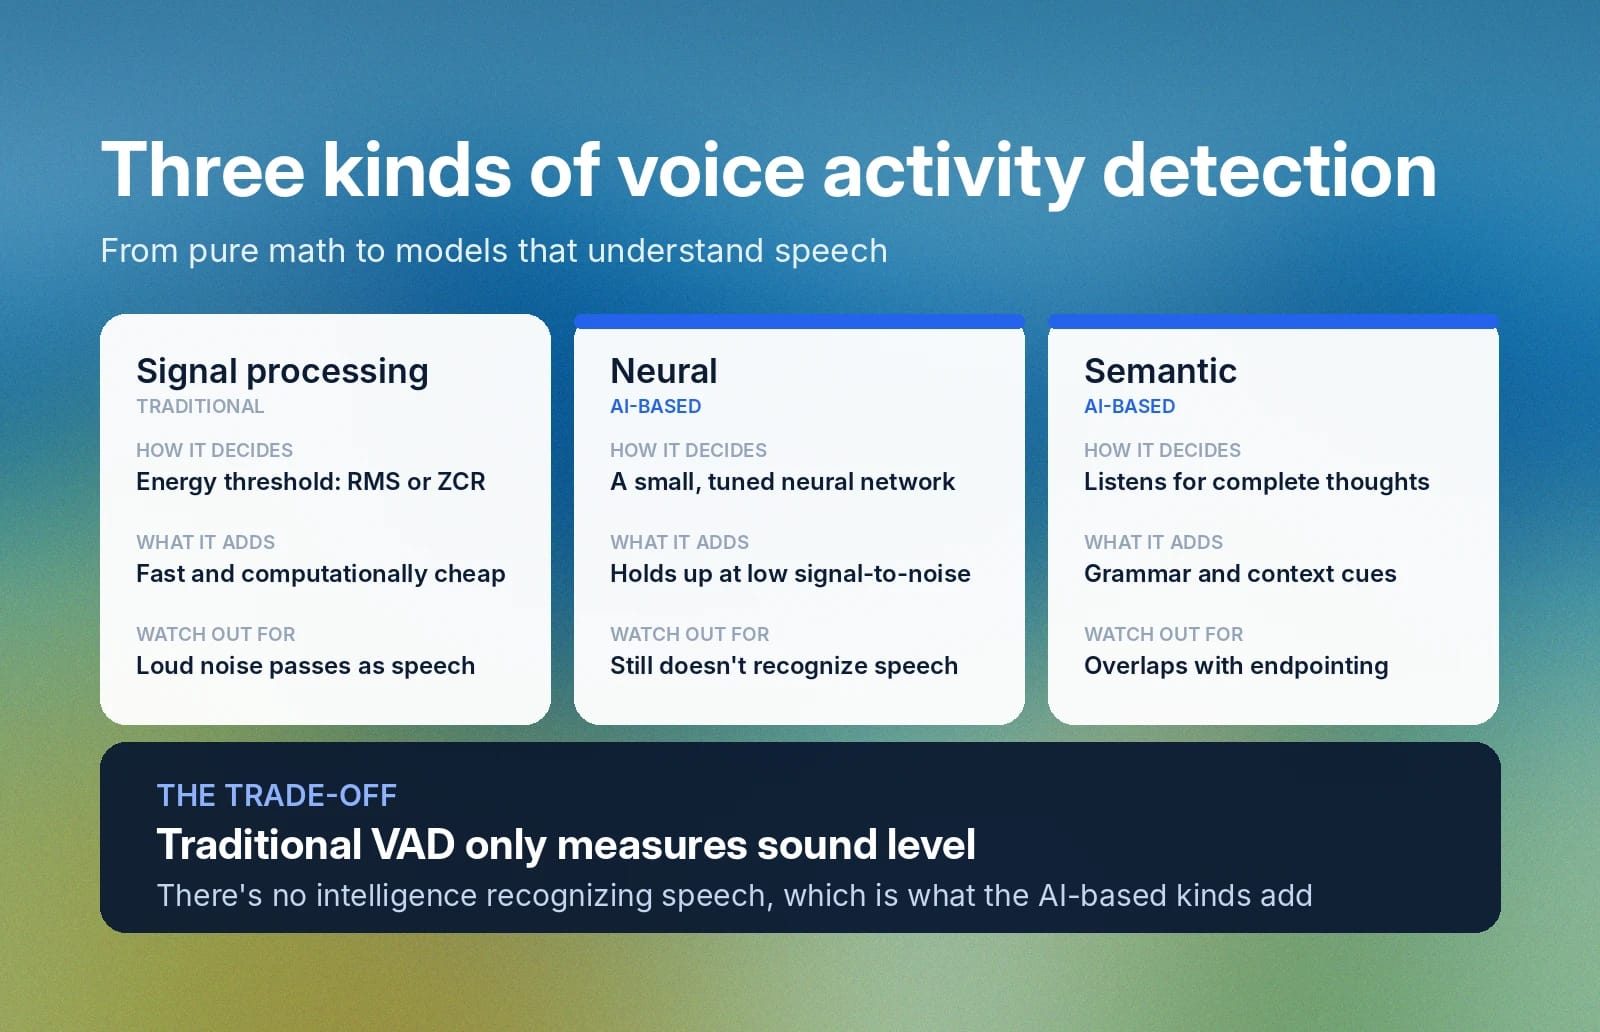
Il VAD rientra in due grandi categorie: elaborazione dei segnali e IA.
All'interno del VAD basato sull'IA esistono due approcci distinti, per un totale di tre tipi di rilevamento dell'attività vocale.
Vediamoli più nel dettaglio.
VAD tradizionale (elaborazione dei segnali)
La tecnologia VAD tradizionale misura il livello energetico di un flusso audio e conferma la presenza di parlato se supera una certa soglia. Si basa esclusivamente sulla matematica, spesso su un calcolo della radice quadratica media (RMS) o del tasso di attraversamento dello zero (ZCR). Se un frame misura un valore superiore alla soglia, viene considerato parlato. Al di sotto della soglia, no.
Il VAD tradizionale è veloce e poco oneroso dal punto di vista computazionale, ma misura soltanto il livello sonoro dell'audio. Un forte rumore di fondo può causare falsi positivi. Non c'è alcuna intelligenza che riconosca davvero il parlato.
VAD basato sull'IA
Esistono due tipi più recenti di VAD basato sull'IA: neurale e semantico. Invece di usare una soglia puramente matematica, il VAD neurale usa una piccola rete neurale altamente ottimizzata per stabilire se un frame audio contiene parlato o silenzio. L'addestramento permette a questi sistemi di capire la differenza tra parlato e rumore, quindi offrono prestazioni migliori del VAD tradizionale quando un flusso audio presenta un basso rapporto segnale-rumore (SNR), ovvero un rumore di fondo significativo.
Lo svantaggio del VAD neurale è che non riconosce ancora il parlato stesso. Il VAD semantico basato sull'IA è una variante diversa che invece lo fa. Si sovrappone all'endpointing perché ascolta un feed audio per valutare la completezza dei pensieri espressi. Può capire grammaticalmente e contestualmente se potrebbe seguire altro parlato.
VAD e endpointing
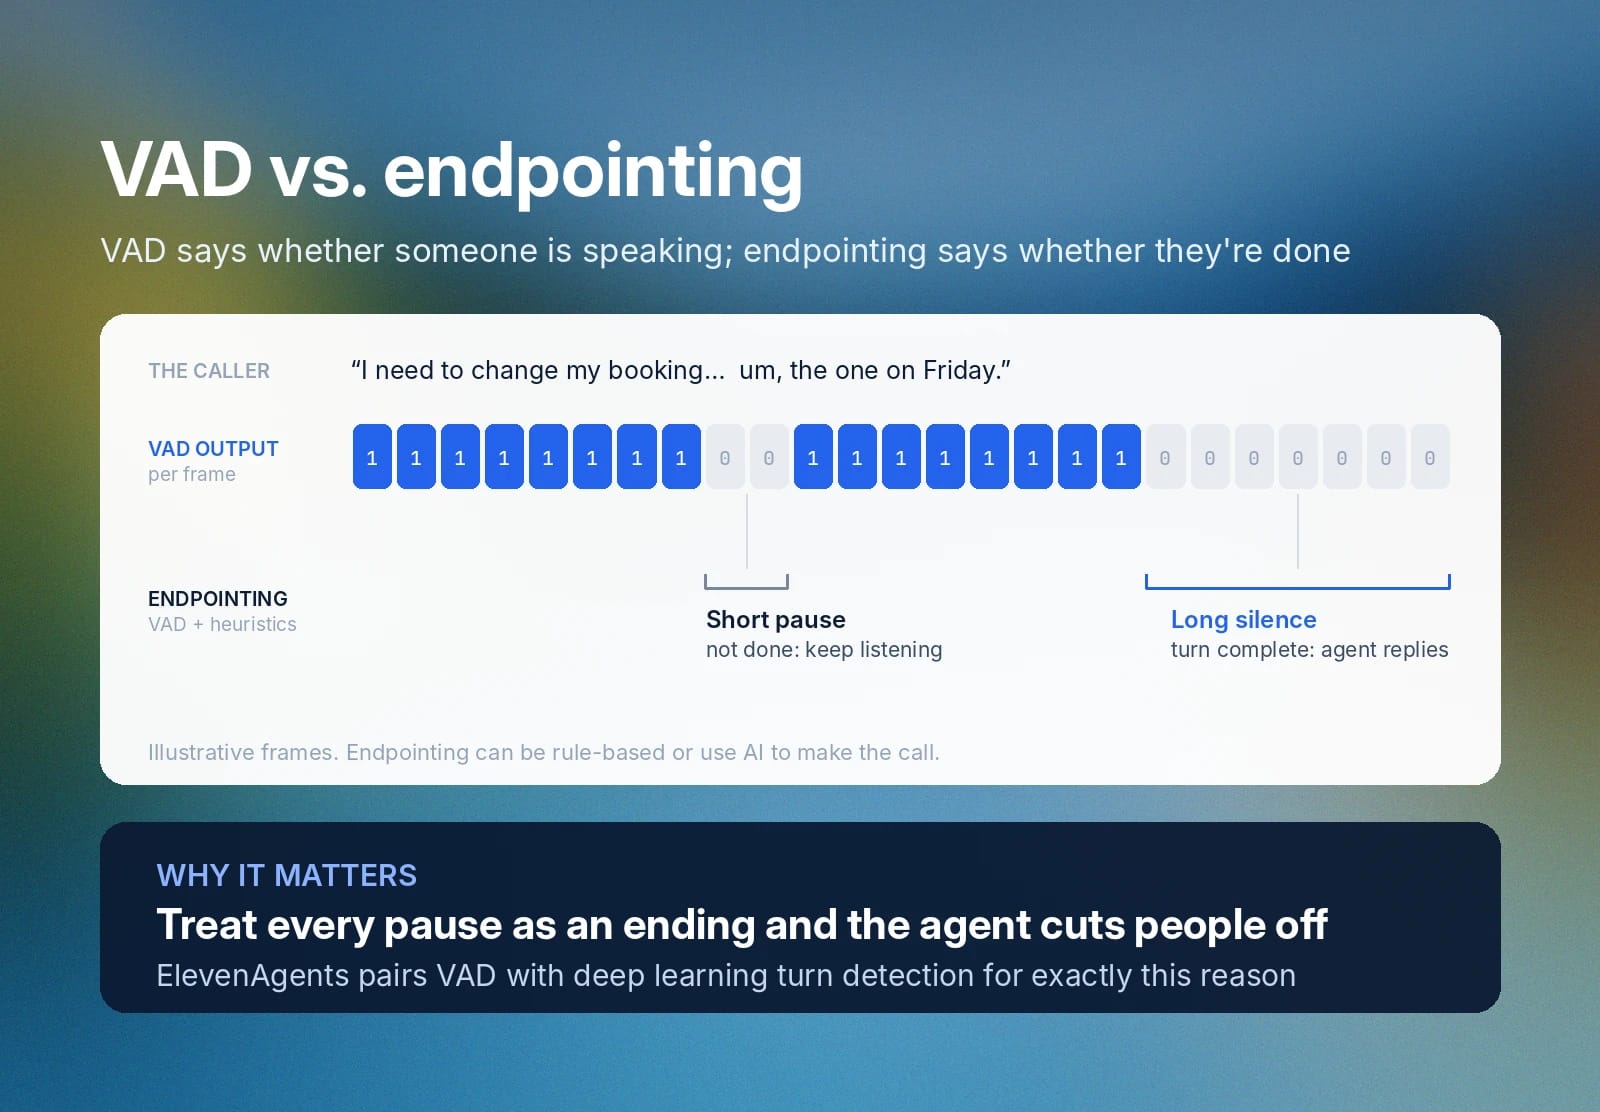
VAD ed endpointing sono tecnologie complementari. Un sistema di rilevamento dell'attività vocale decide semplicemente se qualcuno sta parlando in ogni frame audio che elabora. Prende una decisione binaria, sì o no, e la passa al resto della pipeline di elaborazione audio.
Un sistema di endpointing usa l'output del VAD, combinato con l'analisi euristica, per stabilire se chi parla ha concluso il proprio pensiero. Può usare l'elaborazione dei segnali basata su regole oppure l'IA per prendere questa decisione.
Applicazioni del rilevamento dell'attività vocale nell'IA in tempo reale
Il rilevamento dell'attività vocale è importante in diversi casi d'uso.
Agenti vocali autonomi e call center
Un agente autonomo che gestisce le chiamate dei clienti deve sapere quando è opportuno rispondere. Non vuoi che l'agente interrompa un cliente a metà frase o continui a parlare sopra di lui quando risponde in anticipo. Il VAD aiuta a regolare l'alternanza dei turni di conversazione e a mantenere un flusso naturale nell'interazione. Poiché opera fino al millisecondo, è molto efficace anche nella gestione delle interruzioni del cliente, silenziando l'agente quando il cliente lo interrompe.
Pipeline di trascrizione
Se utilizzi un Speech to Text servizio API di trascrizione, come ElevenAPI, puoi filtrare l'audio che gli invii tramite il rilevamento dell'attività vocale, così il modello elabora soltanto i frame con parlato. Questo riduce la latenza di rete e, cosa ancora più importante, l'utilizzo di token del modello di trascrizione. Non sprecherai budget IA per il rumore di fondo.
Ottimizzazione VoIP e telefonia
La latenza può influire anche sulla qualità delle chiamate nelle reti VoIP aziendali. Per ottimizzare le prestazioni, questi sistemi audio digitali silenziano temporaneamente una linea tramite VAD quando chi chiama non sta parlando.
Cosa rende complesso il rilevamento dell'attività vocale?
Il rilevamento tradizionale dell'attività vocale si basa su algoritmi matematici per decidere se il parlato è presente. Tuttavia, i modelli del parlato umano sono irregolari. Le conversazioni sono spesso discontinue e imprevedibili e avvengono in contesti reali, con rumore di fondo e persino conversazioni parallele. La sfida principale del VAD è identificare silenzi significativi in audio rumoroso.
Questo comporta alcune sfide specifiche.
Pause a metà frase
Le persone non parlano con un ritmo costante per tutta una conversazione. Fanno pause, raccolgono le idee, riconsiderano ciò che stanno dicendo e perdono il filo del discorso. Nessuna di queste pause significa che chi parla ha finito. Per gli ascoltatori umani di solito è facile capirlo, ma può essere difficile per il software, persino per i modelli IA più recenti.
Se i sistemi VAD scambiano queste pause per parlato concluso, possono troncare una frase durante una transazione o indurre un agente vocale a interrompere chi sta parlando.
Rumore vocale
Il parlato a bassa voce, le consonanti finali discendenti (comuni alla fine di una frase) e caratteristiche come il vocal fry possono far sì che i sistemi VAD non rilevino parlato legittimo.
Acustica imprevedibile
Il rumore bianco continuo di fondo, come un ventilatore o l'acqua corrente, è relativamente facile da filtrare per i sistemi VAD. Un rumore sporadico, come l'abbaiare di un cane, potrebbe invece essere segnalato come parlato fantasma.
Una forte compressione audio riduce la gamma dinamica e può rendere più difficile per il VAD distinguere tra frame silenziosi e frame con parlato.
Come valutare le prestazioni del VAD
Il parlato umano è irregolare, soprattutto quando viene registrato in ambienti reali e dinamici. Le registrazioni audio perfette non sono un buon metodo per testare le prestazioni del VAD. Anche la semplice accuratezza speech to text non misura direttamente l'efficacia di un sistema VAD, poiché si colloca a valle di ciò che il VAD rileva.
Falsi positivi e falsi negativi
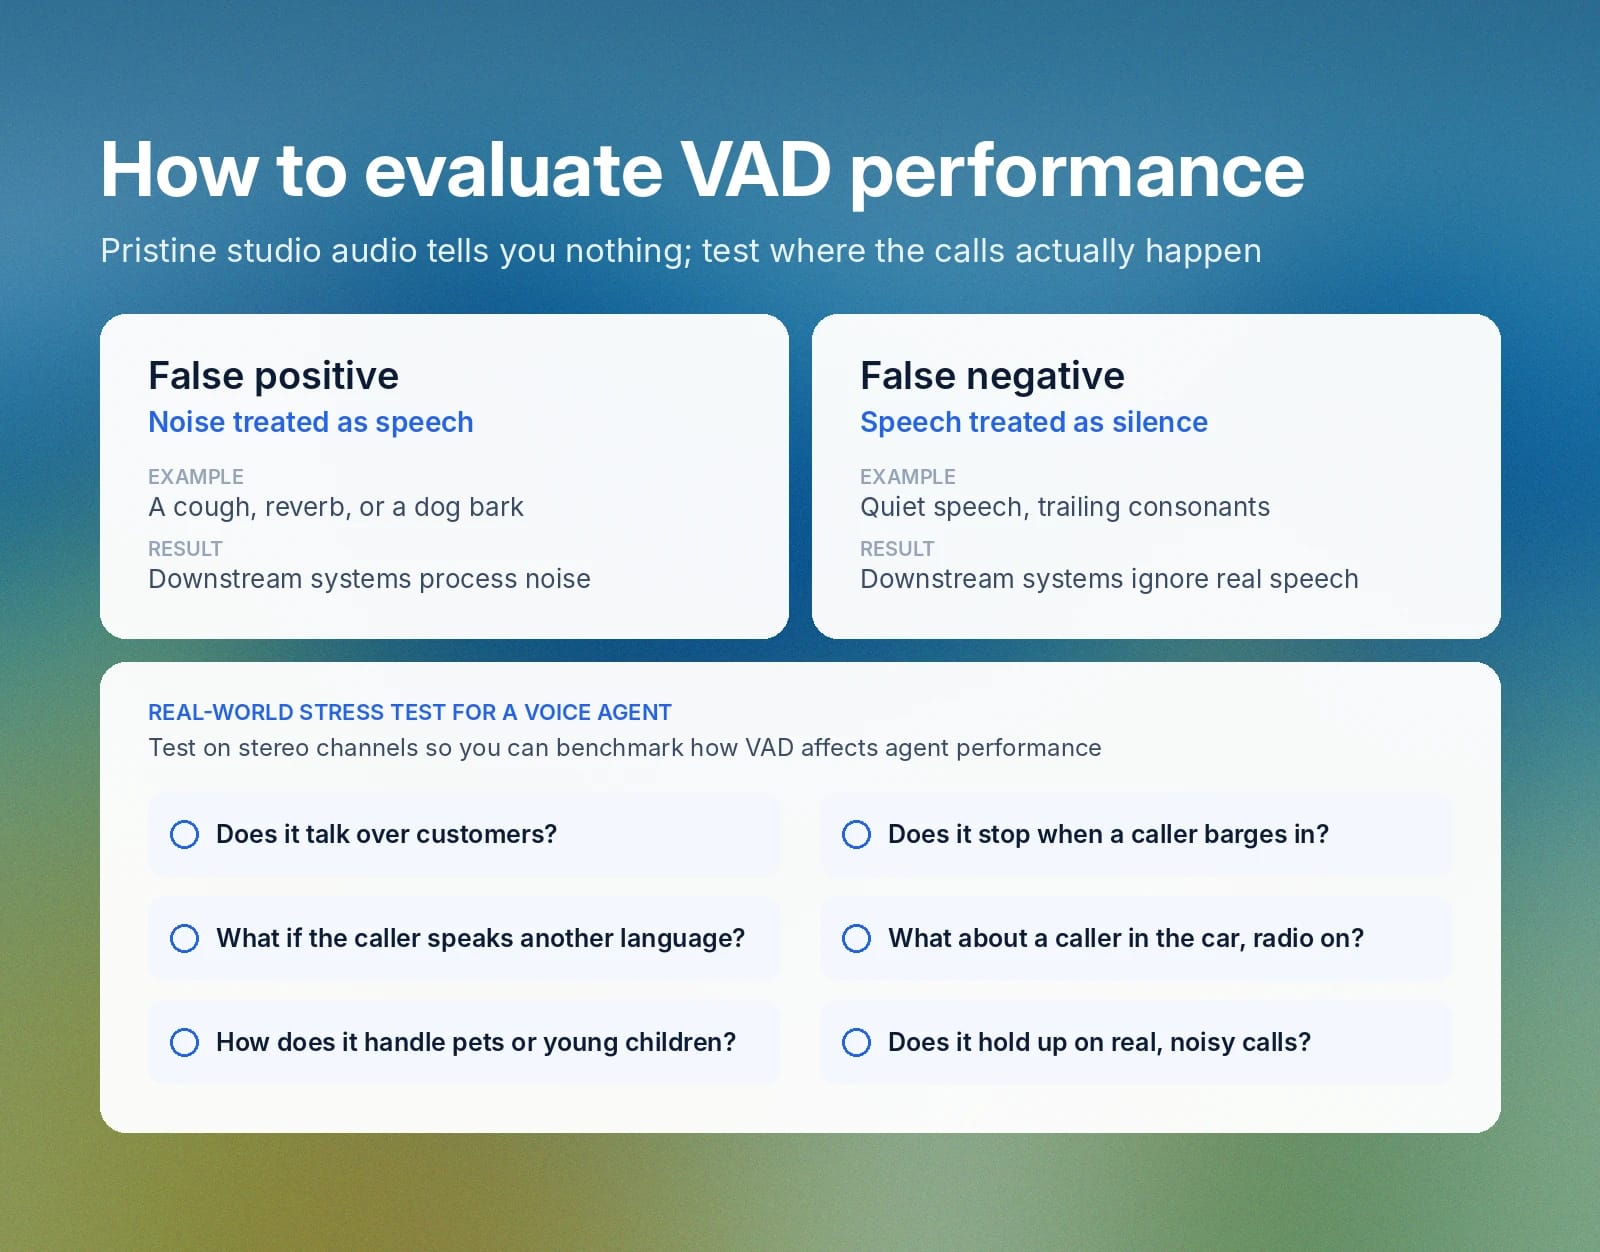
I falsi positivi del VAD sono rumori trattati come parlato. Un colpo di tosse, il riverbero, l'abbaiare di un cane e qualsiasi altro rumore improvviso di fondo possono attivarne uno e venire inavvertitamente passati come frame di parlato.
I falsi negativi sono parlato trattato come silenzio. Il VAD indica erroneamente ai servizi a valle di ignorare i frame audio.
Stress test in condizioni reali
Per valutare un servizio VAD, devi vedere come si comporta negli ambienti in cui verrà registrato l'audio e in condizioni reali.
Ad esempio, se intendi usare il VAD per un agente vocale, prova a testarlo con canali stereo per valutare come influisce sulle prestazioni dell'agente. Potrebbero sorgere domande come queste:
- Ci sono falsi negativi che lo portano a parlare sopra i clienti?
- Impedisce all'agente di parlare quando un utente lo interrompe?
- Cosa succede se chi chiama parla una lingua straniera?
- Come funziona con persone che chiamano da ambienti reali?
- Cosa succede quando un cliente chiama dall'auto ma non abbassa il volume della radio?
- Come si comporta con il rumore di fondo causato da animali domestici o bambini piccoli?
Tutte queste condizioni possono verificarsi nelle chiamate con i clienti. Il VAD deve saperle gestire e offrire buone prestazioni anche sotto stress.
Inizia a usare ElevenAgents per il servizio clienti
ElevenAgents usa un sistema ibrido di VAD e rilevamento dei turni basato sul deep learning per rendere le conversazioni con gli agenti fluide e naturali.
Inizia oggi a creare un nuovo agente per il servizio clienti con ElevenAgents. Registrati per iniziare.
Domande frequenti

Jack Limebear fa parte del team Growth e si occupa di scrivere contenuti e definire strategie per il blog e le pagine insights. Prima di arrivare in ElevenLabs, ha guidato la strategia dei contenuti per oltre dieci anni in realtà che vanno da startup SaaS in rapida crescita a grandi aziende Fortune 500. Ha conseguito un Master in Letteratura Inglese presso l’Università di Cambridge.



