
Cos'è un LLM? Una guida pratica ai modelli linguistici
- Scritto da
- Jack Limebear
- Pubblicato
AscoltaAscolta questo articolo
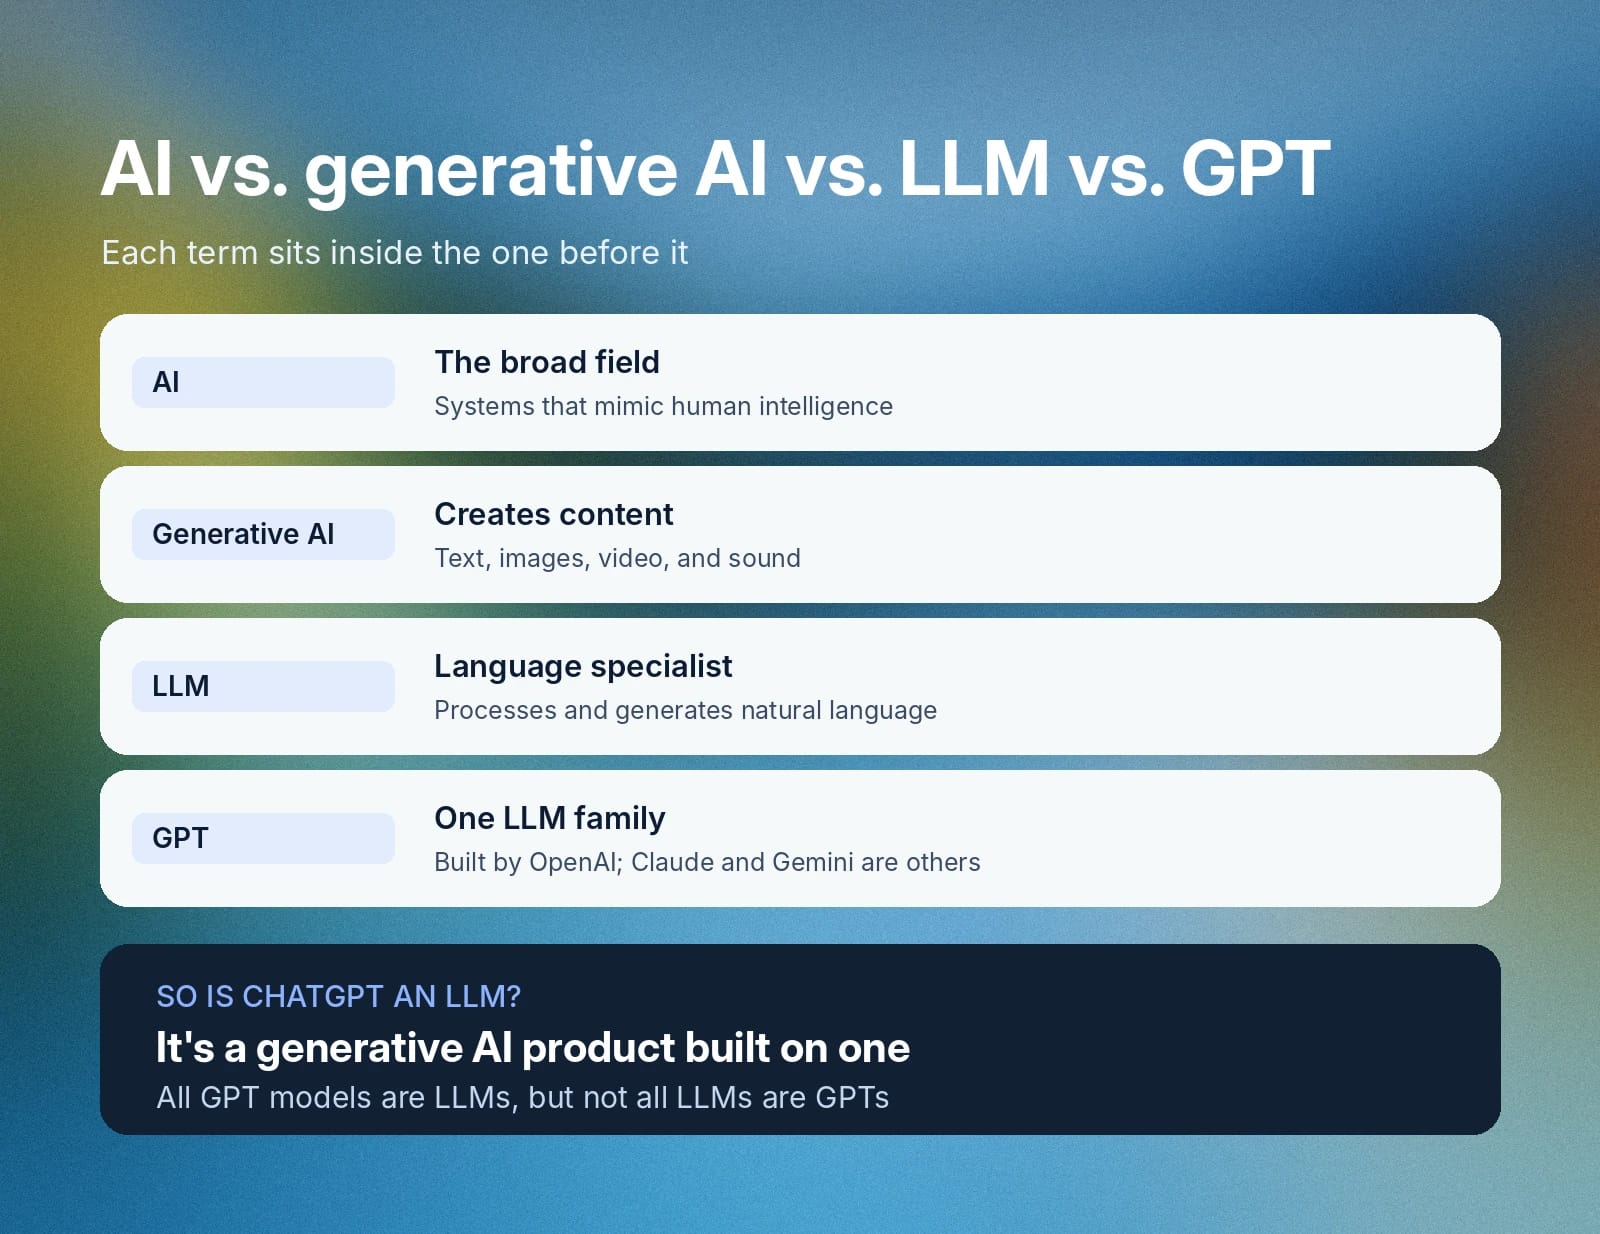
Un large language model (LLM) è un sistema di intelligenza artificiale addestrato su un vasto dataset per analizzare, prevedere e generare linguaggio naturale. Tra gli LLM più diffusi ci sono i modelli GPT di OpenAI, Claude di Anthropic e Gemini di Google, spesso usati per attività come scrittura, revisione e programmazione.
Inizialmente, i dataset degli LLM includevano soprattutto testi provenienti da fonti come libri, blog e perfino forum online. Gli LLM moderni usano ora dati multimodali per ampliare i casi d'uso, ad esempio alimentando agenti vocali conversazionali o creando musica.
Prima di implementare questa tecnologia, le organizzazioni hanno spesso bisogno di risposte a domande come: cos'è un LLM, come funziona un LLM e quali architetture dovrebbe usare il team? Questa guida affronta queste domande, illustrando anche le applicazioni concrete della tecnologia e i relativi vantaggi tangibili.
In sintesi
- Un large language model (LLM) è un modello di intelligenza artificiale addestrato su vasti dataset di testo e dati multimodali con l'obiettivo di analizzare, prevedere e generare output.
- La principale differenza tra GPT e LLM è che GPT (Generative Pre-trained Transformer) è una specifica famiglia di LLM creata da OpenAI, mentre LLM è il termine generico per modelli come Claude e Gemini.
- L'IA generativa è la categoria ampia di modelli che creano un'ampia varietà di contenuti a partire dai dati di addestramento, mentre gli LLM sono un sottoinsieme specializzato dell'IA generativa incentrato sull'elaborazione del linguaggio naturale.
- Gli LLM funzionano usando reti neurali transformer per suddividere il testo in unità più piccole chiamate token, quindi prevedono il token successivo in base alle informazioni contestuali del prompt e alla cronologia della chat esistente.
- Esempi pratici di large language model includono chatbot per il servizio clienti, strumenti di scrittura automatizzata, generatori di codice e livelli di elaborazione del linguaggio naturale per applicazioni vocali.
Cos'è un LLM? La definizione di large language model
Un large language model è un programma di IA basato su reti neurali di deep learning per analizzare, prevedere e generare linguaggio naturale. Gli sviluppatori hanno addestrato questi modelli su dataset contenenti miliardi di opere, tra cui libri, articoli accademici, siti web e blog. Il termine “large” si riferisce sia all'enorme volume di dati usato per addestrare questi modelli sia ai miliardi di parametri interni che ne regolano il comportamento.
I large language model rappresentano un grande cambiamento rispetto al funzionamento dei software precedenti: il software tradizionale si basava su comandi sintattici espliciti, mentre gli LLM no. Invece di elaborare ogni parola isolatamente, gli LLM usano relazioni contestuali per riconoscere modelli linguistici complessi e la grammatica. Interpretano il linguaggio umano non strutturato e continuano a rispondere a prompt utente aperti, adattandosi ai cambiamenti di contesto nel corso della conversazione.
Questi progressi nell'elaborazione del linguaggio naturale consentono a ElevenAgents di comprendere intenzioni complesse dei clienti ed eseguire workflow automatizzati.
Come funzionano i large language model?
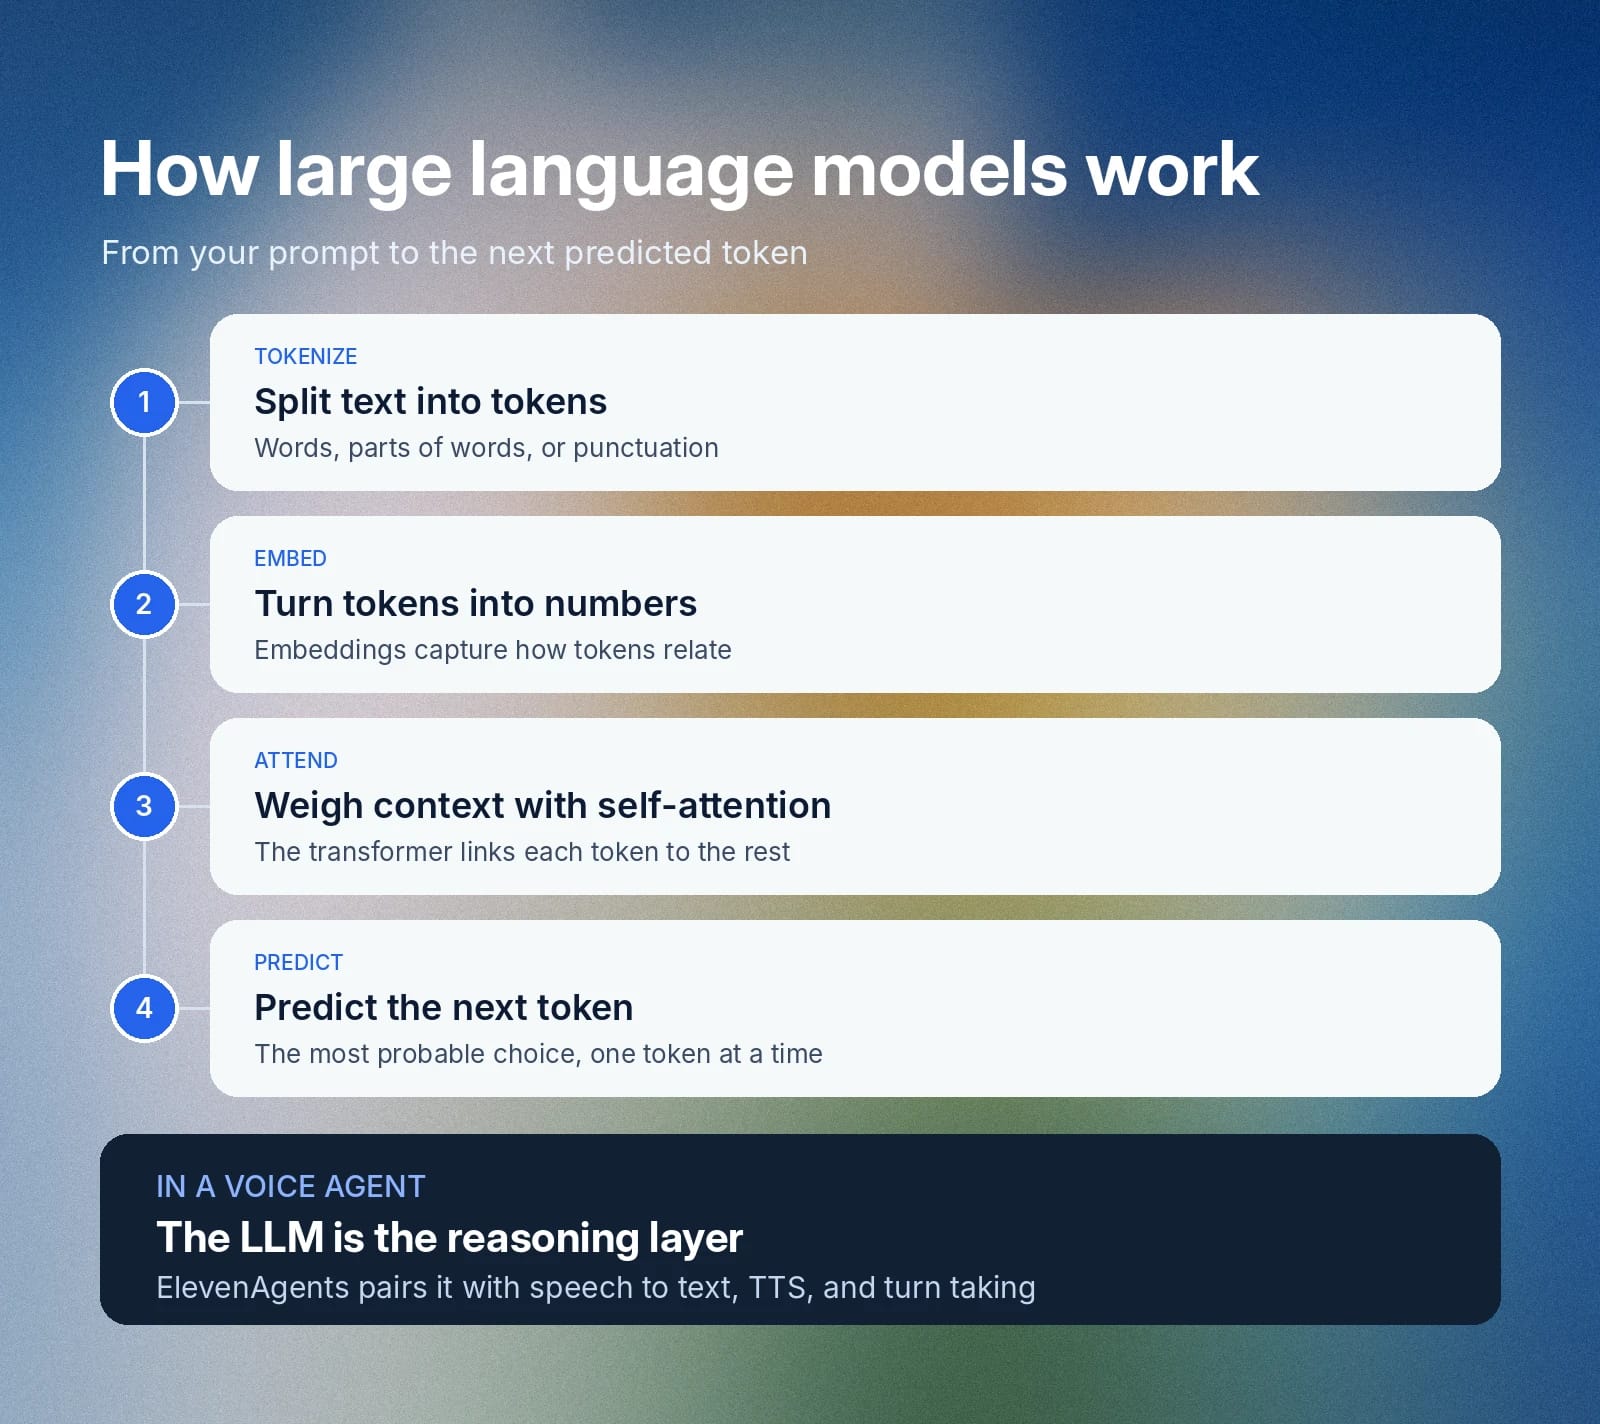
I large language model elaborano il testo tramite reti neurali artificiali per analizzare input in linguaggio naturale e generare contenuti pertinenti. Il processo inizia con la tokenizzazione, in cui il modello divide il testo di input in unità più piccole chiamate token. Il modello traduce poi questi token in rappresentazioni numeriche, chiamate embedding, per valutare le relazioni matematiche o statistiche tra i token.
La maggior parte dei sistemi LLM moderni si basa sull'architettura di rete neurale transformer. I transformer usano meccanismi di self-attention, che valutano le relazioni contestuali tra i token. Il modello prevede il token statisticamente più probabile per completare una sequenza, usando modelli appresi per calcolare le distribuzioni di probabilità.
La self-attention consente ai modelli di elaborazione del linguaggio naturale di mantenere un contesto a lungo raggio e adattarsi ai cambiamenti nel corso di una conversazione. Le integrazioni della piattaforma con ElevenAgents sfruttano queste capacità per offrire risposte pertinenti e a bassa latenza, simili a una conversazione umana naturale.
Cos'è la temperatura in un LLM?
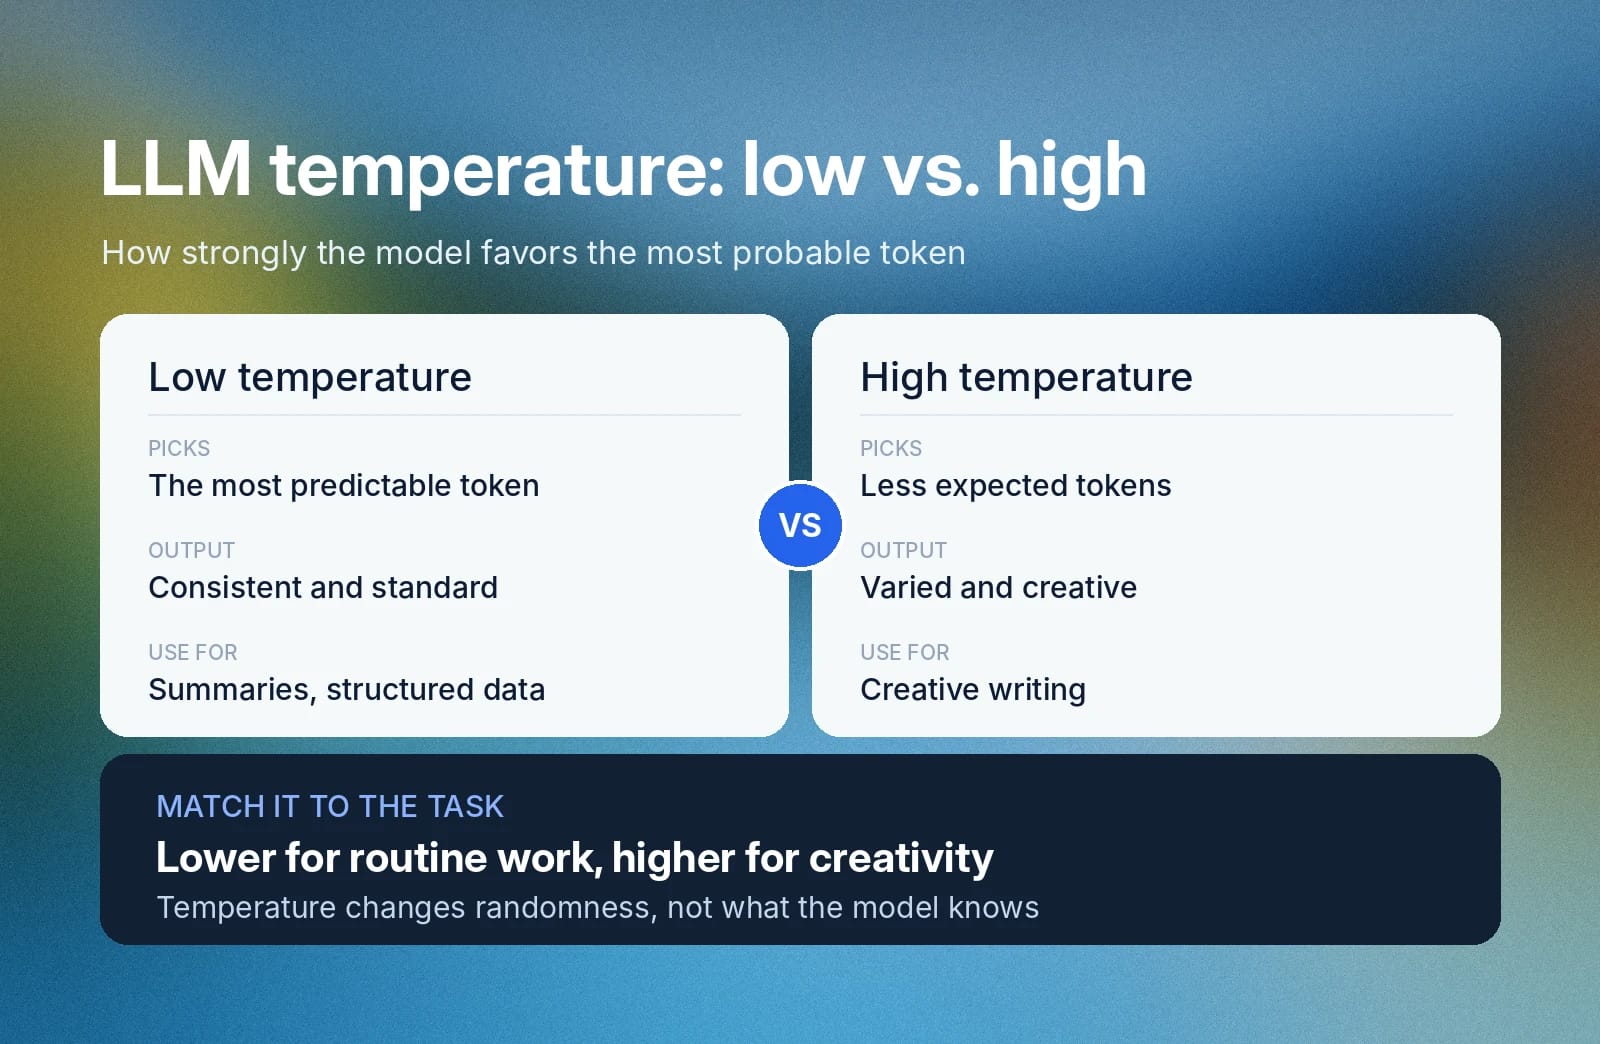
La temperatura di un LLM è un'impostazione variabile che gli sviluppatori possono configurare per stabilire quanto casuali saranno gli output di un LLM. Gli LLM generano il token successivo in una sequenza di parole selezionando l'opzione più comune. Tuttavia, per ogni scelta effettuata dall'LLM possono esistere diverse altre alternative con una ponderazione simile.
Regolando la temperatura dell'LLM, modifichi quanto un LLM favorisca l'opzione più probabile. Un'impostazione di temperatura bassa produrrebbe un output standard e coerente, poiché tenderebbe a scegliere sempre il token successivo più prevedibile in una sequenza. Al contrario, una temperatura alta si discosterebbe più spesso dalla scelta prevista, producendo output più creativi e vari.
Dovresti adattare il valore della temperatura dell'LLM all'attività che vuoi svolgere. Tutto ciò che richiede un elemento di creatività dovrebbe orientarsi verso temperature più alte, mentre le attività di routine o gli output strutturati, come i riepiloghi dei dati, dovrebbero usare temperature più basse.
Come vengono addestrati e sottoposti a fine-tuning gli LLM?
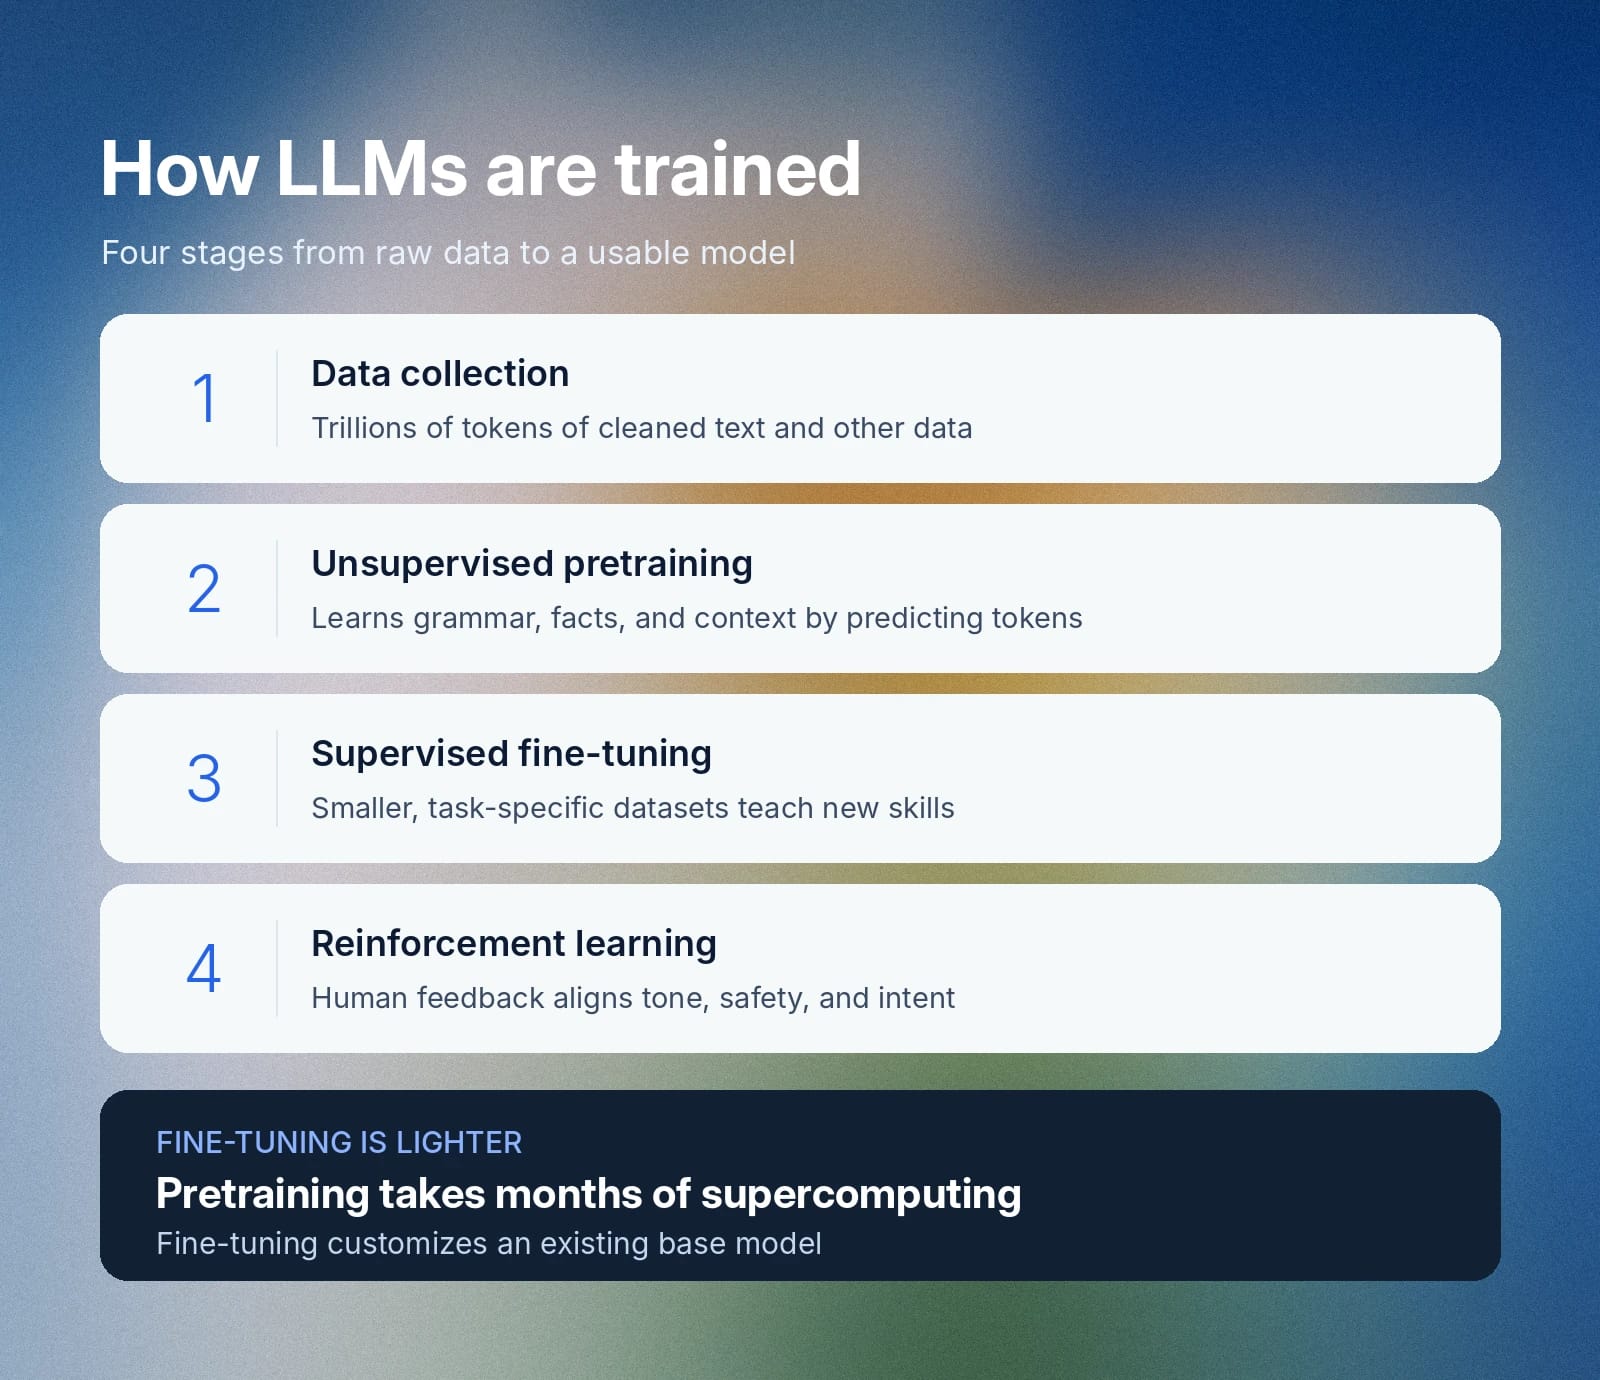
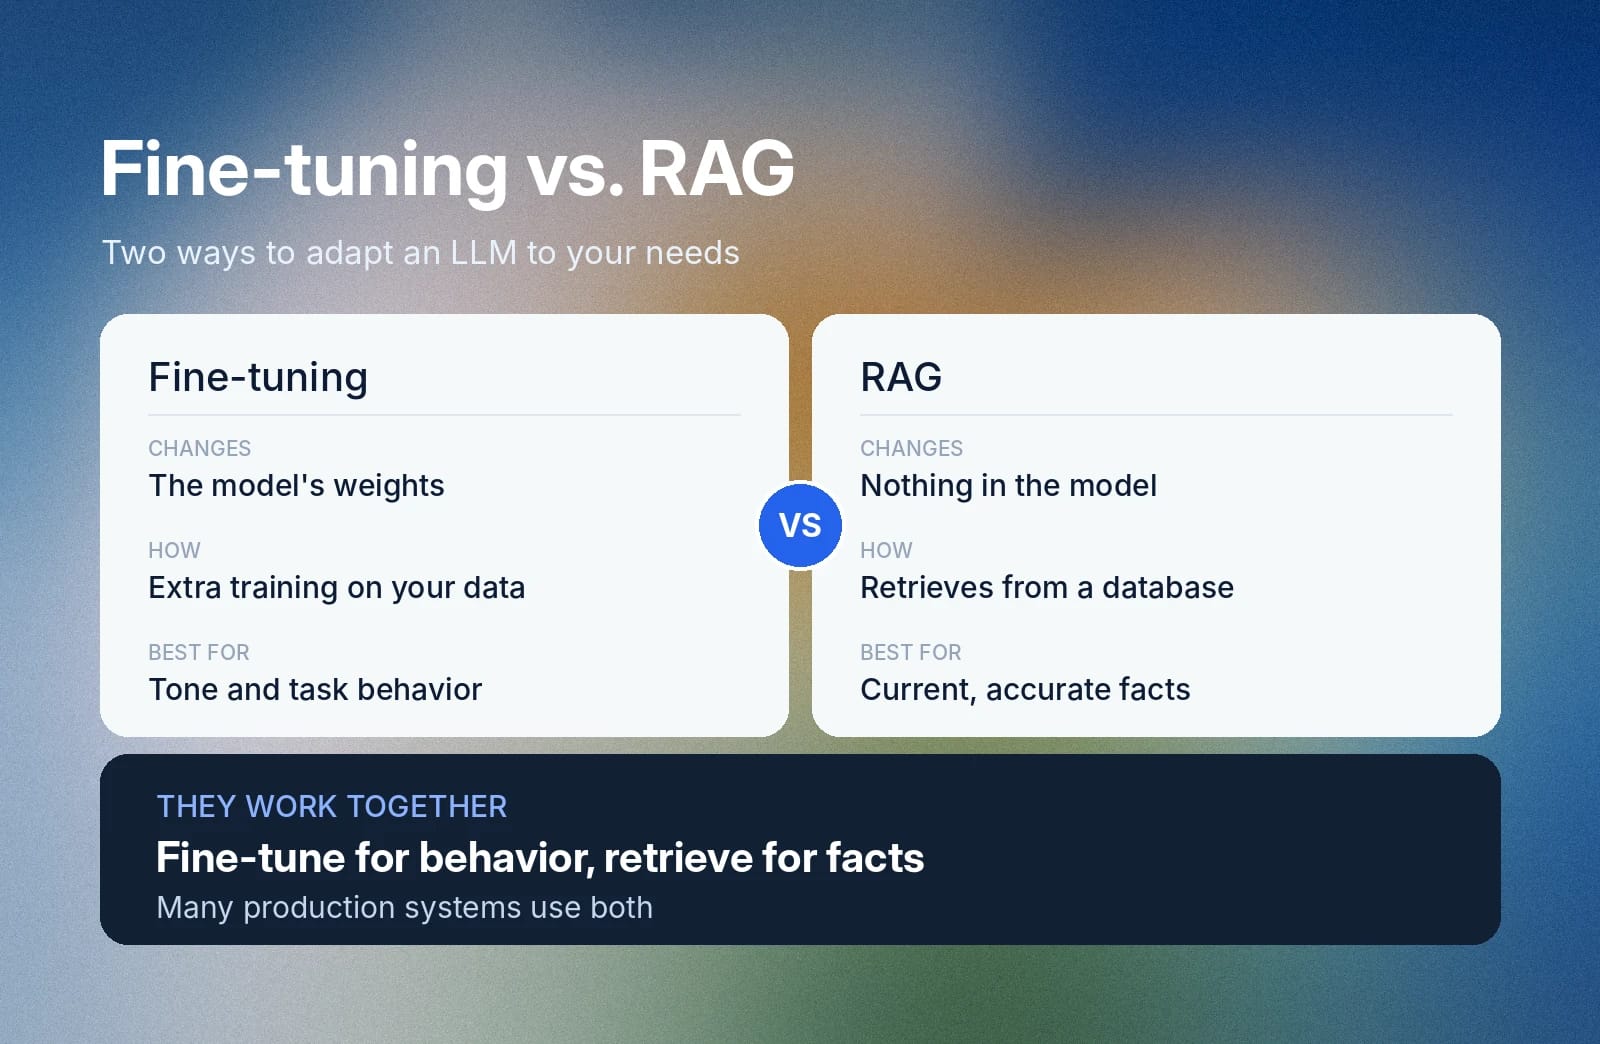
L'addestramento degli LLM richiede un processo in più fasi per trasformare testo grezzo e dati multimodali in sistemi linguistici funzionali. Le aziende necessitano di capacità di supercalcolo avanzate in funzione per diversi mesi, mentre il fine-tuning è un processo più leggero che personalizza il modello di base esistente.
Le aziende di IA di frontiera tendono a considerare l'esatto processo di addestramento come informazione proprietaria e la maggior parte non divulga il codice sorgente o i pesi. Tuttavia, l'addestramento segue generalmente questo processo:
- Raccolta e pre-elaborazione dei dati: Gli sviluppatori creano dataset da più fonti con corpus di pre-addestramento che includono trilioni di token estratti da terabyte di testo pulito. Lo scraping o l'estrazione di testo da fonti internet è uno dei principali modi con cui le aziende creano questi dataset.
- Pre-addestramento non supervisionato: Il large language model legge trilioni di token per apprendere regole grammaticali, relazioni fattuali e contesto linguistico. In sostanza, esegue il pre-addestramento autonomamente tramite la modellazione linguistica autoregressiva basata su meccanismi di self-attention che calcolano il token successivo statisticamente probabile in una sequenza.
- Fine-tuning supervisionato: Gli ingegneri usano dataset più piccoli e specifici per l'attività per adattare il modello pre-addestrato. Questo passaggio insegna al modello competenze specifiche, dalla risposta a domande generiche alla generazione di loghi o alla conduzione di ricerche di laboratorio.
- Apprendimento per rinforzo e allineamento: Gli sviluppatori perfezionano il comportamento del modello usando il feedback di revisori umani e modelli di ricompensa. Questa fase allinea gli output del modello alle linee guida di sicurezza, ai requisiti di tono e all'intento umano.
Tipi di architetture LLM: encoder, decoder e modelli ibridi
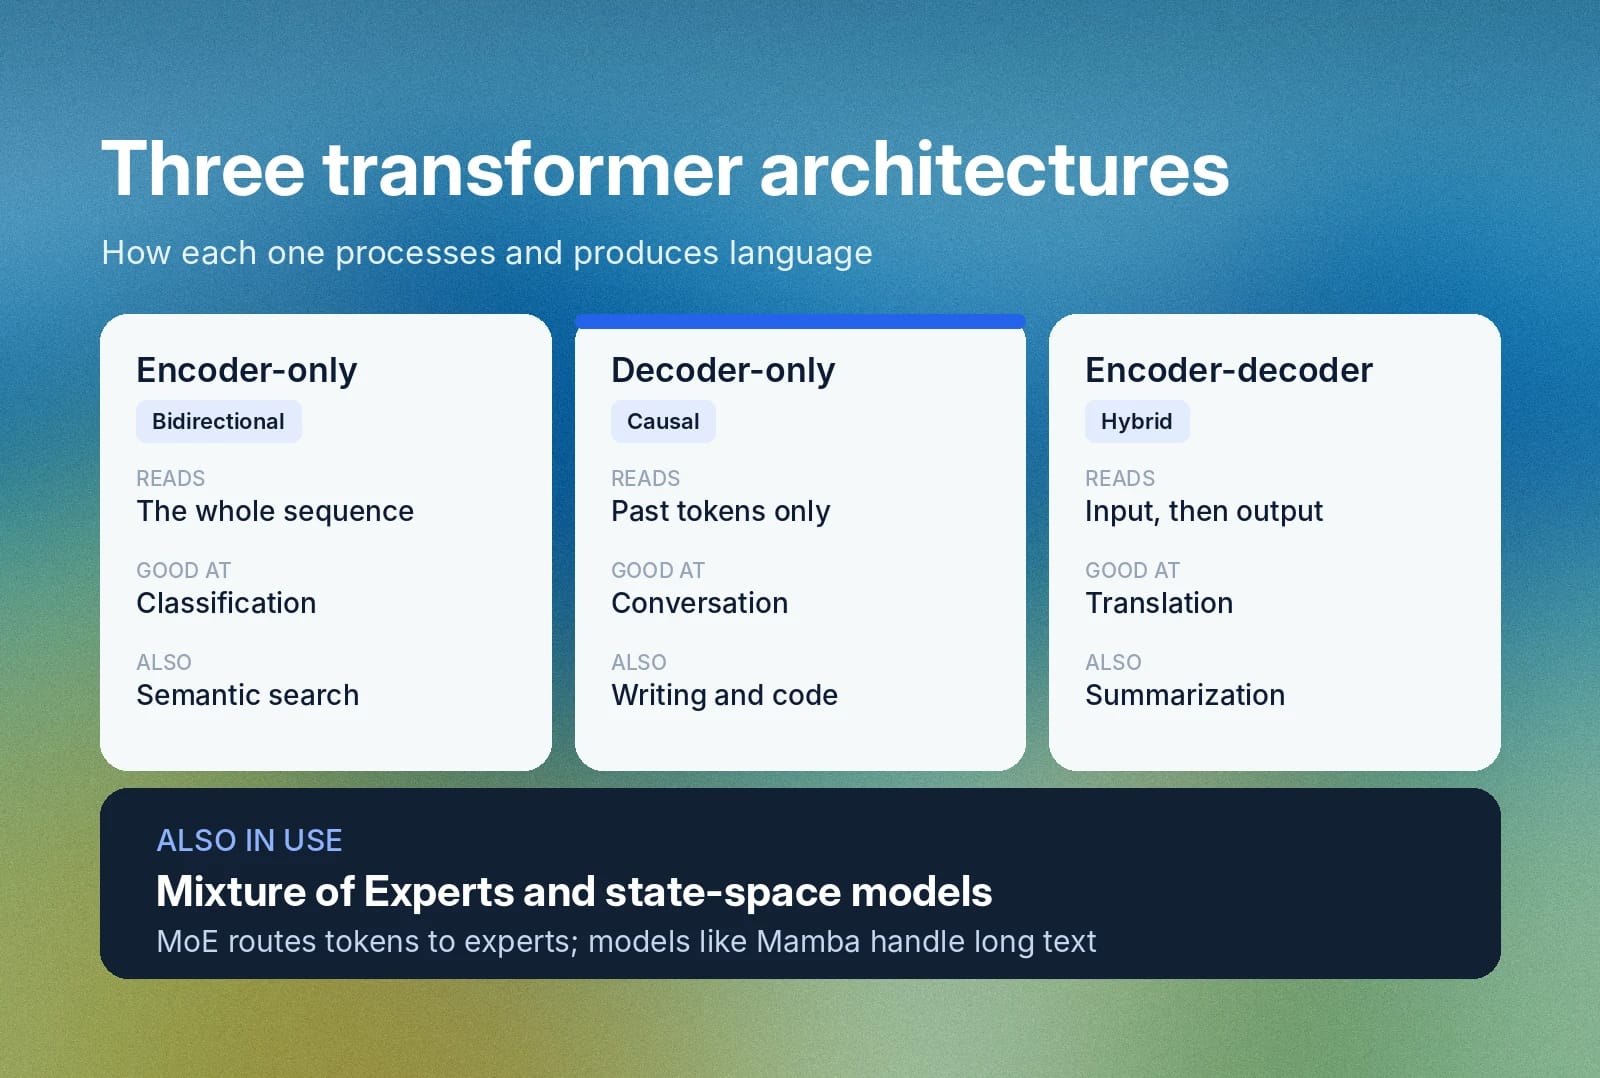
Le architetture transformer organizzano gli strati delle reti neurali in modi diversi per elaborare input e produrre contenuti. I transformer classici rientrano in tre categorie principali: modelli solo encoder, solo decoder ed encoder-decoder, o ibridi. Tuttavia, i sistemi moderni incorporano anche architetture di efficienza per aumentare le prestazioni.
Modelli solo encoder
Le architetture solo encoder elaborano intere sequenze contemporaneamente tramite self-attention bidirezionale. Ciò consente alla macchina di valutare la relazione di ciascun token con altri token passati e futuri. In pratica, questo ottimizza i modelli per attività come:
- Classificazione del testo
- Analisi del sentiment
- Recupero delle informazioni
- Ricerca semantica
Attività come queste sono presenti anche nei workflow vocali. Il modello Scribe di ElevenLabs per Speech to Text trascrive il parlato in oltre 90 lingue e la sua funzione di rilevamento delle entità segnala dettagli sensibili e linguaggio offensivo nelle trascrizioni.
Modelli solo decoder
Le architetture solo decoder usano l'attenzione causale per elaborare i token, prevedendo ogni parola in base ai token precedenti. Questi modelli generano conversazioni fluide e costituiscono l'architettura principale alla base dei moderni chatbot conversazionali, degli assistenti di scrittura aperti e degli strumenti di generazione del codice.
In ElevenAgents, l'LLM che scegli, generalmente un modello solo decoder, genera le risposte dell'agente, mentre un modello proprietario di gestione dei turni gestisce le tempistiche della conversazione.
Modelli encoder-decoder (ibridi)
I modelli encoder-decoder usano un encoder per elaborare l'input e un decoder per generare l'output. Questo approccio a doppia struttura rende i modelli ibridi più adatti alle attività che richiedono una rigorosa conservazione del contesto, come il riepilogo di documenti, la traduzione linguistica e la riformattazione dei dati.
La traduzione è una classica attività encoder-decoder e Dubbing di ElevenLabs supporta oltre 90 lingue.
Mixture of Experts (MoE) e modelli state-space
Invece di attivare ogni parametro della rete neurale per ciascuna parola, Mixture of Experts (MoE) instrada i singoli token verso piccoli team di sottoreti “esperte” specializzate. Questo offre una profondità di ragionamento paragonabile a quella di modelli enormi, ma con maggiore velocità e costi di calcolo inferiori. Nel frattempo, i modelli state-space, come Mamba, elaborano in modo efficiente testi estremamente lunghi.
ElevenAgents include LLM open source che ElevenLabs fornisce nella propria infrastruttura.
Esempi di large language model e applicazioni quotidiane
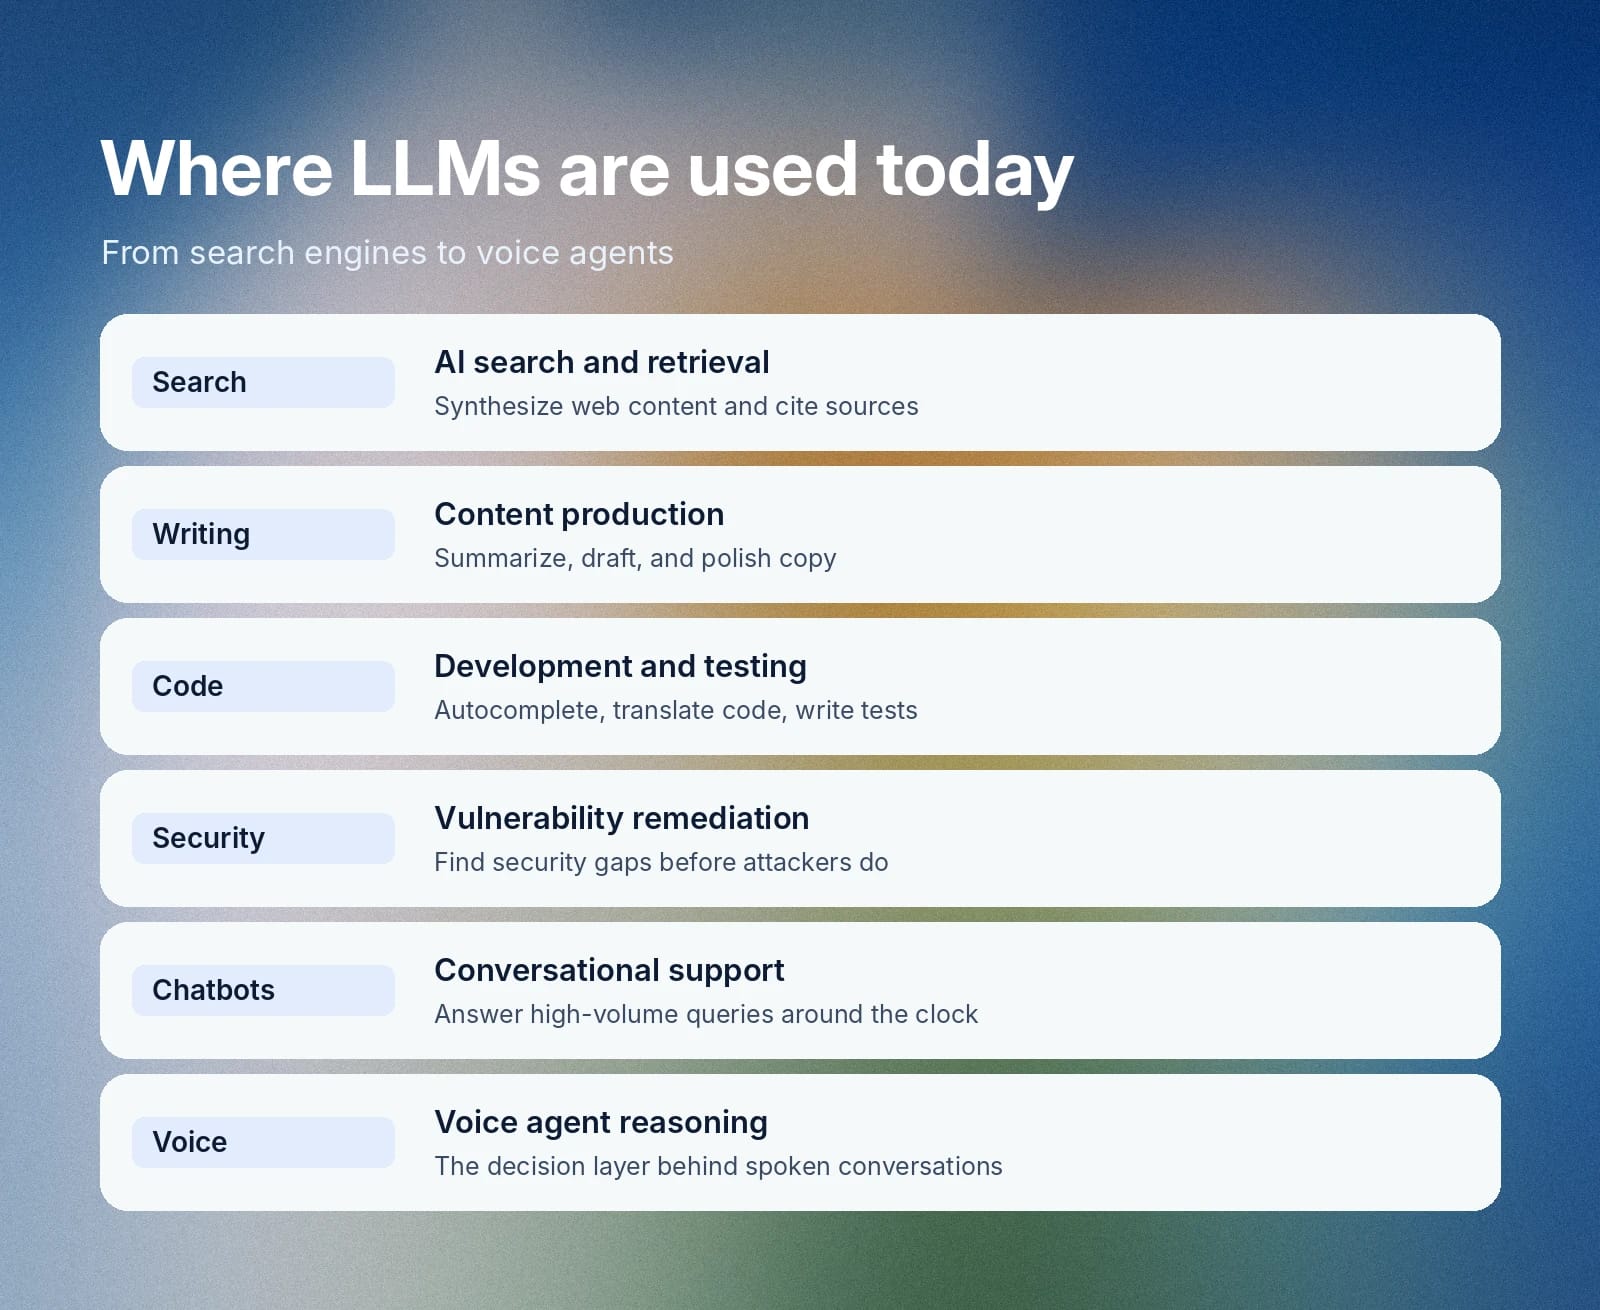
Le organizzazioni hanno individuato un'ampia gamma di casi d'uso per i large language model. Questi casi d'uso mostrano come l'IA sia passata dalla ricerca sperimentale a una funzionalità standard sul web, nelle applicazioni software e nei dispositivi di uso quotidiano. Mentre gli scienziati dell'IA continuano a studiare e ottimizzare l'architettura sottostante, gli esempi reali di LLM mostrano come i team li abbiano implementati finora:
- Ricerca IA e recupero delle informazioni: Motori di ricerca conversazionali come Bing, Google AI Overviews e Perplexity usano gli LLM per analizzare contenuti web in tempo reale. I modelli sintetizzano le informazioni, citano direttamente le fonti e consentono agli utenti di porre domande di approfondimento.
- Scrittura, revisione e produzione di contenuti: Gli LLM e altri strumenti basati sull'IA semplificano la scrittura e la revisione di materiali per uso interno ed esterno. Ad esempio, NotebookLM riassume report lunghi, Jasper AI scrive annunci e Grammarly perfeziona i testi.
- Generazione del codice, sviluppo e test: L'IA alimenta strumenti di coding come GitHub Copilot per completare automaticamente le funzioni e tradurre il codice da un linguaggio di programmazione a un altro. I team possono anche usarla per generare suite di test automatizzate, così da identificare e correggere facilmente i bug prima del deployment.
- Cybersecurity e correzione delle vulnerabilità: Le aziende di IA di frontiera hanno rilasciato modelli specializzati per rilevare lacune di sicurezza, aiutando le organizzazioni a implementare correzioni prima che gli aggressori possano trovarle e sfruttarle.
- Chatbot e assistenti conversazionali: Le organizzazioni implementano interfacce conversazionali per offrire assistenza clienti 24 ore su 24, 7 giorni su 7. L'integrazione di piattaforme come ElevenAgents consente alle aziende di automatizzare le richieste ad alto volume con soluzioni conversazionali invece di affidarsi alle FAQ.
- Motore di ragionamento per agenti vocali: Gli LLM fungono anche da livello centrale di ragionamento per i sistemi di IA vocale. ElevenAgents combina l'LLM che scegli con Speech to Text, Text to Speech a bassa latenza e un modello proprietario di gestione dei turni per sostenere conversazioni naturali in tempo reale.
Quali sono i limiti dei large language model?
Essendo la struttura portante della maggior parte dei prodotti di IA con cui interagiscono i consumatori, gli LLM sono un componente architetturale potente che supporta numerosi workflow e casi d'uso. Tuttavia, se vuoi sviluppare con gli LLM o addestrare il tuo modello, dovresti conoscerne i principali limiti:
- Allucinazioni: Non c'è garanzia che ciò che genera un LLM sia accurato. Una risposta può facilmente contenere informazioni inventate o semplicemente errate.
- Conoscenza statica: Senza RAG, un LLM è limitato all'ambito di conoscenze predefinito ottenuto durante il processo di addestramento.
- Bias: Se i tuoi dati di addestramento contengono bias, il tuo modello li rifletterà. È particolarmente importante tenerne conto se usi un LLM per classificare dati o prendere decisioni sulle informazioni, poiché alcuni bias impliciti nei dati potrebbero influenzare negativamente gli output senza che tu ne sia consapevole.
- Finestra di contesto limitata: Gli LLM lavorano in genere soltanto con una quantità fissa di testo, il che significa che le conversazioni più lunghe potrebbero iniziare a perdere dettagli e diventare meno efficaci nel tempo.
- Costo e latenza: Più grande è l'LLM, maggiore è la capacità di calcolo necessaria per eseguirlo. Se scegli modelli più potenti, probabilmente pagherai un sovrapprezzo per il servizio migliorato.
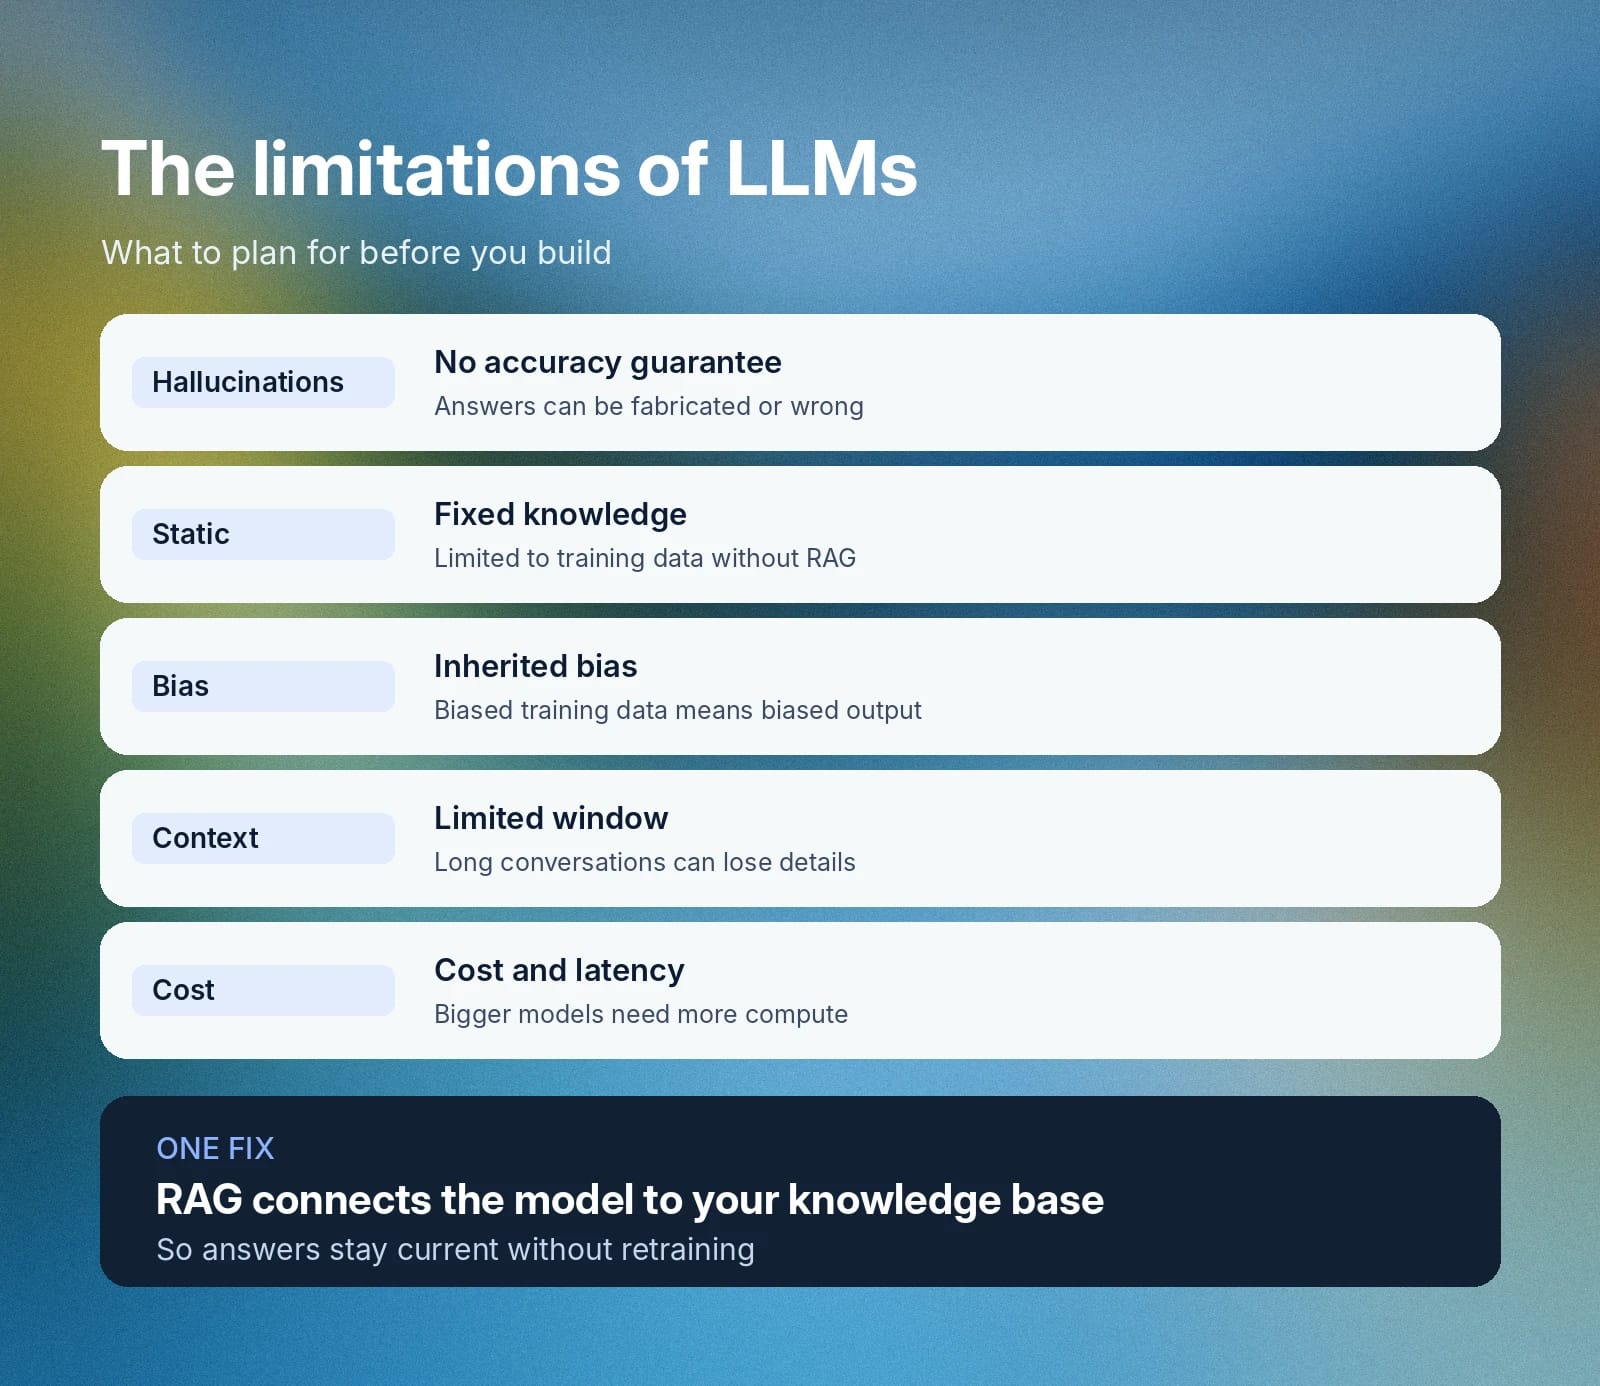
Puoi prendere in considerazione diverse strategie o implementazioni per ridurre l'impatto di questi limiti. Ad esempio, abilitare il RAG in un LLM e collegare una knowledge base in continua espansione risolverebbe il problema della conoscenza statica.
Crea esperienze LLM vocali con ElevenAgents
Scegliere un large language model per il tuo caso d'uso è una decisione critica che potresti dover adattare al variare delle esigenze aziendali e persino dei requisiti normativi. Evitare il vendor lock-in mantiene l'agilità e la flessibilità dell'azienda nello sviluppo di soluzioni di IA vocale conversazionale.
ElevenAgents ti consente di scegliere tra gli LLM supportati di provider tra cui OpenAI, Anthropic e Google, oppure di collegare il tuo modello personalizzato tramite un endpoint compatibile con OpenAI. Così puoi scegliere facilmente il giusto equilibrio tra velocità, capacità di ragionamento e costo per le tue esigenze specifiche.
Esplora ElevenAgents per scoprire come gli LLM forniti ottimizzano i workflow vocali oppure contatta il team commerciale per iniziare oggi a creare i tuoi agenti vocali a bassa latenza.
Domande frequenti sugli LLM

Jack Limebear fa parte del team Growth e si occupa di scrivere contenuti e definire strategie per il blog e le pagine insights. Prima di arrivare in ElevenLabs, ha guidato la strategia dei contenuti per oltre dieci anni in realtà che vanno da startup SaaS in rapida crescita a grandi aziende Fortune 500. Ha conseguito un Master in Letteratura Inglese presso l’Università di Cambridge.


