
Cos'è un database vettoriale? Come la ricerca IA trova il significato
- Scritto da
- Jack Limebear
- Pubblicato
AscoltaAscolta questo articolo
Un database vettoriale è un sistema di archiviazione che consente ai modelli IA di interrogare e recuperare dati non strutturati in base alla somiglianza semantica. Aiuta l'IA a generare risposte basate su conoscenze che vanno oltre i suoi dati di addestramento.
I database vettoriali archiviano le informazioni in un formato facilmente elaborabile dagli LLM. Forniscono ai modelli IA informazioni aggiuntive per generare risposte pertinenti e accurate.
Questa guida spiega cos'è un database vettoriale, come funziona, i casi d'uso più comuni, le tipologie, alcuni esempi e come si confronta con i database relazionali e a grafo.
In sintesi
- Un database vettoriale archivia rappresentazioni di caratteristiche apprese come embedding vettoriali in uno spazio multidimensionale.
- A differenza dei database tradizionali, che si basano sulla corrispondenza delle parole chiave, i database vettoriali recuperano dati semanticamente simili quando ricevono una query.
- Un database vettoriale archivia documenti interni che aiutano l'IA vocale e il servizio clienti a fornire risposte consapevoli del contesto tramite un sistema RAG.
- Applicazioni come chatbot, motori di ricerca IA e IA conversazionale traggono vantaggio dalla ricerca semantica e dai tipi di dati non strutturati supportati dai database vettoriali.
- I database vettoriali differiscono dai database a grafo. Questi ultimi collegano entità correlate per supportare query multi-hop tramite algoritmi di attraversamento dei grafi, mentre i database vettoriali sono adatti a query dirette che richiedono contesto aggiuntivo.
Cos'è un database vettoriale e cosa archivia?
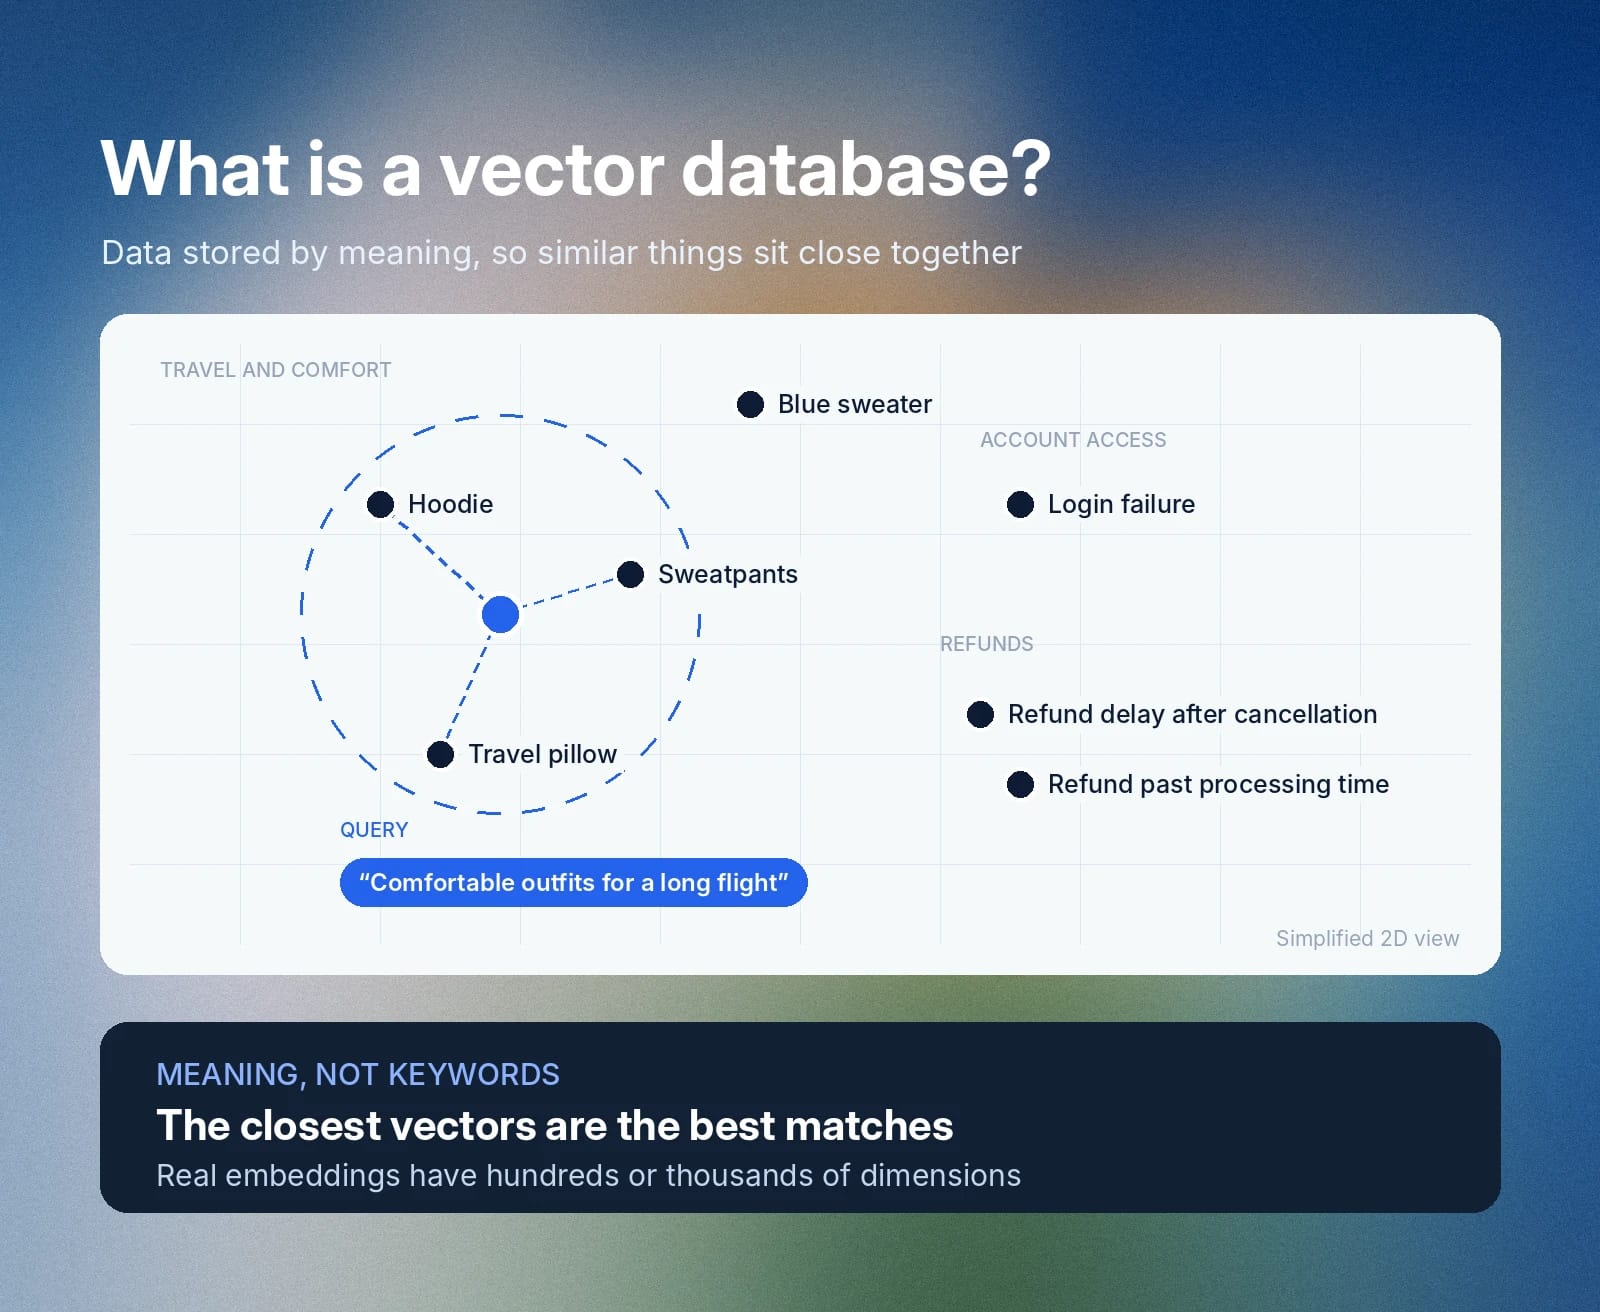
Un database vettoriale archivia i dati come rappresentazioni numeriche chiamate embedding, consentendo la ricerca semantica a bassa latenza per i modelli IA. A differenza di un database tradizionale, che archivia le informazioni in righe e colonne, un database vettoriale raggruppa gli embedding in uno spazio multidimensionale in base alle somiglianze semantiche.
Nell'IA, il termine "dimensione" descrive le caratteristiche apprese di un oggetto specifico. Per esempio, puoi immaginare che un cane abbia dimensioni come il colore del pelo e la razza. Nella pratica, le singole dimensioni di un embedding appreso raramente corrispondono a una caratteristica leggibile.
Le applicazioni di IA generativa, in particolare quelle collegate a una fonte di conoscenza esterna, usano un database vettoriale per velocizzare il recupero delle informazioni. Anziché cercare una corrispondenza diretta di parole chiave in un database tradizionale, il sistema di recupero trova gli embedding più simili nel database vettoriale.
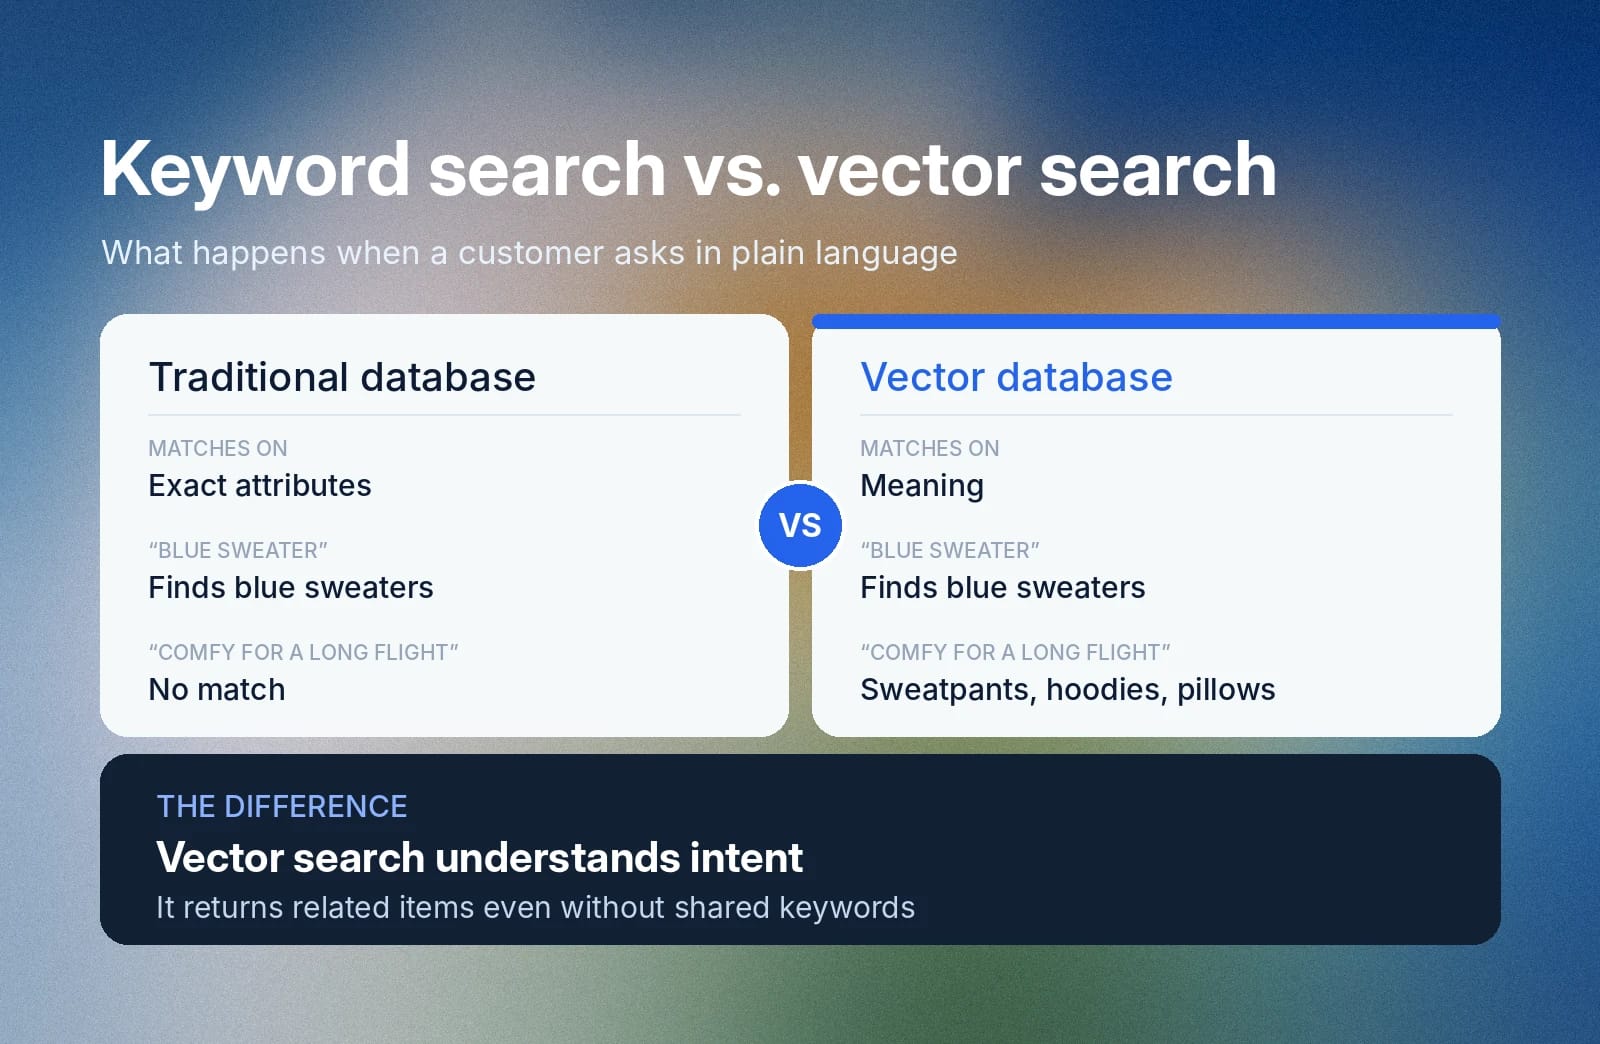
Supponiamo che un cliente chiami e ti chieda di consigliare un "maglione blu". Con un database tradizionale, cercheresti prodotti che corrispondono agli attributi "blu" e "maglione". Tuttavia, se il cliente desidera "outfit comodi per un lungo volo", un database tradizionale non potrebbe fornire una risposta.
Un database vettoriale, invece, coglie il significato semantico della richiesta. Mappandola nello spazio vettoriale, il sistema restituisce articoli come pantaloni della tuta, felpe con cappuccio e cuscini da viaggio, che hanno rappresentazioni di caratteristiche strettamente correlate. Questa capacità di associare il significato distingue un database vettoriale da uno tradizionale.
Embedding vettoriali: trasformare voce, testo e immagini in numeri
Gli embedding vettoriali sono array di numeri che rappresentano dati non strutturati come testo, immagini e video, così che i modelli IA possano elaborarli facilmente.
Un vettore è la rappresentazione matematica di numeri in diverse dimensioni. Tuttavia, un vettore non acquisisce il contesto, la struttura e il significato di uno specifico set di dati.
Per esempio, un elenco di numeri decimali [0.82, 0.14, 0.67] è un vettore, ma ciò che rappresenta è determinato dal modello di embedding.
Gli embedding acquisiscono le qualità dei dati e le archiviano come vettore in uno spazio multidimensionale. Danno significato a quella che altrimenti sarebbe soltanto una lista di numeri. Ogni numero nel vettore è una dimensione della rappresentazione appresa.
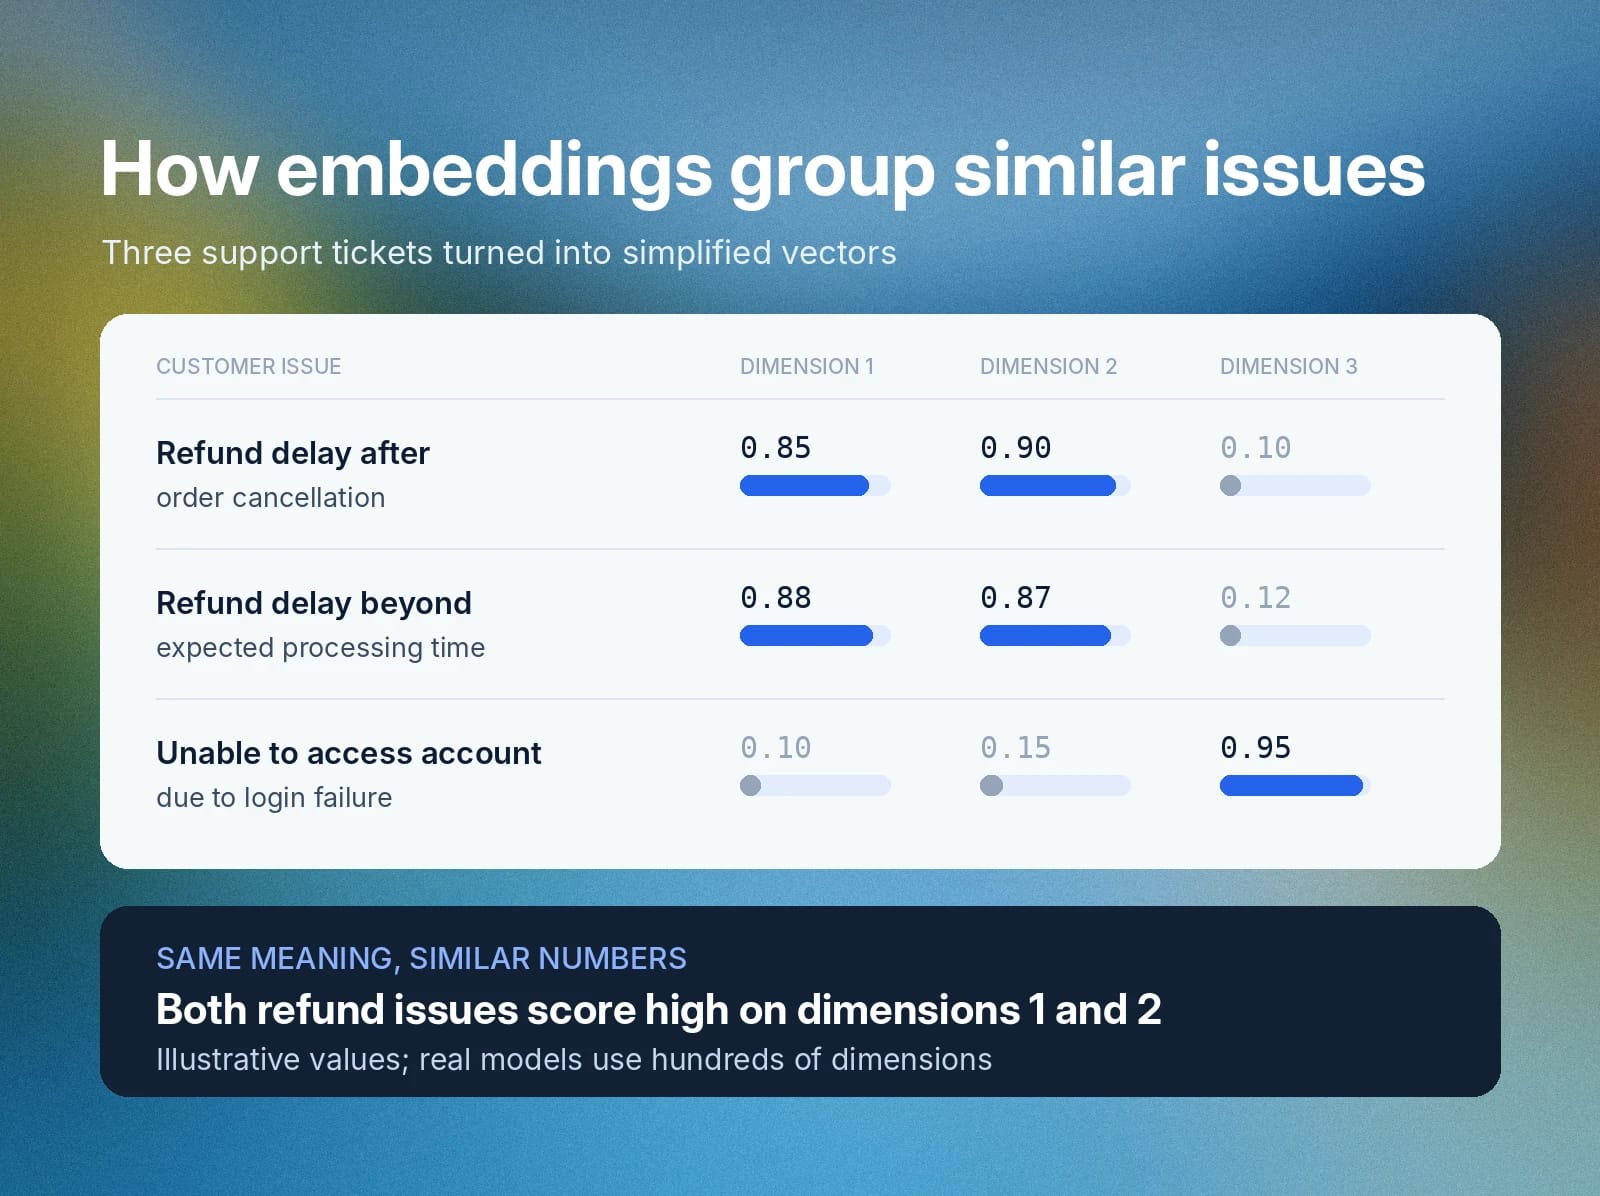
Supponiamo che tu voglia archiviare i casi dei clienti in un database vettoriale. Con un modello di embedding, converti i tipi di ticket in embedding con valori distinti nelle varie dimensioni. I valori seguenti sono semplificati a scopo illustrativo.
Problema del cliente
Embedding
Ritardo nel rimborso dopo l'annullamento dell'ordine
[0.85, 0.90, 0.10]
Ritardo nel rimborso oltre i tempi di elaborazione previsti
[0.88, 0.87, 0.12]
Impossibile accedere all'account a causa di un errore di accesso
[0.10, 0.15, 0.95]
Entrambi i problemi di rimborso, pur avendo cause diverse, hanno numeri più alti nella prima e nella seconda dimensione, mentre il problema di accesso ha il numero più alto nella terza. I modelli di embedding producono in genere centinaia o migliaia di dimensioni, ed è per questo che i database vettoriali sono progettati per confrontarle rapidamente.
Come funzionano i database vettoriali?
I database vettoriali trasformano i dati non strutturati in embedding, li archiviano in uno spazio multidimensionale e facilitano la ricerca per somiglianza semantica. Gli embedding strettamente correlati tra loro avranno, in una certa misura, una distanza minore nello spazio vettoriale.
Quando il database vettoriale riceve una query, usa algoritmi di approximate nearest neighbor (ANN) per recuperare gli embedding più simili senza analizzare l'intero database.
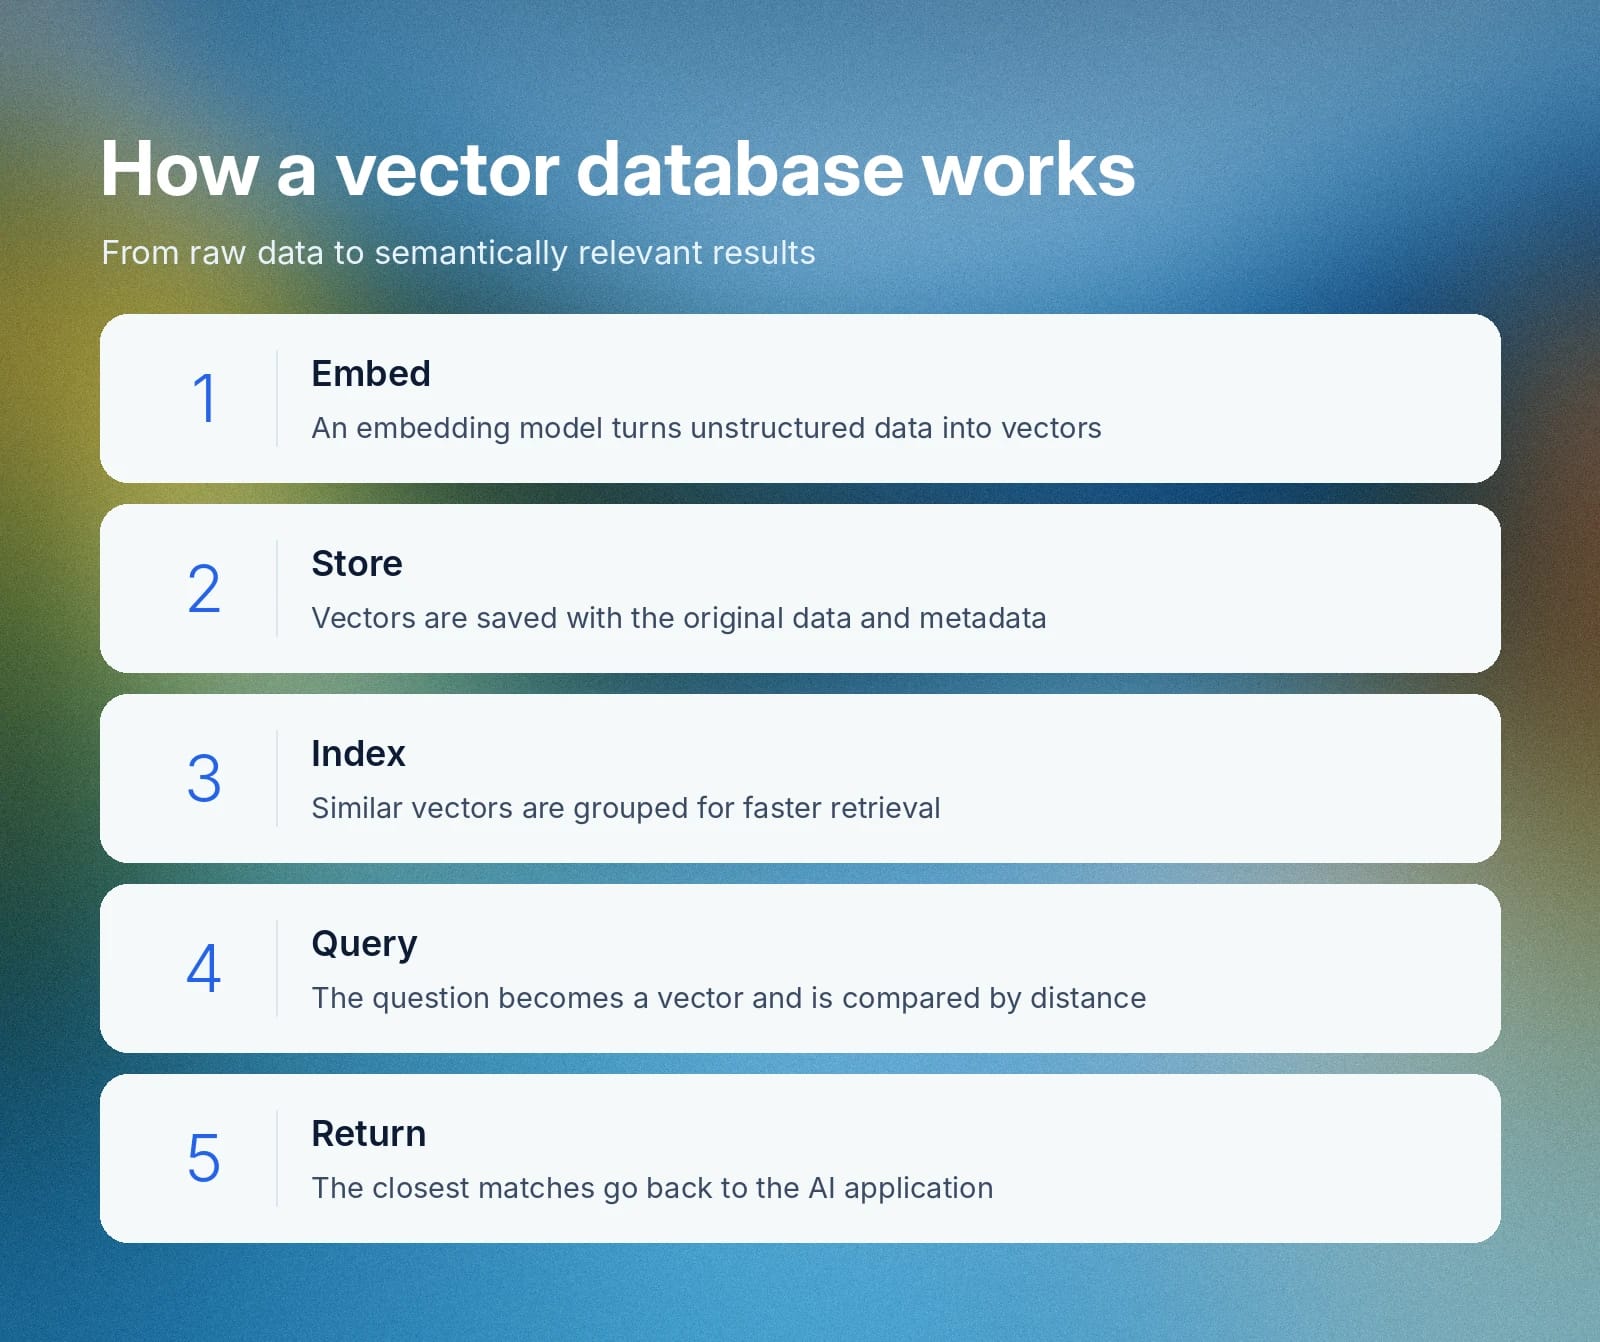
Queste sono le fasi per configurare un database vettoriale e recuperare dati da esso.
Archiviazione degli embedding
Innanzitutto, un modello di embedding converte i dati non strutturati in embedding. Ogni embedding rappresenta caratteristiche che esprimono il significato semantico dell'oggetto reale. Poi, il sistema archivia gli embedding, insieme ai dati originali e ai metadati, nel database vettoriale.
Poiché gli embedding con significato simile sono vicini nello spazio vettoriale, il database può recuperare corrispondenze pertinenti misurando la distanza tra i vettori.
Indicizzazione per un recupero più rapido
L'indicizzazione è un processo che organizza gli embedding vettoriali per migliorare l'efficienza del recupero. I database vettoriali usano diverse tecniche di indicizzazione per raggruppare embedding strettamente correlati. Per esempio, un database vettoriale può usare una struttura a elenco, grafo o albero, in base ai requisiti di recupero.
Oltre all'indicizzazione, il database vettoriale può comprimere i dati tramite una tecnica chiamata quantizzazione del prodotto. La quantizzazione del prodotto comprime gli embedding in codici compatti, risparmiando memoria a fronte di una lieve perdita di precisione nella ricerca.
Interrogare dati semanticamente pertinenti
Quando riceve una query, il database vettoriale la trasforma in un embedding. Quindi confronta l'embedding della query con quelli archiviati nel database multidimensionale dei vettori, usando tecniche come la similarità del coseno, il prodotto scalare e la distanza euclidea.
In base ai risultati, il database vettoriale restituisce gli embedding con il punteggio di somiglianza semantica più vicino, che le applicazioni di IA generativa usano per arricchire le proprie risposte. Insieme, archiviazione, indicizzazione e interrogazione consentono al database di restituire rapidamente risultati pertinenti.
Come la ricerca vettoriale e la ricerca per somiglianza restituiscono risultati pertinenti
La ricerca per somiglianza è un'ampia categoria di sistemi di corrispondenza delle informazioni. Include approcci basati su parole chiave, che corrispondono alle parole esatte di una query, e la ricerca vettoriale, che si basa sul significato.
La ricerca vettoriale usa un database vettoriale per restituire risposte semanticamente correlate. Anziché eseguire una ricerca esatta per parole chiave, confronta la distanza tra la query e i possibili risultati per scegliere quello più appropriato.
Spesso, il database vettoriale usa i metadati per prefiltrare gli embedding prima di eseguire una ricerca per somiglianza. Per esempio, restringe la ricerca filtrando gli embedding entro uno specifico intervallo temporale. In questo modo, il recupero è più rapido.
Casi d'uso dei database vettoriali per l'IA vocale e l'assistenza clienti
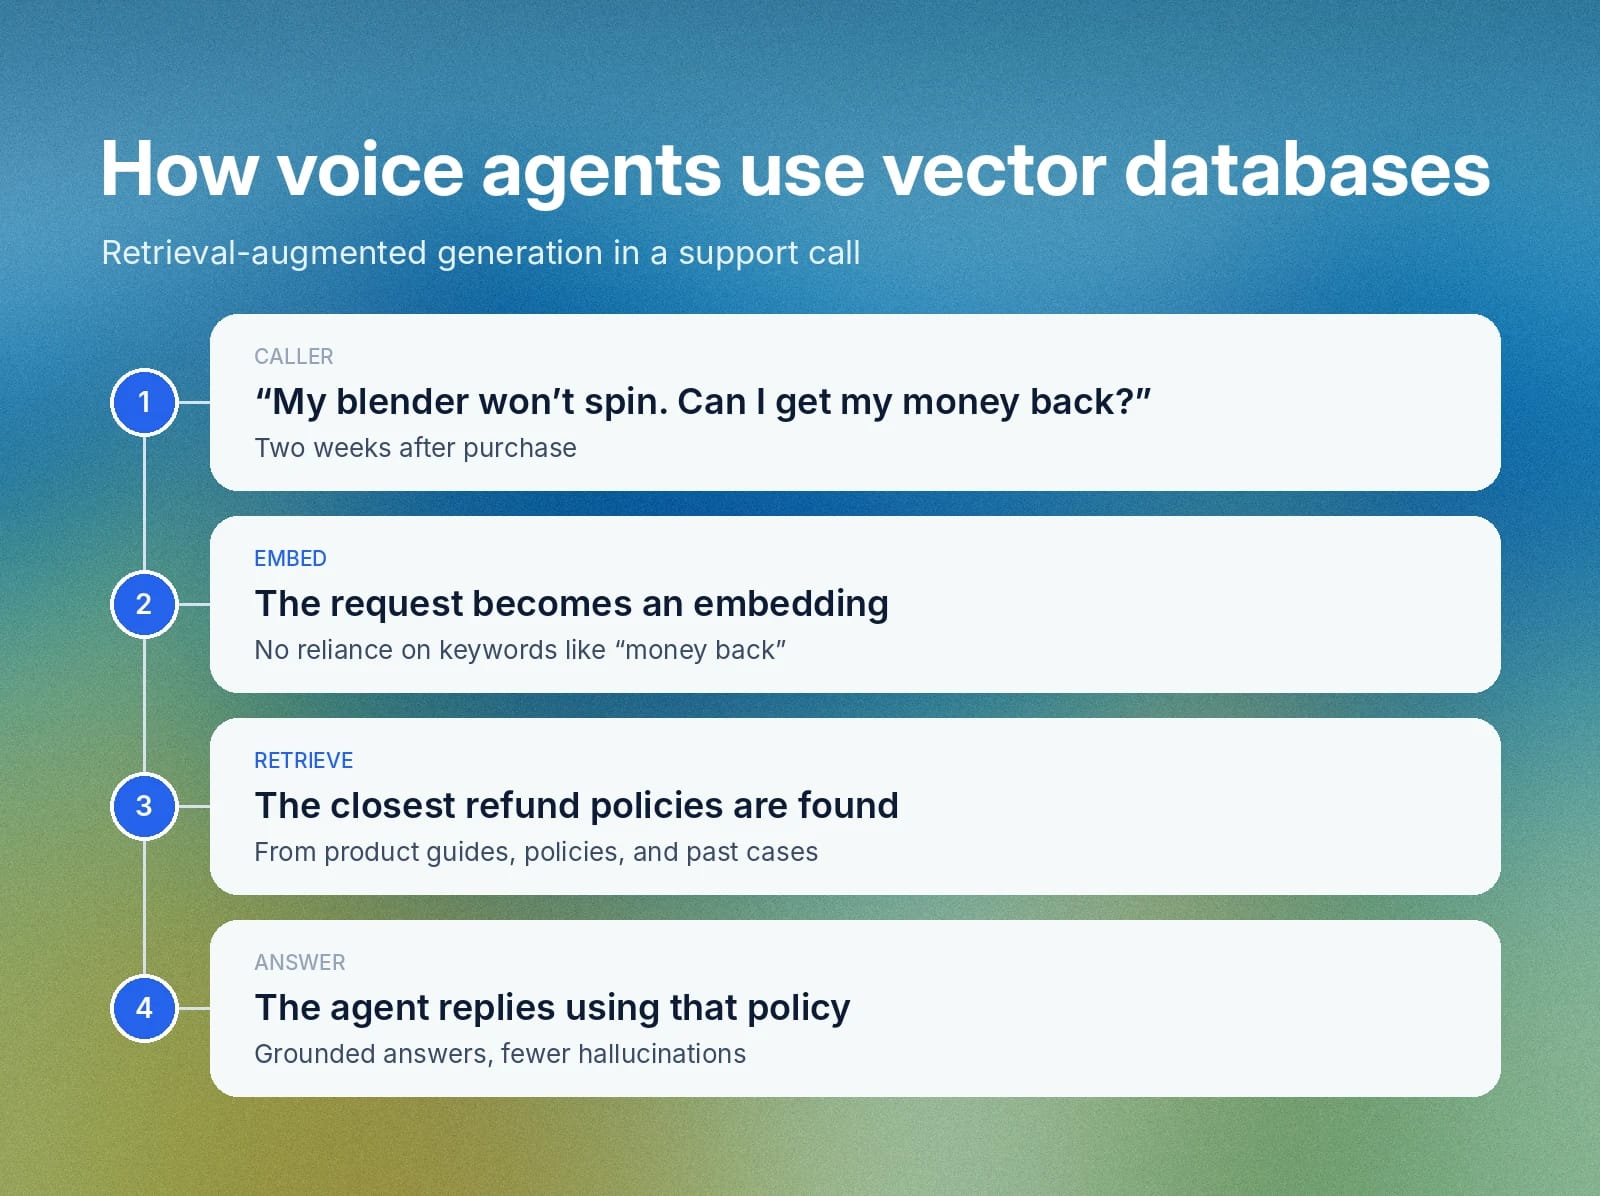
I database vettoriali aiutano i team di assistenza clienti a implementare IA vocale e chatbot in grado di rispondere con una conoscenza accurata dei prodotti. In un sistema di assistenza clienti basato sull'IA, il database vettoriale archivia knowledge base proprietarie, come guide ai prodotti, policy aziendali e casi dei clienti.
L'agente IA si collega al database vettoriale tramite un sistema di generation (RAG) aumentata dal recupero .
Quando l'agente vocale IA riceve una query, verifica se dispone di informazioni sufficienti per rispondere al cliente. Se non ha dati aggiornati o sufficienti, il RAG recupera dati semanticamente corrispondenti per integrare la risposta.
Supponiamo che un agente vocale riceva il seguente reclamo: "Il mio frullatore non gira più dopo due settimane. Posso avere un rimborso?" Anziché cercare parole chiave esatte come "non gira" e "rimborso", il RAG trasforma la richiesta in un embedding. Quindi recupera le policy di rimborso con il significato più vicino.
Recuperando documenti interni pertinenti, un sistema RAG supportato da un database vettoriale aiuta a ridurre le allucinazioni negli agenti vocali, anche se non le elimina. Anziché fare supposizioni, sia gli agenti IA sia quelli umani possono usare documenti interni per risolvere le richieste dei clienti.
Database vettoriale e database relazionale: differenze principali
Un database relazionale usa righe e colonne, insieme a uno schema fisso, per archiviare i dati. Un database vettoriale usa invece embedding, che rappresentano dati non strutturati.
I database relazionali sono adatti alle corrispondenze esatte e alle query strutturate, come trovare ogni ordine effettuato in una determinata data. I database vettoriali, invece, recuperano gli embedding archiviati più vicini nel significato a una query, risultando più efficaci per le domande in linguaggio naturale.
Nella maggior parte dei casi, i team useranno entrambi, perché ciascuno ha il proprio ruolo nel lavoro con i dati.
Database vettoriale e database a grafo: quando usare ciascuno
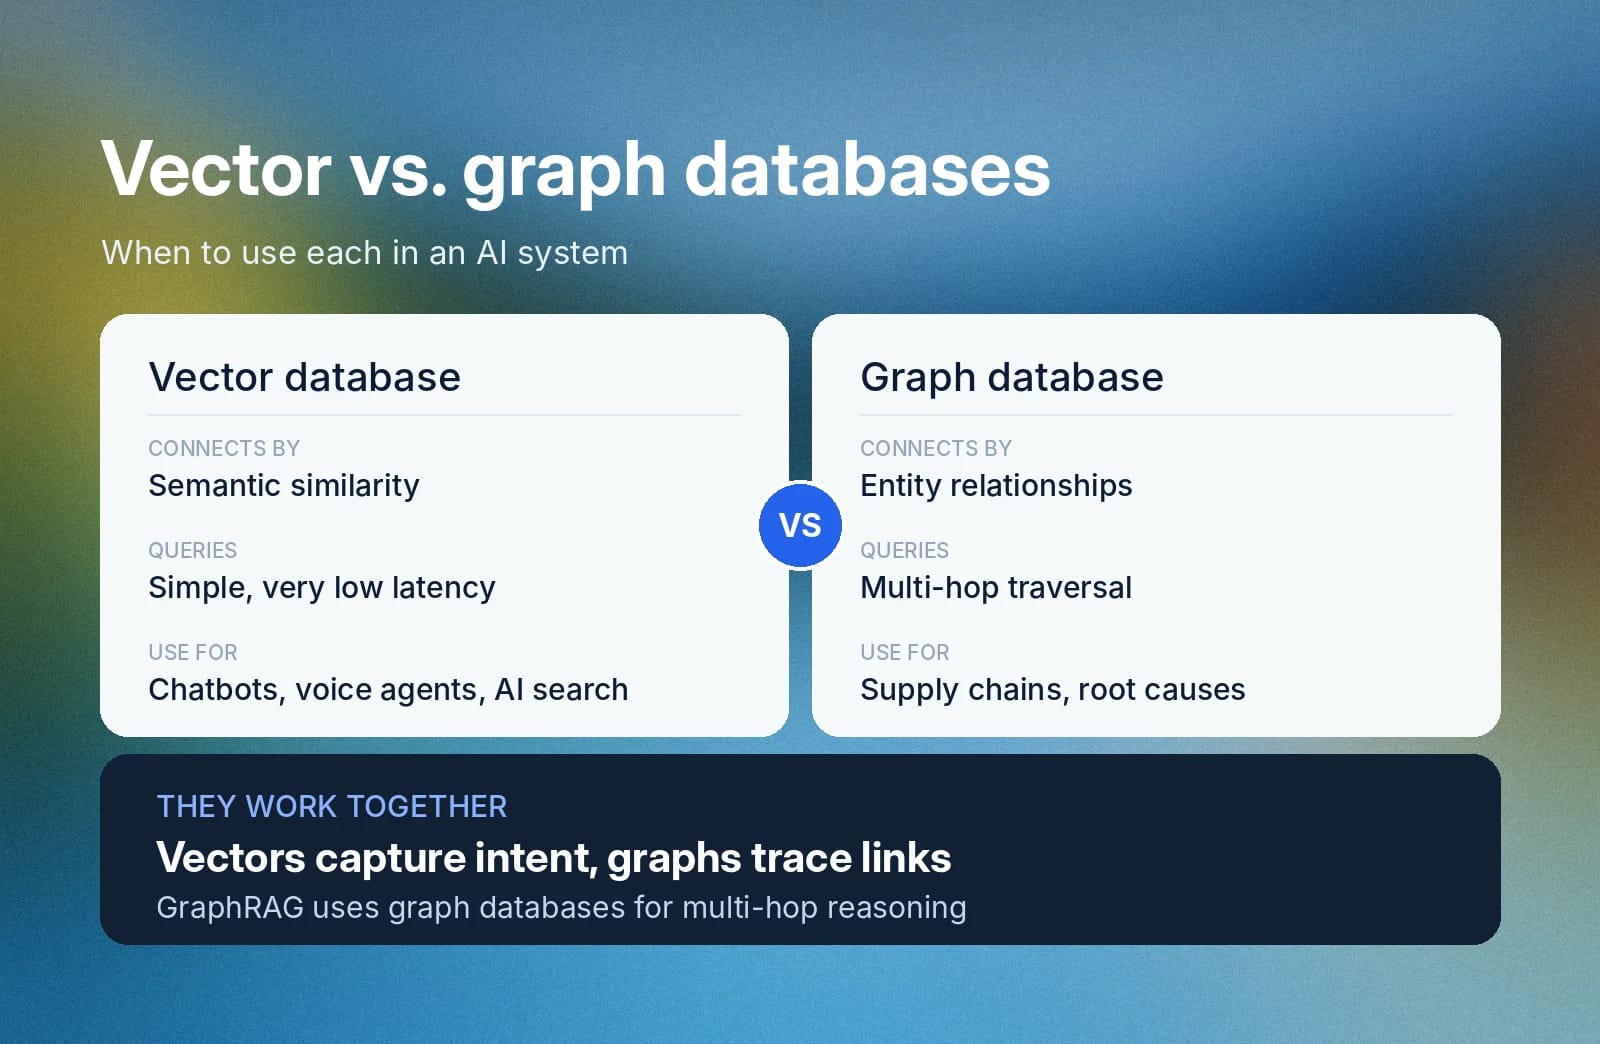
I database a grafo usano grafi di conoscenza per collegare diverse entità in modi che ne riflettono la gerarchia e le relazioni. Sistemi IA come GraphRAG usano database a grafo per rispondere a query che richiedono ragionamenti multi-hop.
Quando interroghi un database a grafo, individua il punto dati iniziale e usa un algoritmo di attraversamento del grafo per trovare entità correlate. Per esempio, i nomi dei clienti possono essere collegati in sequenza alle date di rinnovo e ai ticket di assistenza.
I database vettoriali, invece, archiviano dati non strutturati con rappresentazioni numeriche basate sul loro significato semantico. Consentono ai sistemi RAG di eseguire semplici corrispondenze delle query con latenza molto bassa. Per esempio, un database vettoriale restituisce la policy di rimborso quando elabora "Voglio un rimborso".
Sia i database vettoriali sia quelli a grafo sono utili per i sistemi IA. Puoi usarli insieme:
- Usa un database vettoriale se vuoi alimentare un chatbot, un agente vocale o un motore di ricerca IA che deve comprendere l'intento espresso in linguaggio umano.
- Usa un database a grafo se vuoi risolvere problemi di interdipendenza, come tracciare catene di fornitura, consigliare prodotti pertinenti o eseguire un'analisi della causa principale.
Quali tipi di database vettoriali sono disponibili?
In generale, esistono due tipi di database vettoriali, differenziati dal loro stile architetturale.
- Database vettoriale standalone: sono database indipendenti e progettati per uno scopo specifico, che supportano ricerche di somiglianza multidimensionali a bassa latenza. Molte applicazioni di IA generativa si collegano a database vettoriali standalone per scalare carichi di lavoro con molte query.
- Estensione per database vettoriale: i database esistenti possono introdurre funzionalità di ricerca vettoriale per consentire il recupero basato sulla semantica per i modelli IA. Questi database mantengono la loro architettura originale, come uno schema SQL basato su righe, ma supportano tipi di dati vettoriali.
La scelta dipende principalmente dal fatto che ti serva un sistema dedicato per grandi carichi di query oppure che tu voglia aggiungere un elemento di ricerca semantica a un database già in uso.
Esempi di database vettoriali
Ecco due esempi di database vettoriali:
- Database vettoriali standalone: Pinecone è un servizio gestito di database vettoriale. Milvus, Weaviate, Qdrant e Chroma sono database vettoriali open source.
- Estensioni per database vettoriali: pgvector aggiunge la ricerca per somiglianza vettoriale a PostgreSQL e MongoDB Atlas Vector Search la aggiunge a MongoDB.
La scelta più adatta dipende dalla tua scala e da quanta infrastruttura vuoi gestire.
Inizia con ElevenAgents per agenti vocali pronti al recupero delle informazioni
ElevenAgents consente agli agenti vocali di recuperare informazioni dalla tua knowledge base per fornire risposte conversazionali e consapevoli del contesto. Usando il RAG, l'agente recupera dai documenti, URL o testi che aggiungi alla knowledge base i contenuti semanticamente più simili. Puoi impostare il recupero su "On demand", così l'agente cerca nella knowledge base quando decide di averne bisogno.
Comprensibilmente, implementare il RAG aumenta la latenza di generazione delle risposte. Tuttavia, grazie ai nostri progressi ingegneristici, abbiamo ridotto la latenza mediana del RAG di ElevenAgents da 326 ms a 155 ms.
Inizia con ElevenAgents e scopri come configurare qui la tua knowledge base.
Domande frequenti

Jack Limebear fa parte del team Growth e si occupa di scrivere contenuti e definire strategie per il blog e le pagine insights. Prima di arrivare in ElevenLabs, ha guidato la strategia dei contenuti per oltre dieci anni in realtà che vanno da startup SaaS in rapida crescita a grandi aziende Fortune 500. Ha conseguito un Master in Letteratura Inglese presso l’Università di Cambridge.


