Risolvi i problemi di accuratezza del Speech to Text con un workflow più efficace
- Scritto da
- Jack Limebear
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
L'accuratezza del Speech to Text (STT) dipende da tre fattori: la qualità dell'audio, il modo in cui parlano le persone e le parole che usano. Il rumore e una compressione elevata eliminano dettagli da una registrazione e persino i modelli più efficaci faticano con voci sovrapposte o gergo poco familiare. Questa guida mostra da dove nasce ogni problema di STT e come risolverlo.
Gli errori di trascrizione raramente restano confinati alla trascrizione. Un nome di farmaco frainteso in una nota clinica o un numero di conto errato nel registro di una chiamata si propaga in ogni sistema che utilizza quel testo, dalla ricerca e dall'analisi agli agenti IA che agiscono in base a quanto è stato detto. Una scarsa accuratezza aumenta anche i tempi di revisione, perché qualcuno deve individuare e correggere manualmente gli errori.
La buona notizia è che la maggior parte dei problemi di accuratezza dell'STT si può risolvere. Molte di queste soluzioni richiedono solo piccole modifiche alle configurazioni o alle impostazioni di registrazione esistenti, quindi puoi risolvere il problema senza dover cambiare le impostazioni del modello.
Questo argomento può anche essere chiamato accuratezza del riconoscimento vocale, accuratezza ASR o accuratezza della trascrizione. Speech to Text, riconoscimento vocale e riconoscimento vocale automatico (ASR) descrivono tutti lo stesso processo di conversione dell'audio parlato in testo scritto. Le soluzioni di questa guida valgono indipendentemente dal termine che usi.
Riepilogo
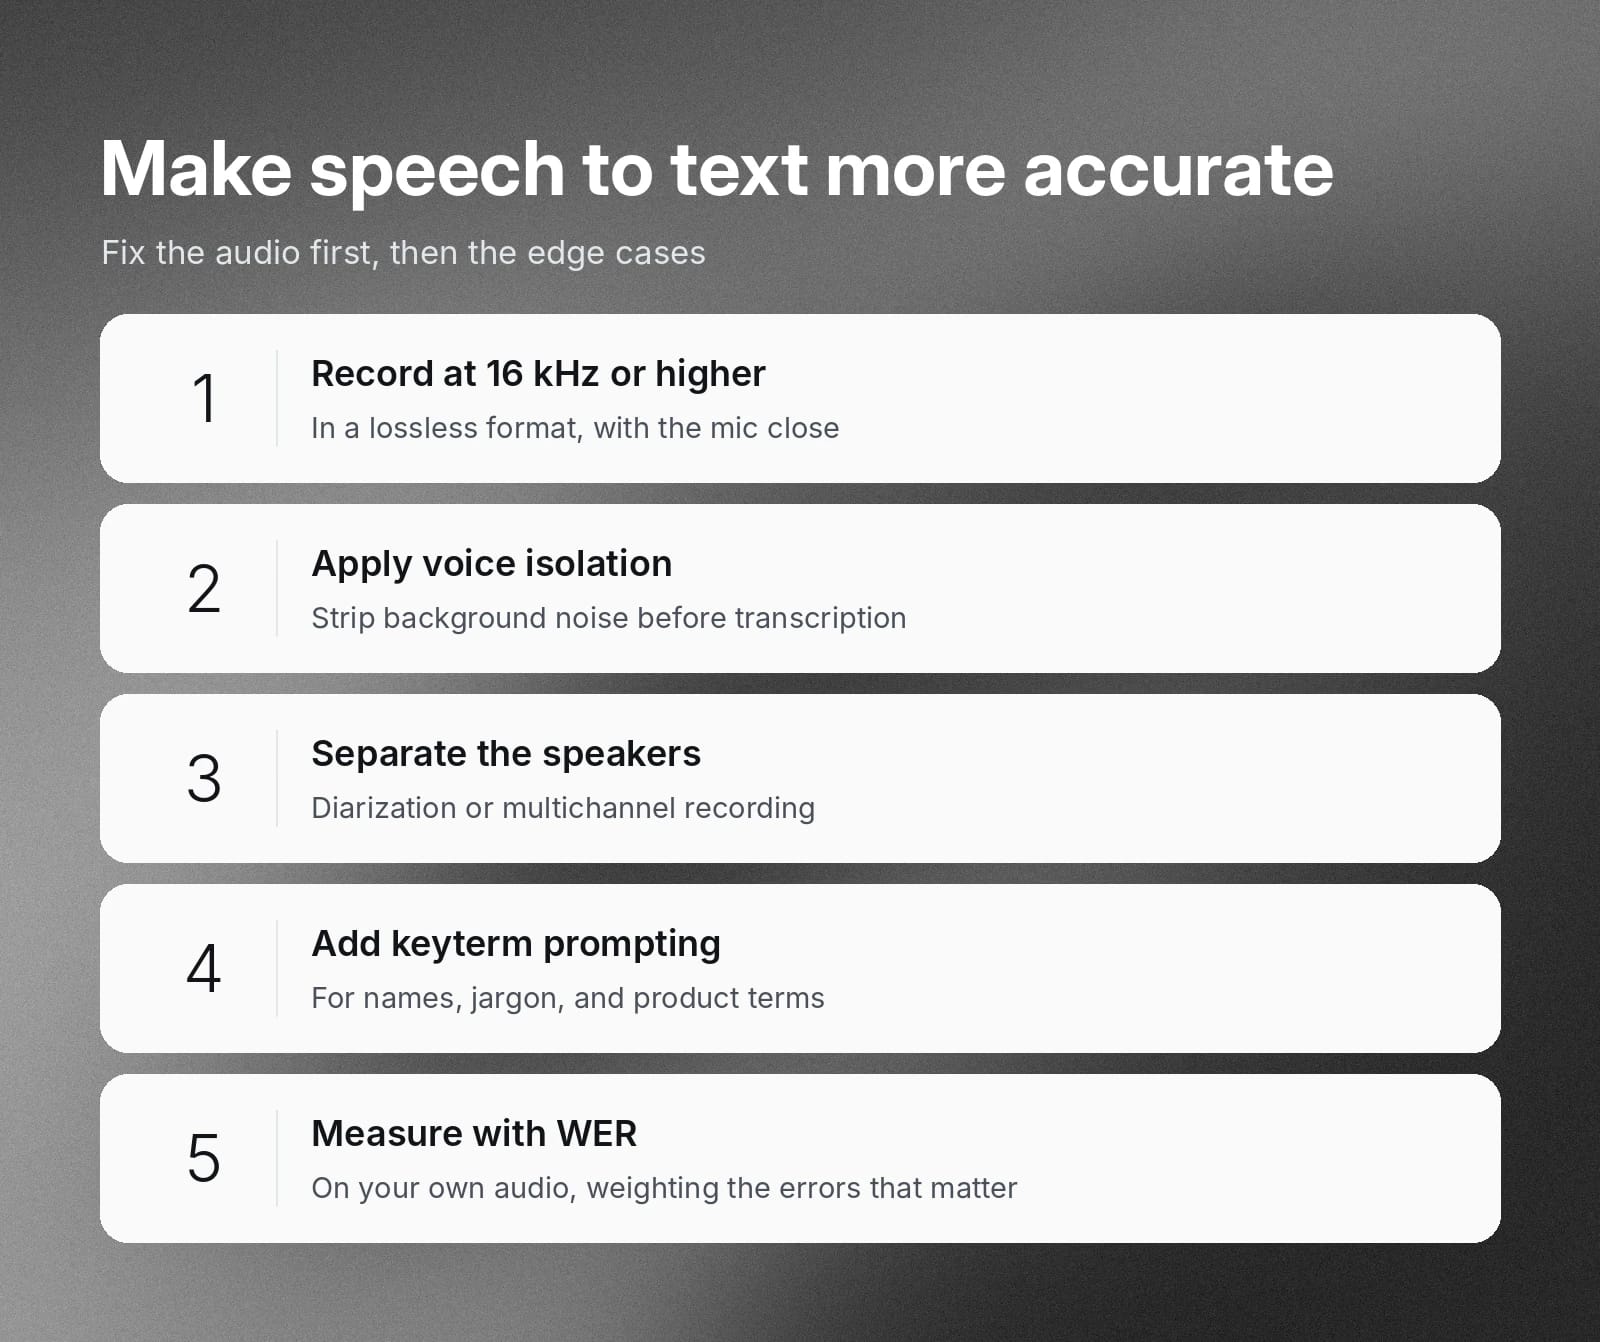
- L'accuratezza del Speech to Text dipende dalla qualità dell'input audio, dalla dinamica dei parlanti e da problemi lessicali e contestuali.
- Per risolvere un problema di accuratezza, individua in quale punto della pipeline (input, elaborazione o output) puoi intervenire.
- Registra a 16 kHz o più, usa formati lossless e posiziona i microfoni a una distanza di 10-15 cm dal parlante.
- Usa l'isolamento vocale, la diarizzazione o la registrazione multicanale, nonché il keyterm prompting, per gestire rumore, parlanti sovrapposti e vocabolario specialistico.
- Misura l'accuratezza con il tasso di errore delle parole (WER) e verifica quali errori contano di più per il tuo caso d'uso.
Quali sono le cause dei problemi di accuratezza del Speech to Text?
Immagina che qualcuno ti chieda di trascrivere una registrazione audio di un professore dal forte accento che descrive concetti complessi di fisica teorica, registrata in un ristorante affollato con musica di sottofondo e chiacchiericcio ambientale. I sistemi informatici digitali non sono naturalmente predisposti alla variabilità acustica. Servono addestramento e fine-tuning significativi per far funzionare efficacemente l'STT e, anche se gli strumenti di IA moderni sono molto efficaci, molti fattori possono ancora influire sull'output. Comprendendoli, però, puoi affrontarli nei tuoi workflow di trascrizione.
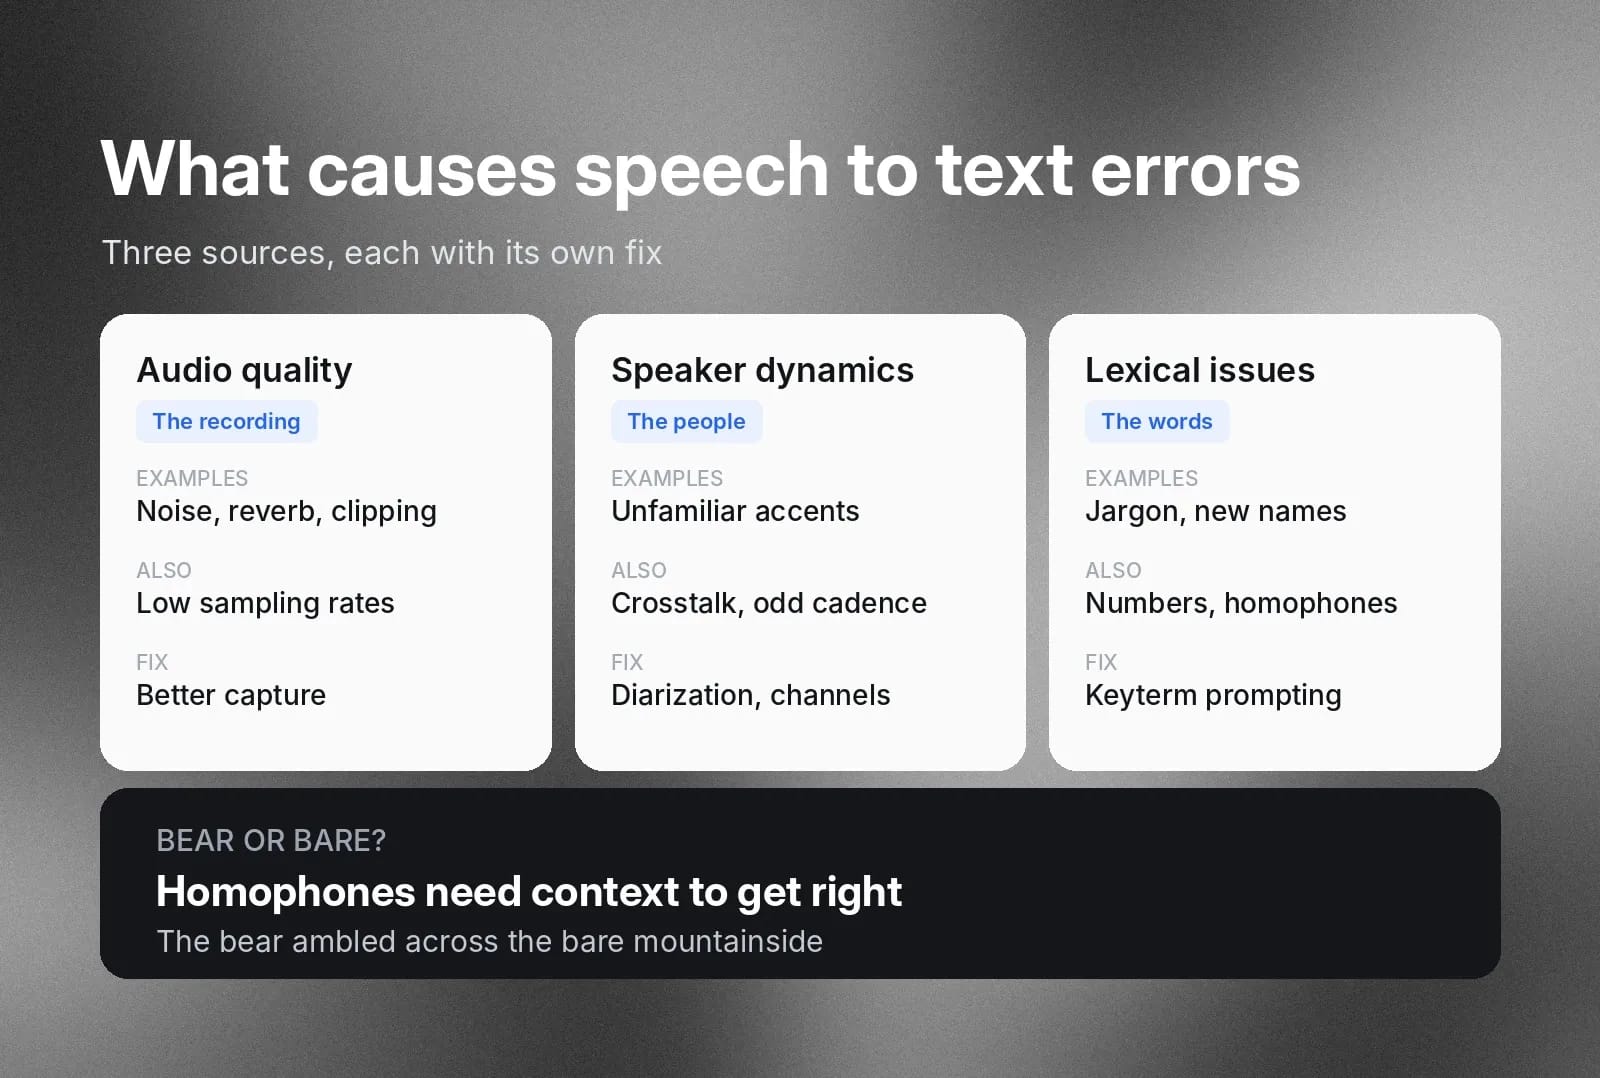
Le cause principali di una conversione Speech to Text inaccurata sono tre:
- Problemi con la qualità dell'input audio
- Dinamica dei parlanti
- Problemi lessicali e contestuali
Ogni causa richiede una soluzione diversa, descritta a seguire nelle sezioni dedicate.
Problemi di qualità audio
La registrazione audio stessa può presentare problemi. I problemi del microfono possono distorcere o troncare il parlato. Il riverbero dovuto all'acustica dell'ambiente, un basso rapporto segnale-rumore (SNR) nella registrazione o una bassa frequenza di campionamento possono tutti eliminare importanti informazioni fonetiche dalle registrazioni.
Dinamica dei parlanti
Un singolo parlante con un accento neutro, in un ambiente silenzioso, sarà relativamente facile da trascrivere. Ma raramente è questo il tipo di registrazione che vogliamo trascrivere. Accenti poco familiari, un ritmo di parlato spezzato o comunque non tradizionale possono confondere un modello STT addestrato su un parlato standardizzato. Anche conversazioni incrociate o parlanti sovrapposti possono compromettere la capacità del modello di interpretare accuratamente ciò che viene detto.
Problemi lessicali e contestuali
Infine, anche il contenuto del parlato può mettere in difficoltà alcuni modelli STT. Il gergo di settore e i nuovi nomi di prodotti potrebbero non essere termini incontrati dal modello STT durante l'addestramento. Poiché seleziona l'output statisticamente più probabile, un parlato poco familiare potrebbe non essere tra le previsioni principali. Anche espressioni numeriche o matematiche, o un parlato che altrimenti sarebbe scritto in forma numerica, potrebbero non essere trascritti chiaramente.
Gli omofoni sono parole che suonano allo stesso modo ma si scrivono diversamente. Un modello STT deve comprendere sufficientemente il contesto per distinguerle. Per esempio, in inglese “the bear ambled across the bare mountainside.” Il modello deve sapere che l'animale si scrive “bear” e che l'aggettivo per una superficie scoperta si scrive “bare”.
Come risolvere i problemi di accuratezza del Speech to Text dall'audio all'output
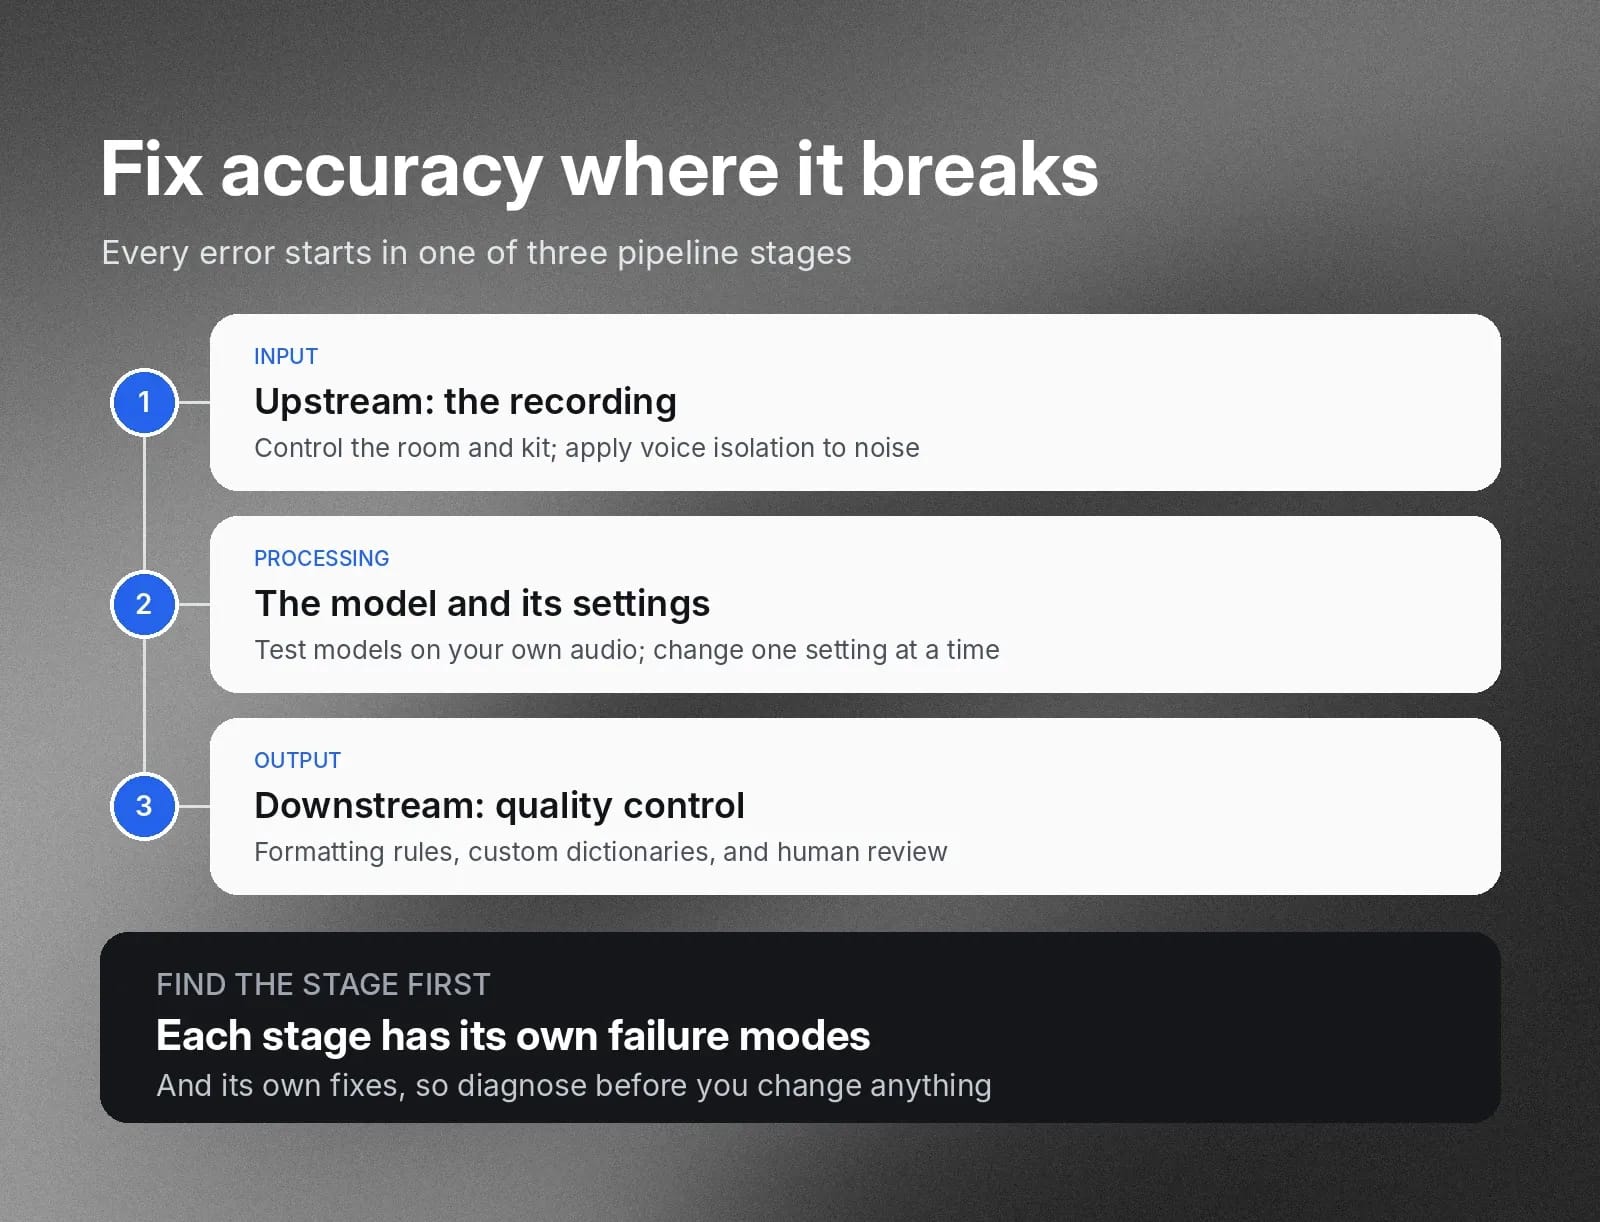
L'elaborazione Speech to Text avviene attraverso una serie di passaggi ben definiti. Per risolvere un problema di accuratezza, devi identificare in quale punto della pipeline puoi intervenire. In generale, il processo STT si suddivide in:
- Input
- Elaborazione
- Output
Ogni fase ha modalità di errore e soluzioni proprie.
Problemi di accuratezza nell'input a monte
Potrebbero esserci problemi nell'ambiente in cui registri. Tra i più comuni ci sono il rumore di fondo e l'eco. Anche l'attrezzatura di registrazione può essere all'origine del problema se è difettosa.
Risolvere i problemi in questa fase di solito significa isolare la causa e correggerla. Ad esempio, se sai che lo strumento STT ha difficoltà con rumori di fondo forti, è una buona idea svolgere le conversazioni in un ambiente su cui hai maggiore controllo.
Per qualsiasi rumore che non puoi evitare, applica l'isolamento vocale prima che l'audio raggiunga il modello.
Problemi di accuratezza nell'elaborazione
Il modo in cui configuri la tua API per un motore STT può influire sull'elaborazione. Anche la struttura del prompt e il modello scelto possono influire sulla qualità e sul numero di imprecisioni.
Risolvere i problemi in questa fase significa testare la configurazione con il tuo audio. Esegui le stesse registrazioni campione con ogni modello candidato, confronta i rispettivi tassi di errore delle parole e modifica un'impostazione alla volta per perfezionare il risultato.
Se un modello continua a non riconoscere un tipo di parlato, come una chiamata rumorosa o un certo accento regionale, testa modelli diversi per valutarne l'accuratezza nell'esatto ambiente in cui li utilizzerai.
Problemi di accuratezza nell'output a valle
Questo è il livello di controllo qualità, in cui processi specializzati correggono gli errori e le ambiguità di trascrizione che il motore principale potrebbe non aver rilevato. Le pipeline STT usano regolarmente il matching di pattern basato su regole per standardizzare la formattazione, ad esempio trasformando “dieci dollari” in “$10.00”, un processo chiamato normalizzazione inversa del testo (ITN). Tuttavia, se un parlante usa uno di questi termini in modo non standard o lo pronuncia male, uno strumento rigido di ricerca e sostituzione non lo rileverà.
C'è anche da valutare se un operatore umano nel loop (HITL) controlli la qualità dell'output. Altrimenti, le imprecisioni potrebbero arrivare nell'output di produzione. Come per qualsiasi attività svolta da una persona, esiste la possibilità di errore umano.
In questa fase, risolvere i problemi significa intercettare gli errori lasciati dai motori principali. Puoi confrontare le trascrizioni con un campione di riferimento per individuare gli errori ricorrenti, quindi aggiungere regole mirate o un dizionario personalizzato per quei termini. Soprattutto per le trascrizioni ad alta criticità, aggiungi sempre una fase di revisione umana.
Come migliorare l'accuratezza del riconoscimento vocale con un audio migliore
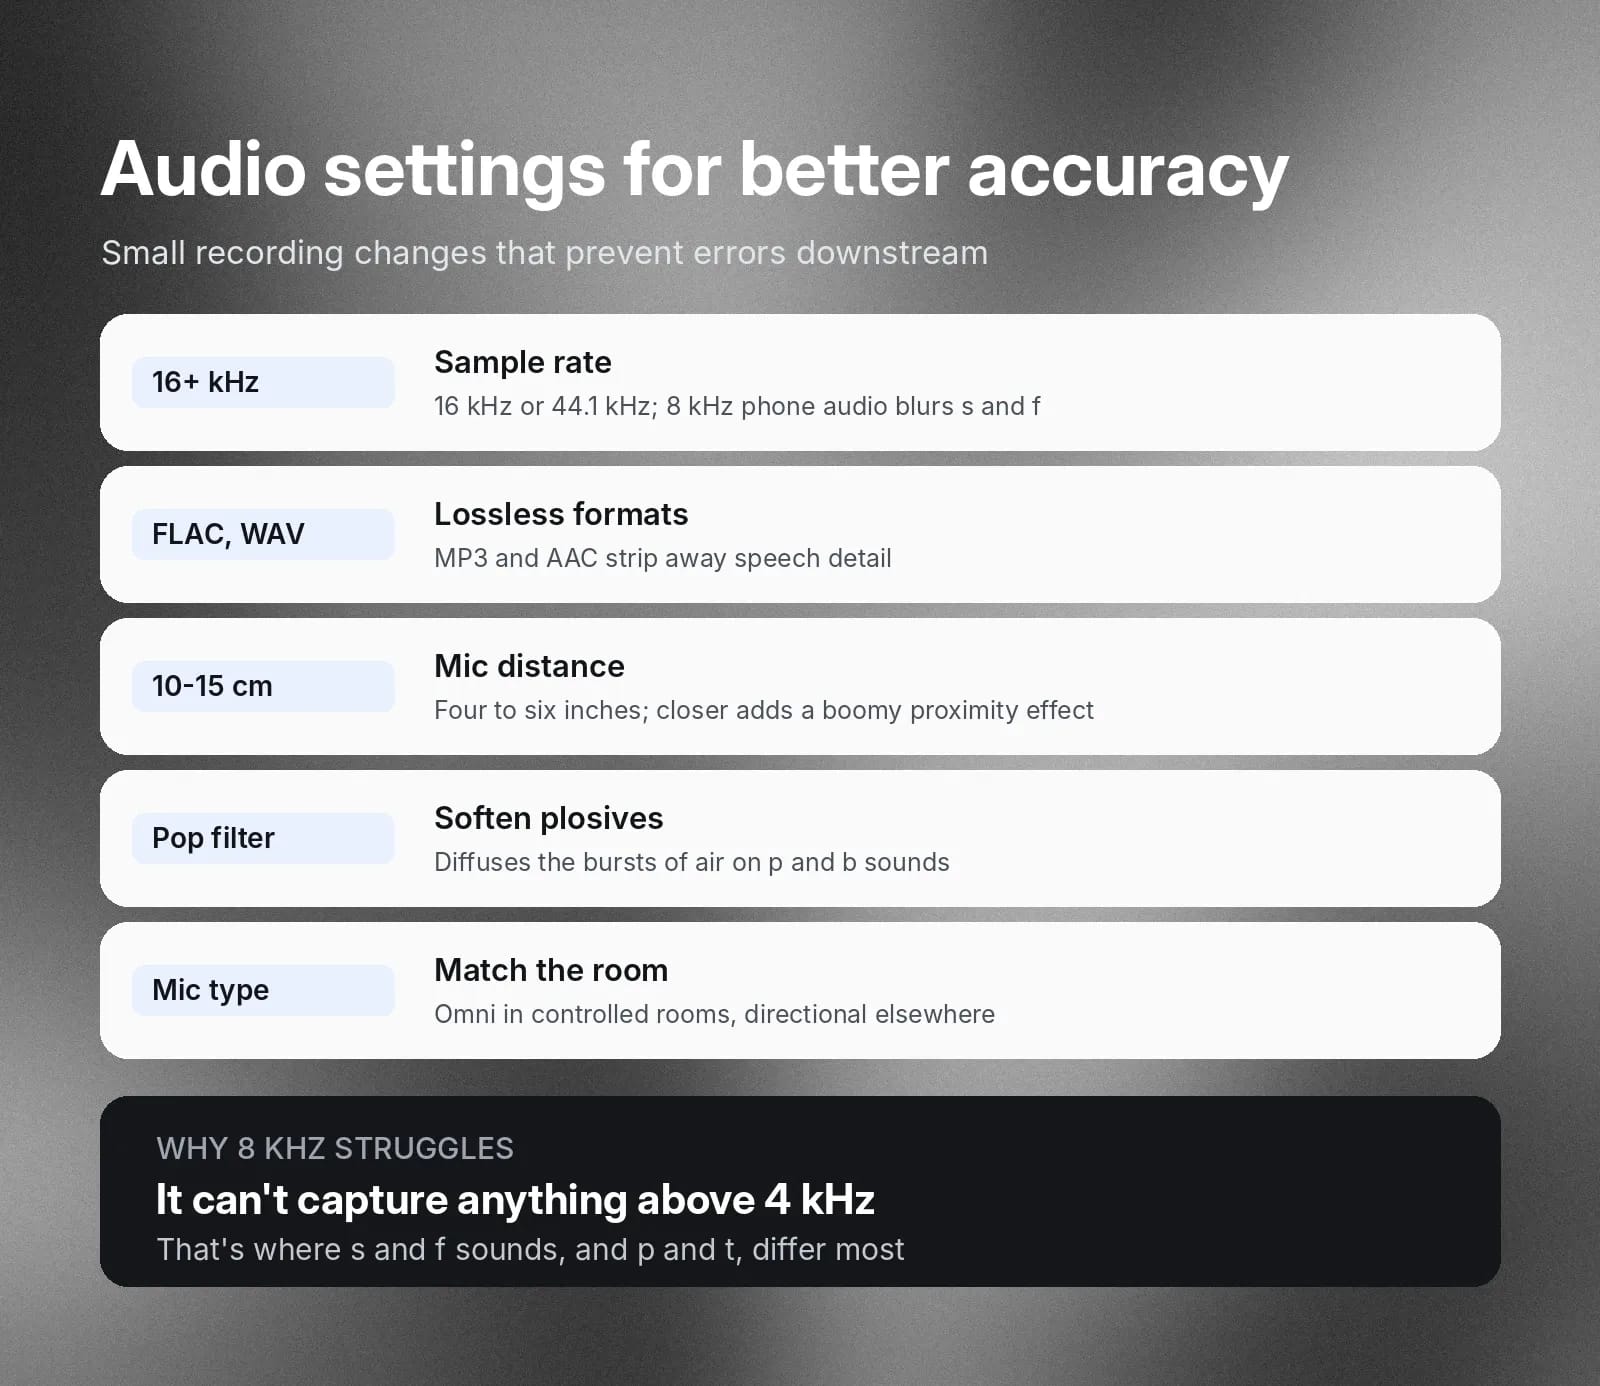
Migliorare la qualità audio durante la registrazione può ridurre molti problemi di accuratezza a valle. Usa una frequenza di campionamento più elevata, applica poca o nessuna compressione e mantieni l'ambiente di registrazione più nitido possibile.
Qualità del campionamento
Per la registrazione usa audio a 16 kHz o 44,1 kHz. Il campionamento audio telefonico tradizionale a 8 kHz o inferiore può essere difficile da interpretare per i modelli STT. Per i modelli suona ovattato e confuso, e non possono chiedere ai parlanti di ripetere come farebbe una persona al telefono.
Una frequenza di campionamento può riprodurre solo frequenze fino alla metà del proprio valore. Questa è chiamata frequenza di Nyquist del sistema. A soli 8 kHz, verrebbe escluso tutto ciò che supera i 4 kHz e sarebbe particolarmente difficile per un modello STT distinguere tra fricative, come i suoni “s” e “f”, e occlusive, come i suoni “p” e “t”.
Compressione
La registrazione in formati lossy, come MP3 e AAC, può eliminare anche le sfumature del parlato. Il modello dispone di meno segnale su cui lavorare. Preferisci formati lossless o non compressi, come FLAC o PCM WAV.
Ambiente di registrazione
Segui le best practice dell'ingegneria audio per l'uso dei microfoni. I microfoni omnidirezionali funzionano meglio in ambienti controllati. Altrimenti, i microfoni direzionali sono più indicati per isolare il parlato. Posiziona i microfoni a 10-15 cm dalla bocca del parlante e cerca di evitare che si avvicini ulteriormente, poiché questo crea un effetto di prossimità e rende fangosa la registrazione amplificando le basse frequenze.
Quando possibile, usa anche un filtro anti-pop sul microfono. I filtri anti-pop diffondono i soffi d'aria prodotti quando si pronunciano consonanti occlusive, ad esempio i suoni “p” e “b”.
Riduci il rumore di fondo per un migliore riconoscimento vocale
Come indicato nella sezione precedente, usa la registrazione con microfono ravvicinato ogni volta che è possibile, idealmente a 10-15 cm dalla bocca del parlante. Evita il rumore bianco e i rumori di fondo che rendono torbide le registrazioni. Fonti comuni che potresti non notare senza esperienza nelle registrazioni sul campo includono il ronzio degli impianti HVAC, i clic della tastiera e il rumore generale della strada. Tutti questi elementi possono rendere più difficile per un modello STT interpretare il parlato.
Tuttavia, spesso non è possibile evitare il rumore di fondo: in questo caso, applica l'isolamento vocale come fase di pre-elaborazione prima di inviare l'audio a un modello STT. L'isolamento vocale utilizza algoritmi software o un modello neurale leggero e specializzato per filtrare l'audio di fondo dalle registrazioni vocali.
Gestisci accenti, parlanti sovrapposti e vocabolario specialistico
I moderni modelli multilingue sono addestrati su set di parlato diversi, ma i loro livelli di accuratezza variano ancora quando lavorano con audio del mondo reale. Esegui benchmark su modelli diversi usando campioni audio dei gruppi demografici pertinenti. Se disponi di chiamate di assistenza storiche da utilizzare, sottoponile alla trascrizione, scegliendo quelle con gli accenti, le cadenze e i modelli di parlato che desideri trascrivere nel mondo reale.
Controlla gli output per rilevare errori e individuare eventuali pattern pertinenti. Il modello ha difficoltà con lo slang usato dai gruppi di età più giovani? Inciampa su uno specifico accento regionale che incontri spesso?
Gestisci i parlanti sovrapposti
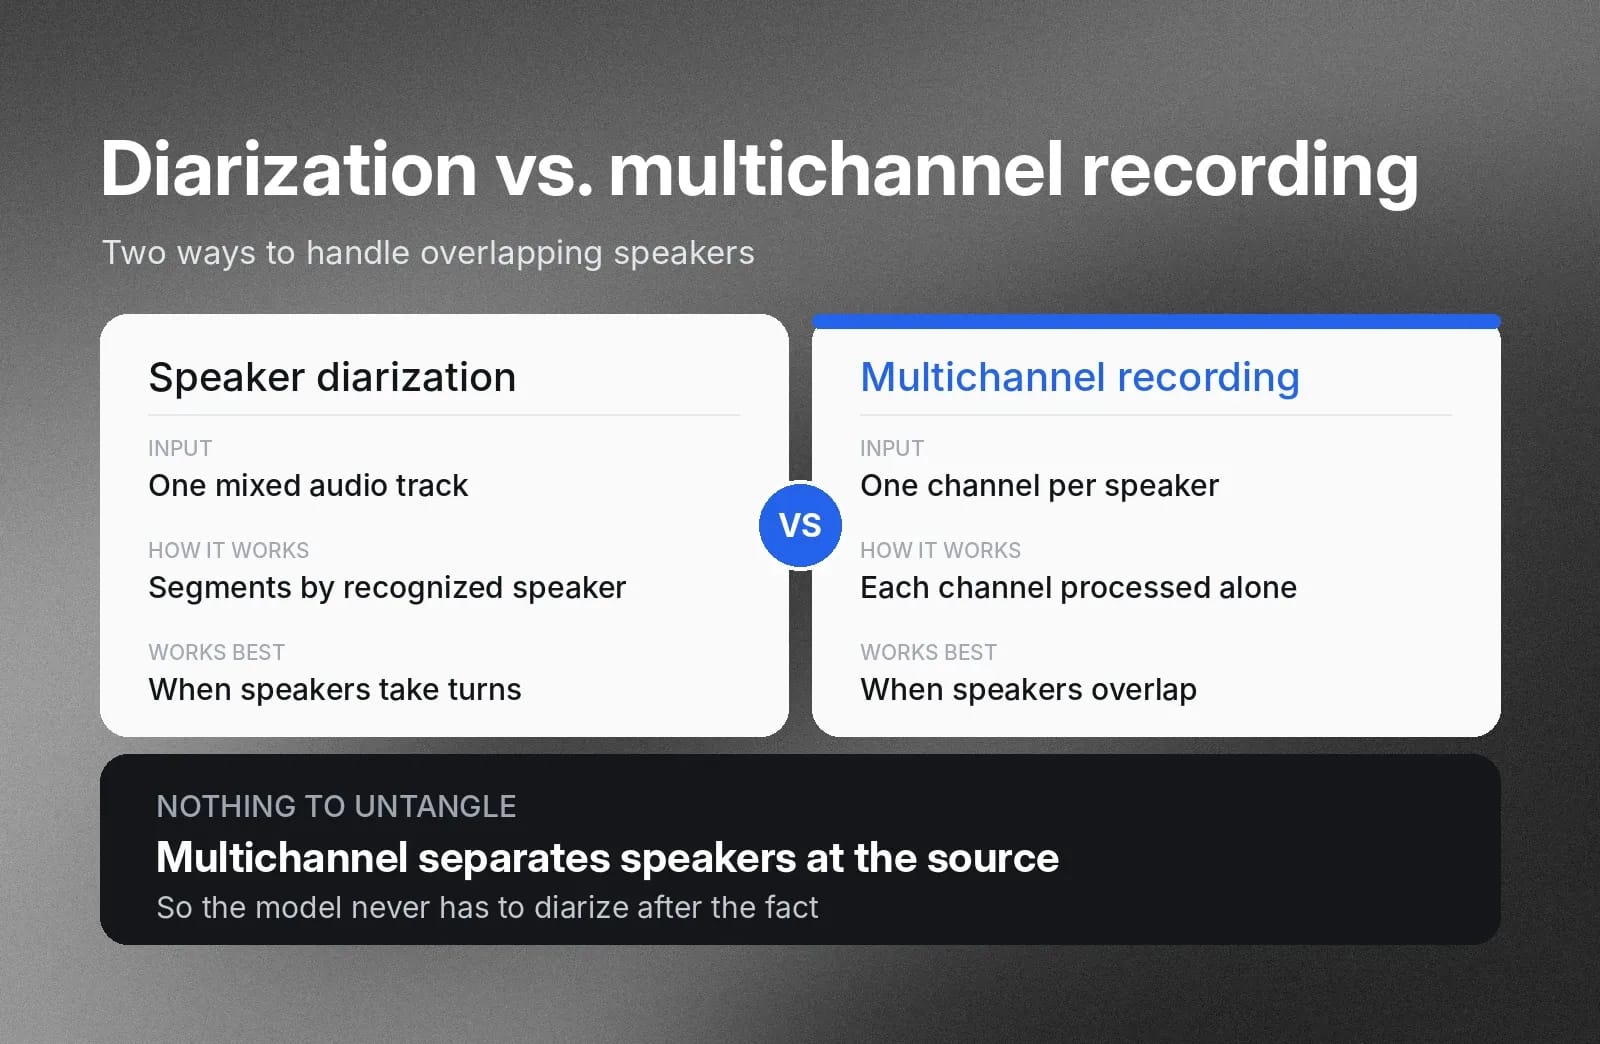
I due strumenti principali per trascrivere accuratamente il parlato sovrapposto sono la diarizzazione e la registrazione multicanale. Un processo di diarizzazione riceve un input audio grezzo e lo segmenta in base ai singoli parlanti riconosciuti. Funziona bene quando i parlanti si alternano chiaramente.
Invece di combinare tutti i flussi vocali in un'unica traccia audio, la registrazione multicanale nativa ti permette di mantenere ogni parlante su un canale separato, che il modello STT può identificare ed elaborare in modo indipendente. Ogni parlante è separato nativamente nella registrazione, quindi il modello vocale non deve eseguire una diarizzazione a posteriori.
Il keyterm prompting crea un bias positivo
Nomi di brand, nuovi nomi di prodotti, gergo di settore e altri termini univoci spesso non vengono trascritti correttamente se non erano presenti nei dati di addestramento di un modello STT. Il keyterm prompting consiste nel fornire a un modello STT grafie specifiche che vuoi favorire. In genere non si tratta di prompt di sostituzione uno a uno: indirizzi semplicemente il modello a selezionare la grafia personalizzata desiderata in base al contesto.
Trascrivi accuratamente numeri, ID e nomi di farmaci
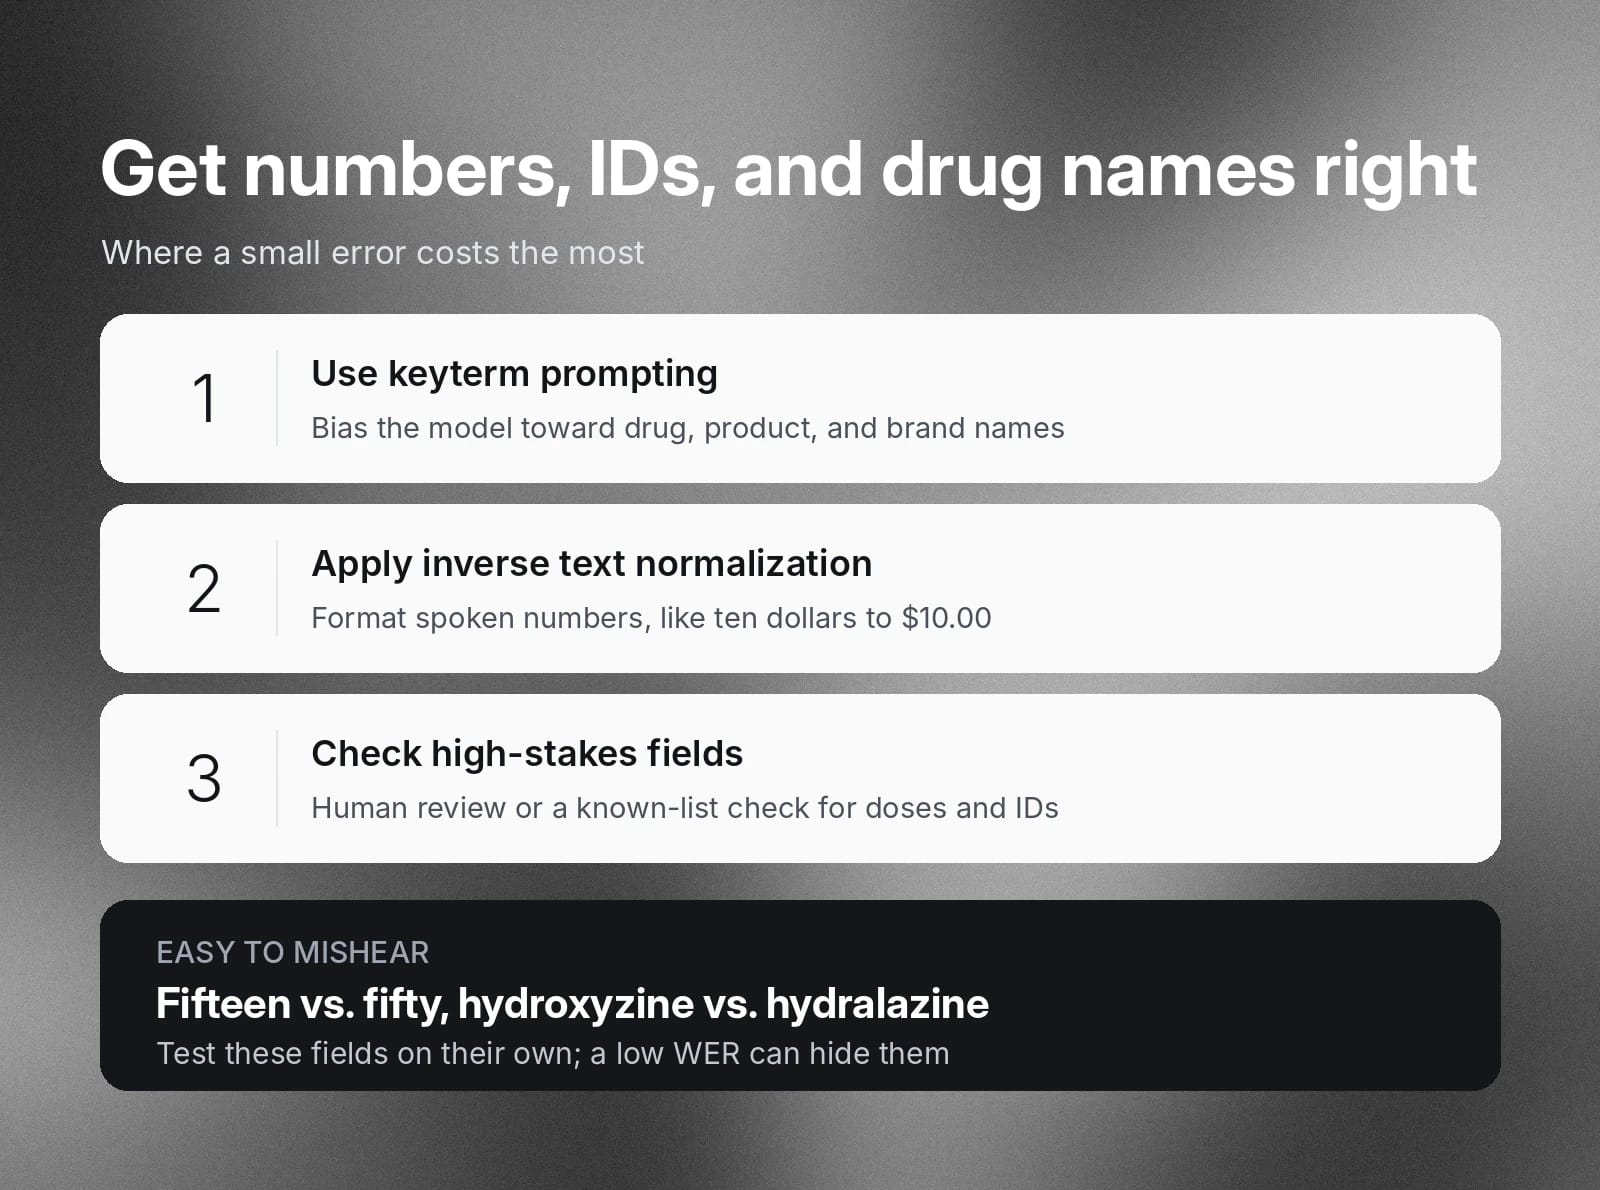
Numeri, ID di conto, codici postali e nomi di farmaci sono i casi in cui un piccolo errore costa di più. Un modello può sentire “quindici” come “cinquanta” o confondere due nomi di farmaci che differiscono di una sola sillaba, come idrossizina e idralazina.
Tre passaggi sono utili:
- Usa il keyterm prompting: indirizza il modello verso le grafie dei nomi di farmaci, dei nomi di prodotti e degli altri termini attesi.
- Applica la normalizzazione inversa del testo (ITN): formatta in modo coerente i numeri pronunciati, ad esempio trasformando “dieci dollari” in “$10.00”.
- Aggiungi un controllo per i campi ad alta criticità: usa una revisione umana o un controllo automatico rispetto a un elenco noto per campi quali dosaggi di farmaci e numeri di conto.
Testa questi campi separatamente, perché un WER complessivo basso può nascondere errori proprio nelle parole più importanti.
Misura la qualità con il tasso di errore delle parole nel riconoscimento vocale
Il tasso di errore delle parole (WER) è una metrica utile per valutare l'accuratezza di un motore STT. Puoi confrontare il WER tra i diversi test effettuati sui modelli per comprendere la loro accuratezza relativa.
Ecco come viene calcolato il WER:
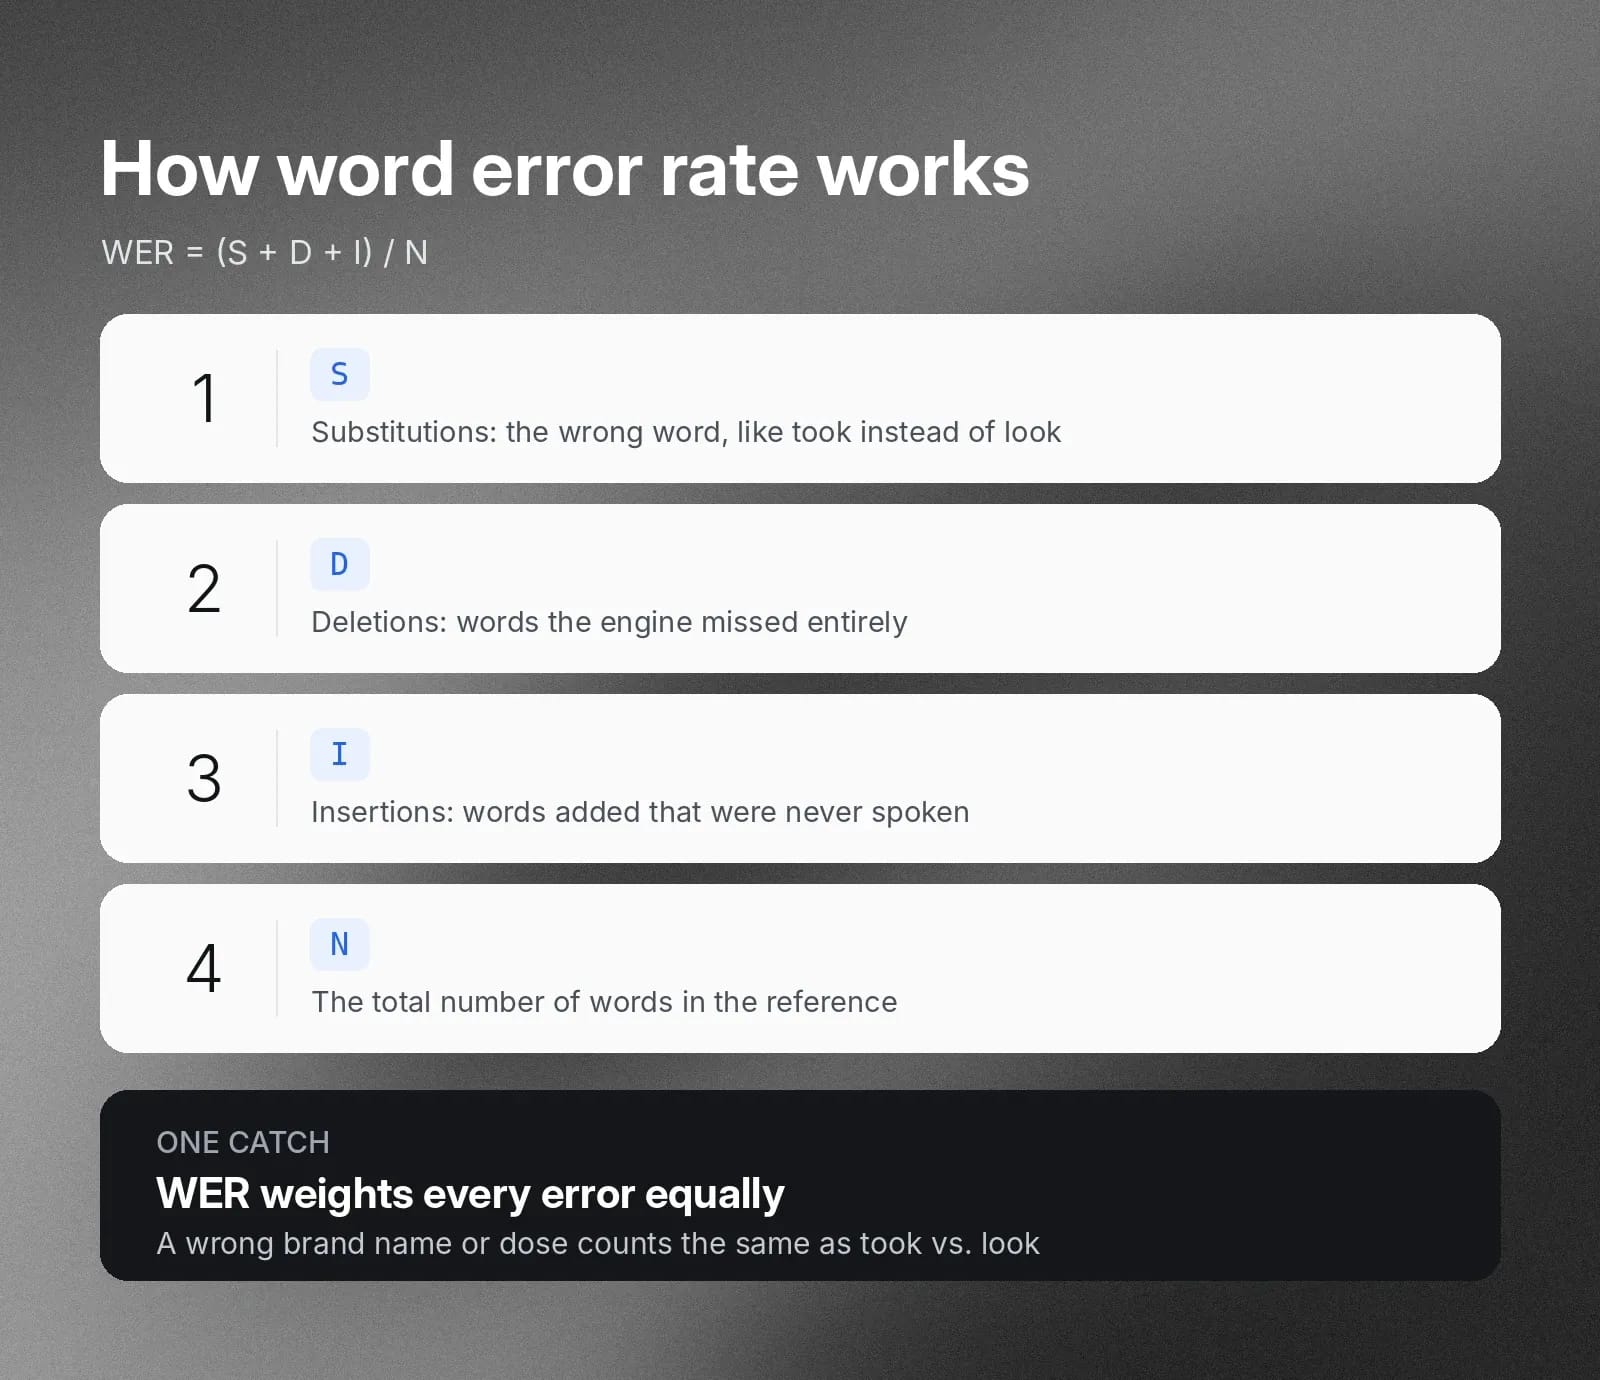
WER = (S + D + I) / N
- Sostituzioni (S): in una trascrizione, il numero di volte in cui il motore STT restituisce una parola errata, ad esempio “took” anziché “look”.
- Omissioni (D): il numero di parole che non ha rilevato affatto.
- Inserimenti (I): il numero di parole che ha aggiunto senza che fossero mai state pronunciate.
- Parole totali di riferimento (N): il numero totale di parole nel campione di input vocale.
È importante notare che il WER attribuisce lo stesso peso a tutti gli errori. Ad esempio, sostituire “took” con “look” ha lo stesso peso di riconoscere erroneamente il tuo nome di brand o un dato importante, come l'entità di una dose di farmaco. Verifica i WER dei diversi modelli.
Cosa è considerato un buon tasso di errore delle parole?
Non esiste un unico buon WER, perché l'obiettivo corretto dipende dall'audio e dal caso d'uso. L'audio pulito con un solo parlante produce tassi di errore molto più bassi rispetto a chiamate rumorose con parlanti sovrapposti. Confronta i modelli sulle tue registrazioni, invece di affidarti a un numero in evidenza.
Come riferimento per l'audio specialistico, Scribe v2 Medical è tra i modelli con le migliori prestazioni nei benchmark pubblici di ASR in ambito medico. Consulta i risultati aggiornati dei benchmark per i dati più recenti.
I risultati dei benchmark cambiano con il rilascio di nuovi modelli. Consulta i risultati aggiornati prima di confrontarli.
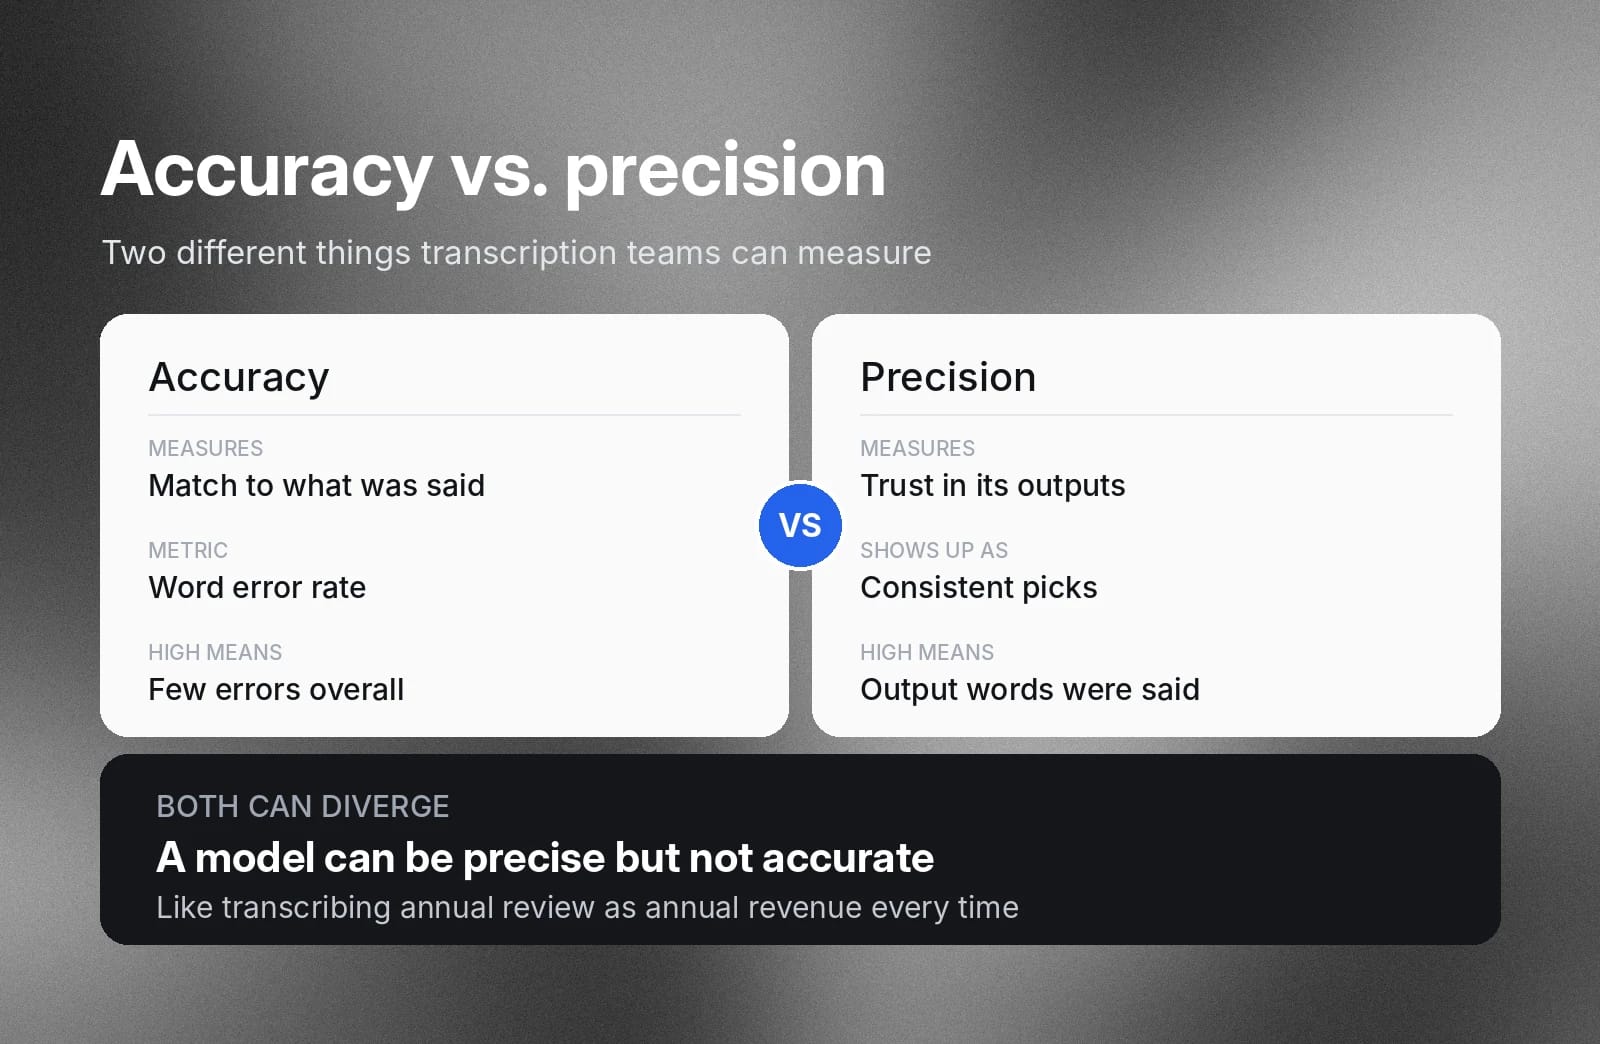
Accuratezza e precisione: cosa dovrebbero misurare i team di trascrizione
L'accuratezza indica quanto l'output della trascrizione corrisponde all'input parlato di “verità di riferimento”. Il tasso di errore delle parole misura l'accuratezza.
La precisione indica quanto siano affidabili le previsioni positive del modello STT. Un modello molto preciso selezionerà la stessa parola per un parlato complesso in più esecuzioni. Se il modello restituisce una parola, puoi fidarti che quella parola fosse presente nel parlato. Tuttavia, un modello molto preciso può comunque avere una bassa accuratezza, ossia omettere molte parole.
Inizia con ElevenAPI per trascrizioni più accurate
ElevenAPI ti dà accesso a Scribe v2, il modello Speech to Text di ElevenLabs, oltre a funzionalità che affrontano i problemi di accuratezza descritti in questa guida: keyterm prompting per nomi e gergo, trascrizione multicanale per parlanti sovrapposti e diarizzazione dei parlanti.
Se vuoi trascrivere senza usare l'API, puoi anche accedere a ElevenCreateive STT.
Inizia oggi a generare trascrizioni Speech to Text di alta qualità con ElevenAPI oppure scopri di più sulle funzionalità Speech to Text di ElevenAPI.
Domande frequenti sull'accuratezza del Speech to Text

Jack Limebear fa parte del team Growth e si occupa di scrivere contenuti e definire strategie per il blog e le pagine insights. Prima di arrivare in ElevenLabs, ha guidato la strategia dei contenuti per oltre dieci anni in realtà che vanno da startup SaaS in rapida crescita a grandi aziende Fortune 500. Ha conseguito un Master in Letteratura Inglese presso l’Università di Cambridge.