
Speech to Text per content creator: guida al workflow per didascalie e riutilizzo dei contenuti
- Scritto da
- Jack Limebear
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
Uno strumento Speech to Text accurato è indispensabile nello stack tecnologico di ogni content creator. Con lo Speech to Text basato sull'IA, puoi trasformare l'audio esistente in didascalie video, note dello show per podcast, articoli del blog e molto altro. Ti aiuta a riutilizzare i contenuti su diversi canali per raggiungere un pubblico più ampio.
Speech to Text fa risparmiare molto tempo anche ai content creator più impegnati. Trascrivere manualmente ogni voce fuori campo e podcast può richiedere ore, ma i modelli Speech to Text fanno il lavoro in pochi minuti, così puoi rispettare il tuo calendario di pubblicazione.
In questo articolo vedremo come funziona lo Speech to Text per content creator, perché è così efficace e come integrarlo nei tuoi workflow di creazione dei contenuti.
In sintesi
- I content creator usano i modelli Speech to Text per generare didascalie video, creare note dello show per podcast e riutilizzare contenuti audio in formati scritti.
- I modelli Speech to Text basati sull'IA offrono trascrizioni e formattazione più accurate delle didascalie automatiche dei social media.
- Trascrivendo i podcast con Speech to Text, puoi creare rapidamente note dello show o riutilizzarli come blog e newsletter.
- Con il keyterm prompting, puoi chiarire nomi e termini specifici del settore per ottenere trascrizioni più accurate.
- Per tradurre le didascalie, doppia il video nella lingua che preferisci, poi usa Speech to Text per trascrivere l'audio doppiato.
Quali sono gli usi principali dello Speech to Text per i content creator?
I content creator usano Speech to Text per varie attività, tra cui:
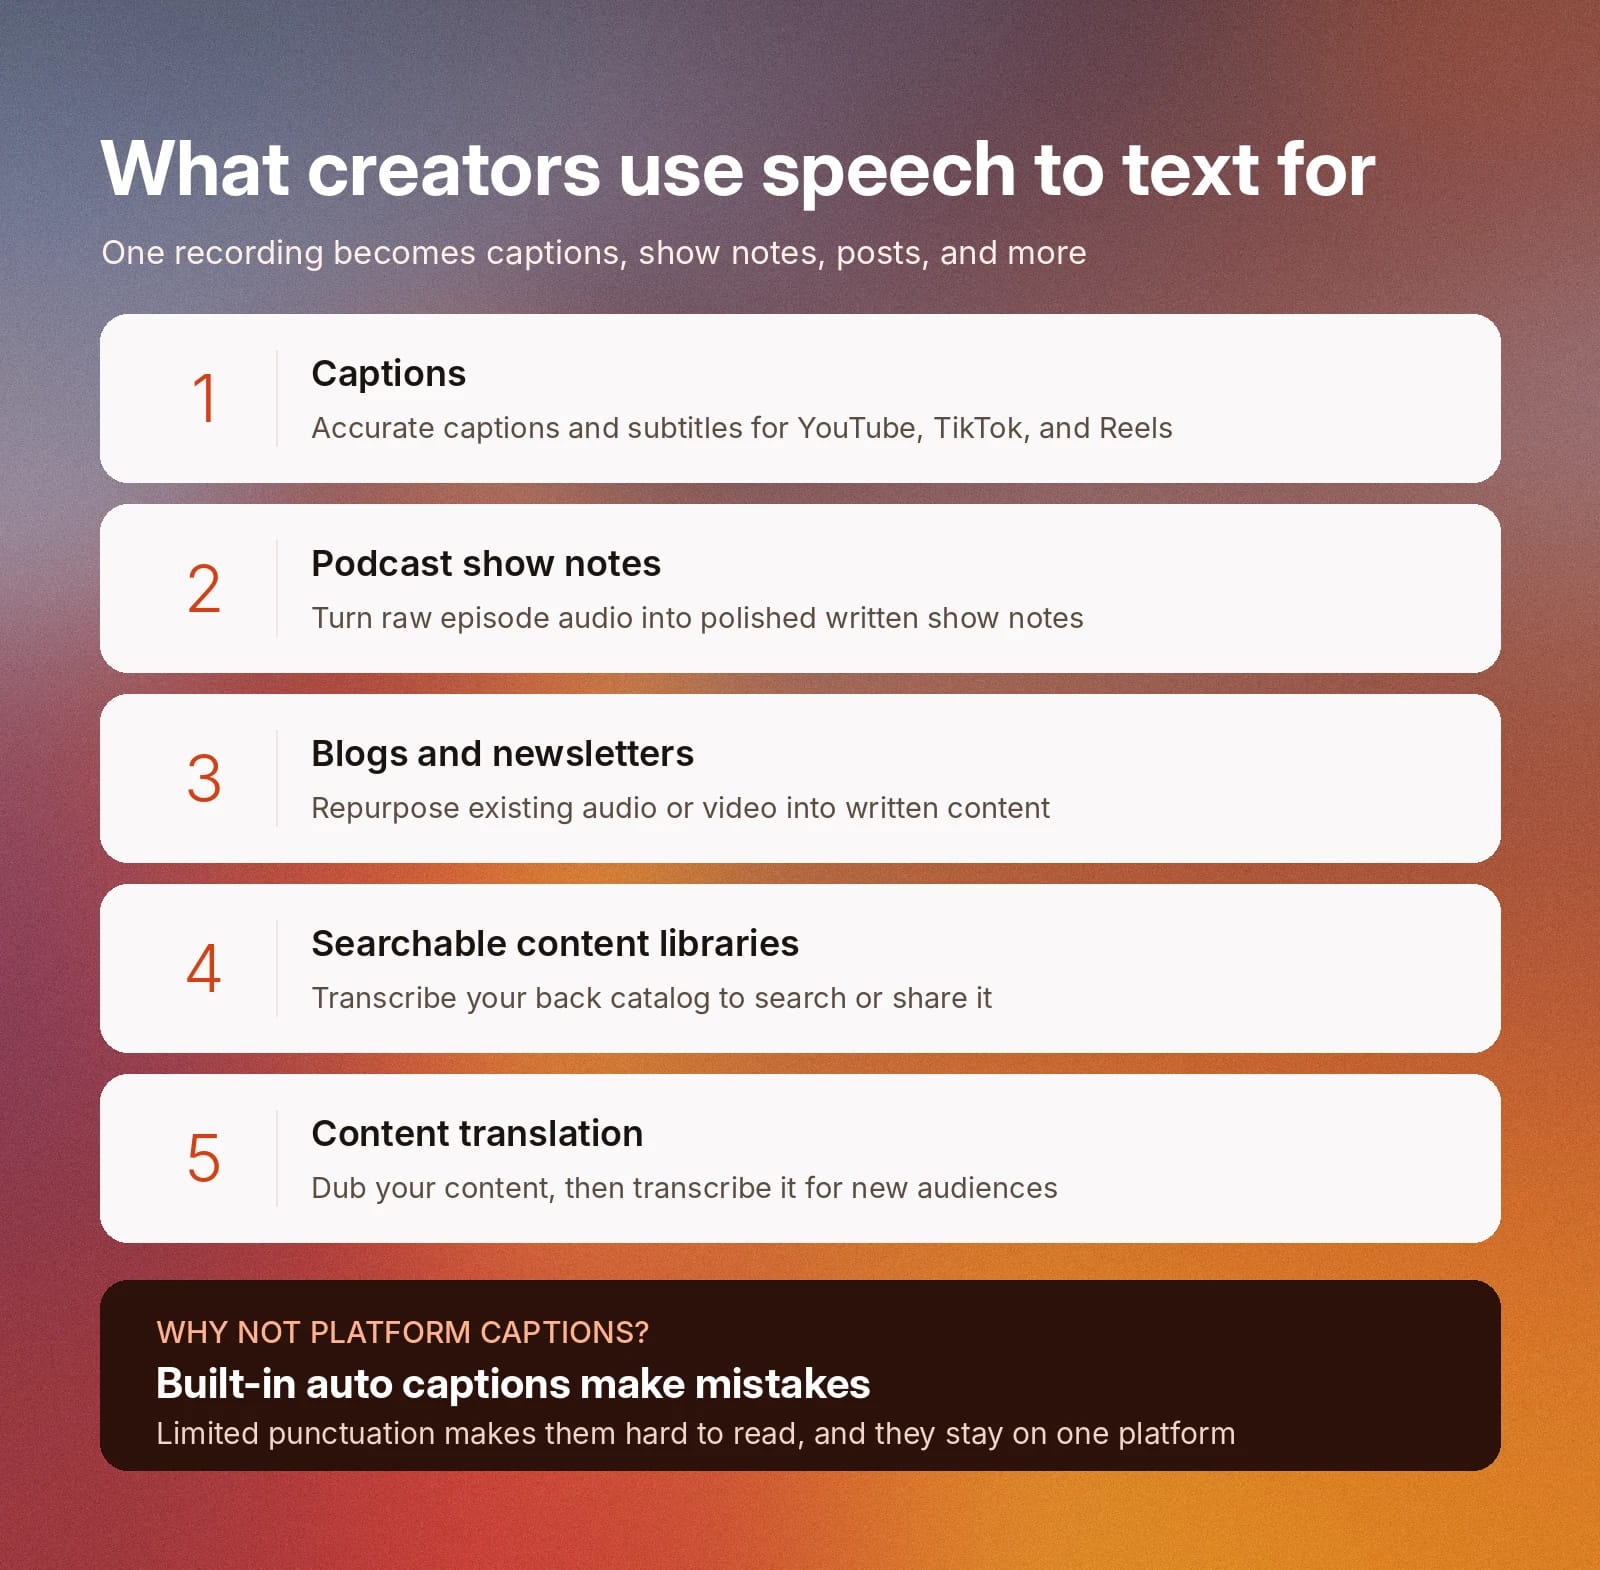
- Didascalie: Speech to Text genera didascalie e sottotitoli accurati per video brevi e lunghi su piattaforme come YouTube, TikTok e Instagram Reels.
- Note dello show per podcast: Speech to Text ti aiuta a trasformare l'audio grezzo di un episodio in note dello show scritte e curate.
- Blog e newsletter: Con Speech to Text, puoi trasformare contenuti audio o video esistenti in blog, newsletter e altri contenuti scritti.
- Librerie di contenuti ricercabili: Gli strumenti Speech to Text automatici trascrivono la tua libreria di contenuti esistente, rendendola ricercabile. Puoi usarla per mantenere l'organizzazione interna o creare una libreria di risorse esterna per il tuo pubblico.
- Traduzione dei contenuti: Speech to Text traduce i tuoi contenuti in lingue diverse per raggiungere pubblici in tutto il mondo.
Molte piattaforme social dispongono di funzionalità automatiche per generare didascalie per i contenuti video. Tuttavia, questi strumenti possono commettere errori e usare una punteggiatura limitata, rendendo le didascalie difficili da leggere.
Usare un modello Speech to Text dedicato ti aiuta a creare didascalie pulite e accurate per i tuoi video. Puoi anche scaricare e riutilizzare la trascrizione su piattaforme diverse.
Trasformare una trascrizione in didascalie e sottotitoli
Le didascalie e i sottotitoli non sono più facoltativi per i video sui social media. Rendono i video accessibili a tutti, indipendentemente dal livello di udito. Permettono inoltre agli spettatori di guardare i tuoi video senza audio.
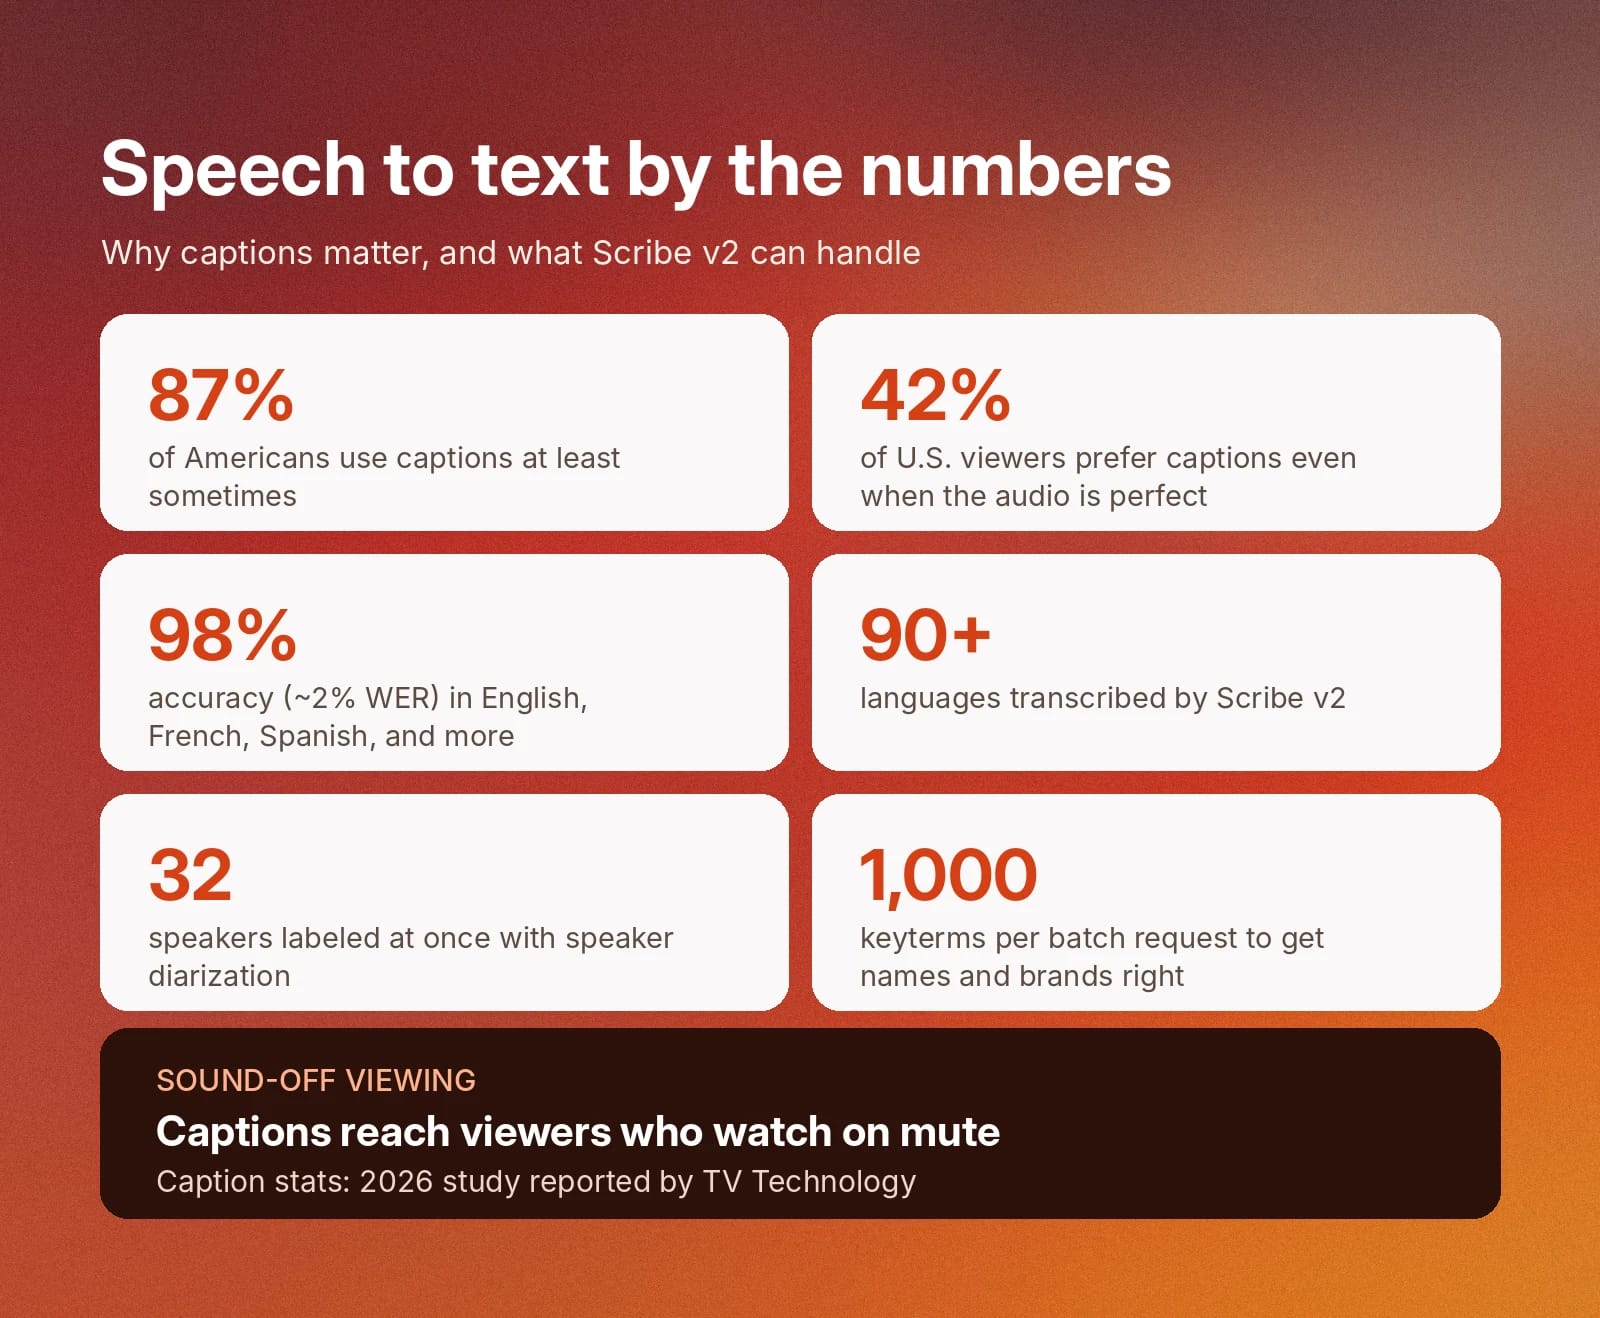
Guardare video senza audio è diventata la norma per molti utenti dei social media, soprattutto quando si trovano in luoghi pubblici o non hanno le cuffie a portata di mano. Uno studio del 2026 ha rilevato che l'87% degli americani usa le didascalie almeno occasionalmente quando guarda video.
Infatti, il 42% degli spettatori statunitensi preferisce le didascalie anche quando l'audio di un video è già perfetto, a dimostrazione di quanto aggiungerle a ogni video renda i tuoi contenuti più interessanti.
Speech to Text trascrive i tuoi video per i social media per generare didascalie e sottotitoli. ElevenLabs Caption Generator crea trascrizioni con timestamp a livello di parola e carattere, così si sincronizzano con il parlato del tuo video. Questi timestamp rimangono disponibili anche se tagli il video originale in clip più brevi per piattaforme diverse.
Puoi anche esportare le didascalie come file SRT e VTT, così da caricarle direttamente sui social media o sulla piattaforma di editing video che preferisci. Quando modifichi il video, assicurati di regolare le interruzioni di riga affinché seguano bene il flusso della conversazione.
SRT o VTT: quale file di didascalie esportare?
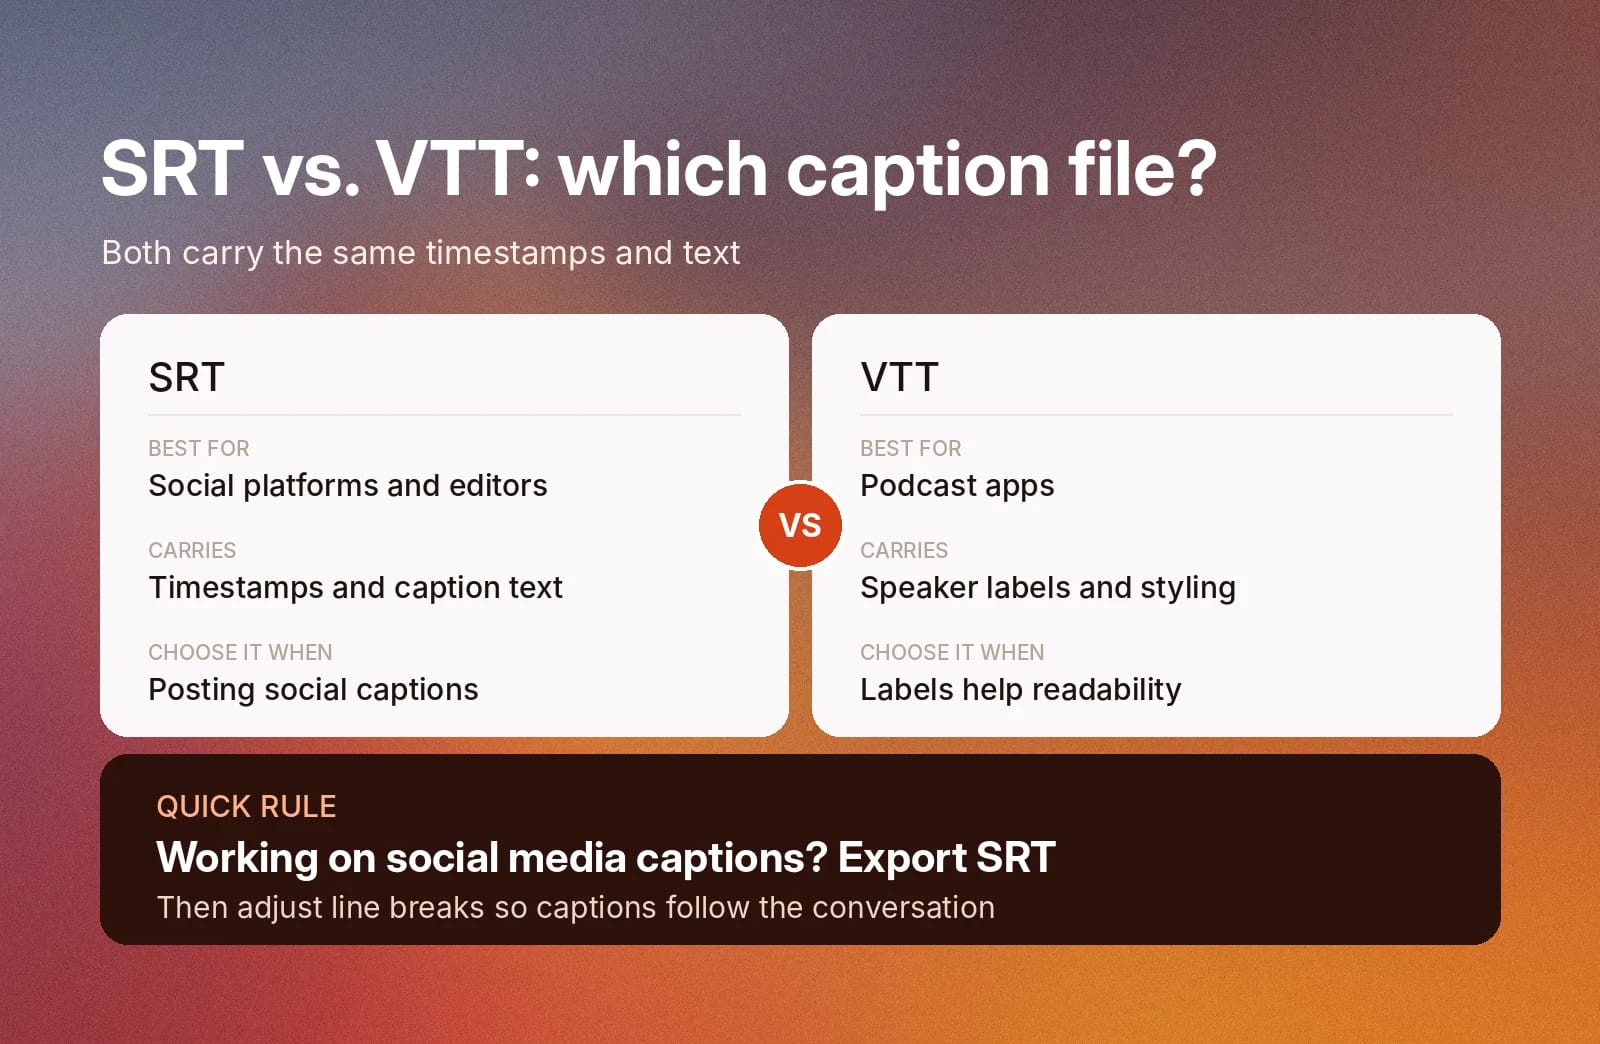
Sia SRT sia VTT contengono gli stessi timestamp e lo stesso testo.
Ecco quando scegliere ciascun formato:
- Esporta in SRT se vuoi un file semplice, accettato dalla maggior parte delle piattaforme social e dei software di editing video.
- Esporta in VTT se pubblichi didascalie o trascrizioni nelle app per podcast: può aggiungere etichette dei parlanti e uno stile di base che migliora la leggibilità.
Se stai creando didascalie per i social media, SRT è probabilmente l'opzione giusta.
Trascrizione pulita o letterale per le didascalie sui social media
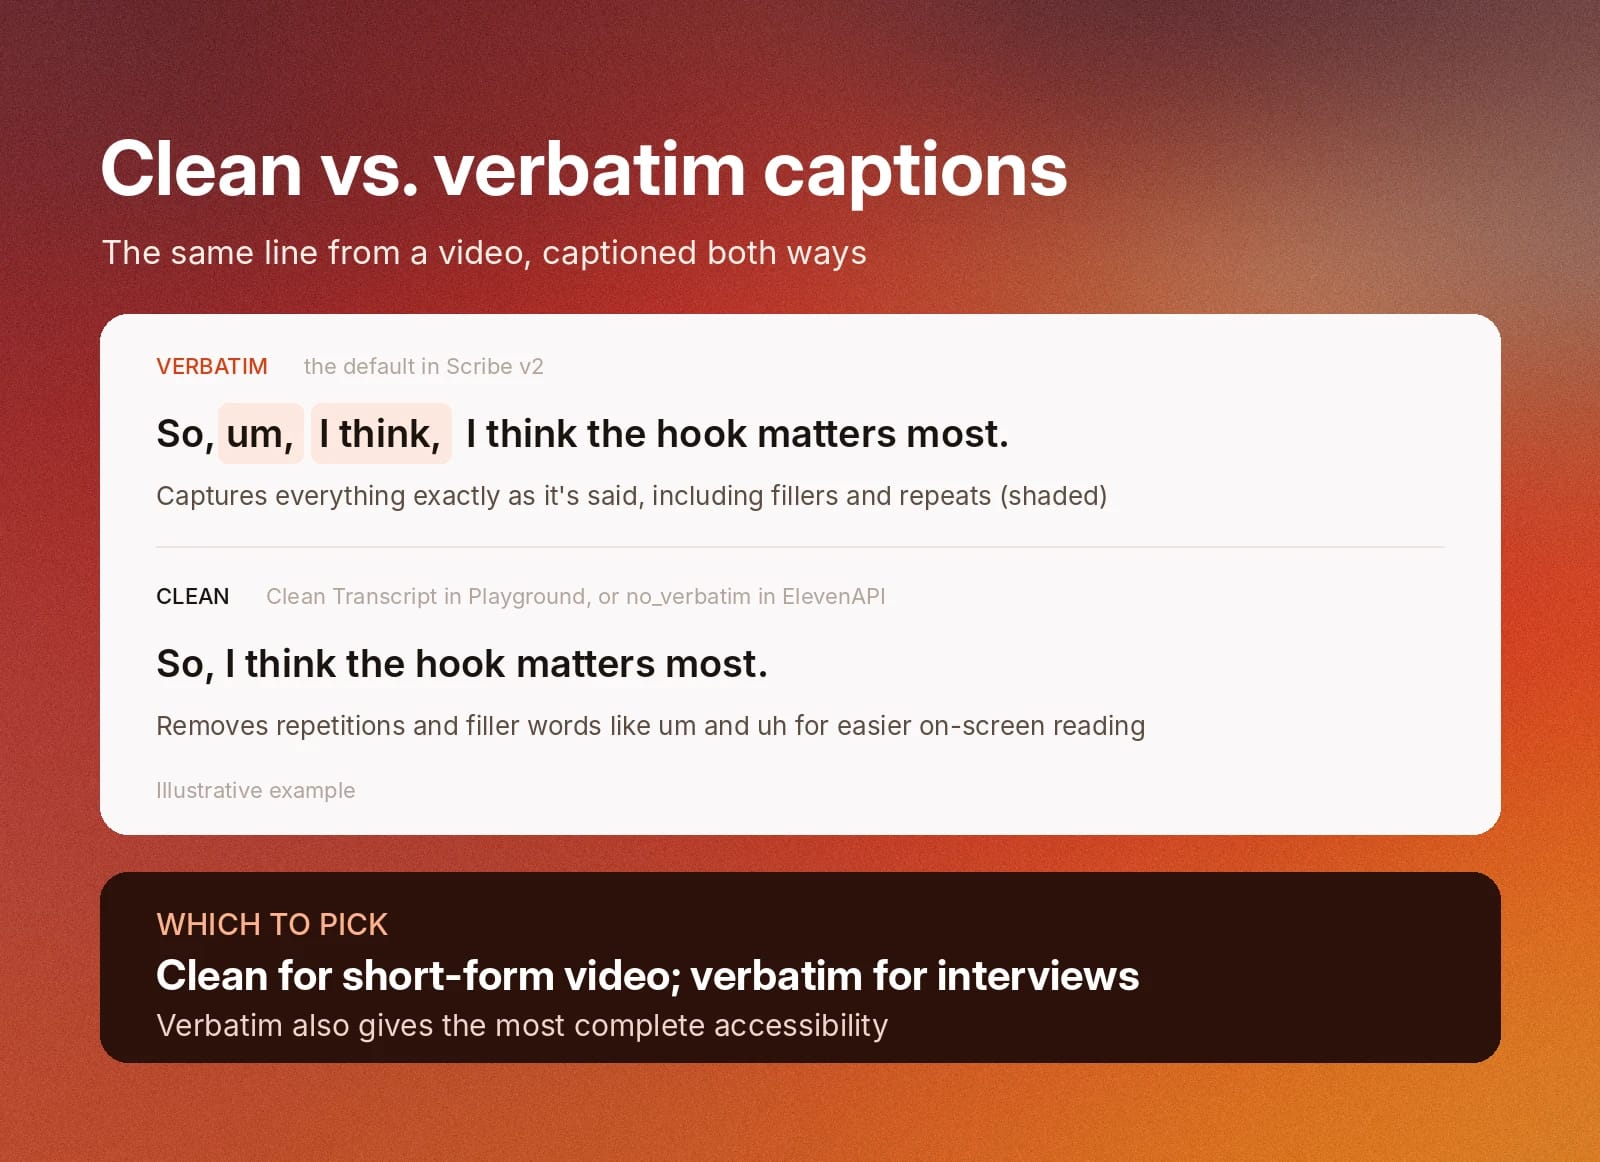
Quando crei didascalie per i social media, puoi scegliere tra trascrizione pulita e letterale. La trascrizione pulita rimuove ripetizioni e riempitivi come “ehm”, mentre quella letterale cattura tutto esattamente come viene detto.
Anche se le didascalie pulite sono più facili da leggere sullo schermo, quelle letterali sono migliori per un'accessibilità completa. La scelta giusta dipende dal tuo pubblico e dalle sue esigenze specifiche.
Il modello ElevenLabs Scribe v2 usa la trascrizione letterale come impostazione predefinita. Tuttavia, puoi passare alla trascrizione pulita attivando “Clean Transcript” in ElevenLabs Playground o usando il parametro no_verbatim con ElevenAPI.
Scegli la modalità pulita per i video brevi, in cui gli spettatori probabilmente leggono i contenuti scorrendo velocemente il video. La modalità letterale è ideale per interviste più lunghe o scenari di ricerca in cui è importante trascrivere con precisione le parole esatte.
Trascrivere podcast per note dello show e riutilizzo dei contenuti
Il tuo podcast è la base dell'intera strategia di contenuti. Per raggiungere un pubblico più ampio, prendi le idee discusse in ogni episodio e trasformale in note dello show, blog, newsletter e contenuti brevi per i social media.
Gli strumenti Speech to Text ti aiutano a trascrivere gli episodi del tuo podcast per riutilizzarli facilmente. Dopo aver creato la trascrizione, puoi modificarla e convertirla in note dello show che il tuo pubblico potrà consultare in qualsiasi momento.
Puoi anche trasformare sezioni di ogni trascrizione in contenuti per blog e newsletter, invece di scrivere articoli da zero. Così raggiungi chi preferisce leggere anziché ascoltare.
Le librerie di contenuti scritti sono facili da cercare. Se il tuo pubblico vuole ritrovare un'idea di un episodio precedente, basta cercare nelle note dello show o nel blog. I contenuti scritti hanno inoltre maggiori probabilità di comparire nei risultati di ricerca rispetto ai contenuti audio, aumentando la tua visibilità online.
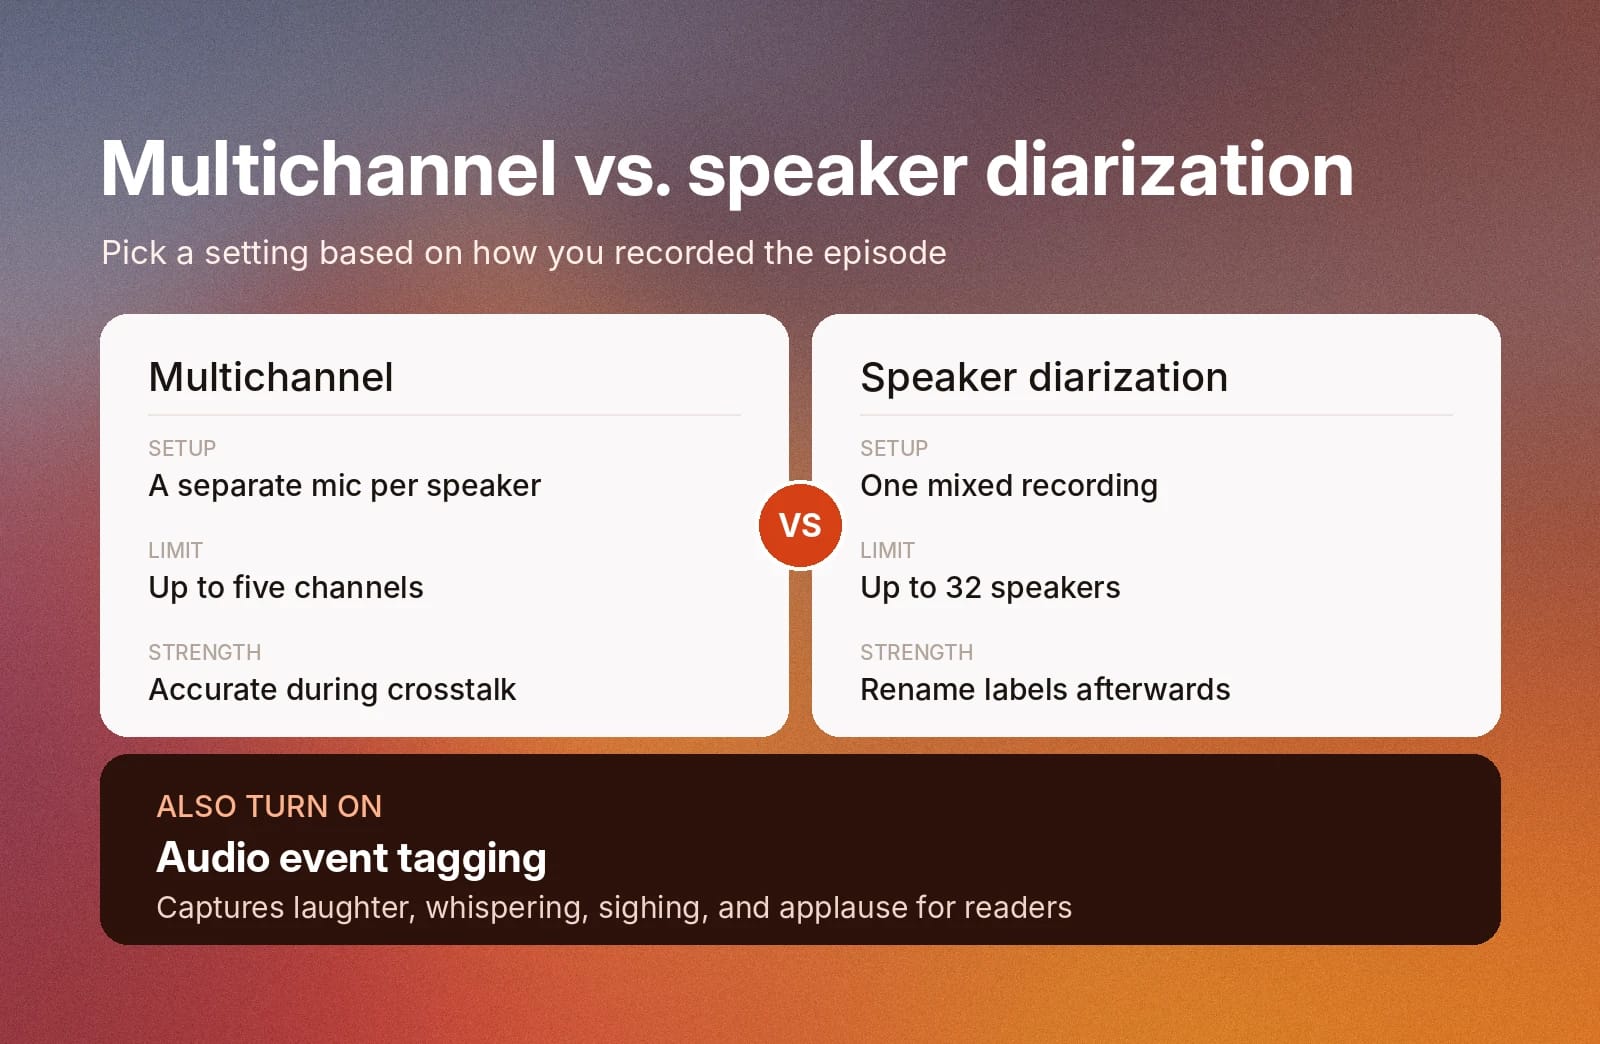
Il modo più efficiente per trascrivere i podcast è usare una configurazione di trascrizione multicanale. Per farlo, usa un microfono separato per ogni parlante. Il modello di trascrizione trascriverà ogni persona separatamente, per risultati accurati anche quando i parlanti si sovrappongono.
Inoltre, attiva il tagging degli eventi audio quando trascrivi i podcast. Questa impostazione rileva risate, sussurri, sospiri o applausi, offrendo ai lettori il contesto completo. Per farlo con ElevenLabs Speech to Text, attiva “Tag Audio Events” oppure usa il parametro tag_audio_events con ElevenAPI.
Identificare i parlanti in una singola registrazione
La trascrizione multicanale supporta fino a cinque canali. Se registri tutte le voci su un'unica traccia mixata o hai più voci che canali, attiva invece la diarizzazione dei parlanti. Scribe v2 assegna un'etichetta a ogni parlante nella trascrizione e supporta fino a 32 parlanti contemporaneamente. Dopo la trascrizione, puoi rinominarli facendo clic sul pulsante di modifica accanto all'etichetta del parlante nella dashboard di ElevenLabs.
Riutilizzare le registrazioni in clip, blog e newsletter
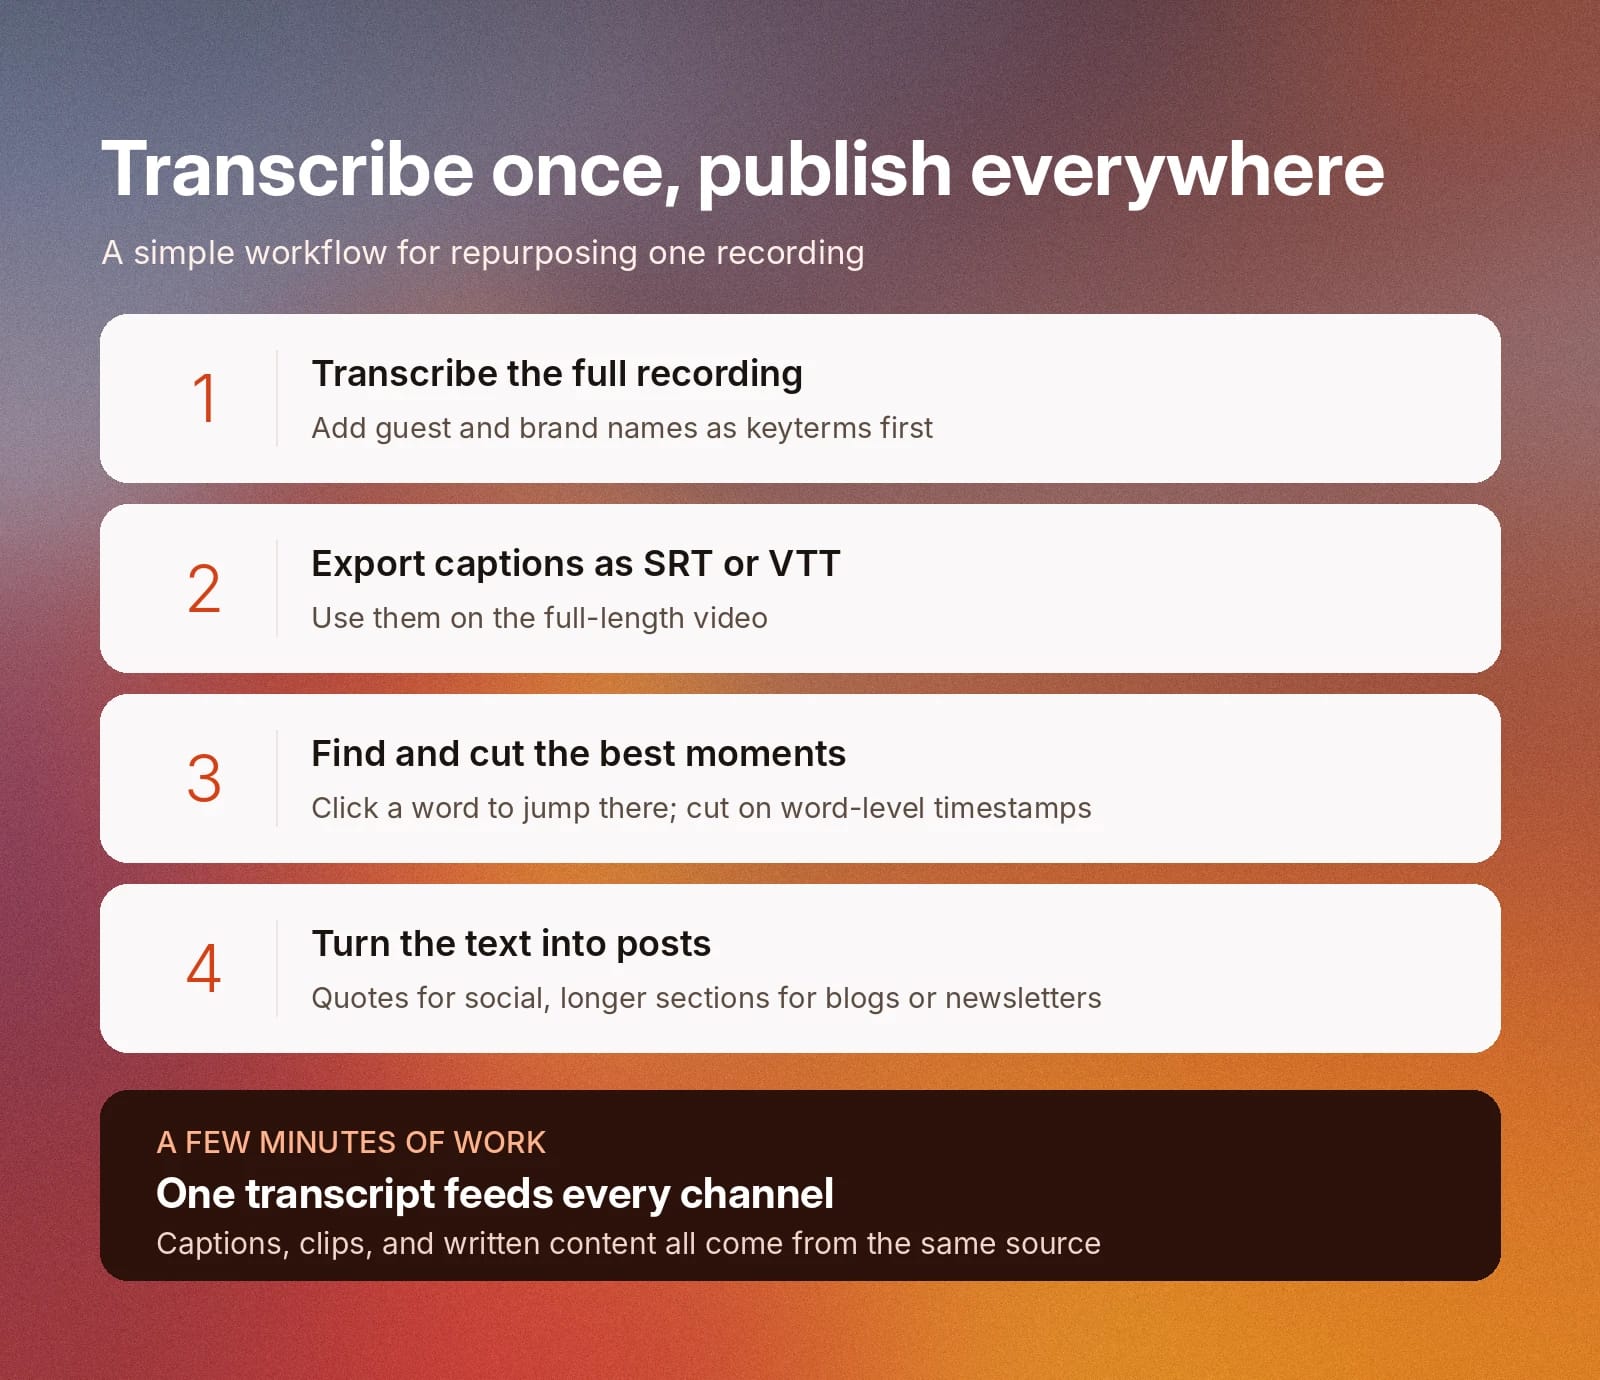
Trascrivi un'intervista una volta e riutilizzala su ogni canale su cui pubblichi.
La stessa trascrizione fornisce le didascalie e il materiale grezzo per clip e contenuti scritti. Creator e aziende di tutto il mondo usano ElevenLabs STT per velocizzare il passaggio dal podcast ai contenuti scritti.
Ogni podcast, keynote e intervista che realizzo passa attraverso Speech to Text. Una trascrizione mi offre didascalie accurate per l'intero contenuto, i momenti migliori da trasformare in video brevi e citazioni chiave che converto in contenuti scritti.
Ecco un semplice workflow di riutilizzo che puoi usare:
- Trascrivi la registrazione completa e aggiungi i nomi degli ospiti e dei brand al tuo dizionario di pronuncia.
- Esporta le didascalie in formato SRT o VTT e usale per il video completo.
- Leggi la trascrizione per individuare i momenti più efficaci. Fai clic su una parola nella trascrizione per passare a quel punto dell'audio, quindi usa i timestamp a livello di parola per tagliare ogni clip all'inizio e alla fine esatti.
- Copia le citazioni chiave nei post sui social e trasforma le sezioni più lunghe in un articolo del blog o una newsletter.
Ti bastano pochi minuti per creare contenuti lunghi dalle trascrizioni STT dei tuoi podcast.
Trasformare i tuoi video in trascrizioni per l'analisi con LLM
Dopo aver trasformato i tuoi video in testo, puoi caricare in blocco i contenuti in un LLM per analizzarli. Individua nuove idee, evidenzia punti utili per riutilizzare i contenuti o scopri semplicemente cosa funziona nei tuoi contenuti.
Tutto ciò che creo parte dalla mia voce, ma la maggior parte dei miei strumenti IA funziona ancora meglio con il testo. ElevenLabs Scribe è il mio livello di traduzione: trasforma i miei video in trascrizioni, così qualsiasi LLM può analizzare cosa funziona e cosa no. Secondo me, colma una delle lacune più grandi dell'IA.
Ecco come configurare un workflow simile:
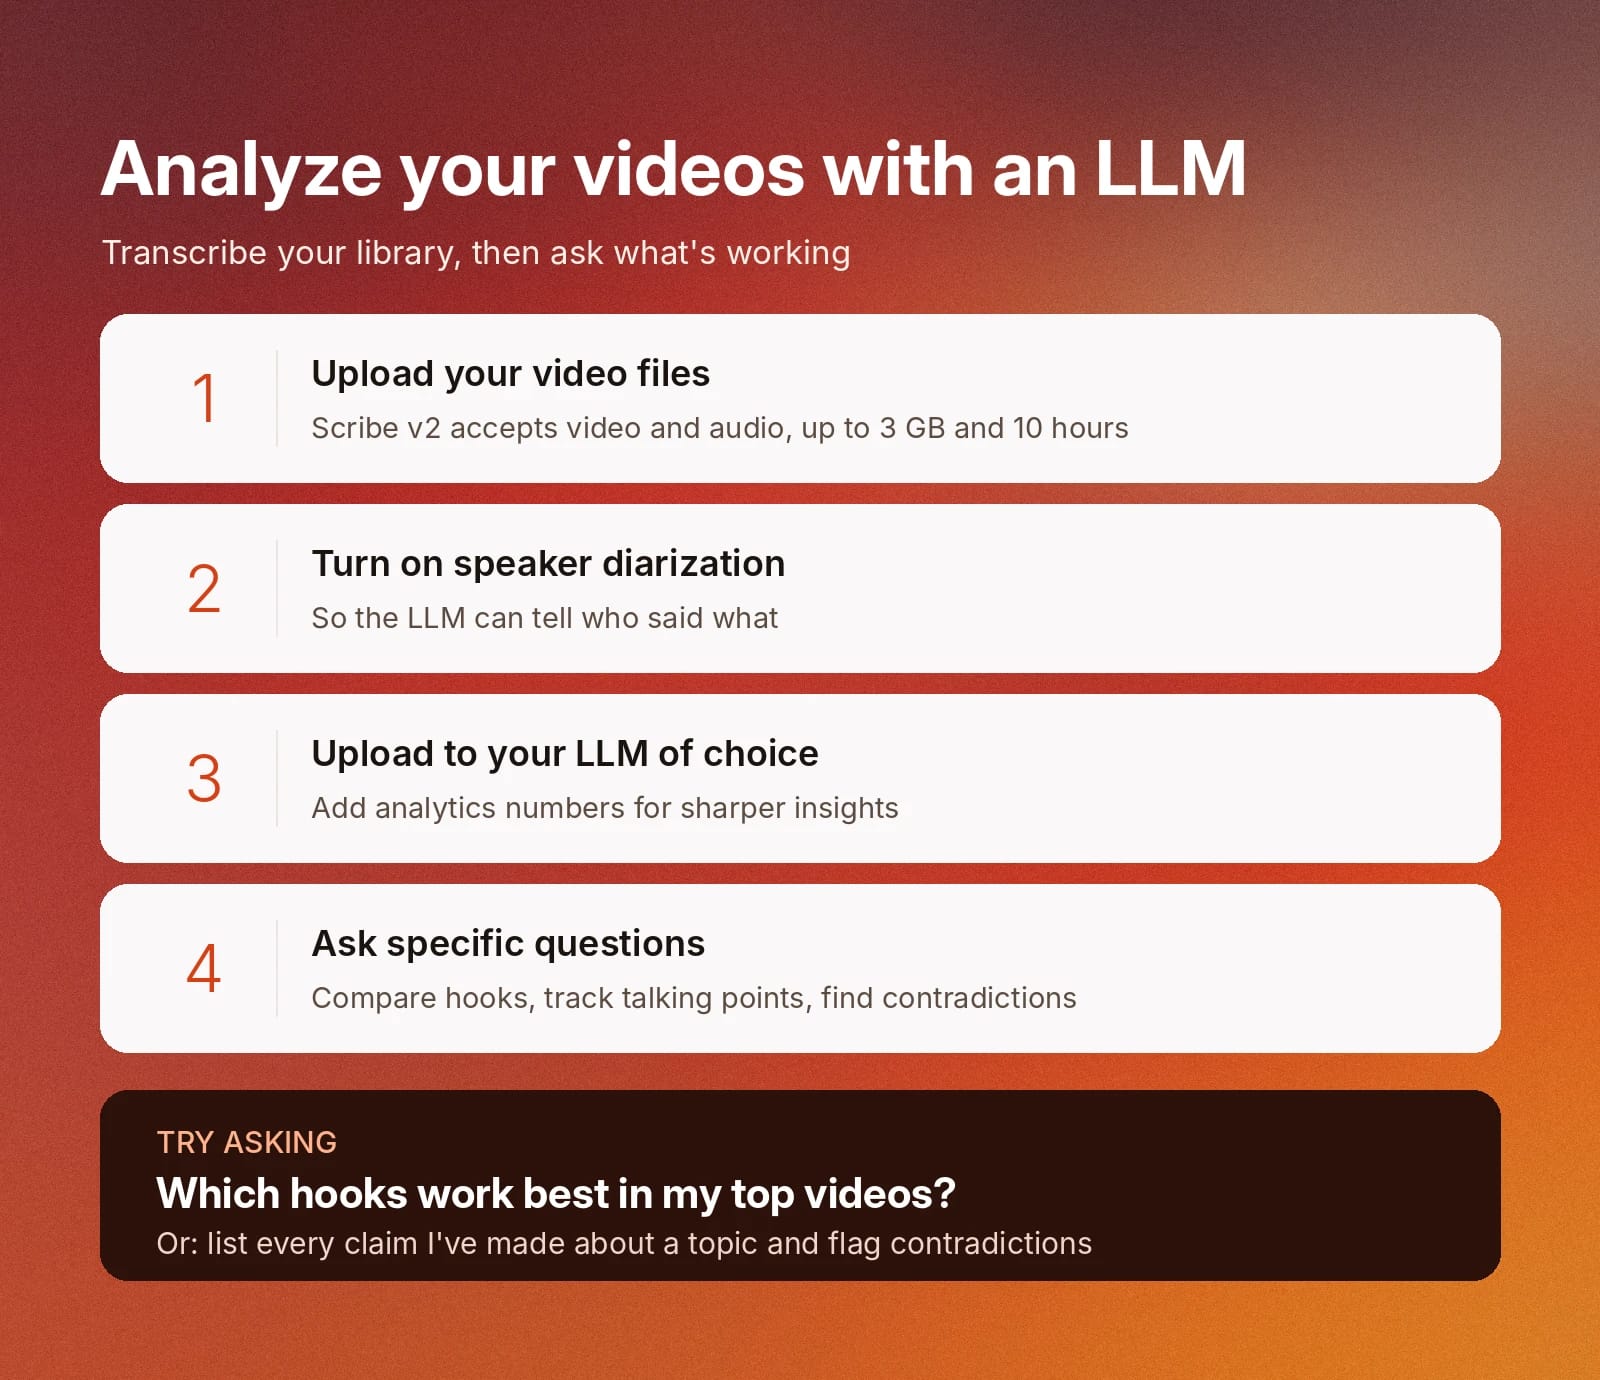
- Carica i file video per la trascrizione: ElevenLabs STT accetta video e audio, con file fino a 3 GB e della durata massima di 10 ore.
- Attiva la diarizzazione dei parlanti: Se parla più di una persona, attiva la diarizzazione affinché l'LLM possa distinguere chi ha detto cosa.
- Carica nel tuo LLM preferito: Aggiungi dati di analytics o informazioni aggiuntive per migliorare gli insight che puoi ottenere.
- Fai domande specifiche sui tuoi contenuti: Domande come “Confronta i primi 20 secondi dei miei video più performanti per capire quali hook funzionano meglio per il mio pubblico” oppure “Elenca tutte le affermazioni che ho fatto sul tema X e segnala eventuali contraddizioni” possono aiutarti a scoprire nuovi insight.
Dettare prompt e note
La digitazione vocale ti permette di fornire a uno strumento IA il contesto e le sfumature che potresti omettere se dovessi scrivere tutto. Speech to Text trasforma ciò che dici in testo che puoi incollare direttamente in un prompt, un brief o nelle tue note. Alcuni scrittori stanno persino iniziando a usare STT per scrivere più velocemente, trascrivendo il parlato invece di digitare tutto.
Non riesco a immaginare di lavorare senza, soprattutto per i prompt. Ogni interazione con l'IA richiede tantissime sfumature e non ho voglia di digitare tutto quanto.
Esistono due modi per dettare con ElevenLabs:
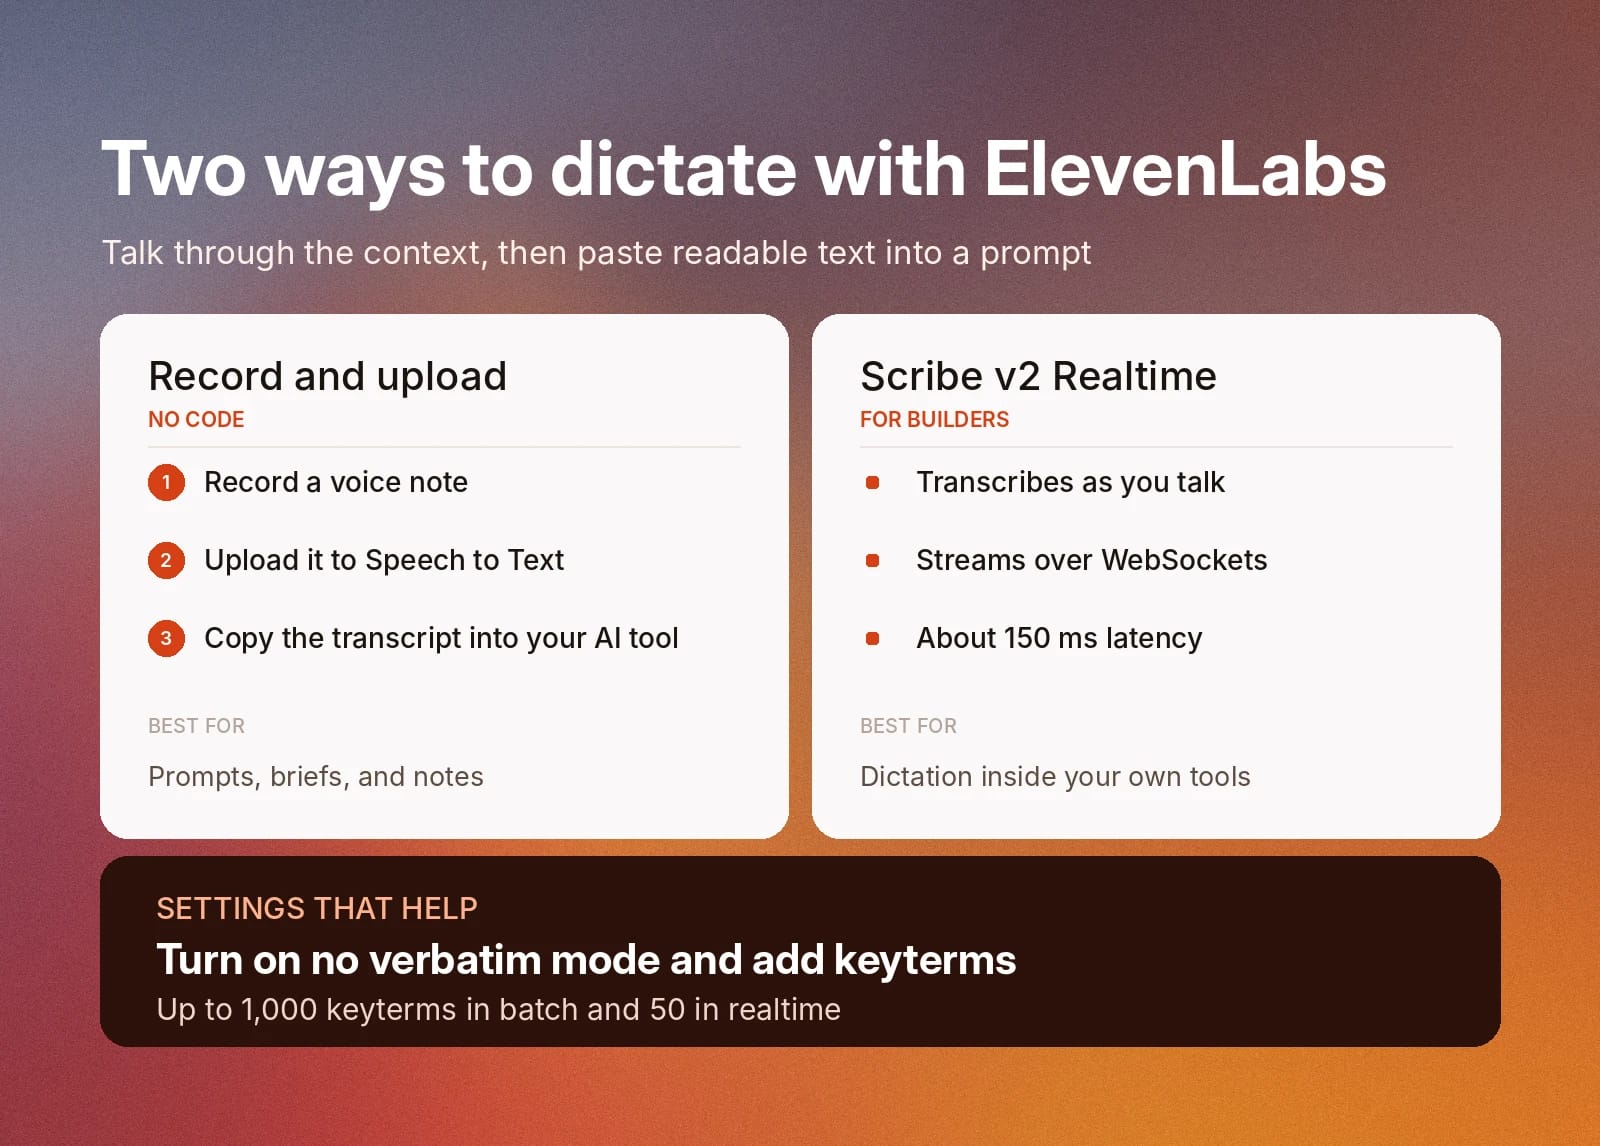
- Registra e carica: Registra una nota vocale, caricala nella pagina ElevenLabs Speech to Text e copia la trascrizione nel tuo strumento IA.
- Trasmetti in tempo reale: Se stai creando i tuoi strumenti, Scribe v2 Realtime trascrive il parlato mentre parli tramite WebSockets, con una bassa latenza di circa 150 ms secondo la documentazione.
Assicurati di attivare la modalità no verbatim, che rimuove riempitivi, false partenze e disfluenze, per trasformare una nota vocale prolissa in testo leggibile. Poi aggiungi con il keyterm prompting i nomi dei prodotti e il gergo che usi spesso, per assicurarti che vengano trascritti correttamente ogni volta. La trascrizione batch accetta fino a 1.000 keyterm, quella realtime fino a 50.
Trascrivere correttamente nomi, brand e termini di nicchia con STT
I modelli Speech to Text non riconoscono sempre i nomi dei parlanti, dei brand o i termini specifici del settore. Quando trascrivi i contenuti, usa il keyterm prompting per chiarire ortografia e formattazione.
Il keyterm prompting ti permette di indicare l'ortografia corretta di nomi o termini di nicchia prima che inizi la trascrizione. Per ogni video o episodio di podcast, aggiungi i nomi di ospiti, canali o brand che menzioni spesso. Potresti anche dover aggiungere il gergo del settore o altri termini di nicchia.
Il keyterm prompting rende le trascrizioni più accurate e facili da leggere per il pubblico. Inoltre velocizza il processo di editing, perché non dovrai correggere manualmente questi termini.
Raggiungere il pubblico in altre lingue
I modelli Speech to Text vanno oltre la trascrizione. Come content creator, puoi usarli anche per localizzare i tuoi contenuti e raggiungere chi parla altre lingue.
ElevenLabs Scribe v2 trascrive contenuti in oltre 90 lingue. Puoi abbinarlo a Studio di Doppiaggio ElevenLabs per creare un workflow di localizzazione completo.
Per farlo, carica l'audio nello Studio di Doppiaggio per doppiare i contenuti nella lingua che preferisci. Quindi trascrivi l'audio doppiato per creare didascalie localizzate, note dello show o altri contenuti scritti.
Cosa non può fare Speech to Text per te
Speech to Text è uno strumento potente, ma ha dei limiti. Sebbene i modelli Speech to Text trascrivano l'audio con timestamp accurati, non sono editor video. Per creare il prodotto finale dovrai usare una piattaforma di editing video separata.
Quando crei contenuti, inizia usando Speech to Text per trascrivere l'audio. Poi esporta sia la trascrizione grezza sia le didascalie da usare nei tuoi contenuti. Carica le didascalie nel tuo editor video o direttamente sui social media e usa la trascrizione come base per note dello show, articoli del blog e altre risorse scritte.
Assicurati di rivedere ogni trascrizione prima di pubblicarla, soprattutto i nomi e i passaggi in cui i parlanti parlano contemporaneamente. Il Transcript Editor ti permette di correggere facilmente gli errori direttamente nell'app.
Come scegliere il miglior strumento Speech to Text come content creator
Lo strumento STT giusto trasforma la tua registrazione in testo pulito, scritto correttamente e con timestamp che rendono il riutilizzo dei contenuti più semplice possibile.
Quando cerchi la migliore piattaforma Speech to Text, assicurati che abbia queste cinque caratteristiche:
- Accuratezza nella tua lingua: Le prestazioni degli STT possono variare tra le lingue, soprattutto per quelle con meno dati disponibili. Cerca dati pubblicati sull'accuratezza. Ad esempio, ElevenLabs Scribe v2 ha un'accuratezza del 98% (~2% di WER) in lingue come inglese, francese, italiano, spagnolo e altre.
- Gestione di nomi e gergo del settore: Il tuo modello STT deve essere in grado di comprendere il contesto delle conversazioni e trascriverle accuratamente. Cerca piattaforme STT che offrano keyterm prompting e dizionari di pronuncia.
- Timestamp e formati di esportazione: Ti serviranno timestamp a livello di parola e l'opzione per esportare didascalie SRT o VTT.
- Gestione dei parlanti: Soprattutto se lavori con audio che include più di un parlante, identificare con precisione le voci distinte aiuterà a mantenere chiare le trascrizioni.
- Limiti dei file: Per progetti audio o video più grandi, come i podcast, potresti dover gestire file di dimensioni maggiori. ElevenLabs accetta file fino a 3 GB e, in modalità standard, fino a 10 ore.
Ecco come un modello STT dedicato come Eleven Scribe v2 si confronta con gli strumenti automatici per le didascalie integrati nelle piattaforme social:
Cosa ti serve
Didascalie automatiche della piattaforma
Modello dedicato come Scribe v2
Ortografia corretta di nomi e brand
Può commettere errori
Keyterm prompting, fino a 1.000 termini per richiesta batch
Punteggiatura leggibile
Spesso limitata
Output pulito con modalità no verbatim
Riutilizzare il testo altrove
Le didascalie restano sulla piattaforma
Scarica trascrizione e didascalie e usale ovunque
Sincronizzazione
Vincolata al player della piattaforma
Timestamp a livello di parola da usare nelle clip
Lingue
Varia in base alla piattaforma
Oltre 90 lingue
Due modi per iniziare: caricamento senza codice o API
Con ElevenLabs, hai due modi per trascrivere i tuoi contenuti video usando Speech to Text.
La prima opzione consiste nel caricare il tuo file audio nella dashboard di ElevenLabs Playground. Regola le impostazioni di trascrizione, modifica l'output direttamente nel Transcript Editor, poi esporta nel formato file che ti serve. Il processo è rapido e semplice e non richiede codice.
Se stai creando un tuo workflow di pubblicazione dei contenuti, puoi trascrivere anche con ElevenAPI. Aggiungi l'API direttamente agli strumenti che stai già creando per ottenere le stesse trascrizioni accurate senza cambiare strumento.
Registrati a ElevenLabs per iniziare oggi con STT oppure scopri di più su come Speech to Text per creator sta cambiando le regole del gioco.
FAQ

Jack Limebear fa parte del team Growth e si occupa di scrivere contenuti e definire strategie per il blog e le pagine insights. Prima di arrivare in ElevenLabs, ha guidato la strategia dei contenuti per oltre dieci anni in realtà che vanno da startup SaaS in rapida crescita a grandi aziende Fortune 500. Ha conseguito un Master in Letteratura Inglese presso l’Università di Cambridge.



