Infraestrutura de voz IA: a stack de 2026 explicada
- Escrito por
- Jack Limebear
- Publicado
OuvirOuça este artigo
A infraestrutura de voz IA é o conjunto de modelos, conexões, ferramentas e serviços que permite a um agente de IA ouvir uma chamada, decidir o que fazer, realizar ações em outros sistemas e responder em voz alta. E, com provedores líderes como a ElevenLabs, tudo isso acontece em uma fração de segundo.
Um agente de voz em produção opera sobre uma stack de camadas que inclui reconhecimento de fala, gerenciamento de turnos, um grande modelo de linguagem, orquestração, ferramentas, recuperação de conhecimento, síntese de fala, telefonia e monitoramento.
Este guia explica a arquitetura de agentes de IA por trás de um agente de voz funcional. Cada seção mostra o que uma camada faz, por que ela importa na infraestrutura mais ampla e como o ElevenAgents a implementa, usando o Eleven v4 como exemplo da camada de voz.
Como a infraestrutura de voz IA se integra
Um agente de voz transforma áudio em texto, raciocina com base nessa entrada, gera uma resposta e então transforma essa resposta em áudio que o cliente ouve. Essa cascata de ações é formada por uma stack robusta de arquitetura de agentes de IA.
Estas são as principais camadas que contribuem para a infraestrutura de voz IA em 2026:
- Reconhecimento de fala: a tecnologia Automatic Speech Recognition (ASR) converte o áudio de quem liga em texto para processamento.
- Gerenciamento de turnos: o gerenciamento de turnos determina quando quem liga terminou de falar e quando parar de falar, permitindo uma conversa mais fluida e responsiva.
- Modelo(s) de linguagem: interpreta a solicitação transcrita e gera uma resposta após obter o contexto necessário.
- Orquestração: uma camada de orquestração de IA direciona a conversa entre prompts, subagentes, ferramentas e pessoas.
- Ferramentas e MCP: conectam o agente a sistemas externos, como plataformas de CRM ou centrais de atendimento, para executar tarefas.
- Conhecimento e memória: fornecem fatos e contexto sobre quem liga por meio da Geração Aumentada por Recuperação.
- Síntese de fala: usa o Text to Speech para transformar a resposta gerada em texto em áudio.
- Transporte e telefonia: transportam o áudio entre o agente e quem liga.
- Guardrails, testes e monitoramento: mantêm o agente focado na tarefa e mensurável.
Juntos, esses componentes criam conversas em tempo real entre agentes de IA e clientes que ligam.
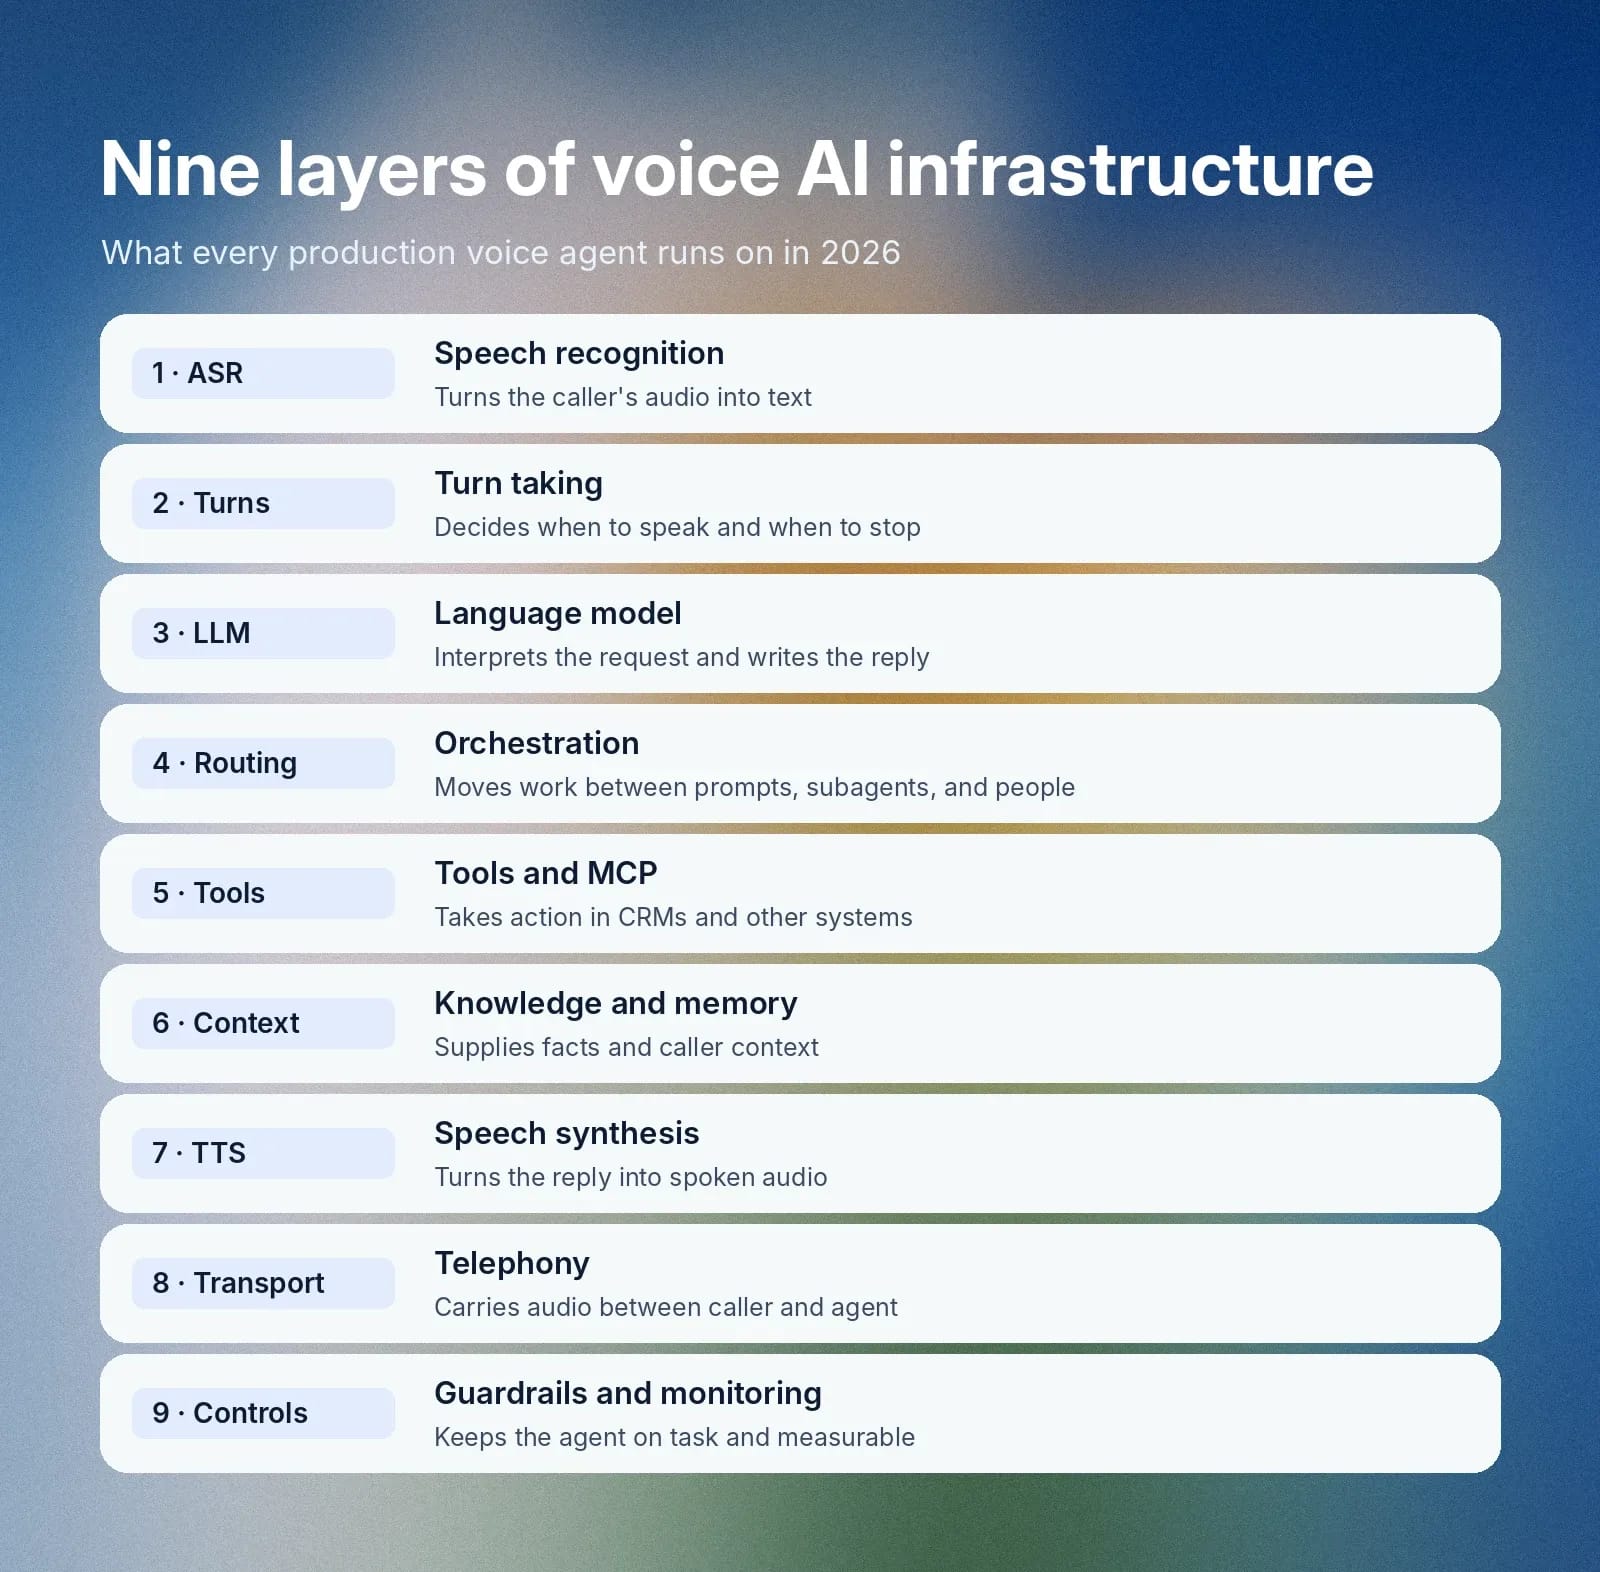
Diagrama de arquitetura de voz IA
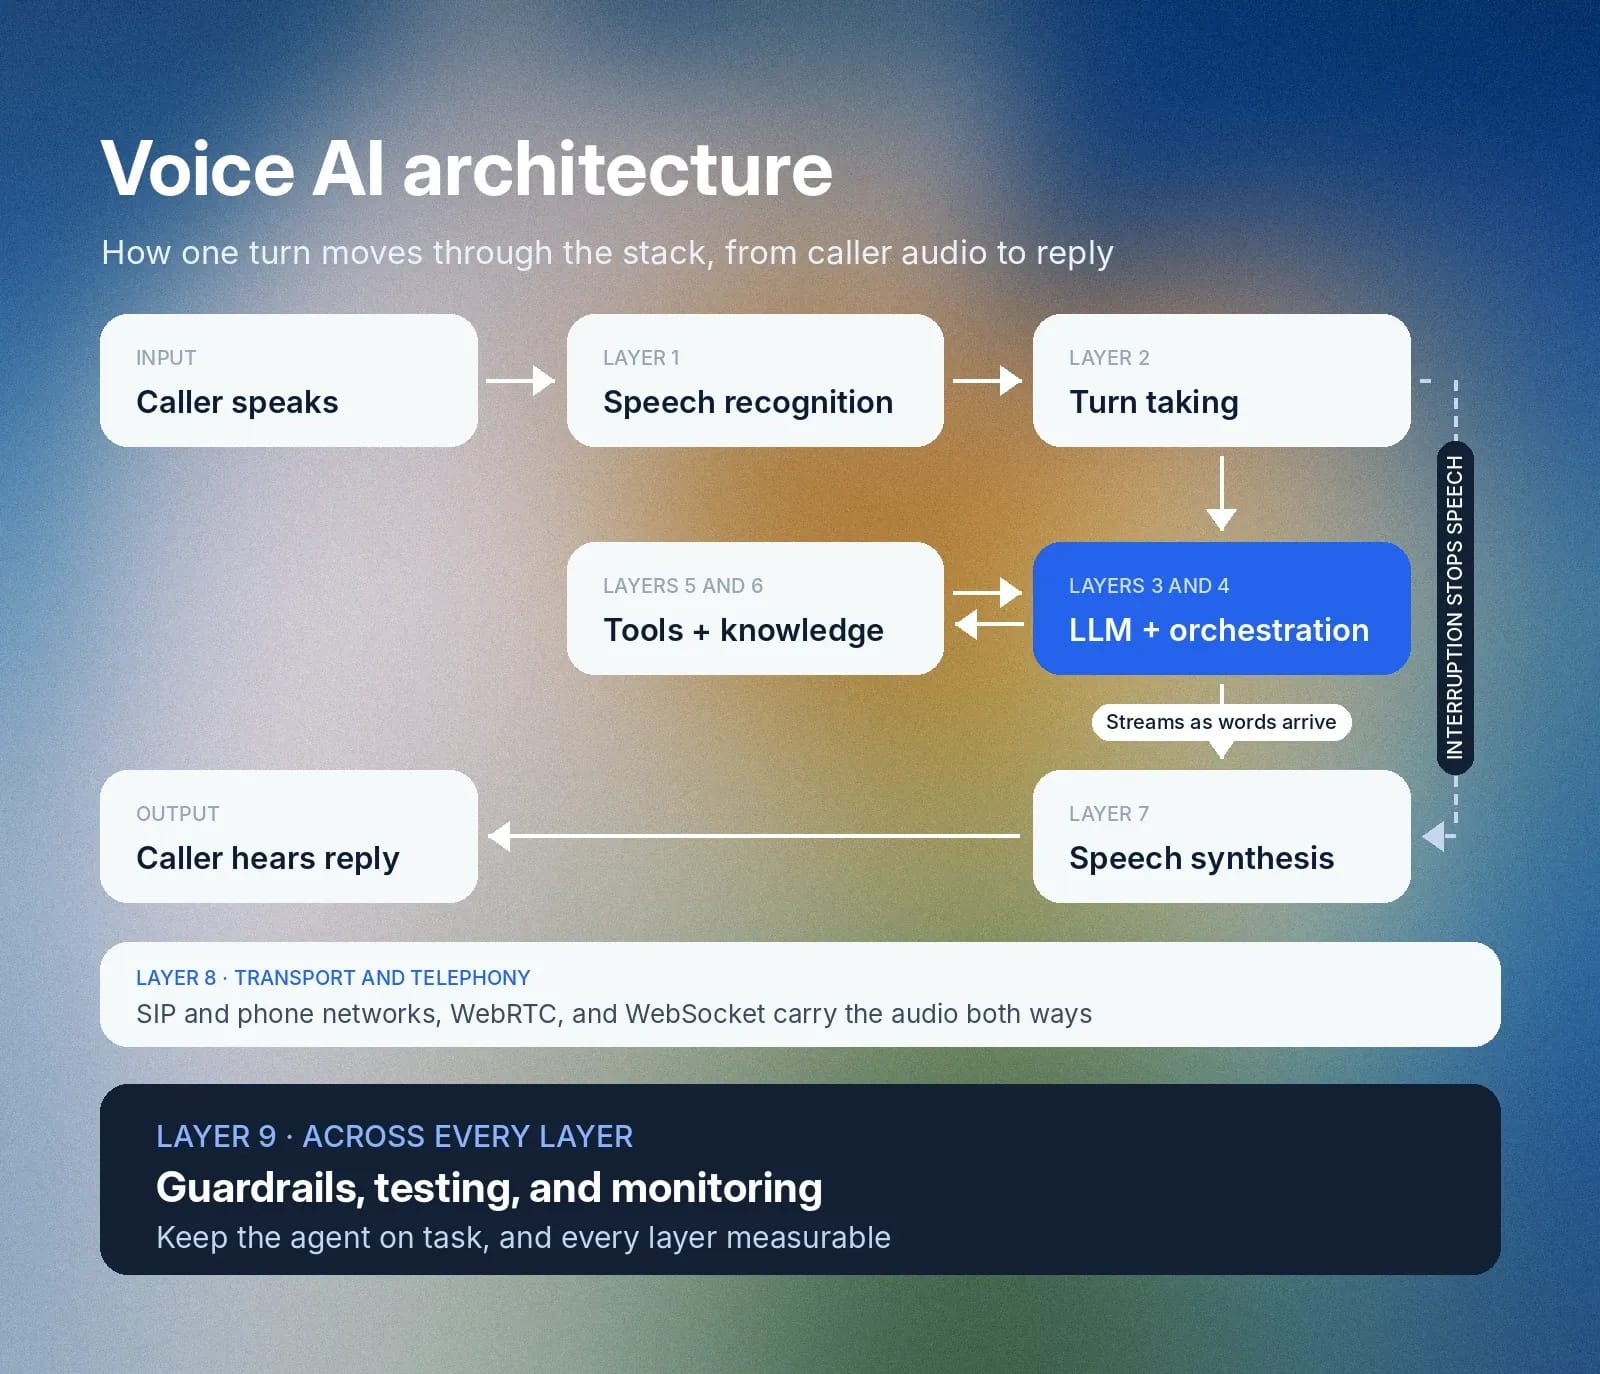
O fluxo não é uma linha reta. O ElevenAgents começa a falar depois que recebe “palavras suficientes e uma vírgula” do modelo de linguagem, o que significa que o áudio começa a tocar antes de a resposta completa existir. Chamadas de ferramentas e a recuperação ocorrem no meio de um turno. Interrupções podem ocorrer e são tratadas naturalmente pelo agente enquanto ele gera fala.
Duas formas de criar uma arquitetura de voz IA
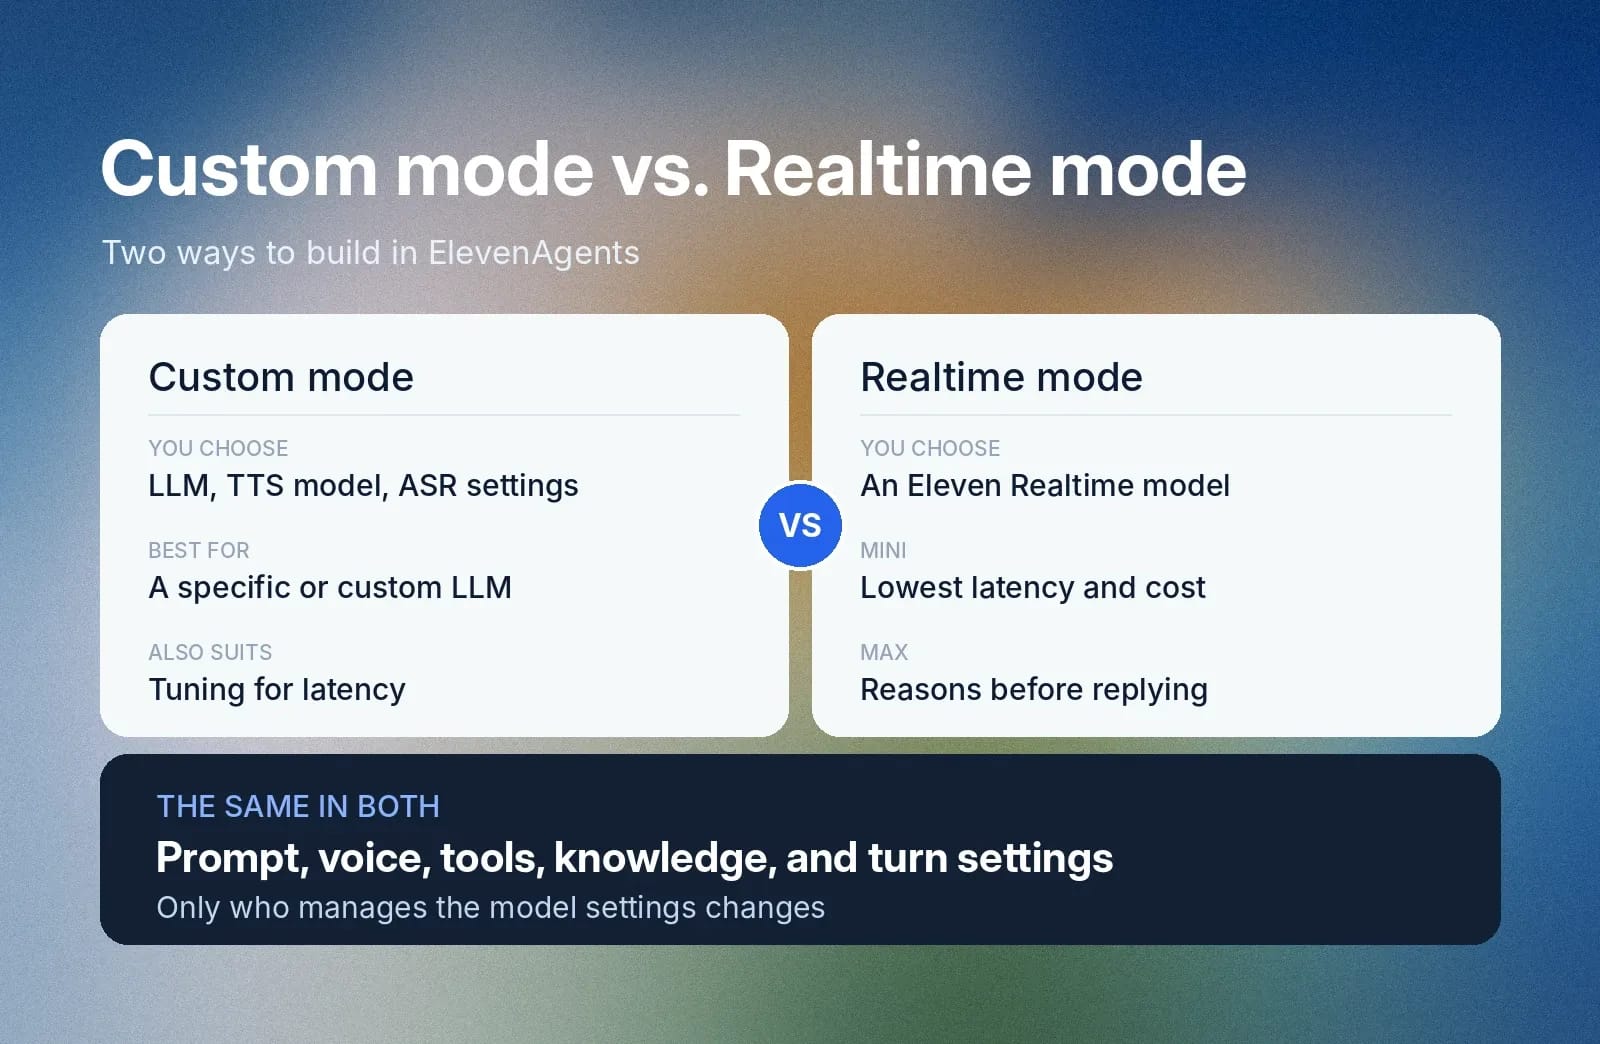
O ElevenAgents oferece dois modos de voz. No modo Custom, você escolhe o modelo de linguagem, o modelo de Text to Speech e as configurações de reconhecimento de fala.
No modo Realtime, você seleciona um modelo Eleven Realtime, e a ElevenLabs gerencia essas configurações para você. O Eleven Realtime v1 Mini é o padrão e tem a menor latência e o menor custo. O Eleven Realtime v1 Max raciocina antes de responder, sendo ideal para instruções mais complexas e casos que exigem uso de ferramentas em várias etapas.
O prompt de sistema, a voz escolhida, as ferramentas, a base de conhecimento anexada e as configurações de turno funcionam da mesma forma nos dois modos. O modo Custom é a melhor escolha quando você precisa de um modelo de linguagem específico, de um LLM personalizado ou de um modelo TTS específico (por desempenho ou otimização de latência.)
Reconhecimento de fala: transformando áudio em texto
O reconhecimento de fala, também chamado de ASR ou speech to text, é a primeira camada da stack.
O que faz
O modelo transcreve continuamente o áudio de quem liga enquanto essa pessoa fala. Fazer isso de forma contínua permite que o restante do pipeline comece a trabalhar antes de a frase terminar, reduzindo a latência. Modelos avançados lidam com tudo, de sotaques marcantes e diferentes velocidades de fala a ruído de fundo.
Por que isso importa para a infraestrutura de voz IA
A transcrição é, possivelmente, uma das camadas mais importantes da stack, pois qualquer erro nela se propaga pelas etapas seguintes. Entendeu errado uma referência de reserva? Registro do cliente errado atualizado. Errou o nome de um medicamento? Um possível desastre.
Em seu Trust Framework for Healthcare, a ElevenLabs mostra o quanto uma única sílaba mal compreendida pode ser crítica: hidroxizina versus hidralazina.
Como o ElevenAgents faz isso
O ElevenAgents usa o Scribe v2 Realtime, que transcreve a fala em aproximadamente 150 ms. A ElevenLabs o treinou para ruídos de fundo, sotaques diversos e identificadores como nomes, e-mails e IDs. No benchmark multilíngue FLEURS, abrangendo 30 idiomas, a ElevenLabs registrou a menor taxa de erro de palavras entre todos os modelos ASR de baixa latência.
Você o ativa na seção Advanced da configuração do agente. No mesmo white paper mencionado acima, a ElevenLabs informa que o Scribe v2 Medical lidera todos os modelos no benchmark público Eka Medical ASR, com uma taxa de erro de palavras de 7,0% na data da publicação.
Uma transcrição precisa — e rápida — fornece às próximas camadas a entrada limpa de que precisam sem adicionar latência significativa.
Gerenciamento de turnos: sabendo quando falar e quando parar
O gerenciamento de turnos é o conjunto de regras que decide quando o agente responde e quando escuta. Conseguir entender efetivamente os turnos em uma conversa e agir com base neles é o que diferencia uma conversa de um menu telefônico de URA legado.
O que faz
Um componente de gerenciamento de turnos oferece algumas funções à infraestrutura de voz IA:
- Detecção de atividade de voz (VAD): o VAD classifica o áudio de entrada como fala ou silêncio dezenas de vezes por segundo.
- Detecção de fim de turno: avalia se quem liga terminou de falar usando tom, ritmo e contexto das palavras.
- Interrupção: permite que quem liga interrompa; nesse momento, o agente para de falar para que o usuário continue.
- Sinais de acompanhamento: confirmações curtas, como “aham”, que não assumem o turno.
Por que isso importa
Em uma conversa humana, um intervalo de cerca de 200 ms é o intervalo típico entre falantes. Um agente que responde cedo demais corta a fala de quem liga, enquanto um que espera demais cria silêncios que fazem a chamada parecer falha ou sem resposta.
Por exemplo, imagine alguém que liga e diz: “Quero agendar para sexta-feira à tarde, mas...” e faz uma pausa. Um temporizador de silêncio responde durante a pausa e não capta a ressalva. Um modelo que lê as palavras e o ritmo espera, permitindo que o usuário conclua: “Não pode ser entre 15h e 17h, pois estarei ocupado.”
Um agente entende errado a intenção de quem liga e agenda a reunião no horário errado. O outro, com recursos eficazes de gerenciamento de turnos, garante que o período especificado seja evitado.
Como o ElevenAgents faz isso
O ElevenAgents executa um modelo proprietário de gerenciamento de turnos que analisa tom, ritmo e contexto das palavras, em vez de depender apenas de temporizadores de silêncio. Quando alguém interrompe, o sinal que para o agente chega em menos de 200 ms.
A ElevenLabs mede uma mediana de ~150 ms entre a solicitação e a fala audível com o Eleven v4 Turbo no ElevenAgents.
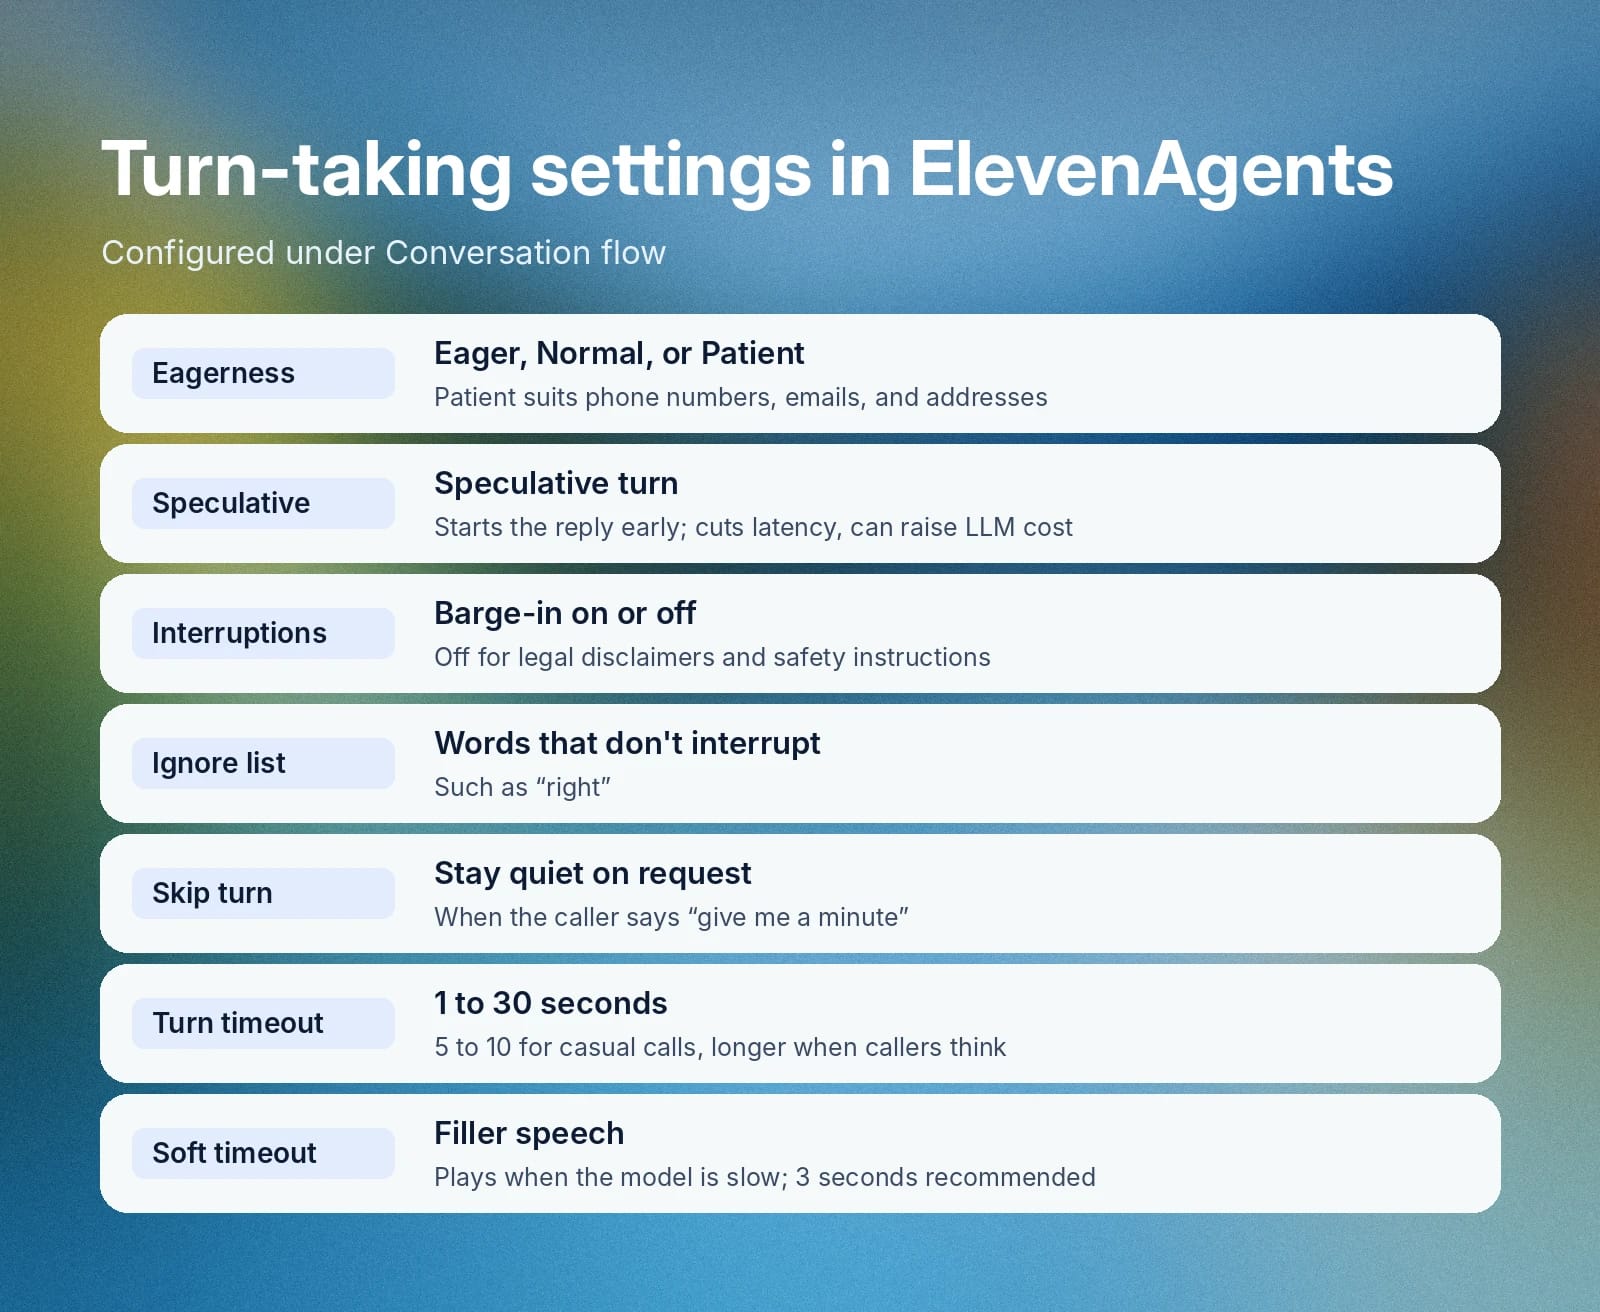
O comportamento pode ser configurado pelo fluxo da conversa:
Configuração
O que controla
Agilidade do turno
Eager responde na primeira oportunidade. Normal é o padrão equilibrado. Patient espera mais e é adequado para números de telefone, endereços e e-mails.
Turno especulativo
Inicia a resposta do modelo de linguagem antes de confirmar que quem liga terminou. Reduz a latência, mas pode aumentar o custo do LLM.
Interrupções
Desative-as quando todas as palavras precisarem ser ouvidas, como em avisos legais e instruções de segurança.
Lista de palavras ignoradas
Palavras como “certo” que não devem interromper o agente.
Ferramenta de pular turno
Mantém o agente em silêncio quando quem liga diz “me dê um minuto”.
Tempo limite do turno
Assume um turno após 1 a 30 segundos de silêncio. Use 5 a 10 segundos para conversas casuais e 10 a 30 quando quem liga precisar de tempo para pensar.
Tempo limite suave
Reproduz falas de preenchimento como “Hhmmmm... aham.” quando o modelo está lento. O intervalo vai de 0,5 a 8 segundos, com recomendação de 3 segundos.
Detecção de ambiente ruidoso
Uma configuração Enterprise que detecta vozes ao fundo e pede a quem liga para ir a um local mais silencioso, no máximo uma vez por conversa.
Os workflows podem alterar a agilidade do turno durante a chamada. Seu cliente também recebe um evento vad_score, uma probabilidade de 0 a 1 de que o usuário esteja falando.
Um gerenciamento de turnos bem ajustado determina se quem liga percebe o agente como atencioso ou abrupto. Para saber mais sobre os conceitos, consulte nosso guia completo sobre gerenciamento de turnos.
O modelo de linguagem: raciocinando e gerando a resposta
O grande modelo de linguagem (LLM) é a camada de raciocínio. Ele lê a transcrição, as instruções e a conversa até o momento, depois escreve a resposta ou decide chamar uma ferramenta.
O que faz
Um bot de voz roteirizado reconhece um pequeno conjunto de comandos. Um LLM interpreta solicitações formuladas de muitas maneiras diferentes, mantém o contexto entre turnos e decide quando recuperar informações ou transferir o atendimento.
Por que isso importa
Os modelos diferem em profundidade de raciocínio, velocidade e custo. Em uma conversa de voz ao vivo, o tempo de resposta importa tanto quanto a qualidade da resposta; portanto, escolher o modelo é uma decisão de latência e de custo.
Como o ElevenAgents faz isso
O ElevenAgents oferece uma única interface para modelos do Google, OpenAI e Anthropic, além de modelos abertos hospedados pela ElevenLabs. Você também pode conectar seu próprio LLM especificando um endpoint e armazenando credenciais como secrets. A ElevenLabs repassa os custos de LLMs de terceiros pela tarifa publicada pelo provedor, sem margem adicional.
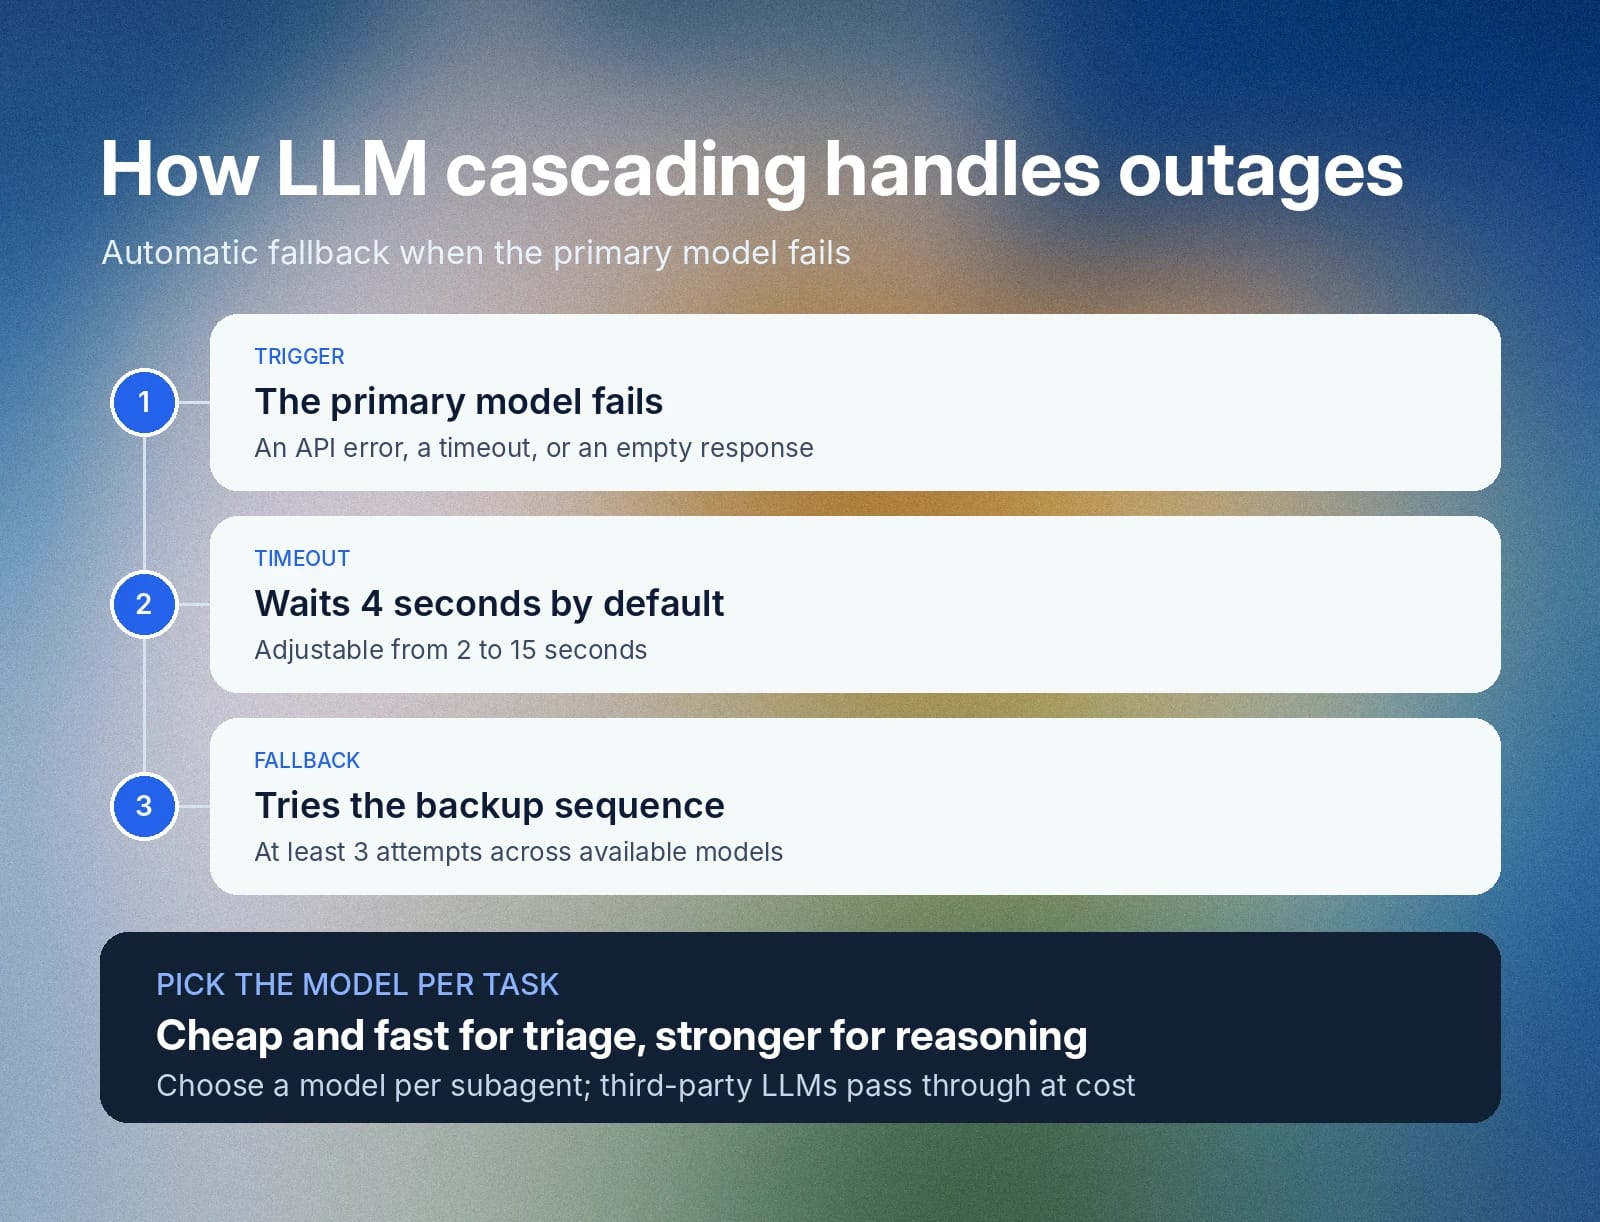
Você pode escolher o modelo por subagente. O Enterprise Conversational Agent Playbook, Volume 2, recomenda reservar modelos de maior desempenho para raciocínio complexo e usar modelos mais baratos e de baixa latência para tarefas como classificação de intenção e FAQs.
Provedores têm indisponibilidades. O encadeamento de LLMs lida com elas: se o modelo principal retornar um erro de API, exceder o tempo limite ou enviar uma resposta vazia, o ElevenAgents tenta uma sequência de backup. O tempo limite padrão para passar do principal ao backup é de 4 segundos, ajustável de 2 a 15 segundos, e o sistema faz pelo menos 3 tentativas entre os modelos disponíveis.
Um LLM personalizado usado como modelo principal tenta novamente pelo menos 3 vezes, a menos que você defina sua própria ordem de backup. O modelo certo para cada tarefa mantém o agente rápido e acessível.
Orquestração: direcionando o trabalho entre agentes e pessoas
A orquestração de agentes coordena os prompts, subagentes, ferramentas e pessoas envolvidos na conclusão de uma tarefa. Ela decide o que acontece em seguida em cada ponto da chamada.
O que faz
Um agente com um único prompt longo se torna difícil de gerenciar à medida que as responsabilidades se acumulam. A orquestração divide o trabalho em etapas, cada uma com suas próprias instruções, modelo e ferramentas, e move quem liga entre elas.
Por que isso importa
Prompts menores são mais fáceis de testar e mais baratos de executar, pois cada interação carrega menos texto. Dividir um fluxo permite que um modelo barato cuide da triagem e das FAQs e transfira para um modelo mais robusto apenas quando uma solicitação precisar disso.
Como o ElevenAgents faz isso
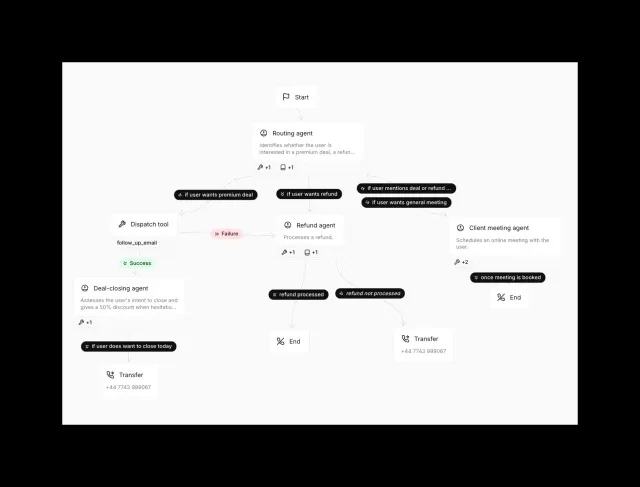
Os workflows no ElevenAgents são um criador visual de gráficos de conversa ramificados.
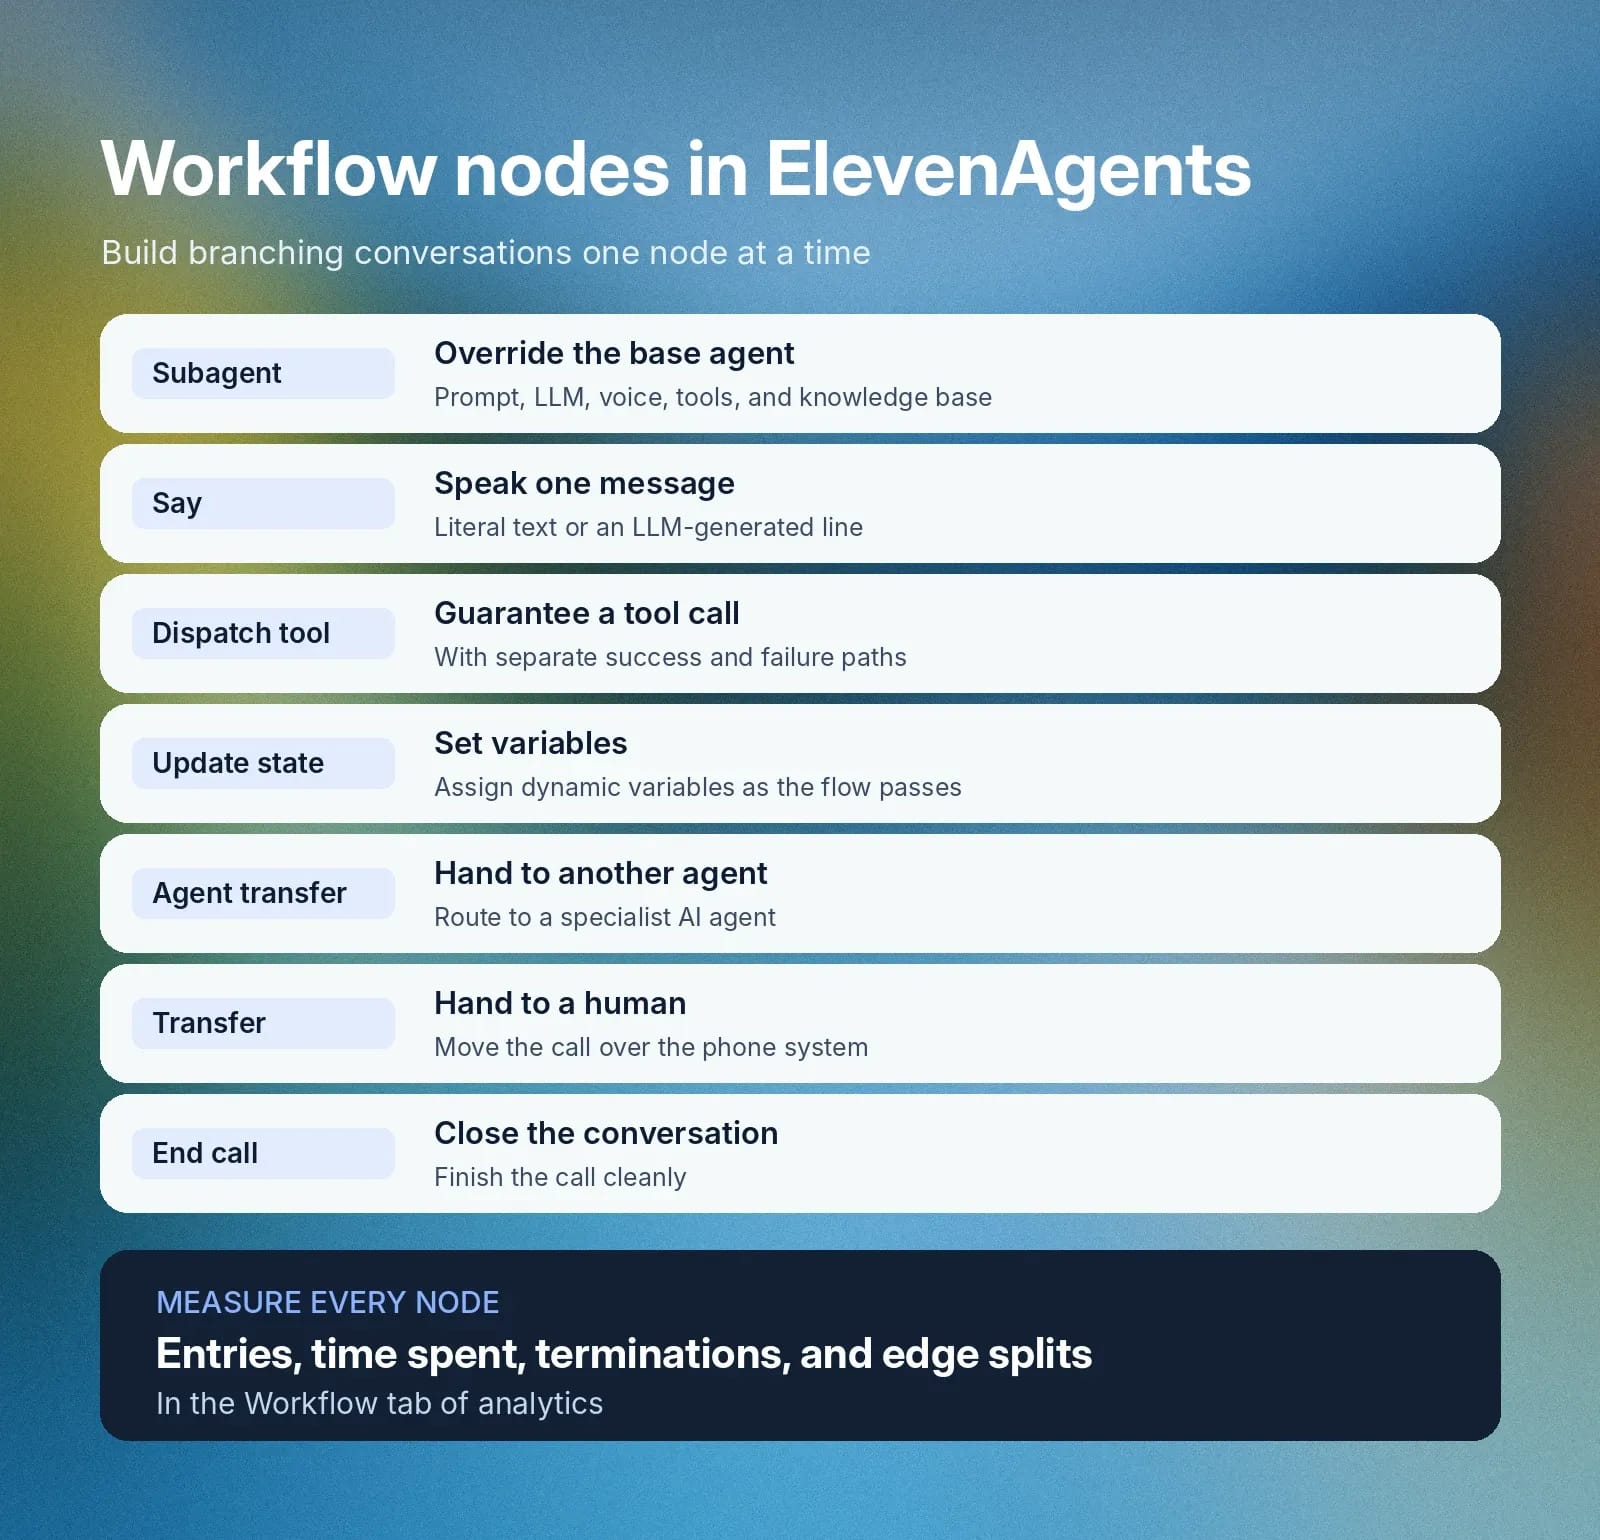
Os nós são:
- Subagente: altera ou substitui o agente base, incluindo prompt, LLM, voz, ferramentas e base de conhecimento.
- Falar: diz uma mensagem, seja texto literal ou uma linha gerada por LLM.
- Ferramenta de despacho: uma etapa dedicada que garante uma chamada de ferramenta, com caminhos separados para sucesso e falha.
- Atualizar estado: atribui variáveis dinâmicas à medida que o fluxo avança.
- Transferência de agente: transfere a chamada para outro agente.
- Transferir para número: move a chamada do agente de IA para uma pessoa pelo sistema telefônico.
- Encerrar chamada: encerra a conversa.
As conexões entre os nós carregam condições em linguagem natural que o LLM avalia em tempo real. Um fluxo de suporte pode começar com um subagente de roteamento em um modelo rápido, enviar dúvidas de faturamento a um subagente de faturamento em um modelo mais robusto e terminar com um nó de transferência para número quando quem liga pede uma pessoa. Após o lançamento, a aba Workflow nas análises mostra entradas, tempo médio gasto, encerramentos e distribuição de conexões para cada nó.
A orquestração transforma um único agente em um sistema que você pode projetar, medir e aprimorar, um nó por vez.
Ferramentas e MCP: permitindo que o agente aja
A chamada de funções, também chamada de chamada de ferramentas, permite que um agente solicite ações de softwares externos conectados à sua stack tecnológica.
Ela transforma uma interface de perguntas e respostas em um sistema de IA agêntica capaz de concluir tarefas e interagir com outras ferramentas em seu nome.
O que faz
Imagine alguém que liga e pede para mudar o compromisso de amanhã para sexta-feira. O agente recupera a reserva, verifica a disponibilidade de sexta-feira, atualiza o sistema de agendamento e confirma a alteração. Cada etapa é uma chamada de ferramenta que executa uma ação.
Por que isso importa
As ferramentas são onde as conversas geram resultados. Cada ferramenta precisa de entradas e saídas claras, e o agente precisa saber se uma chamada foi bem-sucedida antes de informar que ela foi concluída.
Como o ElevenAgents faz isso
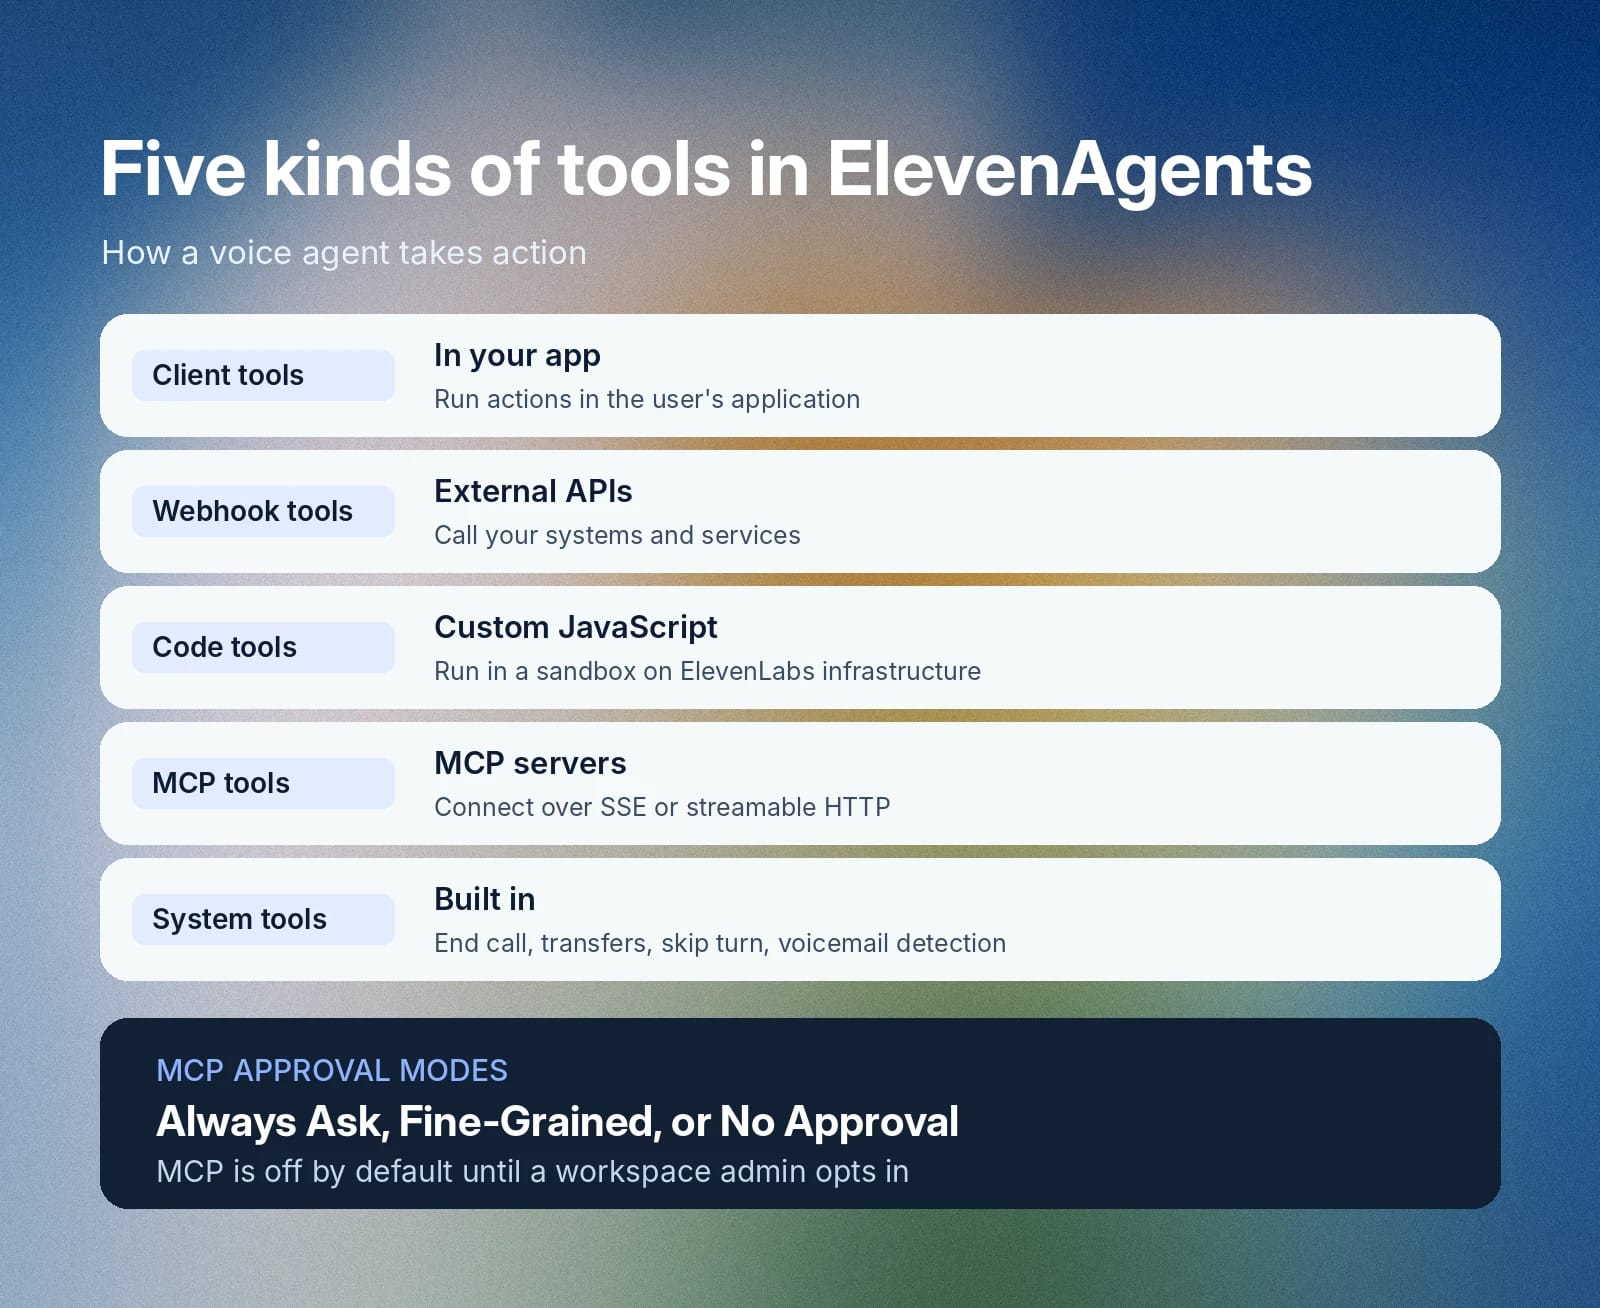
O ElevenAgents oferece ferramentas de cliente que são executadas no aplicativo do usuário, ferramentas de webhook que chamam APIs externas, ferramentas de código que executam JavaScript personalizado em uma sandbox na infraestrutura da ElevenLabs, ferramentas MCP e ferramentas de sistema integradas.
As ferramentas de sistema incluem encerrar chamada, detecção de idioma, transferência de agente, transferência para número, pular turno, reproduzir tom de tecla e detecção de caixa postal. Você pode adicionar áudio ambiente enquanto uma ferramenta é executada e controlar se quem liga pode interromper durante a execução.
O Model Context Protocol (MCP) é um padrão aberto para que aplicativos forneçam contexto e ferramentas a modelos de linguagem. O ElevenAgents se conecta a servidores MCP por SSE e HTTP streaming. Os administradores do workspace primeiro precisam habilitá-lo, pois o MCP vem desativado por padrão em todos os workspaces. Em seguida, você escolhe um modo de aprovação para cada servidor: Always Ask, Fine-Grained Tool Approval ou No Approval.
Eventos de cliente como client_tool_call e mcp_tool_call informam a atividade das ferramentas, e o evento MCP informa quatro estados: carregando, aguardando aprovação, sucesso e falha. Ferramentas confiáveis dão ao agente alcance no mundo real, e regras de aprovação claras mantêm esse alcance sob controle.
Conhecimento e memória: fatos e contexto de quem liga
A geração aumentada por recuperação (RAG) fornece ao agente fatos do seu próprio conteúdo, como uma base de fatos interna ou um registro mais amplo do histórico do cliente. Memória e personalização fornecem contexto sobre quem liga, permitindo que seu agente melhore a personalização e a utilidade para sua empresa.
O que faz
Um modelo de linguagem tem um limite de dados de treinamento e não tem acesso à sua documentação ou aos seus registros. O RAG pesquisa uma base de conhecimento a cada consulta, recupera os trechos mais relevantes e os fornece ao modelo para dar o contexto extra necessário para uma resposta útil.
Os dados de personalização informam ao agente quem está ligando e o que é relevante para essa pessoa.
Por que isso importa
Basear as respostas em conteúdo aprovado mantém as respostas precisas. A velocidade de recuperação também importa, pois cada milissegundo adicionado é mais um que seus clientes terão de esperar. As funções de personalização também evitam que quem liga precise repetir informações em chamadas diferentes, pois seus agentes terão os registros do CRM em mãos no início de cada nova sessão.
Como o ElevenAgents faz isso
Você adiciona documentos à base de conhecimento como arquivos (PDF, DOCX, TXT, MD, HTML ou EPUB, de até 20 MB cada), URLs ou texto colado. Um documento usa o contexto completo quando seu texto extraído cabe no prompt, até aproximadamente 300.000 caracteres. Documentos maiores usam RAG. A recuperação pode ser executada em todos os turnos ou sob demanda, e o modo de uso padrão é Auto, que usa RAG quando ele está habilitado e o documento está indexado.
A ElevenLabs trabalha diretamente na velocidade de recuperação. Seu artigo de engenharia, How we reduced RAG latency, documenta uma redução na latência mediana de RAG de 326 ms para 155 ms usando modelos auto-hospedados em uma infraestrutura que a ElevenLabs já opera.
Para o contexto de quem liga, o ElevenAgents usa variáveis dinâmicas escritas como {{ var_name }}, que preenchem mensagens, prompts de sistema e ferramentas. Para chamadas recebidas por Twilio, tronco SIP, WhatsApp e SMS, o ElevenAgents pode buscar dados de início no seu servidor antes de a conversa começar. Seu servidor procura quem liga por caller_id e retorna as variáveis, por exemplo, do seu CRM, em uma resposta de até 256 KB. Após a chamada, webhooks pós-chamada entregam resultados de avaliação e dados extraídos aos seus sistemas externos.
Juntas, a recuperação e a personalização fornecem ao agente os fatos certos e a pessoa certa.
Síntese de fala: dando voz ao agente
O Text to Speech (TTS) transforma a resposta do modelo de linguagem em áudio falado. É a camada que quem liga realmente ouve.
O que faz
O modelo converte texto em áudio com ritmo natural e entonação emocional. Em uma chamada ao vivo, ele transmite o áudio em blocos para que a reprodução comece antes de a resposta completa ser gerada.
Por que isso importa
A latência e a entrega moldam a avaliação que quem liga faz da chamada. Dois números importam para o trabalho em tempo real: o tempo para gerar áudio e o tempo até que a pessoa ouça o primeiro som. Nomes, nomes de medicamentos e termos técnicos também precisam ter a pronúncia correta, ou quem liga perde a confiança no agente.
Como o Eleven v4 potencializa a camada de voz
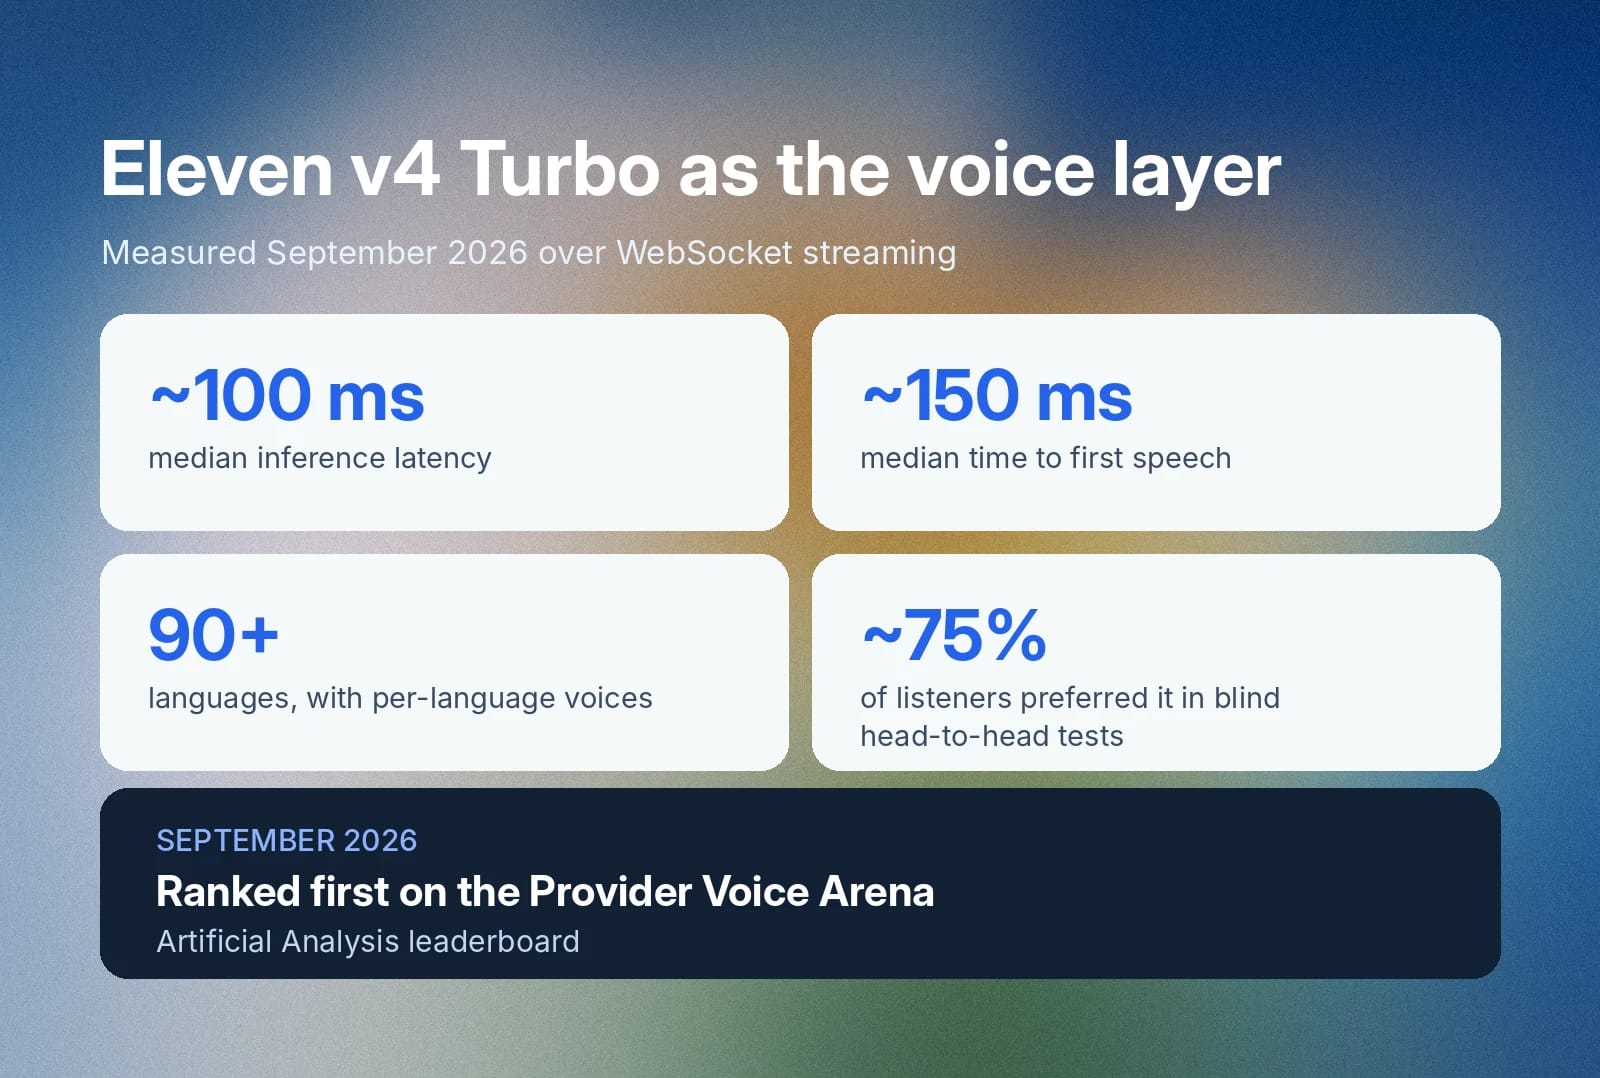
O Eleven v4 é o modelo de Text to Speech mais expressivo da ElevenLabs até hoje, desenvolvido com uma arquitetura totalmente nova. O Eleven v4 Turbo é a variante de baixa latência para uso em tempo real, como em agentes, otimizada com o ElevenAgents como um único sistema.
Eleven v4 Turbo
Valor
Latência mediana de inferência
Cerca de 100 ms
Tempo mediano até a primeira fala
Cerca de 150 ms
Idiomas
90+
A ElevenLabs mediu os números de latência em setembro de 2026 por streaming WebSocket, sem a latência de rede. O Eleven v4 ficou em primeiro lugar no Artificial Analysis Provider Voice Arena Leaderboard em setembro de 2026*, e cerca de 75% dos ouvintes o preferiram em testes cegos**.
* Artificial Analysis, Provider Voice Arena Leaderboard, set. 2026
** Com base em testes de preferência de usuários frente a frente contra Cartesia Sonic 3.6, Inworld TTS-2, Google Gemini 3.8 Flash-Lite TTS e Google Gemini 3.8 Flash TTS.
O Eleven v4 oferece suporte a audio tags inline, como [laughs], para entonação e suporte a fonemas IPA para pronúncia. Em agentes de saúde, esse controle de pronúncia abrange termos médicos. O ElevenAgents adiciona controles no nível do agente. O suporte a várias vozes permite que um agente alterne entre vozes em conversas com vários personagens. A velocidade varia de 0,7x a 1,2x. Cada idioma adicional pode usar sua própria voz. Os dicionários de pronúncia aceitam notação IPA ou CMU para palavras específicas.
Um primeiro som rápido e uma voz precisa e expressiva fazem o agente parecer um parceiro de conversa.
Telefonia e transporte: conectando o agente a quem liga
A camada de transporte leva o áudio entre quem liga e o agente. Dependendo do canal de telefonia usado, as integrações que você incluirá aqui na sua infraestrutura de voz IA mudarão.
O que faz
As chamadas telefônicas trafegam por uma rede telefônica e por SIP, enquanto as conversas no navegador e no aplicativo trafegam por WebRTC ou WebSocket. Um widget de site envolve a conexão do navegador em uma interface pronta para uso.
Por que isso importa
Cada canal tem necessidades de configuração e limitações de áudio diferentes; por isso, defina seus canais cedo. Uma implantação com foco em telefone precisa de trunking e gerenciamento de números. Uma implantação de produto precisa de um SDK.
Como o ElevenAgents faz isso
- Trunking SIP: conecta seu sistema telefônico diretamente à ElevenLabs, para chamadas de entrada e saída. Funciona com Twilio, Vonage, Sinch, Infobip, Telnyx e outros provedores padrão. A sinalização opera por TCP na porta 5060 ou TLS 1.2 ou superior na porta 5061, e o áudio usa G.711 ou G.722. Planeje pelo menos 100 Kbps por chamada. Os limites de chamadas simultâneas seguem seu plano de assinatura, e quem liga aguarda quando a fila de chamadas está habilitada.
- Integração nativa com Twilio: importe um número Twilio adquirido para chamadas de entrada e saída. IDs de chamada verificados funcionam apenas para chamadas de saída.
- Chamadas em lote: envie uma lista de destinatários em CSV ou XLS, e cada coluna extra se torna uma variável dinâmica. Você pode executar imediatamente ou agendar um início. Os lotes usam o menor valor entre 50% do limite de simultaneidade do seu workspace e 70% do limite de simultaneidade do seu agente, deixando capacidade para chamadas recebidas.
- WebRTC e WebSocket: por padrão, os SDKs usam WebRTC para voz e WebSocket para conversas apenas de texto. Agentes privados são autenticados com uma URL assinada ou um token de conversa criado no seu servidor. O endpoint WebSocket é wss://api.elevenlabs.io/v1/convai/conversation.
- SDKs: Python, JavaScript, React, React Native, Swift, Kotlin e Unity.
- Widget: adicione o elemento <elevenlabs-convai> a uma página. Ele oferece modos somente voz, voz mais texto e chat, e o agente pode mostrar respostas rápidas e carrosséis.
Um agente pode atender por telefone, web, WhatsApp, SMS e e-mail, o que permite que as equipes criem uma vez e implementem em vários canais.
Guardrails: mantendo o agente focado na tarefa
Guardrails são controles que mantêm o comportamento de um agente dentro de limites definidos. Eles funcionam junto com o embasamento, pois um guardrail limita o que o agente diz sem tornar corretos os fatos por trás disso. Os guardrails operam em paralelo às conversas do agente, ajudando a manter suas conversas com agentes de IA em conformidade e precisas.
O que faz
O ElevenAgents aplica guardrails em três níveis. O prompt de sistema define comportamentos permitidos e proibidos, idealmente sob o título # Guardrails. A validação da entrada do usuário examina mensagens em busca de injeção de prompt. A validação de resposta verifica cada resposta antes da entrega.
Por que isso importa
Um agente que sai do assunto ou inventa uma política corrói a confiança rapidamente. Um agente de atendimento ao cliente deve recuperar a política de reembolso de uma fonte aprovada antes de responder, e um guardrail reforça esse limite.
Como o ElevenAgents faz isso
O ElevenAgents lançou o Guardrails 2.0 em setembro de 2026. Com esse novo sistema, veja algumas configurações que ajudam os guardrails a funcionar com eficácia:
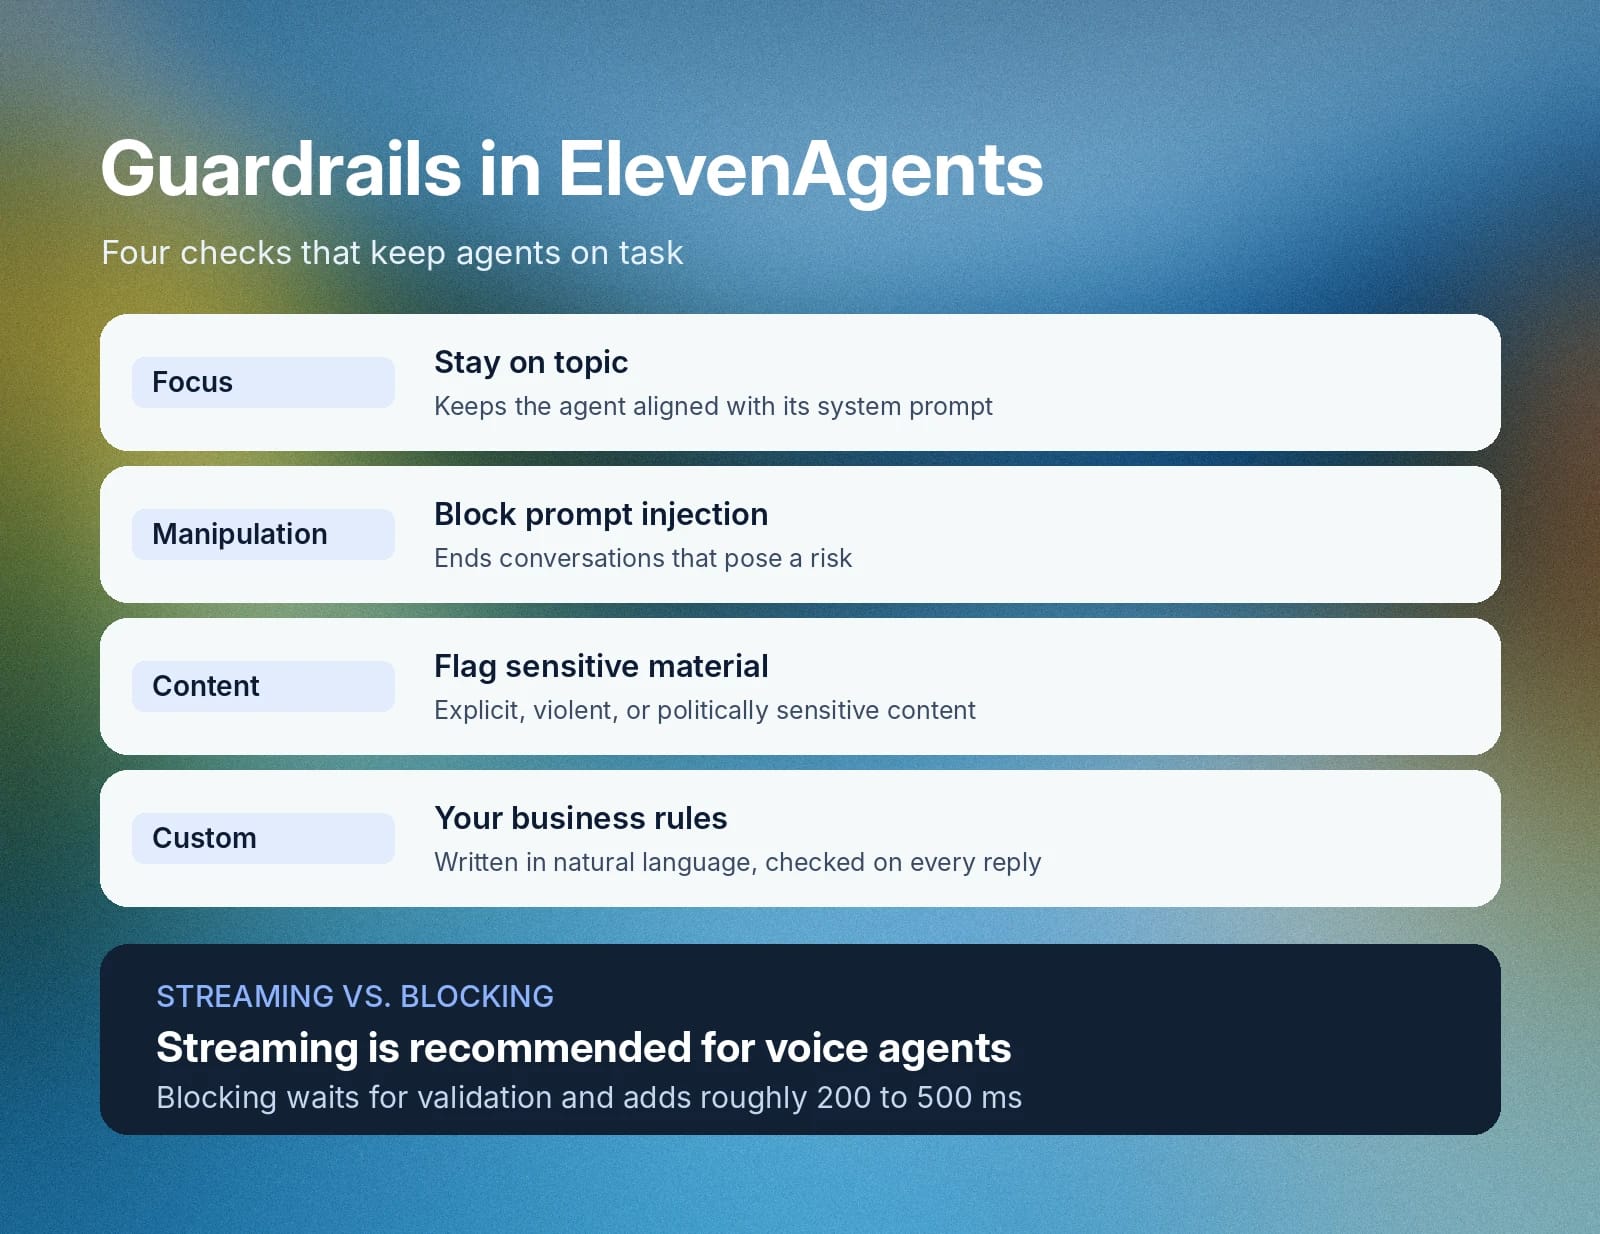
- Foco: mantém o agente no assunto e alinhado ao prompt de sistema.
- Manipulação: detecta injeção de prompt e encerra conversas que apresentam risco.
- Conteúdo: sinaliza categorias como material sexualmente explícito, violento ou politicamente sensível.
- Personalizado: regras de negócios escritas por você em linguagem natural, avaliadas em cada resposta.
O modo de execução determina a troca entre latência e controle. O modo streaming permite que a resposta comece antes de a verificação terminar; assim, menos de 500 ms de áudio podem tocar antes que um bloqueio encerre a chamada, e a ElevenLabs o recomenda para agentes de voz. O modo blocking espera a validação e adiciona cerca de 200 a 500 ms.
Quando um guardrail personalizado é acionado, a ação de acionamento encerra a chamada ou tenta novamente a resposta até três vezes com o feedback que você escreve. Seu cliente pode escutar o evento guardrail_triggered.
Guardrails em camadas com um perfil de latência escolhido mantêm o comportamento previsível sem desacelerar todas as respostas.
Testes e experimentos: comprovando que o agente funciona
Os testes verificam um agente antes do lançamento. Os experimentos verificam mudanças em relação ao tráfego real após o lançamento.
O que faz
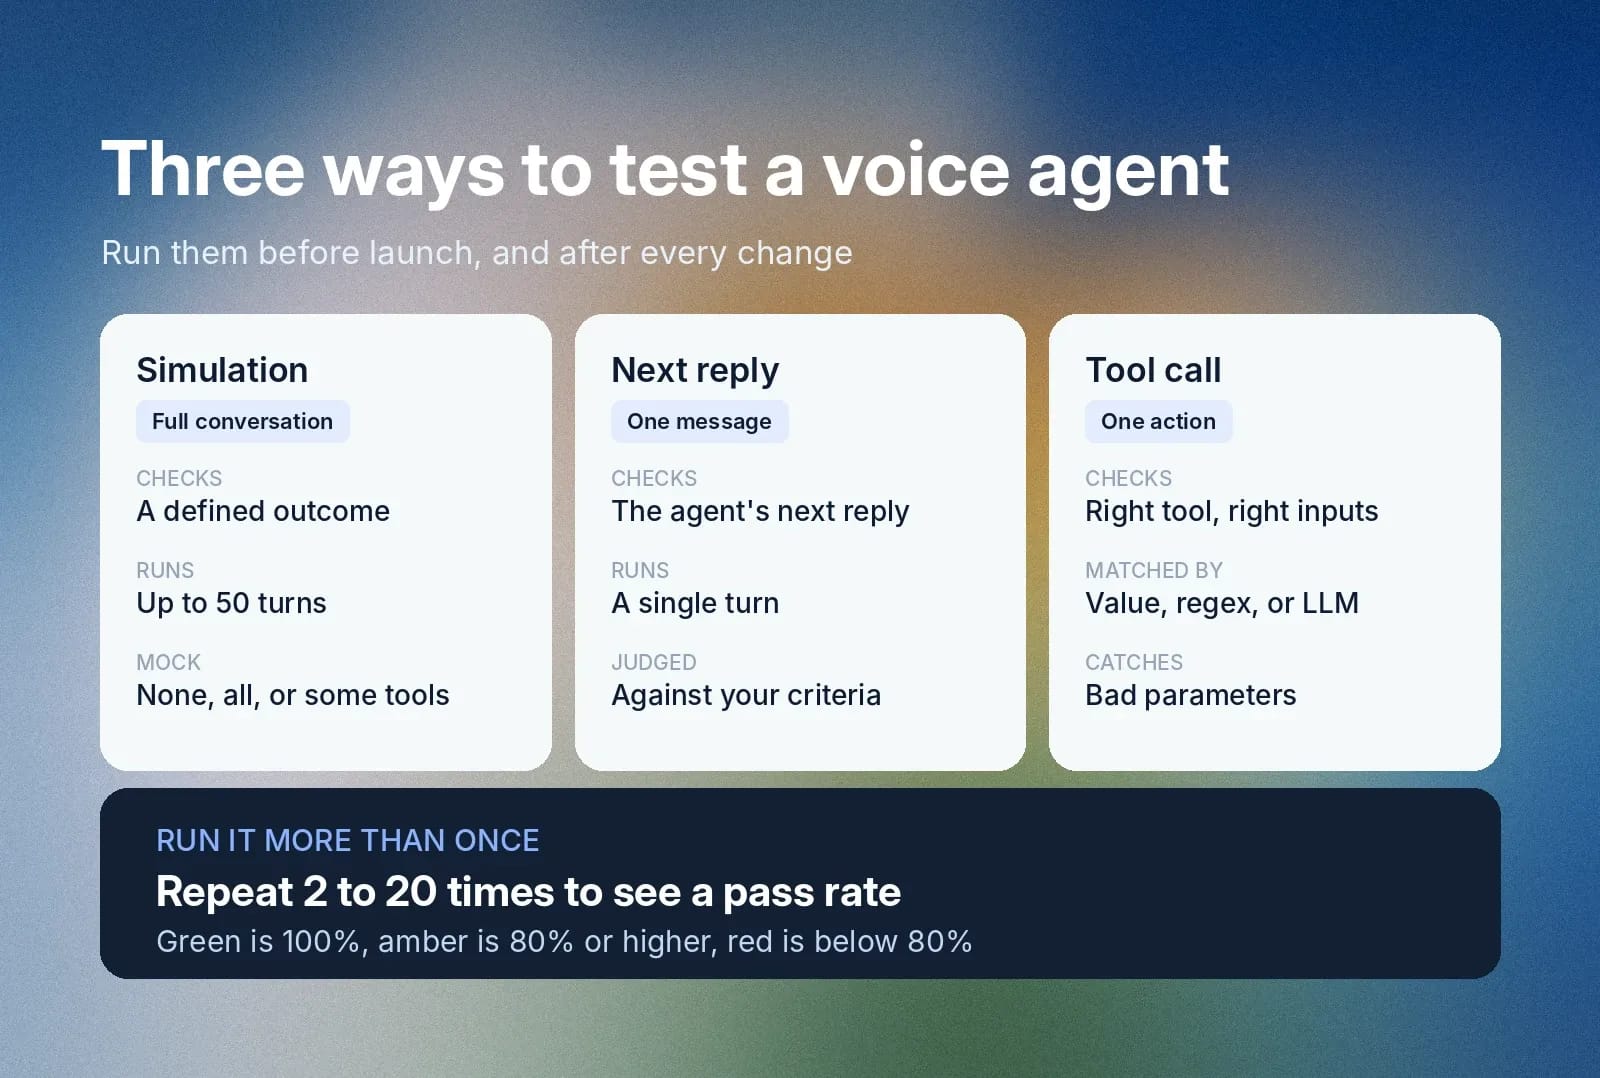
O ElevenAgents tem três tipos de teste de agente. A simulação executa uma conversa completa com um usuário simulado e verifica se ela alcança um resultado definido, com até 50 turnos (o padrão é 5). Os testes Next Reply avaliam apenas a próxima mensagem do agente conforme seus critérios. Os testes Tool Call verificam se o agente usa a ferramenta certa com os parâmetros certos, por valor exato, regex ou avaliação do LLM. Em simulações, você pode simular nenhuma, todas ou algumas ferramentas.
Por que isso importa
Uma única execução aprovada mostra que um agente pode ter sucesso. Executar testes repetidamente mostra com que frequência isso acontece. A API aceita repeat_count de 2 a 20, e os resultados exibem uma taxa de aprovação. Verde significa 100%, âmbar significa 80% ou mais, e vermelho significa menos de 80%. As falhas são agrupadas por motivo. Prompts, modelos, workflows e integrações alteram o comportamento, portanto, os testes continuam após o lançamento.
Como funcionam os experimentos
Experimentos são testes A/B baseados no versionamento de agentes. Você cria uma ramificação da configuração, altera uma variável — como o prompt de sistema, workflow, voz, ferramentas, base de conhecimento ou configurações de LLM — e direciona uma parte do tráfego real para a variante. A ElevenLabs recomenda começar com 5 a 10%.
O roteamento é determinístico pelo ID da conversa; assim, um determinado usuário permanece na mesma ramificação, e os percentuais devem totalizar 100%. A CARS24, cliente da ElevenLabs, aumentou o tráfego para 5%, 10%, 20%, 50% e 100%, mantendo cada etapa por dois dias, conforme descrito no relatório.
Juntos, os testes pré-lançamento e os experimentos ao vivo transformam mudanças em melhorias mensuradas.
Observabilidade: medindo o que acontece em produção
Observabilidade é a capacidade de ver o que o agente fez, como ele se saiu e, se for o caso, onde falhou. Um agente que funciona em um teste pode se comportar de forma diferente com pessoas reais ligando, o que torna indispensáveis a observabilidade completa e a manutenção de registros auditáveis.
O que faz
A análise de conversas pontua cada chamada. A avaliação de sucesso aplica critérios que você define para alcance do objetivo e qualidade, e a coleta de dados extrai campos estruturados como informações de contato e tipo de problema. O painel de análises adiciona volume de chamadas, duração, custo, taxas de erro e latência. Chamadas ativas são atualizadas em tempo real, e alertas são disparados quando as taxas de erro aumentam.
Por que isso importa
Sem monitoramento, uma chamada ruim é apenas uma anedota. Com ele, você pode ver qual nó, ferramenta ou modelo causou o problema.
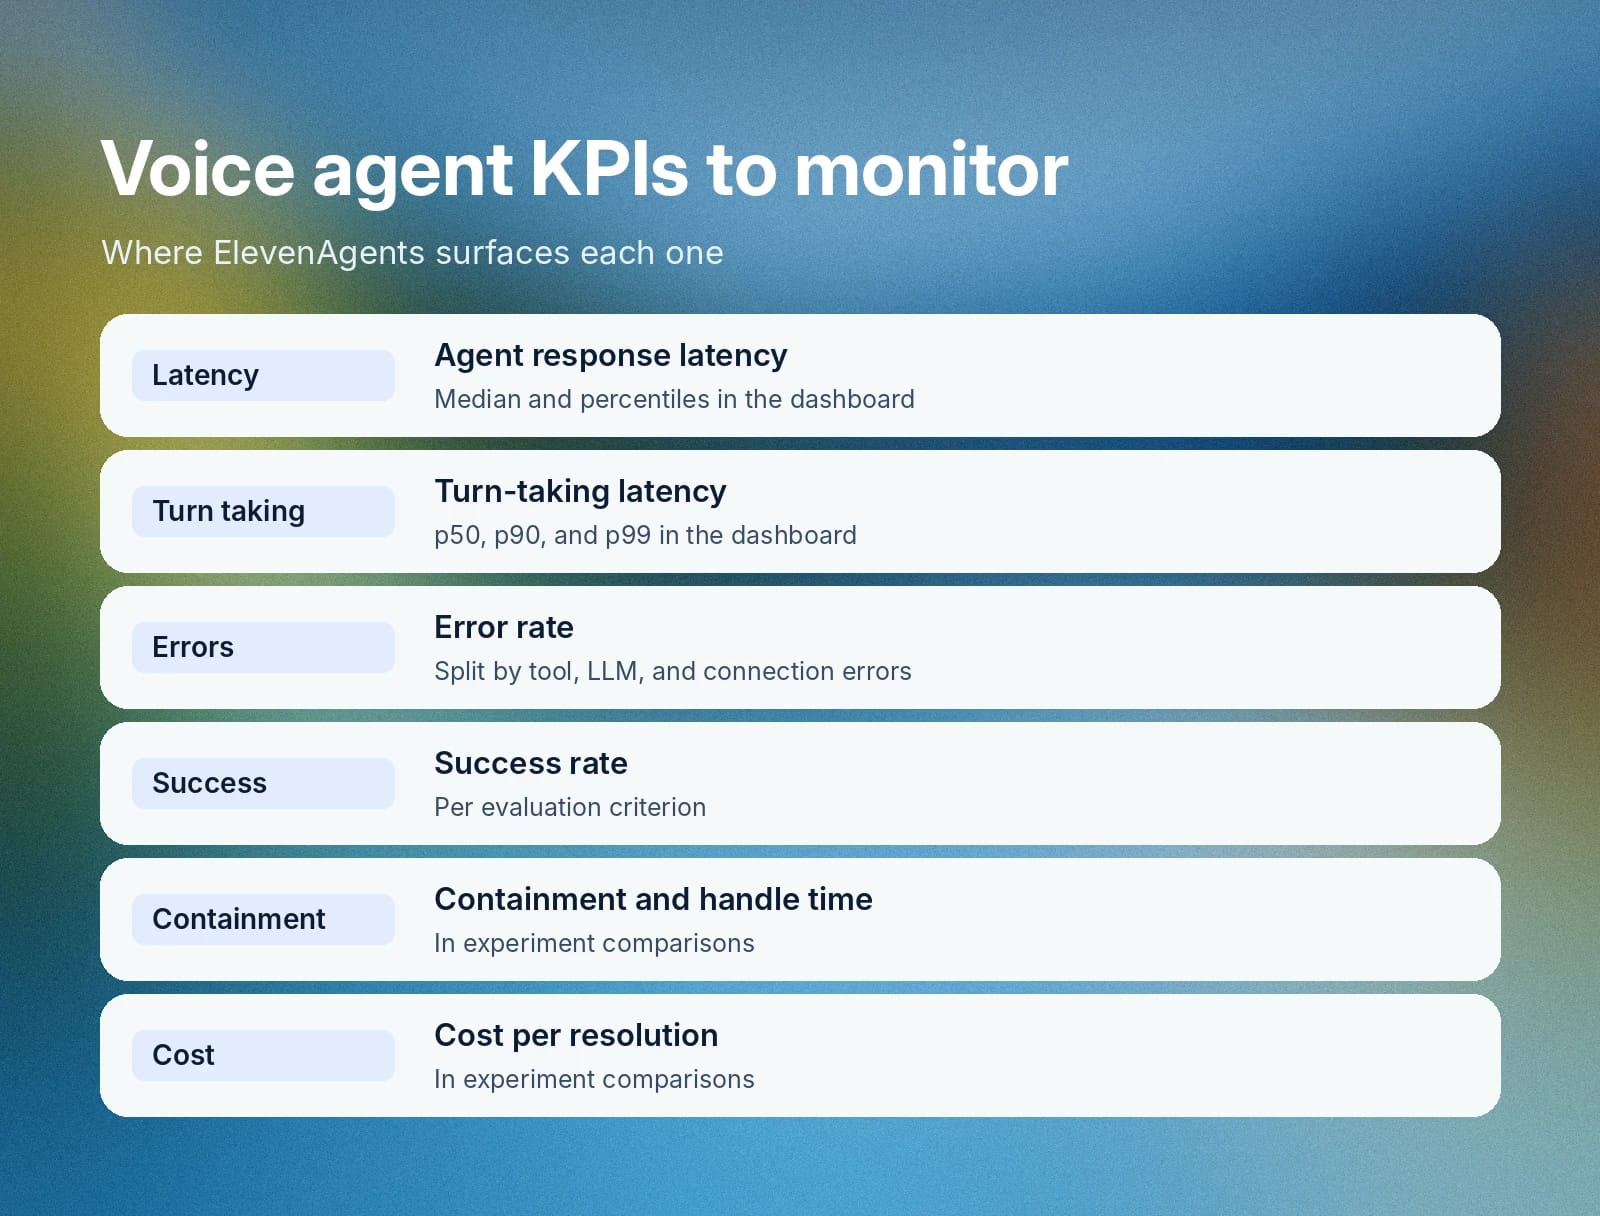
KPI
O que informa
Onde o ElevenAgents mostra
Latência de resposta do agente
Quanto tempo quem liga espera por uma resposta
Painel de análises, mediana e percentis
Latência de gerenciamento de turnos
Com que rapidez o agente assume seu turno
Painel de análises, p50, p90 e p99
Taxa de erro
Proporção de conversas com erros
Painel, detalhado por erros de ferramenta, LLM e conexão
Taxa de sucesso
Alcance do objetivo por critério
Critérios de avaliação, com taxas de sucesso, falha e desconhecido
Taxa de contenção e tempo de atendimento
Chamadas resolvidas sem uma pessoa e duração da chamada
Comparações de experimentos
Custo por resolução
Quanto custa cada conversa resolvida
Comparações de experimentos
Escolha as métricas mais úteis para o trabalho específico que você tem em mente. Um agente de suporte prioriza resolução e escalonamento, enquanto um agente de saída se concentra principalmente em conexão e conclusão.
Escala, confiabilidade e transferência para humanos
A infraestrutura de voz IA precisa funcionar tanto para 5 clientes quanto para 500.000. Mesmo em grande volume, esses componentes precisam ser resilientes e conseguir escalar para pessoas quando necessário.
O que faz
Escala significa oferecer suporte a muitas conversas simultâneas entre reconhecimento de fala, inferência de LLM, síntese de fala, integrações e telefonia. Confiabilidade significa que cada uma dessas dependências tem um caminho de falha definido. Transferência significa uma rota clara para uma pessoa.
Embora não sejam estritamente componentes da infraestrutura de voz IA, todos são partes essenciais do que torna um bom sistema na prática.
Por que isso importa
Um sistema que lida com dez chamadas de teste pode se comportar de forma diferente com dez mil. Uma ferramenta de reserva que excede o tempo limite não pode levar o agente a confirmar uma reserva que nunca aconteceu. Quem liga e pede uma pessoa deve chegar a ela com o contexto intacto, normalmente por meio de uma transferência assistida.
Como o ElevenAgents faz isso
Os limites de simultaneidade seguem o plano de assinatura, e a fila de chamadas mantém quem liga em espera quando um limite é atingido. O encadeamento de LLMs cobre indisponibilidades de modelos. Nós de transferência para número, a ferramenta de sistema de transferência para número e a transferência de agente cobrem o handoff, e os critérios de avaliação podem decidir quando escalar. Períodos silenciosos são cobrados a 5% da taxa usual por minuto.
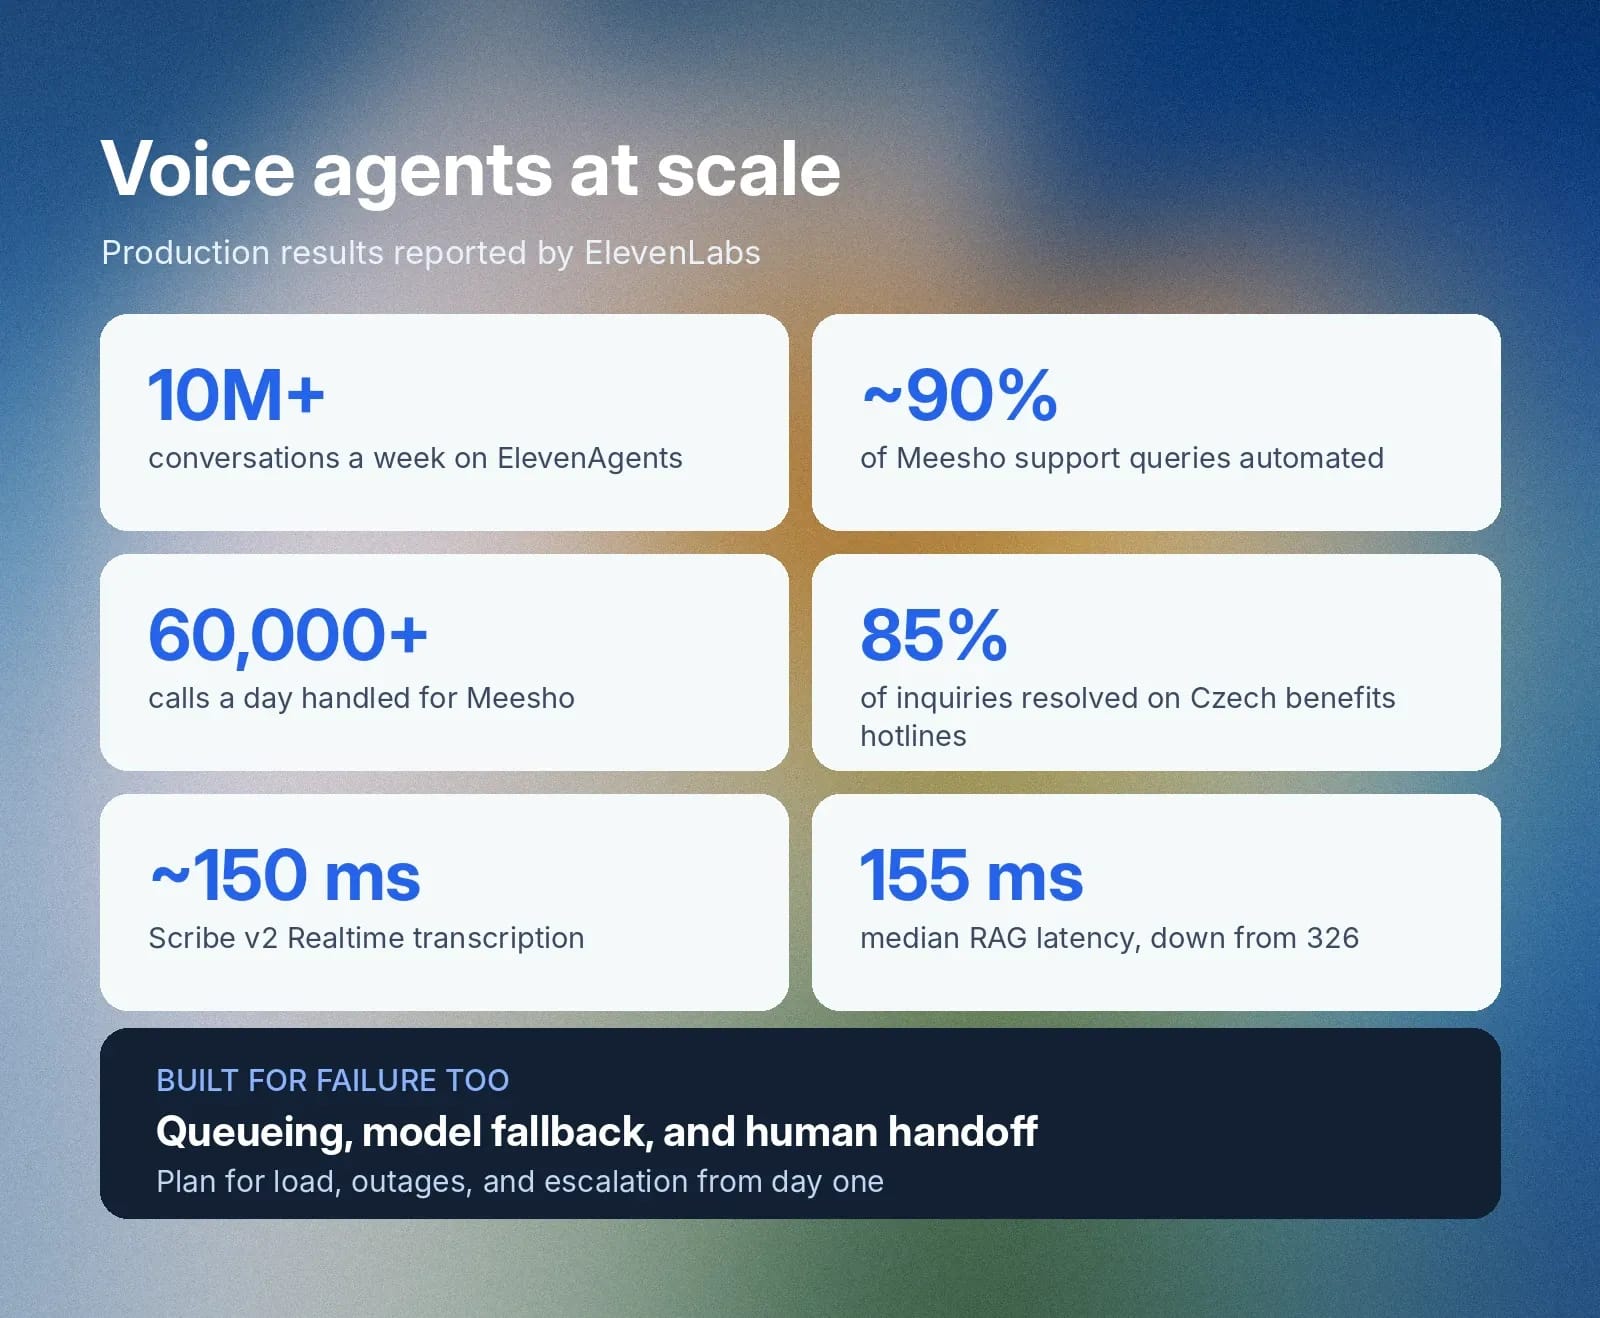
A ElevenLabs relata resultados em produção em escala. O ElevenAgents alimenta mais de 10 milhões de conversas por semana. A Meesho automatiza cerca de 90% das consultas de suporte em mais de 60.000 chamadas por dia, segundo o relatório Building Enterprise-grade Voice Agents. Na República Tcheca, agentes com tecnologia da ElevenLabs atendem cerca de 5.000 chamadas diárias em linhas nacionais de benefícios e resolvem de forma independente 85% das consultas, segundo o relatório State of Conversational Agents in Government.
Planejar carga, falhas e handoff desde o início é o que separa uma demonstração de uma implantação.
O que procurar em uma infraestrutura de voz IA pronta para produção em 2026
Use esta checklist para avaliar qualquer plataforma de voz IA em relação aos seus requisitos.
- Reconhecimento de fala: transcrições precisas para seus idiomas, sotaques e qualidade de áudio, incluindo nomes e identificadores.
- Gerenciamento de turnos: comportamento configurável de fim de turno, interrupção e tempo de resposta a interrupções mensurado.
- Escolha de modelo: um LLM selecionável por agente ou subagente, opção de LLM personalizado e fallback automático.
- Orquestração: workflows em várias etapas e roteamento entre agentes especializados.
- Ferramentas: webhooks, ferramentas de cliente, suporte a MCP e controles de aprovação.
- Conhecimento: seus próprios documentos, com latência de recuperação mensurável.
- Personalização: dados de quem liga disponíveis antes de a primeira palavra ser dita.
- Voz: baixo tempo até a primeira fala e controle sobre pronúncia e expressão.
- Canais: telefone, web, mobile e mensagens, com SDKs e uma API.
- Guardrails: limites de comportamento configuráveis com custo de latência conhecido.
- Testes: conversas simuladas, verificações de chamadas de ferramentas e execuções repetidas.
- Experimentos e análises: testes A/B, latência por percentil e detalhamento de erros.
- Escala e handoff: simultaneidade, enfileiramento e escalonamento para pessoas documentados.
Sistemas líderes de agentes de voz IA, como o ElevenAgents, oferecem todos esses componentes em uma única plataforma.
Comece hoje mesmo entrando em contato com a equipe ou crie seus próprios sistemas de agentes de IA criando uma conta.
Perguntas frequentes sobre infraestrutura de voz IA

Jack Limebear faz parte do time de Growth, atuando como redator e estrategista de conteúdo no blog e nas páginas de insights. Antes da ElevenLabs, ele passou mais de dez anos liderando estratégias de conteúdo em organizações que vão de startups SaaS em rápido crescimento a empresas da Fortune 500. Ele é mestre em Literatura Inglesa pela Universidade de Cambridge.