
O que é um LLM? Um guia prático sobre modelos de linguagem
- Escrito por
- Jack Limebear
- Publicado
OuvirOuça este artigo
Um modelo de linguagem grande (LLM) é um sistema de inteligência artificial treinado em um vasto conjunto de dados para analisar, prever e gerar linguagem natural. LLMs populares incluem os modelos GPT da OpenAI, o Claude da Anthropic e o Gemini do Google, que costumam ser usados para tarefas como redação, edição e programação.
Inicialmente, os conjuntos de dados de LLMs incluíam principalmente textos de fontes como livros, blogs e até fóruns on-line. Hoje, os LLMs usam dados multimodais para ampliar os casos de uso, como impulsionar agentes de voz conversacionais ou criar música.
Antes de implementar essa tecnologia, as organizações geralmente precisam de respostas para perguntas como: o que é um LLM, como um LLM funciona e quais arquiteturas a equipe deve usar? Este guia responde a essas perguntas e mostra aplicações reais da tecnologia e seus benefícios concretos.
Resumo
- Um modelo de linguagem grande (LLM) é um modelo de inteligência artificial treinado em vastos conjuntos de dados de texto e dados multimodais para analisar, prever e gerar resultados.
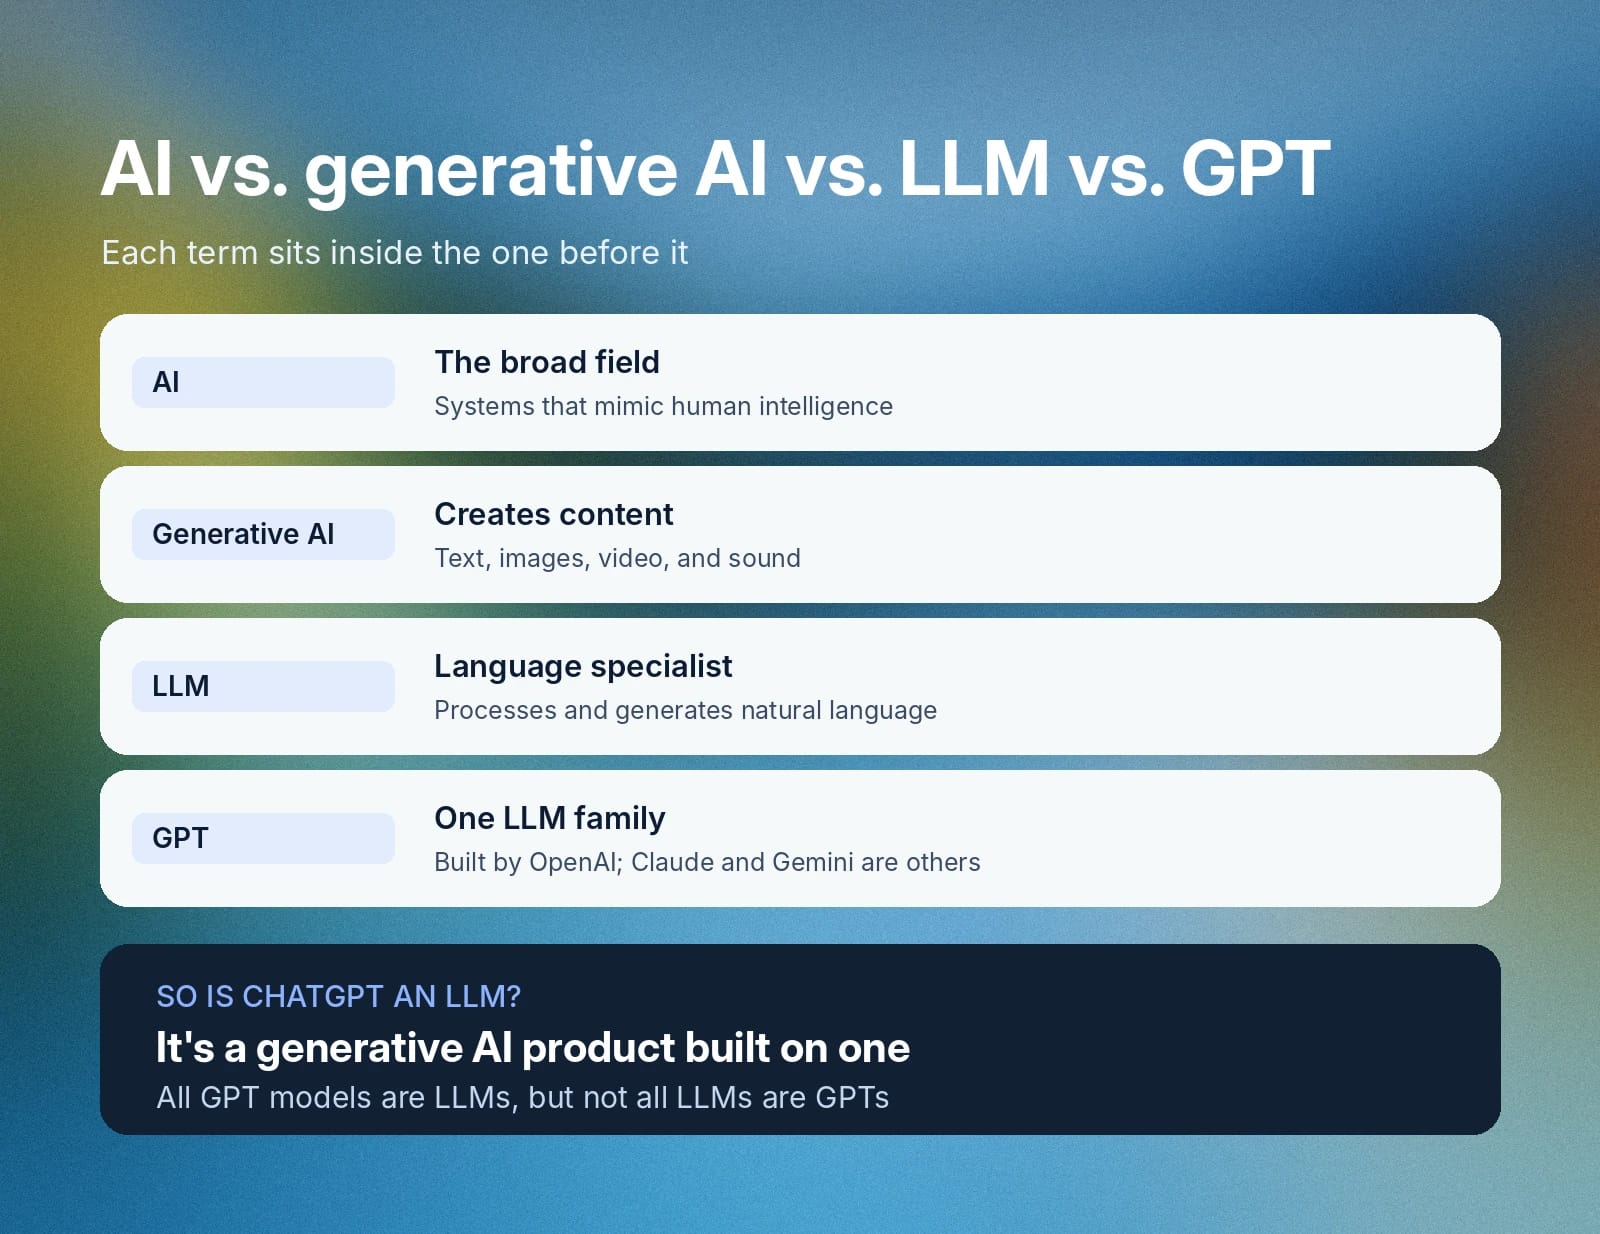
- A principal diferença entre GPTs e LLMs é que GPT (Generative Pre-trained Transformer) é uma família específica de LLMs criada pela OpenAI, enquanto LLM é o termo abrangente para modelos como Claude e Gemini.
- IA generativa é a categoria ampla de modelos que criam diversos tipos de conteúdo com base em dados de treinamento, enquanto os LLMs são um subconjunto especializado da IA generativa voltado ao processamento de linguagem natural.
- Os LLMs funcionam usando redes neurais transformer para dividir o texto em unidades menores chamadas tokens e, depois, prever o próximo token com base em informações contextuais do prompt e do histórico de chat existente.
- Exemplos práticos de modelos de linguagem grandes incluem chatbots de atendimento ao cliente, ferramentas automatizadas de escrita, geradores de código e camadas de processamento de linguagem natural para aplicações de voz.
O que é um LLM? A definição de modelo de linguagem grande
Um modelo de linguagem grande é um programa de IA baseado em redes neurais de aprendizado profundo para analisar, prever e gerar linguagem natural. Os desenvolvedores treinaram esses modelos em conjuntos de dados que contêm bilhões de obras, incluindo livros, artigos acadêmicos, sites e blogs. O termo “grande” se refere tanto ao enorme volume de dados usado para treinar esses modelos quanto aos bilhões de parâmetros internos que determinam seu comportamento.
Os modelos de linguagem grandes representam uma grande mudança em relação ao funcionamento dos softwares anteriores: os softwares tradicionais dependiam de comandos de sintaxe explícitos, mas os LLMs não. Em vez de processar cada palavra isoladamente, os LLMs usam relações contextuais para reconhecer padrões linguísticos complexos e regras gramaticais. Eles interpretam linguagem humana não estruturada e continuam respondendo a prompts abertos dos usuários, adaptando-se a mudanças de contexto no meio da conversa.
Esses avanços no processamento de linguagem natural potencializam o ElevenAgents para que ele entenda intenções complexas dos clientes e execute workflows automatizados.
Como funcionam os modelos de linguagem grandes?
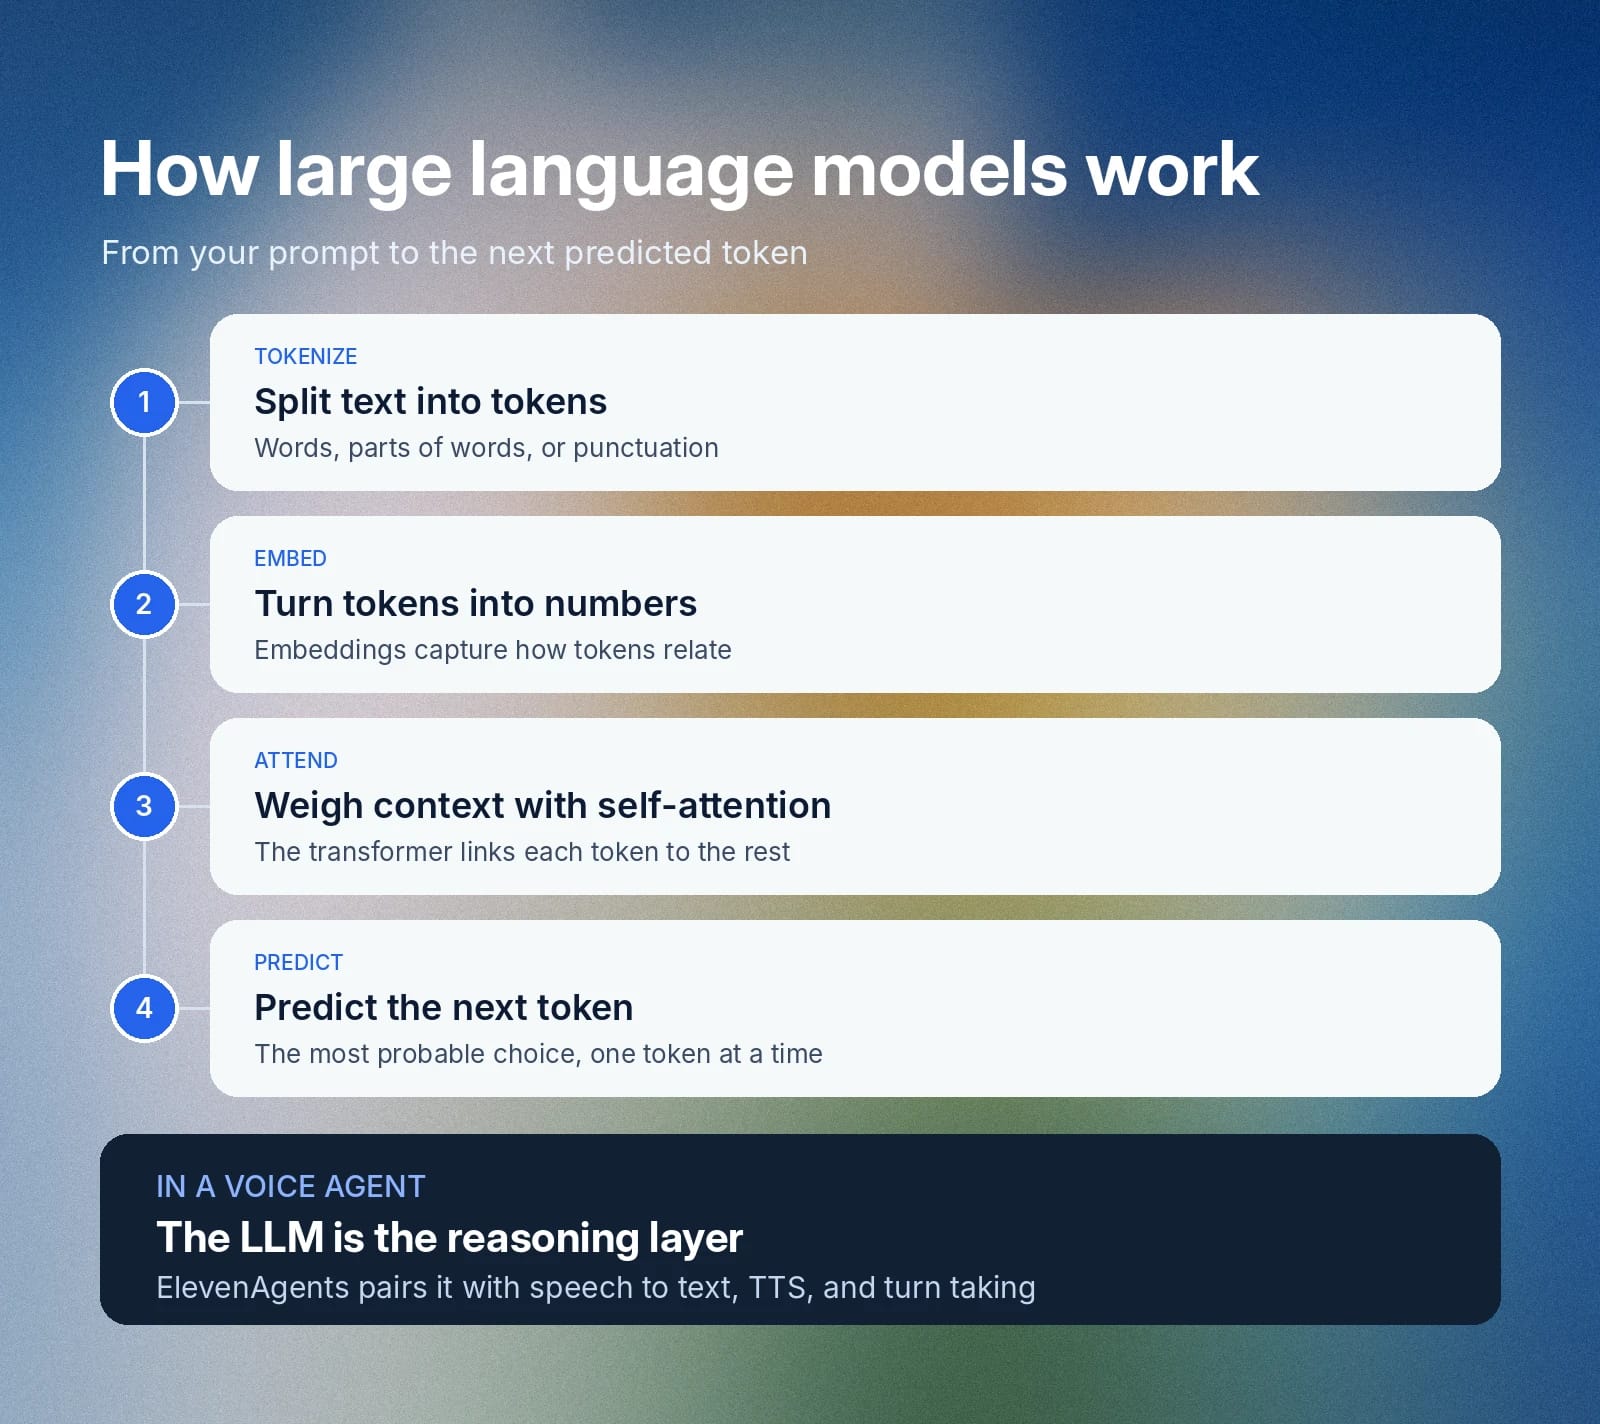
Os modelos de linguagem grandes processam texto por meio de redes neurais artificiais para analisar entradas em linguagem natural e gerar conteúdo relevante. O processo começa com a tokenização, em que o modelo divide o texto de entrada em unidades menores chamadas tokens. Em seguida, o modelo traduz esses tokens em representações numéricas, chamadas embeddings, para avaliar relações matemáticas ou estatísticas entre eles.
A maioria dos sistemas modernos de LLMs depende da arquitetura de redes neurais transformer. Os transformers usam mecanismos de autoatenção, que avaliam as relações contextuais entre os tokens. O modelo prevê o token estatisticamente mais provável para completar uma sequência usando padrões aprendidos para calcular distribuições de probabilidade.
A autoatenção permite que os modelos de processamento de linguagem natural mantenham o contexto de longo alcance e se adaptem a mudanças no meio de uma conversa. As integrações da plataforma com o ElevenAgents se baseiam nesses recursos para fornecer respostas relevantes e de baixa latência que reproduzem a conversa humana natural.
O que é temperatura em um LLM?
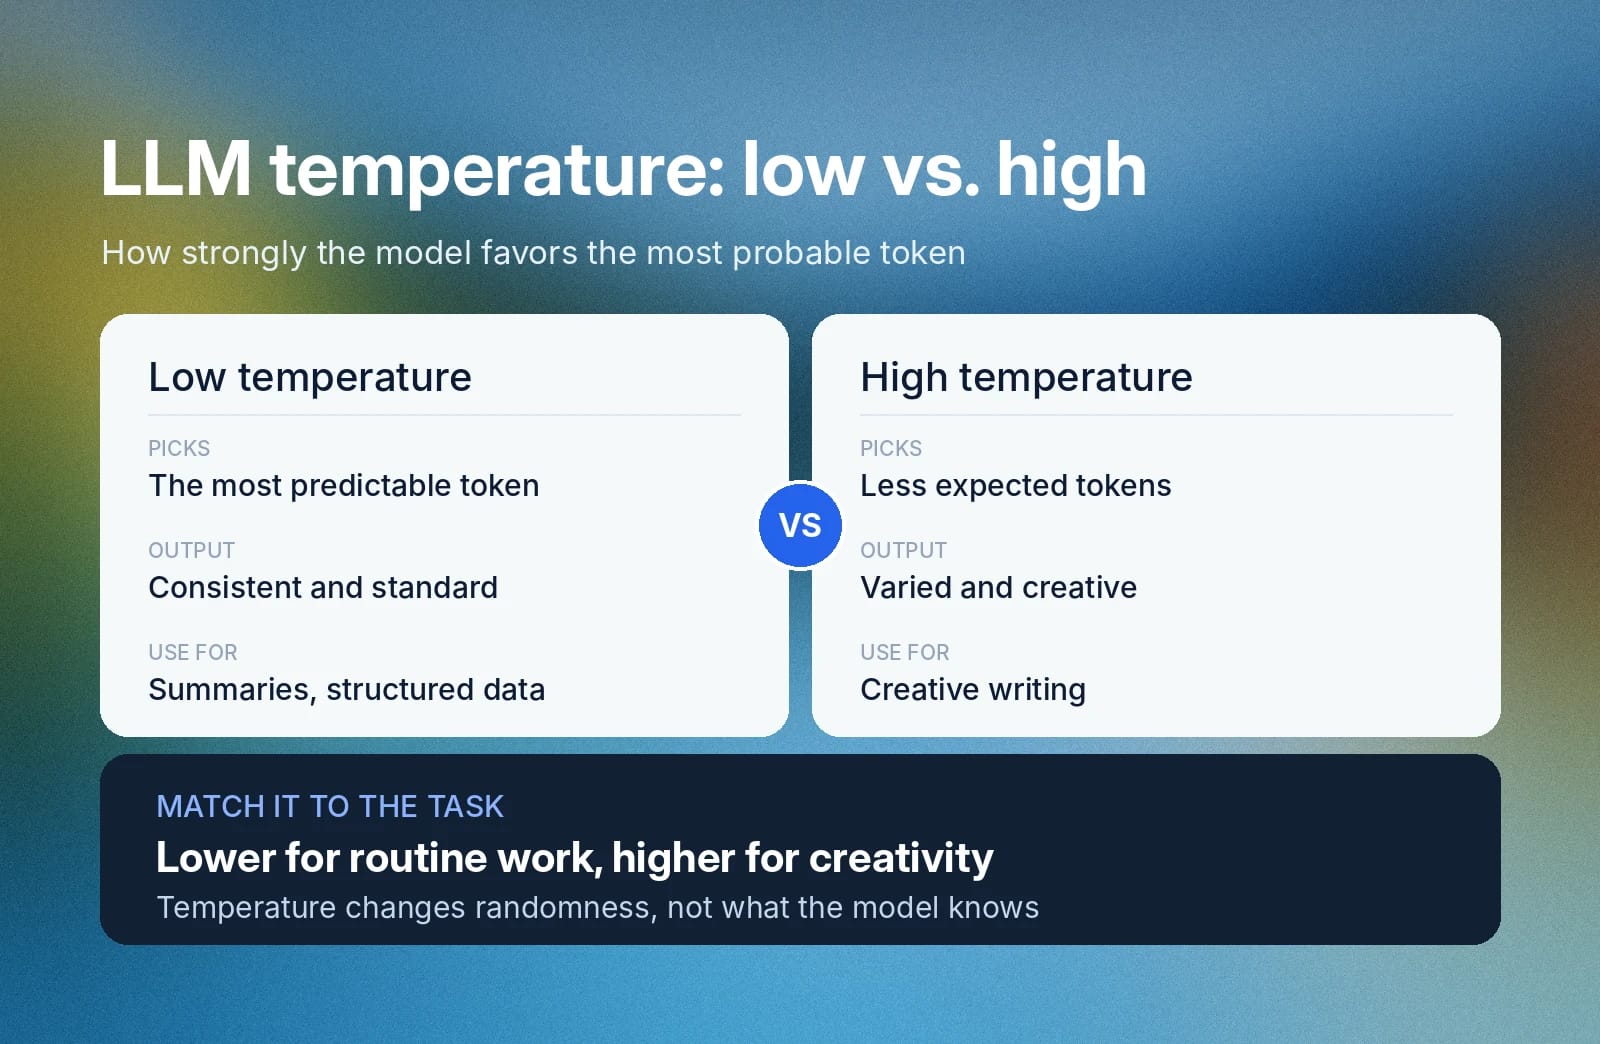
A temperatura de um LLM é uma configuração variável que os desenvolvedores podem ajustar para determinar o nível de aleatoriedade das saídas de um LLM. Os LLMs geram o próximo token em uma sequência de palavras selecionando a opção mais comum. Porém, para cada escolha feita pelo LLM, pode haver várias outras alternativas com ponderação semelhante.
Ao ajustar a temperatura do LLM, você muda o quanto ele favorece a opção mais provável. Uma configuração de temperatura baixa gera uma saída padronizada e consistente, pois tende a escolher sempre o próximo token mais previsível em uma sequência. Por outro lado, uma temperatura alta se afasta da escolha esperada com mais frequência, gerando resultados mais criativos e variados.
Você deve adaptar o valor da temperatura do LLM à tarefa que deseja realizar. Tudo que exige algum grau de criatividade deve usar temperaturas mais altas, enquanto tarefas rotineiras ou saídas estruturadas, como resumos de dados, devem usar temperaturas mais baixas.
Como os LLMs são treinados e ajustados?
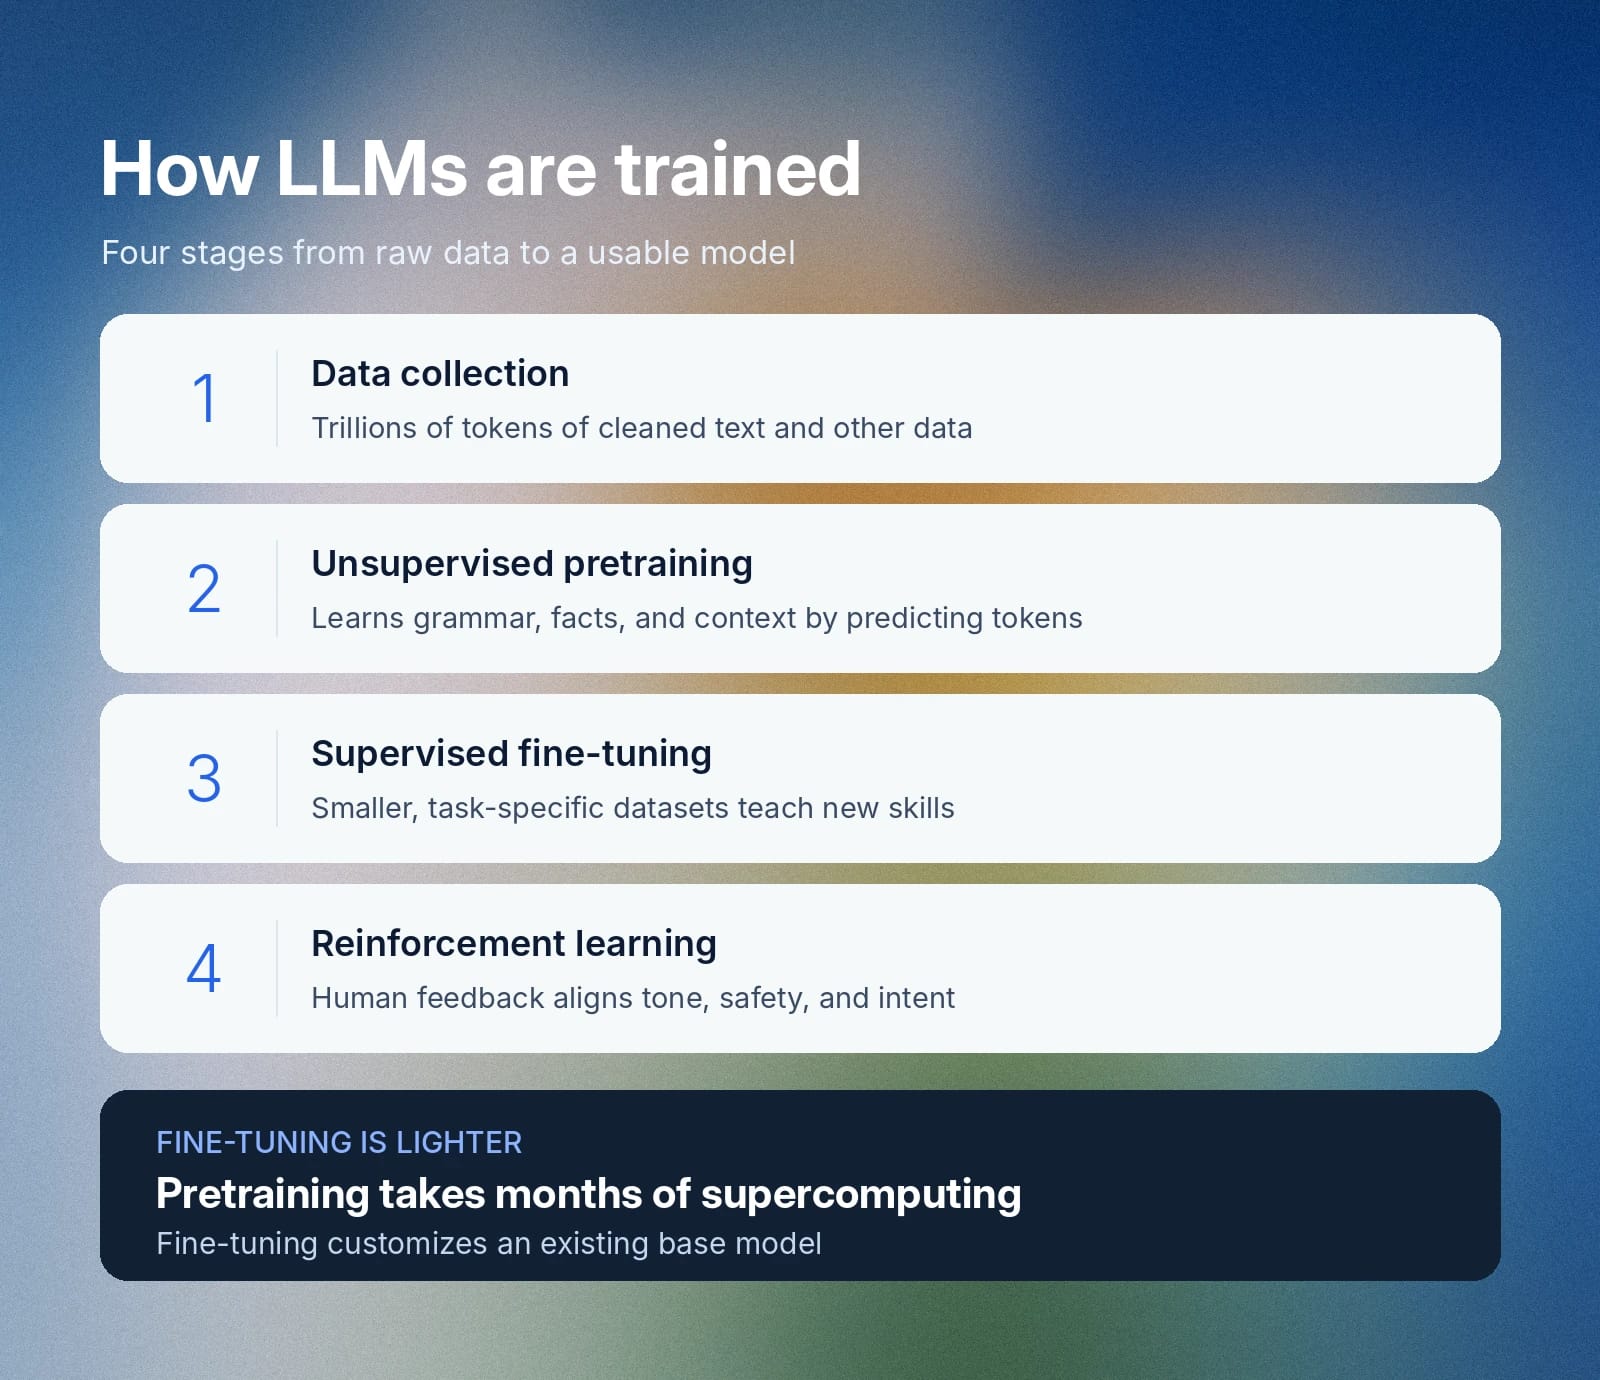
Treinar LLMs exige um processo com várias etapas para transformar texto bruto e dados multimodais em sistemas de linguagem funcionais. As empresas precisam de capacidade avançada de supercomputação operando por vários meses, enquanto o fine-tuning é um processo mais leve que personaliza o modelo-base existente.
Empresas de IA de ponta tendem a tratar seu processo exato de treinamento como informação proprietária, e a maioria não divulga o código-fonte nem os pesos. Ainda assim, o treinamento geralmente segue este processo:
- Coleta e pré-processamento de dados: Os desenvolvedores criam conjuntos de dados a partir de várias fontes, com corpus de pré-treinamento que inclui trilhões de tokens extraídos de terabytes de texto limpo. Extrair ou minerar textos de fontes da internet é uma das principais formas de as empresas criarem esses conjuntos de dados.
- Pré-treinamento não supervisionado: O modelo de linguagem grande lê trilhões de tokens para aprender regras gramaticais, relações factuais e contexto linguístico. Essencialmente, ele se pré-treina por meio de modelagem de linguagem autorregressiva, impulsionada por mecanismos de autoatenção que calculam o próximo token estatisticamente provável em uma sequência.
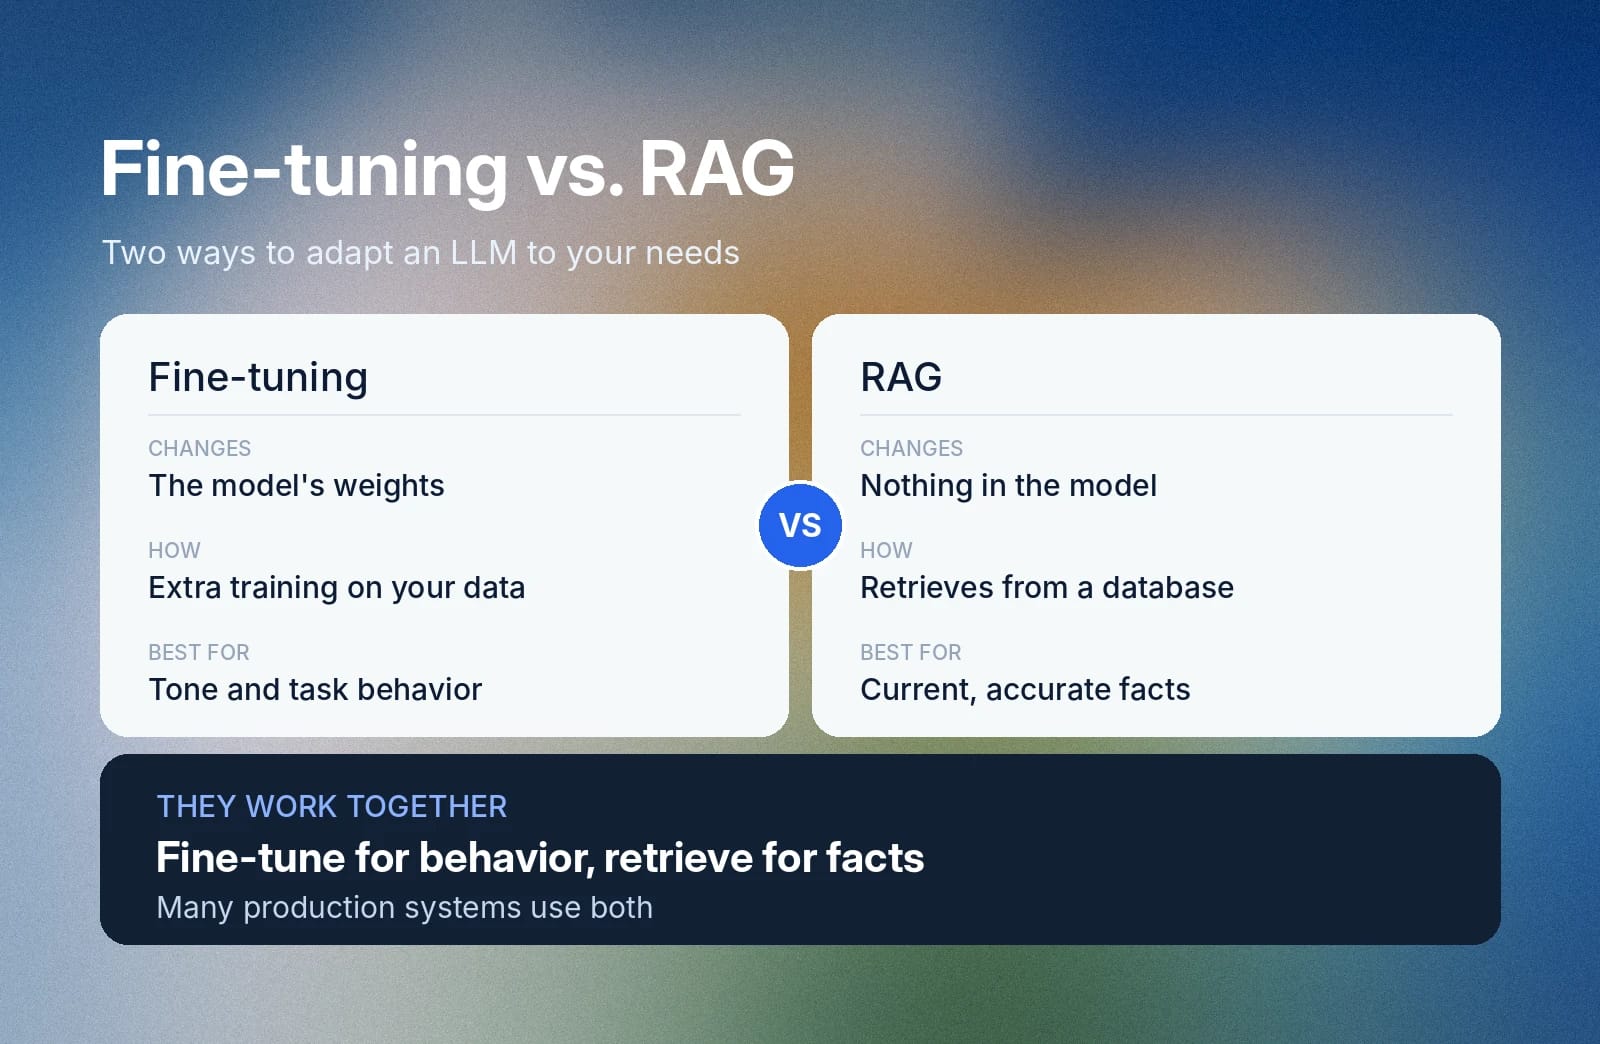
- Fine-tuning supervisionado: Engenheiros usam conjuntos de dados menores e mais específicos para tarefas a fim de ajustar o modelo pré-treinado. Essa etapa ensina competências específicas ao modelo, desde responder perguntas gerais até gerar logotipos ou realizar pesquisas em laboratório.
- Aprendizado por reforço e alinhamento: Os desenvolvedores refinam o comportamento do modelo usando o feedback de revisores humanos e modelos de recompensa. Essa etapa alinha as saídas do modelo às diretrizes de segurança, aos requisitos de tom e à intenção humana.
Tipos de arquiteturas de LLM: codificadores, decodificadores e modelos híbridos
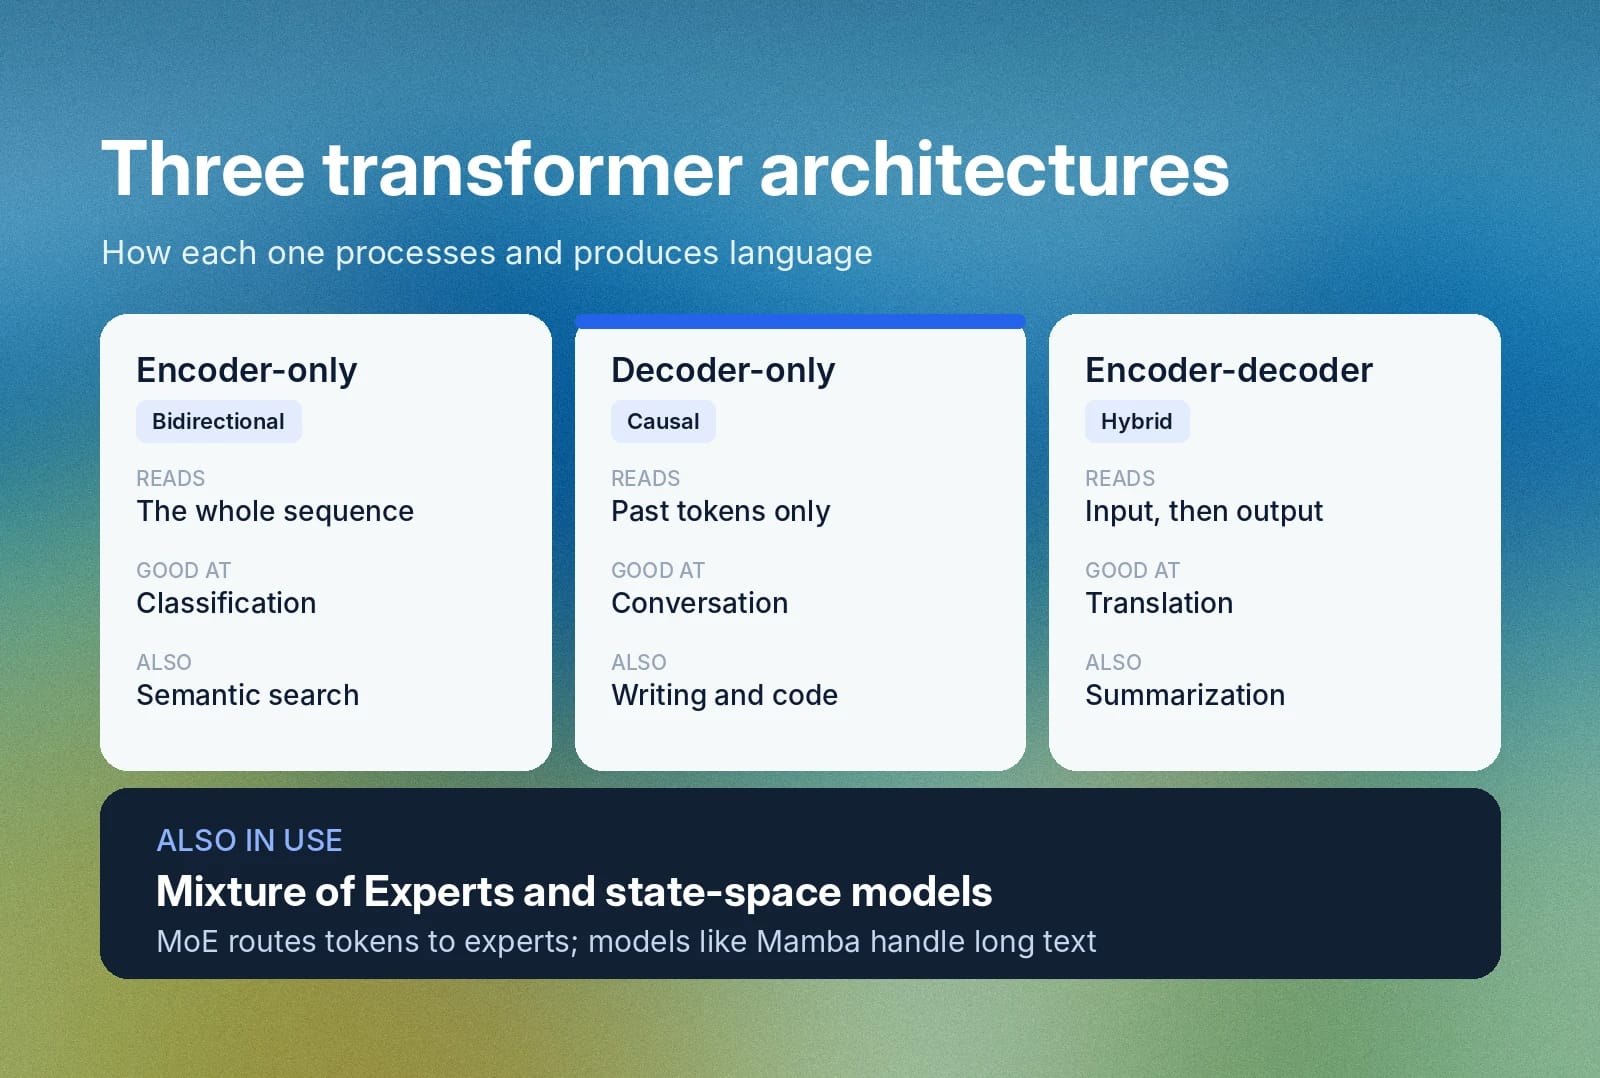
As arquiteturas transformer organizam as camadas das redes neurais de diferentes formas para processar entradas e produzir conteúdo. Os transformers clássicos se dividem em três categorias principais: modelos somente codificador, somente decodificador e codificador-decodificador (híbridos). No entanto, os sistemas modernos também incorporam arquiteturas de eficiência para ampliar o desempenho.
Modelos somente codificador
As arquiteturas somente codificador processam sequências inteiras de uma vez usando autoatenção bidirecional. Isso permite que a máquina avalie a relação de cada token com outros tokens anteriores e posteriores. Na prática, isso otimiza os modelos para tarefas como:
- Classificação de texto
- Análise de sentimento
- Recuperação de informações
- Busca semântica
Tarefas como essas também aparecem em workflows de voz. O modelo de Speech to Text Scribe da ElevenLabs transcreve fala em mais de 90 idiomas, e seu recurso de detecção de entidades sinaliza detalhes sensíveis e linguagem ofensiva nas transcrições.
Modelos somente decodificador
As arquiteturas somente decodificador usam atenção causal para processar tokens e prever cada palavra com base nos tokens anteriores. Esses modelos geram conversas fluidas e são a principal arquitetura por trás de chatbots conversacionais modernos, assistentes de escrita aberta e ferramentas de geração de código.
No ElevenAgents, o LLM que você escolhe, geralmente um modelo somente decodificador, gera as respostas do agente, enquanto um modelo proprietário de alternância de turnos gerencia o timing da conversa.
Modelos codificador-decodificador (híbridos)
Os modelos codificador-decodificador usam um codificador para processar a entrada e um decodificador para gerar a saída. Essa abordagem de estrutura dupla torna os modelos híbridos mais adequados para tarefas que exigem preservação rigorosa de contexto, como resumo de documentos, tradução de idiomas e reformatação de dados.
A tradução é uma tarefa clássica de codificador-decodificador, e o Dubbing da ElevenLabs oferece suporte a mais de 90 idiomas.
Mixture of Experts (MoE) e modelos de espaço de estados
Em vez de ativar todos os parâmetros da rede neural para cada palavra, o Mixture of Experts (MoE) direciona tokens individuais para equipes menores de sub-redes especializadas “especialistas”. Isso proporciona uma profundidade de raciocínio comparável à de modelos enormes, mas com maior velocidade e menor custo computacional. Enquanto isso, modelos de espaço de estados, como o Mamba, processam textos extremamente longos com eficiência.
O ElevenAgents inclui LLMs de código aberto que a ElevenLabs hospeda em sua própria infraestrutura.
Exemplos de modelos de linguagem grandes e aplicações do dia a dia
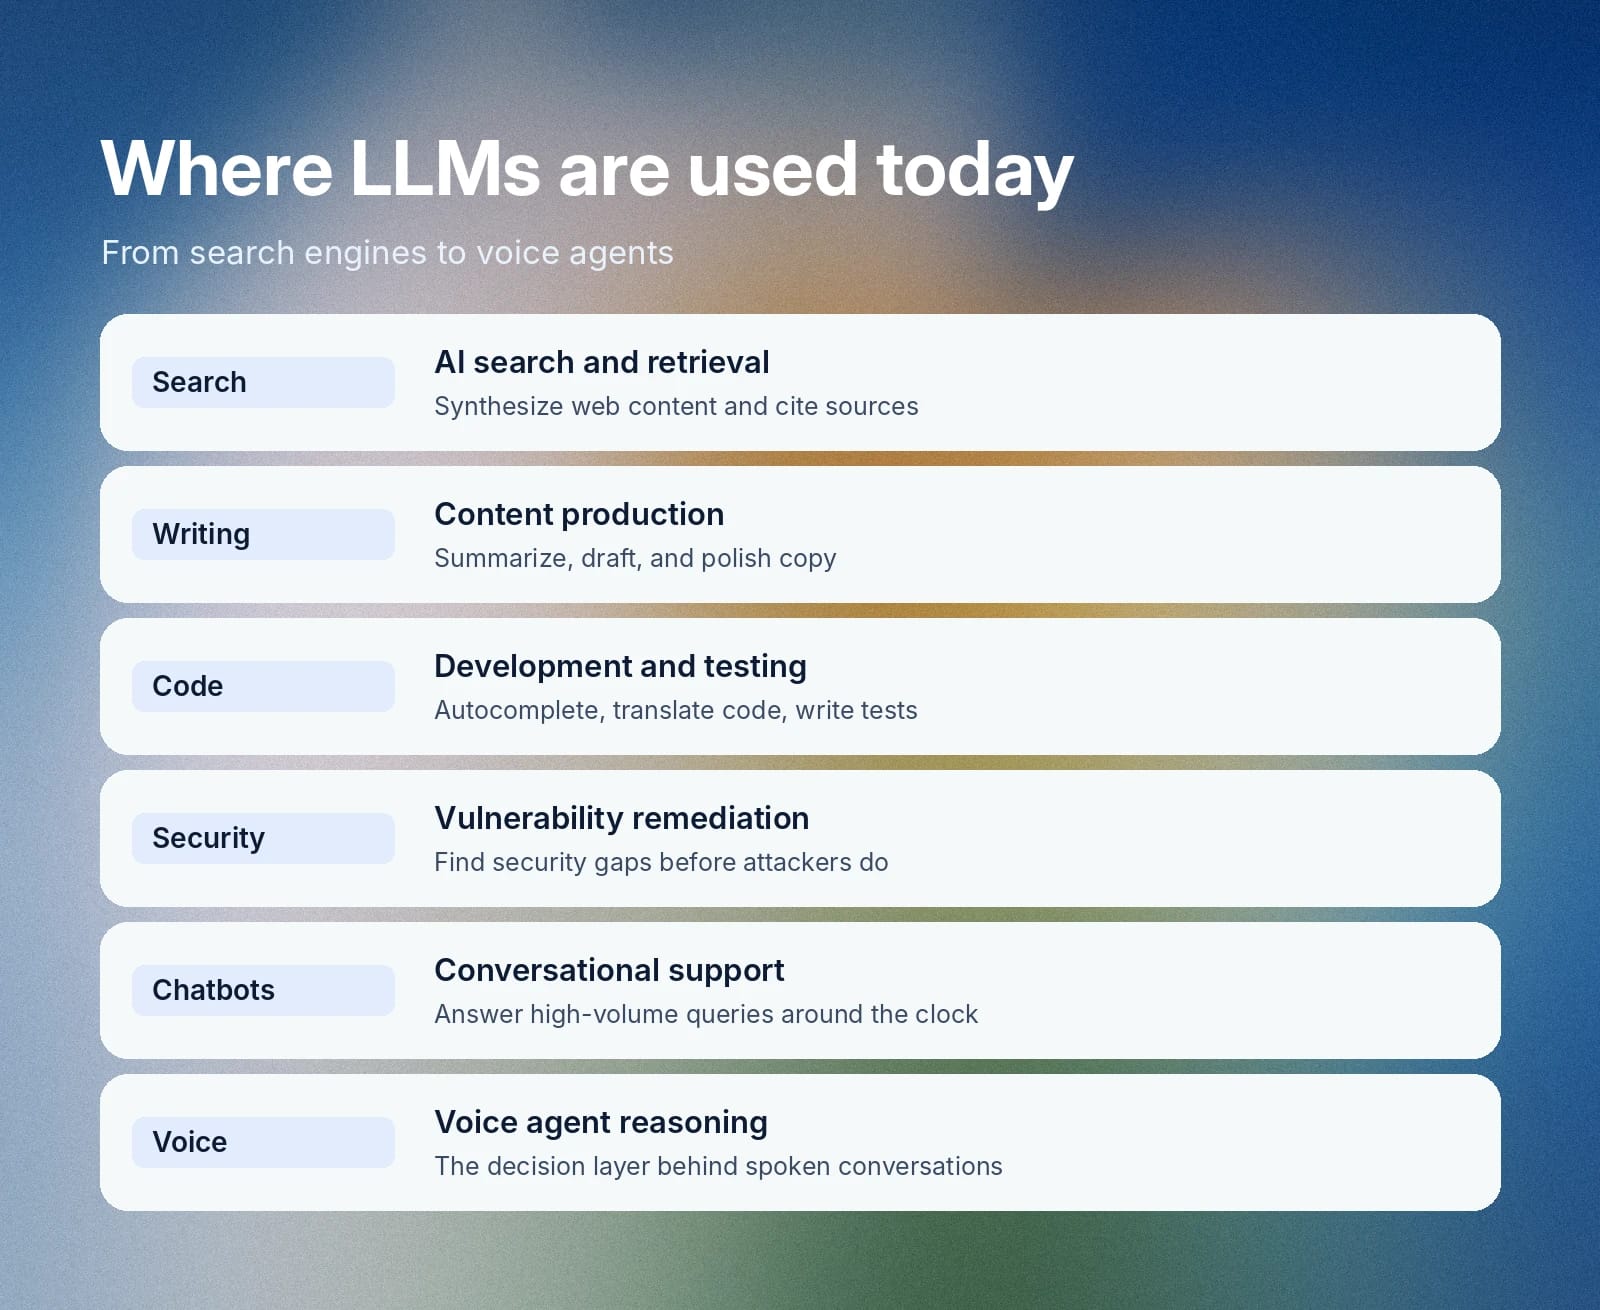
As organizações encontraram uma ampla variedade de casos de uso para modelos de linguagem grandes. Esses casos mostram como a IA passou de pesquisa experimental a um recurso padrão na web, em aplicações de software e em dispositivos do dia a dia. Enquanto cientistas de IA continuam estudando e otimizando a arquitetura subjacente, exemplos reais de LLMs mostram como as equipes os implementaram até agora:
- Busca com IA e recuperação de informações: Mecanismos de busca conversacionais como Bing, Google AI Overviews e Perplexity usam LLMs para analisar conteúdo da web em tempo real. Os modelos sintetizam informações, citam fontes diretamente e permitem que os usuários façam perguntas adicionais.
- Redação, edição e produção de conteúdo: LLMs e outras ferramentas com IA facilitam a redação e edição de materiais para uso interno e externo. Por exemplo, o NotebookLM resume relatórios extensos, o Jasper AI escreve anúncios e o Grammarly aprimora textos.
- Geração de código, desenvolvimento e testes: A IA potencializa ferramentas de programação como o GitHub Copilot para completar funções automaticamente e traduzir código de uma linguagem de programação para outra. As equipes também podem usá-la para gerar suítes de testes automatizados, identificando e corrigindo bugs com facilidade antes da implantação.
- Segurança cibernética e correção de vulnerabilidades: Empresas de IA de ponta lançaram modelos especializados para detectar falhas de segurança, ajudando organizações a implementar correções antes que invasores possam encontrá-las e explorá-las.
- Chatbots e assistentes conversacionais: As organizações implementam interfaces conversacionais para oferecer suporte ao cliente 24 horas por dia, 7 dias por semana. A integração de plataformas como o ElevenAgents permite que empresas automatizem consultas de alto volume usando soluções conversacionais, em vez de depender de FAQs.
- Mecanismo de raciocínio para agentes de voz: Os LLMs também atuam como a camada central de raciocínio para sistemas de voz IA. O ElevenAgents combina o LLM que você escolher com Speech to Text, Text to Speech de baixa latência e um modelo proprietário de alternância de turnos para conduzir conversas naturais em tempo real.
Quais são as limitações dos modelos de linguagem grandes?
Como base da maioria dos produtos de IA com os quais os consumidores interagem, os LLMs são um componente de arquitetura poderoso que ajuda em diversos workflows e casos de uso. Mas, se você pretende desenvolver com LLMs ou treinar seu próprio modelo, deve conhecer suas principais limitações:
- Alucinações: Não há garantia de que o que um LLM gera seja preciso. Uma resposta pode conter facilmente informações inventadas ou simplesmente incorretas.
- Conhecimento estático: Sem RAG, um LLM fica limitado ao escopo de conhecimento preestabelecido que recebeu durante o processo de treinamento.
- Viés: Se seus dados de treinamento tiverem vieses, seu modelo refletirá esses vieses. Isso é especialmente importante se você estiver usando um LLM para classificar dados ou tomar decisões sobre informações, pois certos vieses implícitos nos seus dados podem acabar influenciando negativamente as saídas sem que você perceba.
- Janela de contexto limitada: Os LLMs normalmente trabalham apenas com uma quantidade fixa de texto, o que significa que conversas mais longas podem começar a perder detalhes e se tornar menos eficazes com o tempo.
- Custo e latência: Quanto maior o LLM, maior é a capacidade computacional necessária para executá-lo. Se você optar por modelos mais poderosos, provavelmente pagará mais por esse serviço aprimorado.
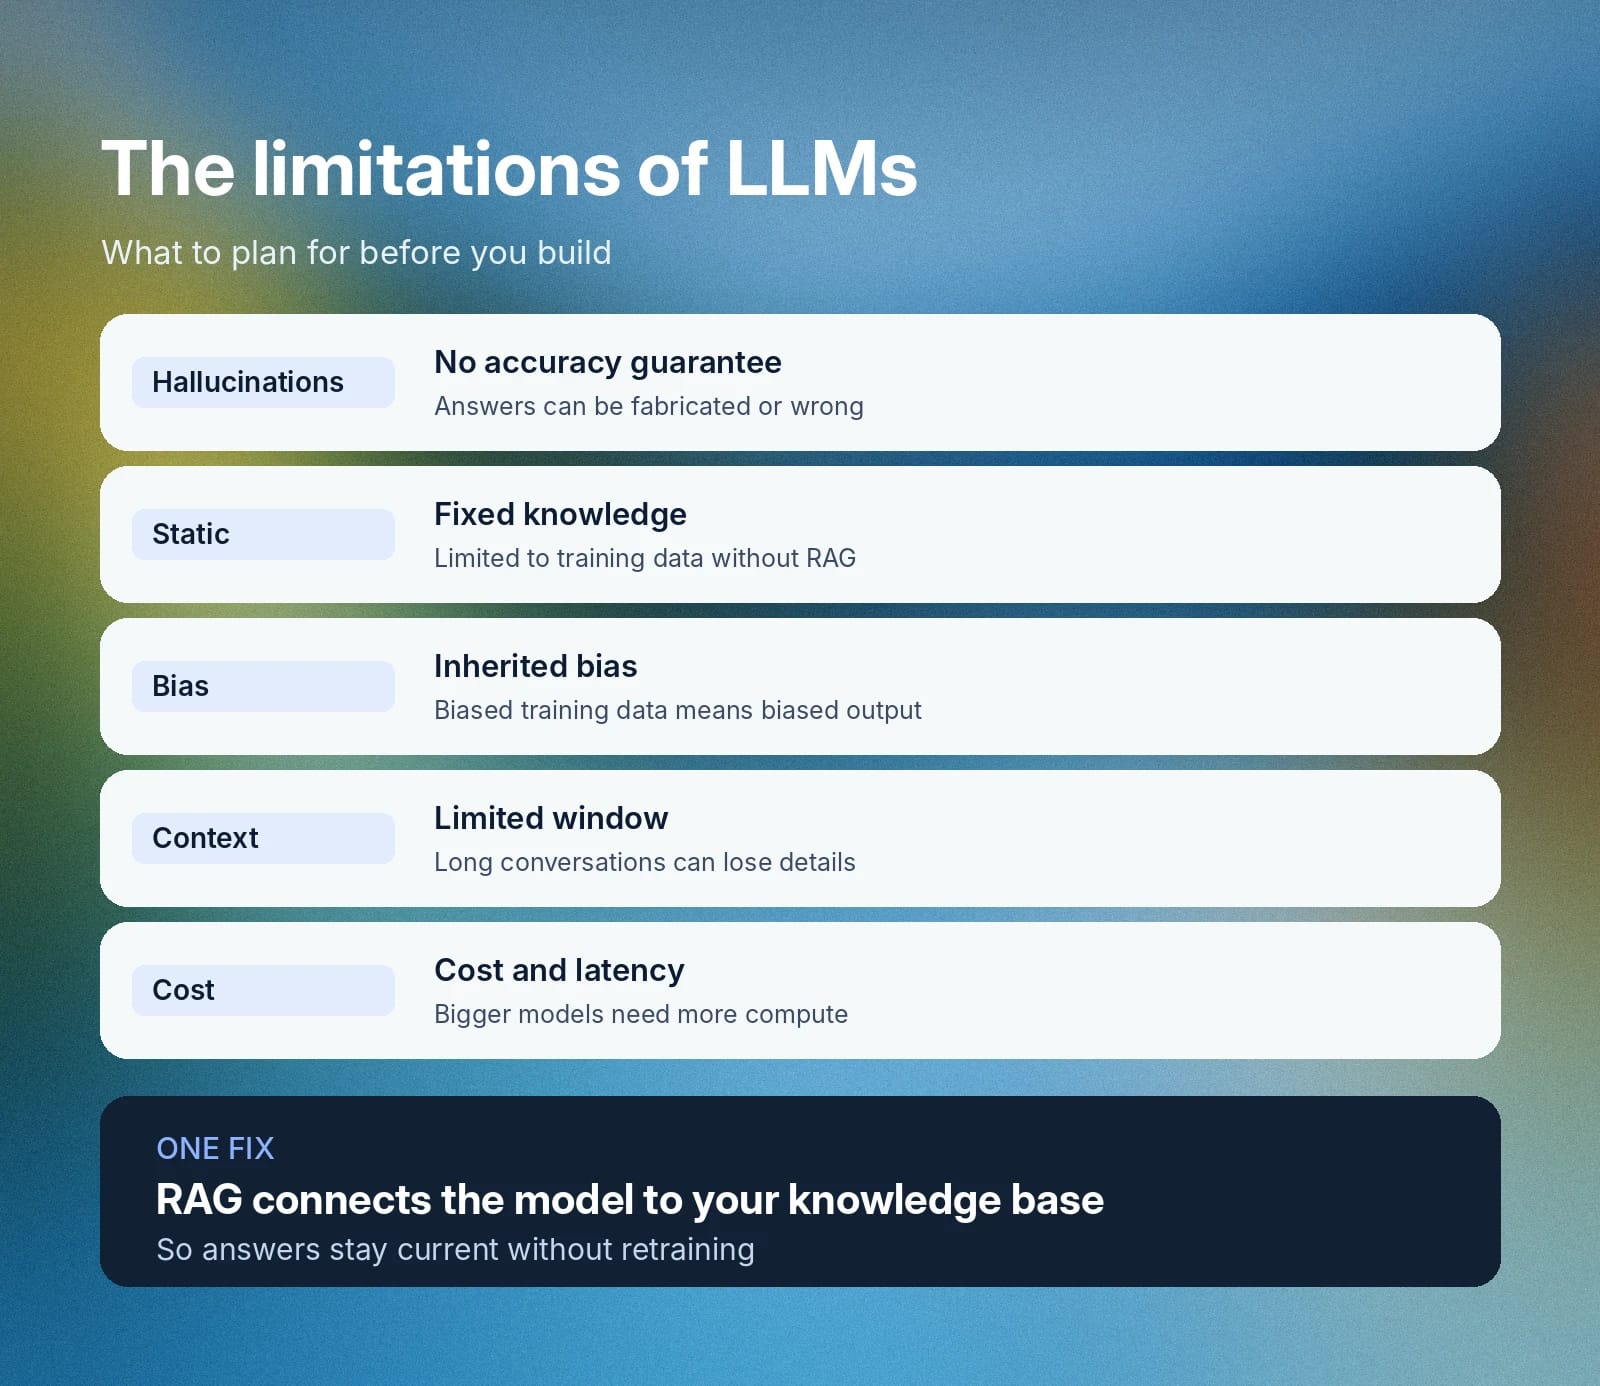
Há várias estratégias que você pode considerar ou implementações que pode fazer para reduzir o impacto dessas limitações. Por exemplo, ativar o RAG em um LLM e conectá-lo a uma base de conhecimento em constante expansão resolveria o problema do conhecimento estático.
Crie experiências de LLM habilitadas por voz com o ElevenAgents
Escolher um modelo de linguagem grande para seu caso de uso é uma decisão importante que talvez você precise ajustar à medida que as necessidades do seu negócio e até os requisitos regulatórios mudam. Evitar a dependência de fornecedores mantém a agilidade e a flexibilidade da empresa ao criar soluções conversacionais de voz IA.
O ElevenAgents permite escolher entre LLMs compatíveis de fornecedores como OpenAI, Anthropic e Google ou conectar seu próprio modelo personalizado por um endpoint compatível com OpenAI. Assim, fica fácil escolher o equilíbrio ideal entre velocidade, capacidade de raciocínio e custo para suas necessidades específicas.
Explore o ElevenAgents para ver como LLMs hospedados simplificam workflows de voz ou fale com vendas para começar a criar seus agentes de voz de baixa latência hoje mesmo.
Perguntas frequentes sobre LLMs

Jack Limebear faz parte do time de Growth, atuando como redator e estrategista de conteúdo no blog e nas páginas de insights. Antes da ElevenLabs, ele passou mais de dez anos liderando estratégias de conteúdo em organizações que vão de startups SaaS em rápido crescimento a empresas da Fortune 500. Ele é mestre em Literatura Inglesa pela Universidade de Cambridge.


