
O que é RAG? Como funciona a Geração Aumentada por Recuperação
- Escrito por
- Jack Limebear
- Publicado
- Última atualização
OuvirOuça este artigo
Os modelos de IA geram respostas com base no que aprenderam durante o treinamento, o que significa que não conhecem automaticamente as políticas, os produtos ou outras informações de uma empresa criadas após esse treinamento. O RAG (Retrieval-Augmented Generation) resolve isso ao buscar informações externas relevantes e fornecê-las ao modelo antes que ele responda.
O RAG fundamenta as respostas dadas por uma IA nos documentos reais da empresa. Um agente de atendimento ao cliente que usa RAG pode consultar a política de devolução ou a especificação do produto atual antes de responder, reduzindo o risco de alucinação.
Este guia explica o que RAG significa em IA, como recuperação e geração trabalham juntas e como o RAG difere de um LLM isolado. Também abordaremos as limitações do RAG, onde ele funciona bem em aplicações de IA generativa e como ele oferece suporte à recuperação de conhecimento em agentes de IA.
Resumo
- O RAG combina um sistema de recuperação com um modelo generativo para que o modelo possa usar informações além dos dados de treinamento.
- O conhecimento recuperado pelo RAG fica fora do modelo, portanto pode ser atualizado sem retreinar nada.
- O ElevenAgents usa RAG automaticamente quando uma base de conhecimento é grande demais para caber diretamente no contexto do modelo, mantendo respostas rápidas sem comprometer a precisão em bases de conhecimento grandes e complexas.
O que é RAG em IA?
RAG é uma arquitetura de sistema construída em torno de um LLM para fornecer informações externas, como diretrizes de marca, manuais de produto, artigos de base de conhecimento ou bancos de dados internos. Isso permite que a IA trabalhe com informações específicas da empresa, para que suas respostas reflitam políticas atuais, conhecimentos privados e detalhes da empresa nos quais o modelo nunca foi treinado.
Um LLM também só consegue considerar uma quantidade limitada de informações de uma vez, conhecida como sua janela de contexto. Uma grande base de conhecimento organizacional pode ultrapassar esse limite rapidamente. Por isso, o RAG mantém as informações fora do LLM e recupera apenas os trechos necessários para a pergunta atual.
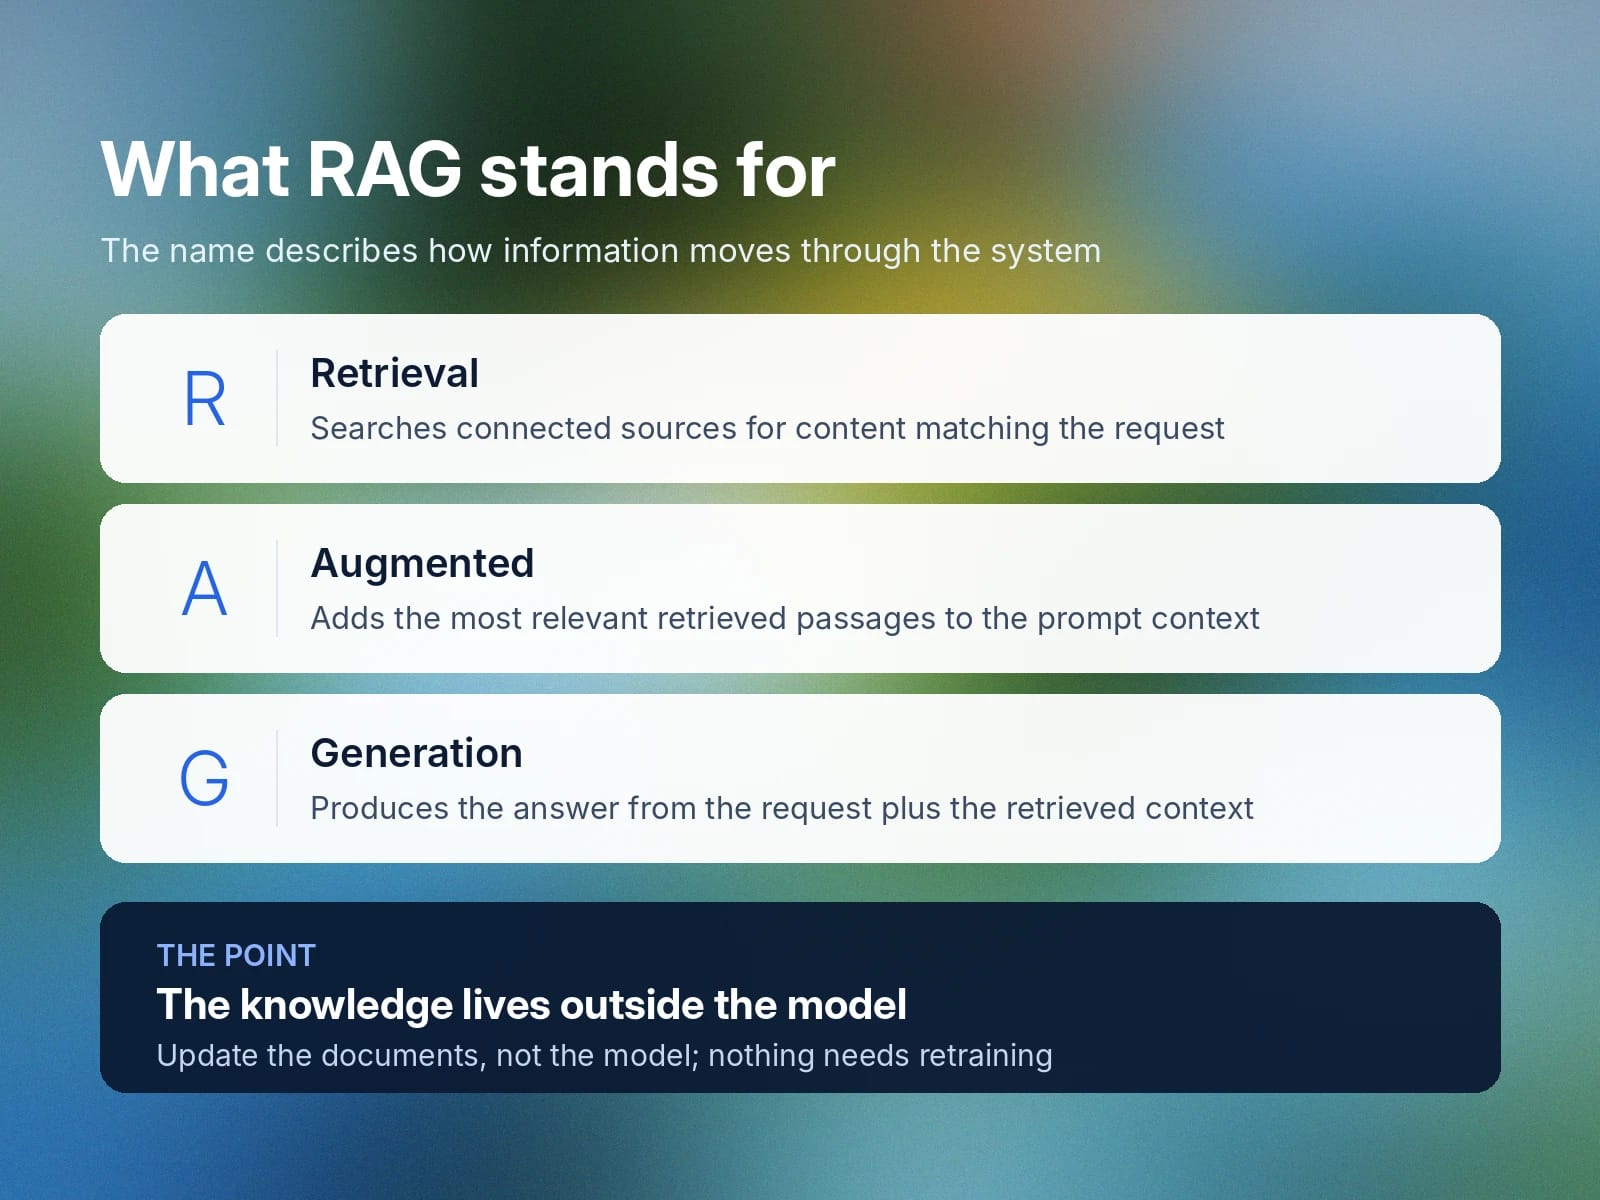
O nome descreve como as informações fluem pelo sistema:
- Recuperação: busca em fontes conectadas, como documentos de políticas, registros de suporte ou arquivos de inventário, conteúdos que correspondam à solicitação do usuário.
- Aumento: adiciona os trechos recuperados mais relevantes ao contexto do prompt.
- Geração: usa a solicitação do usuário e o contexto recuperado para produzir a resposta.
O RAG também dá suporte ao grounding, a prática de vincular uma resposta de IA a informações específicas de uma fonte, fornecendo ao LLM material relevante para usar na geração de uma resposta. Por exemplo, se um cliente perguntar sobre uma política de garantia, o sistema RAG recupera os termos relevantes da documentação da empresa e os fornece ao LLM para que ele responda com base neles.
Como funciona a Retrieval-Augmented Generation?
Um sistema RAG prepara conhecimento externo para busca, recupera as informações mais relevantes para a pergunta de um usuário e as fornece ao LLM como contexto antes de ele gerar uma resposta.
As implementações de RAG variam em complexidade. O RAG básico usa um processo direto de recuperar e gerar, enquanto abordagens mais avançadas podem incluir reescrita de consultas, filtragem, reclassificação ou outras técnicas de recuperação.
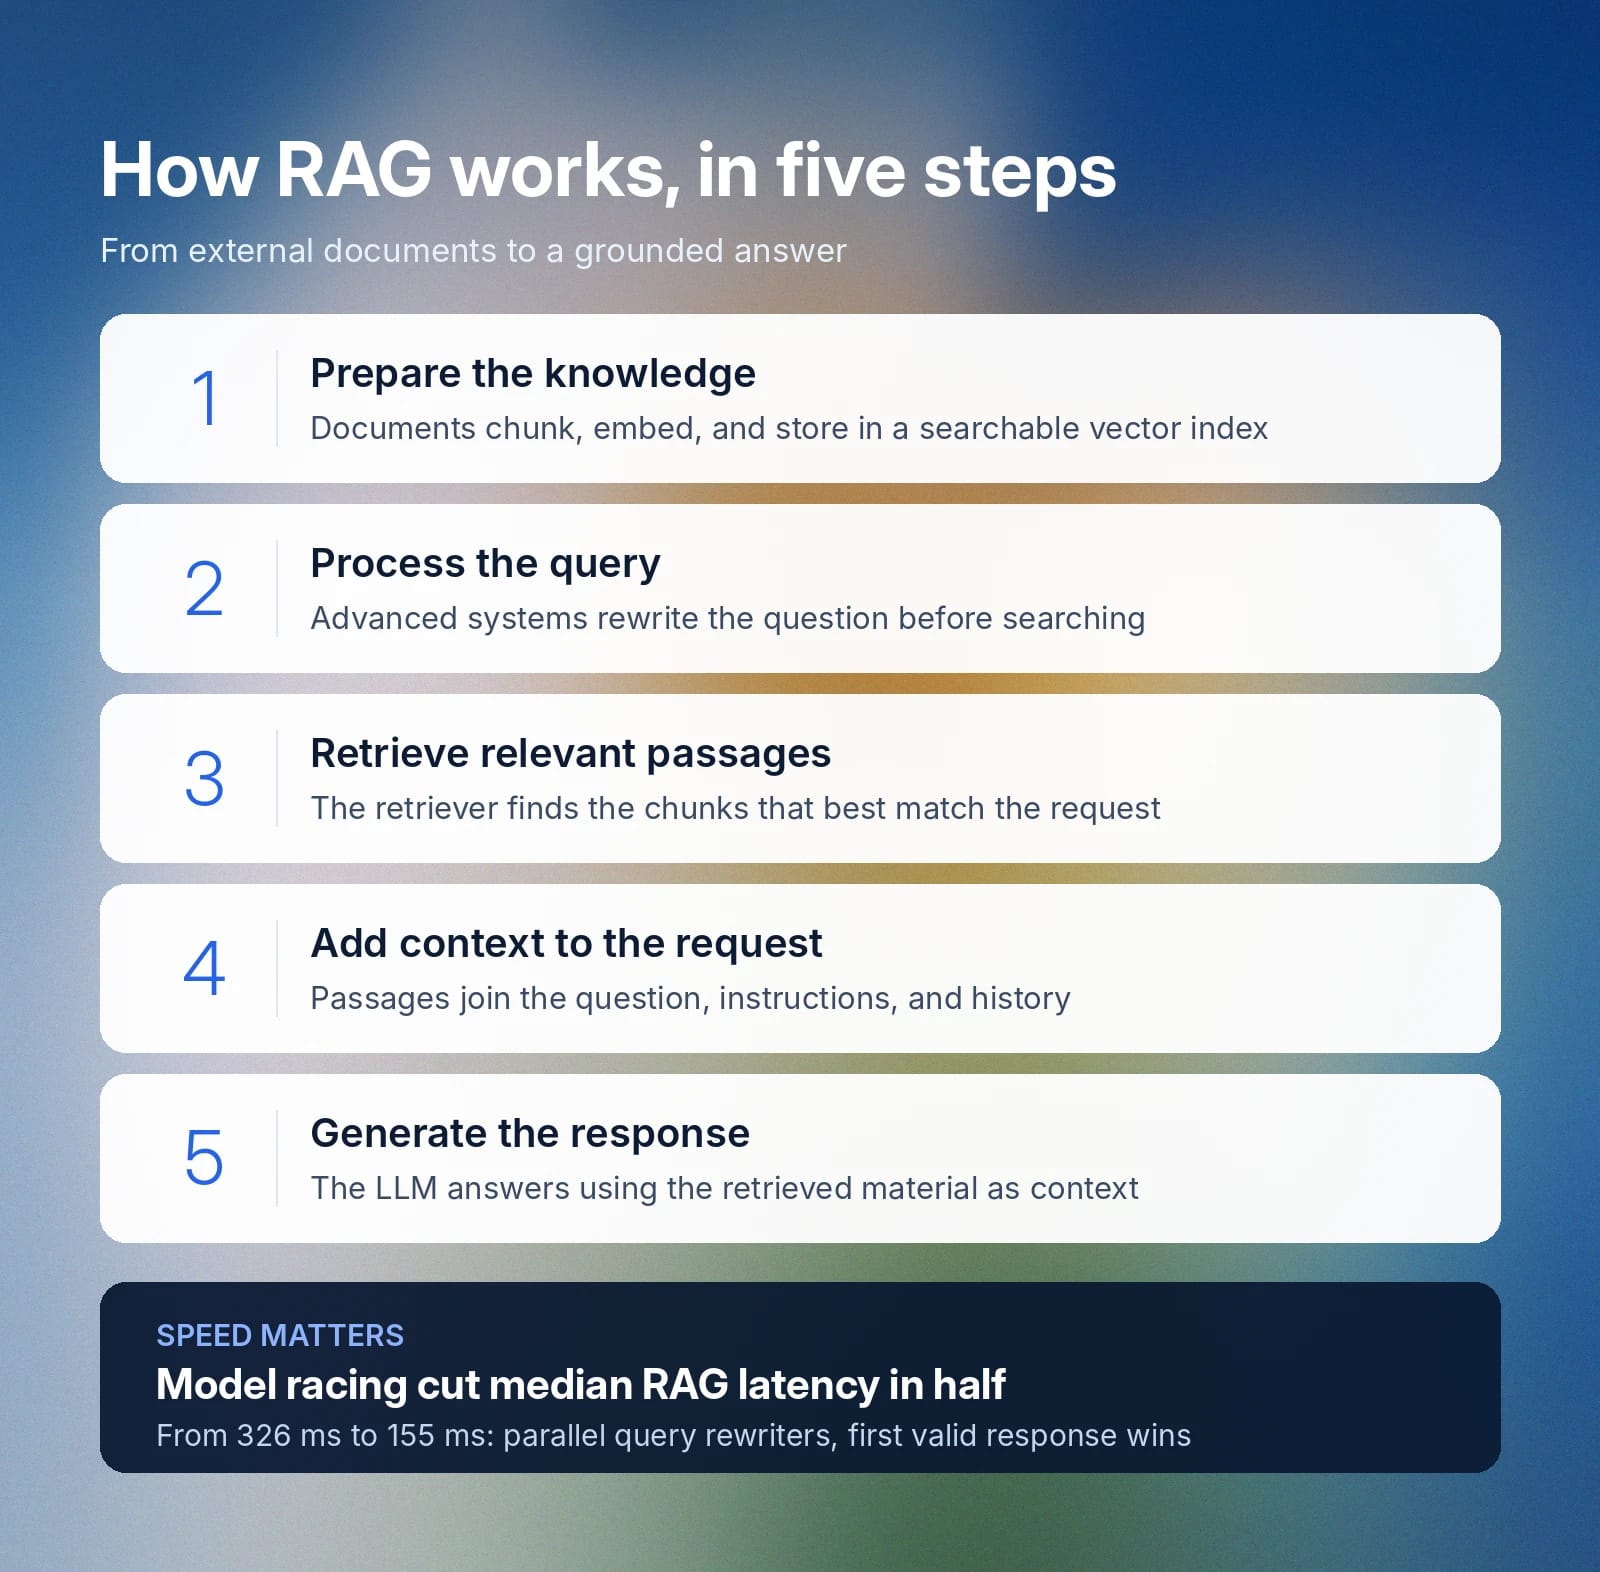
O processo de RAG geralmente segue cinco etapas:
- Preparar o conhecimento: os documentos são divididos em trechos menores (um processo chamado “chunking”), convertidos em representações matemáticas chamadas embeddings e armazenados em um índice pesquisável ou banco de dados vetorial.
- Processar a consulta: o sistema interpreta a pergunta do usuário e, em sistemas RAG mais avançados, a reescreve ou refina antes de buscar.
- Recuperar trechos relevantes: o recuperador busca na base de conhecimento indexada os blocos de texto que melhor correspondem à solicitação.
- Adicionar contexto à solicitação do modelo: os trechos selecionados são enviados ao LLM junto com a pergunta do usuário, instruções relevantes e o histórico da conversa.
- Gerar a resposta: o LLM produz uma resposta usando o material recuperado como parte de seu contexto.
Muitos sistemas RAG acionam a recuperação de forma seletiva como uma ferramenta externa. O ElevenAgents permite que as equipes ativem o RAG para uma base de conhecimento diretamente nas configurações do agente, e o sistema usa a reescrita de consultas para transformar diálogos anteriores e referências vagas em uma consulta de busca precisa e autossuficiente durante interações subsequentes da conversa.
Para garantir respostas ágeis, a ElevenLabs também desenvolveu uma arquitetura de competição entre modelos que envia cada consulta a vários modelos de reescrita em paralelo e usa a primeira resposta válida. Essa abordagem reduziu a latência mediana do RAG pela metade, de 326 ms para 155 ms, mantendo a recuperação rápida o suficiente para preservar o fluxo natural da conversa, mesmo quando ela é acionada por uma base de conhecimento grande.
Qual é a diferença entre LLMs e modelos RAG?
Um LLM é um modelo que entende e gera linguagem. RAG é uma arquitetura em torno do LLM que recupera informações externas quando a aplicação precisa delas.
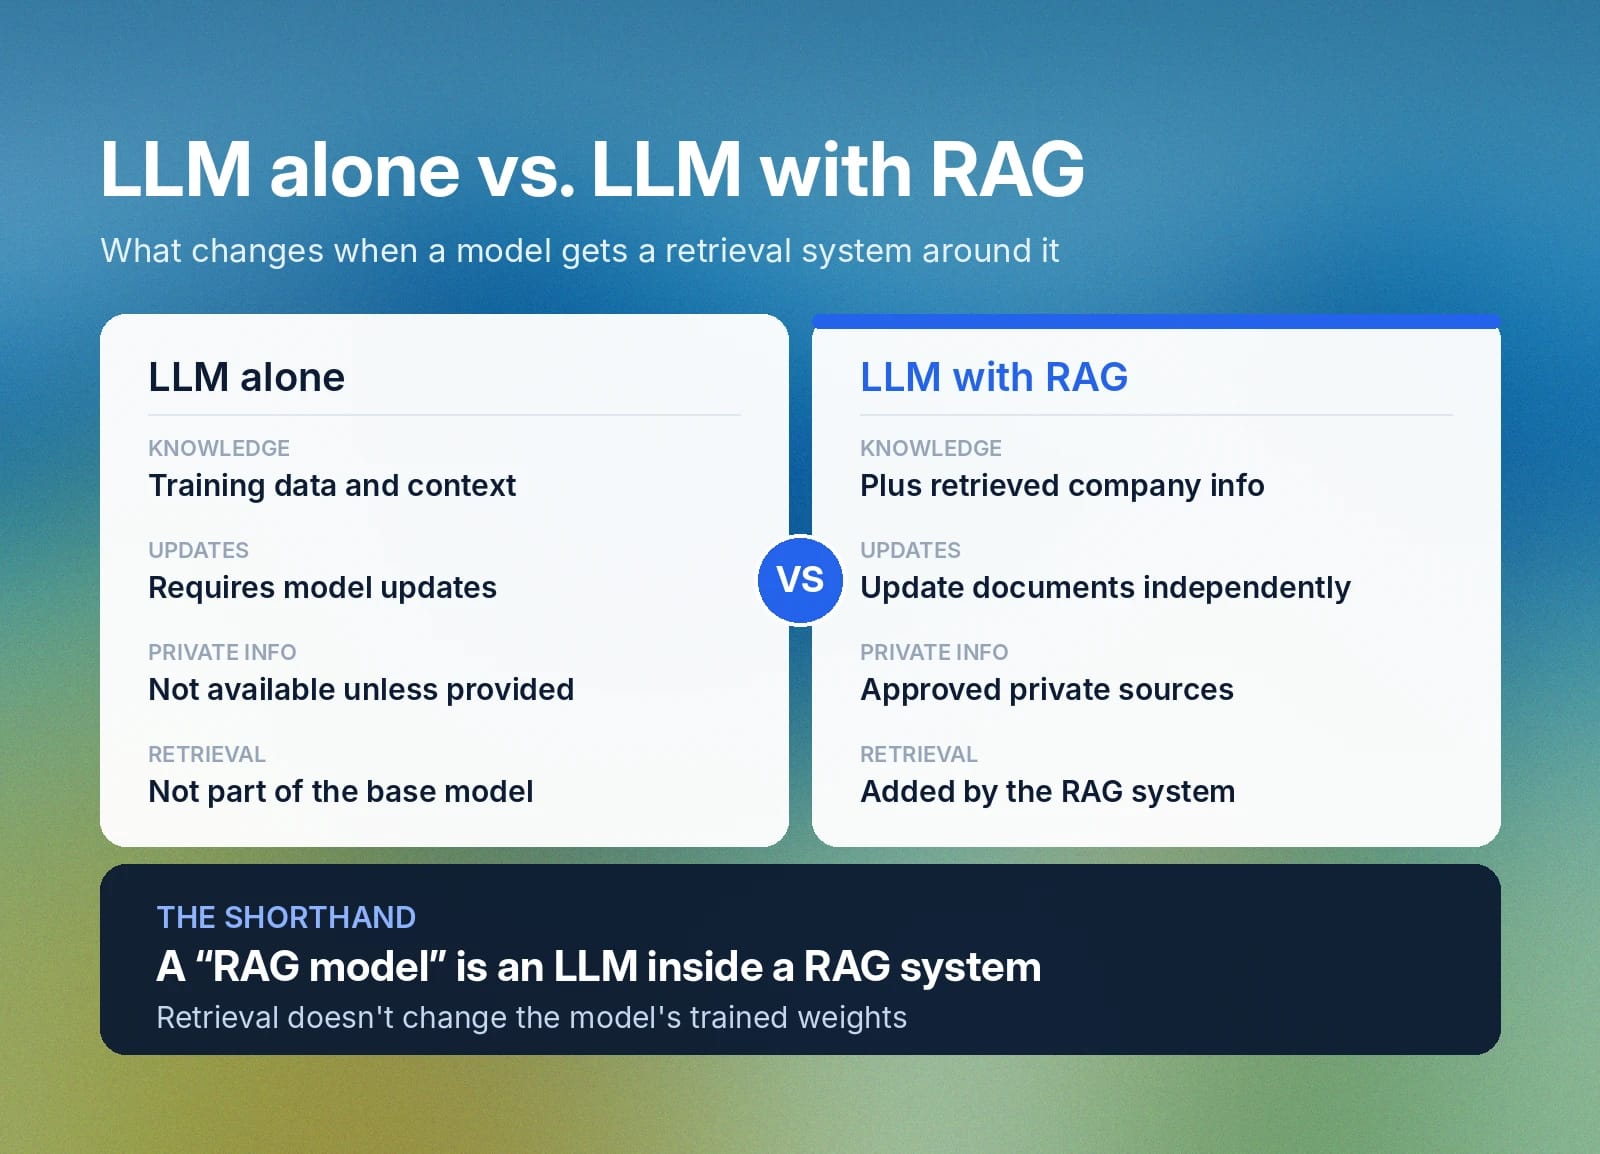
Veja o que muda quando um LLM é combinado com RAG:
Recurso | LLM isolado | LLM usado com RAG |
Conhecimento | Dados de treinamento e contexto atual | Dados de treinamento, contexto atual e informações recuperadas da empresa, como políticas, documentos de produto ou conteúdo da base de conhecimento |
Atualizações | Novas informações precisam ser fornecidas no contexto ou por atualizações do modelo | O conhecimento externo pode ser atualizado separadamente do modelo |
Informações privadas | Não disponíveis, a menos que sejam fornecidas | Pode recuperar dados de fontes privadas aprovadas |
Recuperação | Não faz parte do modelo base | É adicionada pelo sistema RAG ao redor |
“Modelo RAG” às vezes é usado como uma abreviação para um LLM usado dentro de um sistema RAG. Por exemplo, uma empresa pode dizer que usa um “modelo RAG” para atendimento ao cliente quando, na prática, a configuração é um LLM que recupera conteúdo relevante da Central de ajuda ou de políticas antes de gerar uma resposta.
Limitações dos modelos RAG em aplicações do mundo real
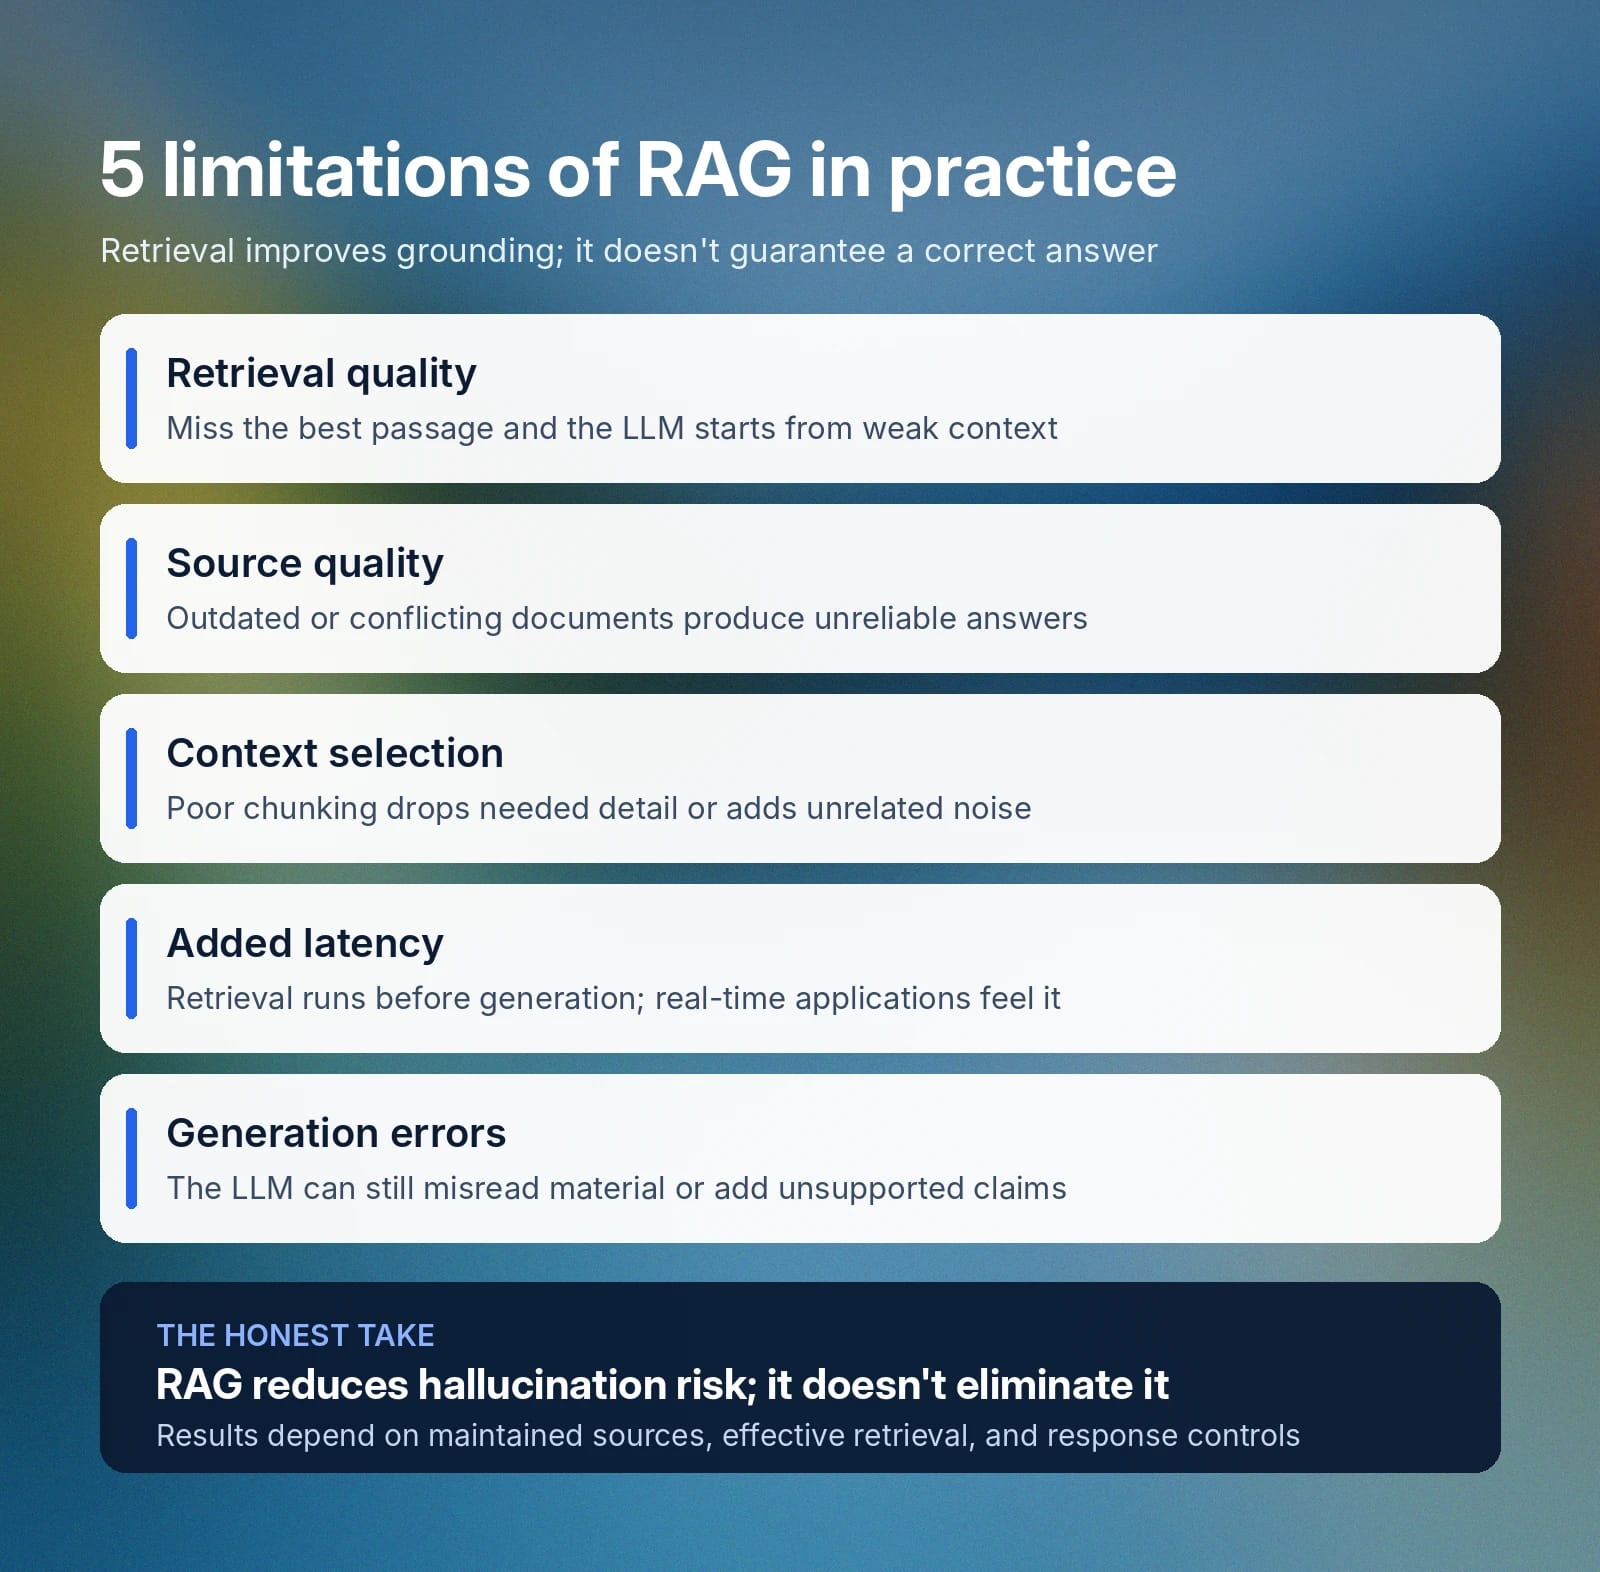
O RAG melhora o acesso a conhecimentos relevantes da empresa armazenados fora do LLM, mas a recuperação traz suas próprias limitações e não garante uma resposta correta. As principais limitações aparecem no que o sistema recupera, no que envia ao modelo e em como o modelo responde:
- Qualidade da recuperação: se o sistema não encontrar o trecho mais relevante, o LLM começará com um contexto incompleto ou fraco. Consultas mal formuladas, correspondências semânticas fracas ou redação ambígua podem direcionar a recuperação para o caminho errado.
- Qualidade das fontes: documentos desatualizados, conflitantes ou incompletos podem levar a respostas pouco confiáveis.
- Seleção de contexto: escolhas inadequadas de chunking ou recuperação podem remover detalhes necessários ou introduzir informações sem relação.
- Latência adicional: a recuperação e o processamento da consulta acontecem antes da geração, o que pode tornar as respostas mais lentas em aplicações em tempo real.
- Erros de geração: o LLM ainda pode interpretar incorretamente as informações recuperadas ou incluir afirmações sem embasamento.
Embora o RAG possa reduzir o risco de alucinações, ele não o elimina completamente. Resultados precisos ainda dependem de fontes bem mantidas, recuperação eficaz e controles sobre a resposta final.
RAG em IA generativa: casos de uso práticos e benefícios
O RAG é mais útil quando uma aplicação de IA precisa de informações que mudam com frequência, pertencem à organização ou são grandes demais para incluir em cada solicitação ao modelo.
Veja onde o RAG faz mais diferença:
Acompanhamento de informações atualizadas com frequência
O RAG ajuda as equipes a manter as respostas da IA alinhadas aos detalhes atuais de produtos, preços, políticas e inventário. As equipes podem atualizar as informações de origem de forma independente, e o RAG recupera a versão relevante quando uma pergunta é feita. Por exemplo, um agente de qualificação de leads pode consultar os preços ou detalhes mais recentes dos planos ao qualificar uma chamada recebida.
Uso de conhecimento privado ou especializado
Alguns conhecimentos são privados ou especializados, e não públicos, como políticas internas, documentação técnica ou conteúdo de suporte destinado a uma equipe específica. O RAG permite que um agente recupere diretamente dessas fontes, em vez de depender apenas do que está disponível publicamente ou incorporado ao modelo.
Por exemplo, um agente interno de suporte de TI ou RH pode recuperar informações de uma base de conhecimento específica de RH para responder a perguntas sobre benefícios de funcionários, em vez de pesquisar documentação pública que não teria essas informações.
Pesquisa em grandes bases de conhecimento
O RAG ajuda quando uma empresa tem muito mais documentação do que um LLM consegue considerar em uma única solicitação. Ele recupera apenas os trechos relevantes para a pergunta atual, em vez de enviar toda a coleção ao modelo. Em vendas, um assistente técnico pode pesquisar manuais de produto para encontrar requisitos relevantes durante uma chamada.
Comece a usar o ElevenAgents para soluções avançadas de RAG
O ElevenAgents permite que as equipes criem agentes de voz IA e chat que usam RAG com fontes de conhecimento conectadas, seja pela plataforma web sem código, seja pela API, para equipes que desejam integrar agentes diretamente aos próprios produtos.
Para agentes com RAG ativado, as equipes podem adicionar documentos, URLs ou texto a uma base de conhecimento e recuperar apenas as informações relevantes para cada consulta.
A ElevenLabs também otimizou a recuperação para conversas em tempo real, reduzindo a latência mediana do RAG de 326 ms para 155 ms em sua arquitetura do ElevenAgents. As equipes que desenvolvem com o ElevenAgents têm esses recursos de recuperação prontos para uso, seja configurando um agente pelo painel ou desenvolvendo sobre ele por meio da API.
Comece a criar com o ElevenAgents ou fale com nossa equipe para discutir a configuração ideal para sua aplicação.


