
O que é uma janela de contexto? O que todo usuário de LLM deve saber
- Escrito por
- Jack Limebear
- Publicado
- Última atualização
OuvirOuça este artigo
Uma janela de contexto é a quantidade de informações que um modelo de linguagem grande (LLM) consegue processar em uma única solicitação. Medida em tokens, ela pode incluir seu prompt, histórico da conversa, instruções do sistema, documentos recuperados, resultados de ferramentas e a resposta gerada pelo modelo.
Uma janela de contexto maior permite que um modelo trabalhe com mais informações em uma única solicitação. Por exemplo, um agente de programação que investiga um bug poderia trabalhar ao mesmo tempo com arquivos-fonte relevantes, documentação, resultados de testes e alterações recentes no código, em vez de analisar cada parte separadamente e perder contexto útil entre solicitações.
Porém, uma janela de contexto maior não equivale a uma memória perfeita. Prompts mais longos exigem mais computação, consomem mais tokens e podem dificultar a identificação dos detalhes que realmente importam pelo modelo. Pesquisas sobre modelos de contexto longo, incluindo o estudo Lost in the Middle e o benchmark RULER da NVIDIA, constataram repetidamente que os modelos usam menos do que têm disponível à medida que o contexto cresce, especialmente quando informações relevantes ficam ocultas entre materiais menos úteis.
Este artigo explica como as janelas de contexto funcionam, como são medidas, o que acontece quando elas ficam cheias e como os desenvolvedores podem gerenciá-las com eficiência.
Resumo
- Uma janela de contexto é o orçamento total de tokens que um LLM usa em uma única solicitação. Ela abrange o prompt do usuário, o histórico da conversa, o conteúdo recuperado e a saída.
- Janelas de contexto maiores permitem documentos, bases de código e conversas mais longos, mas não garantem que o modelo use bem todas as partes deles.
- Os modelos recuperam informações com menos confiabilidade do meio de prompts longos, um padrão documentado no estudo Lost in the Middle e no benchmark RULER.
- O gerenciamento eficaz de contexto (recuperação, resumo e cache) geralmente é melhor do que simplesmente maximizar a quantidade de tokens enviados.
- A melhor estratégia de contexto é a que corresponde à sua carga de trabalho real, e não a que usa a maior janela de contexto anunciada.
O que é uma janela de contexto em um modelo de IA?
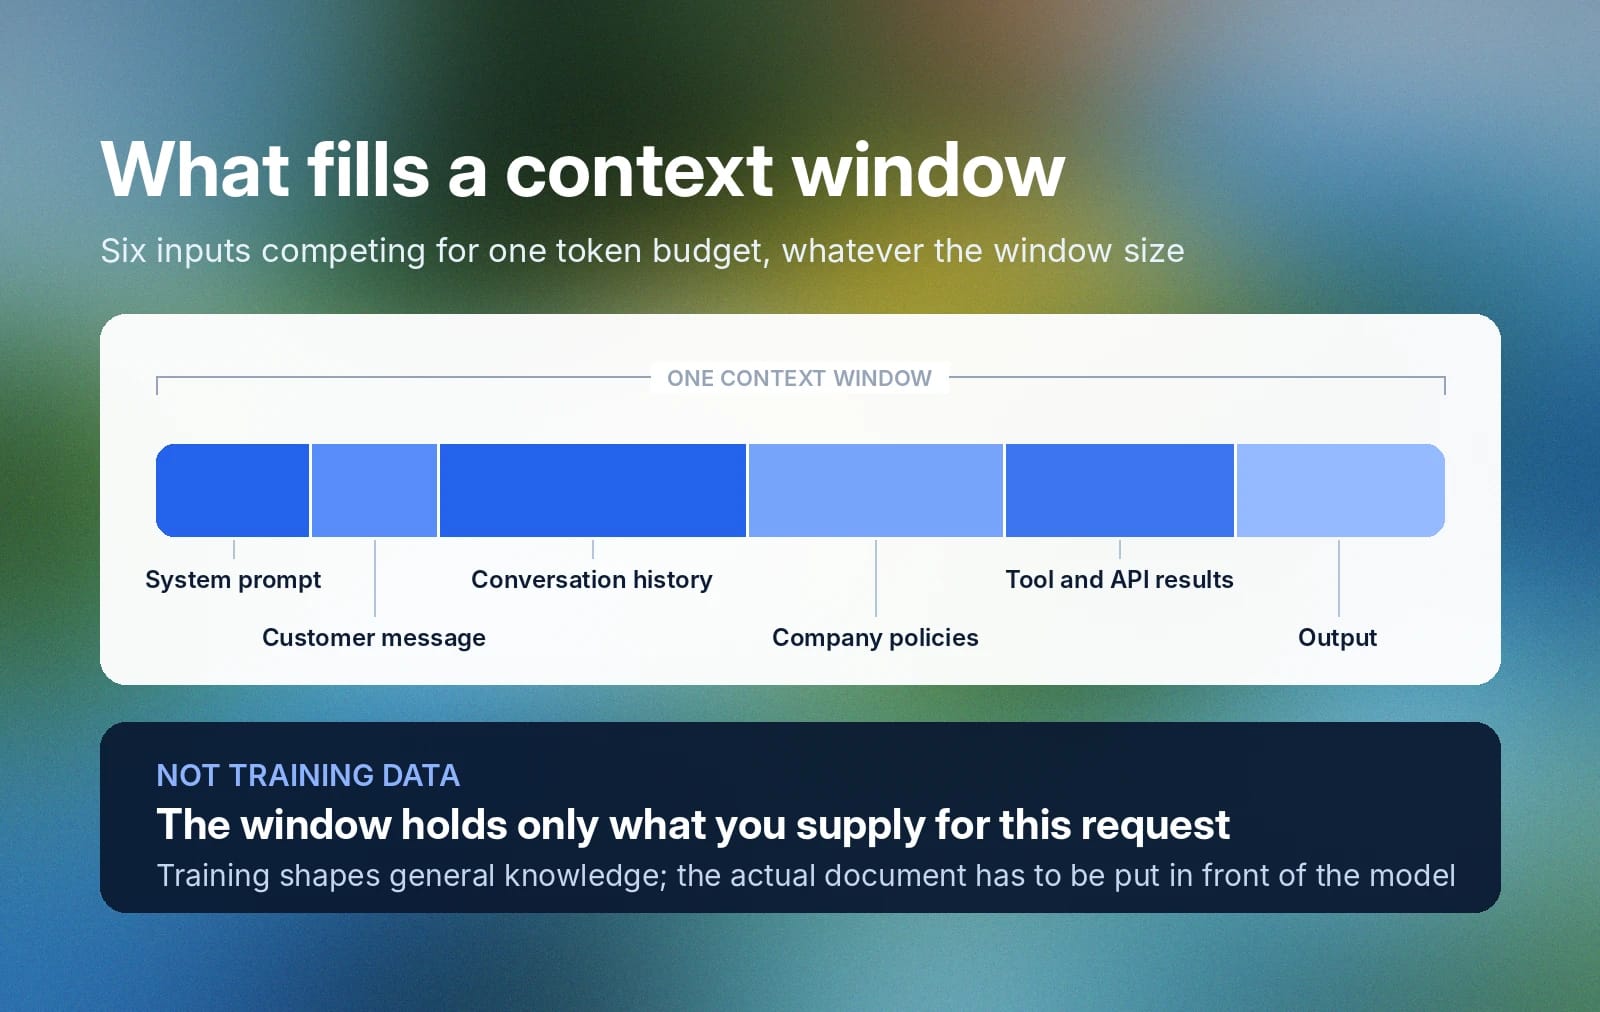
Uma janela de contexto é o espaço de trabalho ativo de um modelo, onde tudo o que é relevante para a solicitação atual se reúne antes que o modelo gere uma resposta.
Imagine um agente de IA resumindo uma conversa de atendimento ao cliente e recomendando uma solução. Para fazer isso bem, o modelo precisa processar:
- O prompt do sistema
- A mensagem do cliente
- O histórico da conversa
- As políticas da empresa
- Os resultados de ferramentas e APIs
- A saída
Tudo isso disputa espaço dentro da mesma janela de contexto, independentemente do tamanho dela.
As janelas de contexto não incluem dados de treinamento. O treinamento incorpora informações permanentemente aos parâmetros de um modelo, moldando o que ele “sabe” em termos gerais. Já uma janela de contexto contém apenas as informações fornecidas para a tarefa atual.
Essa distinção importa na prática: se uma aplicação precisa que um modelo raciocine sobre uma política específica, um registro de cliente ou um documento técnico, essas informações não ficam disponíveis apenas porque o modelo foi treinado com materiais semelhantes. Em geral, elas precisam entrar diretamente no contexto de trabalho do modelo pelo prompt ou por meio de um sistema de recuperação ou de ferramentas; caso contrário, o modelo raciocinará com base em conhecimento geral, e não no documento real à sua frente.
Tokenização e janelas de contexto: como os dados são processados
Antes de um LLM processar texto, um tokenizador o divide em unidades menores chamadas tokens. Um token pode representar uma palavra inteira, parte de uma palavra, um sinal de pontuação ou outro trecho curto de texto.
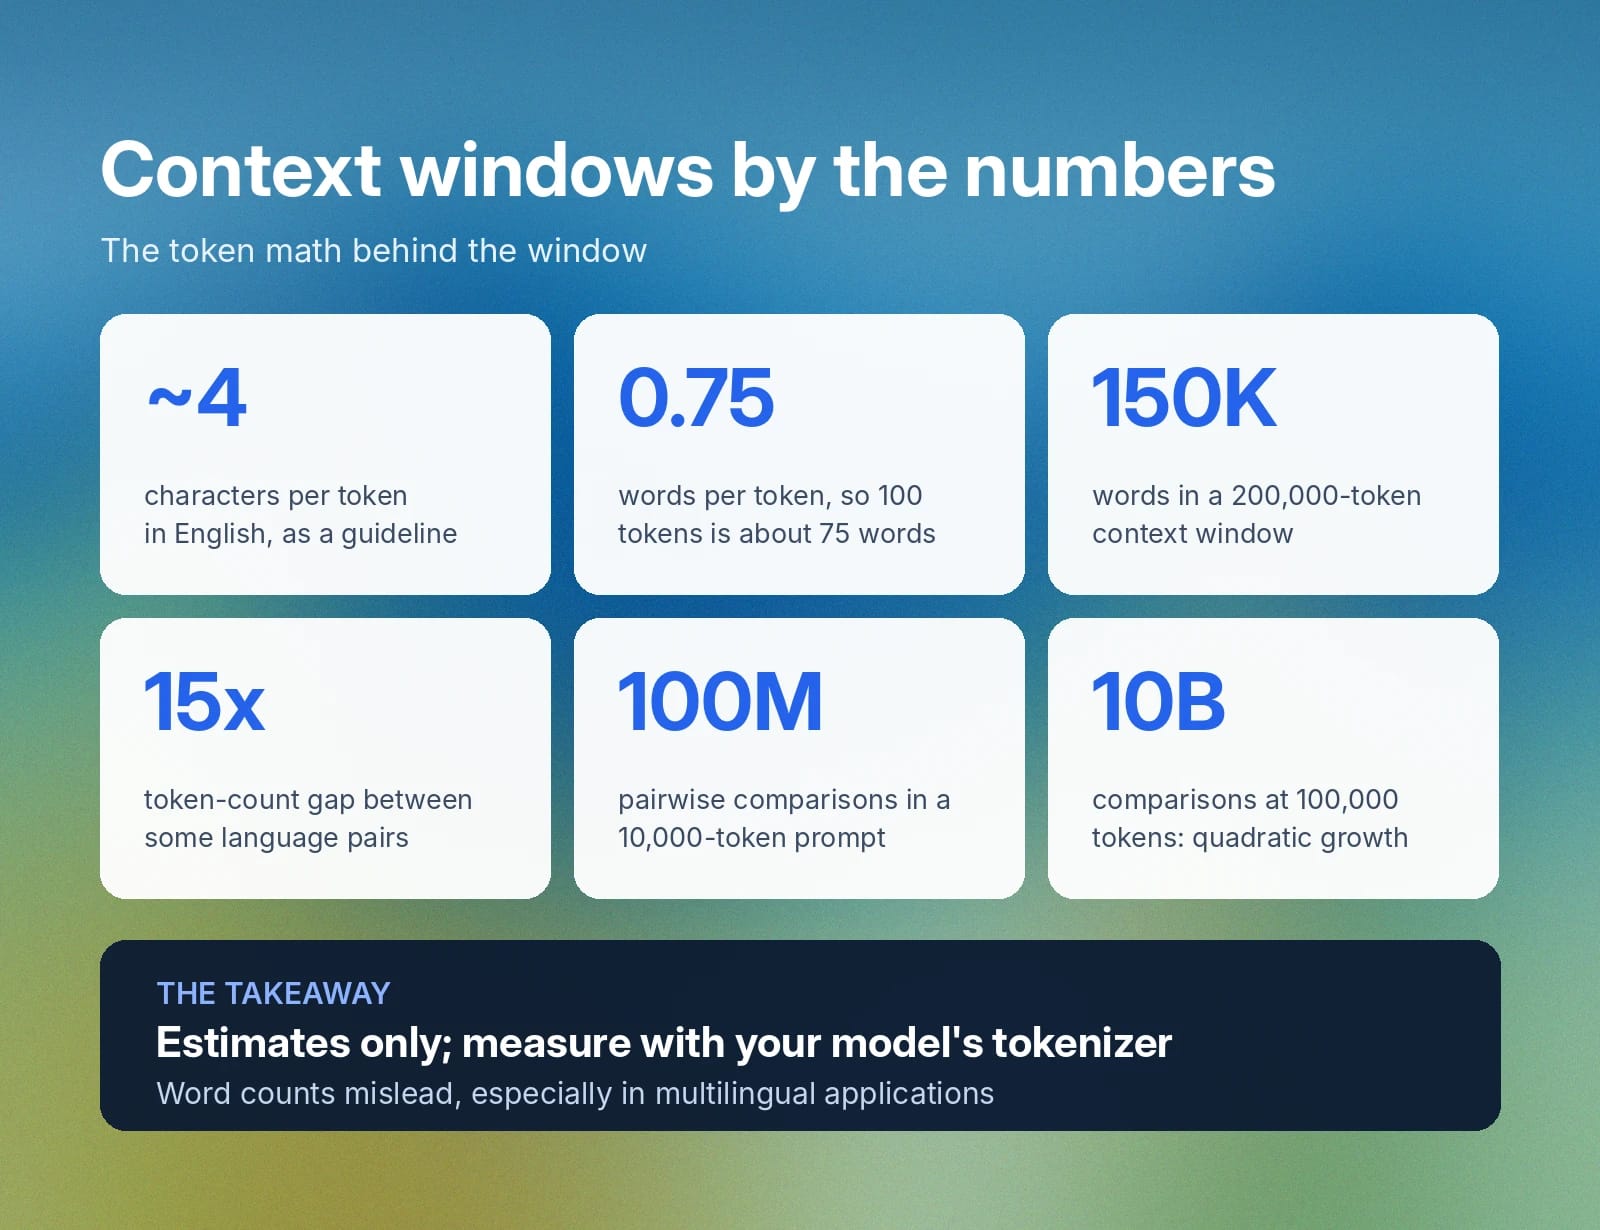
Para o inglês, uma referência útil é que um token representa aproximadamente quatro caracteres, ou cerca de três quartos de uma palavra. Por essa estimativa, 100 tokens correspondem a aproximadamente 75 palavras. Porém, isso é apenas uma aproximação. Considere a frase “As janelas de contexto afetam o desempenho da aplicação”. Um tokenizador não necessariamente a representa como cinco palavras completas; dependendo do tokenizador, uma ou mais palavras podem ser divididas em vários tokens de subpalavras.
A tokenização também varia significativamente entre idiomas. Duas frases com significados semelhantes e extensões visíveis parecidas podem consumir quantidades muito diferentes de tokens, dependendo do idioma e do tokenizador. Pesquisas sobre equidade de tokenizadores constataram que alguns pares de idiomas diferem em até 15 vezes no comprimento tokenizado para textos equivalentes, mesmo com tokenizadores desenvolvidos para suporte multilíngue. Desenvolvedores que criam aplicações multilíngues devem medir o uso de tokens com o tokenizador real do modelo, em vez de estimar com base na contagem de palavras.
Uma janela de contexto de 200.000 tokens pode parecer enorme, mas uma aplicação que adiciona continuamente histórico de conversas, documentação recuperada, respostas de ferramentas e instruções do sistema pode se aproximar desse limite mais rápido do que o esperado. Por isso, aplicações em produção costumam monitorar o uso de tokens e usar técnicas como resumo, poda de histórico, filtragem de recuperação e compressão de prompts para manter as informações mais relevantes no contexto ativo.
Como funciona uma janela de contexto em modelos de linguagem?
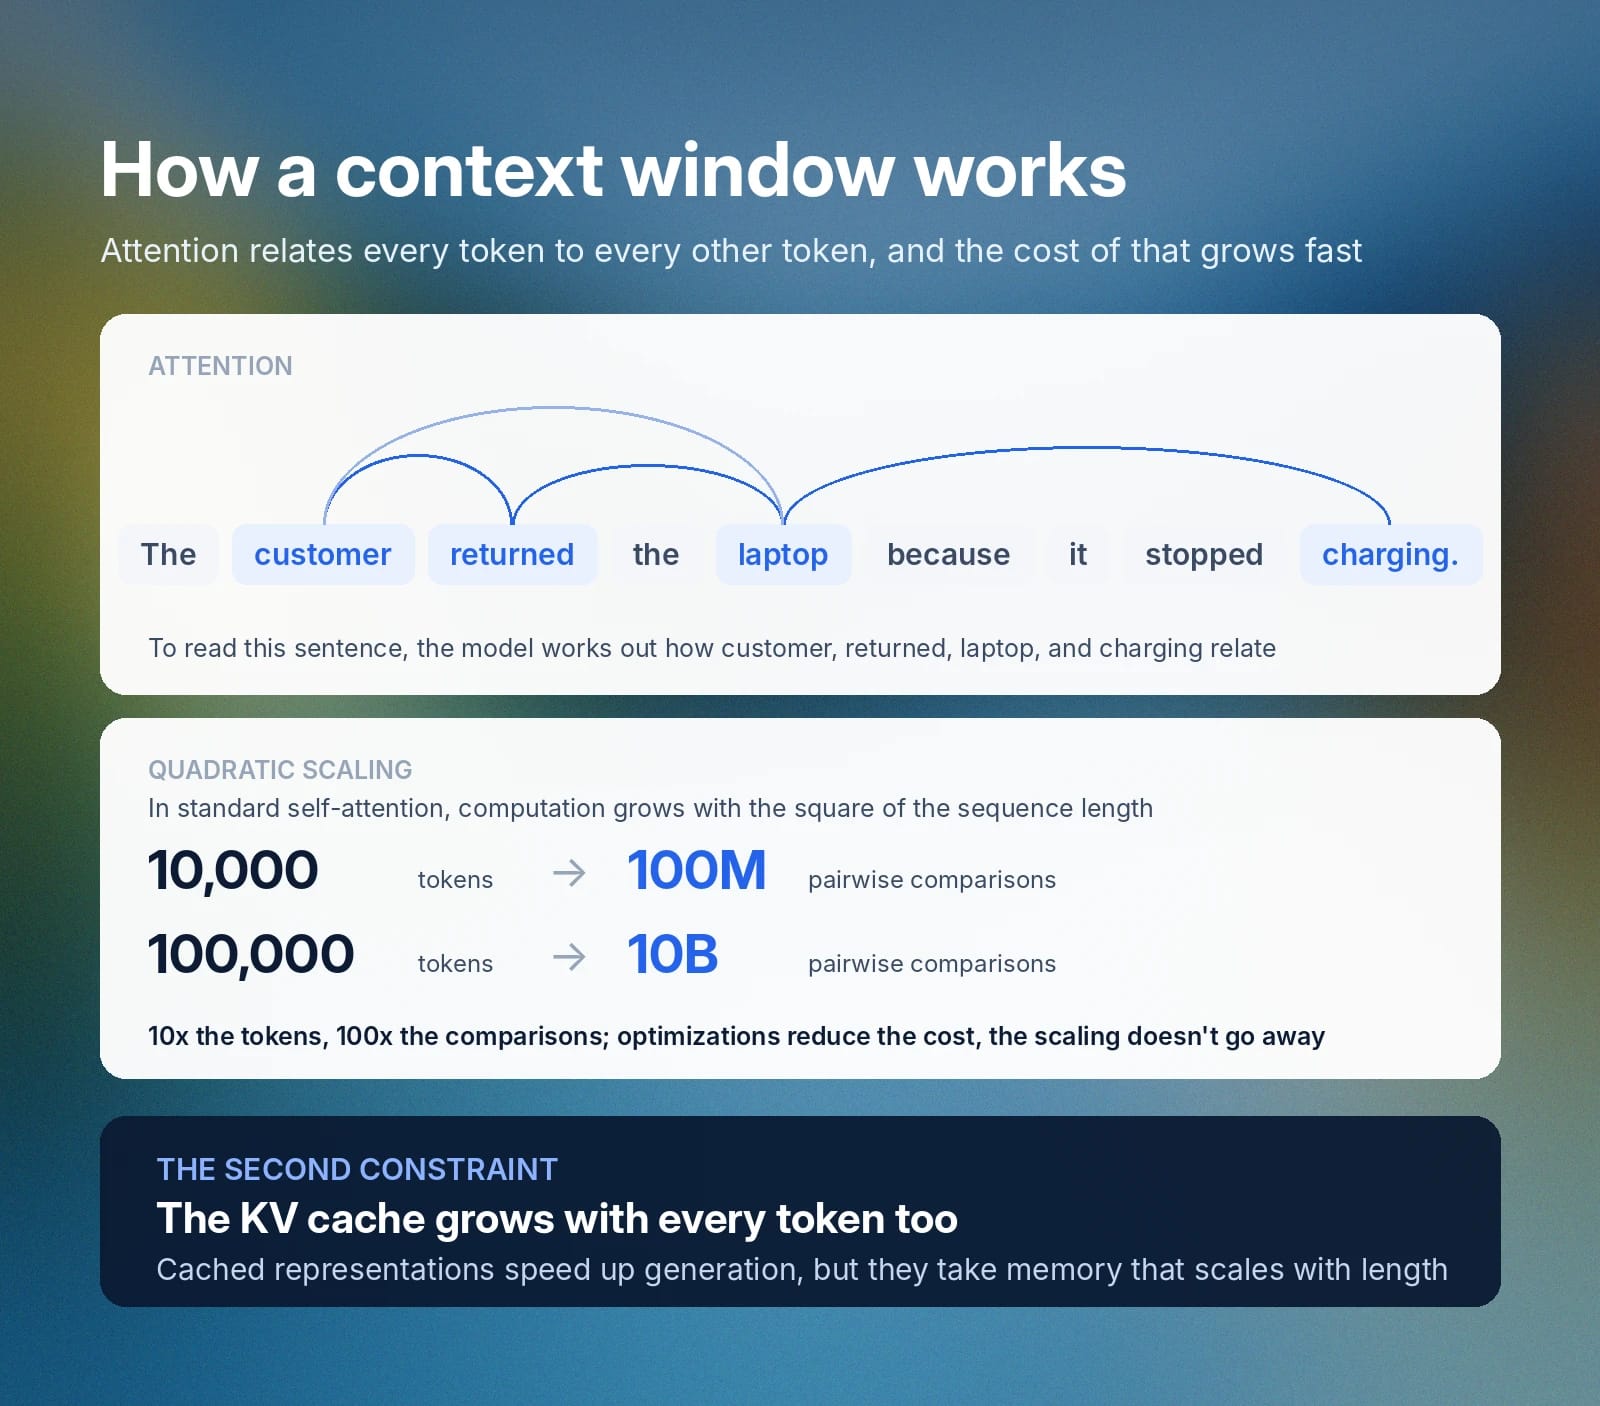
Uma janela de contexto funciona por meio do mecanismo de atenção da arquitetura transformer, que calcula como cada token de uma entrada se relaciona com todos os outros tokens antes de o modelo produzir uma resposta.
Considere a frase "O cliente devolveu o laptop porque ele parou de carregar." Para interpretá-la corretamente, o modelo precisa entender como cliente, laptop, devolveu e carregar se relacionam. À medida que uma sequência fica mais longa, o número dessas relações cresce rapidamente.
Na autoatenção padrão, a computação necessária cresce aproximadamente com o quadrado do comprimento da sequência. Por exemplo, um prompt de 10.000 tokens exige cerca de 100 milhões de comparações em pares, enquanto um prompt de 100.000 tokens exige cerca de 10 bilhões. Modelos modernos usam várias otimizações de arquitetura e infraestrutura para reduzir esse custo na prática, mas o problema de escalabilidade subjacente não desaparece.
Conversas longas acrescentam uma segunda restrição: o cache de chave-valor, ou KV. Durante a geração, os modelos mantêm representações intermediárias dos tokens anteriores em vez de recalculá-las para cada novo token, o que acelera bastante a inferência. Porém, o próprio cache ocupa memória e cresce à medida que a sequência fica mais longa.
Comprimento máximo de contexto em modelos de IA e por que ele importa
O comprimento máximo de contexto de um modelo define quanta informação ele pode aceitar e processar em uma única solicitação. Porém, se o modelo usa uma janela de contexto grande com eficiência é uma questão à parte.
Janelas de contexto mais longas permitem casos de uso que eram difíceis ou inviáveis com LLMs anteriores. Os desenvolvedores podem fornecer a um modelo um repositório de código inteiro, um documento jurídico extenso, um artigo de pesquisa, uma transcrição de reunião ou um histórico de conversa substancial, sem antes reduzir o material a alguns milhares de tokens.
Isso importa porque preservar uma parte maior do contexto original pode melhorar a capacidade do modelo de responder a perguntas com precisão, identificar relações entre informações distantes e executar tarefas que dependem do documento como um todo. Por exemplo, um assistente de programação pode precisar examinar vários arquivos para entender como uma função é chamada, enquanto um assistente de documentos jurídicos pode precisar comparar definições em uma seção com obrigações descritas muito mais adiante no documento.
Porém, uma janela de contexto maior não produz automaticamente resultados melhores. Entradas muito longas podem aumentar o custo e a latência, e os modelos podem dar menos atenção a informações ocultas no meio de um contexto grande. Portanto, os desenvolvedores devem incluir informações relevantes de forma seletiva, organizar entradas longas com clareza e usar técnicas como recuperação, resumo e poda de contexto quando apropriado.
Comparação dos tamanhos de janelas de contexto por modelo
As janelas de contexto variam bastante entre as principais famílias de modelos atuais, de algumas centenas de milhares de tokens a 10 milhões. Veja como os principais modelos atuais se comparam:
Modelo | Janela de contexto | Observações |
10 milhões de tokens | Modelo da Meta com pesos abertos; a maior janela disponível publicamente até o momento | |
1,05 milhão de tokens | Modelo principal atual da OpenAI para programação e raciocínio agêntico | |
1 milhão de tokens | Modelo atual da categoria Pro do Google para análise de documentos longos e múltiplos arquivos | |
1 milhão de tokens | Modelo atual da Anthropic na categoria Sonnet; a janela é aplicada por padrão em toda a API do Claude |
Os limites anunciados mudam rapidamente à medida que os provedores lançam novos modelos e elevam seus tetos. Portanto, considere qualquer tabela como esta um retrato do momento, e não um ranking permanente. O tamanho do contexto é apenas um dos fatores para escolher um modelo. Por si só, ele não diz nada sobre qualidade de raciocínio, limites de saída, latência ou custo.
Implicações de uma janela de contexto pequena versus grande
Uma janela de contexto pequena obriga os desenvolvedores a serem seletivos. Documentos longos são divididos em partes, históricos de conversa mais antigos são resumidos e conhecimento externo é recuperado apenas quando realmente necessário.
Uma janela de contexto grande elimina algumas dessas restrições. Você pode fornecer mais exemplos, preservar mais histórico de conversa ou analisar um conjunto maior de documentos sem precisar dividir tudo antes.
Porém, uma janela maior introduz um problema diferente: diluição da atenção. Quando um prompt contém uma grande quantidade de informações, o modelo pode ter dificuldade para identificar quais detalhes são mais relevantes para a solicitação atual. Instruções ou evidências importantes podem ficar ocultas entre conteúdos menos relevantes, aumentando o risco de respostas incompletas, inconsistentes ou menos precisas.
Por que os modelos se perdem no meio
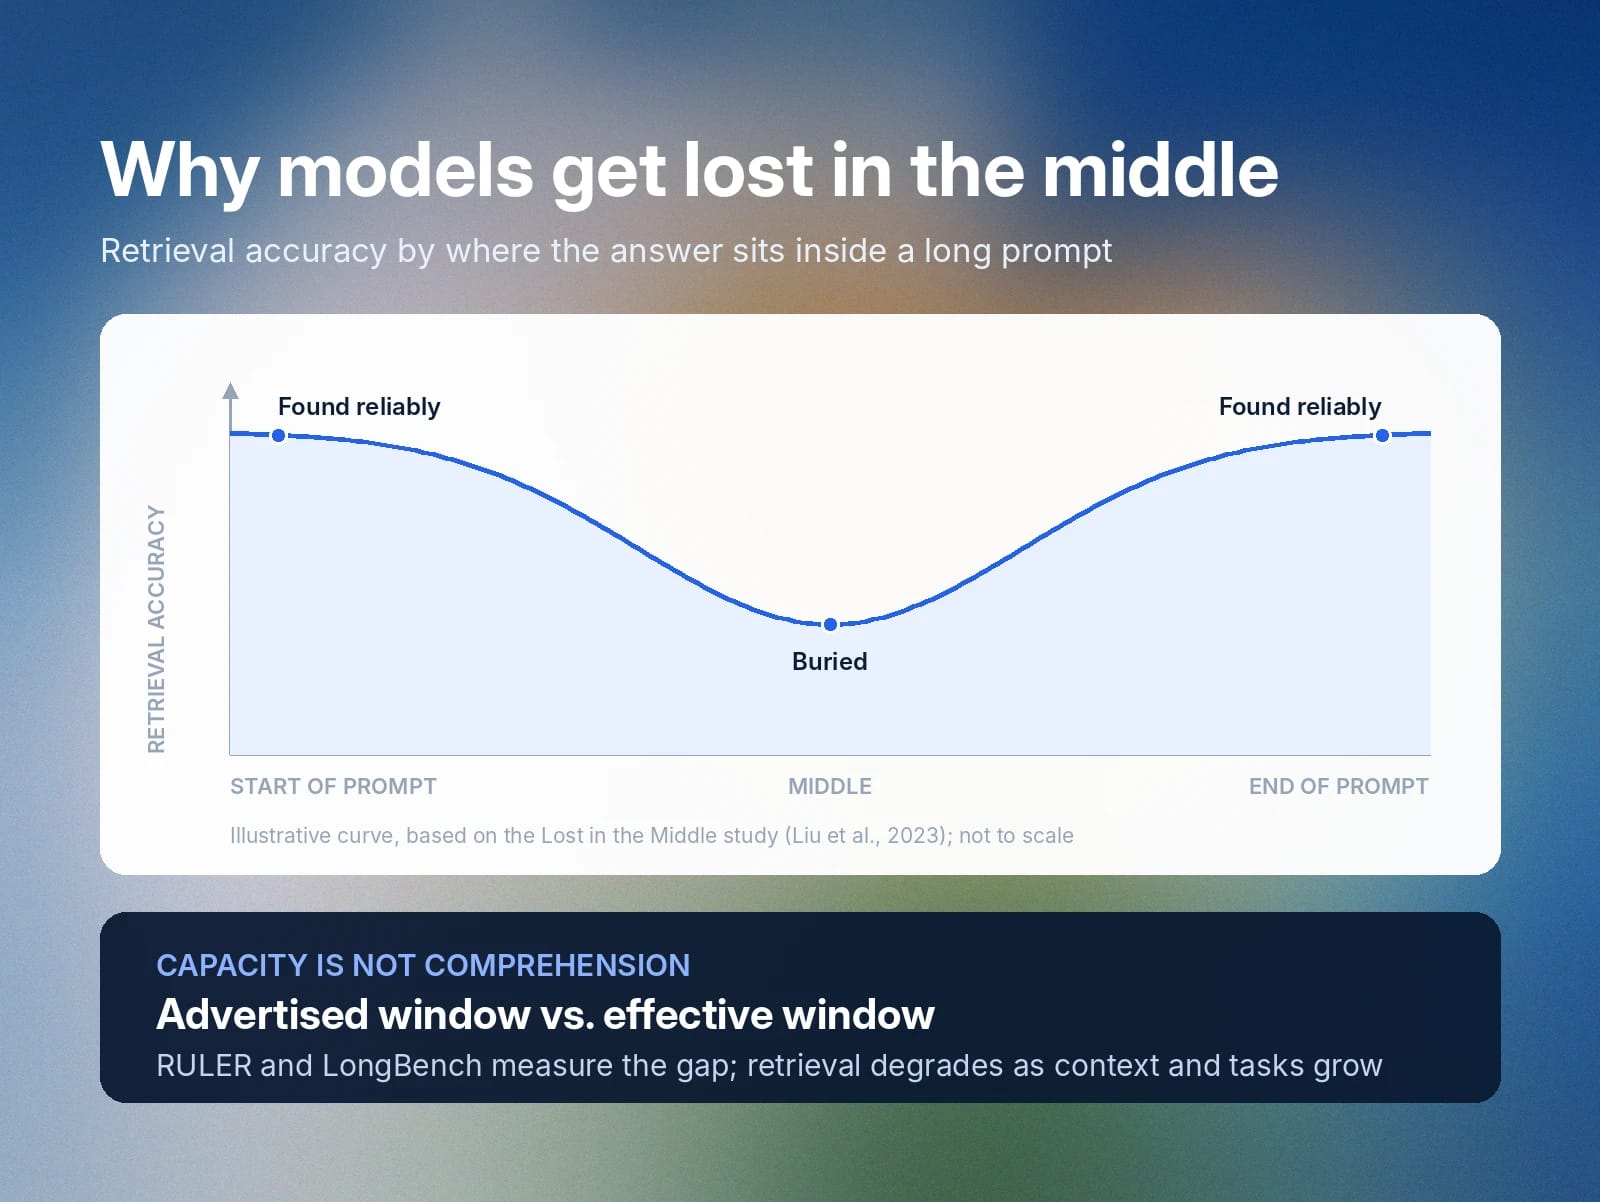
Os modelos tendem a recuperar informações melhor quando elas estão perto do início ou do fim de um prompt longo, e pior quando estão ocultas no meio. O influente estudo Lost in the Middle testou isso diretamente ao posicionar a resposta de uma pergunta em diferentes partes de um prompt longo e medir com que frequência os modelos a encontravam. A precisão foi consistentemente maior no início e no fim do contexto, e menor no meio.
Isso significa que um modelo pode aceitar tecnicamente um documento sem usar todas as partes dele de modo confiável. Envie a um LLM 100 documentos de suporte porque um deles contém a resposta para a pergunta de um cliente, e uma janela de contexto maior poderá acomodar os 100. Mas o modelo ainda precisa encontrar uma passagem relevante entre 99 irrelevantes, e uma janela mais longa não garante que ele conseguirá.
Por isso, vale distinguir entre a janela de contexto anunciada de um modelo e sua janela de contexto efetiva para uma determinada carga de trabalho. Benchmarks como RULER e LongBench tentam medir essa diferença. O RULER constatou que modelos com pontuações quase perfeitas em testes simples de recuperação ainda apresentavam queda de desempenho à medida que o comprimento do contexto e a complexidade da tarefa aumentavam. O LongBench avalia tarefas mais amplas, incluindo resposta a perguntas sobre documentos, raciocínio com múltiplos documentos, resumo, aprendizado few-shot e conclusão de código.
O contexto longo ainda agrega valor real. Capacidade e compreensão são propriedades diferentes, e ambas importam ao escolher um modelo para uma determinada tarefa.
Gerenciamento de limites de contexto: práticas recomendadas para desenvolvedores
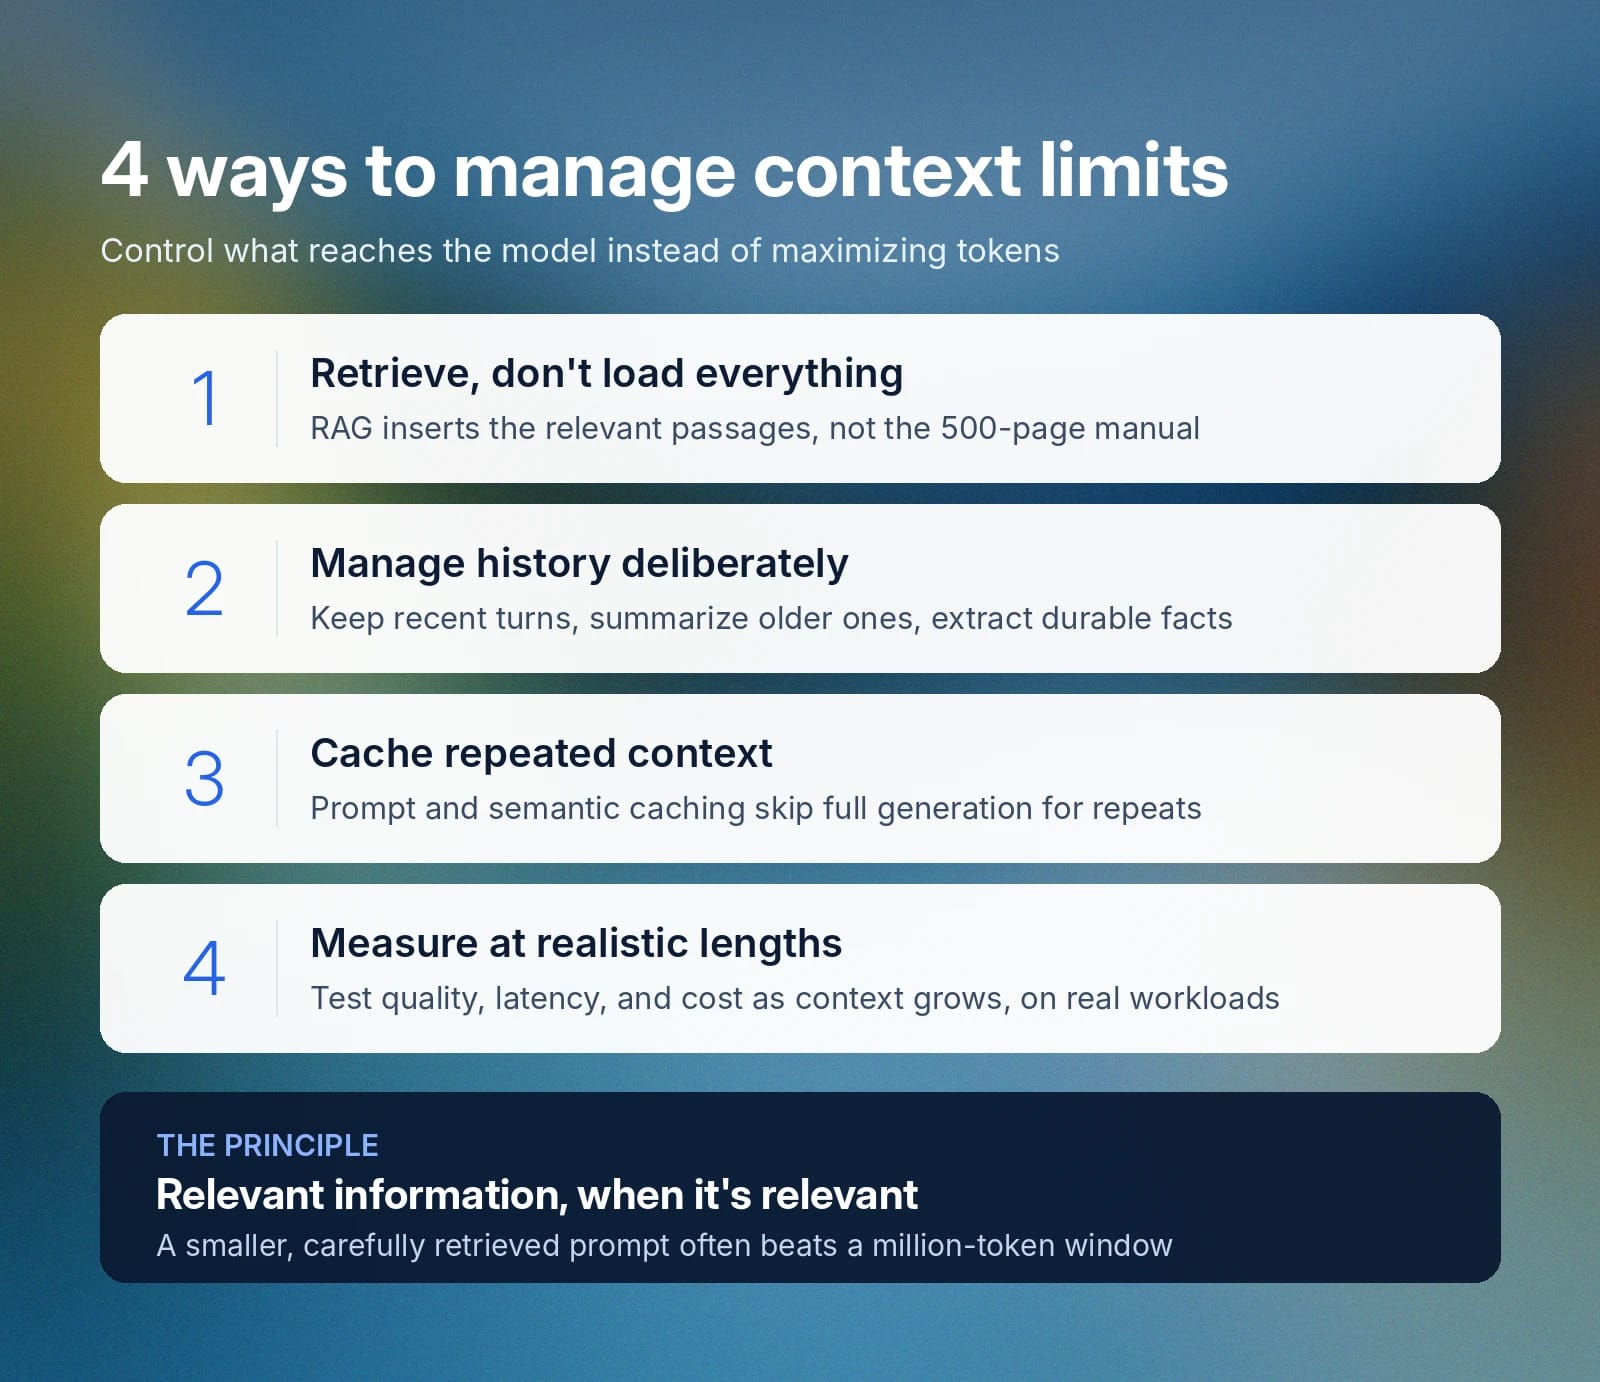
Um bom gerenciamento de contexto significa controlar o que chega ao modelo: fornecer as informações relevantes para a tarefa quando elas são relevantes, em vez de tentar maximizar o número de tokens em cada solicitação. As práticas a seguir podem ajudar desenvolvedores a reduzir contexto desnecessário, melhorar a qualidade das respostas e controlar custo e latência.
1. Recupere informações relevantes em vez de carregar tudo
A geração aumentada por recuperação, ou RAG, permite que uma aplicação pesquise uma base de conhecimento externa e insira apenas as passagens relevantes no contexto do modelo. Em vez de colocar um manual inteiro de 500 páginas em cada solicitação de suporte, a aplicação recupera as poucas passagens mais próximas da pergunta real do cliente.
Isso reduz o uso de tokens e dá ao modelo um sinal muito mais claro sobre o que importa. A qualidade da recuperação continua sendo importante: sistemas de RAG em produção geralmente melhoram os resultados dividindo documentos cuidadosamente, recuperando várias passagens candidatas, reclassificando essas candidatas e filtrando qualquer conteúdo irrelevante antes de criar o prompt final. A ElevenLabs, por exemplo, reconstruiu seu pipeline de RAG para adicionar reformulação de consultas e chamadas paralelas de modelos, reduzindo pela metade a latência mediana de recuperação.
2. Gerencie o histórico de conversas de forma intencional
Aplicações conversacionais acumulam contexto rapidamente. Adicionar todas as mensagens anteriores indefinidamente desperdiça tokens e pode trazer detalhes irrelevantes para interações posteriores.
As aplicações lidam com isso mantendo as interações mais recentes, resumindo trocas mais antigas, extraindo fatos duradouros para uma memória estruturada e recuperando detalhes antigos apenas quando voltam a ser relevantes. Isso cria uma divisão útil entre o contexto conversacional de curto prazo, que o modelo precisa imediatamente, e a memória de longo prazo da aplicação, que pode ser recuperada mais tarde.
3. Use cache quando o contexto se repete
Muitas aplicações enviam repetidamente as mesmas instruções extensas ou respondem a perguntas semanticamente semelhantes às que já processaram. O cache reduz essa sobrecarga.
O cache de prompt ou de contexto permite reutilizar entradas repetidas com mais eficiência, e o cache semântico vai além ao reconhecer quando uma nova pergunta significa praticamente o mesmo que outra que o sistema já respondeu. "Qual é a sua política de devolução?" e "Por quanto tempo posso devolver um item?" são strings diferentes que um cache semântico pode tratar como a mesma pergunta, evitando uma chamada completa de geração e reduzindo tanto a latência quanto os custos de tokens.
4. Meça o desempenho em comprimentos de contexto realistas
Não escolha uma estratégia de contexto com base apenas no limite de tokens anunciado pelo provedor do modelo. Teste cargas de trabalho representativas de produção e meça qualidade das respostas, precisão da recuperação, latência, uso de tokens, custo e taxas de falha à medida que o comprimento do contexto aumenta.
Compare estratégias como fornecer mais contexto, recuperar menos passagens, resumir o histórico de conversas ou combinar recuperação com resumo. Um modelo com uma janela de contexto de um milhão de tokens pode atender tecnicamente à sua aplicação, enquanto um prompt menor e recuperado com cuidado produz resultados mais rápidos e precisos a um custo menor.
Comece a usar o ElevenAgents para soluções de linguagem escaláveis
O gerenciamento de contexto é mais importante em agentes conversacionais, que precisam combinar a fala atual com interações anteriores, instruções da empresa, informações de clientes, conteúdo da base de conhecimento e resultados de ferramentas, tudo isso respondendo rápido o suficiente para que a conversa pareça natural.
ElevenAgents reúne esses elementos em uma única plataforma para criar e implantar agentes de voz IA. Seu mecanismo de orquestração coordena o reconhecimento de fala, um LLM e o Text to Speech, enquanto os desenvolvedores configuram prompts, bases de conhecimento, ferramentas, workflows e o modelo de linguagem subjacente. A entrega expressiva, incluindo como um agente transmite contexto emocional na fala, depende do mesmo contexto que define o que o agente diz em primeiro lugar.
Especificamente para gerenciamento de conhecimento, o ElevenAgents oferece suporte tanto a documentos de contexto completo quanto a RAG, configurável diretamente na plataforma. Documentos pequenos entram diretamente no prompt de um agente, para que seu conteúdo permaneça disponível durante toda a conversa. Bases de conhecimento maiores são indexadas, e o RAG recupera as passagens relevantes para cada consulta, em vez de carregar tudo na janela de contexto de uma só vez.
Comece cadastrando-se no ElevenAgents hoje ou fale com nossa equipe para conhecer suas opções de implantação.
Perguntas frequentes sobre janelas de contexto

Jack Limebear faz parte do time de Growth, atuando como redator e estrategista de conteúdo no blog e nas páginas de insights. Antes da ElevenLabs, ele passou mais de dez anos liderando estratégias de conteúdo em organizações que vão de startups SaaS em rápido crescimento a empresas da Fortune 500. Ele é mestre em Literatura Inglesa pela Universidade de Cambridge.

