Desvendando o Motor de Orquestração do ElevenAgent
- Publicado
- Última atualização
OuvirOuça este artigo
ElevenAgents são impulsionados por um mecanismo de orquestração de baixa latência, criado especificamente para conversas em tempo real, que adiciona menos de 100 ms de sobrecarga. Essa arquitetura combina o melhor das pesquisas da ElevenLabs com LLMs de ponta dos principais provedores, como OpenAI, Google e Anthropic, além de modelos open source selecionados e hospedados pela ElevenLabs. Ao usar vários modelos em diferentes etapas do pipeline de respostas, o agente garante conversas altamente responsivas e contextualizadas. Ao aproveitar dinamicamente os pontos fortes de cada modelo em conjunto, alcançamos um desempenho confiável e escalável em diversas tarefas corporativas e cenários de conversa, otimizando o equilíbrio entre inteligência, velocidade e custo.
Neste artigo, explicamos como esses modelos trabalham juntos para oferecer os recursos essenciais de que os agentes precisam para operar em ambientes complexos e, mais especificamente, qual modelo vê quais tokens e em que momento. No centro disso está o gerenciamento do histórico da conversa em diferentes pontos da interação. Vamos revisar como e onde o histórico da conversa é compartilhado para esclarecer seu papel na orquestração tanto de agentes independentes quanto de workflows com múltiplos agentes.
Agente independente
Começamos explorando o agente independente e seus componentes principais. É razoável considerar que um agente minimamente útil tem um prompt de sistema, acesso a várias ferramentas e uma base de conhecimento. Os clientes devem preferir agentes independentes a workflows quando o caso de uso exige pouca verificação de uma sequência rígida de etapas ou quando é importante evitar silos de conhecimento entre os agentes. Silos de conhecimento surgem quando determinadas ferramentas, documentos ou contexto histórico ficam acessíveis para alguns subagentes, mas não para outros. Eles são inerentes a workflows com múltiplos agentes e criam um equilíbrio entre flexibilidade e determinismo.
Para agentes independentes na ElevenLabs, é importante entender como eles:
- Criam solicitações de geração eficazes
- Recuperam e incorporam documentos relevantes
- Geram e executam chamadas de ferramentas para orientar as respostas do agente
- Geram resultados para avaliação e coleta de dados
Criando o contexto da conversa
Uma conversa entre um cliente e um agente da ElevenLabs representa uma série de turnos, em que cada turno é composto por uma troca de mensagens entre as duas partes. Essa lista alternada de mensagens do agente e do usuário serve como ponto de partida para construir o contexto da conversa. Durante cada turno, o LLM subjacente recebe solicitações de geração que contêm uma série de mensagens alternadas do agente e do usuário, com uma mensagem a mais que no turno anterior. Naturalmente, essa série de mensagens é precedida por uma única mensagem de sistema que representa o prompt de sistema do agente.
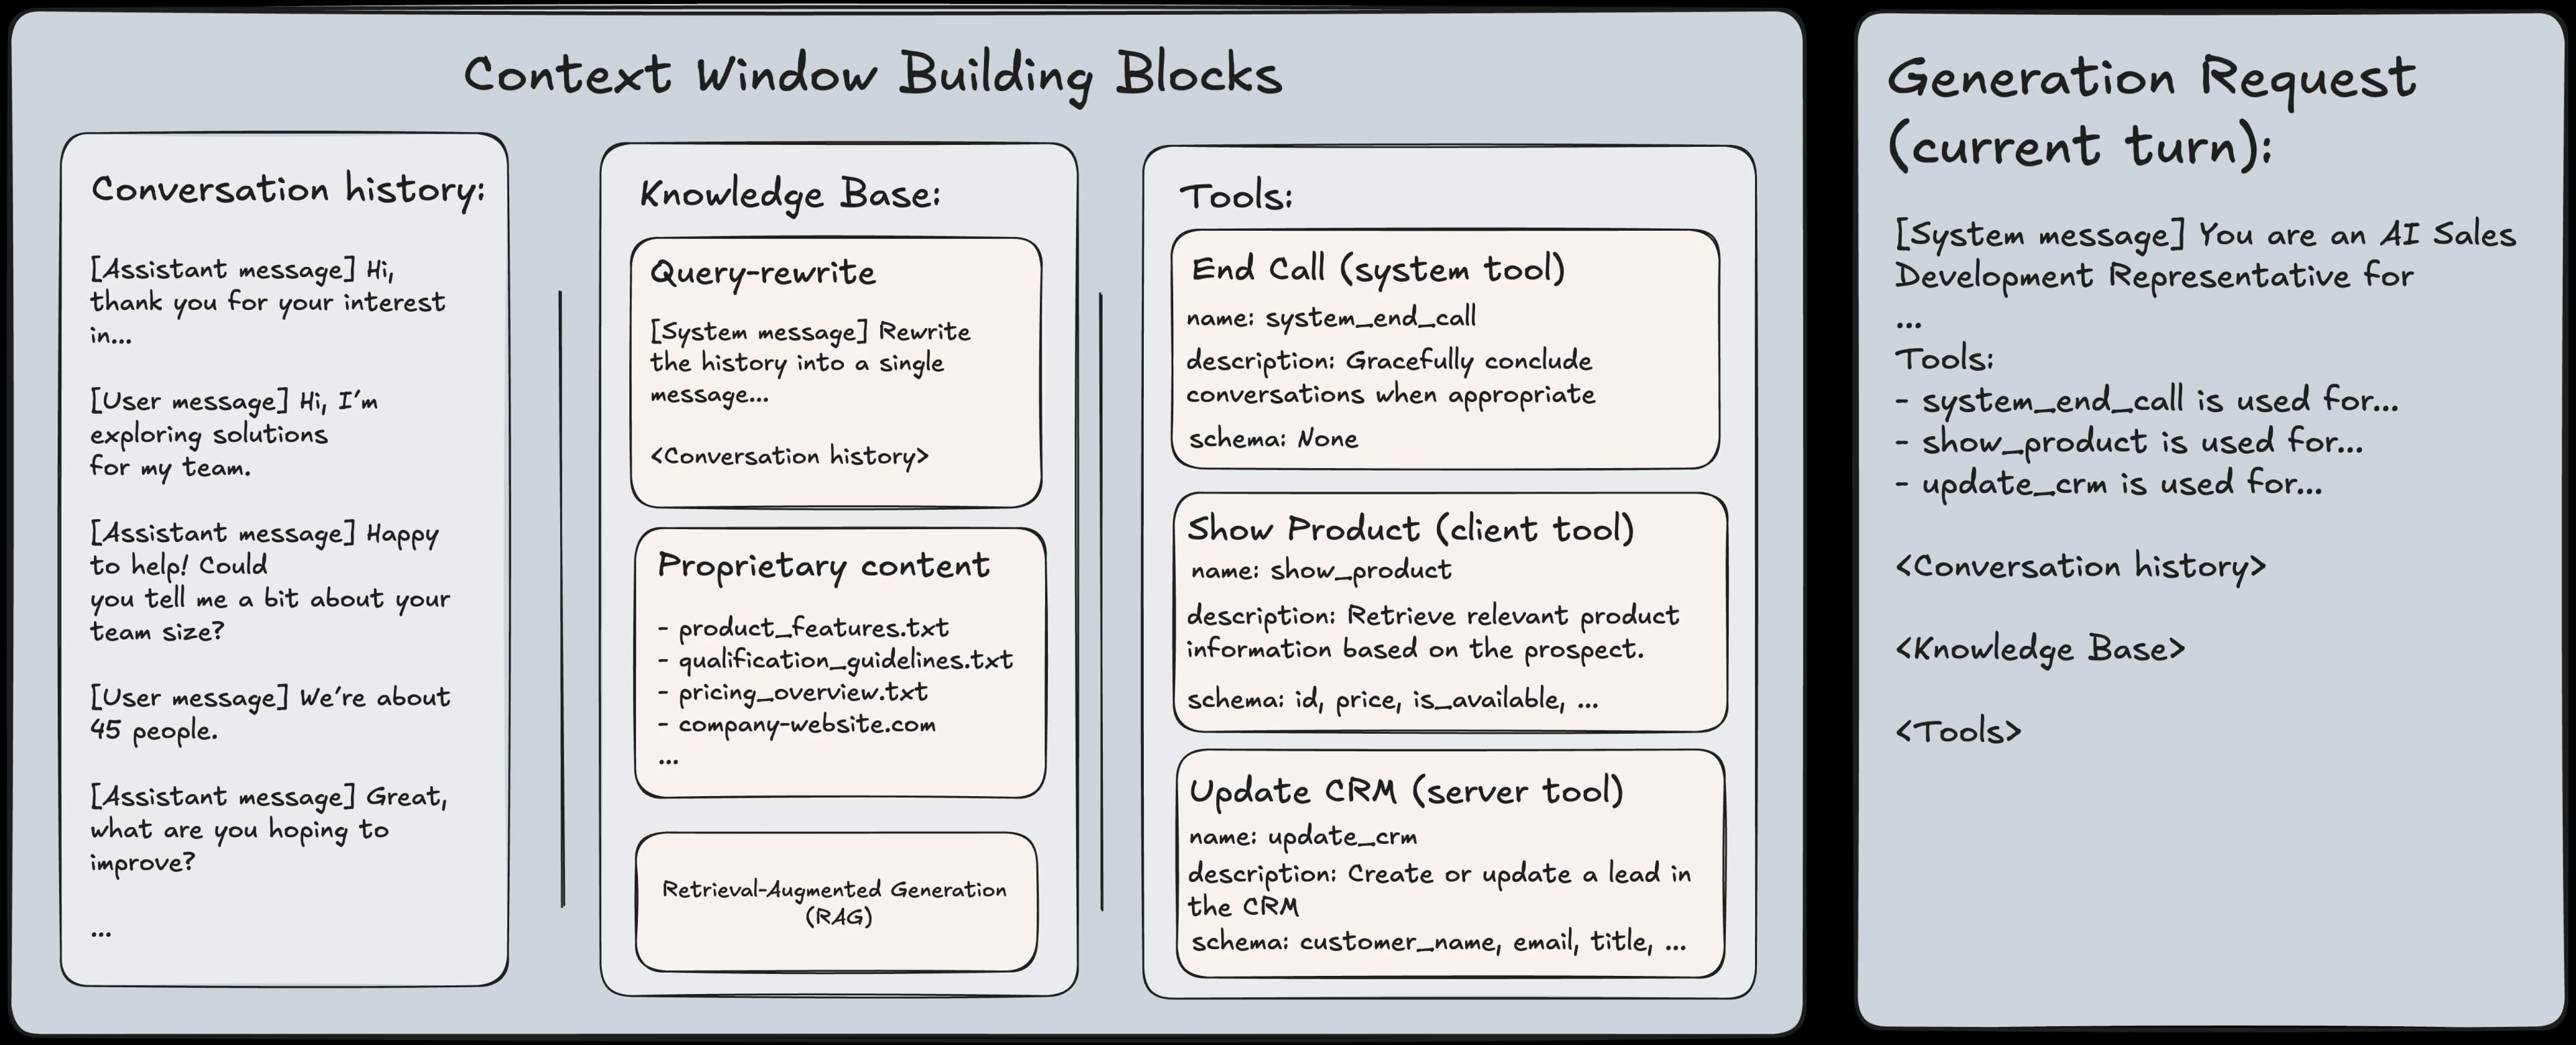
O orquestrador da ElevenLabs reduz a latência percebida do LLM ao prever quando um usuário terminou de falar. Em alguns casos, isso pode resultar em várias solicitações de geração ao LLM com o mesmo contexto de conversa em um único turno. Embora a orquestração otimize a velocidade de resposta dos agentes, a qualidade das respostas depende igualmente de como o conhecimento é acessado. À medida que os clientes avançam, geralmente começam a fundamentar as respostas de seus agentes em uma combinação de documentação proprietária e conteúdo público. Há vários anos, a geração aumentada por recuperação (RAG) é a abordagem padrão para isso. Bases de Conhecimento do ElevenAgents se baseiam em RAG com uma arquitetura otimizada de vários modelos, que detalhamos em uma publicação anterior. Isso permite recuperar documentos de forma confiável mesmo quando a entrada mais recente do usuário é uma pergunta complementar, uma confirmação de um esclarecimento ou não contém uma pergunta explícita.
A recuperação, porém, é apenas uma das formas de os agentes interagirem com sistemas externos.
Executando ações e recuperando informações com ferramentas
Os agentes da ElevenLabs podem executar ações no mundo real e recuperar informações atualizadas durante a conversa por meio de um sistema flexível de ferramentas. Esse poder traz uma consideração importante de design: cada ferramenta ativada aumenta o tamanho do prompt serializado, pois seu nome, descrição e esquema de parâmetros são incluídos junto ao prompt de sistema e ao histórico da conversa. À medida que mais ferramentas são adicionadas, também aumenta a carga de raciocínio do modelo para chamar a sequência correta de ferramentas. No Agent Builder, a descrição da ferramenta explica o que ela faz e quais campos retorna. Essas são as informações que o modelo de linguagem usa para entender o contexto de uso. Depois de definidas, as condições específicas para invocar a ferramenta devem ficar no prompt de sistema do agente. Por exemplo:
- Descrição da ferramenta lookup_order: “Recupera os detalhes do pedido de um cliente pelo ID do pedido. Retorna o status do pedido, os itens comprados, o endereço de entrega e o código de rastreamento.”
- Instrução do prompt de sistema: “Depois de verificar a identidade do cliente, chame a ferramenta lookup_order para recuperar os detalhes do pedido.”
Essa separação de responsabilidades mantém as definições de ferramentas reutilizáveis entre agentes, enquanto permite que o prompt de sistema de cada agente controle o momento exato em que uma ferramenta é chamada. Para ajudar os clientes a criar esses prompts de sistema de forma eficaz, oferecemos orientações mais detalhadas em nosso Guia de Prompting. Nesse contexto, é possível definir principalmente os seguintes tipos de ferramentas:
- Ferramentas de webhook que chamam APIs externas.
- Ferramentas de cliente que enviam solicitações de ferramentas como eventos pelo websocket da conversa.
- Ferramentas de sistema para ações integradas, como transferências de chamada.
- Ferramentas MCP que se conectam a servidores Model Context Protocol.
Sempre que um agente decide usar uma ferramenta, ele extrai os detalhes necessários da conversa e envia uma solicitação para executá-la. Quando a ferramenta retorna um resultado, ele é adicionado à conversa para que o modelo possa fazer referência a ele naturalmente em sua próxima resposta. Se necessário, a saída da ferramenta também pode atualizar as informações armazenadas pelo agente como uma variável dinâmica. Essas informações são mantidas como pares simples de chave-valor, extraídos da resposta da ferramenta usando mapeamentos predefinidos. Depois de definidas, essas variáveis podem retornar ao agente por meio de seu prompt de sistema, de parâmetros de ferramentas futuras e de condições do workflow. Esse ciclo de feedback dá aos agentes uma forma de memória de trabalho que evolui à medida que eles interagem.
Embora isso descreva como as ferramentas se integram ao raciocínio do agente, o momento de execução delas também pode ser configurado. As ferramentas podem ser executadas em um de três modos, cada um adequado a uma necessidade diferente de conversa. No Modo Imediato, a ferramenta é executada assim que é solicitada pelo LLM. Esse é o padrão para consultas rápidas, em que os usuários esperam uma resposta quase instantânea, como verificar o status de um pedido. Quando combinado à fala antes da ferramenta, o agente primeiro gera uma breve confirmação, como “Vou verificar isso para você”, e a envia ao usuário enquanto a ferramenta é executada em paralelo, minimizando o silêncio. Para ferramentas mais lentas, a plataforma estende automaticamente essas mensagens de preenchimento de acordo com o tempo de espera previsto. Já o Modo de Fala Após a Ferramenta adia a execução até o agente terminar de falar. Isso é essencial para ações com consequências no mundo real, como transferir uma chamada, encerrar uma sessão ou enviar um pagamento. O usuário ouve todo o contexto, como “Vou transferir você para o setor de cobrança agora”, e tem a oportunidade de interromper antes que a ação seja realizada. O Modo Assíncrono executa a ferramenta totalmente em segundo plano, sem pausar a conversa. Esse modo é mais indicado para operações fire-and-forget, como enviar um e-mail, acionar um workflow externo ou registrar dados, em que o agente não precisa mencionar o resultado na resposta.
Com a execução e a orquestração definidas, o próximo passo é entender como medir o desempenho.
Medindo o desempenho
Após concluir uma chamada com um Agente, os clientes podem querer extrair determinados dados da chamada para análise e armazenamento posteriores ou determinar se ela foi bem-sucedida. É aí que entram Coleta de dados e Critérios de avaliação. A Coleta de dados permite extrair informações estruturadas da transcrição de uma chamada para análises e agregações posteriores. Os clientes frequentemente exportam esses resultados para o data lakehouse corporativo em workflows de relatórios ou enriquecimento. Por exemplo, um Agente de Desenvolvimento de Vendas pode extrair automaticamente dados de potenciais clientes de uma conversa para criar ou atualizar um lead no sistema de gestão de relacionamento com o cliente (CRM). Já os Critérios de avaliação determinam se uma chamada é considerada bem-sucedida. Se todos os critérios configurados forem atendidos, a própria chamada será marcada como bem-sucedida; caso contrário, será sinalizada como falha. Isso garante que as conversas atendam de forma consistente aos padrões definidos de qualidade e integridade, além de fornecer feedback rápido. Quando uma chamada termina e o webhook pós-chamada é acionado, o agente processa a transcrição final, incluindo execuções de ferramentas e metadados, por meio de um LLM junto com todos os pontos de coleta de dados e critérios de avaliação configurados. O modelo usa esse prompt combinado para determinar se cada critério de avaliação foi atendido e extrair os dados especificados para análise posterior. Como o LLM interpreta essas configurações diretamente como parte do prompt de entrada, é importante formatá-las de maneira clara e consistente para que o modelo possa entendê-las e aplicá-las com precisão. Por isso, recomendamos as seguintes práticas para escrever descrições de Critérios de avaliação e Coleta de dados.
Critérios de avaliação
- Um objetivo claro por critério: uma frase ou item curto é melhor do que vários objetivos em um único critério.
- Observável e baseado na transcrição: formule o objetivo de modo que seja possível decidir o sucesso ou a falha pela transcrição (o que foi dito, o que o agente fez, o que o usuário pediu). Evite objetivos que exijam contexto externo que o LLM não possui.
- Resultados explícitos de sucesso/falha/desconhecido: o LLM já entende que, para marcar como bem-sucedido, o objetivo precisa ser cumprido; para marcar como falha, ele não pode ser cumprido; e, para marcar como desconhecido, não deve ser possível determiná-lo pela transcrição. Portanto, o objetivo deve ser escrito de modo que “cumprido” e “não cumprido” sejam bem definidos; se houver ambiguidade, o modelo poderá tender a classificações como desconhecido ou incorretas
- Mantenha a concisão: às vezes, muitos critérios de avaliação podem ser enviados juntos. Por isso, critérios de avaliação longos podem adicionar ruído e potencialmente causar alucinações
- O idioma importa: qualquer justificativa fornecida pelo LLM sobre um critério de avaliação ter sido atendido ou não será apresentada no mesmo idioma da descrição do critério, por isso é importante levar isso em conta
Coleta de dados
- Descreva exatamente o que extrair: a descrição é o principal sinal para o LLM. Diga o que o campo significa, em que situação ele deve ser definido e o que fazer quando não estiver claro (por exemplo: “Deixe como null se o cliente nunca informou uma data de preferência”).
- Corresponda ao tipo esperado: o valor fornecido pelo LLM sempre corresponderá ao tipo de dado atribuído ao ponto de coleta de dados (por exemplo, boolean, string, integer etc.). Portanto, a descrição deve estar alinhada a ele. Por exemplo, você pode usar algo como “Extraia o número de itens solicitados” para integer e “Sim/não se o cliente aceitou a oferta” para boolean.
- Use enums quando possível: para o tipo string, se o conjunto de valores for fixo, use enum no esquema; isso restringe o modelo e reduz saídas inválidas.
- Um alvo de extração por item: não inclua vários fatos não relacionados na descrição de um item; divida-os em itens separados para que cada chamada tenha um único alvo de extração claro.
- Mantenha as descrições curtas: as descrições podem ter algumas frases; não há necessidade de parágrafos longos. A transcrição já está na mensagem do usuário, então o esquema + uma descrição curta é suficiente.
Atualmente, o LLM usado nesta etapa de avaliação e extração é fixado em um modelo de baixa latência para garantir processamento rápido. Esperamos introduzir em breve opções que ofereçam mais flexibilidade aos clientes.
Agora, vamos abordar casos de uso que exigem orquestração estruturada, determinismo ou especialização entre várias funções de conversa, em que os clientes podem usar Workflows.
Workflows
Workflows oferecem uma interface visual para criar fluxos de conversa complexos. No fim, ela produz o objeto lógico usado pelo orquestrador para gerenciar vários subagentes, ferramentas e transferências sob o identificador de um agente independente. Os Workflows introduzem componentes adicionais a considerar além dos já descritos para agentes independentes, incluindo como:
- Os prompts de sistema e os objetivos de conversa dos subagentes interagem.
- É determinado o percurso pelos vários pontos de transição no grafo.
Objetivos de conversa especializados
Os Workflows reutilizam recursos de agentes independentes para garantir um comportamento consistente durante toda a interação. Isso inclui elementos compartilhados, como o prompt de sistema base, as ferramentas principais e as bases de conhecimento globais, que devem estar sempre disponíveis, independentemente de qual parte do workflow esteja ativa. O prompt de sistema geral normalmente define o contexto global da conversa, o tom esperado, as restrições de segurança e quaisquer instruções específicas da marca ou do produto.
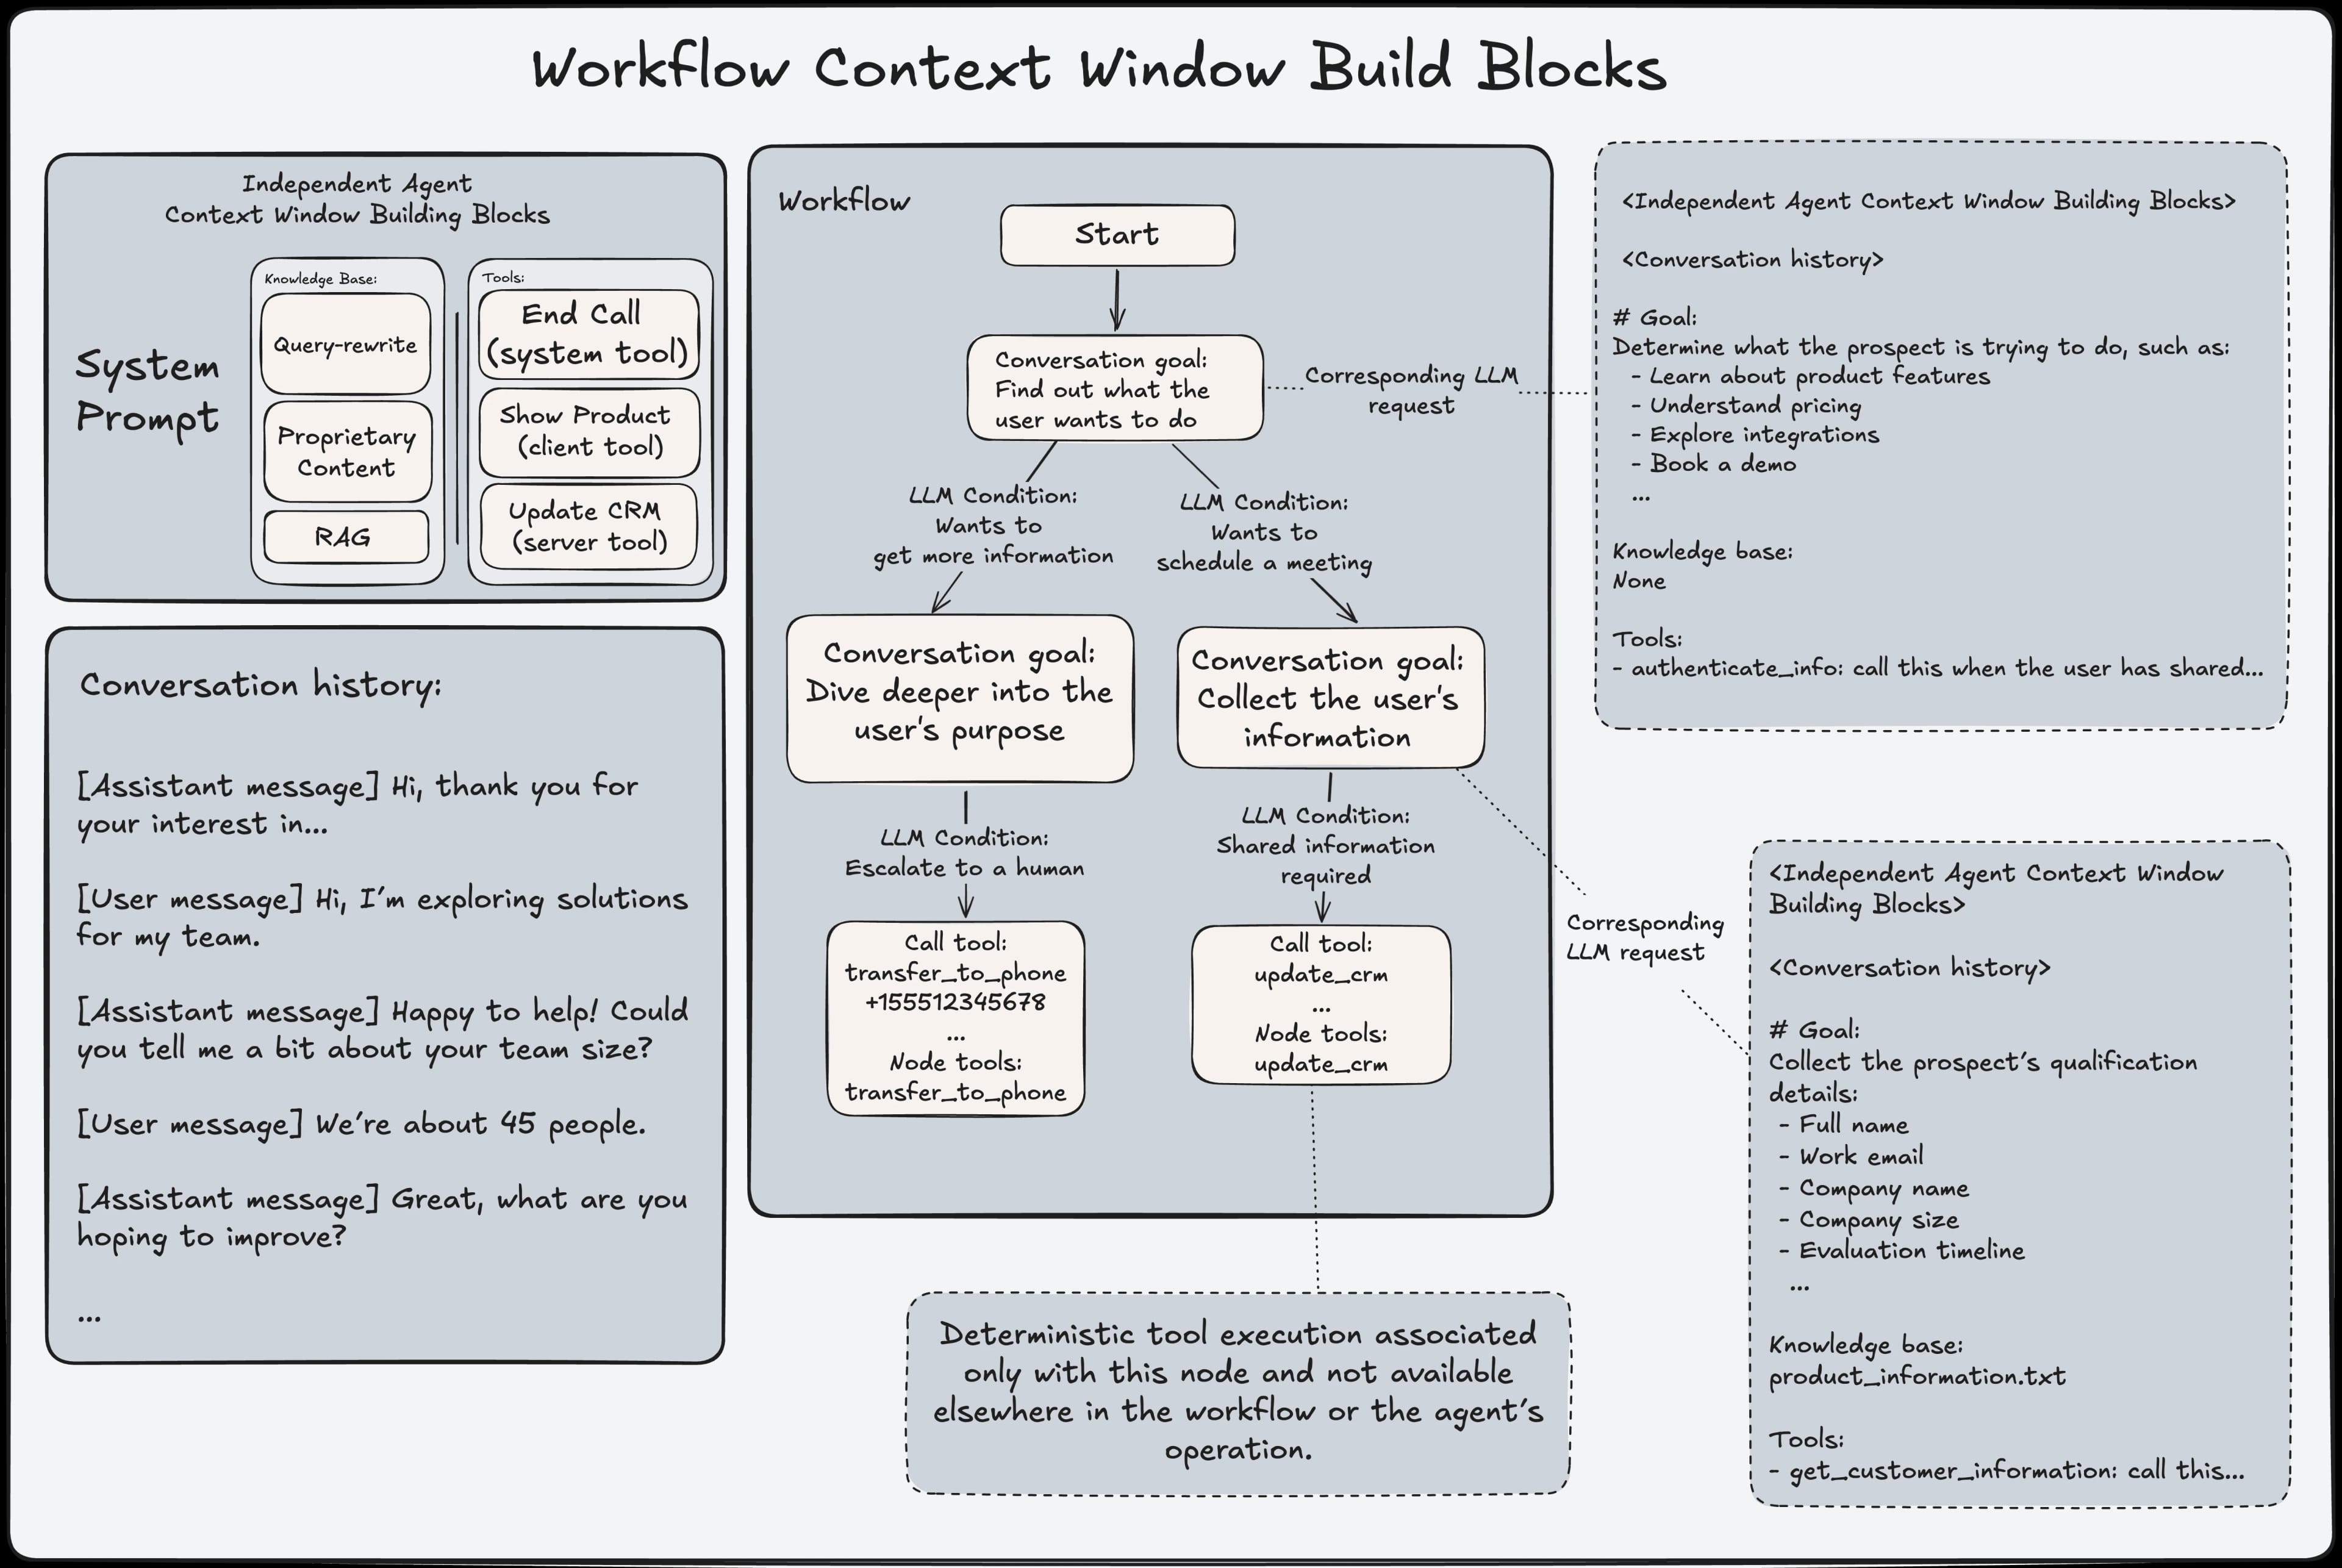
Além dessa base compartilhada, os Workflows introduzem subagentes especializados que operam em um grafo direcionado. Cada subagente recebe um objetivo de escopo restrito e complementa a configuração base com instruções adicionais de prompt, ferramentas e fontes de conhecimento relevantes apenas para sua função. Em vez de redefinir toda a configuração da conversa, os subagentes acrescentam sua intenção ao agente base por meio da composição de prompts e da extensão seletiva de contexto. Embora o histórico da conversa seja preservado nas transições entre subagentes para manter a continuidade, cada subagente opera com uma visão deliberadamente limitada do sistema. As bases de conhecimento e ferramentas são expostas seletivamente, criando silos claros que evitam vazamentos entre responsabilidades. Para reforçar esse isolamento, o objeto do orquestrador é reconstruído em cada transição como se fosse um agente independente. Isso garante que o estado do prompt, a configuração e os recursos disponíveis do subagente ativo permaneçam totalmente determinísticos. Esse design permite que os Workflows mantenham consistência global e ofereçam especialização local, resultando em comportamento previsível, clara separação de responsabilidades e controle preciso sobre como contexto, conhecimento e ações são aplicados em cada etapa de uma interação.
Um dos principais mecanismos que possibilitam esse controle é a forma como as transições entre subagentes são governadas.
Orientando transições de workflow com condições de LLM
Os Workflows avançam percorrendo um grafo direcionado de subagentes, em que as transições entre nós são controladas por condições explícitas. Essas condições determinam quando o controle deve passar de um subagente para outro e permitem que os workflows respondam à entrada do usuário, aos resultados de ferramentas e a variáveis dinâmicas. As condições do grafo podem ser determinísticas ou avaliadas por LLM. Condições determinísticas, como transições incondicionais, verificações baseadas em expressões de variáveis dinâmicas ou condições de resultado de ferramentas, oferecem fortes garantias sobre o fluxo de controle e são adequadas para impor uma progressão rigorosa em um workflow. Já as condições baseadas em LLM permitem a avaliação semântica de critérios em linguagem natural, como detectar a intenção do usuário ou reconhecer quando informações específicas foram fornecidas.
É importante destacar que as condições de LLM são avaliadas fora do prompt de sistema do agente ativo e não influenciam o comportamento de geração do agente. Em vez disso, são avaliadas em paralelo pelo orquestrador com base no estado atual da conversa. Essa separação garante que a lógica de transição não contamine o prompt do agente nem afete a forma como as respostas são geradas, ao mesmo tempo que permite aos workflows usar o raciocínio de LLM para percorrer o grafo com flexibilidade. Ao combinar condições determinísticas e avaliadas por LLM, os workflows podem alcançar previsibilidade e adaptabilidade, usando transições determinísticas quando a correção é essencial e transições baseadas em LLM quando é necessária interpretação semântica.
Quando uma conversa avança para uma nova etapa, o sistema ativa uma versão do agente adaptada especificamente àquele passo. Cada etapa opera com suas próprias instruções focadas e acesso somente ao conhecimento e às ferramentas relevantes para sua responsabilidade. Por exemplo, uma etapa de tratamento de reembolsos pode consultar políticas de reembolso sem herdar contexto não relacionado de onboarding ou triagem. A movimentação entre etapas é regida por condições explícitas de transição. Essas condições determinam quando a responsabilidade deve mudar e permitem que decisões de encaminhamento ocorram naturalmente à medida que a conversa se desenvolve. Para manter a continuidade, a experiência do usuário permanece fluida nas transições, e cada etapa herda o contexto de conversa relevante sem expor a mecânica da transferência. Mecanismos de proteção também monitoram as transições para evitar ciclos de encaminhamento improdutivos, garantindo que o workflow permaneça estável e orientado a objetivos.
Segurança e proteção
Para casos que exigem mais controles de segurança e proteção, os clientes podem contar com partes adicionais do orquestrador.
Proteções
Os Agentes da ElevenLabs implementam proteções de segurança por meio de um sistema configurável de moderação e alinhamento que avalia mensagens de usuários e agentes em tempo real. O conteúdo recebido é classificado em várias categorias de risco, incluindo conteúdo sexual, violência, assédio, ódio e automutilação, cada uma com limites configuráveis de forma independente. Quando uma proteção é acionada, a conversa é encerrada imediatamente e o cliente é notificado com um motivo claro para a falha. Isso garante que interações inseguras sejam bloqueadas cedo e de forma consistente, sem depender apenas de mitigações baseadas em prompts. As proteções operam fora da lógica de prompt do agente, fornecendo uma camada de aplicação confiável que não pode ser contornada pelo comportamento do modelo ou pela entrada do usuário. Essa abordagem permite que os clientes ajustem a sensibilidade de segurança de acordo com seu domínio, mantendo uma aplicação determinística em tempo de execução.
Gerenciamento de dados em conformidade
Às vezes, as pessoas podem compartilhar informações confidenciais com um agente, sujeitas a requisitos rigorosos de armazenamento e processamento, como dados médicos que exigem tratamento em conformidade com a HIPAA. Para atender a esses casos de uso, oferecemos o Zero Retention Mode (ZRM) no nível do Agente ou do Workspace. Quando ativado, todos os dados de chamadas são processados apenas na memória e nunca gravados em armazenamento persistente. Após a conclusão da chamada e do processamento, nenhuma informação é retida pela ElevenLabs. Como resultado, transcrições, gravações de áudio e resultados de análise não ficam disponíveis no Dashboard de Agentes, e essa política se aplica tanto aos sistemas voltados ao cliente quanto aos logs internos. Embora os dados não sejam retidos, eles são processados durante a chamada, e quaisquer webhooks pós-chamada configurados receberão os resultados, permitindo que os clientes armazenem transcrições ou resultados de análise em seus próprios sistemas, se necessário.
Quando o ZRM está ativo, também garantimos que os subprocessadores não retenham dados ao restringir os LLMs disponíveis a provedores com compromissos contratuais que proíbem o treinamento com dados de clientes ou a retenção desses dados; atualmente, isso inclui modelos do Google Gemini e do Anthropic Claude. Clientes que desejarem usar outro LLM sob o ZRM poderão fazê-lo firmando seu próprio acordo com esse provedor e configurando-o como um LLM personalizado usando chaves de API abrangidas por esse acordo. Como isso estende o tratamento de dados além do nosso limite de confiança padrão, nossa equipe de Segurança precisa analisar e aprovar manualmente o caso de uso antes de habilitá-lo. Embora o ZRM garanta que a ElevenLabs e seus subprocessadores não retenham dados de chamadas, os clientes continuam responsáveis por garantir que quaisquer ferramentas externas ou webhooks usados por seu Agente cumpram os requisitos aplicáveis de retenção e regulamentação.
O que vem por aí
Neste artigo, exploramos como os Agentes da ElevenLabs gerenciam contexto de conversa, ferramentas, avaliações e workflows estruturados para oferecer experiências confiáveis e em tempo real em escala. À medida que os clientes implantam agentes em ambientes cada vez mais complexos, continuamos expandindo a flexibilidade do nosso mecanismo de orquestração, com modelos de avaliação configuráveis, controles de transição mais robustos e maior observabilidade sobre a composição de prompts e o uso de tokens entre as etapas.
Nossa equipe de Engenharia de Implantação Avançada trabalha em parceria próxima com os clientes para garantir que esses recursos evoluam em sintonia com implantações no mundo real. A próxima geração de Agentes oferecerá ainda mais transparência, determinismo e adaptabilidade, sem comprometer o desempenho de baixa latência que torna possível a conversa em tempo real.


