Como projetamos o RAG para ser 50% mais rápido
- Escrito por
- Michal Korbela
- Publicado
- Última atualização
OuvirOuça este artigo
O RAG melhora a precisão dos agentes de IA ao fundamentar as respostas dos LLMs em grandes bases de conhecimento. Em vez de enviar toda a base de conhecimento ao LLM, o RAG transforma a consulta em embedding, recupera as informações mais relevantes e as fornece como contexto ao modelo. Em nosso sistema, primeiro adicionamos uma etapa de reformulação da consulta, que condensa o histórico do diálogo em uma consulta precisa e autossuficiente antes da recuperação.
Para bases de conhecimento muito pequenas, pode ser mais simples incluir tudo diretamente no prompt. Mas, quando a base de conhecimento cresce, o RAG se torna essencial para manter respostas precisas sem sobrecarregar o modelo.
Muitos sistemas tratam o RAG como uma ferramenta externa, mas nós o integramos diretamente ao pipeline de solicitações para que seja executado em cada consulta. Isso garante uma precisão consistente, mas também cria um risco de latência.
Por que a reformulação de consultas nos deixou mais lentos
A maioria das solicitações dos usuários faz referência a interações anteriores, então o sistema precisa condensar o histórico do diálogo em uma consulta precisa e autossuficiente.
Por exemplo:
- Se o usuário perguntar: “Podemos personalizar esses limites com base nos nossos padrões de pico de tráfego?”
- O sistema reformula para: “Os limites de taxa da API do plano Enterprise podem ser personalizados para padrões de tráfego específicos?”
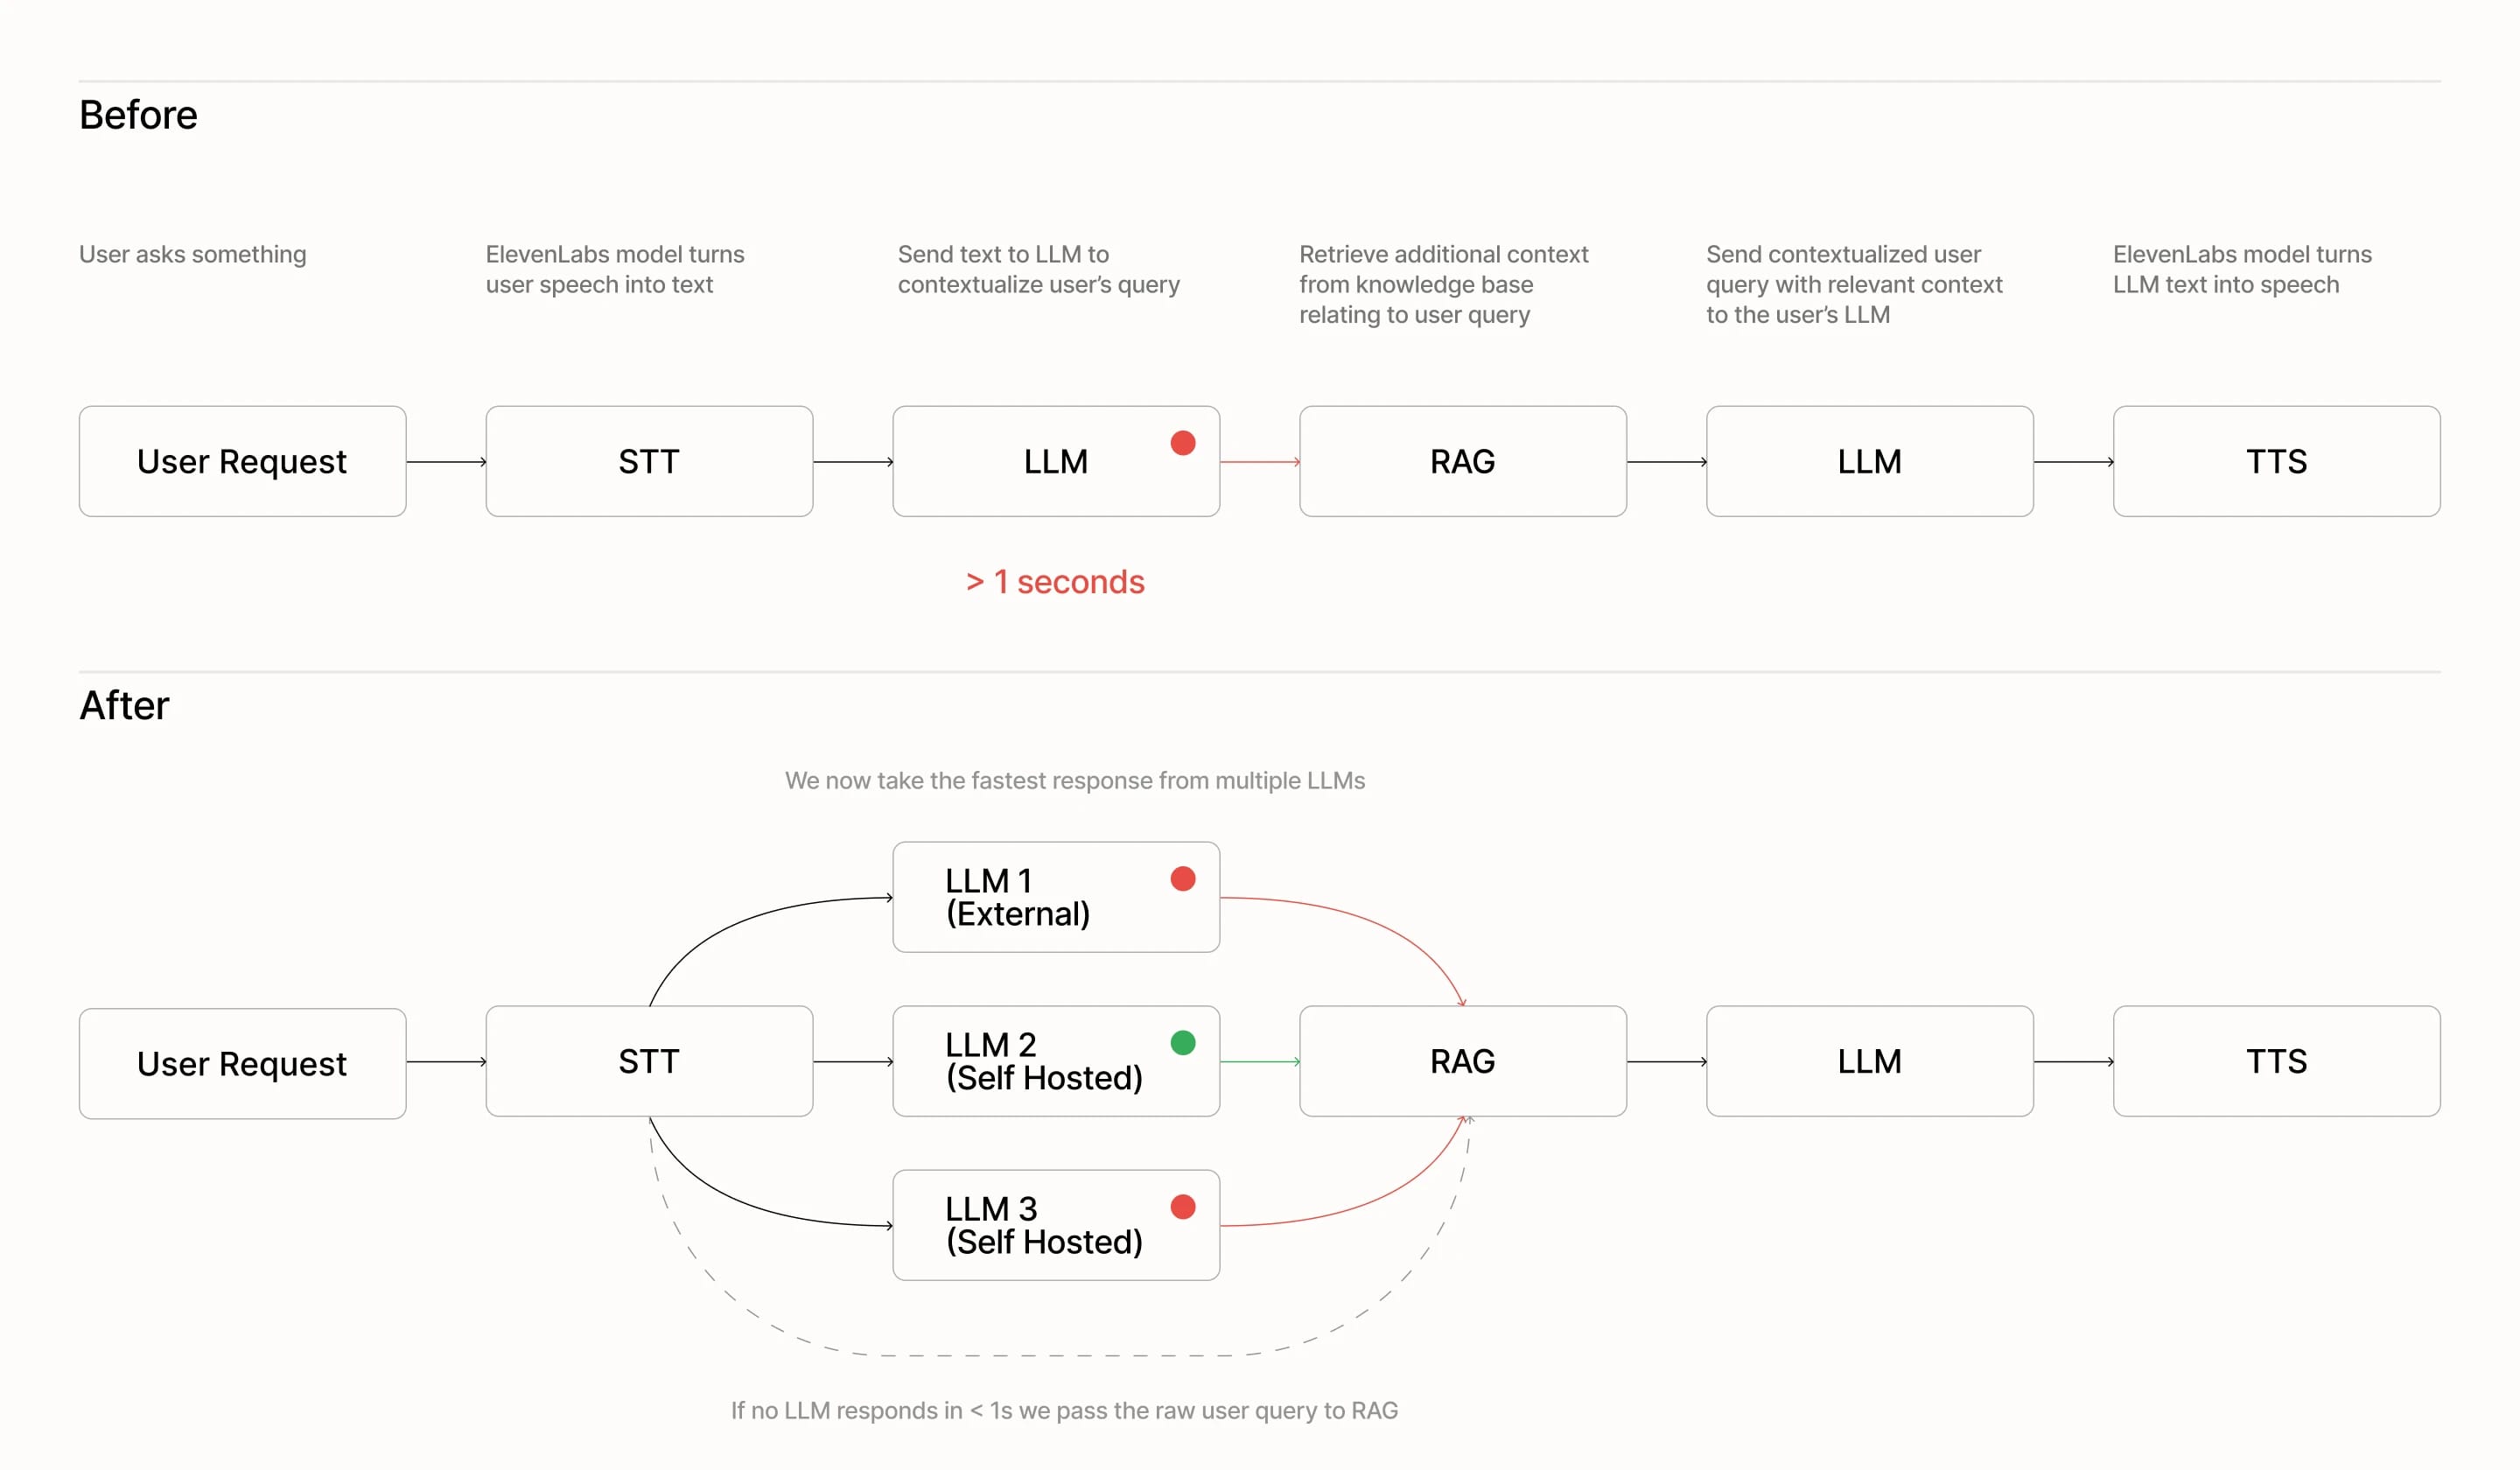
A reformulação transforma referências vagas, como “esses limites”, em consultas autossuficientes que os sistemas de recuperação podem usar, melhorando o contexto e a precisão da resposta final. Mas depender de um único LLM hospedado externamente criou uma forte dependência da sua velocidade e disponibilidade. Só essa etapa representava mais de 80% da latência do RAG.
Como resolvemos isso com corrida de modelos
Redesenhamos a reformulação de consultas para funcionar como uma corrida:
- Vários modelos em paralelo. Cada consulta é enviada simultaneamente a vários modelos, incluindo nossos modelos Qwen 3-4B e 3-30B-A3B hospedados por nós. A primeira resposta válida vence.
- Fallbacks que mantêm as conversas fluindo. Se nenhum modelo responder em um segundo, usamos a mensagem original do usuário. Ela pode ser menos precisa, mas evita interrupções e garante a continuidade.
O impacto no desempenho
Essa nova arquitetura reduziu pela metade a latência mediana do RAG, de 326 ms para 155 ms. Diferentemente de muitos sistemas que acionam o RAG seletivamente como uma ferramenta externa, nós o executamos em todas as consultas. Com a latência mediana reduzida para 155 ms, a sobrecarga dessa operação é insignificante.
Latência antes e depois:
- Mediana: 326 ms → 155 ms
- p75: 436 ms → 250 ms
- p95: 629 ms → 426 ms
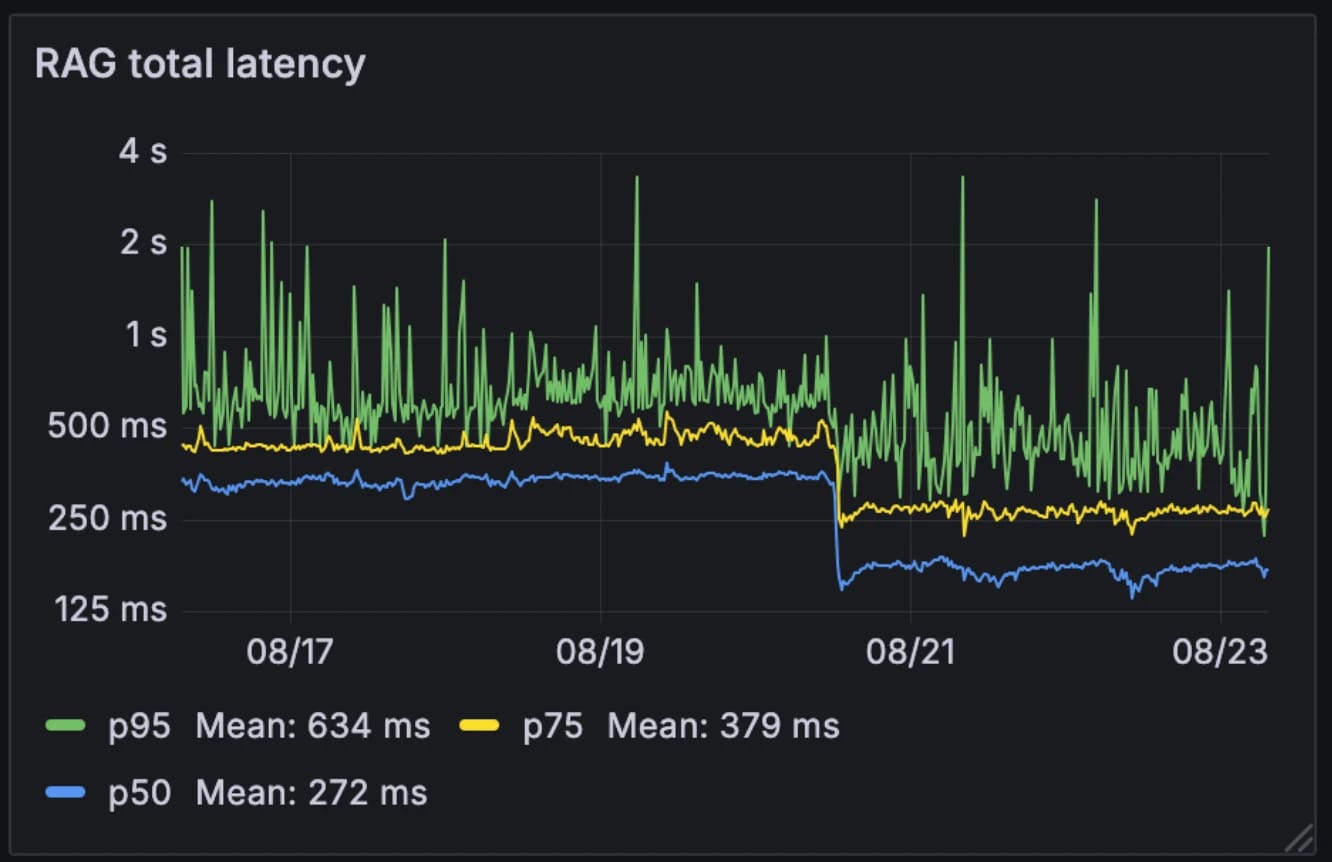
A arquitetura também tornou o sistema mais resiliente à variabilidade dos modelos. Embora modelos hospedados externamente possam ficar mais lentos nos horários de pico, nossos modelos internos permanecem relativamente consistentes. Colocar os modelos para competir reduz essa variabilidade, transformando o desempenho individual imprevisível dos modelos em um comportamento de sistema mais estável.
Por exemplo, quando um dos nossos provedores de LLM teve uma indisponibilidade no mês passado, as conversas continuaram sem interrupções em nossos modelos hospedados por nós. Como já operamos essa infraestrutura para outros serviços, o custo adicional de computação é insignificante.
Por que isso importa
A reformulação de consultas RAG em menos de 200 ms elimina um grande gargalo para agentes conversacionais. O resultado é um sistema que mantém o contexto e opera em tempo real, mesmo ao trabalhar com grandes bases de conhecimento corporativas. Com a sobrecarga da recuperação reduzida a níveis quase insignificantes, os agentes conversacionais podem escalar sem comprometer o desempenho.