Taxa de erro de palavras (WER): conceitos-chave, fórmula e usos
- Escrito por
- Jack Limebear
- Publicado
- Última atualização
OuvirOuça este artigo
Em teoria, a taxa de erro de palavras (WER) é uma métrica para determinar a precisão de uma ferramenta de Reconhecimento Automático de Fala (ASR). Uma WER baixa significa que sua transcrição final é mais precisa, enquanto uma taxa de erro mais alta indica informações transcritas incorretamente.
Na prática, a WER pode ser a diferença entre um software de transcrição médica que registra que um paciente precisa de ‘quinze miligramas’ em vez de ‘cinquenta miligramas’ de um medicamento. É a diferença entre uma ferramenta de suporte que transcreve com precisão as necessidades de um cliente e outra que deixa seu usuário frustrado.
Neste artigo, vamos explicar o que é WER, como calculá-la e como usá-la para comparar seu próprio provedor de ASR.
Resumo
- A taxa de erro de palavras contabiliza três tipos de erro: substituições, exclusões e inserções, divididos pelo número de palavras na transcrição de referência.
- A fórmula da WER é WER = (S + D + I) / N.
- Pontuações de WER menores significam que o resultado final é mais preciso.
- Uma WER abaixo de 5% é uma boa referência, embora transcrições jurídicas ou médicas possam exigir uma taxa de erro de palavras ainda menor.
- A WER trata todos os erros como iguais, o que significa que não é uma métrica perfeita para avaliar o contexto. Métricas emergentes, como a Taxa de Erro de Palavras Semântica (SWER), tentam resolver isso ao medir se o significado de uma fala foi preservado.
O que é taxa de erro de palavras?
A taxa de erro de palavras (WER) é a métrica padrão para medir a precisão do reconhecimento de fala em modelos de Speech to Text. Ela é representada de 0 a 1 (0,8 representaria uma taxa de erro de 80%) e indica o que um sistema de STT erra ao transcrever, considerando substituições, exclusões e inserções.
Uma substituição ocorre quando uma palavra é trocada por outra incorreta. Uma exclusão ocorre quando uma palavra é totalmente omitida. Por fim, uma inserção ocorre quando a transcrição inclui uma palavra que nunca foi dita. A WER usa esses três componentes e os divide pelo número de palavras na transcrição correta, gerando um número que você pode usar para comparar diferentes fornecedores.
Veja a fórmula da WER:
WER = (S + D + I) / N
Em que:
- S: Substituições (a palavra está errada)
- D: Exclusões (a palavra está ausente)
- I: Inserções (há uma palavra adicional)
- N: Total de palavras na transcrição de referência
Você pode expressar a WER como decimal ou porcentagem. Quanto menor a WER, melhor a pontuação, pois o modelo cometeu menos erros na transcrição.
Na prática, uma WER de 10% significa que aproximadamente 1 em cada 10 palavras da transcrição da sua reunião precisa ser revisada.
Por que a taxa de erro de palavras é importante em sistemas de reconhecimento de fala?
A taxa de erro de palavras oferece uma métrica objetiva que as equipes podem usar para comparar diferentes provedores. Ela vai além de promessas de marketing e mostra claramente o nível de precisão de um modelo de reconhecimento de fala. Ao se basear em evidências, qualquer empresa que esteja avaliando opções consegue ver quais modelos lideram atualmente esse segmento.
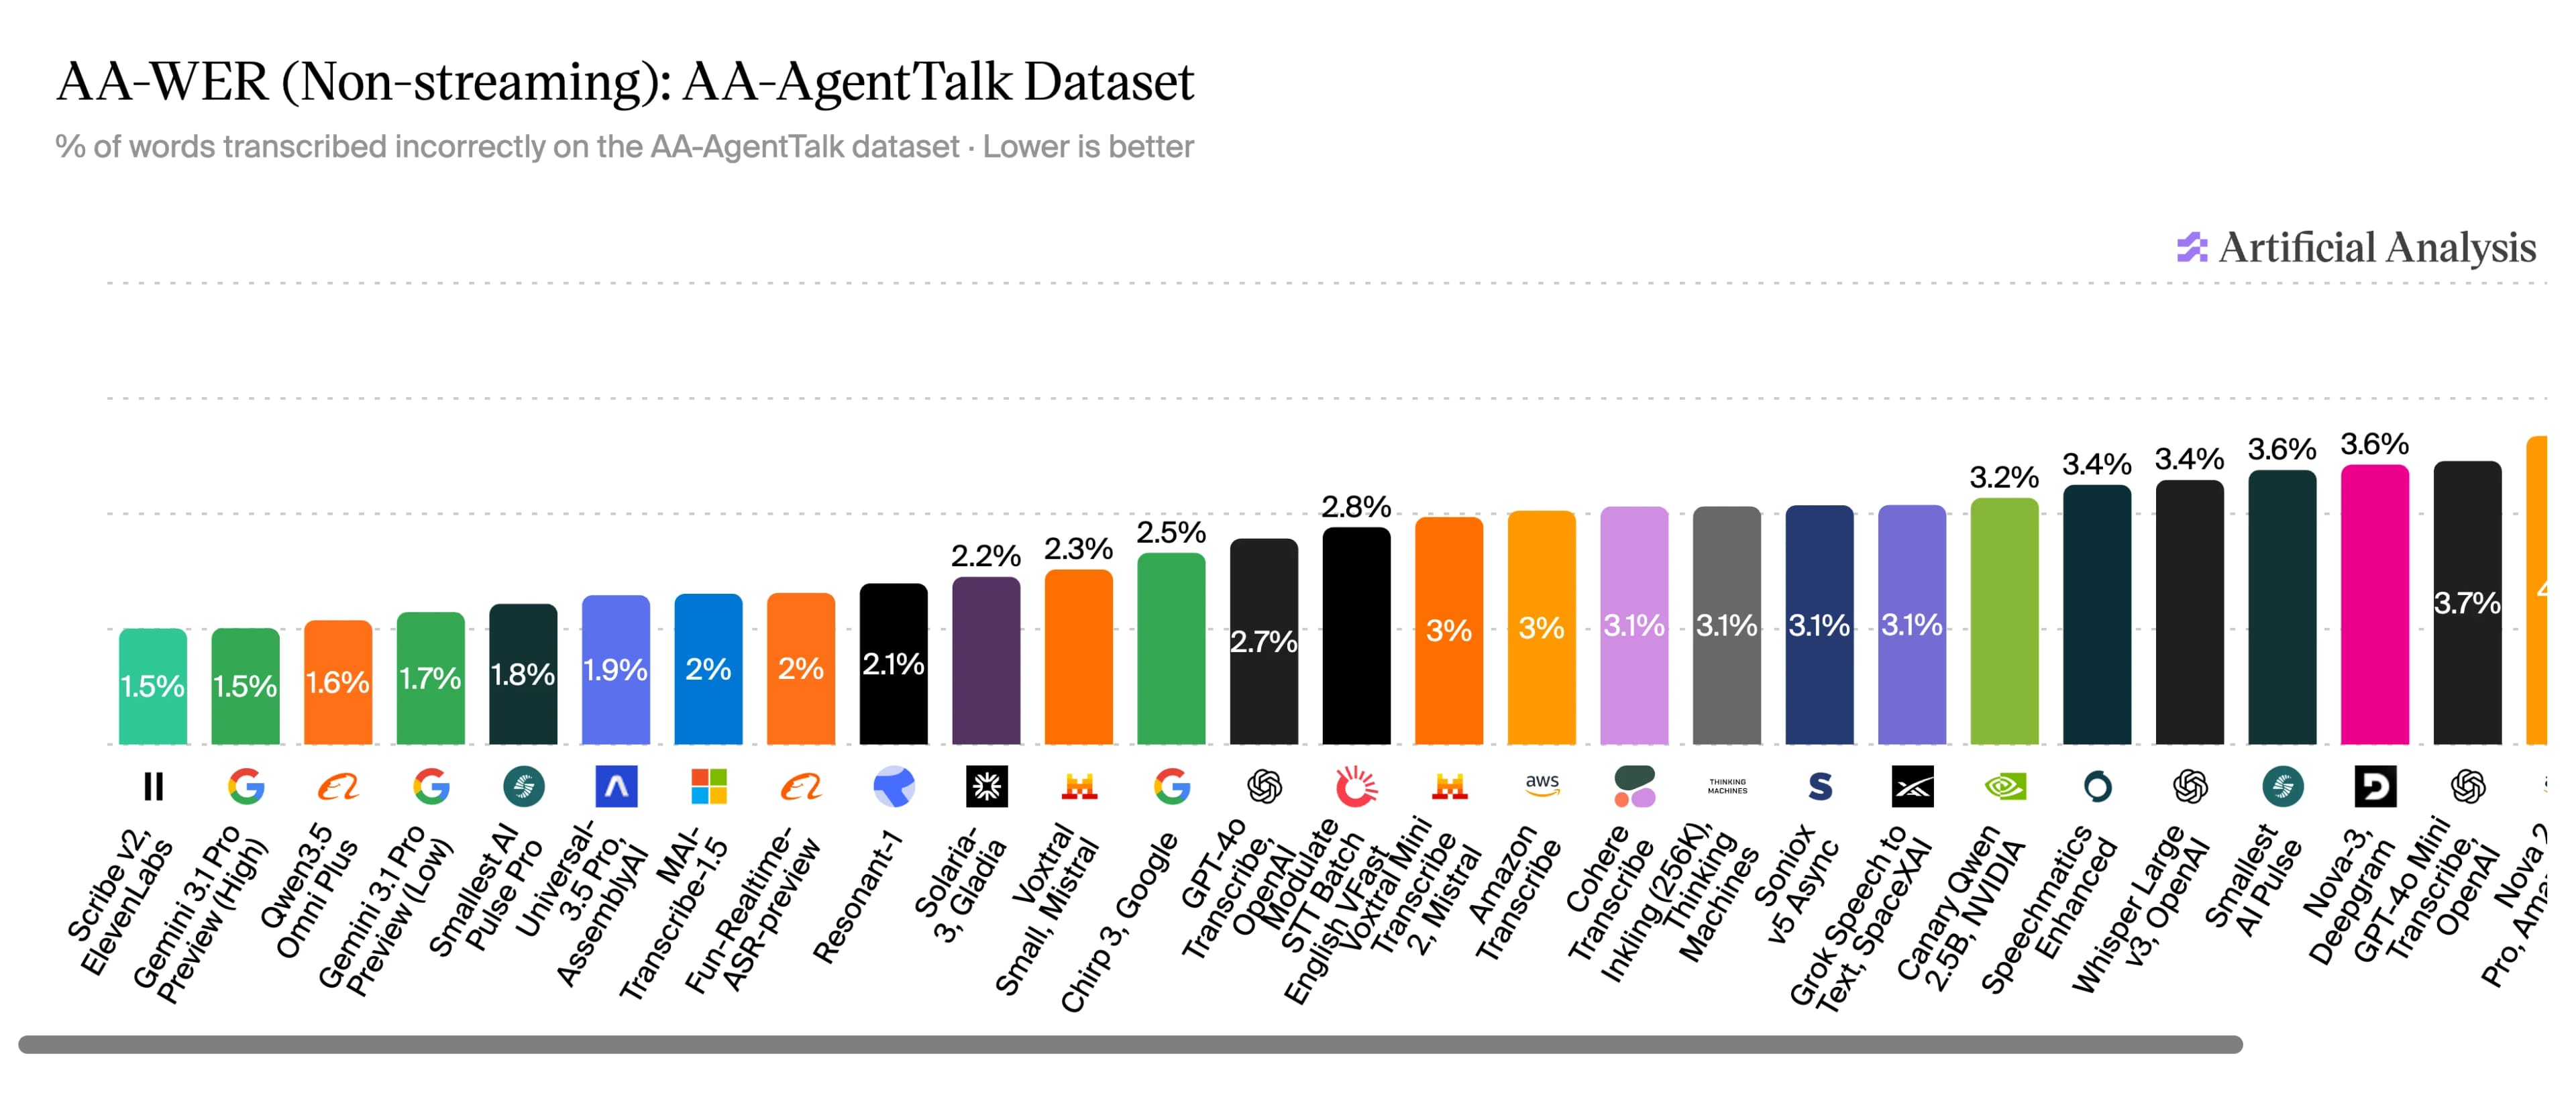
Fonte: Artificial Analysis acessado em 10 de julho de 2026.
Em julho de 2026, uma pesquisa independente da Artificial Analysis classificou o Scribe v2 da ElevenLabs como o modelo com a menor WER do setor no conjunto de dados AA-AgentTalk para modelos de transcrição sem streaming, com uma WER de 1,5%.
Além da avaliação de fornecedores, a WER tem impacto real nos produtos. Um software de transcrição médica com WER de 12% pode introduzir erros críticos em prontuários de pacientes. Transcrições incorretas em uma chamada de suporte ao cliente podem levar a falhas posteriores, como análise de sentimento imprecisa ou categorização inadequada.
Além desses problemas específicos de cada caso de uso, quando sistemas de ASR falham, as pessoas mais afetadas geralmente são aquelas para quem a transcrição é a única forma de acessar conteúdo falado. O World Wide Web Consortium oferece documentação extensa sobre os padrões mínimos esperados por iniciativas de acessibilidade para mais contexto.
Como calcular a taxa de erro de palavras: fórmula e exemplo
Calcular a taxa de erro de palavras é simples depois que você conhece as etapas. Como vimos acima, a fórmula usada é WER = (S + D + I) / N. Todos os termos foram descritos acima, mas, como referência rápida, são substituições, exclusões, inserções e N para o total de palavras na transcrição.
Veja como calcular a WER:
- Crie uma transcrição de referência: Use transcrição e verificação humanas para produzir uma transcrição precisa de um clipe de áudio.
- Use sua ferramenta de STT: Use uma plataforma de ASR para transcrever o clipe de áudio e gerar uma transcrição por IA que será usada no teste.
- Alinhe as duas versões: Use programação dinâmica — especificamente, o algoritmo de Levenshtein — para encontrar o número mínimo de edições. Vamos explicar melhor esse algoritmo em uma seção posterior.
- Aplique a fórmula: Conte o número total de erros na versão gerada por IA em comparação com a cópia verificada por humanos e use WER = (S + D + I) / N para calcular a WER exata.
Isso pode parecer bastante técnico no papel, mas na prática é bem mais simples. Veja um exemplo para entender melhor.
Transcrição de referência: A Sra. Dalloway disse que ela mesma compraria as flores.
Resultado do ASR: A Srta. Dalloway disse que compraria flores.
Se calcularmos o total de erros, teremos 1 S e 1 D em um total de 9 palavras.
Usando a fórmula, temos: WER = 2 / 9 = 0,222 = 22,2%.
Como calcular a taxa de erro de palavras com Python
Embora o método manual funcione muito bem, você pode economizar tempo calculando a WER com Python. A biblioteca jiwer faz tudo isso de forma totalmente automática.
Usando a documentação do jiwer, você pode instalar o pacote, criado especificamente para avaliar um sistema de ASR e gerar métricas essenciais como a WER. Depois de baixá-lo, você pode usar o código abaixo para calcular rapidamente a WER com Python:
Observe que, neste exemplo, o resultado do ASR difere da referência original em dois pontos. A palavra ‘jumps’ foi transcrita incorretamente como ‘leaps’ (uma substituição), e ‘last’ foi inserida antes de ‘lazy’ (uma inserção). Com dois erros nas nove palavras da transcrição de referência, o resultado é uma Taxa de Erro de Palavras (WER) de 0,222 ou 22,2%.
Comparando a taxa de erro de palavras com outras métricas de reconhecimento
Embora a WER seja a métrica padrão para calcular a precisão em um ASR, há outras ferramentas que você pode usar. Por exemplo:
- Taxa de Erro de Caracteres (CER): Assim como a WER, mede a precisão da transcrição no nível dos caracteres, e não das palavras. É ideal para idiomas sem limites claros entre palavras (scriptio continua) ou tarefas sensíveis à ortografia.
- Taxa de Erro de Correspondência (MER): Mede a proporção de erros de transcrição, tratando substituições, inserções e exclusões de forma ligeiramente diferente da WER. Foca na proporção de erros em uma frase.
- Informação de Palavras Perdida (WIL): Uma estimativa de quanto da informação original foi perdida durante a transcrição, oferecendo uma medida de inteligibilidade em vez da contagem direta de erros da WER.
- Taxa de Erro de Embedding (EmbER): Oferece uma análise semântica entre as transcrições. Vai além da WER para mostrar a distância semântica entre a palavra correta e a transcrição incorreta.
Cada uma dessas métricas é mais adequada para um cenário diferente. Veja uma tabela de referência:
Exemplos de distância de Levenshtein: a matemática por trás da WER
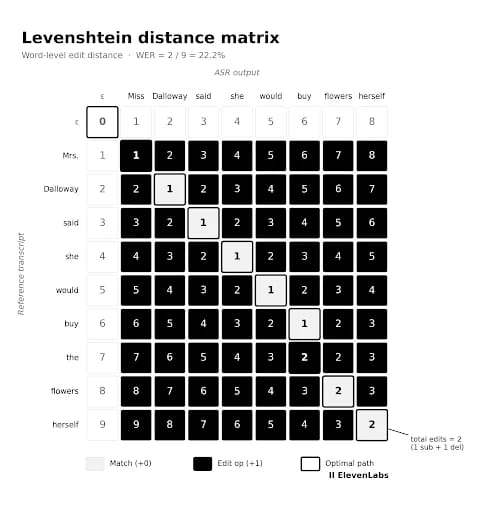
A taxa de erro de palavras é, na verdade, uma medida da distância entre o resultado original e o resultado hipotético. Para entender essa diferença matematicamente, usamos a distância de Levenshtein.
A distância de Levenshtein conta o número mínimo de edições de uma única unidade necessárias para transformar uma sequência em outra. No caso da WER, isso significa especificamente edições de substituições, inserções e exclusões. Por exemplo, para transformar Cat em Mat, seria preciso trocar a letra ‘C’ pela ‘M’, resultando em uma distância de Levenshtein de 1.
Embora isso apareça com mais frequência em cálculos de CER, a WER aplica a distância de Levenshtein ao nível das palavras. Cada unidade é uma palavra inteira, em vez de um caractere, e a distância real mede quantas edições de palavras seriam necessárias para transformar nosso resultado de ASR no original correto.
Criamos uma matriz em que cada célula representa a distância total entre a transcrição original e a transcrição do ASR. A distância de Levenshtein preenche a matriz do canto superior esquerdo ao inferior direito, e a célula final mostra o número total de edições no nível das palavras. Ao dividir esse número por N, você obtém a WER.
Embora essa matriz geralmente seja calculada com caracteres individuais, aqui está uma versão ampliada do exemplo anterior para simplificar.
Erros e equívocos comuns sobre a taxa de erro de palavras
Especialmente à medida que as APIs de STT se tornam mais acessíveis e o software de ASR passa a fazer parte de stacks mais amplas de agentes, veremos muitas comparações entre ferramentas diferentes.
Antes de calcular suas próprias taxas de erro de palavras, há alguns problemas e equívocos comuns que você precisa entender.
- Todos os erros são iguais: A WER considera todos os erros igualmente relevantes. Embora isso possa ser aceitável em muitos contextos, em alguns casos de uso não é. Por exemplo, em um hospital, uma taxa de erro de 5%, considerada uma boa WER, ainda pode ser inaceitável, pois um ou dois erros podem colocar um paciente em risco. Essa limitação levou ao desenvolvimento de métricas mais recentes, como a Taxa de Erro de Palavras Semântica (SWER), que busca medir se o sentido de uma frase foi preservado, em vez de verificar se todas as palavras correspondem exatamente.
- A WER pode ultrapassar 100%: Embora tenhamos dito anteriormente que a WER varia entre 0 e 1, ainda é possível encontrar uma WER acima de 100%. Isso acontece porque o erro de inserção pode criar mais palavras do que o total da transcrição original. Um exemplo comum é transcrever ‘I’m’ como ‘I am’, em que uma palavra se torna duas.
- Tecnicamente, uma WER menor nem sempre é melhor: No papel, uma WER de 5% é melhor do que uma WER de 10%. Mas, se os erros que contribuíram para esses 5% alteraram significativamente o contexto de uma frase, enquanto os dos 10% não alteraram, a história completa não está representada. O contexto continua sendo muito importante, e métricas como a SWER estão sendo desenvolvidas especificamente para captar esse impacto semântico.
Em 2024, a Apple publicou um estudo interessante que explorou o último ponto acima. Quando pessoas avaliaram um cálculo de WER de 9,4% considerando se o ASR era legível ou não, elas atribuíram à mesma passagem uma WER de apenas 2,2%. No exemplo testado, as pessoas consideraram os ‘erros’ irrelevantes em muitos casos, resultando em uma WER humana mais de 4 vezes mais tolerante que a das máquinas.
Referências de WER por setor
A WER ideal depende muito do setor ou caso de uso em que você utiliza a tecnologia de ASR. Embora <5% seja uma referência do setor para WER, áreas específicas, como transcrição médica ou jurídica, precisam de uma taxa muito menor.
No estudo de julho de 2026 da Artificial Analysis, o Scribe v2 da ElevenLabs alcançou uma WER de 1,5%. No entanto, é importante lembrar que essas estatísticas geralmente são realizadas tendo o inglês como idioma principal. A tecnologia de STT pode não ser tão eficaz em outros idiomas.
A documentação da ElevenLabs detalha as faixas gerais de WER em todos os idiomas compatíveis com o Scribe v1 e o Scribe v2.
Comece a usar a ElevenAPI para aumentar a precisão do reconhecimento
Ao desenvolver um aplicativo ou produto em que a qualidade da transcrição importa, a diferença entre uma API de ASR bem escolhida e uma mediana aparece primeiro na sua WER e depois na experiência dos seus usuários.
O ElevenLabs Scribe é a camada de Speech to Text acessível pela ElevenAPI. Além de mais de 90 idiomas e uma WER líder no setor, ele oferece recursos como diarização de locutores, marcas de tempo por palavra, prompts de termos-chave e detecção de entidades.
Explore a documentação da ElevenLabs para saber mais sobre a ElevenAPI ou comece criando sua conta hoje.