Como transcrever uma entrevista: transcrições precisas com identificação de locutores
- Escrito por
- Jack Limebear
- Publicado
OuvirOuça este artigo
Transcrever uma entrevista manualmente leva horas de trabalho. Quando você tem o prazo de um artigo ou trabalha em uma pesquisa com prazo apertado, talvez não tenha essas horas extras na agenda. Ferramentas de Speech to Text com IA transcrevem entrevistas em minutos, liberando tempo para edição e análise.
Neste guia, vamos mostrar como transcrever uma entrevista com precisão usando IA. Também vamos explorar ferramentas, estilos e formatação para ajudar você a transformar cada entrevista em áudio em uma transcrição escrita útil.
Resumo
- Transcrições de entrevistas geralmente precisam atender a padrões rigorosos de precisão para jornalismo ou pesquisa acadêmica.
- A transcrição no modo literal registra tudo o que foi dito na entrevista, incluindo repetições e palavras de preenchimento.
- Para evitar erros na identificação de locutores, use a transcrição multicanal com um microfone separado para cada pessoa. Esse recurso transcreve o áudio de cada pessoa separadamente, garantindo a identificação correta mesmo quando há falas sobrepostas.
- Eventos de áudio, como risadas, suspiros ou aplausos, acrescentam contexto à gravação de uma entrevista. O Speech to Text do ElevenCreative os marca por padrão, mas você pode desativar a configuração “marcar eventos de áudio” se não precisar deles.
- Se sua entrevista incluir nomes de pessoas, empresas ou jargões do setor, use o keyterm prompting para esclarecer a grafia antes de iniciar a transcrição.
O que diferencia a transcrição de entrevistas das transcrições de reuniões ou chamadas
Entrevistadores, seja no jornalismo ou na pesquisa acadêmica, precisam extrair citações diretas de suas transcrições. Quando as entrevistas duram uma hora ou mais, a transcrição manual não é viável, especialmente quando você precisa de um alto nível de precisão.
Essas citações acabam em artigos, relatórios e referências publicados. A transcrição precisa registrar tudo o que é dito, sem alterar palavras ou cortar trechos.
Reuniões de negócios são diferentes. Elas costumam ser mais curtas, e a maioria das equipes precisa apenas dos pontos principais. Muitas usam ferramentas que resumem a reunião em vez de produzir um registro palavra por palavra.
Se você está escolhendo um software de transcrição de entrevistas, a precisão deve vir em primeiro lugar, mas não deve ser o único item da sua lista. Estes são os recursos mais importantes.
Literal ou limpa: escolhendo o estilo da sua transcrição
Ao transcrever suas entrevistas, você pode escolher entre dois estilos: literal ou limpo.
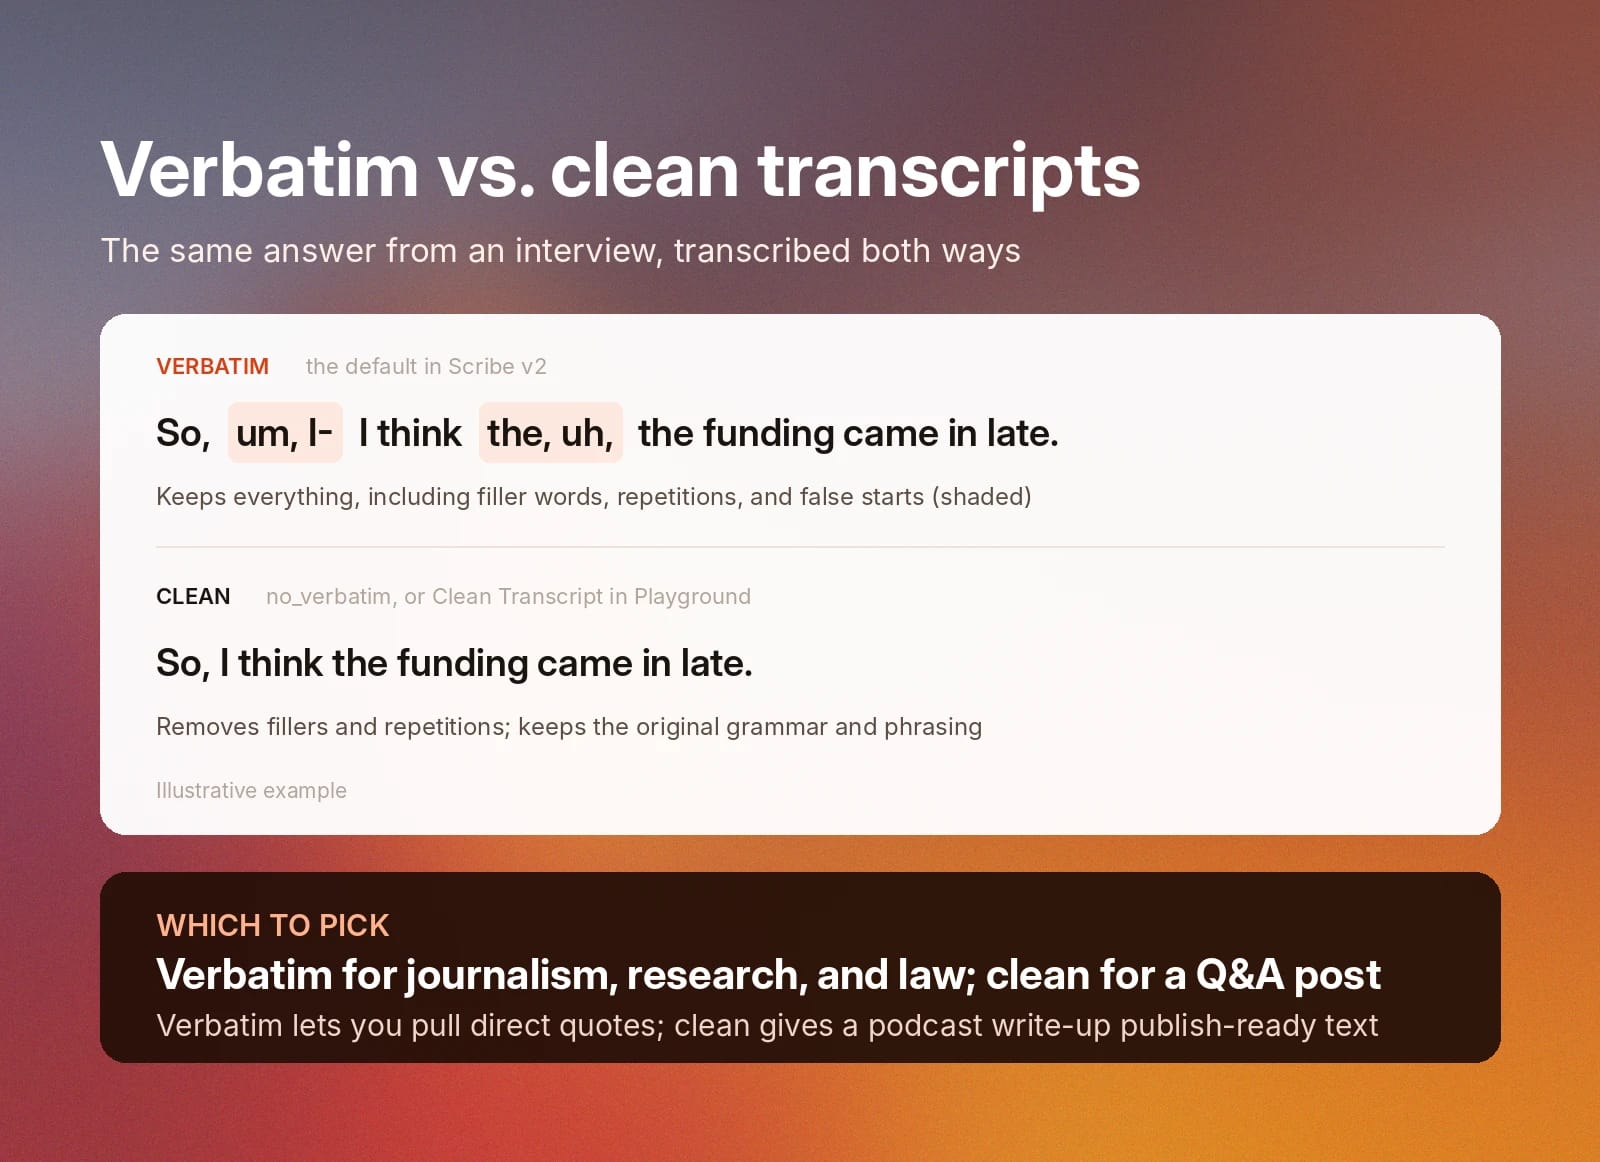
Uma transcrição literal registra cada palavra e expressão da conversa, sem alterar ou remover nada. Isso inclui repetições, começos falsos e palavras de preenchimento como “é” ou “ahn”.
Uma transcrição limpa remove palavras de preenchimento e repetições, mas mantém a gramática e a formulação originais. Transcrições limpas melhoram a legibilidade e preservam a intenção original da conversa.
Para a maioria das entrevistas, as transcrições literais são a melhor opção. Como preservam toda a conversa, atendem aos rigorosos padrões de precisão exigidos no jornalismo, na pesquisa acadêmica ou no direito.
No entanto, há situações em que a transcrição limpa é adequada para entrevistas. Digamos que você tenha feito uma entrevista para seu podcast e queira transformá-la em uma publicação de perguntas e respostas no blog do seu site. Nesse caso, a transcrição limpa gera resultados prontos para publicação.
Speech to Text do ElevenCreative oferece suporte à transcrição literal e limpa no ElevenLabs Playground e na ElevenAPI, usando o modelo Scribe v2. As transcrições literais são o padrão, mas você pode criar transcrições limpas ativando Clean Transcript/No Verbatim no painel de configurações do Playground ou habilitando o parâmetro no_verbatim na ElevenAPI.
Como acertar a identificação dos locutores
Na transcrição de entrevistas, a identificação dos locutores deixa claro quem disse o quê. Uma identificação incorreta pode resultar em atribuição imprecisa de citações, por isso é importante acertar.
As ferramentas de Speech to Text com IA têm dois métodos para identificar locutores. O método usado depende de como você grava suas entrevistas.
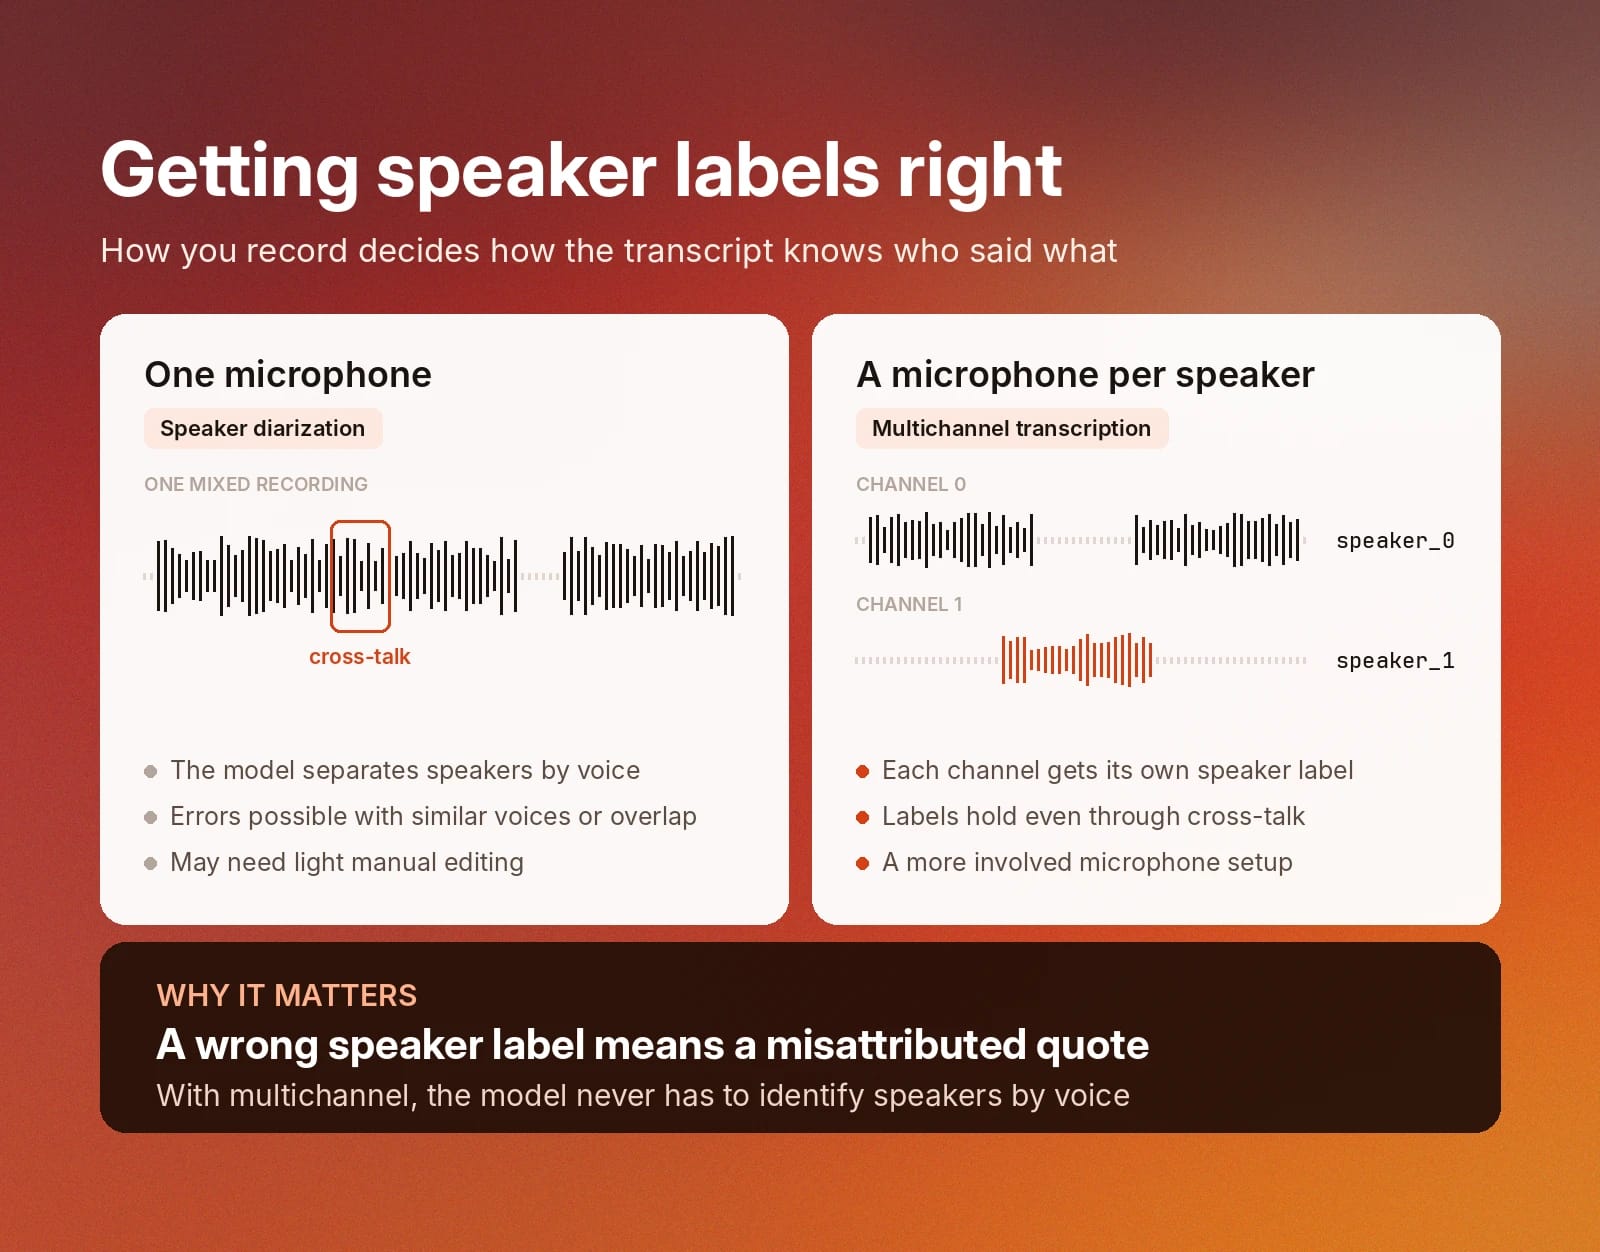
Se você usa um único microfone para gravar as duas pessoas, o modelo de transcrição usa diarização integrada para identificá-las, separá-las e rotulá-las automaticamente. Modelos que usam diarização podem cometer erros, especialmente se os locutores tiverem vozes parecidas ou falarem ao mesmo tempo.
Se cada pessoa tiver seu próprio microfone, você poderá usar a transcrição multicanal para garantir a precisão na identificação dos locutores. Com esse método de transcrição, cada canal de áudio recebe sua própria identificação de locutor na transcrição.
A transcrição multicanal exige uma configuração de microfones mais complexa do que usar uma única gravação para as duas pessoas. No entanto, ela oferece uma identificação de locutores mais clara e precisa. Como cada pessoa tem um canal pré-configurado, o modelo de transcrição não precisa identificá-las pela voz.
Como lidar com falas sobrepostas e interrupções
A identificação dos locutores nem sempre é simples. É normal que as pessoas falem ao mesmo tempo ou se interrompam durante uma conversa.
Ao transcrever uma entrevista para jornalismo ou pesquisa acadêmica, é essencial identificar corretamente falas sobrepostas e interrupções. Isso garante que cada citação seja atribuída à pessoa certa.
Se possível, use um microfone separado para cada pessoa e transcreva no modo multicanal. Nesse modo, cada pessoa é gravada e transcrita separadamente. Isso evita erros de identificação, mesmo quando elas falam ao mesmo tempo.
Se você estiver usando um único microfone na entrevista, o modelo de transcrição usará a diarização de locutores automatizada para identificar quem está falando em cada momento. Com essa abordagem, podem ocorrer erros de identificação, principalmente quando as pessoas falam ao mesmo tempo. A transcrição pode exigir uma leve edição manual para garantir a precisão.
Como capturar o tom ao transcrever entrevistas
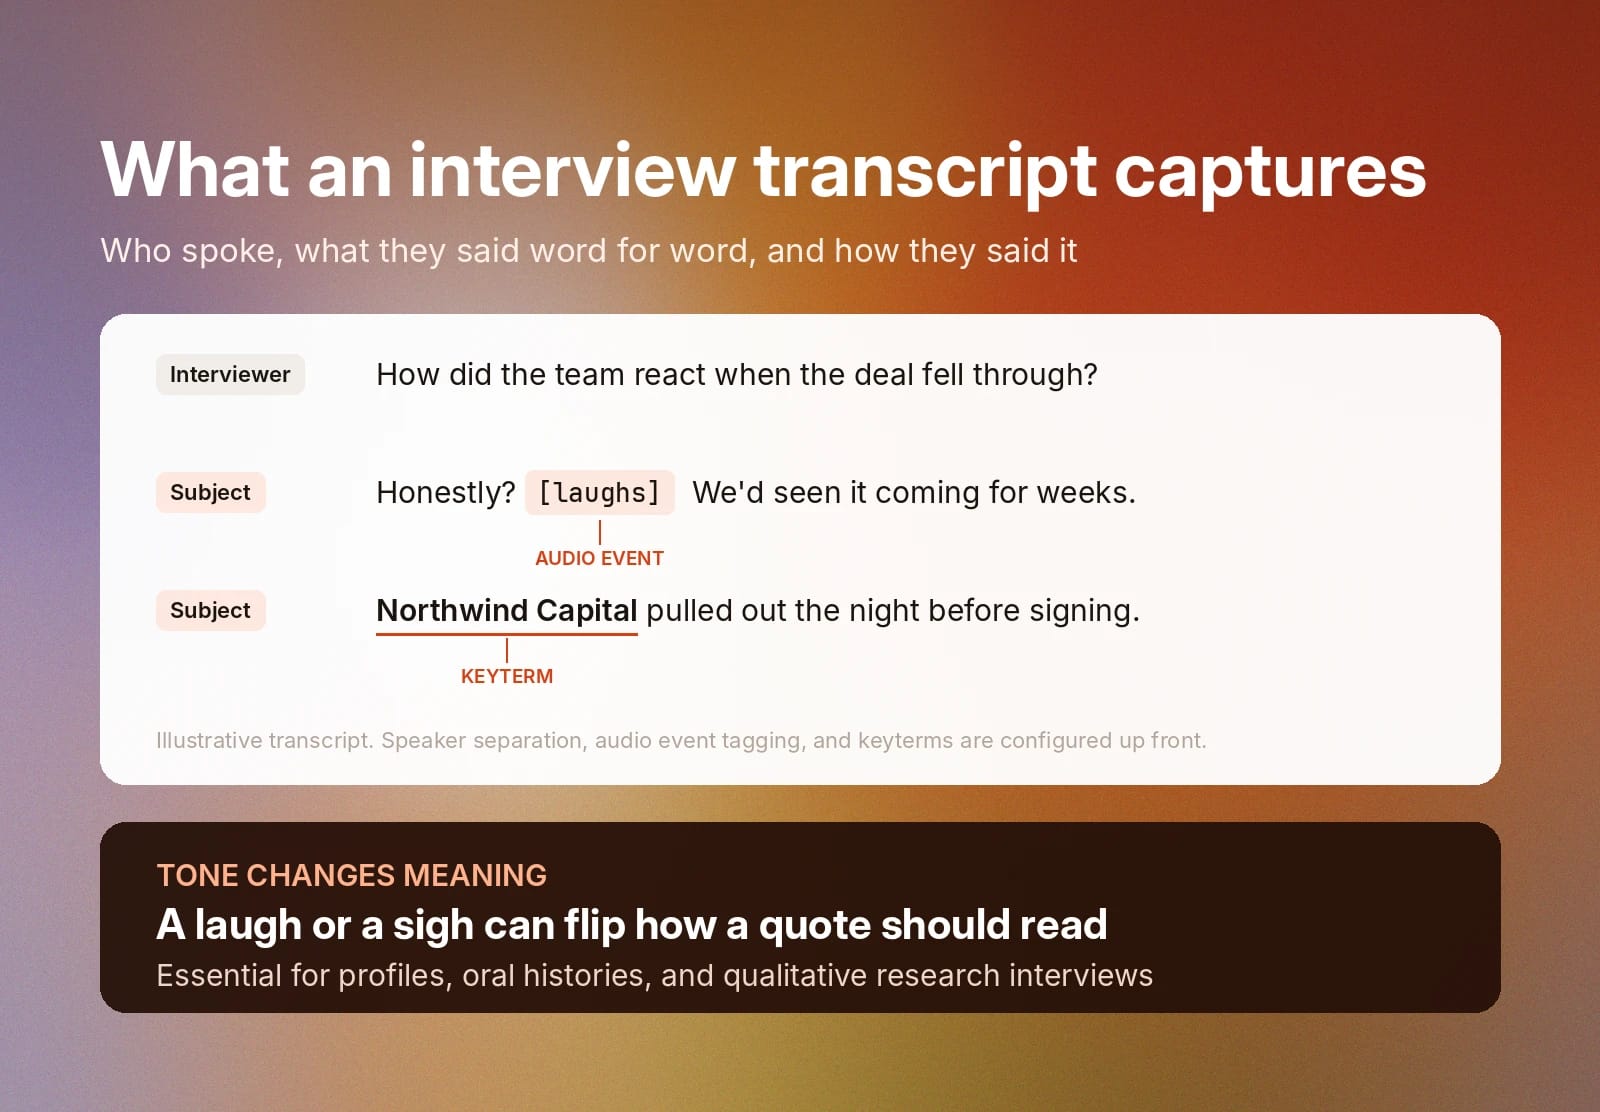
O tom de uma pessoa pode mudar completamente as implicações do que ela diz, e você vai querer garantir que essas nuances sejam preservadas nas transcrições de suas entrevistas. Para isso, ajuste as configurações da sua ferramenta de transcrição para que ela registre risadas, sussurros, suspiros e outros eventos não verbais.
Para fazer isso com a ElevenLabs, use o parâmetro tag_audio_events. Essa configuração é ativada automaticamente ao converter fala em texto com o ElevenCreative e ao usar a ElevenAPI.
Se não quiser registrar esses eventos na transcrição da entrevista, basta desativar “Tag audio events” ao criar uma transcrição no Playground. Na ElevenAPI, use tag_audio_events="false" para desativar essa configuração.
Marcar eventos não verbais é especialmente importante ao entrevistar alguém para um perfil ou uma história oral, pois isso registra a intenção e a expressão completas de quem fala. Também é útil em entrevistas de pesquisa qualitativa, nas quais eventos não verbais podem afetar os resultados finais.
Como acertar nomes e termos
Muitas entrevistas contêm nomes e jargões do setor que os modelos de transcrição não reconheceriam por conta própria.
Com o keyterm prompting, você pode esclarecer nomes, palavras ou frases antes de iniciar o processo de transcrição. Isso evita que o modelo de transcrição escreva termos incorretamente ou os confunda com outras palavras mais comuns.
ElevenLabs Scribe v2 oferece suporte a até 1.000 termos-chave por transcrição, enquanto o ElevenLabs Scribe v2 Realtime oferece suporte a 50 termos-chave por transcrição.
Duas formas de transcrever: upload sem código ou API
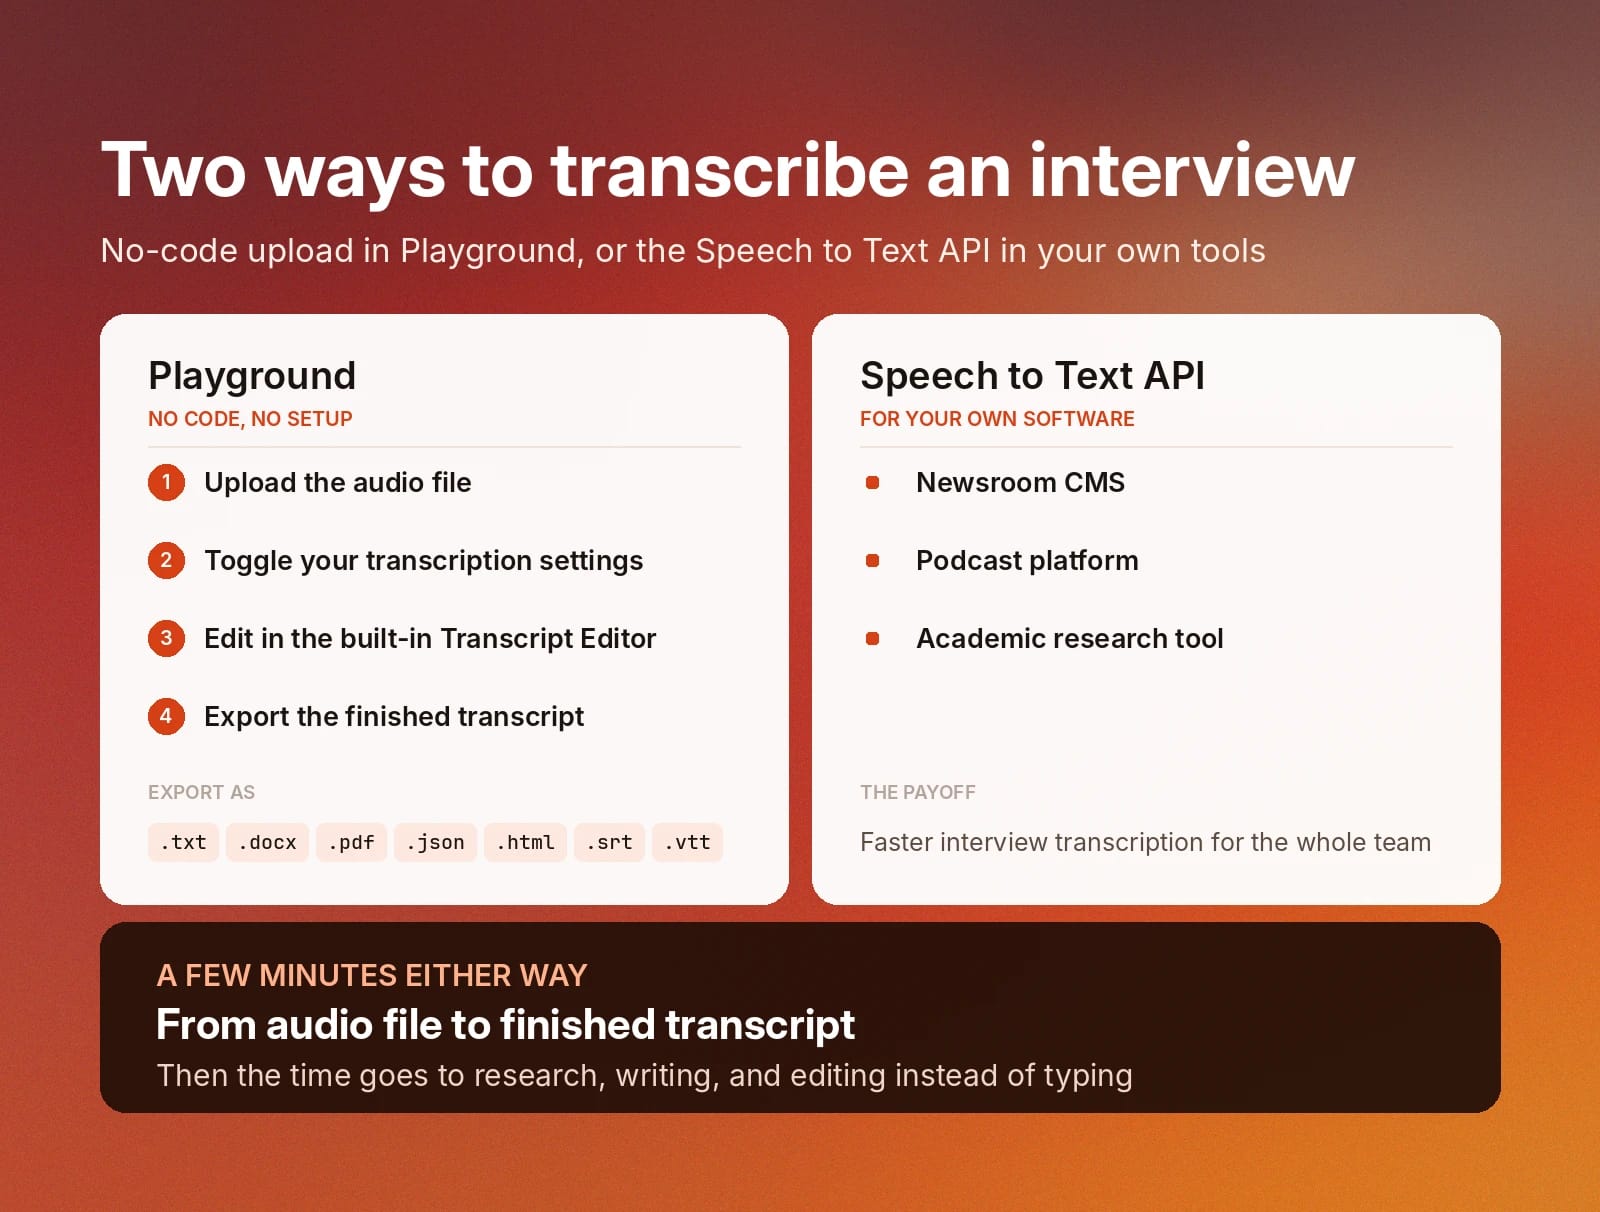
A ElevenLabs oferece dois métodos de Speech to Text para transcrever entrevistas. O ElevenLabs Playground é uma ferramenta sem código, enquanto a API de Speech to Text da ElevenLabs adiciona recursos de transcrição diretamente às ferramentas digitais que você está desenvolvendo.
Transcrever uma entrevista com o ElevenLabs Playground leva apenas alguns minutos e não exige configuração. Faça upload do arquivo de áudio diretamente no painel e ative as configurações de transcrição que preferir.
Antes de a transcrição começar, você pode ajustar a marcação de eventos não verbais, o modo literal e o modo multicanal de acordo com suas preferências. Também é possível adicionar termos-chave relevantes.
Quando a transcrição estiver pronta, você poderá editar o resultado diretamente no Editor de Transcrições integrado. Você também pode exportar a transcrição em diversos formatos de arquivo, incluindo .txt, .docx, .pdf, .json, .html, .srt e .vtt.
Se você está desenvolvendo seu próprio software e quer adicionar recursos de transcrição de entrevistas, pode usar a API de Speech to Text da ElevenLabs. Ao adicionar esse recurso ao CMS da sua redação, à plataforma de podcast ou à ferramenta de pesquisa acadêmica, você acelera o processo de transcrição de entrevistas para toda a equipe.
Transcreva suas entrevistas com o ElevenCreative
Ao transcrever entrevistas, precisão é essencial. Recursos como transcrição literal, transcrição multicanal, marcação de eventos de áudio e keyterm prompting registram cada detalhe da sua entrevista para gerar resultados precisos.
As ferramentas de Speech to Text do ElevenCreative produzem transcrições de entrevistas em minutos, liberando tempo para pesquisa, redação, edição e muito mais. O ElevenLabs Playground tem uma interface intuitiva que não exige configuração e leva você do arquivo de áudio à transcrição finalizada em poucos minutos. A ElevenAPI leva a transcrição de entrevistas diretamente para sua plataforma de software, acelerando seus workflows.
Cadastre-se na ElevenLabs hoje para começar a transcrever suas entrevistas ou saiba mais sobre tudo o que o ElevenCreative oferece.
Perguntas frequentes

Jack Limebear faz parte do time de Growth, atuando como redator e estrategista de conteúdo no blog e nas páginas de insights. Antes da ElevenLabs, ele passou mais de dez anos liderando estratégias de conteúdo em organizações que vão de startups SaaS em rápido crescimento a empresas da Fortune 500. Ele é mestre em Literatura Inglesa pela Universidade de Cambridge.