
Speech to Text para criadores de conteúdo: guia de workflow para legendas e reaproveitamento
- Escrito por
- Jack Limebear
- Publicado
OuvirOuça este artigo
Uma ferramenta precisa de Speech to Text é indispensável no conjunto de ferramentas de qualquer criador de conteúdo. Com Speech to Text com IA, você pode transformar áudios existentes em legendas para vídeos, notas de episódios de podcast, posts de blog e muito mais. Ela ajuda você a reaproveitar conteúdo em diferentes canais para alcançar um público maior.
O Speech to Text também economiza muito tempo de criadores de conteúdo ocupados. Transcrever manualmente cada locução e podcast pode levar horas, mas os modelos de Speech to Text fazem o trabalho em minutos para que você mantenha seu cronograma de publicações em dia.
Neste artigo, vamos explorar como o Speech to Text para criadores de conteúdo funciona, por que ele é tão eficaz e como incorporá-lo aos seus workflows de criação de conteúdo.
Resumo
- Criadores de conteúdo usam modelos de Speech to Text para gerar legendas de vídeo, criar notas de episódios de podcast e reaproveitar conteúdo de áudio em formatos escritos.
- Modelos de Speech to Text com IA oferecem transcrição e formatação mais precisas que as legendas automáticas das redes sociais.
- Ao transcrever podcasts com Speech to Text, você pode criar rapidamente notas de episódios ou reaproveitá-los como blogs e newsletters.
- Com o prompt de termos-chave, você pode esclarecer nomes e termos específicos do setor para obter transcrições mais precisas.
- Para traduzir suas legendas, duble o vídeo no idioma escolhido e use o Speech to Text para transcrever o áudio dublado.
Quais são os principais usos do Speech to Text para criadores de conteúdo?
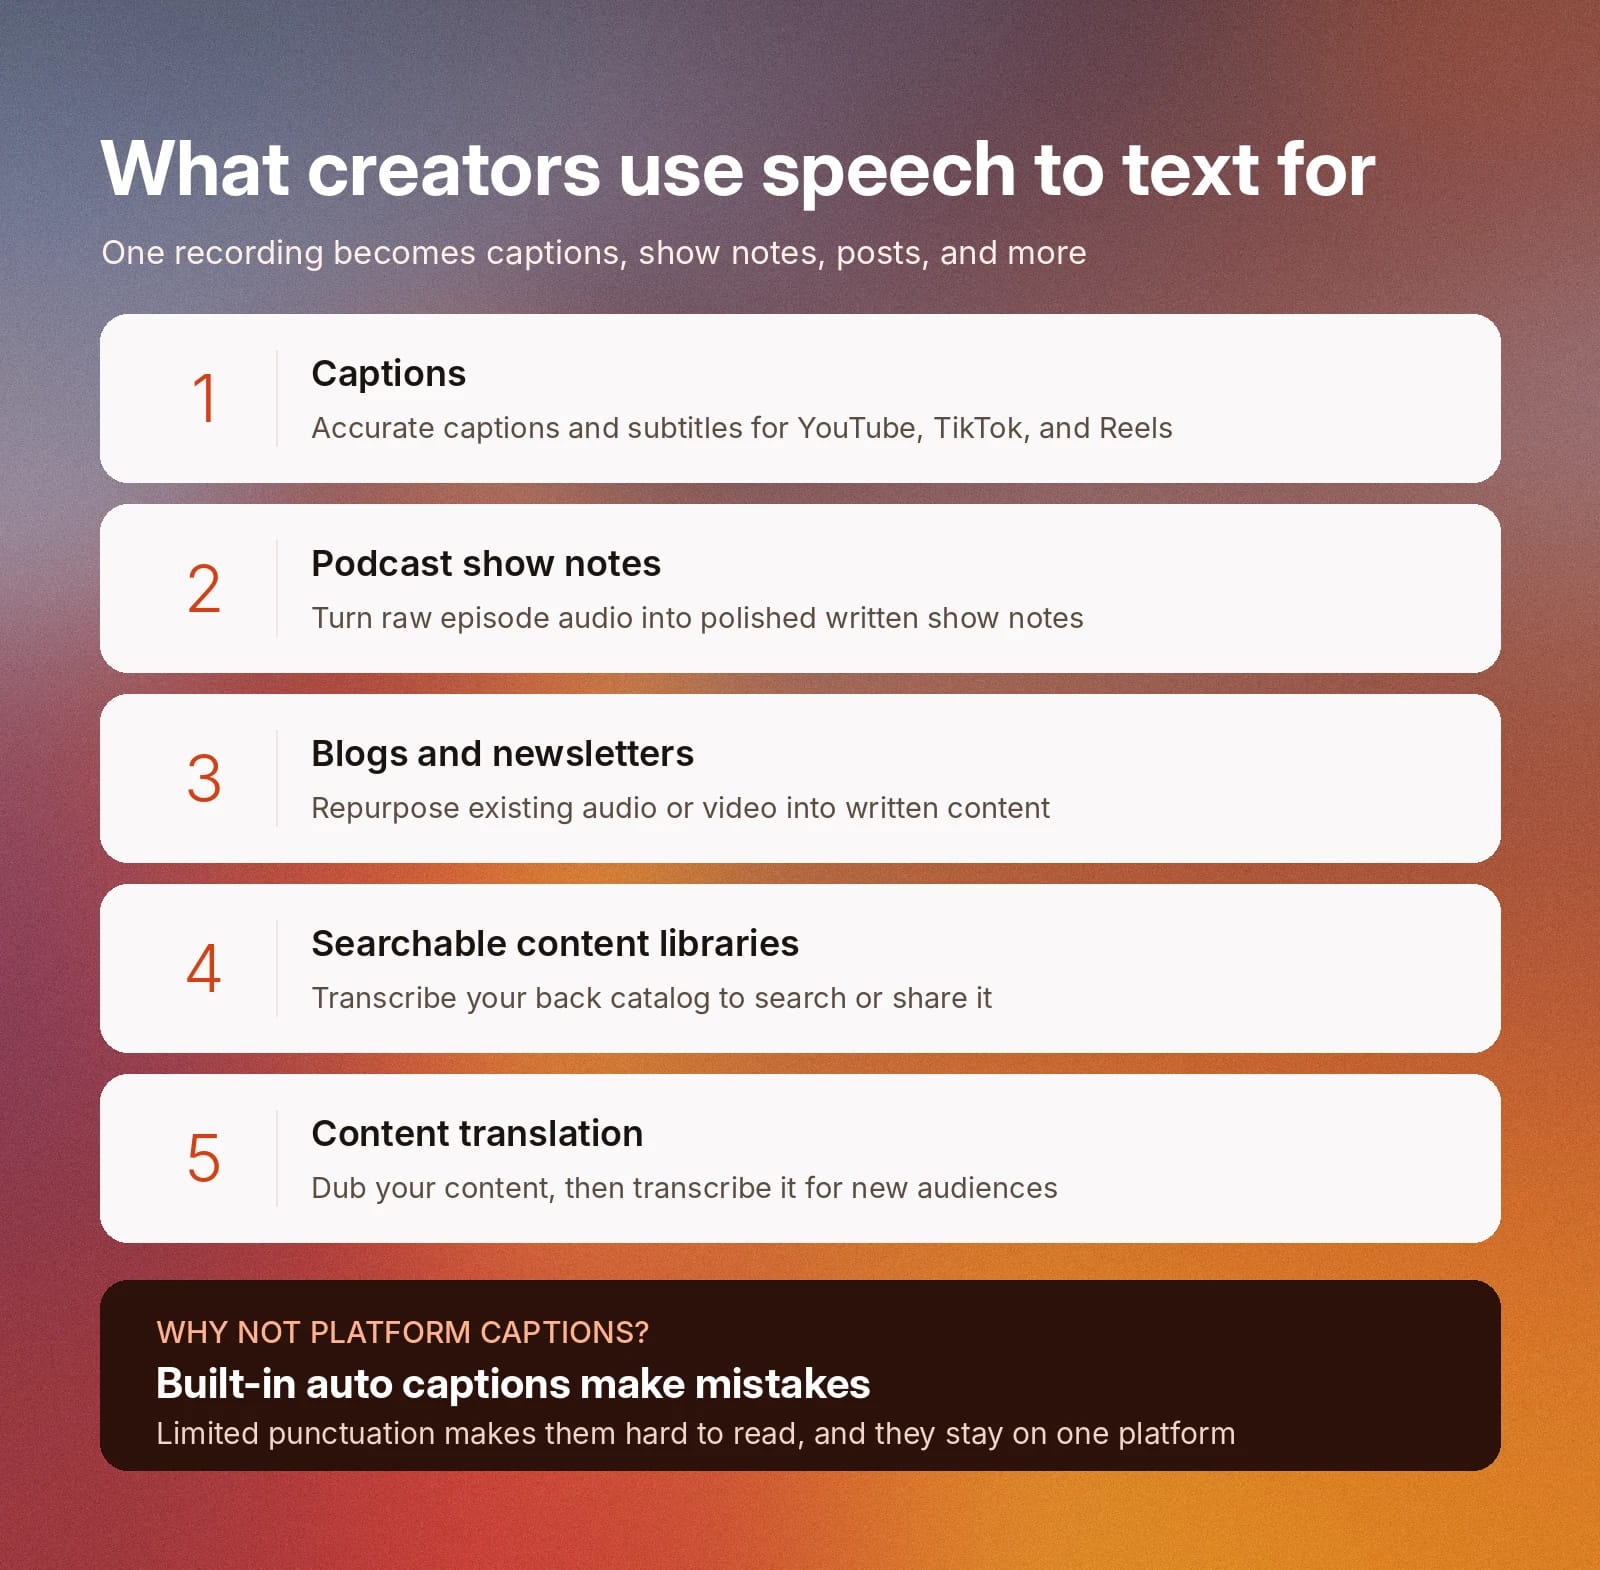
Criadores de conteúdo usam o Speech to Text em diversas tarefas, incluindo:
- Legendas: O Speech to Text gera legendas precisas para vídeos curtos e longos em plataformas como YouTube, TikTok e Instagram Reels.
- Notas de episódios de podcast: O Speech to Text ajuda você a transformar o áudio bruto de um episódio em notas escritas bem elaboradas.
- Blogs e newsletters: Com Speech to Text, você pode transformar conteúdo existente de áudio ou vídeo em blogs, newsletters e outros conteúdos escritos.
- Bibliotecas de conteúdo pesquisáveis: Ferramentas automatizadas de Speech to Text transcrevem sua biblioteca de conteúdo para torná-la pesquisável. Você pode usá-las para se organizar internamente ou criar uma biblioteca de recursos externa para seu público.
- Tradução de conteúdo: O Speech to Text traduz seu conteúdo para diferentes idiomas, alcançando públicos no mundo todo.
Muitas plataformas de redes sociais têm recursos de geração automática de legendas para vídeos. No entanto, essas ferramentas podem cometer erros e usar pouca pontuação, o que torna as legendas difíceis de ler.
Usar um modelo dedicado de Speech to Text ajuda você a criar legendas claras e precisas para seus vídeos. Você também pode baixar e reaproveitar a transcrição em diferentes plataformas.
Transformando uma transcrição em legendas
Legendas não são mais opcionais em vídeos para redes sociais. Elas tornam os vídeos acessíveis a todos, independentemente do nível de audição. Também permitem que o público assista aos vídeos sem som.
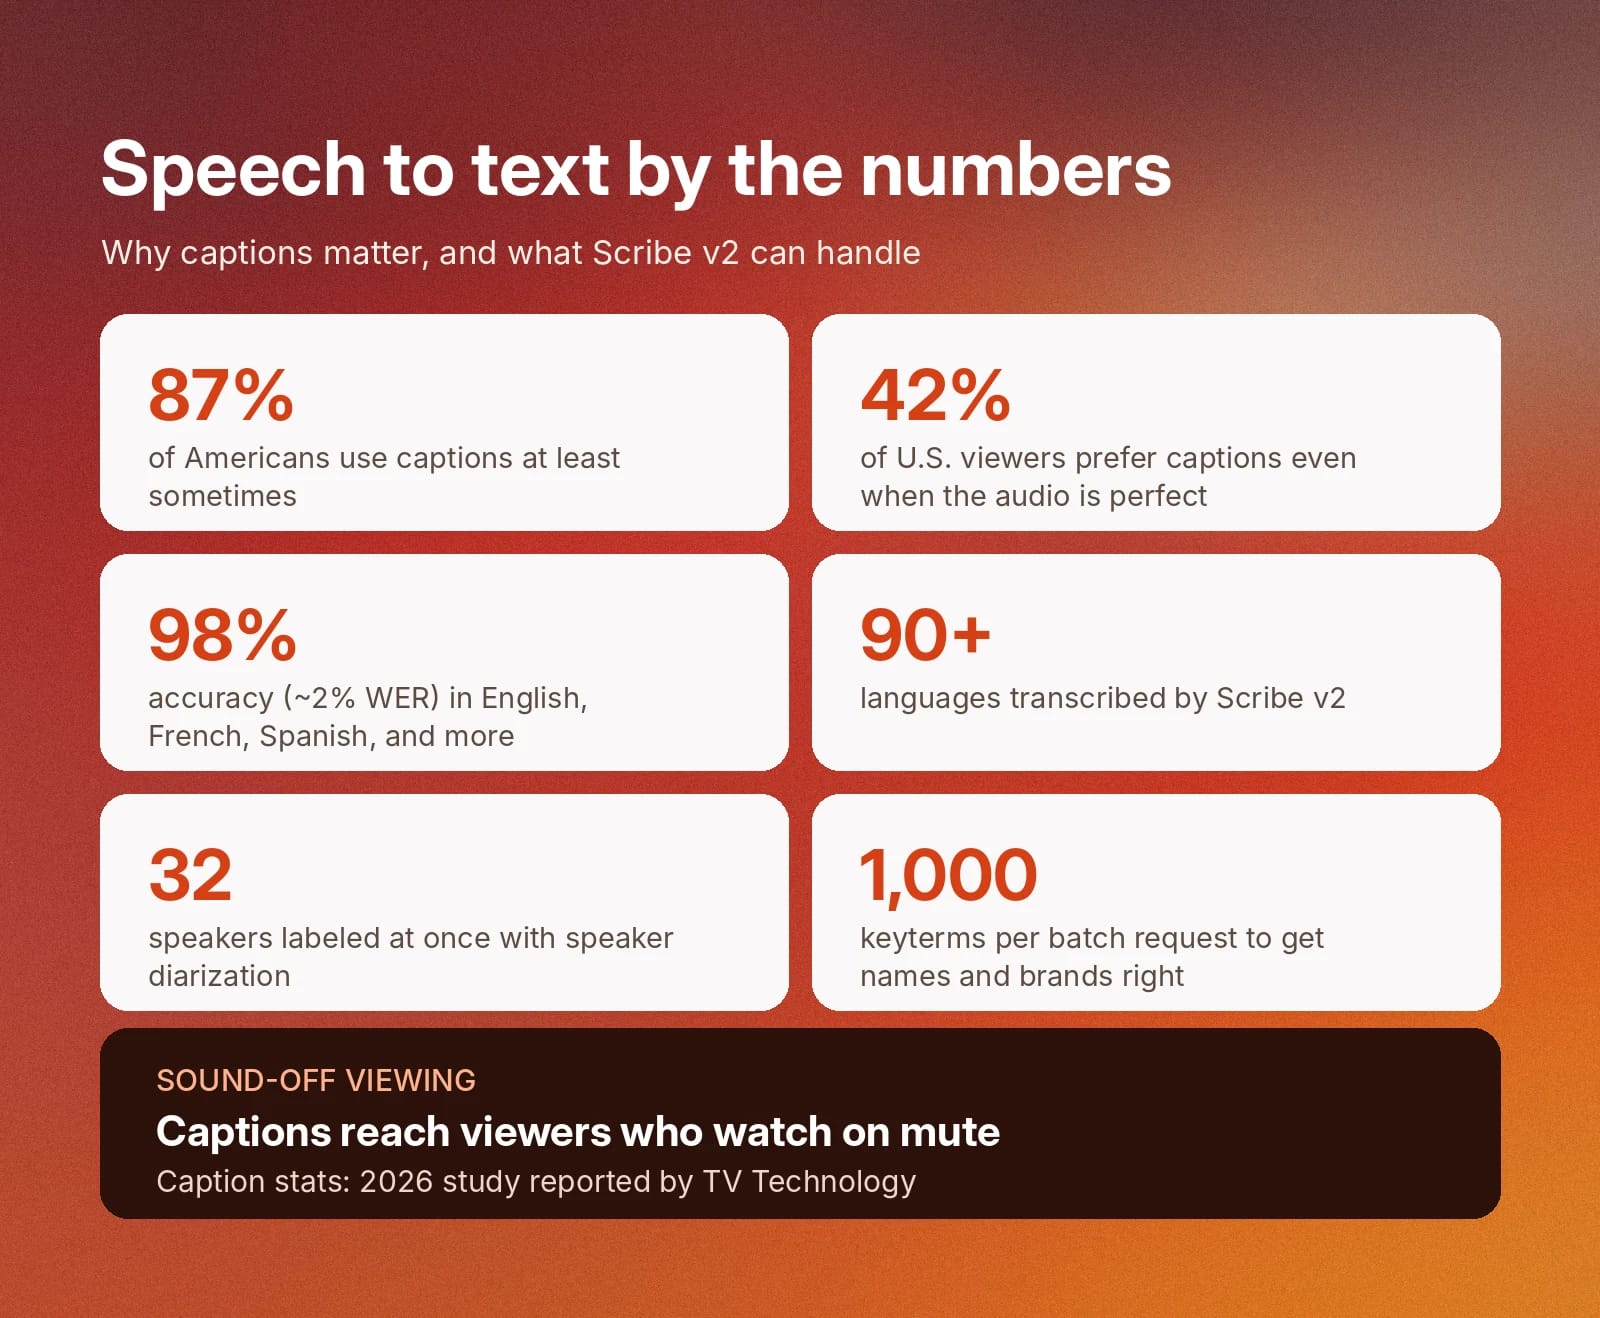
Assistir sem som se tornou o padrão para muitos usuários de redes sociais, especialmente quando estão em locais públicos ou não têm fones de ouvido à mão. Um estudo de 2026 constatou que 87% dos americanos usam legendas pelo menos às vezes ao assistir a vídeos.
De fato, 42% dos espectadores dos EUA preferem legendas mesmo quando o áudio do vídeo já está perfeito, mostrando como legendar todos os vídeos torna seu conteúdo mais atraente.
Speech to Text transcreve seus vídeos de redes sociais para gerar legendas. Gerador de Legendas da ElevenLabs cria transcrições com marcações de tempo por palavra e caractere, sincronizadas com a fala do seu vídeo. Essas marcações permanecem mesmo se você recortar o vídeo original em clipes menores para diferentes plataformas.
Você também pode exportar as legendas como arquivos SRT e VTT para enviá-las diretamente às redes sociais ou à sua plataforma de edição de vídeo preferida. Ao editar seu vídeo, ajuste as quebras de linha para que acompanhem bem o ritmo da conversa.
SRT vs. VTT: qual arquivo de legenda você deve exportar?
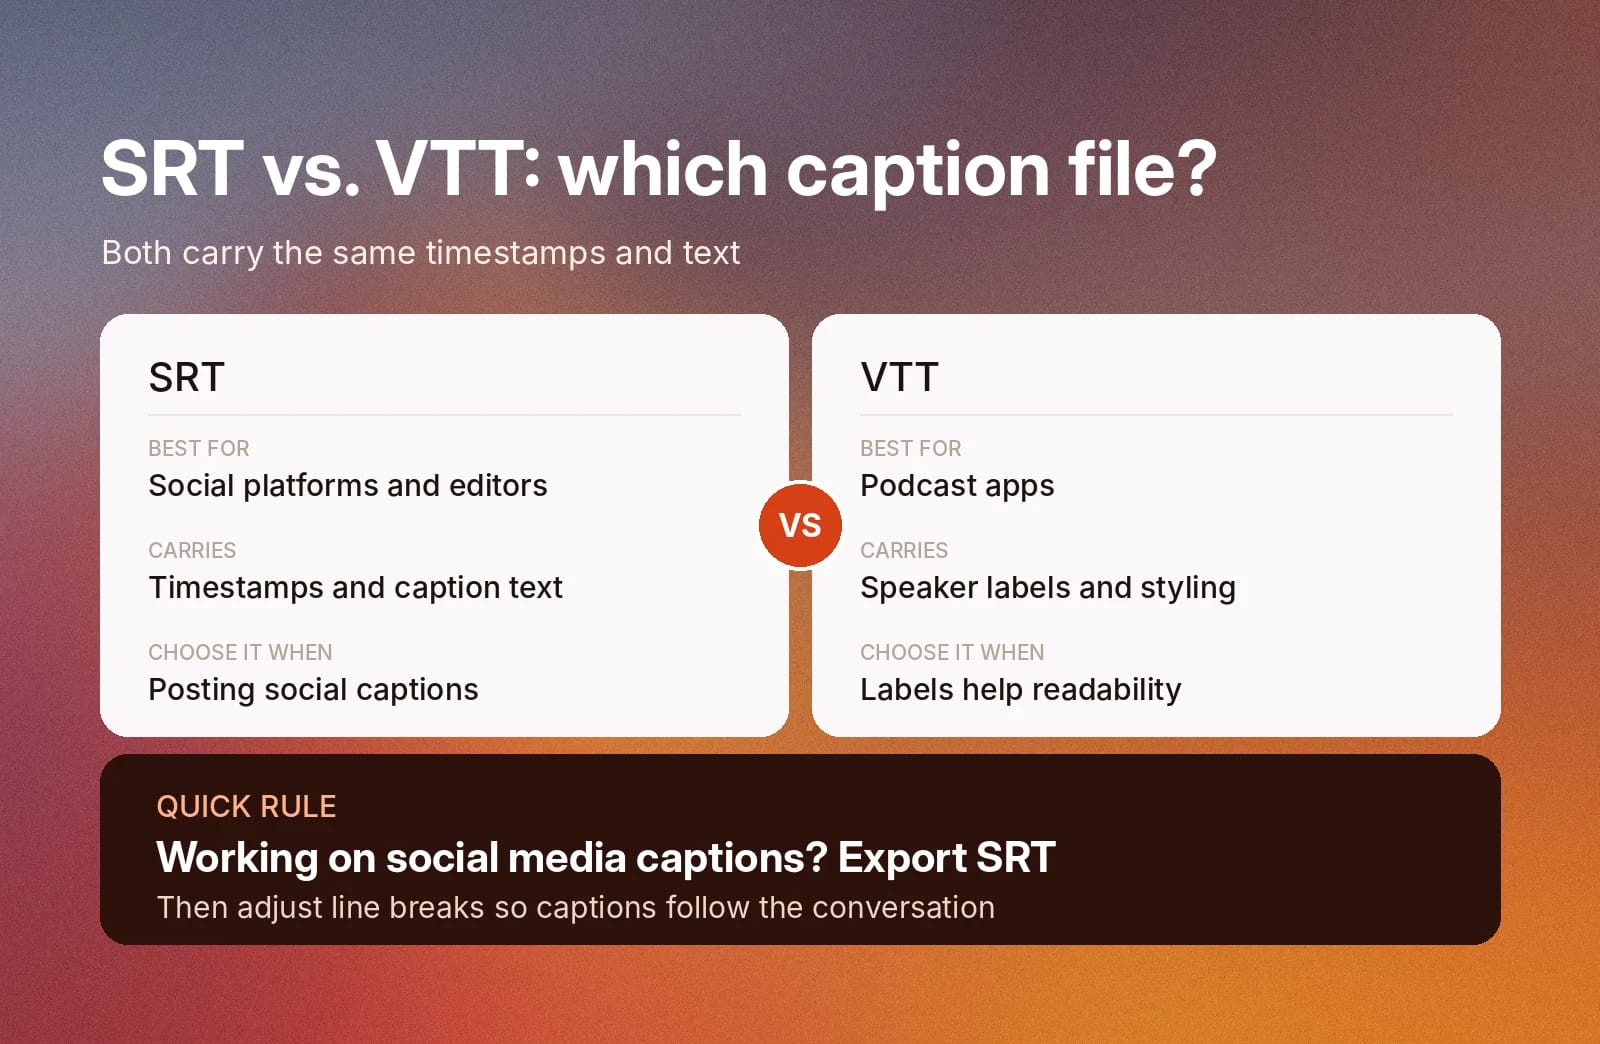
Tanto SRT quanto VTT contêm as mesmas marcações de tempo e o mesmo texto.
Veja quando escolher cada um:
- Exporte em SRT quando quiser um arquivo simples aceito pela maioria das plataformas sociais e softwares de edição de vídeo.
- Exporte em VTT ao publicar legendas ou transcrições em apps de podcast, pois ele permite adicionar identificação dos falantes e estilos básicos que melhoram a leitura.
Se você trabalha com legendas para redes sociais, SRT provavelmente é a opção certa.
Transcrição limpa vs. literal para legendas de redes sociais
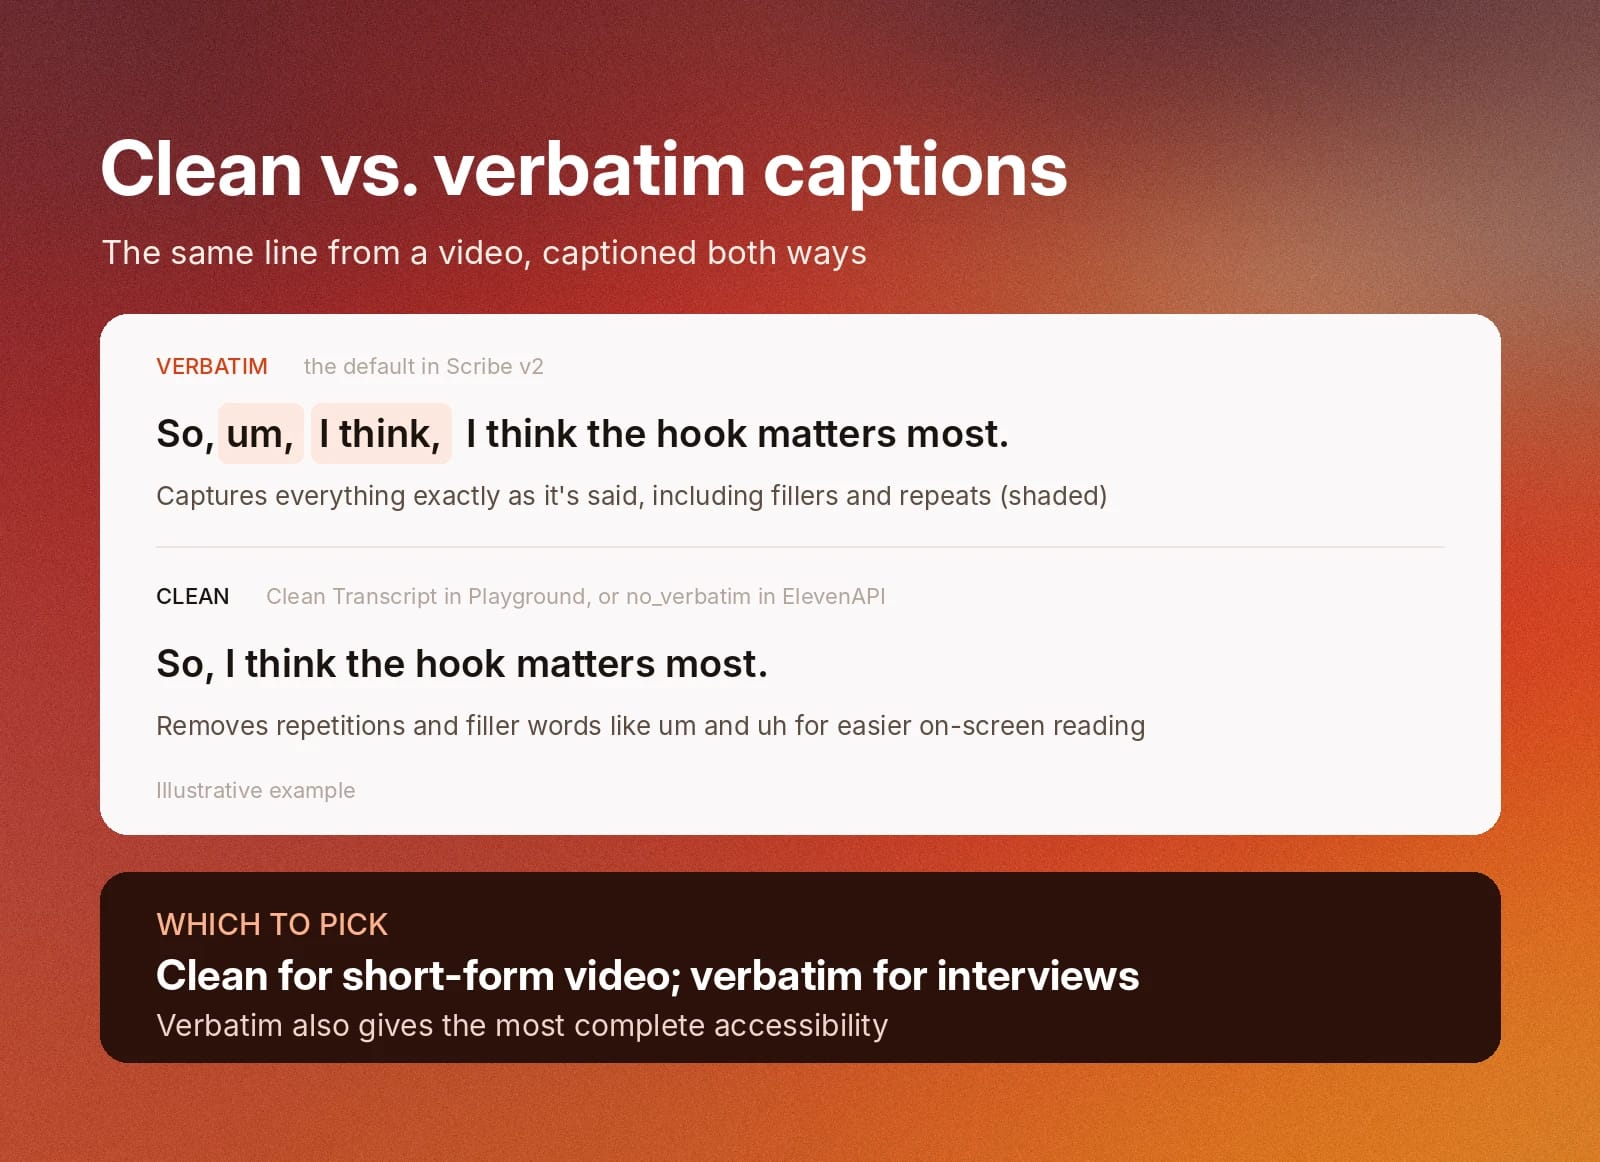
Ao criar legendas para redes sociais, você pode escolher entre transcrição limpa e literal. A transcrição limpa remove repetições e palavras de preenchimento como “ahn” e “éé”, enquanto a transcrição literal registra tudo exatamente como foi dito.
Embora legendas limpas sejam mais fáceis de ler na tela, as literais são melhores para acessibilidade total. A escolha certa depende do seu público e das necessidades específicas dele.
ElevenLabs Scribe v2 usa a transcrição literal como configuração padrão. No entanto, você pode mudar para a transcrição limpa ativando “Clean Transcript” no ElevenLabs Playground ou usando o parâmetro no_verbatim com a ElevenAPI.
Escolha a transcrição limpa para vídeos curtos, nos quais é provável que o público leia seu conteúdo enquanto percorre o vídeo rapidamente. A literal é melhor para entrevistas mais longas ou contextos de pesquisa em que a redação exata importa.
Transcrevendo podcasts para notas de episódios e reaproveitamento
Seu podcast serve de base para toda a sua estratégia de conteúdo. Para alcançar um público maior, transforme as ideias discutidas em cada episódio em notas de episódios, blogs, newsletters e conteúdo curto para redes sociais.
Ferramentas de Speech to Text ajudam você a transcrever episódios de podcast para reaproveitá-los facilmente. Depois de criar a transcrição, você pode editá-la e transformá-la em notas de episódios que seu público pode consultar a qualquer momento.
Você também pode transformar trechos de cada transcrição em conteúdo para blogs e newsletters, em vez de escrever artigos do zero. Isso ajuda você a alcançar públicos que preferem ler a ouvir.
Bibliotecas de conteúdo escrito são fáceis de pesquisar. Se seu público quiser revisitar uma ideia de um episódio anterior, basta buscar nas notas do episódio ou no blog. Conteúdo escrito também tem mais chances de aparecer nos resultados de busca do que conteúdo de áudio, aumentando sua visibilidade online.
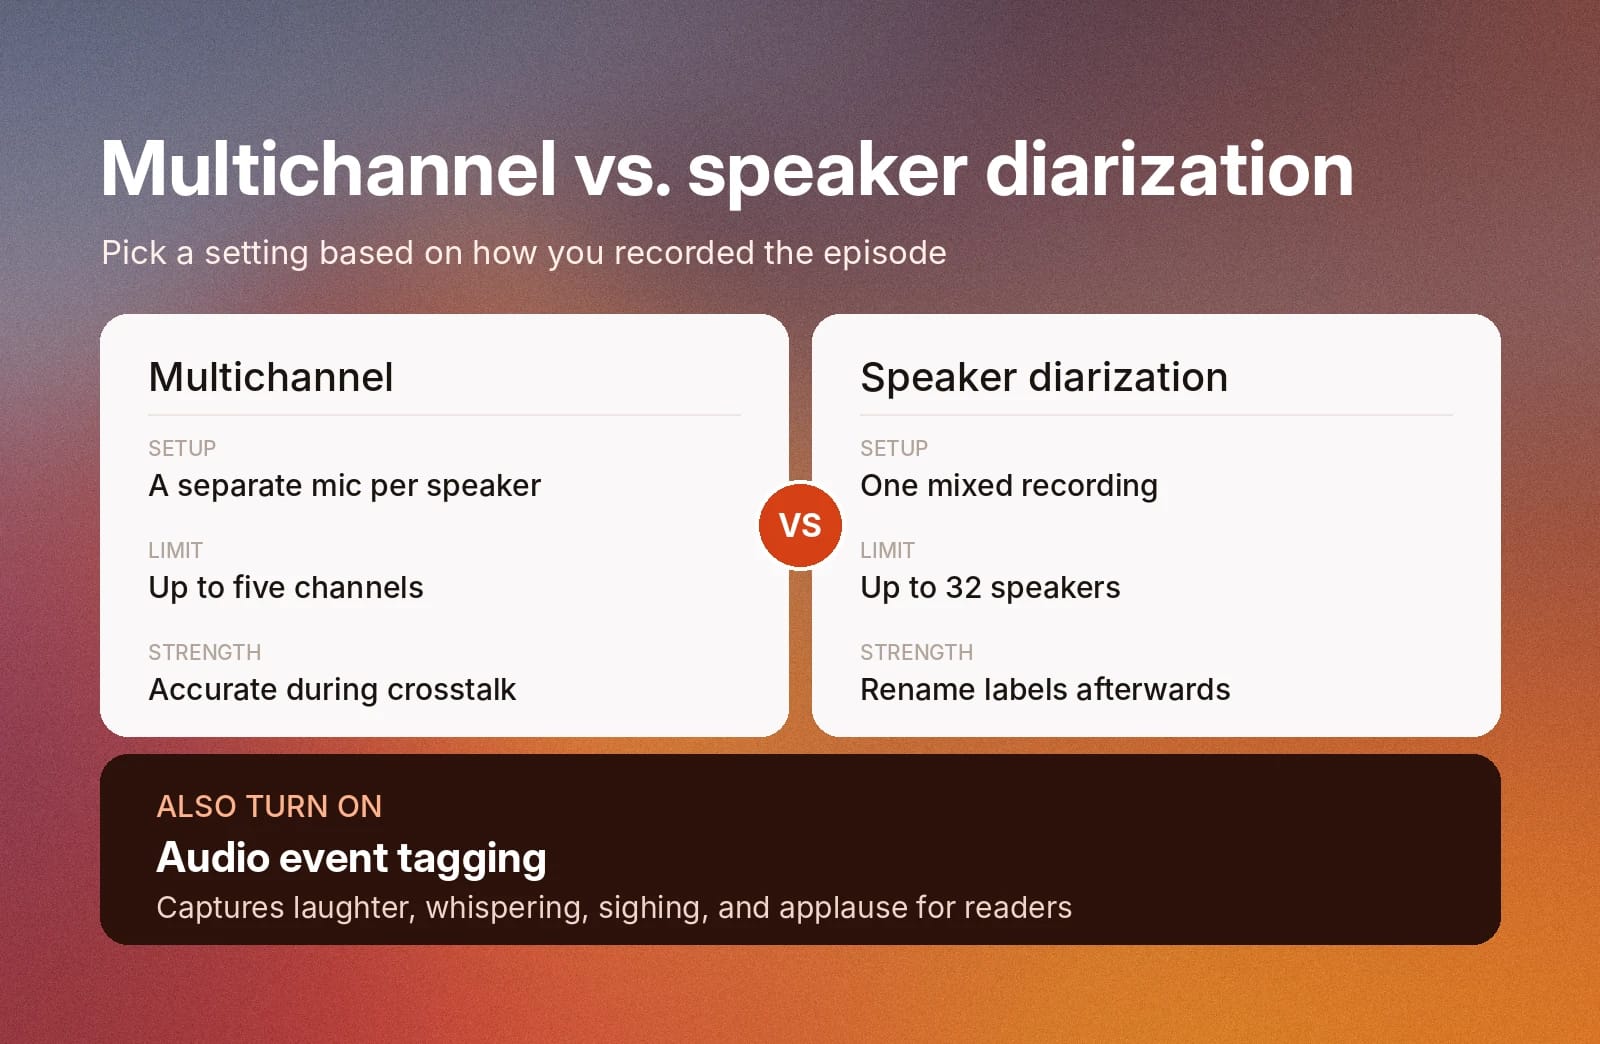
A maneira mais eficiente de transcrever podcasts é usar uma configuração de transcrição multicanal. Para isso, use um microfone separado para cada falante. O modelo de transcrição processará cada falante separadamente, garantindo resultados precisos mesmo quando falam ao mesmo tempo.
Além disso, ative a marcação de eventos de áudio ao transcrever podcasts. Essa configuração registra risos, sussurros, suspiros ou aplausos, para que os leitores tenham o contexto completo. Para fazer isso no Speech to Text da ElevenLabs, ative “Tag Audio Events” ou use o parâmetro tag_audio_events com a ElevenAPI.
Identificando falantes em uma única gravação
A transcrição multicanal suporta até cinco canais. Se você gravar todas as vozes em uma única faixa mixada ou tiver mais vozes que canais, ative a diarização de falantes em vez disso. Scribe v2 identifica cada falante na transcrição e suporta até 32 falantes de uma vez. Após transcrever, você pode renomear os falantes clicando no botão de edição ao lado do rótulo de cada um no painel da ElevenLabs.
Reaproveitando gravações em clipes, blogs e newsletters
Transcreva uma entrevista uma vez e reutilize-a em todos os canais onde publica.
A mesma transcrição fornece as legendas e a matéria-prima para clipes e conteúdo escrito. Criadores e empresas do mundo todo usam o STT da ElevenLabs para acelerar o processo de transformar podcasts em conteúdo escrito.
Todos os podcasts, palestras e entrevistas que faço passam pelo Speech to Text. Uma transcrição me dá legendas precisas para tudo, os melhores momentos para recortar em vídeos curtos e citações importantes que transformo em conteúdo escrito.
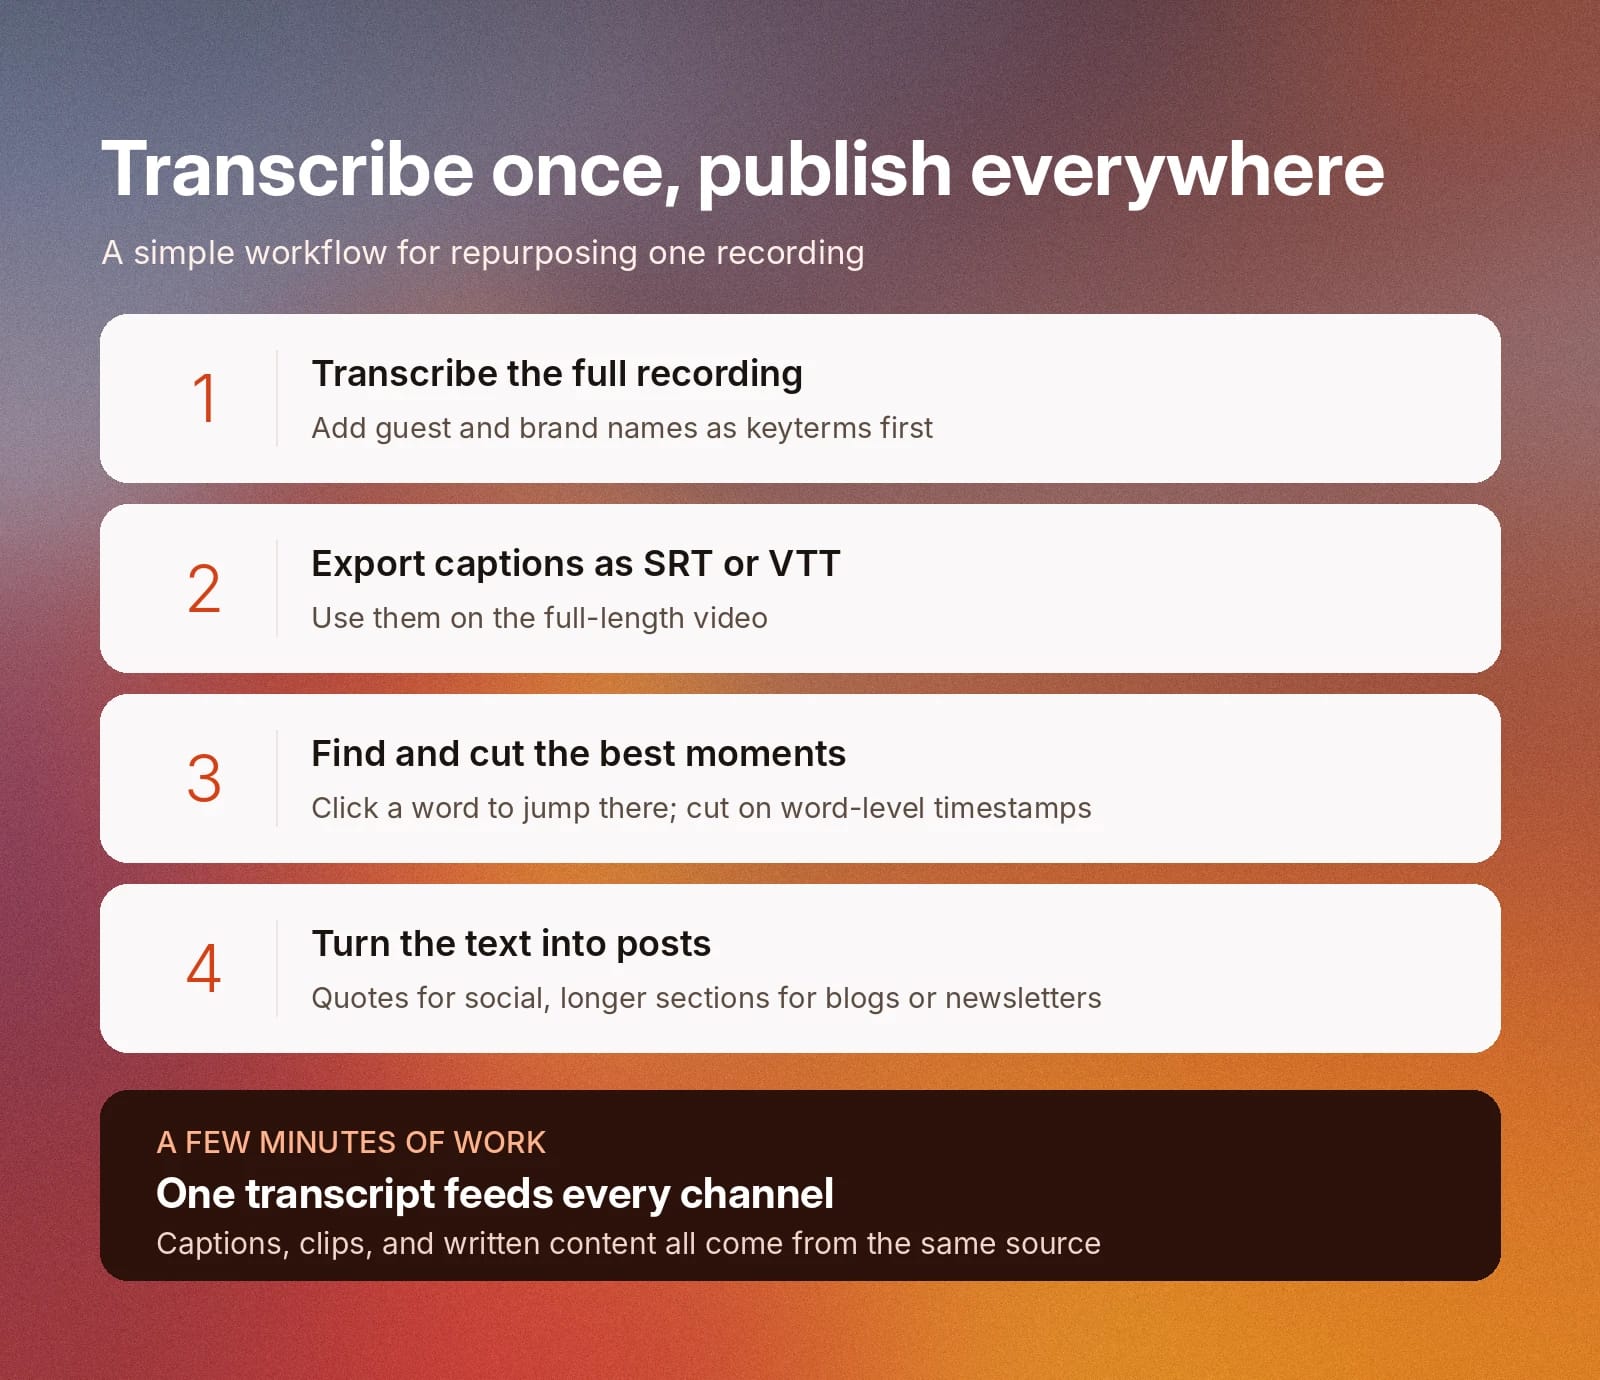
Veja um workflow simples de reaproveitamento que você pode usar:
- Transcreva a gravação completa e adicione os nomes de convidados e marcas ao seu dicionário de pronúncia.
- Exporte as legendas como SRT ou VTT e use-as no vídeo completo.
- Leia a transcrição procurando os melhores momentos. Clique em uma palavra na transcrição para ir àquele ponto do áudio e use as marcações de tempo por palavra para cortar cada clipe exatamente no início e no fim.
- Copie citações importantes para publicações sociais e edite trechos mais longos em um post de blog ou newsletter.
Leva apenas alguns minutos para criar conteúdo longo a partir das transcrições STT do seu podcast.
Transformando seus vídeos em transcrições para análise com LLMs
Depois de transformar seus vídeos em texto, você pode enviar seu conteúdo em massa a um LLM para análise. Identifique novas ideias, destaque pontos que pode usar para reaproveitar conteúdo ou simplesmente descubra o que está funcionando no seu conteúdo.
Tudo o que crio começa com minha voz, mas a maioria das minhas ferramentas de IA ainda funciona melhor com texto. O ElevenLabs Scribe é minha camada de tradução: ele transforma meus vídeos em transcrições, para que qualquer LLM possa analisar o que está funcionando (e o que não está). Na minha opinião, isso resolve uma das maiores lacunas da IA.
Veja como configurar um workflow semelhante:
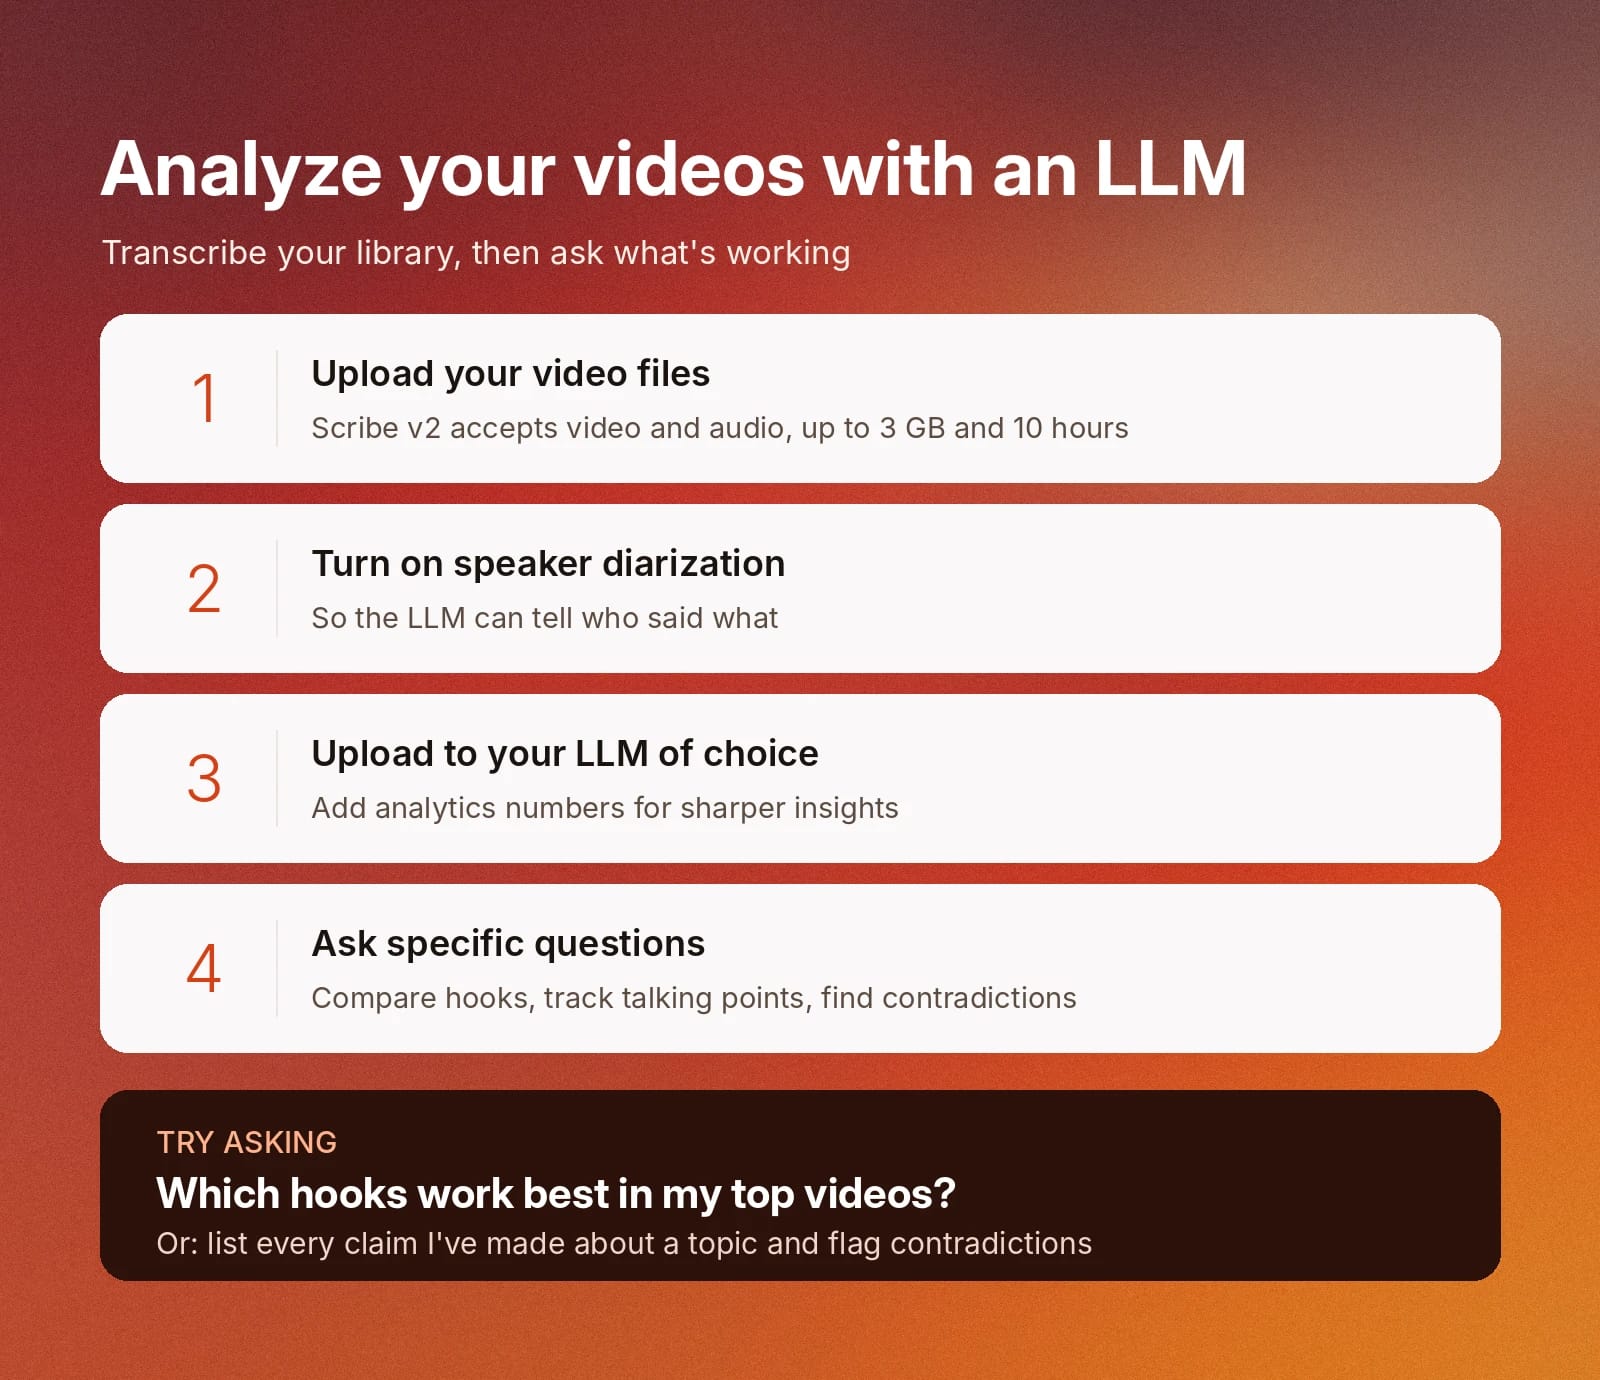
- Envie seus arquivos de vídeo para transcrição: o STT da ElevenLabs aceita vídeo e áudio, com arquivos de até 3 GB e duração de até 10 horas.
- Ative a diarização de falantes: Se mais de uma pessoa falar, ative a diarização para que o LLM saiba quem disse o quê.
- Envie ao LLM de sua escolha: Adicione números de análise ou informações extras para melhorar os insights que você pode obter.
- Faça perguntas específicas sobre seu conteúdo: perguntas como “Compare os primeiros 20 segundos dos meus vídeos de melhor desempenho para ver quais ganchos funcionam melhor para meu público” ou “Liste todas as afirmações que fiz sobre o tema X e sinalize contradições” podem revelar novos insights.
Ditando prompts e anotações
A digitação por voz permite fornecer a uma ferramenta de IA o contexto e as nuances que você talvez deixasse de fora se precisasse digitar tudo. O Speech to Text transforma o que você diz em texto para colar diretamente em um prompt, briefing ou em suas anotações. Alguns escritores até estão usando STT para escrever mais rápido, transcrevendo a fala em vez de digitar tudo.
Não consigo imaginar trabalhar sem isso, especialmente na hora de criar prompts. Há tantas nuances que precisam entrar em cada interação com a IA, e não tenho disposição para digitar tudo isso.
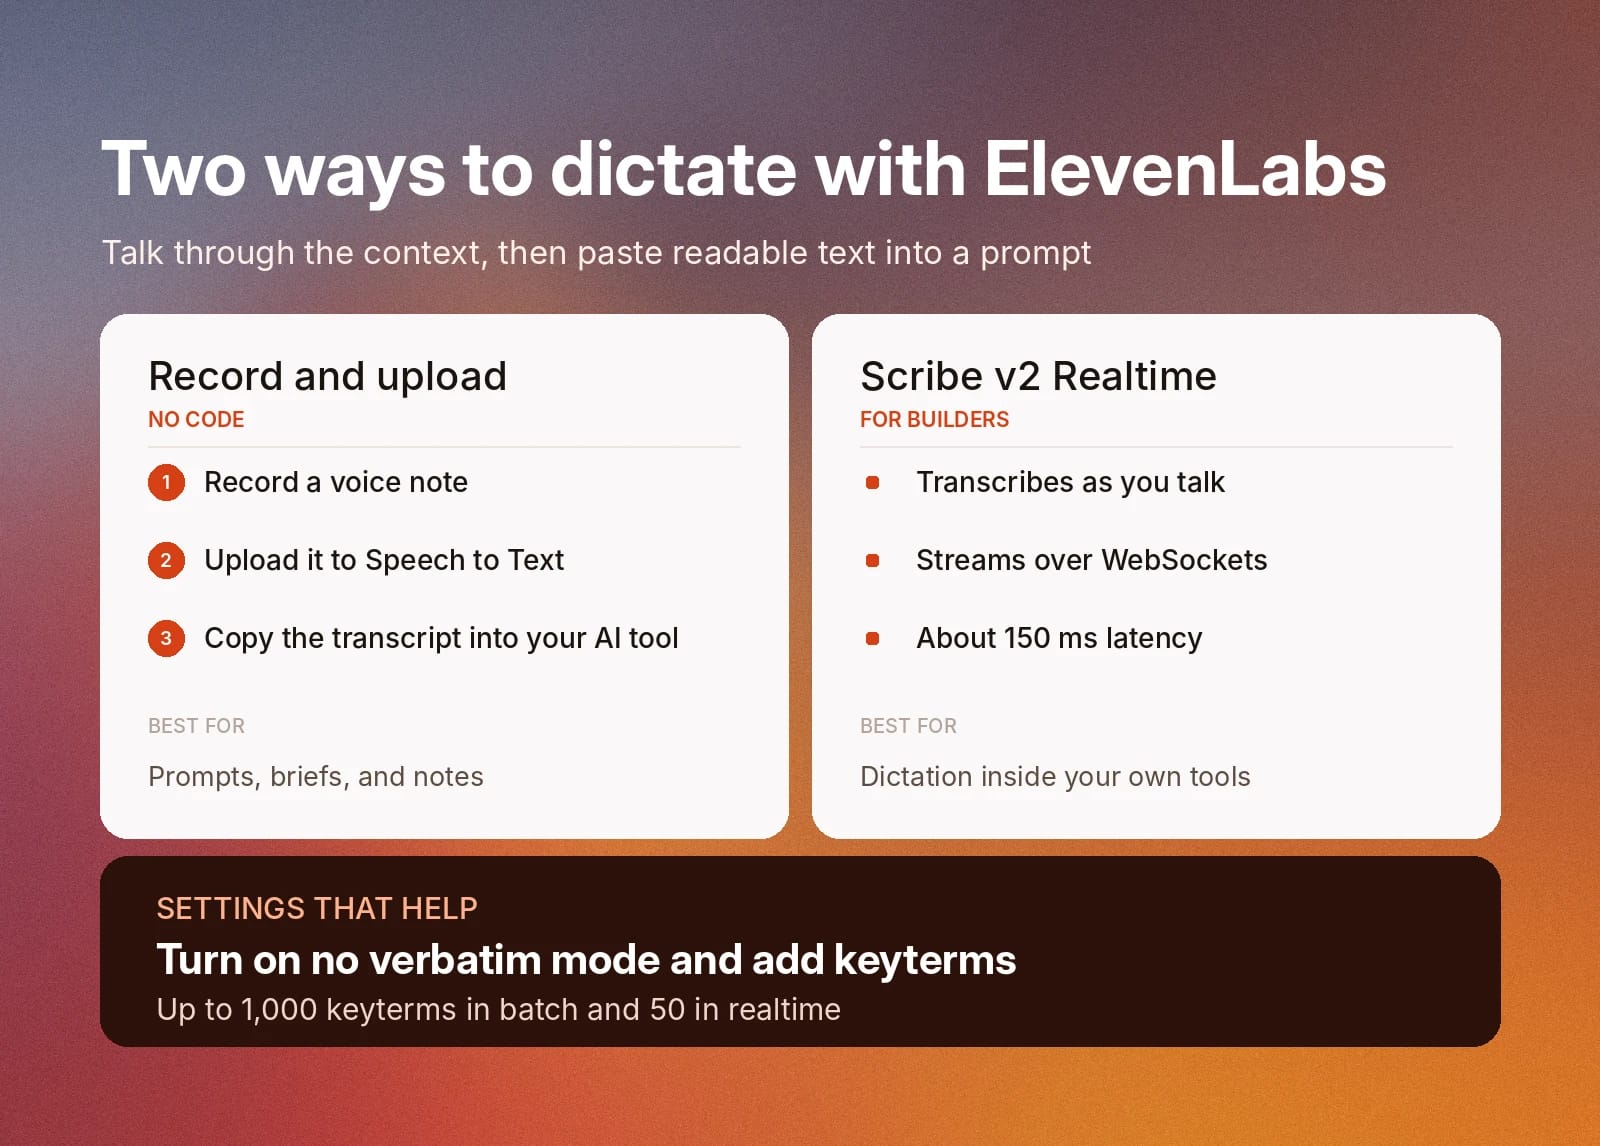
Há duas formas de ditar com a ElevenLabs:
- Grave e envie: Grave uma nota de voz, envie-a à página de Speech to Text da ElevenLabs e copie a transcrição para sua ferramenta de IA.
- Transmita em tempo real: se você estiver criando suas próprias ferramentas, o Scribe v2 Realtime transcreve sua fala em WebSockets, com baixa latência de cerca de 150 ms, segundo a documentação.
Ative o modo não literal, que remove palavras de preenchimento, recomeços e disfluências, para garantir que uma nota de voz longa se transforme em texto legível. Depois, adicione com o prompt de termos-chave os nomes de produtos e jargões que você usa com frequência para garantir a transcrição correta sempre. A transcrição em lote aceita até 1.000 termos-chave, e a em tempo real aceita até 50.
Acertando nomes, marcas e termos de nicho com STT
Modelos de Speech to Text nem sempre reconhecem nomes de falantes, marcas ou termos específicos do setor. Ao transcrever seu conteúdo, use prompt de termos-chave para esclarecer a grafia e a formatação.
O prompt de termos-chave permite fornecer a grafia correta de nomes ou termos de nicho antes do início da transcrição. Para cada vídeo ou episódio de podcast, adicione nomes de convidados, canais ou marcas que você menciona com frequência. Talvez você também precise adicionar jargões do setor ou outros termos de nicho.
O prompt de termos-chave torna suas transcrições mais precisas e fáceis de ler para o público. Ele também acelera a edição, pois você não precisará corrigir esses termos manualmente.
Alcançando públicos em outros idiomas
Modelos de Speech to Text vão além da transcrição. Como criador de conteúdo, você também pode usá-los para localizar seu conteúdo e alcançar públicos que falam outros idiomas.
O Scribe v2 da ElevenLabs transcreve conteúdo em mais de 90 idiomas. Você pode combiná-lo com o Dubbing Studio da ElevenLabs para criar um workflow completo de localização.
Para isso, envie o áudio ao Dubbing Studio para dublar o conteúdo no idioma de sua preferência. Depois, transcreva o áudio dublado para criar legendas localizadas, notas de episódios ou outro conteúdo escrito.
O que o Speech to Text não faz por você
O Speech to Text é uma ferramenta poderosa, mas tem limitações. Embora os modelos de Speech to Text transcrevam áudio com marcações de tempo precisas, eles não são editores de vídeo. Você precisará usar uma plataforma separada de edição de vídeo para criar o produto final.
Ao criar conteúdo, comece usando o Speech to Text para transcrever o áudio. Depois, exporte a transcrição bruta e as legendas para usar em seu conteúdo. Envie as legendas ao seu editor de vídeo ou diretamente às redes sociais e use a transcrição como base para notas de episódios, posts de blog e outros materiais escritos.
Revise todas as transcrições antes de publicar, especialmente nomes e trechos em que os falantes falam ao mesmo tempo. O Editor de Transcrições permite corrigir erros facilmente no app.
Como escolher a melhor ferramenta de Speech to Text como criador de conteúdo
A ferramenta STT certa transforma sua gravação em texto claro, com grafia correta e marcações de tempo que facilitam ao máximo o reaproveitamento de conteúdo.
Ao buscar a melhor plataforma de Speech to Text, verifique se ela tem estes cinco recursos:
- Precisão no seu idioma: o desempenho de STT pode variar entre idiomas, especialmente nos que têm menos dados disponíveis. Procure métricas publicadas de precisão. Por exemplo, o ElevenLabs Scribe v2 tem 98% de precisão (~2% de WER) em idiomas como inglês, francês, italiano, espanhol e outros.
- Processamento de nomes e jargões do setor: seu modelo de STT precisa entender o contexto das conversas e transcrevê-las com precisão. Procure plataformas de STT que ofereçam prompt de termos-chave e dicionários de pronúncia.
- Marcações de tempo e formatos de exportação: você precisará de marcações de tempo por palavra e da opção de exportar legendas SRT ou VTT.
- Processamento de falantes: especialmente se você trabalha com áudio de mais de um falante, identificar essas vozes corretamente como distintas ajuda a manter as transcrições claras.
- Limites de arquivo: em projetos maiores de áudio ou vídeo, como podcasts, você pode lidar com arquivos maiores. A ElevenLabs aceita arquivos de até 3 GB e, no modo padrão, de até 10 horas.
Veja como um modelo de STT dedicado, como o Eleven Scribe v2, se compara às ferramentas automáticas de legendas integradas às plataformas sociais:
O que você precisa
Legendas automáticas da plataforma
Modelo dedicado, como o Scribe v2
Grafia correta de nomes e marcas
Pode cometer erros
Prompt de termos-chave, até 1.000 termos por solicitação em lote
Pontuação legível
Frequentemente limitada
Resultado limpo com modo não literal
Reutilização do texto em outros lugares
As legendas ficam na plataforma
Baixe a transcrição e as legendas e use onde quiser
Sincronização
Vinculada ao player da plataforma
Marcações de tempo por palavra que você pode levar para os clipes
Idiomas
Varia conforme a plataforma
Mais de 90 idiomas
Duas formas de começar: envio sem código ou a API
Com a ElevenLabs, há duas formas de transcrever seu conteúdo de vídeo usando Speech to Text.
A primeira opção é enviar seu arquivo de áudio ao painel do ElevenLabs Playground. Ajuste as configurações de transcrição, edite o resultado diretamente no Editor de Transcrições e exporte no formato de arquivo necessário. O processo é rápido e simples, sem necessidade de programação.
Se você está criando seu próprio workflow de publicação de conteúdo, também pode transcrever usando a ElevenAPI. Adicione a API diretamente às ferramentas que você já está criando para obter as mesmas transcrições precisas sem precisar trocar de ferramenta.
Cadastre-se na ElevenLabs para começar a usar STT hoje ou saiba mais sobre como o Speech to Text para criadores está mudando o cenário.
Perguntas frequentes

Jack Limebear faz parte do time de Growth, atuando como redator e estrategista de conteúdo no blog e nas páginas de insights. Antes da ElevenLabs, ele passou mais de dez anos liderando estratégias de conteúdo em organizações que vão de startups SaaS em rápido crescimento a empresas da Fortune 500. Ele é mestre em Literatura Inglesa pela Universidade de Cambridge.



