
Guia de dicionário de pronúncia: corrija qualquer palavra no TTS do Eleven v4
- Escrito por
- Jack Limebear
- Publicado
- Última atualização
OuvirOuça este artigo
O Eleven v4 estabelece um novo padrão de desempenho em pronúncia para modelos de Text to Speech, lidando com abreviações, termos técnicos, nomes e textos em vários idiomas com mais precisão do que qualquer modelo anterior. Ainda assim, cada marca tem seu próprio vocabulário, de nomes de produtos exclusivos a jargões específicos do setor, e você vai querer ter controle total sobre como essas palavras soam.
Eleven v4 oferece várias formas de corrigir a pronúncia, dando a você controle detalhado sobre como o modelo fala. Você pode criar um dicionário de pronúncia completo que se aplica a todos os roteiros escritos no app de TTS. Ou escrever IPA diretamente no texto para uma correção pontual.
Veja um exemplo rápido do Eleven v4 lidando com um roteiro cheio de termos desafiadores:
Este guia explica como criar e usar um dicionário de pronúncia para TTS, além de todas as estratégias que você pode usar para fazer seu áudio soar o mais próximo possível do que imaginou.
Resumo
- Um dicionário de pronúncia é um conjunto de regras que você escreve para dizer a um modelo de Text to Speech como pronunciar palavras ou frases específicas.
- As regras de pronúncia para TTS podem ser baseadas em aliases, que substituem o texto, ou em fonemas, que usam uma grafia fonética.
- O Eleven v4 oferece suporte a regras de fonemas e IPA em linha (Alfabeto Fonético Internacional).
- As tags de fonema e pausa do SSML não funcionam no Eleven v4, mas você pode usar um dicionário de pronúncia ou Audio Tags como alternativa em linguagem natural.
- Você pode aplicar até três dicionários de pronúncia por solicitação usando a ElevenAPI.
O que é um dicionário de pronúncia?
Um dicionário de pronúncia é uma ferramenta que permite configurar exatamente como um modelo de Text to Speech pronuncia determinadas palavras. Ao adicionar palavras ou frases a um dicionário de pronúncia, você define como elas vão soar sempre que aparecerem em um roteiro de TTS.
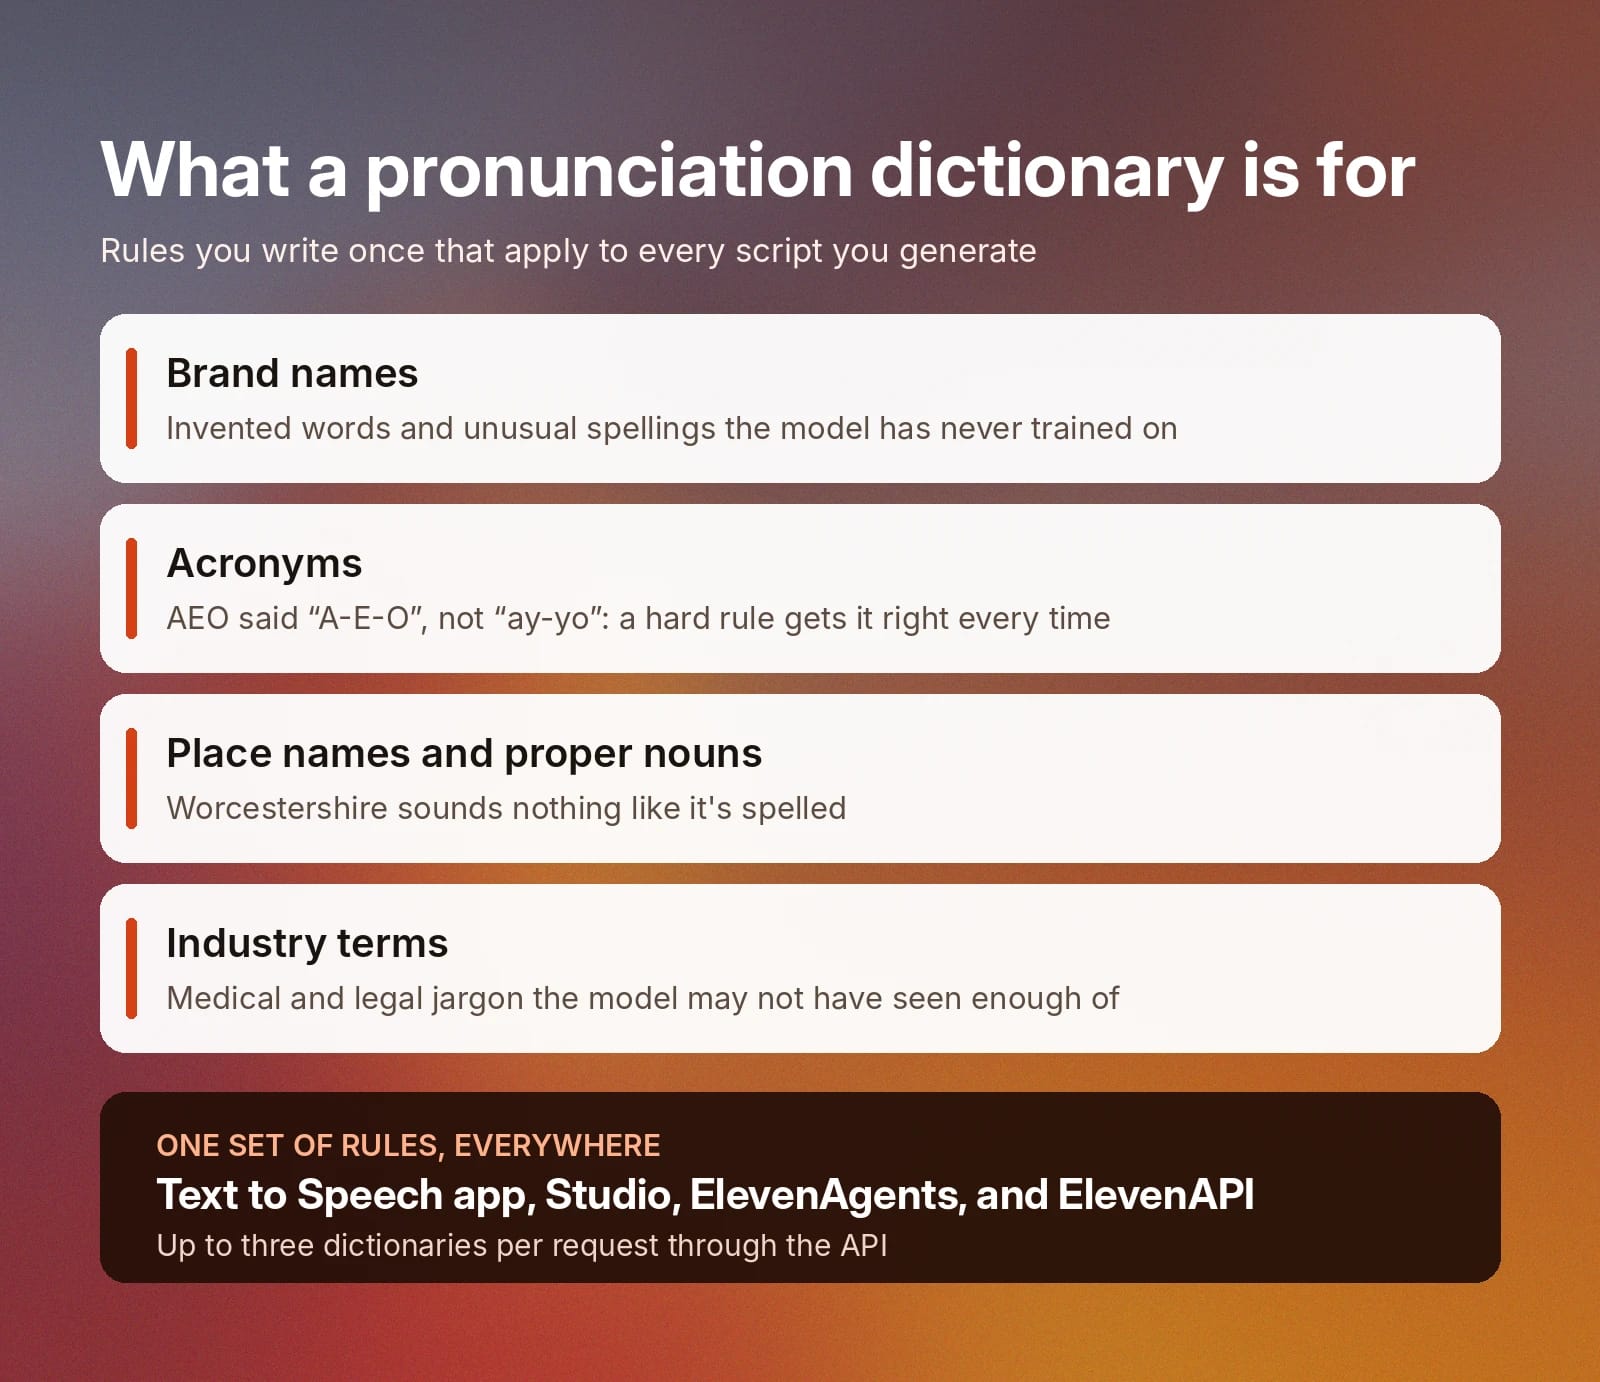
Os dicionários de pronúncia costumam ser usados para:
- Nomes de marcas: Nomes de marcas são entradas comuns em dicionários de pronúncia, especialmente quando têm grafias únicas ou incomuns.
- Siglas: Algumas siglas têm uma forma específica de serem pronunciadas. Por exemplo, AEO deve soar como /ˌeɪ.iːˈoʊ/ ("A-E-O"), e não como /eɪˈjoʊ/ ("ei-iô"). Uma regra fixa no dicionário garante que o modelo acerte sempre que você a escrever.
- Nomes de lugares e outros nomes próprios: Alguns nomes de lugares podem soar bem diferentes do que você imaginaria ao vê-los escritos. Worcestershire é um exemplo famoso, para o qual um guia de pronúncia pode ajudar a evitar problemas.
- Termos do setor: Jargões do setor ou termos especializados das áreas médica ou jurídica, por exemplo, podem se beneficiar de um dicionário de pronúncia se o modelo não tiver sido treinado explicitamente com dados desses setores.
Fora do contexto de Text to Speech, dicionários de pronúncia costumam ser repositórios colaborativos de clipes de áudio de falantes nativos, usados por estudantes para ouvir como determinadas palavras são pronunciadas.
Como controlar a pronúncia no TTS com o Eleven v4
O Eleven v4 é classificado como o modelo de Text to Speech de maior qualidade pelo Provider Voice Arena da Artificial Analysis.1 Parte do que torna o Eleven v4 líder de mercado é sua capacidade de lidar com textos complexos mantendo um resultado natural.
Para oferecer aos usuários a melhor experiência possível com o Eleven v4, o modelo conta com várias formas de personalizar a pronúncia e garantir que cada resultado atenda aos seus padrões de precisão.
Veja como controlar a pronúncia com o Eleven v4:
- IPA em linha: Você pode escrever IPA nos roteiros entre barras para orientar a pronúncia sem usar o dicionário de pronúncia. Vamos abordar em breve os detalhes de como fazer isso.
- Regras de fonemas em dicionários: Escreva regras baseadas em fonemas nos seus dicionários de pronúncia para controlar o som fonético de palavras recorrentes.
- Pronúncia fluente em vários idiomas: O Eleven v4 pode gerar fala natural em mais de 90 idiomas. Mantenha a pronúncia nativa em cada idioma usando a mesma voz para uma experiência consistente de identidade sonora.
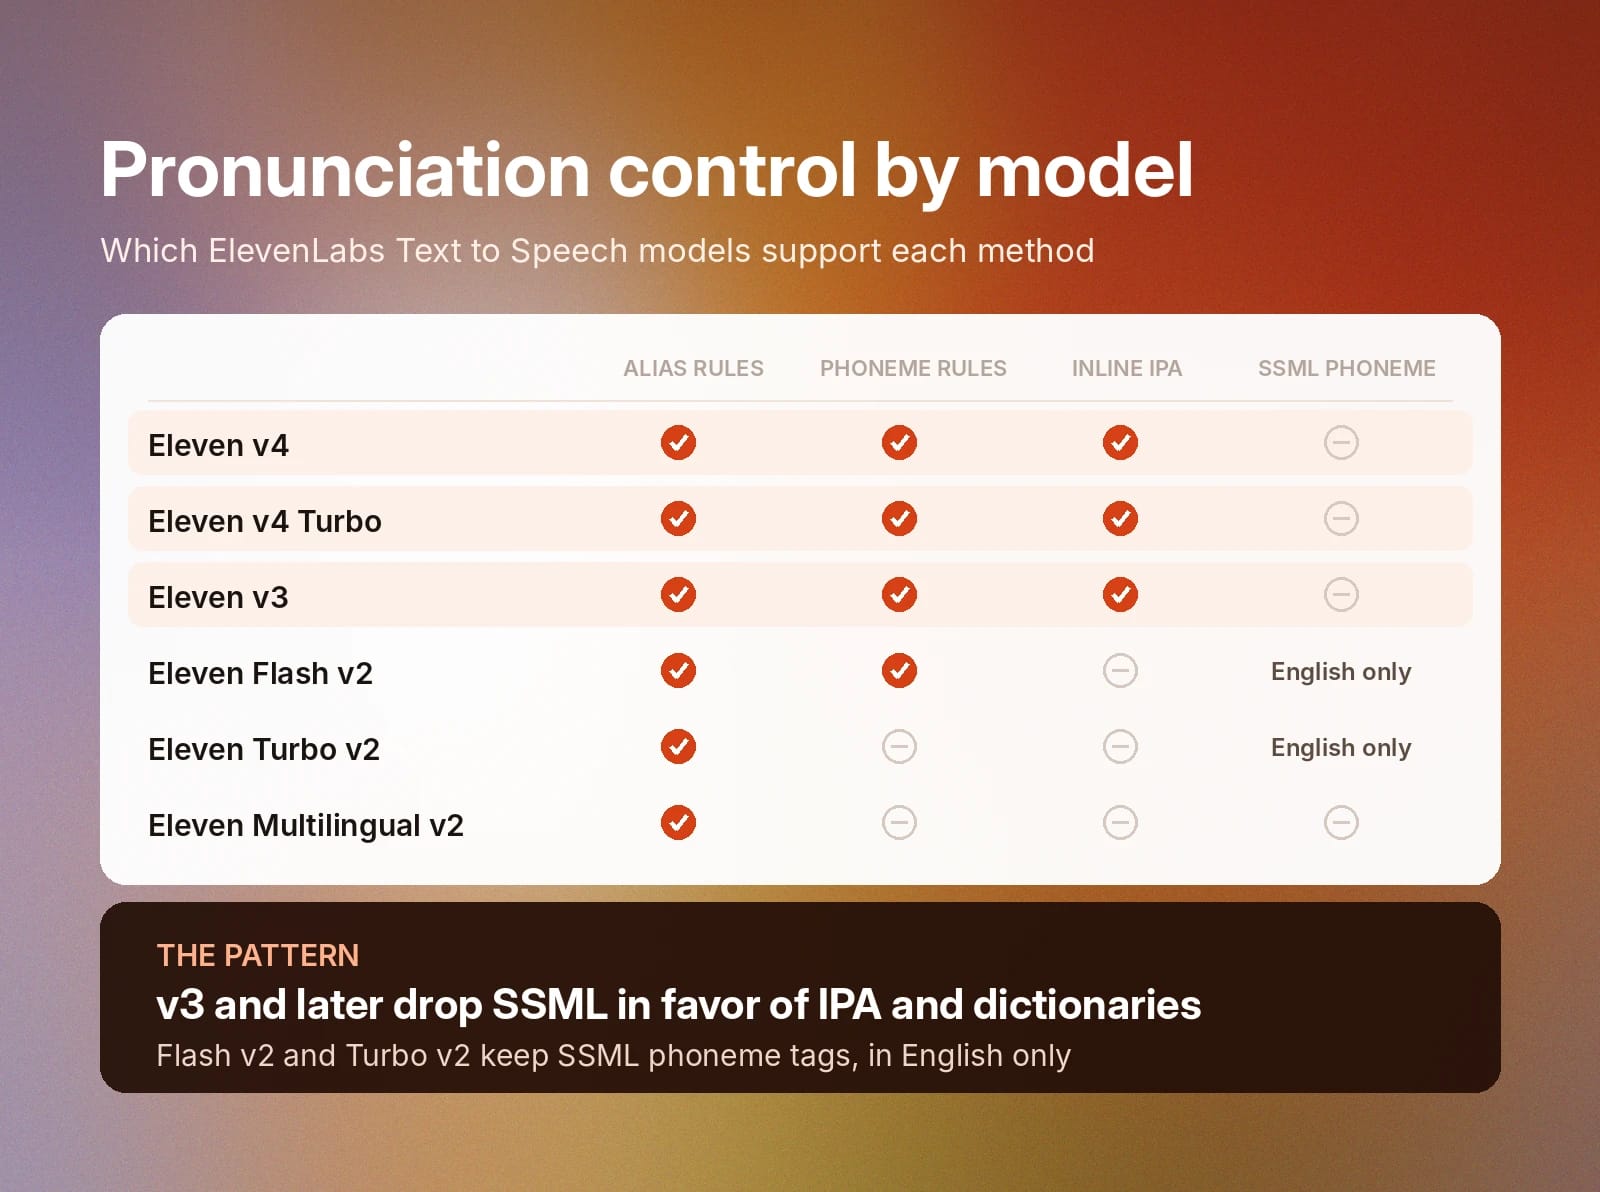
Veja como os diferentes modelos de TTS da ElevenLabs se comparam em controle de pronúncia:
Modelo
Regras de alias (dicionário)
Regras de fonemas (dicionário)
IPA em linha (/.../)
Tags de fonema SSML (<phoneme>)
Eleven v4
Sim
Sim
Sim
Não
Eleven v4 Turbo
Sim
Sim
Sim
Não
Eleven v3
Sim
Sim
Sim
Não
Eleven Flash v2
Sim
Sim
Não
Sim (somente em inglês)
Eleven Turbo v2
Sim
Não
Não
Sim (somente em inglês)
Eleven Multilingual v2
Sim
Não
Não
Não
Qual é a diferença entre regras de alias e de fonemas em um dicionário de pronúncia?
As regras de pronúncia por alias substituem um trecho de texto por outro antes de o modelo pronunciar a palavra. Isso acontece nos bastidores sempre que um modelo gera áudio, substituindo o som de uma palavra ou frase pelo que você incluiu no dicionário de pronúncia.
Veja alguns exemplos de regras de pronúncia por alias:
- “SaaS” se torna “sass”
- “UN” se torna “United Nations”
- “OAuth” se torna “oh auth”
Por outro lado, as regras de fonemas fornecem ao modelo uma grafia fonética exata para usar. Elas são mais difíceis de criar, pois você precisará escrever ou gerar a transcrição em IPA e inseri-la no dicionário. Por exemplo, "Kubernetes" se torna /ˌkuː.bərˈnɛt.iːz/.
Como corrigir a pronúncia de um nome de marca em um modelo de TTS
Nomes de marcas estão entre as entradas mais comuns em dicionários de pronúncia, pois nem sempre são palavras reais. Se sua empresa inventou uma palavra ou uma grafia exclusiva para sua marca, os modelos de TTS podem ter dificuldade para pronunciá-la corretamente, já que há poucos dados de treinamento acessíveis que incluam essa pronúncia específica.
Veja como corrigir a pronúncia de um nome de marca no Eleven v4:
- Teste o som padrão: Abra o app de Text to Speech e escreva o nome da sua marca. Gere um clipe e ouça como ele soa. Se houver um erro de pronúncia, siga para a próxima etapa.
- Experimente uma regra de alias: A maneira mais fácil de corrigir um erro de pronúncia de marca é criar uma regra de alias. Elas são rápidas de escrever e intuitivas.
- Mude para uma regra de fonemas: Se a regra de alias não funcionar bem, use IPA. Transcreva o nome da sua marca usando IPA e crie uma regra no dicionário de pronúncia de Text to Speech para corrigir a pronúncia.
- Inclua todas as formas de capitalização: Inclua a transcrição IPA para as versões em minúsculas e maiúsculas do nome da sua marca, caso use ambas.
- Use IPA em linha para alterações pontuais: Se você só precisa de uma correção rápida para uma geração pontual, basta adicionar o IPA diretamente ao roteiro em vez de configurar uma entrada no dicionário.
Depois de criar uma regra para o nome da marca, ela estará disponível em todos os projetos compartilhados dali em diante, seja no seu agente de IA ou via API.
Como criar um dicionário de pronúncia com a ElevenLabs
Você pode criar um dicionário de pronúncia adicionando regras no app de Text to Speech, enviando um arquivo .pls ou pela ElevenAPI. Neste guia, vamos abordar a primeira opção, que leva apenas alguns passos.
Veja os passos para criar um dicionário de pronúncia:
- Abra o painel de dicionários de pronúncia: Na página de Text to Speech, clique na barra de pesquisa na parte superior, digite "Dicionário de pronúncia" e selecione Dicionários de pronúncia em Ações.
- Crie ou escolha um dicionário: Clique em Novo para iniciar um dicionário novo ou selecione um existente na lista à esquerda.
- Adicione uma regra: Clique em Adicionar regra para criar uma nova linha. Insira a palavra que deseja corrigir. Digite no campo Entrada a palavra ou frase exatamente como ela aparece nos seus roteiros. As regras diferenciam maiúsculas de minúsculas, então use a mesma capitalização.
- Escolha o tipo de regra: Selecione Alias para substituir o texto ou Fonema para inserir uma grafia em IPA ou CMU.
- Insira a substituição: Digite o alias ou a grafia fonética no campo Saída. Use o seletor de voz na parte superior do painel para ouvir a regra com a voz que está usando.
- Salve as alterações: Clique em Salvar alterações na parte inferior do painel.
Para vincular um guia de pronúncia a um agente ou aplicar um via API, siga nossa documentação sobre dicionários de pronúncia.
Como usar IPA em Text to Speech no Eleven v4
Para pequenas alterações ou palavras incomuns, não é necessário criar uma nova entrada no dicionário de pronúncia de TTS para corrigir um erro. Em vez disso, você pode usar IPA em linha para detalhar exatamente como o modelo deve pronunciar uma palavra.
No Eleven v4, você pode ativar o IPA em linha usando barras. Assim como as Audio Tags, elas são inseridas diretamente no roteiro para deixar tudo o mais simples possível. Veja alguns exemplos de IPA no Eleven v4:
- Termos técnicos: O termo "/ˌbaɪoʊˈkemɪstri/" se refere ao estudo de processos químicos.
- Vocabulário médico: "/ɡluːˈkoʊs/" e "/ˈɪnsjəlɪn/" são usados com frequência para controlar condições como "/ˌdaɪəˈbiːtiːz/".
- Nomes de marcas e produtos: Nossos servidores usam "/ˌɛndʒɪnˈɛks/" para lidar com picos de tráfego.
Como observação, para quem não tem formação em linguística, usar um conversor de IPA ajudará você a obter o IPA correto a partir de uma entrada em linguagem natural para colar no roteiro.
Por que as tags de fonema SSML não funcionam no Eleven v4
O Eleven v4 não oferece suporte a SSML e opta por recursos mais flexíveis, como Audio Tags e dicionários de pronúncia, que dão a você mais controle sobre a produção final de áudio.
Cada recurso oferecido pelo SSML tem uma alternativa direta no v4:
Tag SSML
O que fazia
Alternativa no Eleven v4
<phoneme>
Definia uma pronúncia fonética
IPA em linha (/…/) ou uma regra de fonemas no dicionário
<sub alias>
Substituía texto antes da fala
Uma regra de alias no dicionário
<break>
Adicionava uma pausa
Audio Tags como [pause], reticências ou quebras de linha
<prosody rate>
Alterava a velocidade da fala
Audio Tags de ritmo como [slowly] ou [rushed]
<emphasis>
Dava ênfase a uma palavra
Letras maiúsculas ou uma Audio Tag de entonação
Comece a usar a pronúncia natural de Text to Speech no Eleven v4
Com várias ferramentas para refinar a precisão das pronúncias no Eleven v4, você pode escrever roteiros detalhados e fazer o modelo interpretá-los como imaginou.
Crie dicionários de pronúncia no app de Text to Speech da ElevenLabs e aplique-os em escala com a ElevenAPI.
Cadastre-se para começar ou saber mais sobre o Eleven v4 hoje.
Perguntas frequentes
- Artificial Analysis, Provider Voice Arena Preference Elo, 30 de setembro de 2026

Jack Limebear faz parte do time de Growth, atuando como redator e estrategista de conteúdo no blog e nas páginas de insights. Antes da ElevenLabs, ele passou mais de dez anos liderando estratégias de conteúdo em organizações que vão de startups SaaS em rápido crescimento a empresas da Fortune 500. Ele é mestre em Literatura Inglesa pela Universidade de Cambridge.


