Tags SSML explicadas: como controlar pausas, pronúncia e ritmo no Text to Speech
- Escrito por
- Jack Limebear
- Publicado
OuvirOuça este artigo
Speech Synthesis Markup Language (SSML) é uma linguagem de marcação baseada em XML que envolve texto em tags para indicar a um modelo de Text to Speech como ele deve falar, incluindo onde pausar, como pronunciar uma palavra e qual frase enfatizar.
Essa camada de controle está por trás de grande parte das vozes criadas com IA que você já ouve. Tanto um sistema de resposta audível interativa (IVR) que repete um número de confirmação quanto um audiolivro com IA cujo narrador pausa no fim de um capítulo dependem de alguma versão dela. Se você já personalizou vozes geradas por IA, provavelmente já se deparou com SSML.
O SSML faz parte da tecnologia de TTS há mais de duas décadas e ainda é essencial para a forma como muitos provedores oferecem TTS. Este guia explica o que é SSML e exatamente onde ele se aplica na linha de modelos da ElevenLabs, além do aprimorado sistema de Audio Tags que o Eleven v3 e o Eleven v4 usam para oferecer Text to Speech com uma naturalidade de ponta.
Veja o Eleven v4 em ação com Audio Tags
Conheça o Eleven v4Resumo
- SSML é uma linguagem de marcação baseada no W3C usada para controlar pausas vocais, ênfase, pronúncia e ritmo em falas sintetizadas.
- Os modelos da ElevenLabs, exceto o Eleven v3 e o Eleven v4, oferecem suporte à tag SSML <break> para pausas de até 3 segundos.
- O Eleven Flash v2 e o Eleven Turbo v2 oferecem suporte à tag <fonema> para pronúncia personalizada em inglês.
- O Eleven v3 e o Eleven v4 não oferecem suporte a SSML. Em vez disso, usam Audio Tags com instruções em linguagem natural entre colchetes, como [whispering] e [sighs], para controlar o fluxo da fala sintetizada.
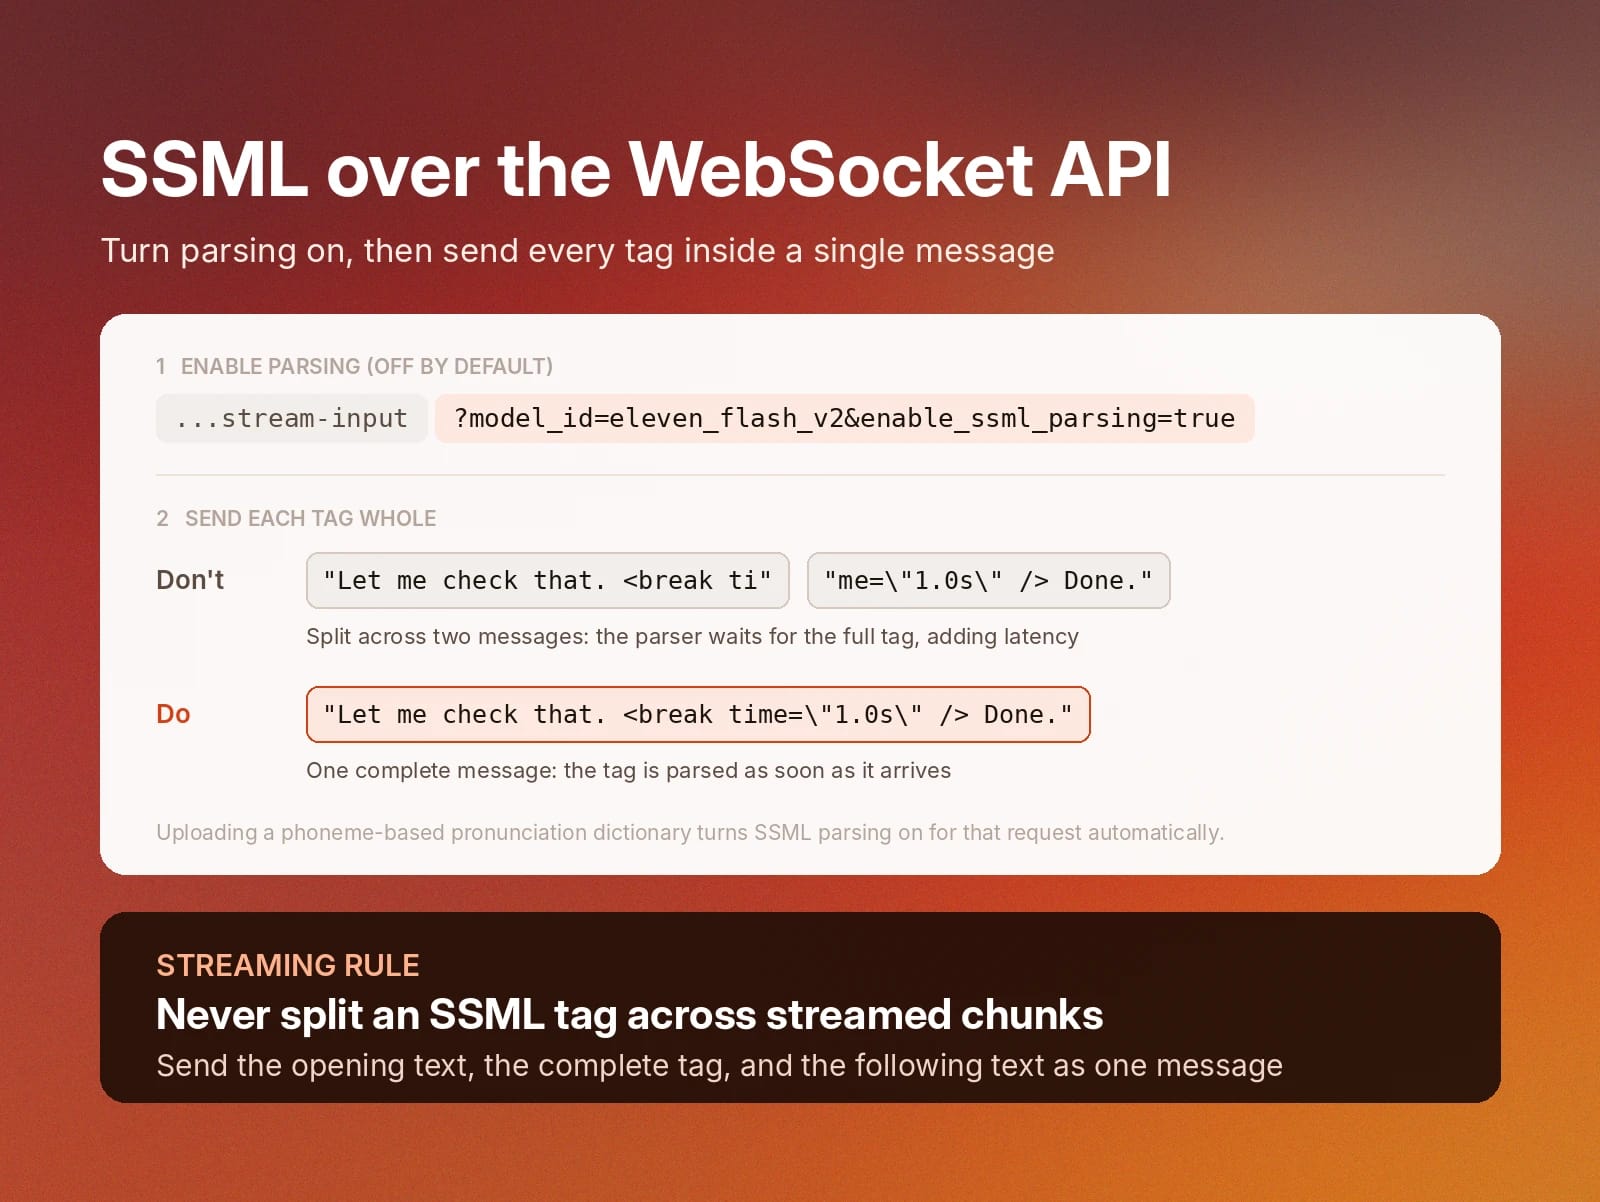
- A API WebSocket controla a análise de SSML pelo parâmetro enable_ssml_parsing e envia as tags SSML como mensagens completas para evitar latência adicional.
- Tags como <prosody>, <say-as>, <sub>, <lang>, <voice> e <audio> não são compatíveis com os modelos da ElevenLabs, mas cada uma tem um equivalente: configurações de voz, normalização de texto, dicionários de pronúncia, modelos multilíngues, vozes separadas e efeitos sonoros.
O que é SSML?
SSML é uma linguagem de marcação que permite anotar texto escrito com instruções sobre como um mecanismo de síntese deve falá-lo. O World Wide Web Consortium (W3C) a desenvolveu como um padrão para ir além dos modelos simples de Text to Speech. O SSML oferece instruções explícitas e legíveis por máquina sobre como uma passagem deve ser pronunciada, em vez de depender de modelos de interpretação de texto simples.
SSML não é uma marcação exclusiva e restrita a um único provedor. Amazon Polly e Microsoft Azure Speech usam tags SSML, como <break> e <emphasis>, como principal mecanismo de controle. A maioria das plataformas de Text to Speech na nuvem aceita alguma versão do padrão. O SSML já era a forma padrão de anotar falas muito antes de existirem modelos de voz generativa.
O SSML continua sendo um padrão fundamental, enquanto controles mais recentes e específicos de cada modelo surgem junto às tecnologias modernas de voz generativa. Essa especificação neutra em relação a fornecedores permite que provedores implementem tags principais em comum. Depois, eles podem adicionar suas próprias extensões e restrições sobre essas tags.
Tags SSML comuns para melhorar a entonação e suas funções
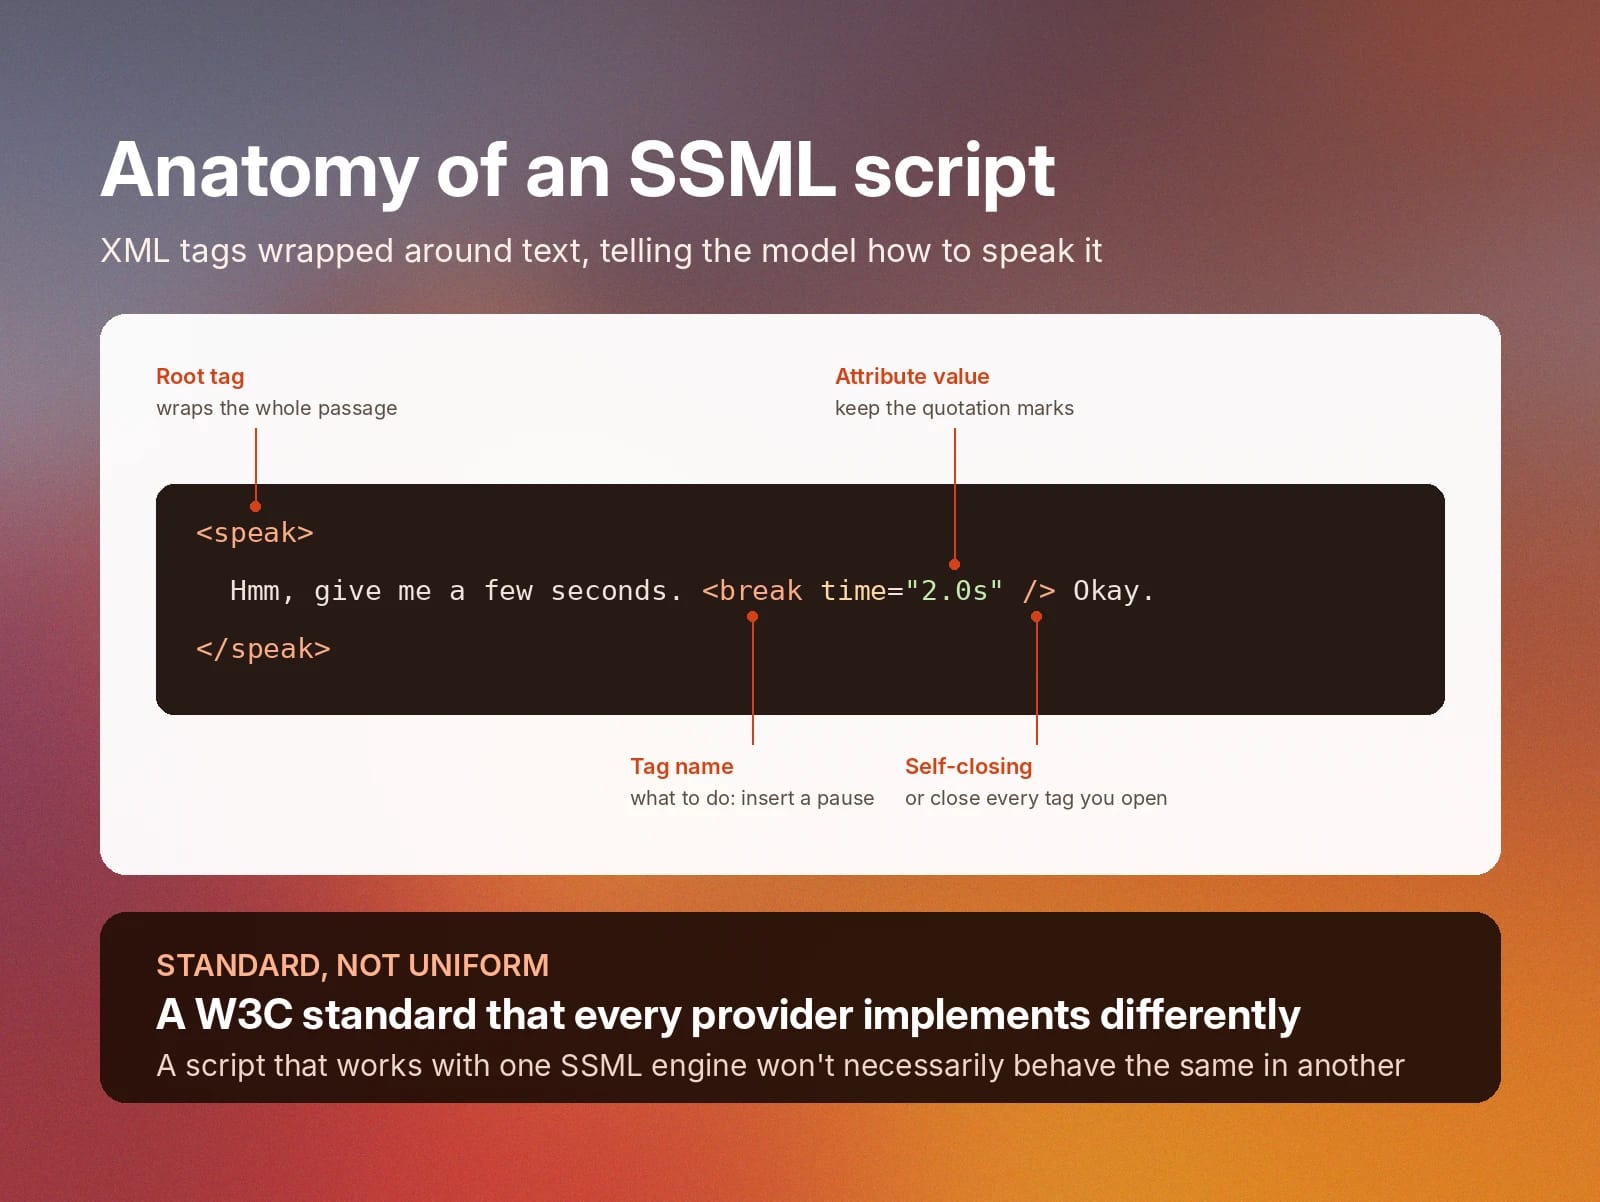
As implementações de SSML compartilham um conjunto principal de tags que a maioria das pessoas procura ao tentar controlar falas sintetizadas.
Estas são as tags SSML mais comuns:
- <speak>: esta é a tag raiz que envolve toda a passagem. A maioria das implementações exige seu uso para reconhecer o conteúdo interno como SSML.
- <break>: insere uma pausa por uma duração especificada, útil para criar uma cadência natural entre orações ou frases, ou gerar suspense em um texto.
- <phoneme>: especifica a pronúncia exata de uma palavra com um alfabeto fonético, como IPA ou CMU Arpabet, sendo útil para siglas, nomes ou termos técnicos.
- <emphasis>: enfatiza uma palavra ou frase, imitando como um falante naturalmente aumenta ou reduz o peso de seu significado.
Cada uma dessas quatro tags se comporta de forma diferente dependendo do modelo de TTS que a lê. Alguns provedores oferecem suporte a tags adicionais para prosódia ou velocidade de fala. Um roteiro escrito para um provedor de TTS não terá o mesmo comportamento em outro, mesmo que ambos afirmem oferecer suporte a SSML, porque a cobertura do conjunto completo de tags varia.
O que mais varia é quais tags um determinado modelo de Text to Speech realmente processa, e é aí que a implementação da ElevenLabs se torna específica.
Como usar SSML com a ElevenLabs
O suporte a SSML na ElevenLabs não é totalmente uniforme. Ele depende do modelo selecionado para gerar o áudio. A tag <break> é o elemento mais amplamente compatível, enquanto <phoneme> está disponível em um conjunto menor de modelos.
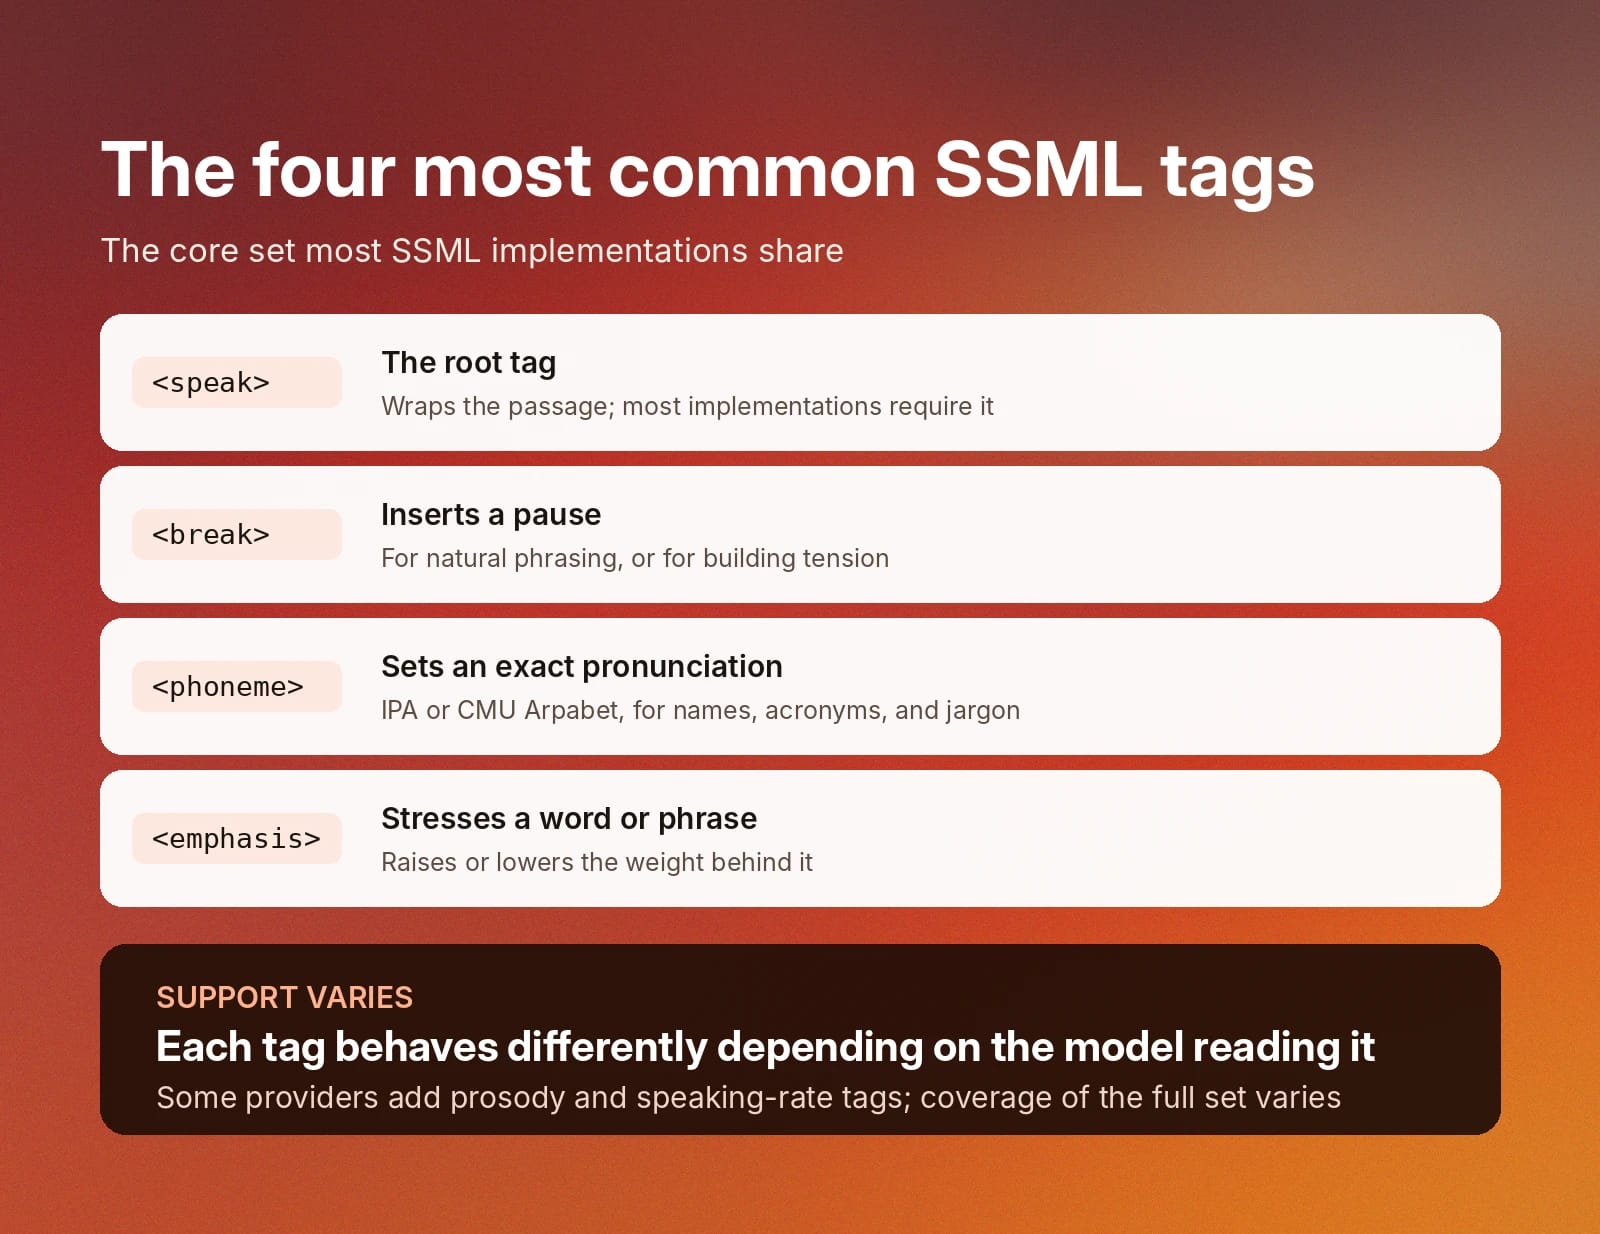
Modelos TTS mais antigos da ElevenLabs, como o Multilingual v2, oferecem suporte à tag <break> para pausas de até três segundos. Por exemplo, um agente de IA pode dizer: "Espere, deixa eu pensar" e usar <break time="2.0s" /> para criar uma pausa audível antes de continuar com "Certo, sei como ajudar". Essa é a tag mais comum em muitos workflows, pois ajuda a simular um estilo de conversa mais natural.
Ao usar tags SSML, é melhor limitar-se a poucas de uma vez. Usar muitas em uma frase ou parágrafo pode fazer o modelo mudar a velocidade inesperadamente ou apresentar diversos artefatos de áudio. Vozes diferentes também lidam com pausas de maneiras distintas, especialmente vozes treinadas com amostras que incluem expressões de preenchimento como "ahn" ou "hum".
SSML na prática com a ElevenLabs
Os modelos Flash v2 e Turbo v2 da ElevenLabs vão além e também oferecem suporte à tag <phoneme> para pronúncias personalizadas, limitada ao inglês. Isso torna a tag phoneme útil para corrigir a pronúncia de um nome, sigla, termo técnico ou outra terminologia de negócios. Isso se aplica desde que o roteiro seja executado em um desses dois modelos.
Por outro lado, o Eleven v3 e o Eleven v4 rompem completamente com esse padrão. Eles usam Audio Tags para controlar a interpretação. Além disso, o Eleven v4 apresenta suporte nativo a IPA inline, permitindo que símbolos IPA entre barras sejam lidos diretamente no texto. A seguir, veremos o que substitui a tag break e os controles de interpretação.
Para ver todos os controles de Text to Speech da ElevenLabs, incluindo dicionários de pronúncia e normalização de texto, consulte o guia de boas práticas.
Exemplos de código SSML com a ElevenLabs
Os exemplos abaixo mostram SSML em um roteiro e em uma chamada de API. Lembre-se de que <break> funciona em todos os modelos, exceto no Eleven v4 e no Eleven v3, e <phoneme> funciona apenas no Flash v2 e no Turbo v2, somente em inglês.
Como implementar SSML para adicionar uma pausa ao controle de voz
Envolva o texto e a tag em um bloco <speak> e mantenha as aspas ao redor do valor do atributo:
Encontre mais informações sobre pausas e tags phoneme SSML pela ElevenAPI.
Corrija uma pronúncia com <phoneme>
Use IPA ou CMU Arpabet para especificar exatamente como uma palavra deve soar. Aqui, o nome "Siobhan" é orientado por IPA, enquanto "Madison" é definido com CMU Arpabet:
Gere fala com SSML em Python
Esta chamada envia um roteiro com uma tag break para um modelo compatível:
Gere fala com SSML em JavaScript
Abaixo está um exemplo semelhante de geração de fala com SSML, mas escrito em JavaScript.
SSML e a API WebSocket: como usar SSML com APIs de TTS
Transmitir áudio pela API WebSocket da ElevenLabs em vez de uma solicitação HTTP padrão exige a ativação explícita da análise de SSML. Ela vem desativada por padrão e pode ser controlada pelo parâmetro enable_ssml_parsing.
Para melhores resultados, recomendamos enviar cada tag SSML como uma mensagem completa e autocontida, em vez de dividi-la entre vários blocos transmitidos. Dividir uma tag no meio de uma mensagem aumenta a latência, pois o analisador precisa da tag completa antes de agir sobre ela.
Fazer upload de um dicionário de pronúncia baseado em fonemas ativa automaticamente a análise de SSML para a solicitação, mesmo quando o parâmetro enable_ssml_parsing não foi definido especificamente. Para informações completas sobre os parâmetros e a formatação de mensagens disponível para a API WebSocket, consulte este guia da documentação sobre geração de áudio em tempo real.
O exemplo abaixo ativa a análise de SSML na URL de conexão e envia a tag break completa em uma única mensagem:
Tags SSML sem suporte da ElevenLabs e o que usar em vez delas
Com a adoção do sistema de Audio Tags, os modelos Text to Speech da ElevenLabs oferecem aos usuários mais flexibilidade e controle detalhado sobre seus resultados de áudio. As Audio Tags também são escritas inteiramente em linguagem natural, o que facilita muito incluí-las nos seus roteiros.
Se você trabalha com um modelo anterior da ElevenLabs, pode ser útil saber quais tags SSML são compatíveis. Como existem várias alternativas preferenciais, os modelos mais antigos da ElevenLabs agora processam apenas <break> e <phoneme>, enquanto as outras tags SSML são cobertas por outros métodos.
Outras tags SSML que você talvez conheça da especificação do W3C não são lidas como marcação, por isso cada uma exige uma abordagem diferente. Veja o que usar no lugar de outras tags SSML na ElevenLabs:
Tag SSML
O que faz
O que usar em vez disso
<prosody>
Define altura, velocidade de fala e volume
As configurações de velocidade e estabilidade da voz. No Eleven v3 e no Eleven v4, Audio Tags de interpretação, como [slowly] ou [rushed]
<emphasis>
Enfatiza uma palavra ou frase
Letras maiúsculas ou pontuação para dar ênfase. No Eleven v3 e no Eleven v4, tags como [shouts]
<say-as>
Controla como números, datas e siglas são lidos
Normalização de texto, escrever o valor por extenso ou uma regra de dicionário de pronúncia
<sub>
Substitui a forma falada de uma palavra escrita
Uma regra de alias de dicionário de pronúncia
<lang>
Muda o idioma de uma frase
Um modelo multilíngue, com a frase escrita no idioma de destino
<voice>
Muda o falante no meio do roteiro
Uma geração separada para cada voz ou diálogo com vários falantes no Eleven v3 e no Eleven v4
<audio>
Insere um arquivo de áudio ou som gravado
Audio Tags de efeitos sonoros no Eleven v3 e v4, a ferramenta de efeitos sonoros da ElevenLabs ou mixagem do áudio após a geração
Prosódia: altura, velocidade de fala e volume com SSML
A tag <prosody> do SSML ajusta a altura, a velocidade de fala e o volume em um trecho de texto. Nos modelos anteriores da ElevenLabs, você controla o ritmo pela configuração de velocidade da voz e a expressividade pela configuração de estabilidade, ambas aplicadas a toda a geração, e não a uma única frase.
Para mudar o ritmo dentro de um roteiro, divida o texto em gerações separadas ou adicione tags <break> entre as frases. No Eleven v3 e v4, use as Audio Tags da tabela acima, como [slowly], [rushed] e [whispers], inseridas diretamente na linha.
Pronúncia: <phoneme>, <say-as> e <sub> com SSML
A ElevenLabs oferece três alternativas para controlar a pronúncia nos seus resultados de TTS.
Estes são os principais métodos que você pode usar:
- Use <phoneme> para uma correção pontual no Flash v2 ou Turbo v2, como no exemplo acima.
- Use um dicionário de pronúncia para termos recorrentes em muitos roteiros. Um dicionário pode conter regras de fonemas e regras de alias que funcionam como <sub>, por exemplo, mapeando "UN" para "Nações Unidas".
- Para os casos tratados por <say-as>, como números, datas, moedas e telefones, conte com a normalização de texto, que converte valores escritos em palavras faladas. Quando um valor precisa ser lido de uma única forma, como um número de confirmação, escreva-o por extenso ou separe os dígitos no roteiro.
Idioma e localidade
A tag <lang> do SSML identifica uma frase como pertencente a outro idioma. Os modelos TTS da ElevenLabs não leem essa tag. Em vez disso, escolha um modelo multilíngue e escreva a frase no idioma em que ela deve ser falada.
O Flash v2 e o Turbo v2 funcionam apenas em inglês, então roteiros que misturam idiomas precisam de um modelo multilíngue, como o Multilingual v2, Flash v2.5, o Eleven v3 ou o Eleven v4. O Eleven v4 e o v3 também oferecem suporte a tags de sotaque, como [French accent], e a transcrição IPA em mais de 70 idiomas.
Áudio e efeitos sonoros
A tag <audio> do SSML reproduz um clipe gravado dentro de uma resposta falada. Essa é uma tag SSML que a ElevenLabs não oferece suporte, pois nossos modelos de TTS podem gerar novos efeitos sonoros a partir dos seus prompts em linguagem natural.
Para adicionar som dentro da própria fala, basta escrever a tag de efeito sonoro, como [applause] ou [door slamming], e ver o Eleven v4 e o Eleven v3 darem vida a ela. Para um design de som mais longo ou detalhado, gere o efeito sonoro separadamente e faça a mixagem com a faixa de voz no seu editor ou workflow de produção.
Boas práticas de SSML com a ElevenLabs
Se você trabalha com um dos modelos TTS mais antigos da ElevenLabs, as tags SSML ainda têm suporte parcial. Lembre-se: você pode migrar para o Eleven v4 a qualquer momento e aproveitar ao máximo as Audio Tags, sem nunca mais precisar procurar a formulação exata de uma tag SSML.
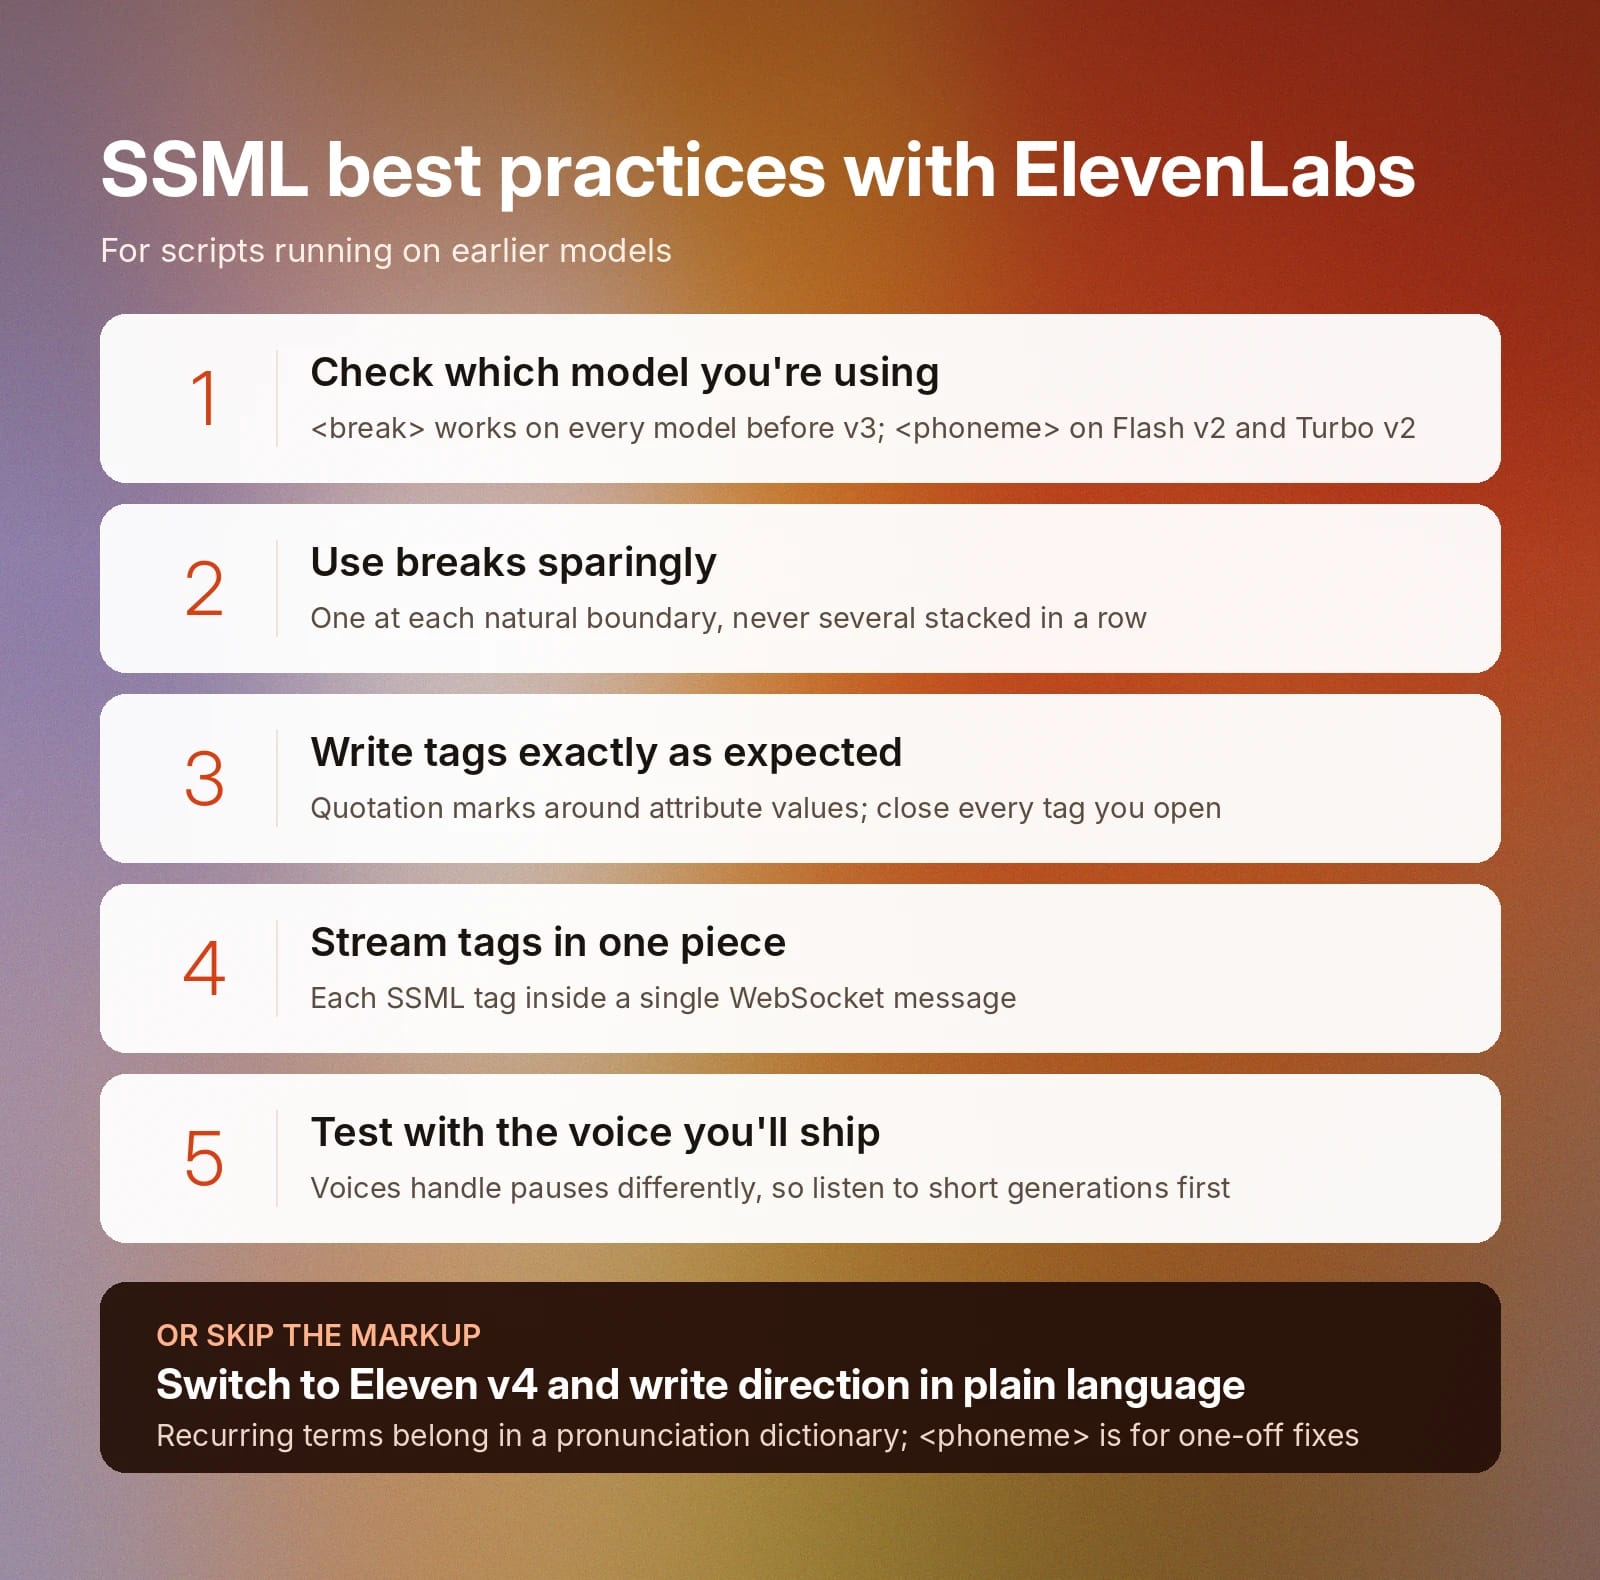
Ao trabalhar com SSML na ElevenLabs, estas dicas ajudam você a começar:
- Verifique qual modelo você está usando: <break> funciona em todos os modelos, exceto o Eleven v3; <phoneme> funciona apenas no Flash v2 e Turbo v2; e as Audio Tags funcionam apenas em modelos mais recentes, como o Eleven v4 e o Eleven v3.
- Use pausas com moderação: coloque uma em cada limite natural, em vez de empilhar várias seguidas.
- Escreva as tags SSML corretamente: mantenha as aspas ao redor dos valores de atributos, por exemplo <break time="2.0s" />, e feche todas as tags que abrir.
- Transmita tags inteiras: envie cada tag SSML em uma única mensagem WebSocket.
- Teste com a voz que você vai usar: as vozes lidam com pausas de forma diferente, portanto ouça gerações curtas antes de executar um roteiro completo. A ElevenLabs tem mais de 17.500 vozes em nossa Voice Library.
Além dessas boas práticas de SSML, é uma boa ideia usar um dicionário de pronúncia para termos que aparecerão com frequência. Para correções pontuais, <phoneme> é a melhor opção.
Quais são os principais casos de uso do SSML?
O Speech Synthesis Markup Language é usado principalmente para controlar ou ajustar com precisão como um mecanismo de TTS produz um clipe de áudio. É uma ferramenta útil para inserir pausas, refinar a pronúncia de determinada palavra e incorporar um senso de prosódia à fala gerada por IA.
Veja alguns casos de uso em que o padrão SSML é útil:
- Sistemas de resposta audível interativa (IVR): úteis quando um sistema IVR precisa pausar entre um prompt e um menu ou ler números com clareza.
- Agentes conversacionais: adicionar uma breve pausa antes da resposta para que a interação soe natural.
- Audiolivros e narração longa: pausar ao final de capítulos e entre cenas para marcar claramente a transição entre momentos.
- E-learning e treinamento: corrigir a pronúncia de nomes de produtos, termos técnicos, siglas e termos específicos de negócios.
- Notificações e alertas: controlar como datas, horários e códigos de referência são lidos.
Embora o SSML ofereça diversos casos de uso, todos eles podem ser realizados com Audio Tags, sem a necessidade de memorizar e inserir tags SSML muitas vezes complexas em seus roteiros. O Eleven v4 e o Eleven v3 criaram o sistema de Audio Tags para dar aos usuários controle completo sobre os resultados de fala gerados por IA, sem a complexidade do SSML.
Por que o Eleven v4 usa Audio Tags em vez de SSML
O Eleven v4 usa Audio Tags como um mecanismo diferente para controlar a interpretação e refinar a pronúncia. Ele lê instruções inline entre colchetes, diretamente do texto do roteiro, permitindo que você escreva em linguagem natural para criar determinado resultado. Essas Audio Tags abrangem uma ampla variedade de instruções, incluindo:
- Emoções ou sentimentos, como [sad] ou [excited]
- Interpretação e ritmo, como [whispers] ou [rushed]
- Reações humanas, como [sighs] ou [laughs]
- Sotaques e vozes de personagens, como [French accent]
- Efeitos sonoros, incluindo [applause] ou [door shutting]
O motivo desse design está na forma como o modelo lê o contexto de uma conversa. A arquitetura do Eleven v4 lê o contexto com mais profundidade do que os modelos anteriores, permitindo que acompanhe sinais emocionais, mudanças de tom, transições de falante e pistas contextuais sem parâmetros ou configurações separados.
O SSML fornece instruções específicas em um ponto fixo do texto, fazendo com que a interpretação pareça rígida e truncada. O SSML é um dos principais motivos pelos quais textos com IA soam robóticos, apesar da alta qualidade dos modelos subjacentes.
Uma indicação como [whisper] dá ao Eleven v4 uma orientação interpretativa aplicada à linha ao redor, moldada pela prosódia de tudo que a cerca.
A maioria dos elementos SSML tem um equivalente direto no v4:
Tag SSML
O que faz
Equivalentes no Eleven v4
<break time="1s">
Insere uma pausa
[pause], reticências ou uma quebra de linha
<prosody rate="slow">
Desacelera a fala
[drawn out] ou [slowly]
<prosody rate="fast">
Acelera a fala
[rushed]
<emphasis>
Enfatiza uma palavra específica
[shouts] ou escrever uma palavra em maiúsculas
<prosody pitch="high">
Aumenta a altura da voz
Tags emocionais, como [excited]
<prosody pitch="low">
Reduz a altura da voz
Tags emocionais, como [sorrowful]
A pronúncia segue o mesmo padrão de substituição. O IPA está incluído como suporte nativo do Eleven v4, com transcrição em mais de 90 idiomas. Isso permite que equipes controlem a pronúncia sem as tags XML necessárias, adicionando a transcrição entre barras diretamente no texto.
Comece a criar falas naturais no ElevenCreative
As Audio Tags dão aos roteiros as pausas, emoções, ritmo e estilo vocal que um dublador interpretaria diretamente no texto. O Eleven v4 leva essa expressividade a um workflow completo de produção, combinando os modelos de voz da ElevenLabs com modelos de imagem e vídeo para transformar um roteiro em uma peça finalizada de áudio ou vídeo em um só espaço de trabalho.
Veja como as Audio Tags se transformam em áudio finalizado com o Eleven v4 ou crie uma conta gratuita para experimentar SSML e Audio Tags nos seus próprios roteiros hoje.
Perguntas frequentes

Jack Limebear faz parte do time de Growth, atuando como redator e estrategista de conteúdo no blog e nas páginas de insights. Antes da ElevenLabs, ele passou mais de dez anos liderando estratégias de conteúdo em organizações que vão de startups SaaS em rápido crescimento a empresas da Fortune 500. Ele é mestre em Literatura Inglesa pela Universidade de Cambridge.