O que são Audio Tags? O guia completo para TTS emocional
- Escrito por
- Jack Limebear
- Publicado
- Última atualização
OuvirOuça este artigo
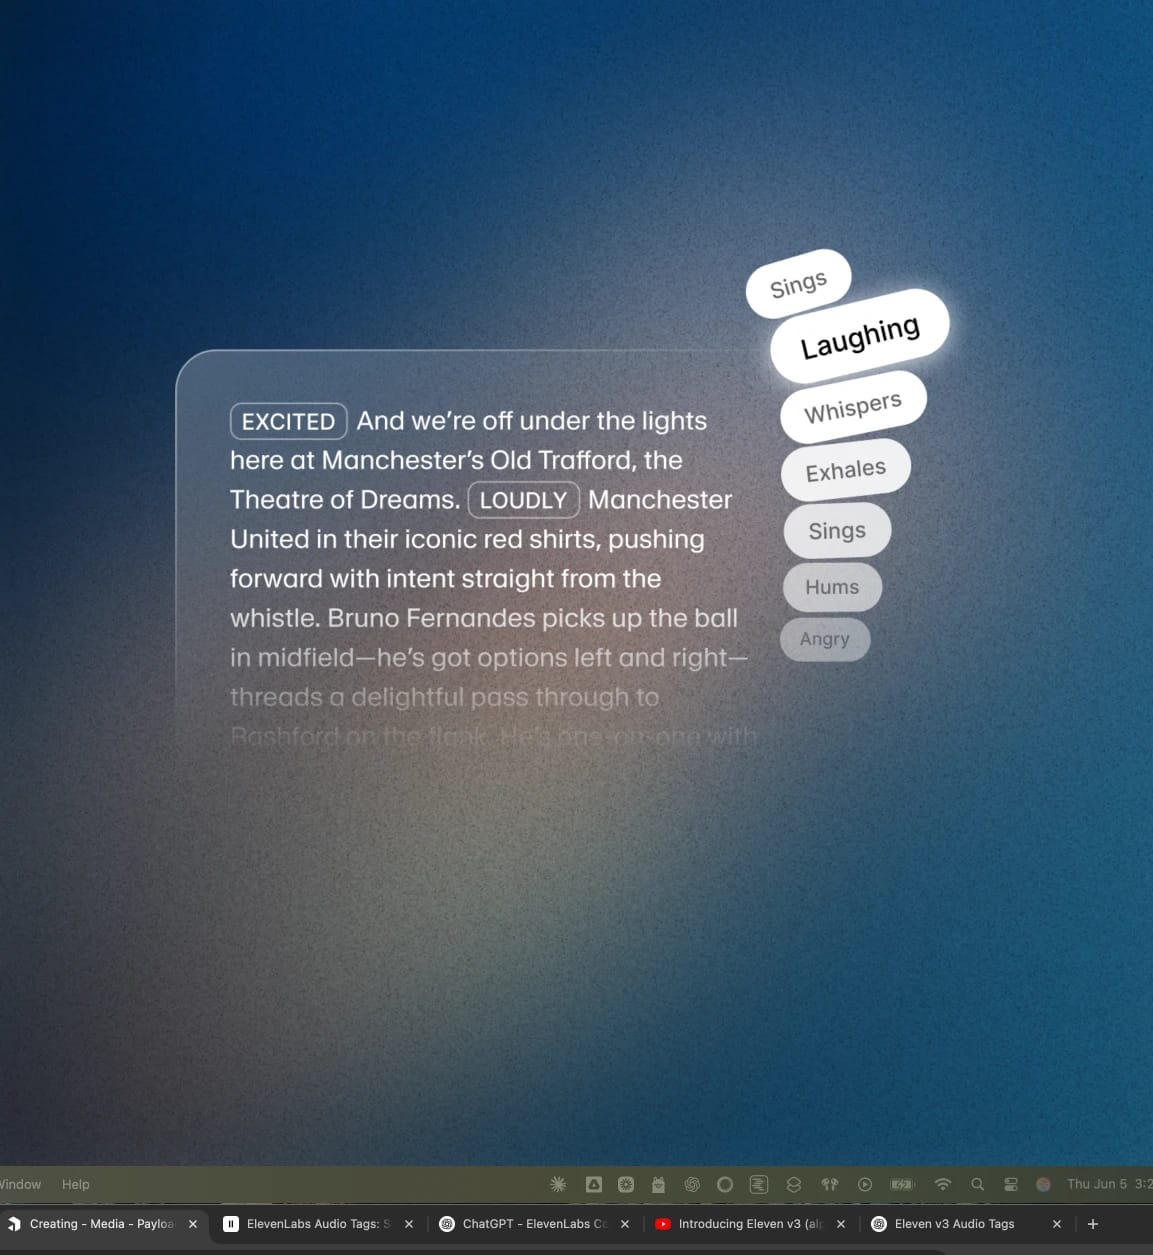
Audio Tags são instruções em linguagem natural entre colchetes, como [laughs], [gasps], [excited] e [worried], que o Eleven v3 e o Eleven v4 interpretam como direcionamento de performance, e não como palavras a serem faladas. Ao escrever um roteiro para um modelo de Text to Speech, inserir essas Audio Tags dá a você controle detalhado sobre a entrega emocional do texto.
Eleven v3 ficou disponível publicamente em março de 2026. Antes do v3, obter uma performance emocional específica de um modelo de Text to Speech exigia regenerar conteúdo e torcer pelo melhor. As Audio Tags eliminam essa incerteza e dão a você controle total sobre uma performance emocional de conversão de texto em voz. Eleven v4 vai ainda mais longe, oferecendo controle emocional detalhado.
Este guia explica o que são Audio Tags, como funcionam, todas as categorias de tags disponíveis e como se comparam ao SSML (Speech Synthesis Markup Language). Também abordaremos casos de uso comuns, cada um com seu próprio guia detalhado.
Resumo
- Audio Tags são instruções entre colchetes, como [shouts] ou [excited], que direcionam a emoção, o ritmo, a entrega e o tom no TTS do Eleven v3 e do Eleven v4.
- O Eleven v3 e o Eleven v4 não oferecem suporte a SSML, mas o substituem por Audio Tags para uma experiência de escrita mais natural.
- As tags abrangem algumas categorias, como emoções, entrega e ritmo, reações humanas, sotaques e efeitos sonoros.
- A pontuação e o uso de maiúsculas no texto permitem moldar o ritmo da performance de uma voz IA.
- Você pode acessar Audio Tags na ElevenLabs pela interface ou pela API.
Como as Audio Tags funcionam?
As Audio Tags ficam no meio da transcrição e são envolvidas por colchetes. Sempre que quiser mudar a entrega, por exemplo, de normal para [worried], basta adicionar uma audio tag.
Você também pode usar mais de uma tag em uma única frase e combiná-las para criar uma performance com mais camadas, como [tired] Foi um dia longo… [upset] Quantos dias mais eu aguento?
A arquitetura por trás do Eleven v4 permite que o modelo leia o contexto em um nível mais profundo do que os modelos anteriores, acompanhando instruções emocionais, mudanças de tom, transições entre falantes e pistas contextuais sem precisar de um parâmetro ou configuração separados. Basta dizer ao modelo o que o momento pede, e ele executará a fala exatamente como você planejou.
O Eleven v4 também lida com diálogos entre várias pessoas que soam espontâneos, incluindo interrupções, mudanças de humor e a troca natural de uma conversa real, tudo apenas com tags e a estrutura do roteiro.
Audio Tags vs. SSML
Se você já trabalhou com outros sistemas de TTS, provavelmente conhece o Speech Synthesis Markup Language. Plataformas como Amazon Polly e Microsoft Azure Speech usam tags de SSML, como <break> ou <emphasis>, para adicionar algum contexto extra a um roteiro de TTS.
O Eleven v4 não oferece suporte a tags de pausa do SSML nem ao restante do conjunto de tags de SSML. Em vez disso, Audio Tags, a pontuação e a própria estrutura do texto assumem essa função, ao mesmo tempo que oferecem controle detalhado sobre a entrega.
Você pode usar a tabela abaixo para relacionar tags comuns de SSML aos equivalentes no Eleven v4.
Do ponto de vista de quem escreve, adicionar [whispers] a uma fala exige muito menos esforço do que configurar uma taxa de prosody.
As categorias de Audio Tags no v3: direcionando a performance com Audio Tags
Você pode colocar Audio Tags em qualquer lugar do roteiro para moldar a entrega em tempo real. Também pode usar combinações de tags em um roteiro ou até mesmo em uma frase.
As tags se dividem nas seguintes categorias principais.
Emoções
Essas tags ajudam a definir o tom emocional da voz, seja ele sombrio, intenso ou animado. Por exemplo, você pode usar uma ou uma combinação de [sad], [angry], [happily] e [sorrowful].
Entrega e ritmo
Elas têm mais relação com o tom e a performance. Você pode usar essas tags para ajustar o volume e a energia em cenas que exigem contenção ou intensidade. Alguns exemplos são [whispers], [shouts] e [softly].
Reações humanas
A fala realmente natural inclui reações. Por exemplo, você pode adicionar realismo inserindo momentos naturais e não roteirizados à fala. Tags como [laughs], [clears throat] e [sighs] ajudam a criar um modelo de TTS capaz de transmitir emoção humana.
Outros exemplos de categorias de audio tags incluem:
- Sotaques e vozes de personagens: As tags de sotaque mudam a voz para uma região ou persona específica sem trocar de modelo, como [French accent], [British accent] ou [pirate voice]. Use-as para transformar uma única voz em um elenco versátil, em vez de uma performance fixa.
- Efeitos sonoros: Tags de efeitos sonoros adicionam áudio não falado diretamente à geração, como [gunshot], [explosion] e [clapping]. Elas funcionam bem em áudios imersivos, jogos e narrações dramatizadas, quando a cena precisa de mais do que uma voz. Como alternativa, use o gerador de efeitos sonoros com IA ElevenCreative.
Embora as tags ofereçam um alto grau de controle, você também pode usar a pontuação para moldar o ritmo e a ênfase. Por exemplo, adicione reticências para uma pausa natural ou use vírgulas para criar padrões naturais de respiração. Experimente escrever uma palavra toda em maiúsculas para dar ênfase: “Eu quero isso AGORA.”
O que você pode fazer com Audio Tags?
Audio Tags liberam a complexidade emocional dos roteiros de forma intuitiva. Escreva naturalmente e adicione tags ao longo do processo.
Veja rapidamente alguns casos de uso de TTS emocional com Audio Tags.
Consciência situacional em áudio criado com IA
Tags como [whisper] ou [shouting] permitem que o Eleven v4 reaja ao momento. De suavizar um aviso a manter uma pausa prolongada para criar suspense, você pode incorporar consciência situacional dinâmica ao roteiro.
Para uma explicação completa, confira nosso guia sobre consciência situacional em áudio criado com IA.
Direcionando a performance de personagens na fala
Ao criar um roteiro com vários personagens, você precisa mostrar claramente como cada voz é diferente. De ajustar a personalidade com [sarcastically] a definir como falam com [British accent], você pode capturar toda uma gama de emoções com nosso mecanismo de TTS.
Saiba mais sobre como direcionar a performance de personagens em fala com IA.
Expressando contexto emocional na fala
As Audio Tags permitem moldar a entrega emocional de uma fala conforme ela avança. Você pode desenvolver emoções ao longo de um discurso e chegar a um clímax no momento em que imagina seu personagem em todo o seu potencial. Tags como [awe], [booming] e [big laugh] ajudam a construir uma gama emocional completa na performance da sua voz IA.
Leia mais sobre como usar contexto emocional na fala com IA.
Dando vida a diálogos com vários personagens
Ao criar performances de diálogo com vários personagens, você pode começar cada fala com uma audio tag para criar conversas ricas entre personagens.
Veja o exemplo a seguir: Tom: [coughing] [beginning to speak] desculpa, estou um pouco doente hoje— Emma: [interrupting] —Doente? Você sabe como eu odeio tosse, Tom! Tom: [surprised] É só uma tossinha, não é nada sério. Como você se sentiria se— Emma: [overlapping] [annoyed] —Acho que você precisa ir para casa.
Veja o que mais você pode fazer com diálogos com vários personagens no Eleven v3.
Controle preciso da entrega para fala com IA
Você pode controlar o ritmo da fala com o Eleven v3 e o Eleven v4 usando Audio Tags ou pontuação. Tags como [pause], [rushed] ou [drawn out] permitem moldar ativamente a fala com precisão. Como alternativa, adicione reticências, pontos finais e pontos de exclamação para criar emoção naturalmente na sua performance de TTS.
Escrevemos um guia detalhado sobre controle preciso da entrega no Eleven v3.
TTS emocional está disponível na API
As Audio Tags funcionam da mesma forma por meio da API de Text to Speech e na interface da ElevenLabs. Escreva a tag junto ao texto do roteiro, e a API retornará a performance marcada no áudio gerado, de fluxos de produção de audiolivros a locuções de anúncios.
Saiba mais sobre Eleven v4 ou fale com vendas para começar hoje.
Perguntas frequentes sobre Audio Tags e TTS emocional

Jack Limebear faz parte do time de Growth, atuando como redator e estrategista de conteúdo no blog e nas páginas de insights. Antes da ElevenLabs, ele passou mais de dez anos liderando estratégias de conteúdo em organizações que vão de startups SaaS em rápido crescimento a empresas da Fortune 500. Ele é mestre em Literatura Inglesa pela Universidade de Cambridge.