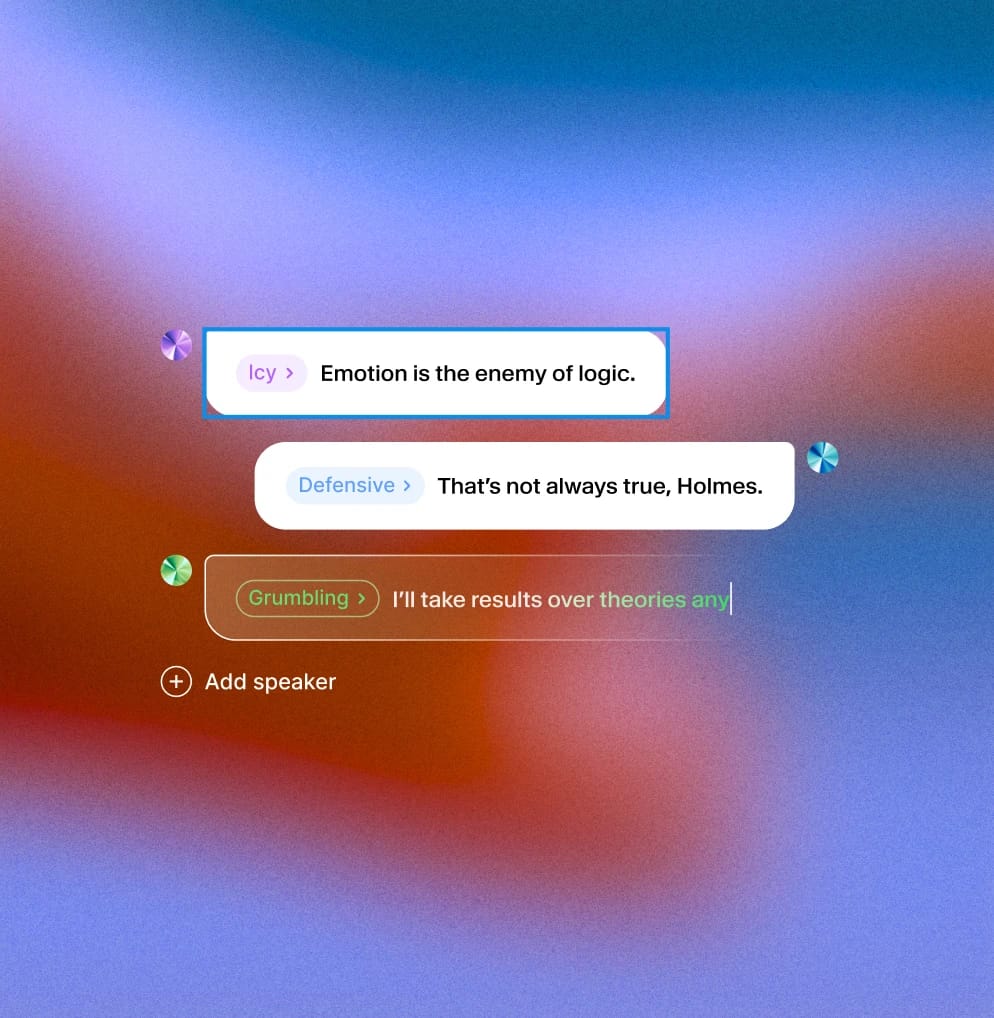
Eleven v3 Audio Tags: Dando consciência situacional ao áudio com IA
- Escrito por
- Ryan Morrison
- Publicado
- Última atualização
OuvirOuça este artigo
As Audio Tags são uma parte fundamental do novo modelo Eleven v3 (alpha) de Text to Speech. Elas permitem controlar como as falas são entregues — ajustando o tom, a emoção e o ritmo para refletir o contexto do mundo real.
Em sua forma mais simples, Audio Tags são palavras entre colchetes. O modelo as interpreta como instruções de interpretação. Isso significa que você pode ajustar a entrega no meio da frase para refletir momentos emocionais ou mudanças de situação — dando à IA certo nível de consciência situacional.
O que é consciência situacional em vozes de IA?
Consciência situacional significa que a IA adapta sua entrega ao momento. Com as Audio Tags, você controla não apenas o que o modelo diz — mas também como ele responde.
Seja para dar urgência com a tag [SHOUTING], suavizar um aviso com [WHISPER] ou indicar hesitação com [SIGH], as tags transformam a narração em interpretação. Elas são especialmente valiosas em cenas dinâmicas ou com muito contexto.
Interpretação, não apenas leitura
Imagine que você está criando o roteiro de um vídeo de melhores momentos no Veo 3 de uma partida de futebol entre o 11 United e o 12 United. Você quer que a intensidade aumente com a ação: “Ele passa por um defensor — [EXCITED] vem o cruzamento — [SHOUTING] GOOOOL!”
Ou você está narrando um momento de suspense em um audiolivro: “[WHISPERING] Acho que tem alguém na casa. [PAUSE] Fique em silêncio.”
Isso não são meros complementos de estilo. As tags definem o momento e determinam como ele é sentido. O modelo não apenas lê — ele interpreta.
Tags comuns para uso situacional
As Audio Tags permitem simular diversos sinais emocionais e físicos:
- Tom emocional: [EXCITED], [NERVOUS], [FRUSTRATED], [TIRED]
- Reações: [GASP], [SIGH], [LAUGHS], [GULPS]
- Volume e energia: [WHISPERING], [SHOUTING], [QUIETLY], [LOUDLY]
- Ritmo e cadência: [PAUSES], [STAMMERS], [RUSHED]
As tags podem ser combinadas para adicionar nuances: “[NERVOUSLY] Eu... não tenho certeza se isso vai funcionar. [GULPS] Mas vamos tentar mesmo assim.”
Uma interpretação que você pode dirigir
O Eleven v3 oferece suporte a essas tags com um modelo contextual mais avançado. Ele pode mudar o tom no meio da fala, lidar com interrupções e manter o fluxo — proporcionando uma entrega mais natural sem precisar reescrever o roteiro.
Para designers de voz, desenvolvedores de jogos e contadores de histórias, isso abre uma nova camada criativa. Você não está apenas escrevendo falas. Está dirigindo como elas são interpretadas.
Como escolher a voz certa
No momento, os Clones de Voz Profissionais (PVCs) não estão totalmente otimizados para o Eleven v3, o que pode resultar em uma qualidade de clone inferior à dos modelos anteriores. Nesta etapa de prévia de pesquisa, o ideal é encontrar um Voice Clone Instantâneo (IVC) ou uma voz criada para o seu projeto, caso você precise usar os recursos do v3. A otimização de PVCs para o v3 chegará em breve.
Ryan se juntou à ElevenLabs após mais de duas décadas em notícias e publicações, incluindo cargos na BBC e Future Plc. Ele se concentra em estratégia de conteúdo e storytelling, ajudando a ElevenLabs a moldar e compartilhar sua narrativa.