
O que é diarização de locutores? Como funciona e casos de uso
- Escrito por
- Jack Limebear
- Publicado
- Última atualização
OuvirOuça este artigo
A diarização de locutores recebe um fluxo de áudio com um número desconhecido de locutores e produz uma linha do tempo de segmentos identificados: locutor A de 0:00 a 0:42, locutor B de 0:42 a 1:15 e locutor A novamente a partir de 1:15. O sistema não sabe quem são os locutores, mas sabe que são pessoas diferentes e mantém os identificadores consistentes durante toda a gravação.
Esse processo é o que torna o áudio com vários locutores utilizável. Anotações de reuniões, análises de call center, transcrições de entrevistas, edição de podcasts e registros jurídicos dependem de saber não apenas o que foi dito, mas também quem disse.
Este guia explica como a diarização funciona, como ela difere de técnicas relacionadas, como segmentação e identificação, quais ferramentas de código aberto realizam essa tarefa e como medir se um sistema de diarização tem bom desempenho.
Resumo
- A diarização de locutores segmenta uma gravação de áudio de acordo com quem está falando, produzindo turnos de fala identificados sem identificar ninguém pelo nome.
- A diarização de locutores difere da segmentação de locutores, que detecta quando os locutores mudam, e da identificação de locutores, que associa vozes a nomes reais.
- O desempenho da diarização é medido pela taxa de erro de diarização (DER), referente à precisão geral, e pela taxa de erro de Jaccard (JER), que verifica se essa precisão se mantém para todos os locutores.
O que é diarização de locutores e como ela funciona?
A diarização de locutores é o processo de dividir um fluxo de áudio em segmentos conforme quem está falando. Uma transcrição com diarização de locutores identifica cada segmento de áudio com a identidade de um locutor. Em resumo, ela responde à pergunta: "Quem falou quando?"
Uma transcrição bruta de uma reunião mostra as palavras, enquanto uma transcrição diarizada informa que o locutor 1 fez a pergunta, o locutor 2 respondeu e o locutor 3 interrompeu no meio.
A maioria dos sistemas de diarização de locutores segue um pipeline com quatro etapas:
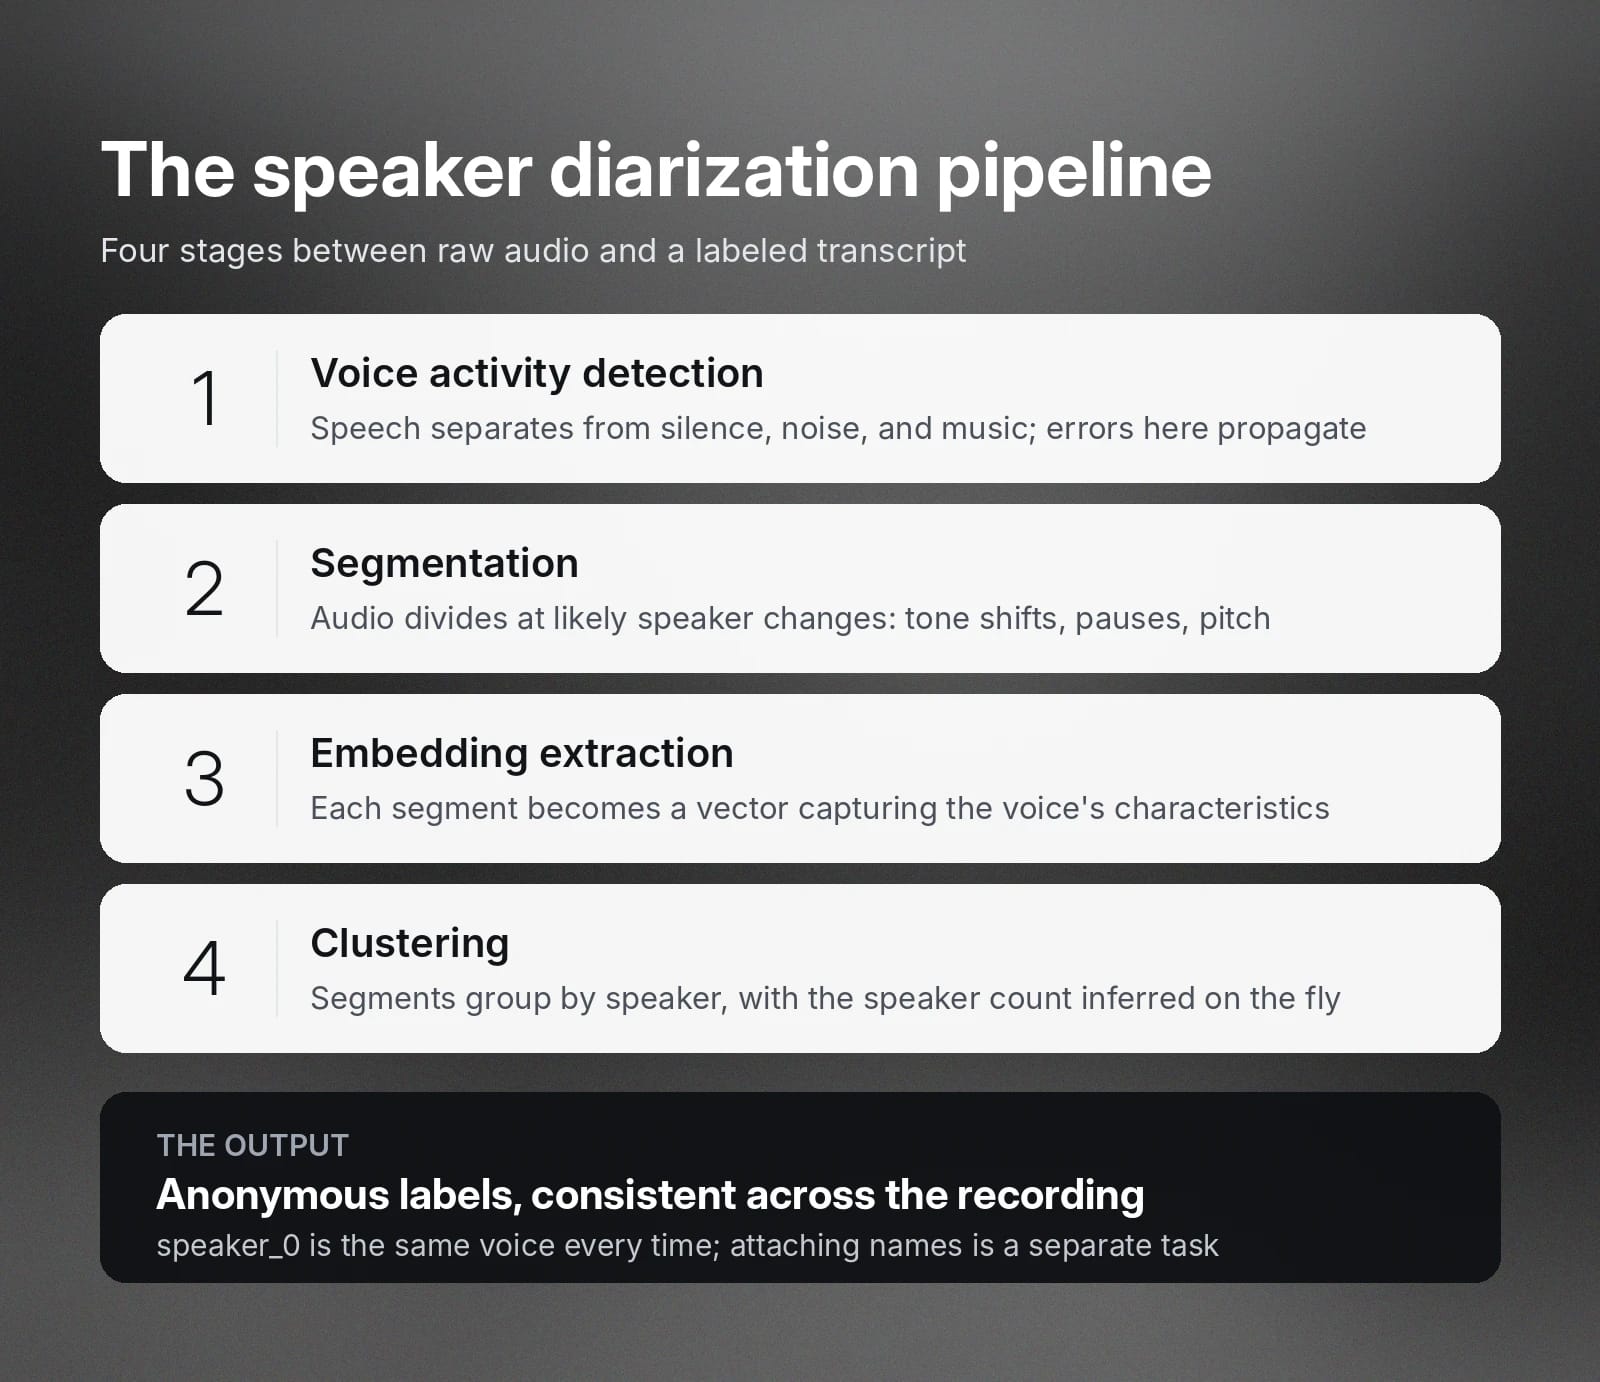
Vamos detalhar melhor essas etapas.
Detecção de atividade de voz (VAD)
A detecção de atividade de voz separa a fala de todo o resto: silêncio, ruído de fundo, música ou cliques de teclado. Apenas os segmentos de áudio que contêm fala de fato seguem para a próxima etapa.
Se houver erros nessa etapa, eles se propagarão por todas as etapas seguintes.
Segmentação
Esses segmentos que contêm fala são então divididos em pontos nos quais é provável que o locutor mude, por exemplo, uma alteração no tom de voz, uma pausa entre turnos ou uma mudança no padrão de entonação. A maioria dos sistemas detecta esses pontos de mudança diretamente, comparando as características acústicas de cada lado de um limite candidato.
Algumas ferramentas de segmentação dividem o áudio em janelas curtas e uniformes, como trechos de dois segundos, e depois usam a etapa de agrupamento para unir janelas adjacentes que pertencem ao mesmo locutor.
Extração de embeddings
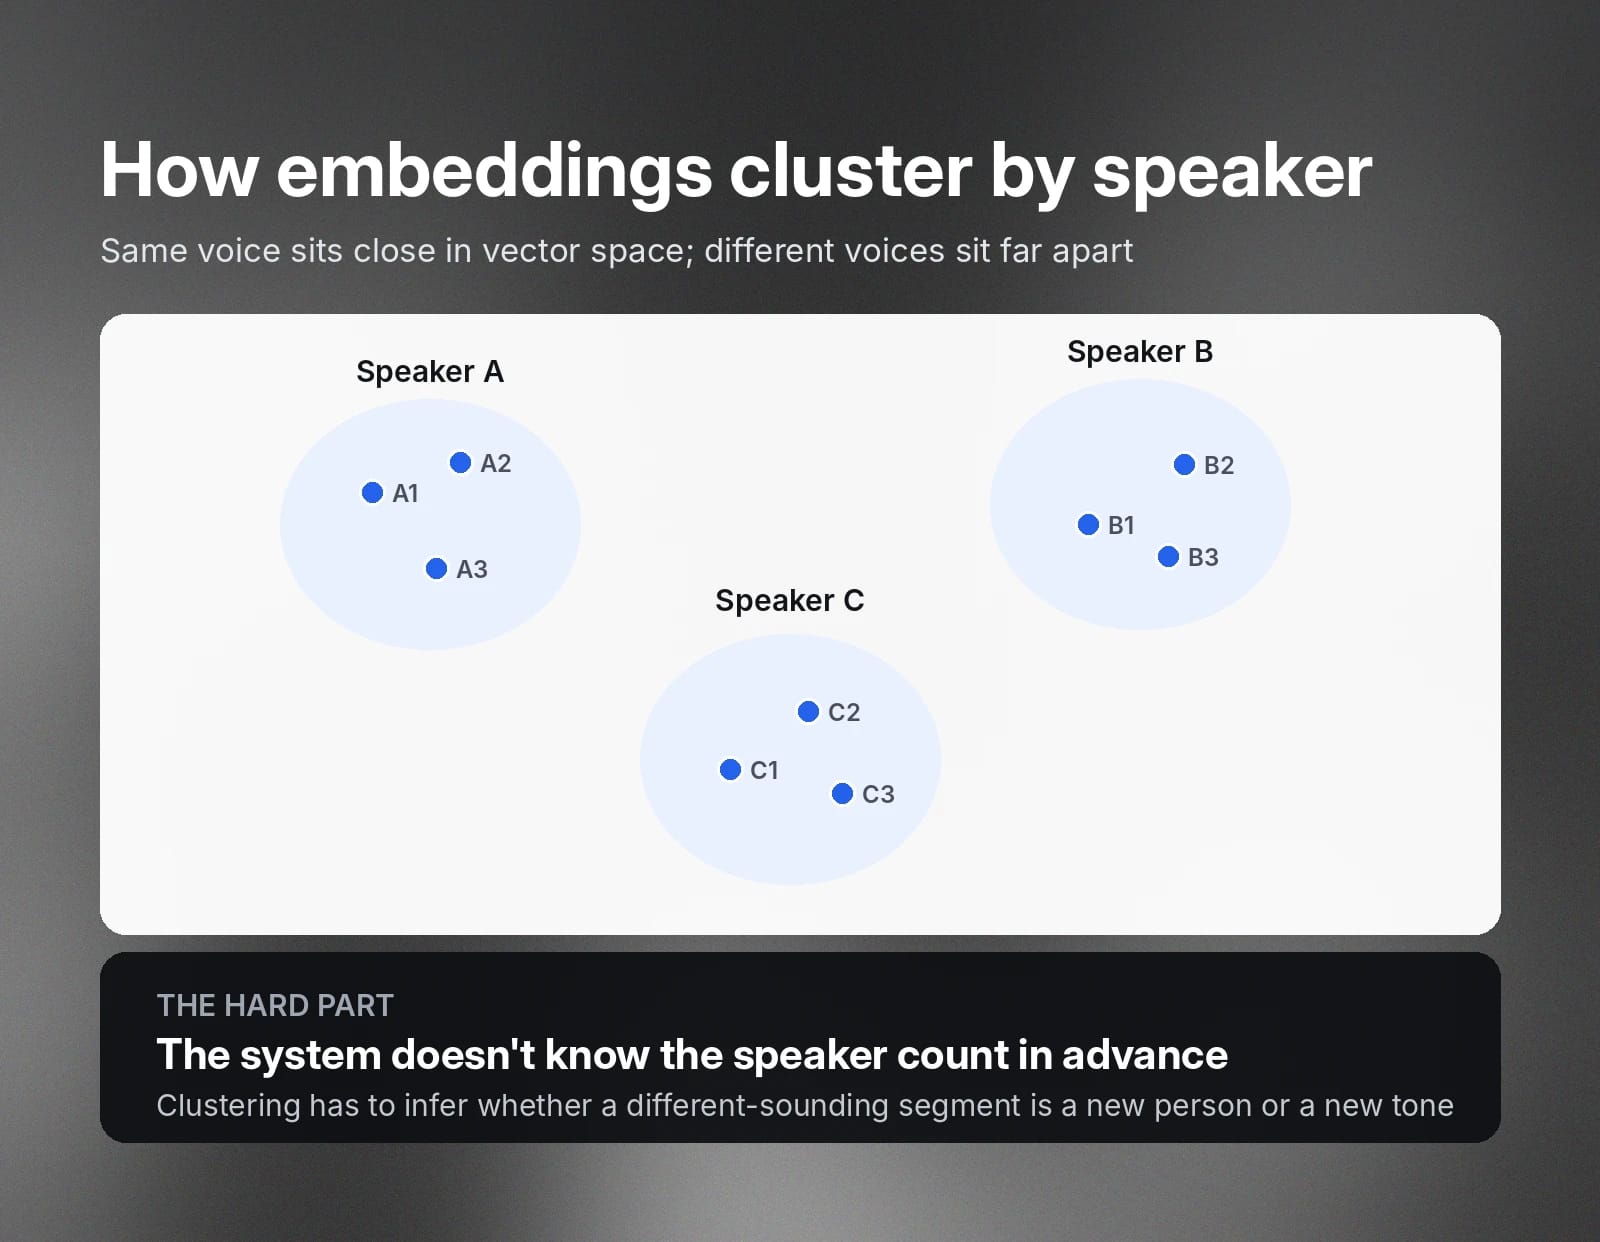
Cada segmento de fala é convertido em um embedding de locutor, ou seja, um vetor numérico que captura as características vocais de quem está falando nesse segmento. Os embeddings do mesmo locutor ficam próximos no espaço vetorial, enquanto os embeddings de locutores diferentes ficam mais distantes.
Agrupamento
Os embeddings são então agrupados para que segmentos do mesmo locutor compartilhem um identificador. O sistema normalmente não sabe antecipadamente quantos locutores há, então o algoritmo de agrupamento precisa inferir isso, decidindo se aquele segmento com som um pouco diferente é de um novo locutor ou da mesma pessoa falando com outro tom.
O resultado é um conjunto de identificadores de locutores associados a intervalos de tempo, geralmente acompanhado de uma transcrição. Por exemplo, uma transcrição diarizada de uma ligação entre duas pessoas seria assim:
- [speaker_0] Obrigado por ligar. Como posso ajudar?
- [speaker_1] Olá, estou ligando sobre minha fatura do mês passado.
- [speaker_0] Claro, deixe-me consultar isso.
Os identificadores são anônimos e internamente consistentes. Speaker_0 é a mesma voz sempre que aparece, mas o sistema não sabe que speaker_0 se chama Fergal. Associar identidades reais é uma tarefa diferente, que abordamos abaixo.
Principais diferenças entre segmentação e identificação de locutores
A segmentação e a identificação de locutores têm grande sobreposição com a diarização, o que significa que as três são frequentemente confundidas.
Cada uma resolve um problema ligeiramente diferente, por isso entender a distinção é importante ao avaliar ferramentas.
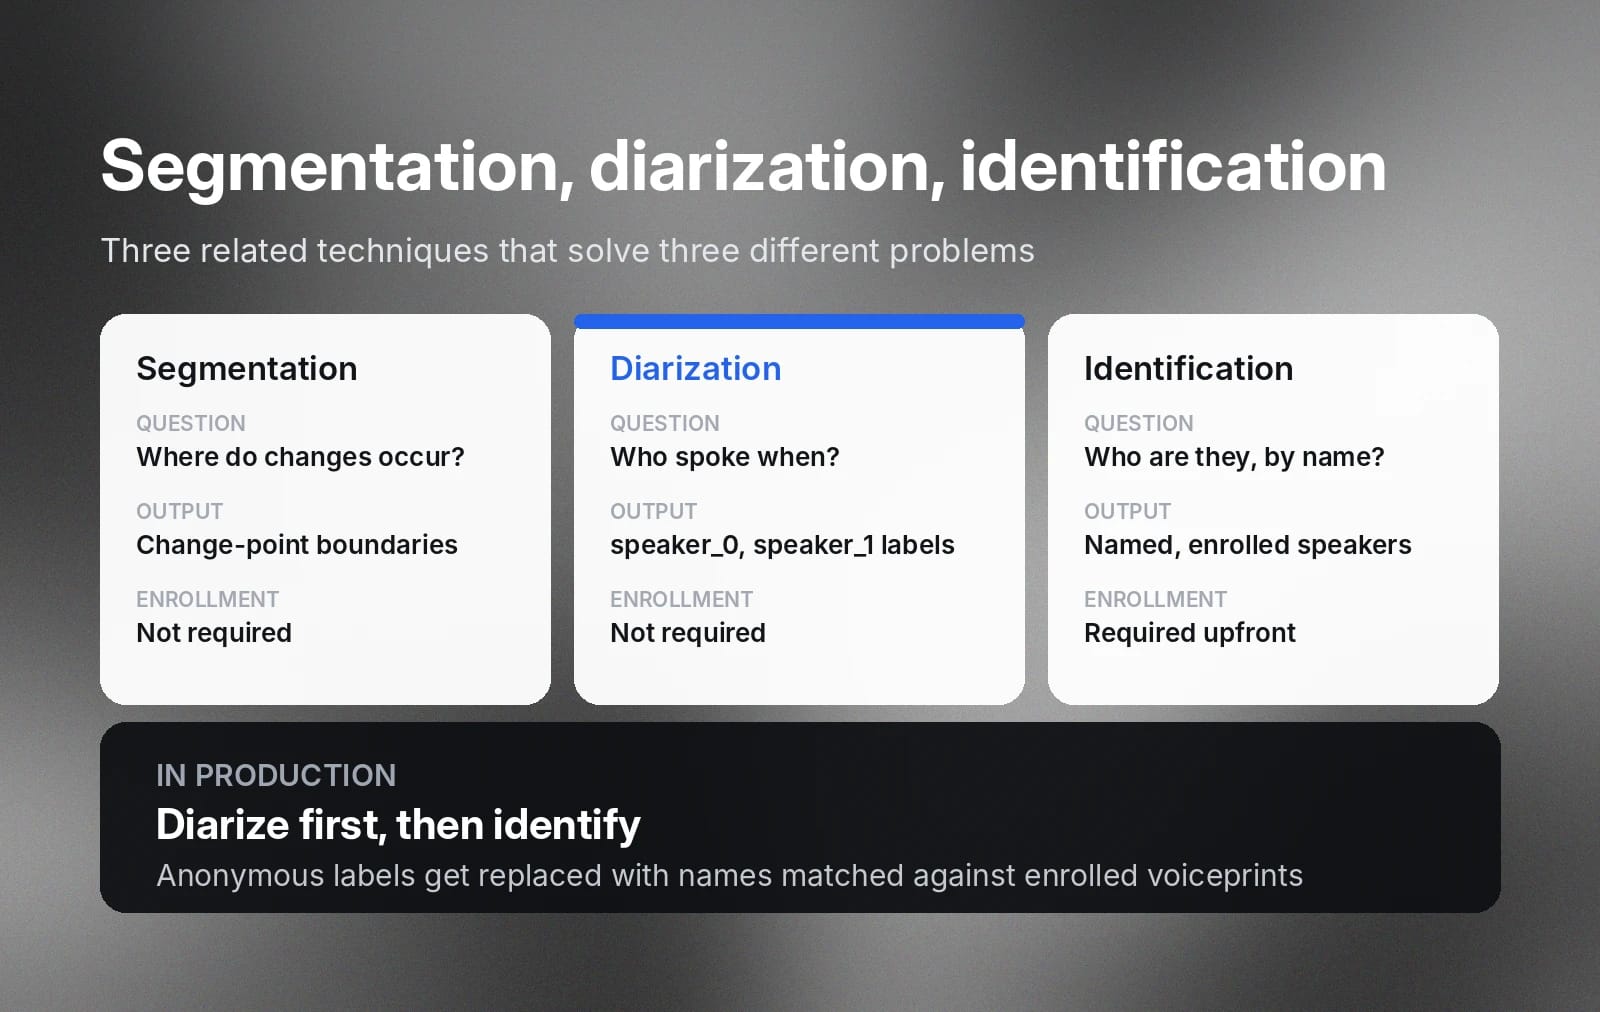
Como explicamos antes, a segmentação de locutores é uma etapa da diarização que ocorre no início do pipeline. Ela encontra os limites em que o locutor muda de uma voz para outra, sem atribuir identificadores. A segmentação informa que houve uma mudança em 0:42. A diarização se baseia nisso ao agrupar os segmentos resultantes e produzir uma saída totalmente identificada, mostrando que a voz em 1:15 é a mesma que falou no início da gravação.
A identificação de locutores é uma capacidade separada da diarização, mas frequentemente é combinada a ela. A identificação determina quem esses locutores realmente são. Um sistema de identificação compara as vozes com impressões vocais cadastradas, usando uma referência de locutores conhecidos para retornar identidades. Após a identificação, speaker_0 e speaker_1 passam a ser "Fergal" e "Eric".
Muitos produtos combinam essas ferramentas para gerar uma transcrição final mais completa. Uma ferramenta de reuniões pode fazer isso automaticamente — possivelmente até usando dados como o nome que alguém definiu no Teams ou Meet — para que as contribuições de cada participante sejam atribuídas pelo nome, sem revisão manual.
Ferramentas e bibliotecas populares de código aberto para diarização de locutores
Vale considerar ferramentas de código aberto para diarização de locutores quando você precisa de controle, flexibilidade ou implantação local. A melhor opção depende do tipo de áudio que você processa — chamadas telefônicas, reuniões, podcasts ou transmissões —, dos seus requisitos de latência e de quanto tempo de engenharia você pode investir.
Estas são algumas das opções mais populares.
Pyannote.audio
Pyannote.audio é um kit de ferramentas baseado em PyTorch, desenvolvido especificamente para diarização de locutores e uma das opções de código aberto mais usadas. Ele fornece pipelines pré-treinados que abrangem toda a pilha de diarização, incluindo VAD, segmentação, embeddings e agrupamento, além dos componentes necessários para treinar ou fazer finetune de modelos com seus próprios dados.
Seus modelos pré-treinados são distribuídos pelo Hugging Face e costumam ser usados como a camada de diarização em projetos maiores de transcrição.
WhisperX
WhisperX combina o Whisper da OpenAI ASR com diarização e alinhamento forçado. O Whisper, por si só, produz boas transcrições, mas não atribui identificadores de locutor, e seus timestamps são apenas aproximados. O WhisperX adiciona alinhamento de timestamps no nível de palavra e integra diarização baseada em pyannote, produzindo transcrições em que cada palavra tem um timestamp preciso e um identificador de locutor.
NVIDIA NeMo
NVIDIA NeMo inclui diarização como parte de seu framework mais amplo de IA conversacional. Ele fornece modelos treináveis de diarização, incluindo abordagens de ponta a ponta que lidam com fala sobreposta, e foi desenvolvido para equipes que criam sistemas de fala personalizados em escala, usando infraestrutura de GPU.
Cada uma dessas ferramentas exige que você gerencie a infraestrutura de diarização, incluindo implantação, escalabilidade, monitoramento e atualizações de modelos. Para equipes que não querem essa sobrecarga operacional, APIs gerenciadas de diarização de fala oferecem uma alternativa mais simples. Elas podem se integrar a workflows existentes ou executar todo o pipeline de diarização, sendo adequadas para casos de uso em produção, como análises de suporte ao cliente, transcrição de reuniões e processamento de podcasts.
Diarização em tempo real: desafios e casos de uso
A diarização em tempo real é consideravelmente mais difícil do que a diarização de uma gravação concluída, pois o sistema precisa tomar decisões com contexto incompleto.
Um sistema offline analisa a gravação inteira antes de tomar qualquer decisão. Ele pode comparar uma voz no minuto 2 com uma voz no minuto 40 e determinar com confiança que é o mesmo locutor, porque ambos os momentos estão disponíveis ao mesmo tempo. Um sistema em tempo real não tem esse privilégio: ele precisa identificar a fala no instante em que ela chega, sem acesso ao que será dito em seguida e com pouca ou nenhuma chance de revisar uma decisão depois de tomá-la.
Essa falta de contexto futuro torna três problemas específicos muito mais difíceis de resolver em tempo real:
- Latência versus precisão: Sem a capacidade de analisar toda a conversa, atender a exigências mais rígidas de tempo de resposta prejudica diretamente a precisão.
- Fala sobreposta: Quando as pessoas falam ao mesmo tempo, um sistema que pudesse reprocessar o áudio talvez conseguisse separá-las. Um sistema em tempo real precisa atribuir uma única identificação ou recorrer imediatamente a modelos especializados em sobreposição.
- Enunciados curtos: Um "sim" ou "pode falar" rápido quase não fornece voz suficiente para o sistema analisar e, sem contexto ao redor para usar como apoio, ele ainda precisa atribuir uma identificação imediatamente.
Apesar da dificuldade, algumas aplicações não podem esperar até que a gravação termine. Legendas ao vivo para reuniões e transmissões precisam de identificadores de locutor enquanto as pessoas falam. Softwares de call center que apresentam orientações aos agentes durante a chamada precisam saber, em tempo real, quais palavras o cliente está usando. Agentes de voz que atendem chamadas com vários participantes precisam acompanhar quem pergunta o quê sem demora. Em cada caso, um sistema um pouco menos preciso, mas imediato, é melhor do que outro mais preciso, porém atrasado.
Para workloads que não exigem realmente identificadores em tempo real, como análises, revisão de conformidade e geração de transcrições, a diarização em lote continua sendo a melhor opção, pois é significativamente mais precisa.
Como avaliar o desempenho da diarização de locutores
Duas métricas são as mais importantes ao medir a precisão da diarização: a taxa de erro de diarização (DER), que captura a precisão geral, e a taxa de erro de Jaccard (JER), que verifica se essa precisão se mantém para todos os locutores.
A DER calcula especificamente a fração do tempo total de fala que foi atribuída de forma incorreta. Ela combina três tipos de erro:
- Fala de falso alarme: O sistema identificou um segmento como fala quando ninguém estava falando.
- Fala não detectada: Alguém estava falando, mas o sistema identificou como silêncio.
- Confusão de locutor: A fala foi detectada, mas atribuída ao locutor errado.
DER = (falso alarme + fala não detectada + confusão de locutor) / duração total da fala
Uma DER de 10% significa erros equivalentes a um décimo do tempo total de fala, considerando esses três tipos. Quanto menor, melhor, e as pontuações só são comparáveis quando medidas nos mesmos dados e nas mesmas condições. A DER varia muito conforme a qualidade do áudio, o número de locutores e o nível de sobreposição na gravação.
A taxa de erro de Jaccard (JER) mede a precisão da diarização para cada locutor separadamente e, em seguida, calcula a média do resultado entre todos os locutores. Para cada locutor de referência, o avaliador associa o identificador de locutor mais próximo do sistema e compara o tempo em que eles se sobrepõem corretamente com o tempo total atribuído a qualquer um dos dois locutores.
Por exemplo, imagine uma reunião de 60 minutos em que o locutor A fala por 50 minutos e o locutor B fala por 10. Um sistema de diarização identifica corretamente 48 dos 50 minutos do locutor A, mas apenas 4 dos 10 minutos do locutor B. Sua DER geral ainda pode parecer relativamente boa, porque a maior parte da reunião pertence ao locutor A. A JER faz com que o resultado ruim do locutor B tenha o mesmo peso, pois avalia os locutores A e B de forma independente antes de calcular a média de suas pontuações.
JER_speaker = 1 - (correct_overlap / (ref_time + sys_time - correct_overlap))
A JER final é a média dessas taxas de erro por locutor:
JER = (1 / N) * Σ[JER_speaker_i] ou i = 1..N
Acompanhar tanto a DER quanto a JER oferece uma visão mais completa da precisão da diarização: a DER para a precisão geral e a JER para verificar se essa precisão se mantém entre todos os participantes, incluindo quem fala com menos frequência.
Testes com áudio representativo da produção
Ao avaliar um sistema de diarização de locutores, calcule a DER e a JER em áudios que correspondam às suas condições reais de implantação: seu número típico de locutores, a qualidade do áudio e o nível de conversas simultâneas.
As pontuações de benchmarks publicados podem ser medidas em conjuntos de dados limpos e controlados, como gravações de estúdio, que raramente correspondem ao som de gravações reais de chamadas ou reuniões ao vivo. Um sistema que tem bom desempenho em benchmarks ainda pode apresentar desempenho significativamente inferior em áudio real, ruidoso e com sobreposições. Teste em seus próprios dados antes de escolher um produto de diarização.
Comece a usar a ElevenAPI para diarização de locutores
Se você está pronto para criar um recurso de transcrição com suporte a vários locutores, Scribe v2 da ElevenLabs disponibiliza a diarização de locutores por meio de uma única API de Speech to Text. Envie áudio ao endpoint com diarize=true, e a resposta JSON identifica cada palavra com um ID de locutor, para até 32 locutores, em mais de 90 idiomas, em arquivos de até 10 horas.
Duas opções ampliam a saída padrão da diarização. Para gravações de chamadas, detect_speaker_roles=true identifica os locutores como agente e cliente, em vez de números anônimos. Se seu workspace tiver perfis de locutores registrados, use_speaker_library=true poderá associar os locutores detectados a vozes cadastradas, reunindo diarização e identificação em uma única solicitação.
Um parâmetro de limite de diarização permite ajustar o equilíbrio entre dividir demais e unir locutores. E quando os locutores já estão isolados em canais de áudio separados, como em gravações estéreo de chamadas, a transcrição multicanal atribui os locutores por canal e ignora a diarização por completo.
O guia de início rápido do Speech to Text orienta você na primeira integração passo a passo. Para implantações regulamentadas, a plataforma está em conformidade com SOC 2, ISO 27001, PCI DSS L1 e HIPAA, com residência de dados na UE e modo de retenção zero disponíveis.
Pronto para incorporar a diarização de locutores aos seus sistemas? Comece obtendo sua chave de API ou confira a documentação da ElevenLabs para saber mais.
Perguntas frequentes

Jack Limebear faz parte do time de Growth, atuando como redator e estrategista de conteúdo no blog e nas páginas de insights. Antes da ElevenLabs, ele passou mais de dez anos liderando estratégias de conteúdo em organizações que vão de startups SaaS em rápido crescimento a empresas da Fortune 500. Ele é mestre em Literatura Inglesa pela Universidade de Cambridge.


