Transcrição em tempo real vs. em lote: principais diferenças
- Escrito por
- Jack Limebear
- Publicado
OuvirOuça este artigo
Ao escolher um modelo de transcrição com IA, você tem duas opções: transcrição em tempo real ou em lote. As duas convertem fala em texto, mas funcionam de formas diferentes.
A transcrição em tempo real processa o áudio enquanto ele acontece, enquanto a transcrição em lote processa uma gravação de áudio inteira após seu término. Embora a transcrição em tempo real entregue resultados instantâneos, a transcrição em lote costuma ser mais precisa.
Neste guia, vamos comparar a transcrição em tempo real e em lote para ajudar você a escolher o modelo certo para seu próximo projeto. Explicaremos como cada modelo funciona, suas vantagens e desvantagens, além de casos de uso comuns.
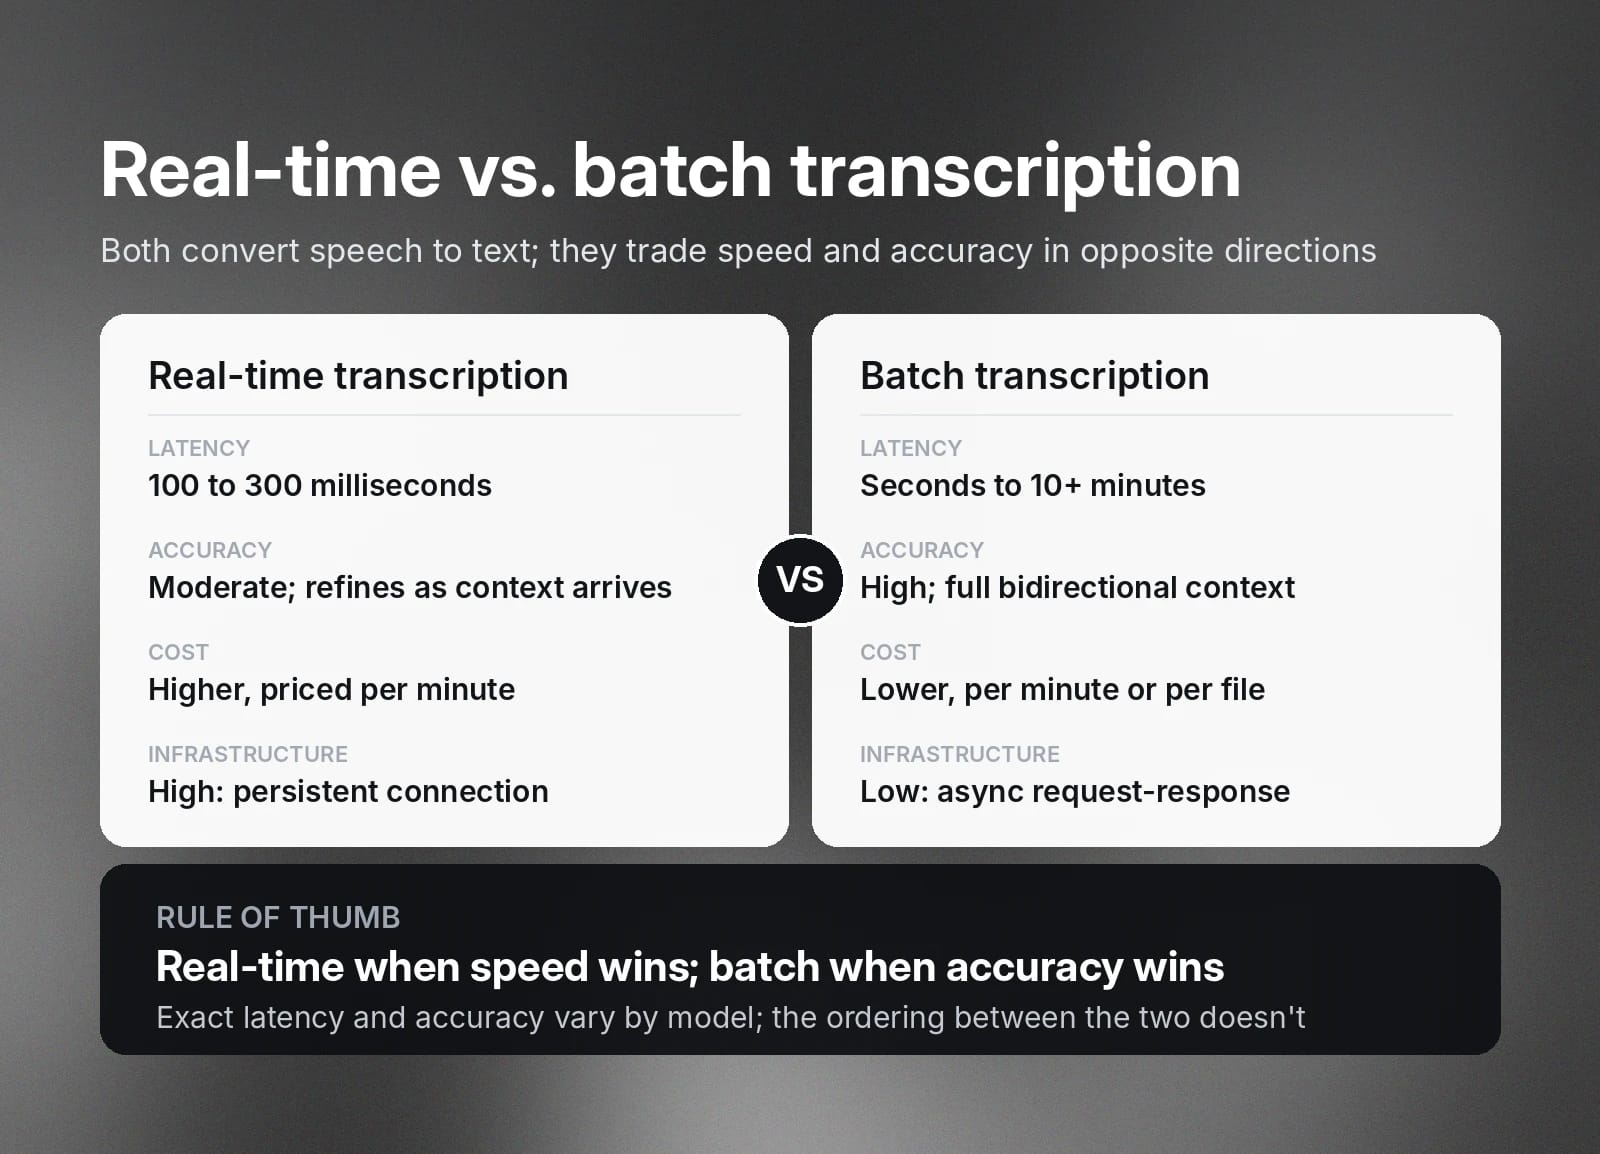
Resumo
- A transcrição em tempo real processa o áudio enquanto ele acontece.
- A transcrição em lote processa um arquivo de áudio inteiro de uma só vez.
- A transcrição em tempo real é mais rápida, mas a transcrição em lote é mais precisa porque o modelo tem contexto bidirecional de todo o arquivo de áudio.
- A transcrição em tempo real é ideal para aplicações como agentes de voz, legendas ao vivo em vídeos ou anotações de reuniões, em que a velocidade é mais importante do que a precisão.
- A transcrição em lote é mais precisa e mais econômica para transcrever áudios em grande volume depois que são gravados.
O que é transcrição em tempo real em STT?
A transcrição em tempo real ocorre quando um modelo de fala para texto (STT) converte áudio em texto escrito enquanto ele acontece. Isso também é chamado, às vezes, de transcrição por streaming.
Na transcrição em tempo real, o modelo STT processa o áudio em pequenos trechos. O texto escrito fica disponível apenas milissegundos depois que as palavras são faladas. À medida que a conversa avança, o modelo STT obtém mais dados e contexto, usando essas informações para aprimorar a transcrição.
Essa forma de transcrição funciona melhor em situações em que a velocidade é mais importante do que a precisão. Por exemplo, esses modelos tornam transmissões de áudio e vídeo mais acessíveis com legendas em tempo real. Outro caso de uso comum são plataformas de anotações em tempo real.
O que é transcrição em lote em STT?
A transcrição em lote converte uma gravação de áudio inteira de fala para texto de uma só vez, depois que a gravação termina. O processo pode levar de alguns segundos a mais de 10 minutos, dependendo da duração e da complexidade da gravação.
Os modelos de transcrição em lote usam o contexto de toda a gravação enquanto trabalham. O contexto completo ajuda o modelo a interpretar com precisão trechos com linguagem complexa, ruído de fundo ou interrupções. Os modelos de transcrição em lote também adicionam pontuação e formatação, algo com que alguns modelos em tempo real podem ter dificuldade.
A transcrição em lote funciona melhor em situações em que a precisão é a maior prioridade. Muitas organizações usam modelos em lote para transcrever entrevistas longas, reuniões ou podcasts para seus arquivos.
Como as arquiteturas em lote e de streaming moldam a transcrição
Ao comparar o processamento em lote com o processamento por streaming para transcrição, os dois modelos usam processos fundamentalmente diferentes, que afetam o resultado final.
Os modelos de transcrição por streaming dividem o áudio em trechos e transcrevem cada um à medida que acontece. Esses trechos são muito pequenos, geralmente têm cerca de 250 milissegundos ou menos. Ao processar o áudio nesse formato, o modelo de transcrição consegue trabalhar rapidamente, fazendo o texto aparecer poucos segundos após o áudio.
Como esses trechos de áudio são tão pequenos, o modelo de Speech to Text não tem o contexto completo da conversa, o que pode gerar erros. Por exemplo, o modelo de transcrição pode usar “concerto” em vez de “conserto”.
Um modelo de transcrição em tempo real corrigirá alguns desses erros conforme a conversa continua e o contexto fica claro. No entanto, geralmente não há tempo ou contexto suficiente para corrigir todos os erros, então a transcrição final nem sempre é 100% precisa.
Por outro lado, os modelos de transcrição em lote processam o arquivo de áudio inteiro de uma só vez. Isso significa que o modelo de transcrição tem contexto bidirecional da conversa, que usa para resolver palavras ou frases pouco claras. Quando algo não está claro no arquivo de áudio, o modelo analisa as palavras anteriores e posteriores para determinar o que foi dito e transcrevê-lo com precisão.
Esse contexto adicional torna os modelos de transcrição em lote mais lentos do que os modelos de transcrição em tempo real. Porém, o resultado final é muito mais preciso e bem-acabado.
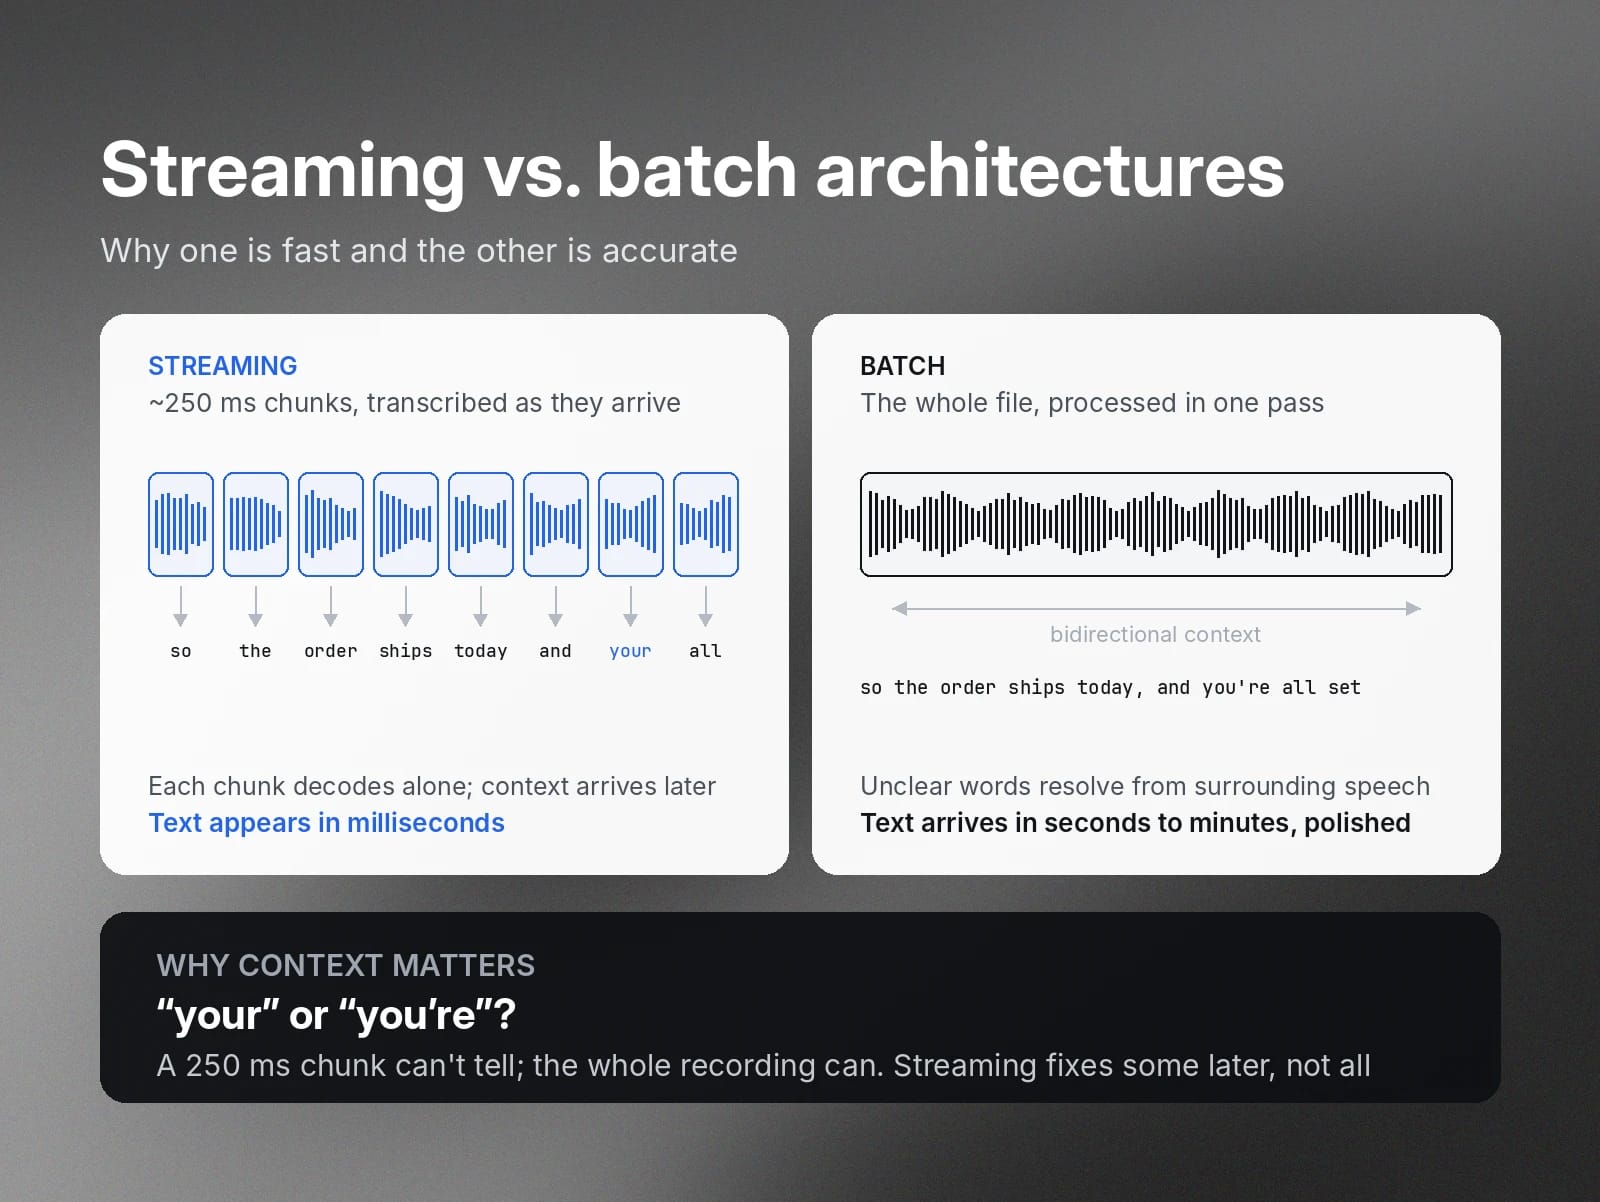
Principais características dos modelos de transcrição em tempo real e em lote: latência, precisão e custo
Tanto os modelos em tempo real quanto os em lote são eficazes para transcrição: tudo depende do tipo de projeto em que você está trabalhando. Alguns projetos exigem resultados instantâneos, enquanto outros precisam de altos níveis de precisão.
Confira os fatores a considerar ao escolher entre transcrição em tempo real e em lote:
Transcrição em tempo real | Transcrição em lote | |
Latência | 100 a 300 milissegundos | De segundos a mais de 10 minutos, dependendo da duração do arquivo |
Precisão | Moderada | Alta |
Custo | Alto, cobrado por minuto | Moderado, cobrado por minuto ou por arquivo |
Complexidade da infraestrutura | Alta, exige conexão estável e balanceamento de carga | Baixa, usa uma estrutura assíncrona de solicitação e resposta |
As taxas exatas de latência e precisão variam de acordo com o modelo de transcrição específico que você usa. Porém, a transcrição em tempo real é consistentemente mais rápida, enquanto a transcrição em lote é mais precisa.
A transcrição em tempo real custa mais do que a transcrição em lote porque exige uma infraestrutura mais complexa e tem custos operacionais maiores. Os modelos em tempo real precisam de uma conexão estável para manter sua velocidade e levam mais tempo para configurar e manter do que os modelos em lote.
Os modelos em tempo real valem o investimento para acessibilidade durante conversas ao vivo. Porém, usar a transcrição em lote economiza dinheiro e tempo de configuração em projetos nos quais a velocidade não é prioridade.
Comparação de APIs de transcrição em tempo real e em lote: como escolher a melhor opção para seu projeto
Antes de começar um novo projeto de transcrição, você precisa avaliar os prós e contras dos modelos em lote e em tempo real para descobrir qual deles é o mais adequado aos seus objetivos. Veja como funciona esse processo de decisão em três cenários reais.
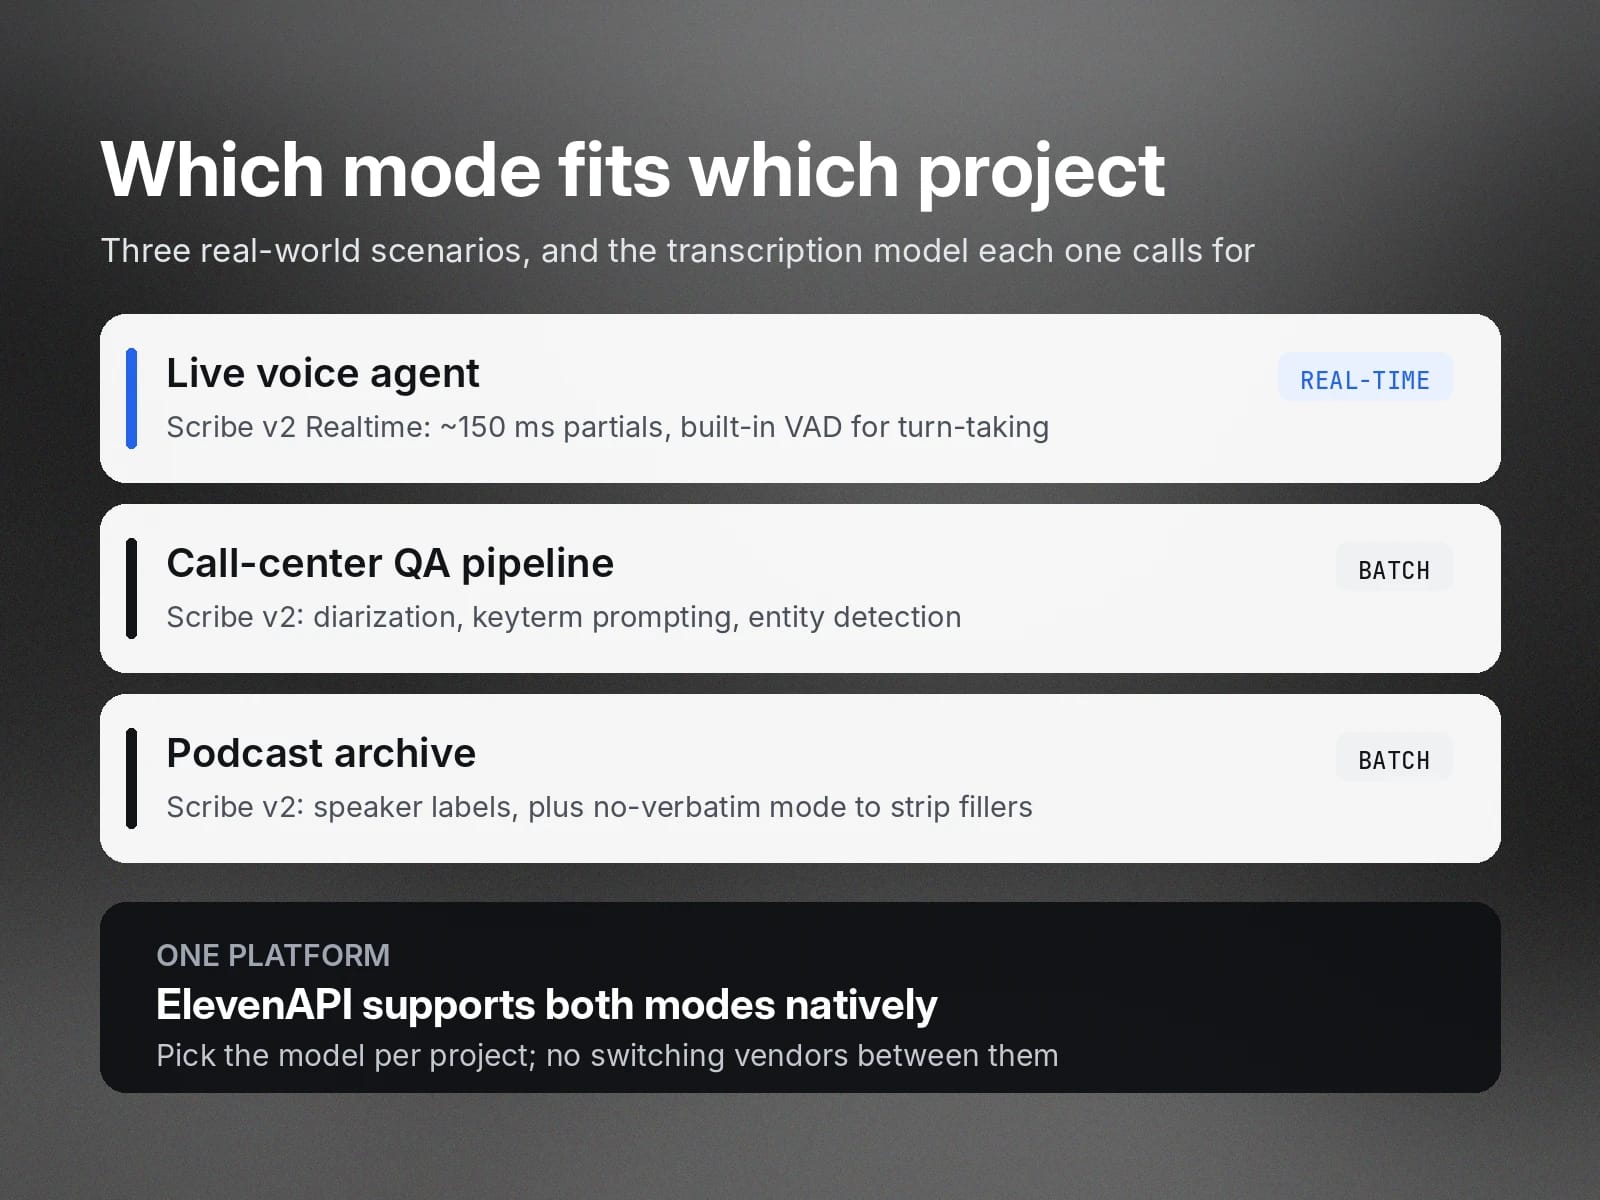
Agente de voz ao vivo: Transcrição em tempo real
Modelos de IA conversacional ao vivo exigem transcrição quase instantânea para garantir acessibilidade, especialmente ao lidar com desafios complexos de operação ou atendimento ao cliente.
Um modelo em tempo real, como o Scribe v2 Realtime, oferece a baixa latência necessária para conversas fluidas e naturais. O Scribe v2 Realtime entrega transcrições parciais em cerca de 150 milissegundos.
Os modelos de transcrição para agentes de voz ao vivo também exigem alternância de turnos precisa. Isso significa que precisam conseguir detectar quando um usuário começou ou terminou de falar e responder imediatamente. A alternância de turnos e o gerenciamento de interrupções eficazes ajudam a evitar que a transcrição fique para trás da conversa.
Os modelos de transcrição em tempo real priorizam uma alternância de turnos precisa para resultados rápidos. Por exemplo, o Scribe v2 Realtime tem Detecção de Atividade de Voz integrada, então segmenta automaticamente a transcrição quando detecta silêncio entre os participantes.
Pipeline de QA de call center: Transcrição em lote
A precisão é essencial ao realizar a garantia de qualidade, então um modelo de transcrição em lote como o Scribe v2 faz mais sentido nesse cenário.
Transcrições de call center geralmente contêm nomes únicos e detalhes específicos do setor. Se não forem transcritos corretamente, será difícil para os analistas determinar se uma chamada foi realmente bem-sucedida. Como os modelos em lote processam a gravação inteira de uma só vez, eles têm o contexto necessário para uma transcrição e formatação precisas.
O Scribe v2 tem vários recursos para aumentar a precisão da transcrição. A diarização de locutores garante que agentes e clientes sejam sempre identificados corretamente, mesmo quando há falas sobrepostas. O prompting de termos-chave fornece antecipadamente ao modelo nomes de marcas e termos do setor para que sejam transcritos com precisão.
As transcrições de call center também podem conter informações confidenciais que precisam ser ocultadas, como números de CPF e de cartões de crédito. O Scribe v2 tem detecção de entidades para encontrar e registrar a marcação de tempo desses dados confidenciais, para que você possa removê-los.
Arquivo de podcasts: Transcrição em lote
Ao criar um arquivo de podcasts, você precisa de transcrições bem-acabadas para que sua equipe e seu público possam consultá-las a qualquer momento. Precisão e formatação limpa são essenciais nesse caso, tornando a transcrição em lote a escolha certa.
Com a transcrição em lote, você obtém transcrições precisas com identificação de locutores e diarização em todos os seus arquivos de podcast. O Scribe v2 também tem o modo não literal, que remove automaticamente vícios de linguagem, gagueira e repetições. Isso significa que você dedicará menos tempo à edição manual e poderá criar seu arquivo de podcasts mais rápido.
O ElevenAPI oferece suporte nativo aos modos em tempo real e em lote. Se você executa vários projetos de transcrição ao mesmo tempo, pode usar o ElevenAPI para gerenciar todos eles na mesma plataforma. Basta escolher o modelo adequado para cada projeto, sem o incômodo de alternar entre provedores de serviço.
Modelos híbridos de transcrição: unindo tempo real e lote
As arquiteturas híbridas de transcrição combinam modelos em tempo real e em lote para equilibrar velocidade e precisão.
Por exemplo, uma equipe de atendimento ao cliente poderia usar um modelo híbrido para fornecer resultados imediatos durante conversas ao vivo e, depois, aprimorar a transcrição para garantia de qualidade e arquivamento. Agentes ao vivo usam transcrição em tempo real e depois enviam a transcrição inicial a um modelo em lote para reprocessamento assíncrono.
Veja como esse fluxo funciona:
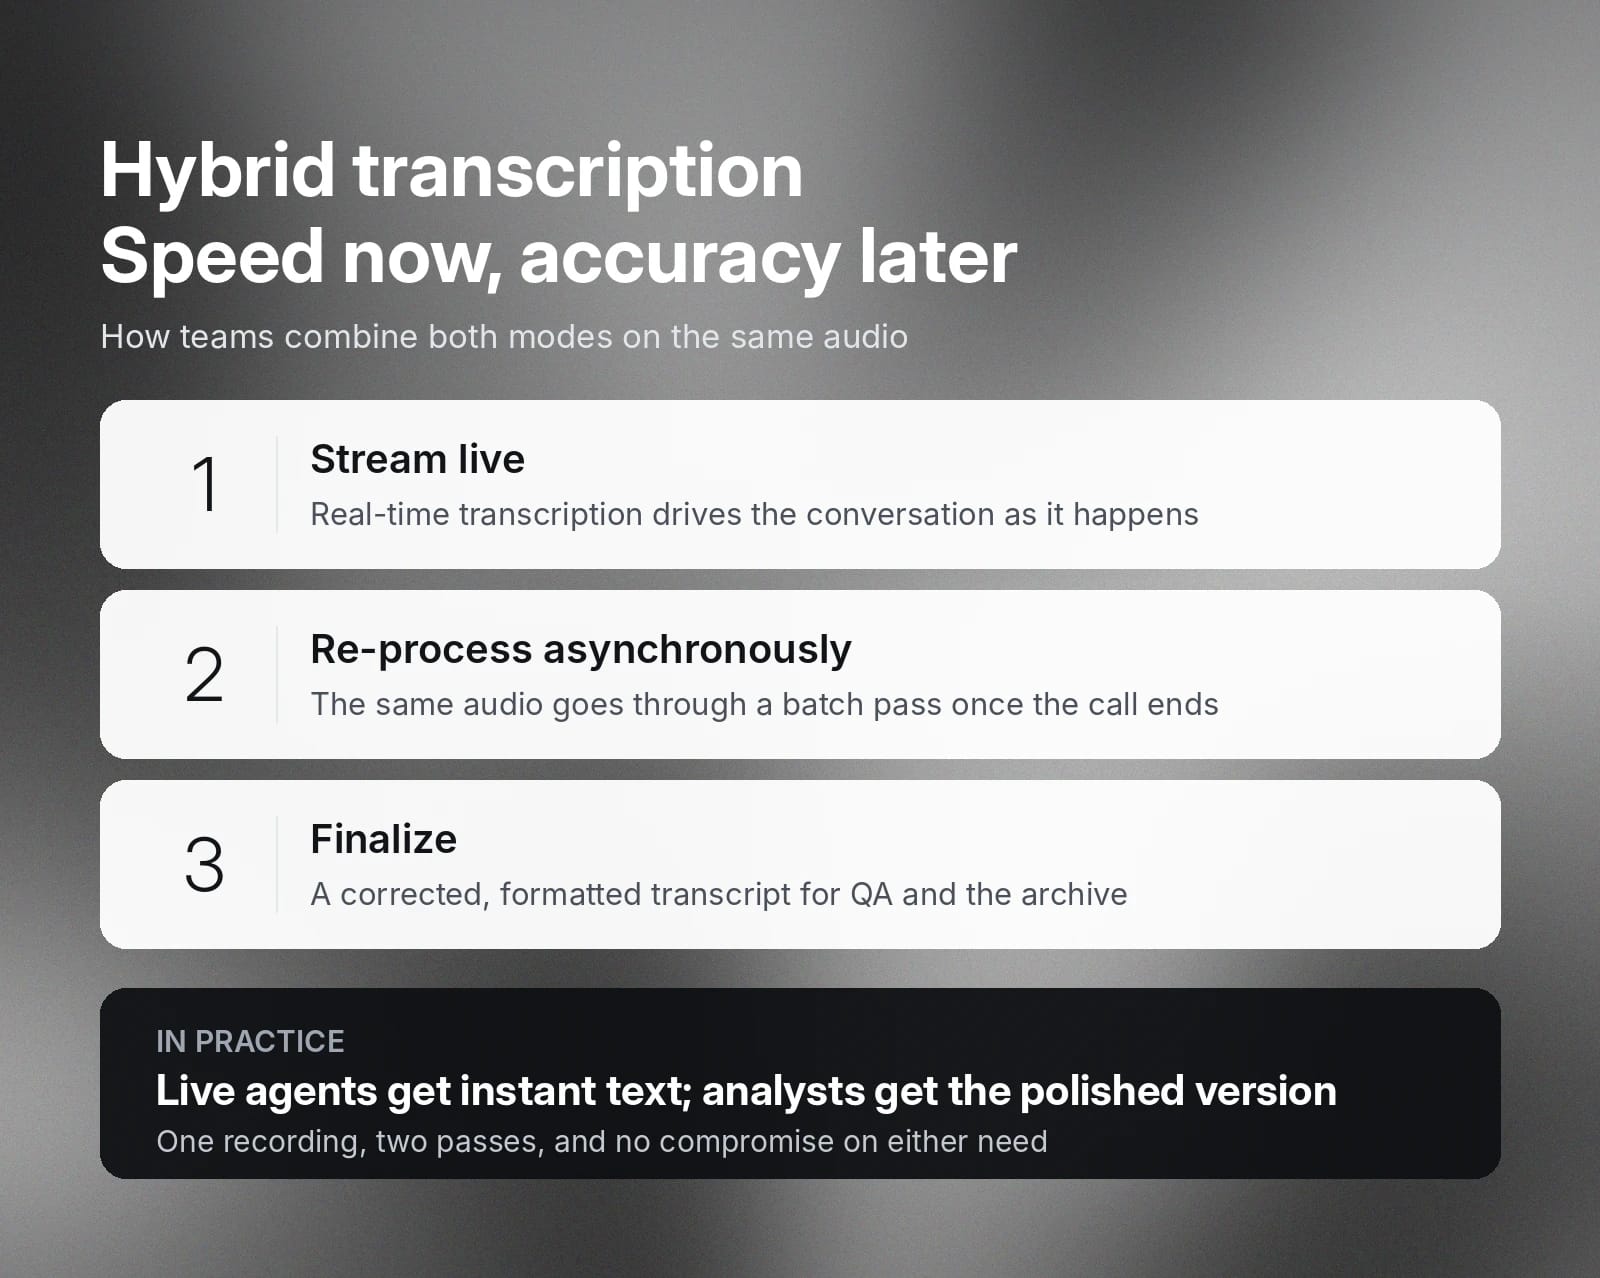
Comece a usar o ElevenAPI para soluções flexíveis de transcrição
O ElevenAPI oferece modelos em tempo real e em lote para transcrições rápidas e precisas em mais de 90 idiomas. Os modelos de transcrição líderes do setor do ElevenAPI fornecem resultados precisos, mesmo com áudio de baixa qualidade, ruído de fundo ou sotaques marcantes.
ElevenAPI oferece modelos em tempo real e em lote para transcrições rápidas e precisas em mais de 90 idiomas. O Scribe v2 oferece precisão de transcrição líder do setor, e o Scribe v2 Realtime oferece precisão excepcional para casos de uso ao vivo. Ambos fornecem resultados confiáveis, mesmo com áudio de baixa qualidade, ruído de fundo ou sotaques marcantes.
Os dois modelos estão disponíveis na mesma plataforma prática para ajudar você a criar uma arquitetura de transcrição que atenda às suas necessidades. Explore a API Speech to Text da ElevenLabs para vê-la em ação ou crie uma chave de API para começar.



