
Como funciona a transcrição de áudio com marcações de tempo e tags de eventos?
- Escrito por
- Jack Limebear
- Publicado
- Última atualização
OuvirOuça este artigo
Um modelo nativo de transcrição em nível de palavra recebe como entrada uma gravação de áudio ou stream em tempo real e gera uma matriz estruturada de objetos de token com tags e timestamps, que representam fala e sons não verbais. Cada token é de um entre três tipos: word, spacing ou audio_event. Os eventos de áudio podem incluir risadas, aplausos ou outros sons de fundo.
Neste artigo, vamos explorar como funciona a transcrição de áudio com timestamps e por que ela é uma forma de transcrição mais flexível e poderosa do que a transcrição convencional, que depende de alinhamento forçado.
Resumo
- A transcrição em nível de palavra gera diretamente matrizes estruturadas e com timestamps de dados de fala e eventos de áudio não verbais.
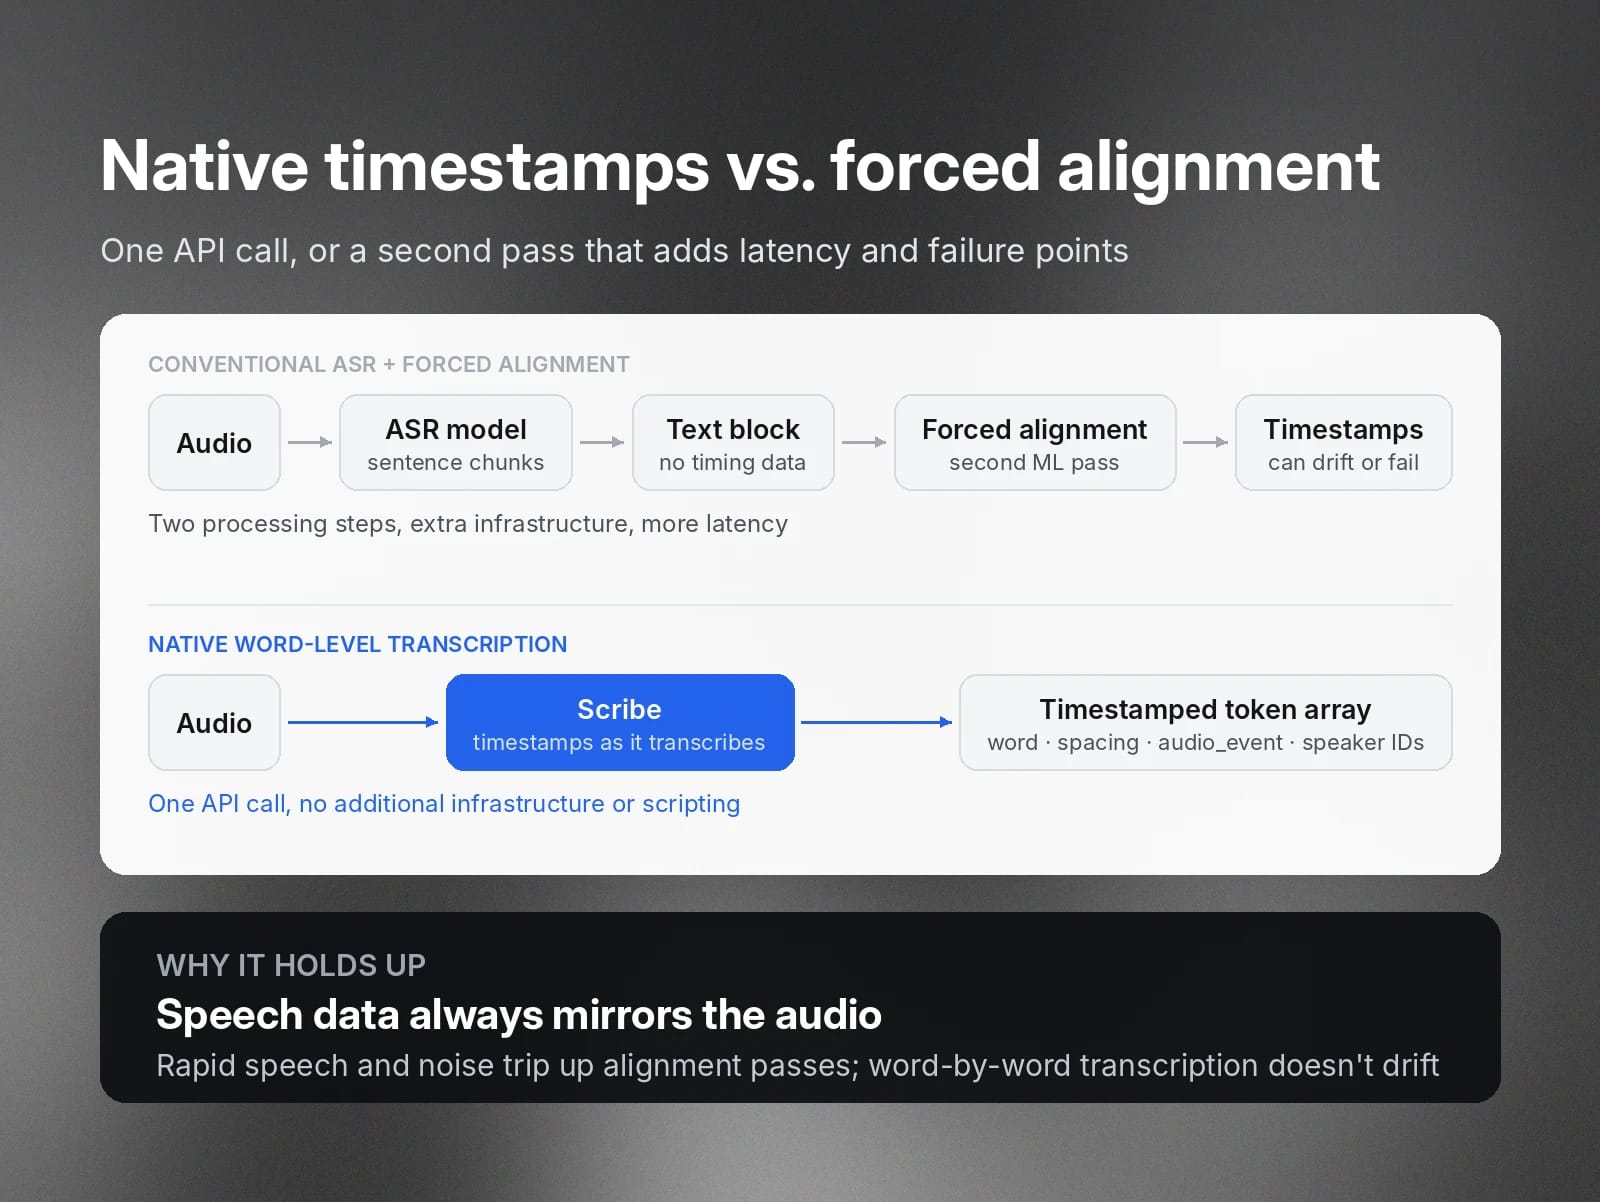
- Isso contrasta com os modelos convencionais de reconhecimento automático de fala, que geram blocos completos de texto. Para adicionar timestamps a esse conteúdo no áudio original, é preciso executar um segundo processo de alinhamento forçado, que leva mais tempo e aumenta o custo computacional.
- As tags de eventos ajudam você a capturar conteúdo não verbal, como risadas ou aplausos. Como esses dados podem ser pesquisados, você pode usá-los para identificar destaques ou momentos virais com base nas reações do público.
- Você pode enviar os dados estruturados gerados para aplicações em vários casos de uso, incluindo legendagem altamente precisa, arquivos de áudio pesquisáveis e criação automatizada de clipes para redes sociais.
- A transcrição em nível de palavra do Scribe pode processar até 5 canais, cada um transcrito de forma independente.
O que é transcrição de áudio com timestamps e tags de eventos?
A transcrição com timestamps é uma forma de reconhecimento automático de fala (ASR) que registra os pontos exatos de início e fim das palavras e de outros eventos de áudio, como aplausos, durante a transcrição. Ela gera dados totalmente estruturados e navegáveis.
A transcrição ASR convencional transforma o áudio em grandes blocos de texto legíveis por humanos. Ela fornece legendas e uma transcrição para leitores, mas não é muito útil como dado.
Se você quiser estruturá-la com timestamps, será necessário passá-la novamente por um serviço secundário de machine learning para mapear o texto ao áudio. É possível gerar uma saída semelhante, mas isso exige várias etapas de processamento em vez de vir nativamente da API, aumentando a latência e o custo computacional.
Adicionando navegação ao áudio
A principal vantagem da transcrição com timestamps e tags de eventos é que ela pode ser lida tanto por humanos quanto por máquinas. Isso traz aplicações importantes para negócios:
- Auditoria de conformidade: você pode pesquisar palavras-chave em uma transcrição e obter timestamps exatos de qualquer menção a dados sensíveis.
- Produção e edição de vídeo: softwares de produção de vídeo podem sincronizar legendas com precisão de milissegundos ao que está sendo dito na tela. Eles também podem rotular adequadamente as reações do público.
- Arquivos pesquisáveis: equipes de relações públicas, vendas e treinamento, entre outras, podem transcrever grandes volumes de entrevistas com clientes, palestras em feiras, webinars ou reuniões gerais e transformá-los em arquivos extensos e pesquisáveis.
- Análises de marketing e sentimento do cliente: a marcação de eventos pode identificar reações do público que poderiam se perder em uma transcrição de texto básica.
Quais são as vantagens de obter timestamps nativos em nível de palavra?
Modelos padrão de Speech to Text processam a fala em blocos, geralmente frases ou parágrafos inteiros. Se você quiser timestamps palavra por palavra, precisará criar outra camada de processamento para executar o chamado alinhamento forçado em uma segunda etapa. Isso adiciona infraestrutura e latência, além de aumentar os possíveis pontos de falha. Por exemplo, os timestamps podem se desalinhar ou falhar completamente ao processar fala rápida ou fala encoberta por ruídos altos de fundo.
A transcrição com timestamps, como a realizada pelo Scribe, evita esse problema ao transcrever em um nível mais granular, palavra por palavra. Ela faz isso em uma única chamada de API. Não é necessária infraestrutura ou scripting adicional. O modelo calcula os timestamps enquanto transcreve, para que os dados de fala sempre reflitam o áudio com precisão.
Como funciona a transcrição com timestamps e tags de eventos?
Vamos usar o Scribe como exemplo.
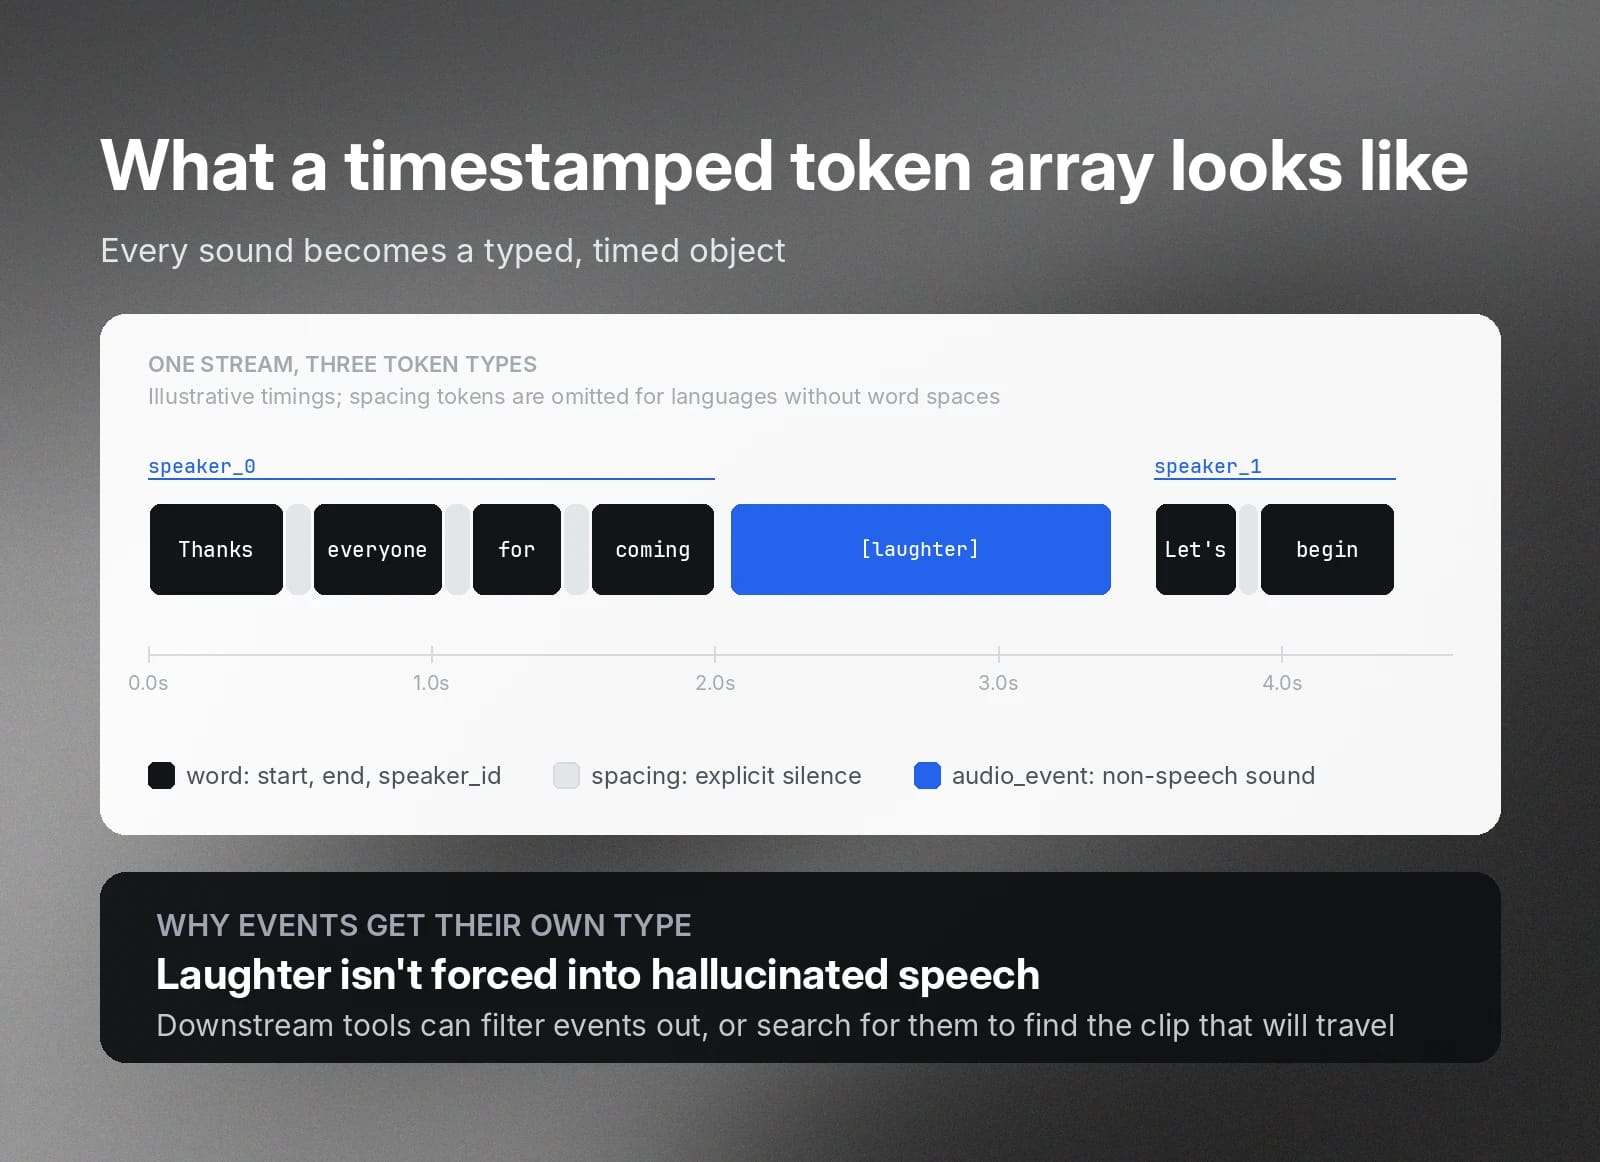
Um modelo nativo de transcrição em nível de palavra mapeia os sons da fala em um feed de áudio para uma matriz estruturada de objetos de token. Ele classifica cada token em um entre três tipos: word, spacing ou audio_event.
- word: Uma palavra individual reconhecida, com horários de início e fim registrados e uma tag speaker_id.
- spacing: Silêncio ou pausas durante a fala identificados explicitamente por tags. Útil para ajudar serviços de legendagem a manter o ritmo correto. Não é usado em idiomas identificados que não usam espaços entre palavras, como japonês, mandarim, tailandês, laociano, birmanês e cantonês.
- audio_event: Áudio não verbal significativo, como risadas ou aplausos. O modelo sabe estruturar esses elementos como um tipo de evento separado e não força o áudio a virar fala alucinada.
Parâmetros de streaming em tempo real
Os modelos de transcrição em nível de palavra também podem incluir recursos especiais para oferecer suporte à transcrição de áudio ao vivo via WebSocket. Por exemplo:
- include_timestamps=true: Esse parâmetro faz com que a conexão inclua timestamps em nível de palavra nas mensagens JSON committed_transcript_with_timestamps enviadas ao fim de cada trecho de áudio finalizado, para que você receba timestamps enquanto o stream ainda está em execução. As tags de eventos de áudio são incluídas apenas se tag_audio_events também estiver ativado.
- include_language_detection=true: Esse parâmetro instrui a conexão a marcar os diferentes idiomas falados detectados, junto com a pontuação de confiança do modelo para a detecção. Isso ajuda você a criar legendas multilíngues ao vivo.
Como um modelo de Speech to Text marca eventos que não são fala?
O Scribe marca eventos de áudio quando o parâmetro tag_audio_events está ativado. Nesse caso, ele marca e adiciona timestamps específicos de início e fim, como faz com as palavras. Ele pode marcar várias reações, sendo as mais comuns risadas e aplausos, além de outros sons ambientes que podem ter relevância contextual, incluindo passos ou música de fundo.
De forma mais imediata, isso torna as transcrições e legendas mais ricas ao adicionar contexto importante. Pode ser mais difícil para um leitor perceber sarcasmo ao ler um texto simples e sem nuances. Uma tag [laughter] enriquece a transcrição e a torna mais emocionalmente expressiva.
Análises melhores
A marcação de eventos também torna mais claras as análises posteriores que você executa, pois essas ferramentas não precisam interpretar um único bloco de texto não estruturado. A transcrição nativa em nível de palavra separa os eventos de áudio como dados estruturados, para que suas ferramentas possam simplesmente filtrá-los quando necessário e operar apenas sobre o conteúdo verbal.
Como os tokens spacing tornam as pausas visíveis, você pode analisá-las. Isso pode ser útil para análises de sentimento e casos de uso de QA, como medir por quanto tempo um atendente ficou em silêncio durante uma chamada.
Pesquisa de timestamps mais fácil
Ou você pode pesquisá-los especificamente. Se estiver fazendo uma análise de sentimento de uma entrevista de teste de produto, poderá destacar reações emocionais relevantes. Ou, se gerencia uma conta em rede social, poderá pesquisar rapidamente por risadas em um discurso de uma hora para encontrar os clipes que têm mais chance de viralizar.
Quais são as aplicações práticas das transcrições estruturadas com timestamps?
Obter dados estruturados nativamente nas transcrições tem vários casos de uso importantes.
Geração de legendas e subtítulos
Você pode exportar transcrições com timestamps diretamente para formatos de legendagem usados em produção, incluindo SRT e VTT, sem processamento intermediário. Sua ferramenta de edição de vídeo pode usar o timing das palavras para destacá-las nas legendas à medida que são faladas.
O modelo de transcrição consegue interpretar fala rápida com facilidade porque a processa palavra por palavra. Enquanto um modelo convencional pode ter dificuldade com fala acelerada ou vozes sobrepostas, um modelo em nível de palavra como o Scribe pode gerar uma transcrição clara e estruturada.
Pesquisa em áudio e vídeo
A transcrição convencional permite encontrar palavras-chave no bloco de texto, mas, sem alinhamento forçado, você não consegue ir diretamente ao momento em que uma frase foi dita. Uma pesquisa por palavra-chave em uma transcrição em nível de palavra é totalmente indexada e leva você exatamente ao segundo em que uma frase foi falada no áudio. Isso transforma seu arquivo de áudio em um catálogo de referência totalmente pesquisável. Esse recurso é particularmente útil para gerenciar grandes bibliotecas de mídia, redes de podcasts e arquivos corporativos.
Auditoria de conformidade e riscos
Muitas vezes, você vai querer gravar áudios que contêm informações sensíveis, por exemplo, chamadas de atendimento ao cliente para QA. Essas podem ser justamente as chamadas com maior probabilidade de conter informações pessoais sensíveis ou regulamentadas.
Para manter a conformidade e ainda ter dados de áudio para análise, você precisa de uma forma de ocultar dados sensíveis das transcrições em tempo real. Os timestamps nativos em nível de palavra permitem aproveitar recursos como a Detecção de Entidades da ElevenLabs, que sinaliza entidades sensíveis, como números de cartão de crédito ou nomes, e retorna seus deslocamentos e timestamps para que você possa ocultá-las nas transcrições conforme são recebidas.
Por exemplo, você pode detectar e ocultar um número de cartão de crédito, nome de solteira da mãe, data de nascimento e nome do cliente conforme são mencionados em uma chamada de verificação de identidade.
Criação automatizada de clipes para redes sociais
Você também pode automatizar programaticamente pesquisas por palavras-chave para encontrar destaques em conteúdos mais longos. Por exemplo, poderia destacar momentos importantes de um discurso de campanha ou seminário corporativo. Isso ajuda você a transformar conteúdo recente em destaques editados profissionalmente para YouTube, LinkedIn ou TikTok.
Timing multicanal e com vários falantes
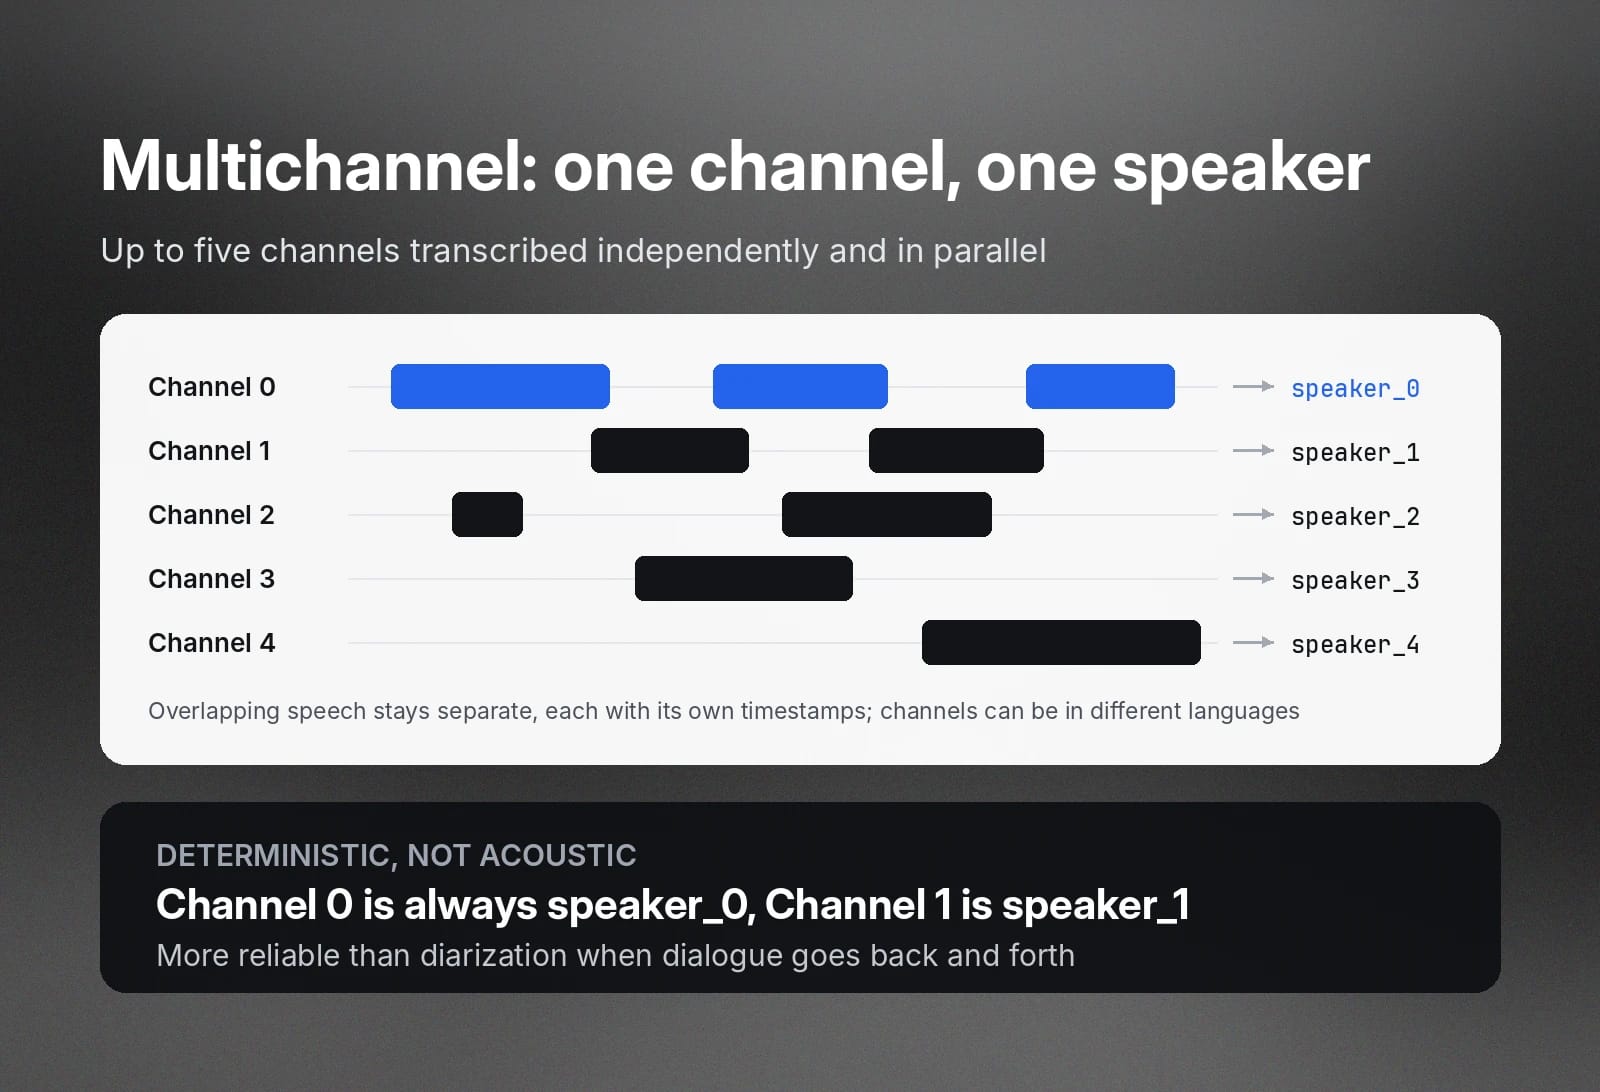
O Scribe pode transcrever até cinco canais de forma independente e em paralelo. Cada um recebe um ID de falante e timestamps. Isso é mais confiável do que a diarização de falantes acústica padrão, que frequentemente tem dificuldade com diálogos de alternância rápida. Em gravações multicanal, a atribuição de falantes do Scribe é totalmente determinística. Isso significa que o Canal 0 corresponde a speaker_0, o Canal 1 a speaker_1 e assim por diante.
Ele consegue reconhecer falantes tentando falar ao mesmo tempo e ainda gerar timestamps independentes para cada fala. Eles também podem falar idiomas diferentes.
Exporte dados com timestamps no formato que você precisa
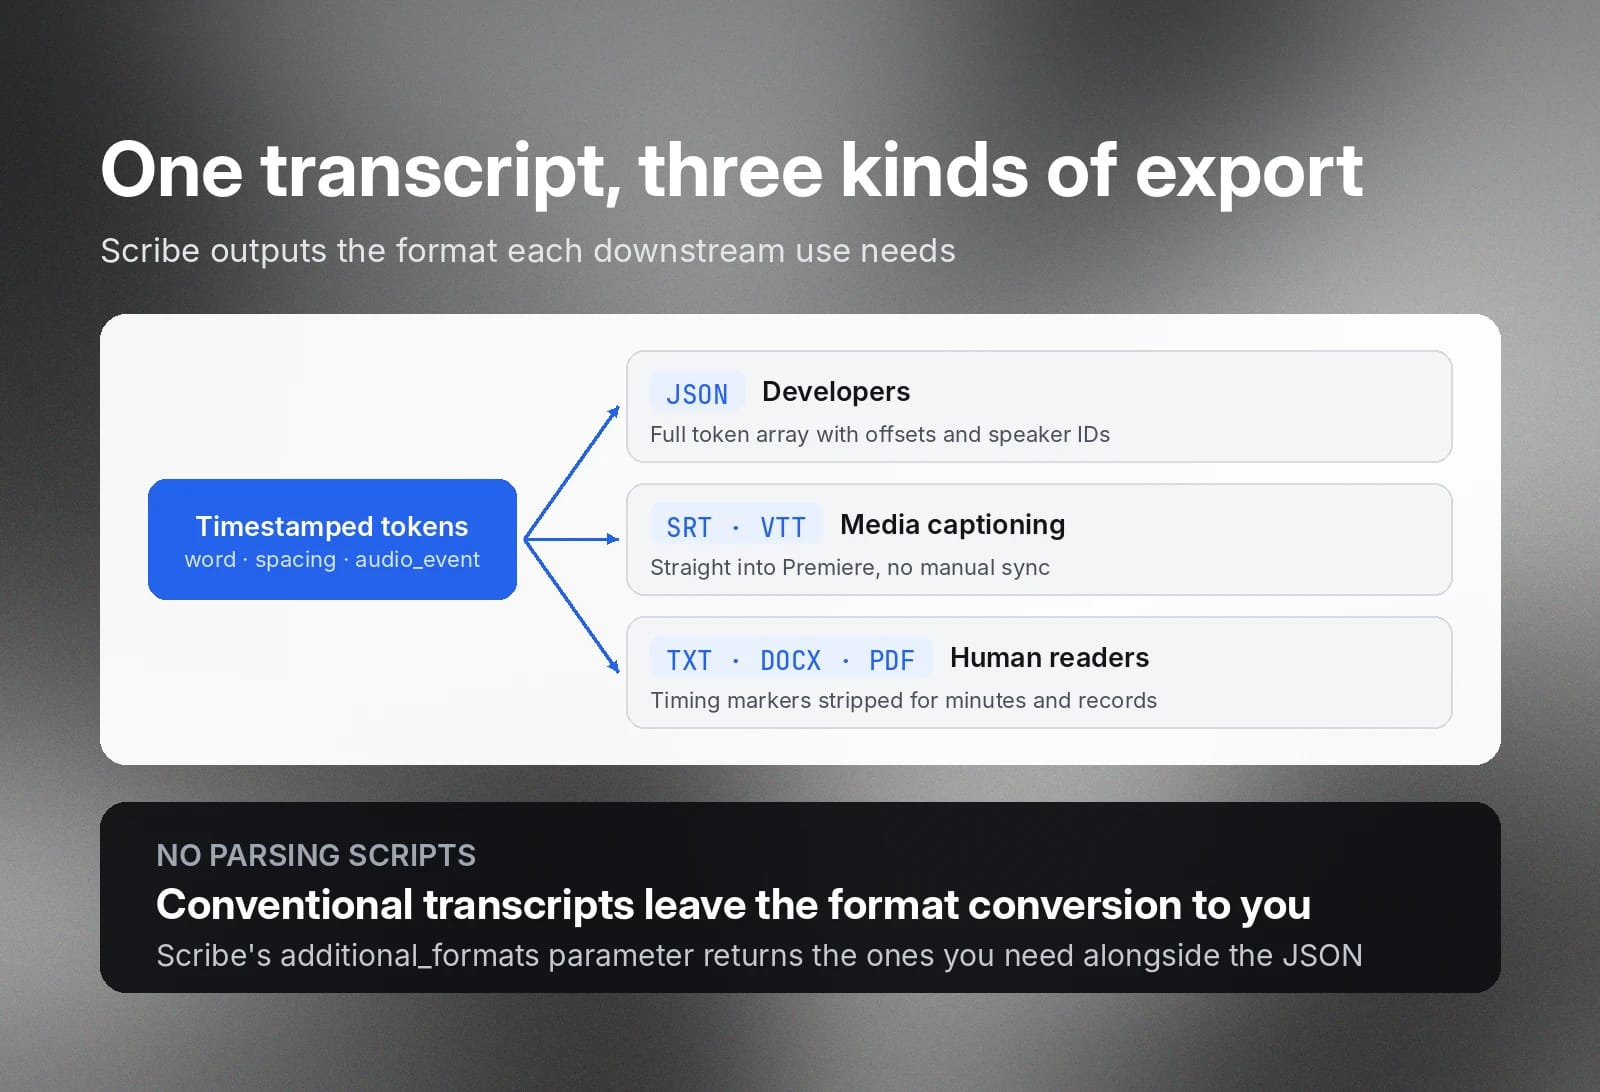
Se quiser distribuir transcrições convencionais em vários formatos, provavelmente será necessário escrever os próprios scripts de análise. O Scribe pode exportar transcrições em vários formatos, dependendo de como você vai usá-las. Você encontra as definições completas de esquema na Referência da API Create Transcript da ElevenLabs.
Dados estruturados para desenvolvedores: JSON
O Scribe permite exportar para JSON para desenvolvedores que querem dados em um esquema que possam enviar a aplicações posteriores. Por exemplo, desenvolvedores podem usar esses dados JSON para criar mídia interativa ou um banco de dados de pesquisa semântica para a organização. A matriz completa de tokens word, spacing e audio_event é gerada com deslocamentos de início e fim e IDs de falantes.
Legendagem de mídia: SRT e VTT
O Scribe pode gerar transcrições em SRT e VTT que você pode importar diretamente para o Adobe Premiere ou outras aplicações de produção, sem sincronização manual.
Legível por humanos: TXT, DOCX e PDF
Ele também pode gerar transcrições em formatos fáceis de ler. Nesses formatos, o Scribe remove marcadores de timing de baixo nível para tornar o texto mais legível e adequado à documentação jurídica ou de auditoria. Por exemplo, isso é útil quando você precisa distribuir com eficiência as atas de uma reunião de conselho logo após uma sessão, publicar transcrições de podcasts para SEO ou arquivar registros jurídicos.
Comece a usar as transcrições da ElevenLabs com timestamps e tags de eventos
A transcrição nativa em nível de palavra fornece rapidamente e com eficiência os dados estruturados de que você precisa para seus workflows.
Comece hoje a transcrever seus áudios com o Scribe na ElevenAPI ou saiba mais sobre transcrição em nível de palavra.
Perguntas frequentes sobre timestamps e transcrição com tags de eventos

Jack Limebear faz parte do time de Growth, atuando como redator e estrategista de conteúdo no blog e nas páginas de insights. Antes da ElevenLabs, ele passou mais de dez anos liderando estratégias de conteúdo em organizações que vão de startups SaaS em rápido crescimento a empresas da Fortune 500. Ele é mestre em Literatura Inglesa pela Universidade de Cambridge.


