Text to Speech vs. Speech to Text: qual é a diferença?
- Publicado
- Última atualização
OuvirOuça este artigo
Imagine a seguinte situação: você está dirigindo para o trabalho, e seu smartphone lê seus e-mails não lidos usando um software de Text to Speech (TTS). Melhor ainda: você envia suas respostas sem precisar tocar no celular nem tirar os olhos da estrada — tudo graças ao software de Speech to Text (STT).
Essas tecnologias não são apenas conceitos divertidos e futuristas. Elas estão rapidamente se tornando partes essenciais do nosso dia a dia, simplificando tarefas e ampliando a acessibilidade.
Vamos explorar o mundo do TTS e do STT com inteligência artificial, entendendo o que são, suas diferenças, como funcionam, o que procurar em provedores de TTS e STT e as diversas formas como são aplicados em diferentes setores.
As diferenças entre TTS e Text from Speech
Há várias diferenças importantes entre TTS e a tecnologia Text from Speech. Veja quais são.
Funcionalidade
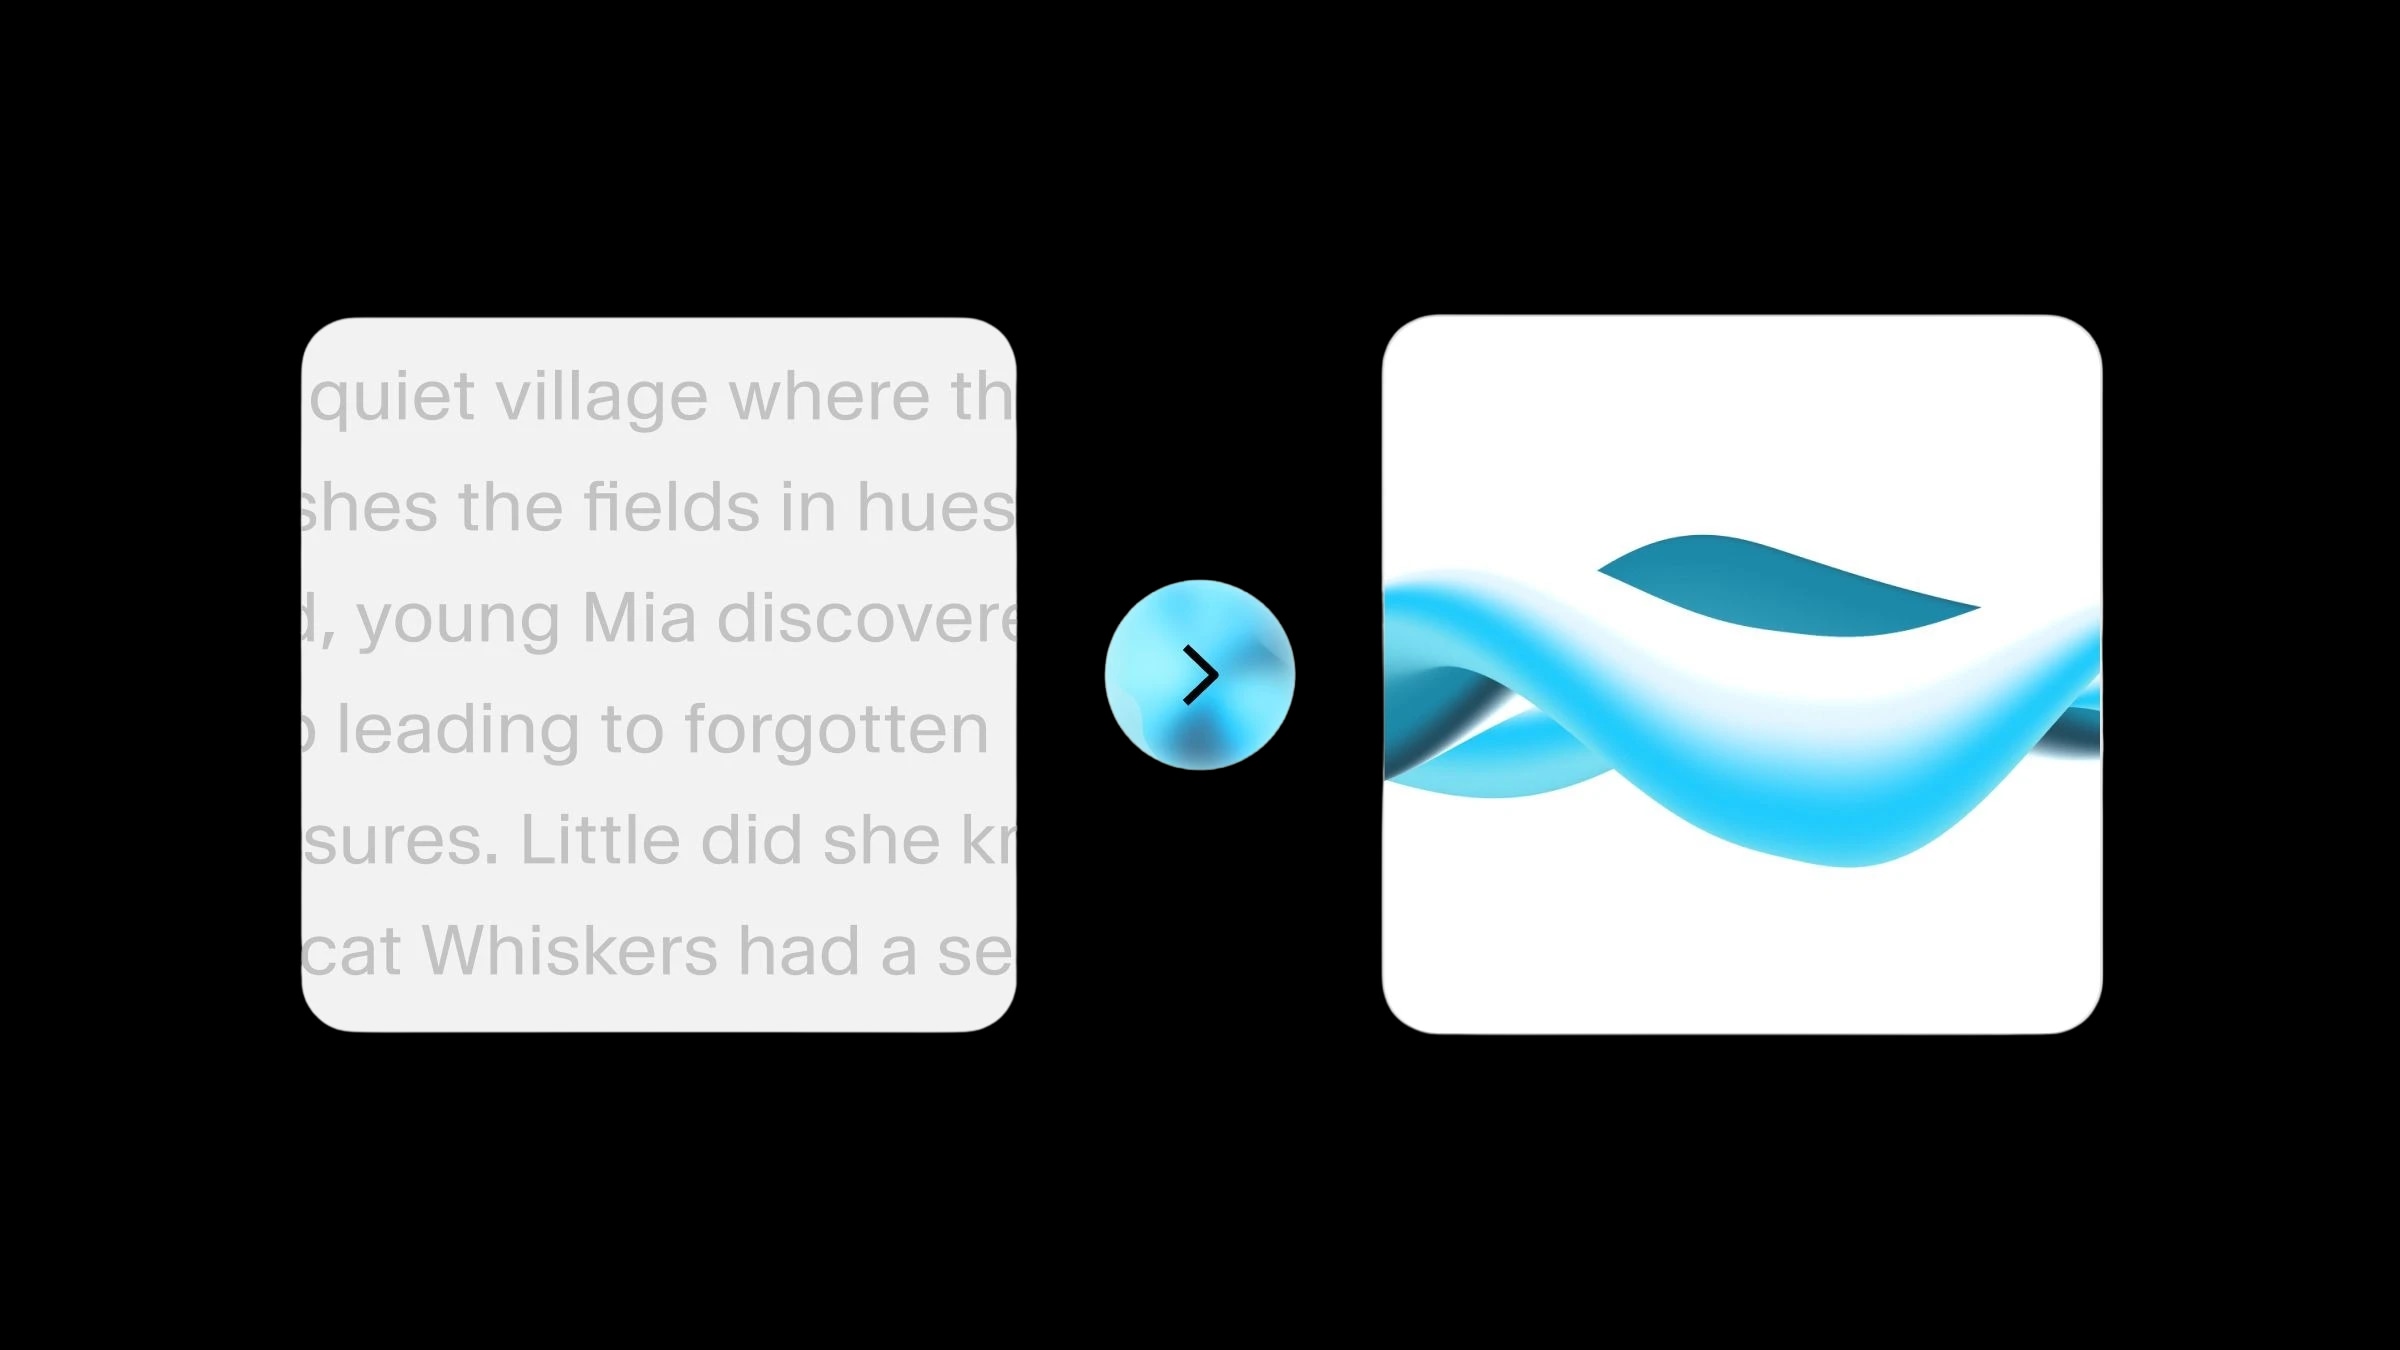
O TTS (TTS) converte texto escrito em palavras faladas, enquanto o Speech to Text (STT) faz o oposto, transcrevendo palavras faladas em texto. O TTS torna o conteúdo escrito audível e atua como um assistente de voz para pessoas com deficiência visual ou dificuldades de aprendizagem. Já o STT capta a linguagem falada e a transforma em uma transcrição escrita, o que é útil para ditado e comandos de voz.
Contexto de uso
TTS é comumente integrado a leitores digitais, sistemas de anúncios públicos e assistentes virtuais para oferecer saída de áudio. O STT é usado em serviços de transcrição, aplicativos controlados por voz e legendagem em tempo real para pessoas com deficiência auditiva. O contexto de uso do TTS é voltado principalmente à saída, com foco em transmitir informações por áudio. Já o STT é centrado na entrada, com foco em captar e processar a linguagem falada.
Abordagem tecnológica
TTS envolve análise de texto, processamento de linguagem e síntese de fala. Ele precisa transmitir com precisão as nuances da linguagem falada, incluindo entonação e ritmo. O STT exige recursos avançados de reconhecimento de voz para transcrever com precisão diferentes sotaques, dialetos e padrões de fala, muitas vezes em tempo real.
O que é TTS (TTS)?
TTS (TTS) é uma tecnologia que converte texto escrito em palavras faladas. Em sua essência, o TTS permite que computadores leiam em voz alta, transformando qualquer texto em uma voz sintética. Essa tecnologia é amplamente usada em aplicações que vão de assistentes virtuais a ferramentas de acessibilidade para pessoas com dificuldades de leitura.
Um exemplo notável de tecnologia de TTS avançada são os recursos de TTS da ElevenLabs. O TTS da ElevenLabs se destaca por sua capacidade de produzir vozes excepcionalmente naturais e semelhantes às humanas. Isso é possível graças a algoritmos sofisticados de IA, que não apenas imitam o som da fala humana, mas também entendem e reproduzem as nuances e inflexões que caracterizam os padrões naturais de fala.
Esse nível de realismo torna o TTS da ElevenLabs ideal para criar conteúdos de áudio envolventes para diferentes mídias, aprimorar interfaces com feedback por voz e oferecer uma alternativa de leitura acessível para usuários com deficiência visual.
O que é Text from Speech (Speech to Text, STT)?
Text from Speech, também conhecido como Speech to Text (STT), é o processo de converter linguagem falada em texto escrito. Essa tecnologia de reconhecimento de fala é fundamental para criar transcrições de gravações de áudio, habilitar comandos de voz e facilitar legendagem em tempo real para acessibilidade.
A ElevenLabs fez avanços significativos na tecnologia STT. Nosso modelo Scribe converte áudio e vídeo em texto com eficiência, em 99 idiomas. Ele oferece uma interface fácil de usar, ideal para registrar reuniões, palestras e entrevistas por escrito a partir de arquivos de áudio e vídeo.
Como o TTS funciona?
A tecnologia TTS (TTS) transforma texto escrito em fala audível, em um processo que envolve várias etapas complexas.
Inicialmente, o sistema de TTS analisa o texto e o segmenta em fonemas — as menores unidades sonoras de qualquer idioma. Essa segmentação é essencial para que o sistema consiga pronunciar várias palavras com precisão.
Depois dessa segmentação fonêmica, o sistema converte esses sons em fala digital. Nesse ponto, a inteligência artificial (IA) tem um papel fundamental. Com algoritmos de IA treinados em extensos conjuntos de dados de linguagem falada, o sistema pode produzir uma fala com tons e ritmos semelhantes aos humanos. Essa fala gerada é então alinhada aos fonemas identificados, resultando em uma saída com som natural.
Graças aos avanços em IA e aprendizado de máquina, as tecnologias modernas de TTS evoluíram muito. Agora, elas conseguem entender nuances contextuais, atender a vários idiomas e até reproduzir parcialmente inflexões emocionais. Essas melhorias tornaram a fala gerada muito mais humana, levando a interações mais naturais e envolventes com dispositivos digitais.
Quais são os melhores provedores de TTS?
The best TTS software solutions are ElevenLabs, Murf, and PlayHT. Here’s a brief rundown of their main features, pros, cons, and rating out of 5.
Como o Speech to Text funciona?
A tecnologia Speech to Text (STT) transforma linguagem falada em texto escrito por meio de um processo complexo com várias etapas.
Primeiro, as palavras faladas são captadas, normalmente por um microfone. Essa entrada de áudio é então convertida em um formato digital que o sistema pode processar. O ponto central do STT é sua capacidade de analisar esse áudio digital. Ele usa algoritmos sofisticados para dividir a fala em segmentos menores e reconhecíveis.
Esses segmentos são fonemas, as menores unidades de som da fala. O sistema STT compara esses fonemas a um modelo linguístico predefinido para identificar palavras e frases. Essa etapa é essencial para entender diferentes sotaques, dialetos e variações na fala.
Em seguida, o sistema aplica técnicas de processamento de linguagem natural (PLN). O PLN ajuda a entender o contexto e a sintaxe da linguagem falada, permitindo uma transcrição mais precisa. Ele também permite que o sistema lide com estruturas de frases complexas e jargões específicos de cada setor.
Sistemas STT avançados usam algoritmos de aprendizado de máquina e aprendizado profundo, que melhoram com mais dados e uso. Essas tecnologias permitem que o sistema aprenda, ao longo do tempo, novos padrões de fala, sotaques e até idiomas, aumentando sua precisão e eficiência.
Em resumo, a tecnologia STT envolve captura de áudio, análise fonêmica, modelagem linguística e PLN, tudo apoiado por aprendizado de máquina, para converter fala em texto com eficiência.
Quais são os melhores provedores de Speech to Text?
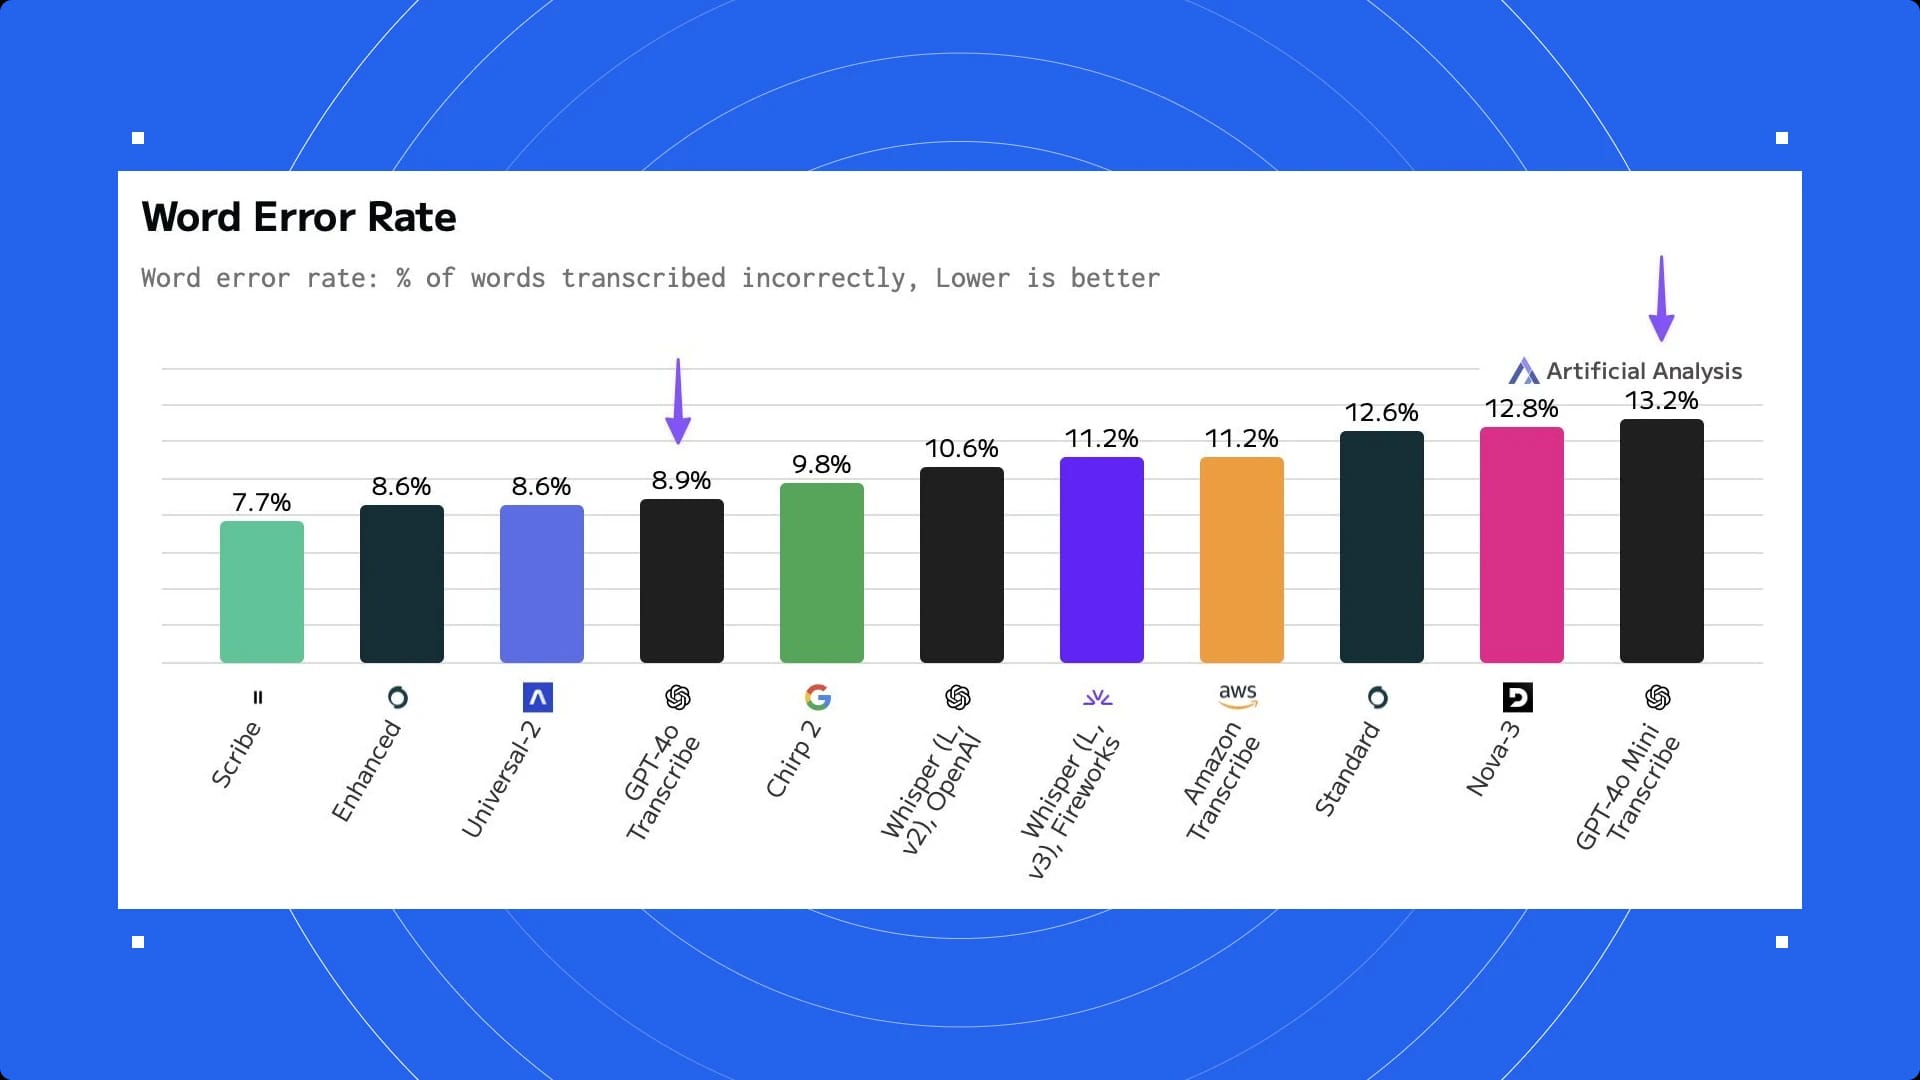
Os melhores provedores de Speech to Text são o Scribe da ElevenLabs, seguido pela OpenAI e outros provedores, como o Google.
TTS e STT: precisão e desafios
As tecnologias TTS e Speech to Text buscam uma precisão semelhante à humana. Sua precisão melhora constantemente, mas isso não quer dizer que seja perfeita. Veja o que esperar em termos de precisão e desafios dessas duas tecnologias.
Precisão e desafios do TTS (TTS)
A tecnologia de TTS com voz IA evoluiu significativamente, mas ainda enfrenta desafios. O principal é alcançar vozes humanas com som natural. Embora os sistemas modernos de TTS possam produzir áudio claro e compreensível, incluir inflexões e emoções semelhantes às humanas continua sendo um obstáculo. Além disso, o TTS tem dificuldades para interpretar o contexto e, às vezes, pronuncia palavras incorretamente conforme o contexto. Outro desafio é personalizar vozes para atender a necessidades diversas, como diferentes sotaques e padrões de fala, algo essencial para a acessibilidade global.
Precisão e desafios do Text from Speech/Speech to Text (STT)
A tecnologia STT avançou em precisão, especialmente com o surgimento do aprendizado profundo. No entanto, ela encontra dificuldades em ambientes barulhentos, onde sons de fundo podem interferir no reconhecimento de voz. Captar e transcrever com precisão diferentes sotaques e dialetos também é um desafio significativo. Além disso, sistemas STT frequentemente têm dificuldade com homófonos — palavras que soam iguais, mas têm significados diferentes — e para entender sintaxe complexa ou gírias, o que afeta sua eficácia geral em aplicações do mundo real.
Aplicações em diversos setores
TTS e as tecnologias Speech to Text encontraram casos de uso inovadores em uma grande variedade de setores, transformando a forma como interagimos com informações e ampliando a acessibilidade.
Aplicações de TTS nos setores
A tecnologia TTS é aplicada em vários setores. Na educação, ela ajuda a criar materiais de aprendizagem acessíveis para estudantes com dificuldades de leitura ou deficiência visual. Por exemplo, ao transformar livros didáticos em audiolivros.
No setor automotivo, o TTS fornece respostas por voz em sistemas de navegação. O setor de atendimento ao cliente usa TTS para respostas automatizadas em call centers, aumentando a eficiência. Além disso, o TTS é fundamental no entretenimento, especialmente em jogos e assistentes virtuais, onde proporciona experiências interativas aos usuários.
Aplicações de STT nos setores
A tecnologia STT tem aplicações diversas em vários setores. Na saúde, ela ajuda a transcrever conversas entre médicos e pacientes e a ditar documentação clínica, melhorando a eficiência. Na área jurídica, o STT é usado para transcrever processos judiciais e documentos legais. A tecnologia também tem um papel fundamental na mídia, ajudando a gerar legendas em tempo real para transmissões destinadas a pessoas com deficiência auditiva. No mundo corporativo, o STT facilita transcrições eficientes de reuniões, melhorando o registro e a acessibilidade das informações.
Considerações finais
As tecnologias TTS (TTS) e Speech to Text (STT), embora pareçam semelhantes, têm funções distintas. O TTS transforma texto escrito em palavras faladas, dando vida ao conteúdo escrito com vozes semelhantes às humanas. Já o STT faz o oposto: converte palavras faladas em texto escrito e registra as nuances da linguagem falada em formato textual.
Ambas as tecnologias usam IA avançada, mas atendem a necessidades diferentes: o TTS para o consumo por áudio de material escrito, e o STT para criar registros escritos de conteúdo falado.
Pronto para começar? Experimente o Eleven v4, nosso modelo de Text to Speech mais expressivo.
Se você quer conhecer uma tecnologia TTS de última geração, crie sua conta na ElevenLabs hoje mesmo. Você não vai se decepcionar.