
Tutorial de reconhecimento de fala em Python: do arquivo de áudio à transcrição
- Escrito por
- Jack Limebear
- Publicado
- Última atualização
OuvirOuça este artigo
Antes, adicionar recursos de reconhecimento de fala a um app em Python era trabalhoso. Os desenvolvedores Python precisavam programar todo o processo de transcrição, incluindo pré-processamento de áudio, extração de características e integração de modelos. Além disso, as equipes de engenharia enfrentavam o processamento de áudio de baixo nível, qualidade de transcrição abaixo do ideal e atrasos entre as palavras faladas e as legendas ao vivo.
Os avanços nos modelos de áudio e nos SDKs de reconhecimento de fala mudaram isso.
Neste tutorial de reconhecimento de fala em Python, você vai aprender a integrar os modelos de áudio Speech to Text da ElevenLabs ao seu projeto em Python para criar apps de transcrição prontos para uso comercial.
Resumo
- Os modelos comerciais de Speech to Text oferecem recursos como diarização de locutores, timestamps por palavra e sugestões de termos-chave, que os modelos básicos de reconhecimento de fala não têm.
- O ElevenAPI adiciona recursos de reconhecimento de fala ao seu código Python com o Scribe v2 e o Scribe v2 Realtime.
- Os desenvolvedores podem instalar skills da ElevenLabs em uma plataforma de programação com IA para gerar código Python preciso com base na documentação oficial da API.
- Você pode testar a API da ElevenLabs gratuitamente antes de assinar um plano pago para desenvolvimento comercial.
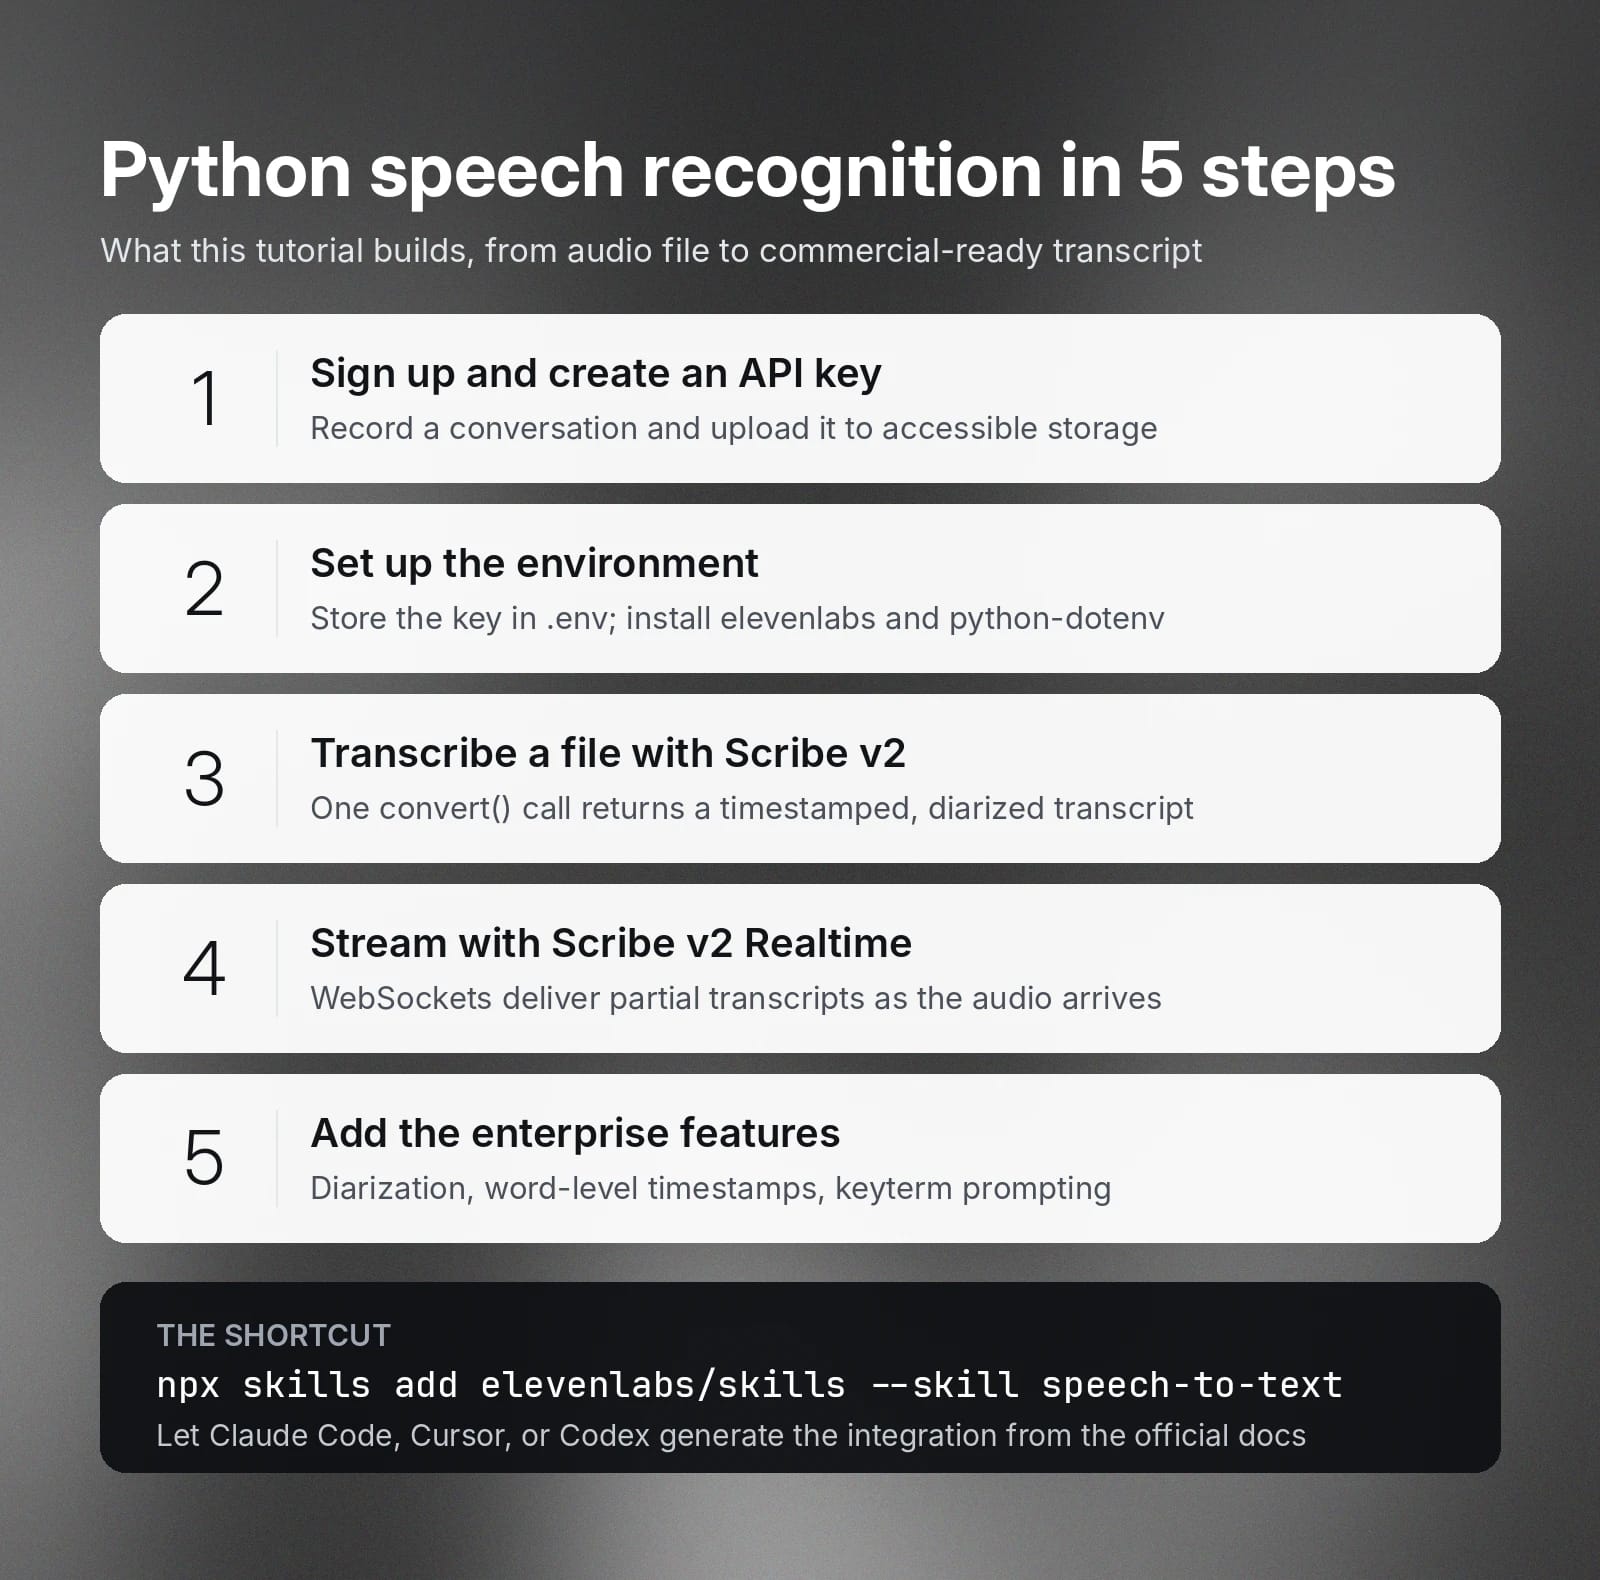
O que este tutorial de reconhecimento de fala em Python aborda
Este tutorial aborda pré-requisitos, integração de API e recursos avançados de transcrição que ajudam você a criar um app Python de reconhecimento de fala para casos de uso empresariais.
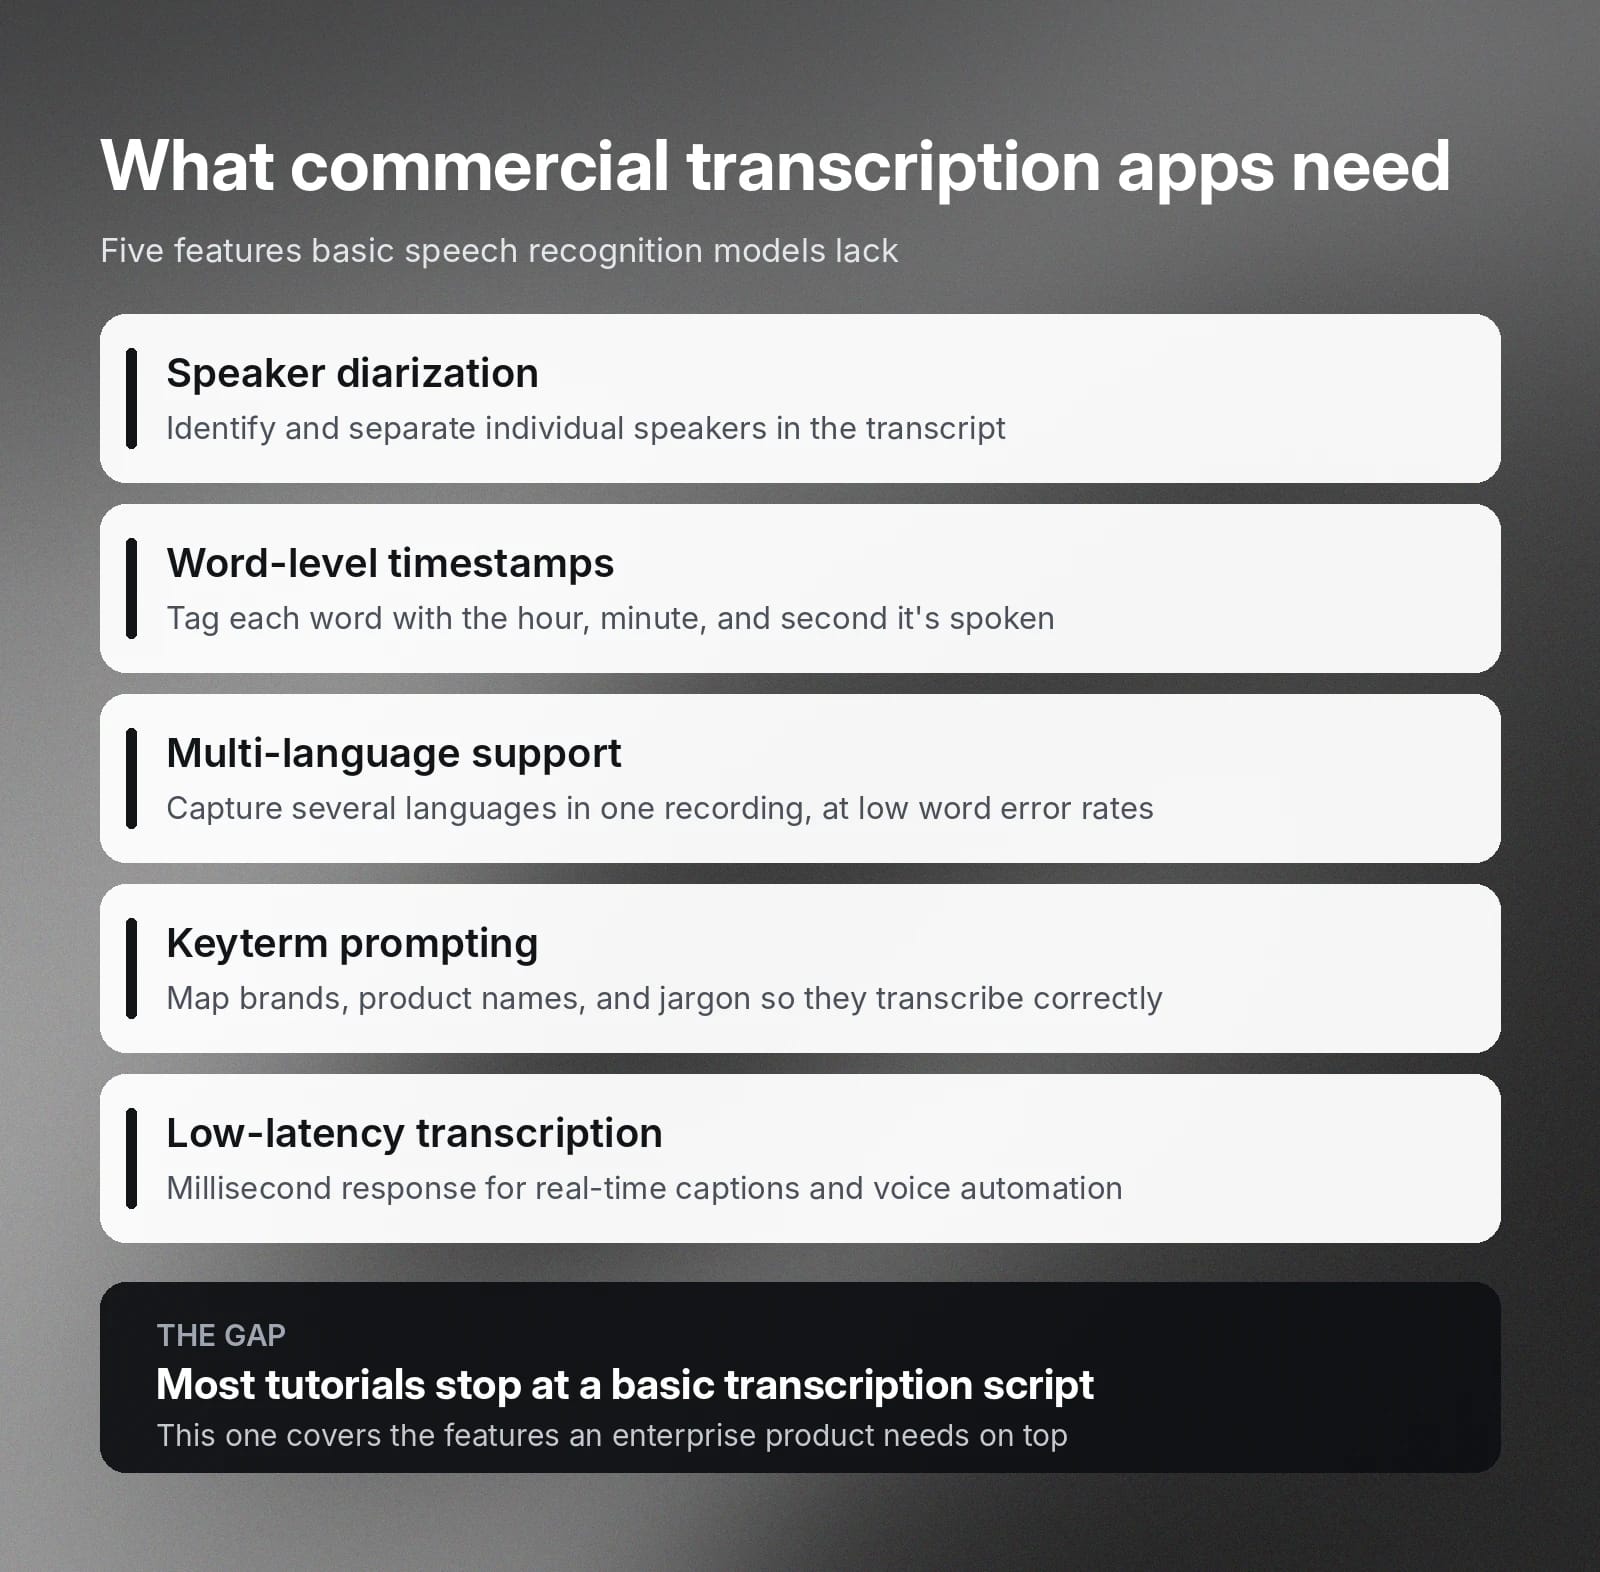
O reconhecimento de fala amadureceu nos últimos anos, especialmente porque os grandes modelos de linguagem e as redes neurais de deep learning mudaram a forma como desenvolvedores Python usam SDKs de transcrição. Embora muitos tutoriais mostrem como criar apps básicos de transcrição, poucos abordam os recursos que um produto pronto para uso comercial precisa.
Escrevemos este tutorial para preencher essa lacuna.
Por exemplo, muitas soluções empresariais de transcrição exigem estes recursos:
- Diarização de locutores: A capacidade de identificar e separar locutores individuais na transcrição.
- Timestamp: Marcação precisa de cada palavra com as horas, os minutos e os segundos relativos em que ela é falada.
- Suporte a vários idiomas: Captura falas em diferentes idiomas em uma única gravação ou transmissão ao vivo, com baixas taxas de erro por palavra.
- Sugestões de termos-chave: Mapeamento de palavras específicas, como marcas, nomes de produtos e termos técnicos, para evitar erros de grafia nas transcrições.
- Transcrição de baixa latência: Resposta de fala para texto em milissegundos que viabiliza apps de transcrição em tempo real.
Observação: este tutorial vai além da criação de scripts pessoais simples para hobbies ou projetos pessoais. Ele não inclui a lógica da aplicação criada sobre a integração com a API de Speech to Text, pois ela varia de acordo com cada empresa.
Pré-requisitos para integrar reconhecimento de fala em Python
Criamos este tutorial com base no ElevenAPI, uma API da ElevenLabs pronta para produção que simplifica a interação com modelos de voz no seu código. Com o ElevenAPI, você tem acesso ao Scribe v2 e ao Scribe v2 Realtime, nossos principais modelos de voz para transcrição em lote e ao vivo.
Em vez de acessar diretamente os modelos de Speech to Text da ElevenLabs, você envia gravações de áudio, transmissões ao vivo e argumentos por chamadas de API. Depois, o modelo de áudio converte os dados de áudio em texto. Quando o processo é concluído, você recebe as transcrições no código ou por webhook.
Para começar, siga estas etapas de preparação.
- Cadastre-se na ElevenLabs.
- Crie sua chave de API.
- Grave uma conversa e faça upload para um armazenamento acessível publicamente.
Quando estiver tudo pronto, avance para a próxima seção.
Configurando seu ambiente
Antes de integrar os modelos da ElevenLabs, configure seu ambiente Python para proteger sua chave de API da ElevenLabs. Como acontece com todas as chaves de API, recomendamos armazená-la como uma variável de ambiente (um segredo gerenciado) no arquivo .env.
Ao fazer uma chamada de API, você passa a variável de ambiente. Isso evita que você exponha acidentalmente a chave de API ao fazer solicitações de API por uma rede pública.
Em seguida, execute um comando Bash para instalar elevenlabs, o SDK da ElevenLabs, no seu ambiente Python. O SDK permite acessar vários modelos de voz. Neste caso, você escolhe entre o Scribe v2 e o Scribe v2 Realtime.
Você também precisará instalar python-dotenv, que permite ao seu código Python acessar variáveis de ambiente armazenadas no arquivo .env.
Escrevendo seu primeiro script de transcrição
Depois de configurar o ambiente Python, você pode transcrever o arquivo de áudio usando o ElevenLabs Scribe v2.
O ElevenLabs Scribe v2 é um modelo de reconhecimento de fala líder do setor que permite transcrever arquivos de áudio em escala. Ele detecta fonemas com alta precisão, mesmo quando a gravação de áudio tem muito ruído de fundo. Para transcrever o áudio, você envia a gravação ao modelo pela API da ElevenLabs e recupera a transcrição concluída.
Abaixo está um trecho de código Python que converte um arquivo de áudio em uma transcrição com timestamps e diarização.
O código carrega as bibliotecas necessárias, que fornecem as funções de que ele precisa. Ele também carrega para o ambiente do programa as variáveis de ambiente que você declarou.
Em seguida, ele cria um cliente da ElevenLabs usando a chave de API armazenada na variável de ambiente. Depois, faz download do arquivo de áudio e o converte em dados binários.
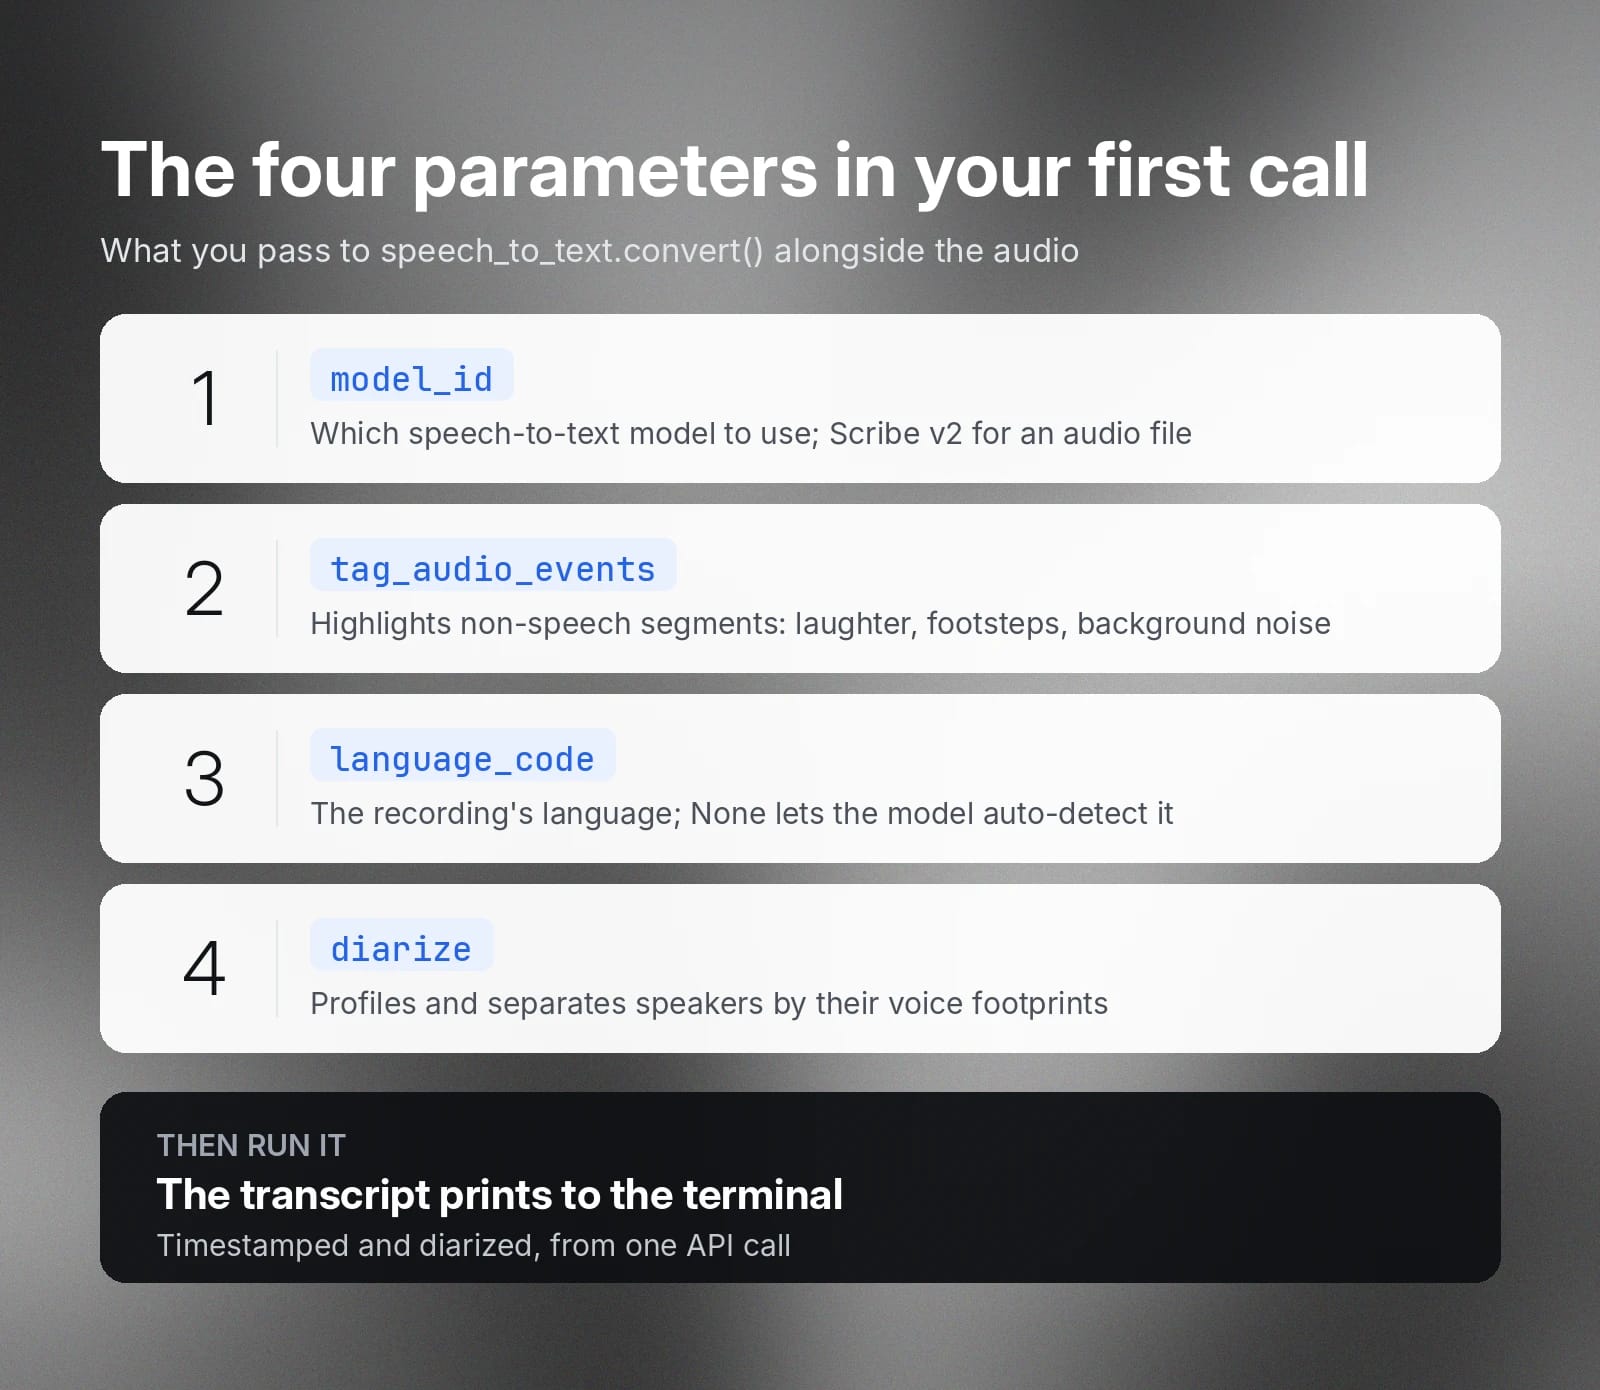
Depois de ter os dados brutos de áudio, você os envia para a API da ElevenLabs junto com vários parâmetros.
- model_id indica o modelo de fala para texto que você quer usar. Como você está enviando um arquivo de áudio, o Scribe v2 é a melhor opção.
- tag_audio_events permite destacar segmentos sem fala, como risadas, passos e outros ruídos de fundo.
- language_code representa o idioma das conversas no arquivo de gravação. Quando definido como None, o modelo detecta o idioma automaticamente.
- diarize indica se você quer que o modelo identifique e separe diferentes locutores com base nas características das vozes.
Por fim, execute o código e você verá o áudio transcrito no terminal.
Reconhecimento de fala por streaming em Python
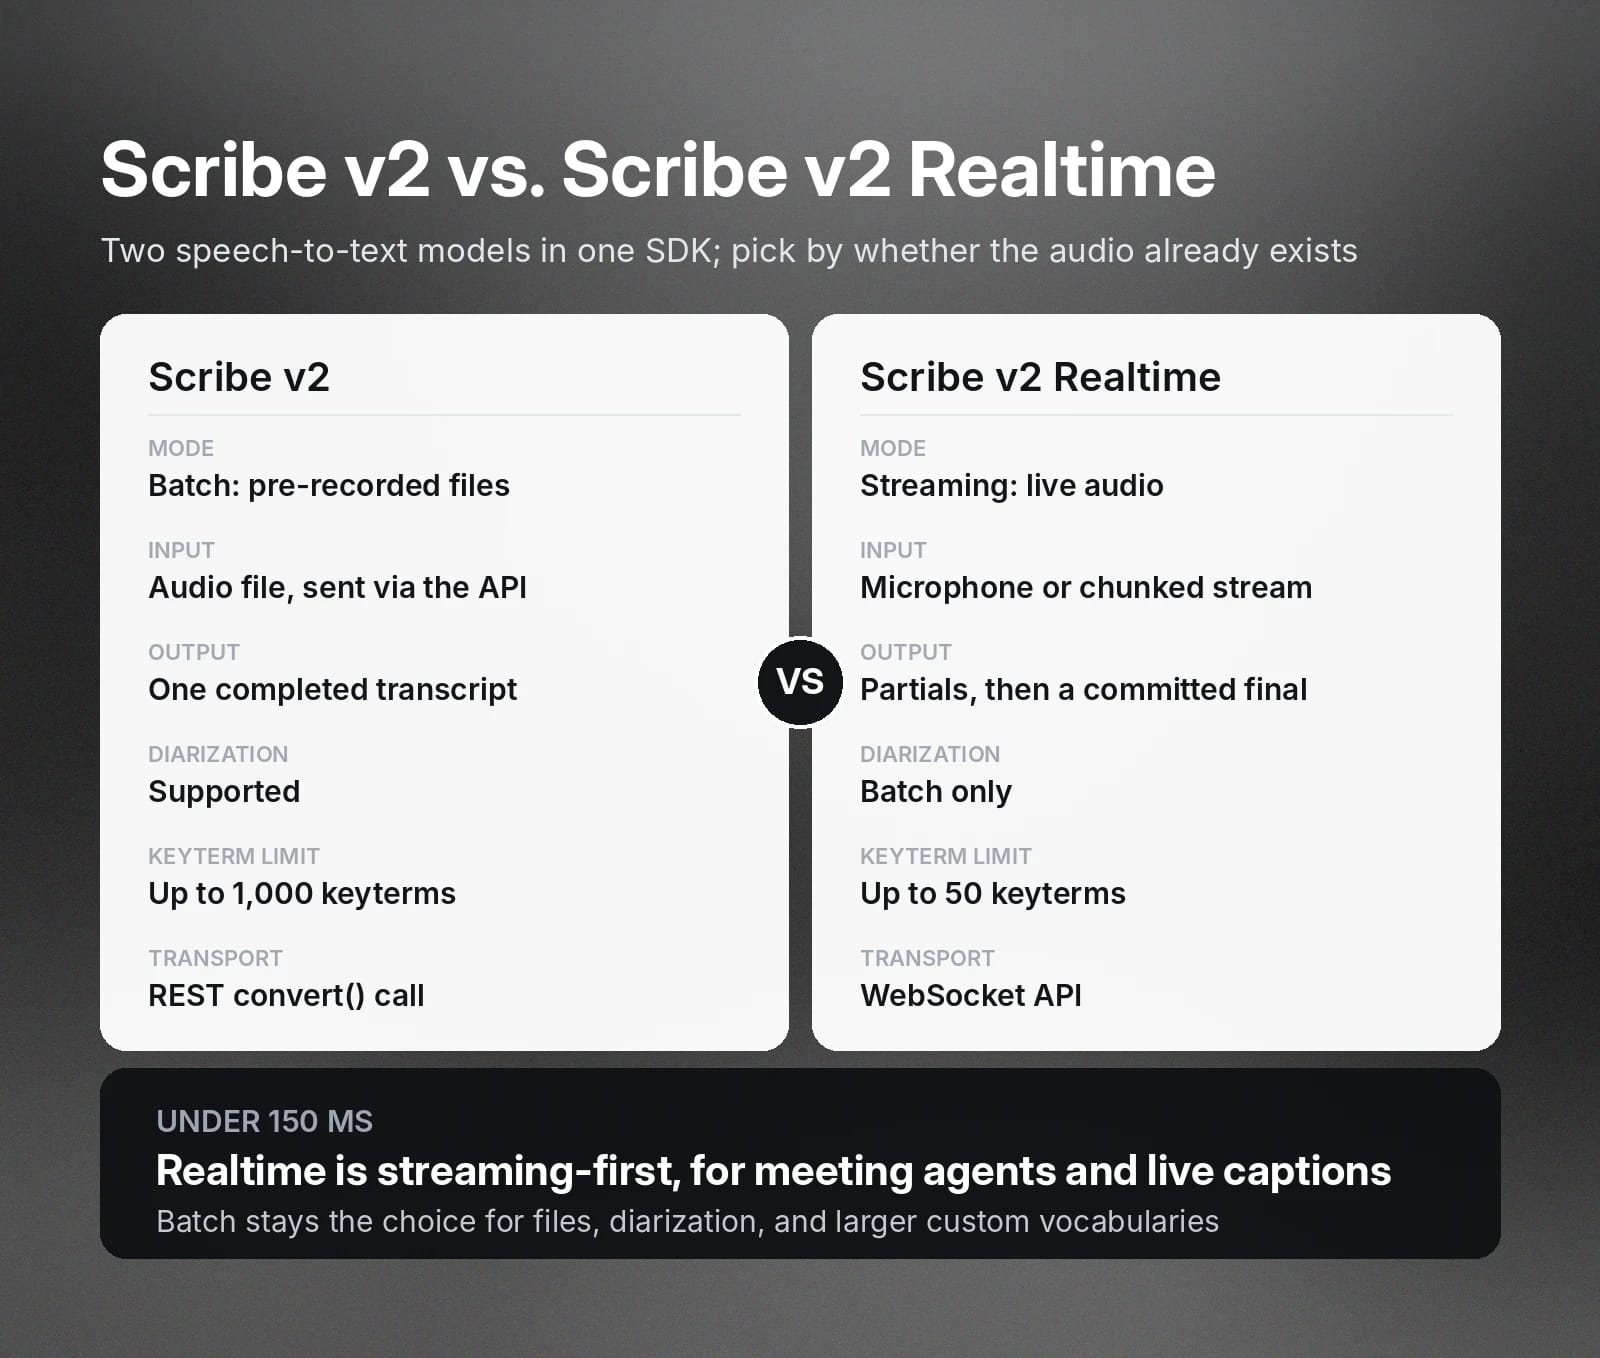
O exemplo acima aborda a transcrição em lote, adequada para arquivos pré-gravados. No entanto, a ElevenLabs também oferece APIs que permitem criar reconhecimento de fala por streaming. Diferentemente do processamento em lote, esse modo executa o reconhecimento de fala em tempo real para gerar transcrições enquanto a conversa acontece.
Para isso, você conecta seu código Python ao modelo Scribe v2 Realtime usando a API WebSocket.
O Scribe v2 Realtime oferece uma arquitetura focada em streaming, com latência de transcrição inferior a 150 ms. Você pode usar o Scribe v2 Realtime para criar aplicações como agentes de reunião, ferramentas de acessibilidade e automação ativada por voz. O modelo retorna uma transcrição parcial enquanto processa o fluxo de áudio. Ele retorna a transcrição final apenas quando o código confirma um segmento de áudio, de forma automática ou manual.
Dependendo da fonte de áudio e do tipo de aplicação, você integra o reconhecimento de fala à API da ElevenLabs no lado do servidor ou do cliente.
- Streaming no lado do cliente permite transmitir diretamente do microfone ou por fluxos de áudio divididos manualmente em blocos.
- Streaming no lado do servidor encaminha dados de áudio de uma URL ou fonte de áudio para o modelo de voz.
Tanto o streaming no lado do cliente quanto no lado do servidor permitem usar um workflow assíncrono. Em vez de consultar continuamente a API, use WebSockets para processar os resultados. No seu código, você precisa criar handlers que recebam transcrições parciais e finalizadas.
Indo além: diarização, timestamps e vocabulário personalizado
Além do reconhecimento automático de fala, os modelos de Speech to Text da ElevenLabs oferecem suporte à diarização, timestamps e vocabulário personalizado.
- Diarização: apenas a transcrição em lote oferece suporte à diarização de locutores. Você ativa a diarização definindo o argumento diarize. No entanto, a transcrição multicanal, um modo da transcrição em lote, não oferece suporte à diarização.
- Timestamps: ao realizar uma transcrição em lote, você pode escolher timestamps no nível de palavra ou caractere. Para isso, defina o parâmetro timestamps_granularity ao usar o método convert.
- Vocabulário personalizado: Tanto a transcrição em tempo real quanto a em lote oferecem suporte a sugestões de termos-chave. Esse recurso orienta o modelo a transcrever termos-chave específicos incluídos em uma lista. O Scribe v2 Realtime aceita até 50 termos-chave, enquanto o Scribe v2 aceita 1.000 termos-chave.
Usando a skill da ElevenLabs em assistentes de programação com IA
Assistentes de programação com IA aceleram o desenvolvimento. Se você usa ferramentas como Claude Code, Cursor, Codex ou ferramentas semelhantes de programação com IA, pode adicionar skills da ElevenLabs ao ambiente de programação.
Basta executar este comando no terminal da sua plataforma:
O agente de programação com IA fará download da skill de fala para texto do repositório da ElevenLabs no GitHub e a instalará no diretório local de skills. Isso permite gerar automaticamente código Python para reconhecimento de fala com base na documentação oficial da ElevenLabs, em vez de escrever toda a integração da API do zero.
Depois de instalada, você pode gerar código Python para reconhecimento de fala apenas descrevendo em linguagem natural o que ele faz. Com base na descrição, o assistente de programação gera automaticamente código usando a skill de fala para texto, com o modelo e os parâmetros corretos.
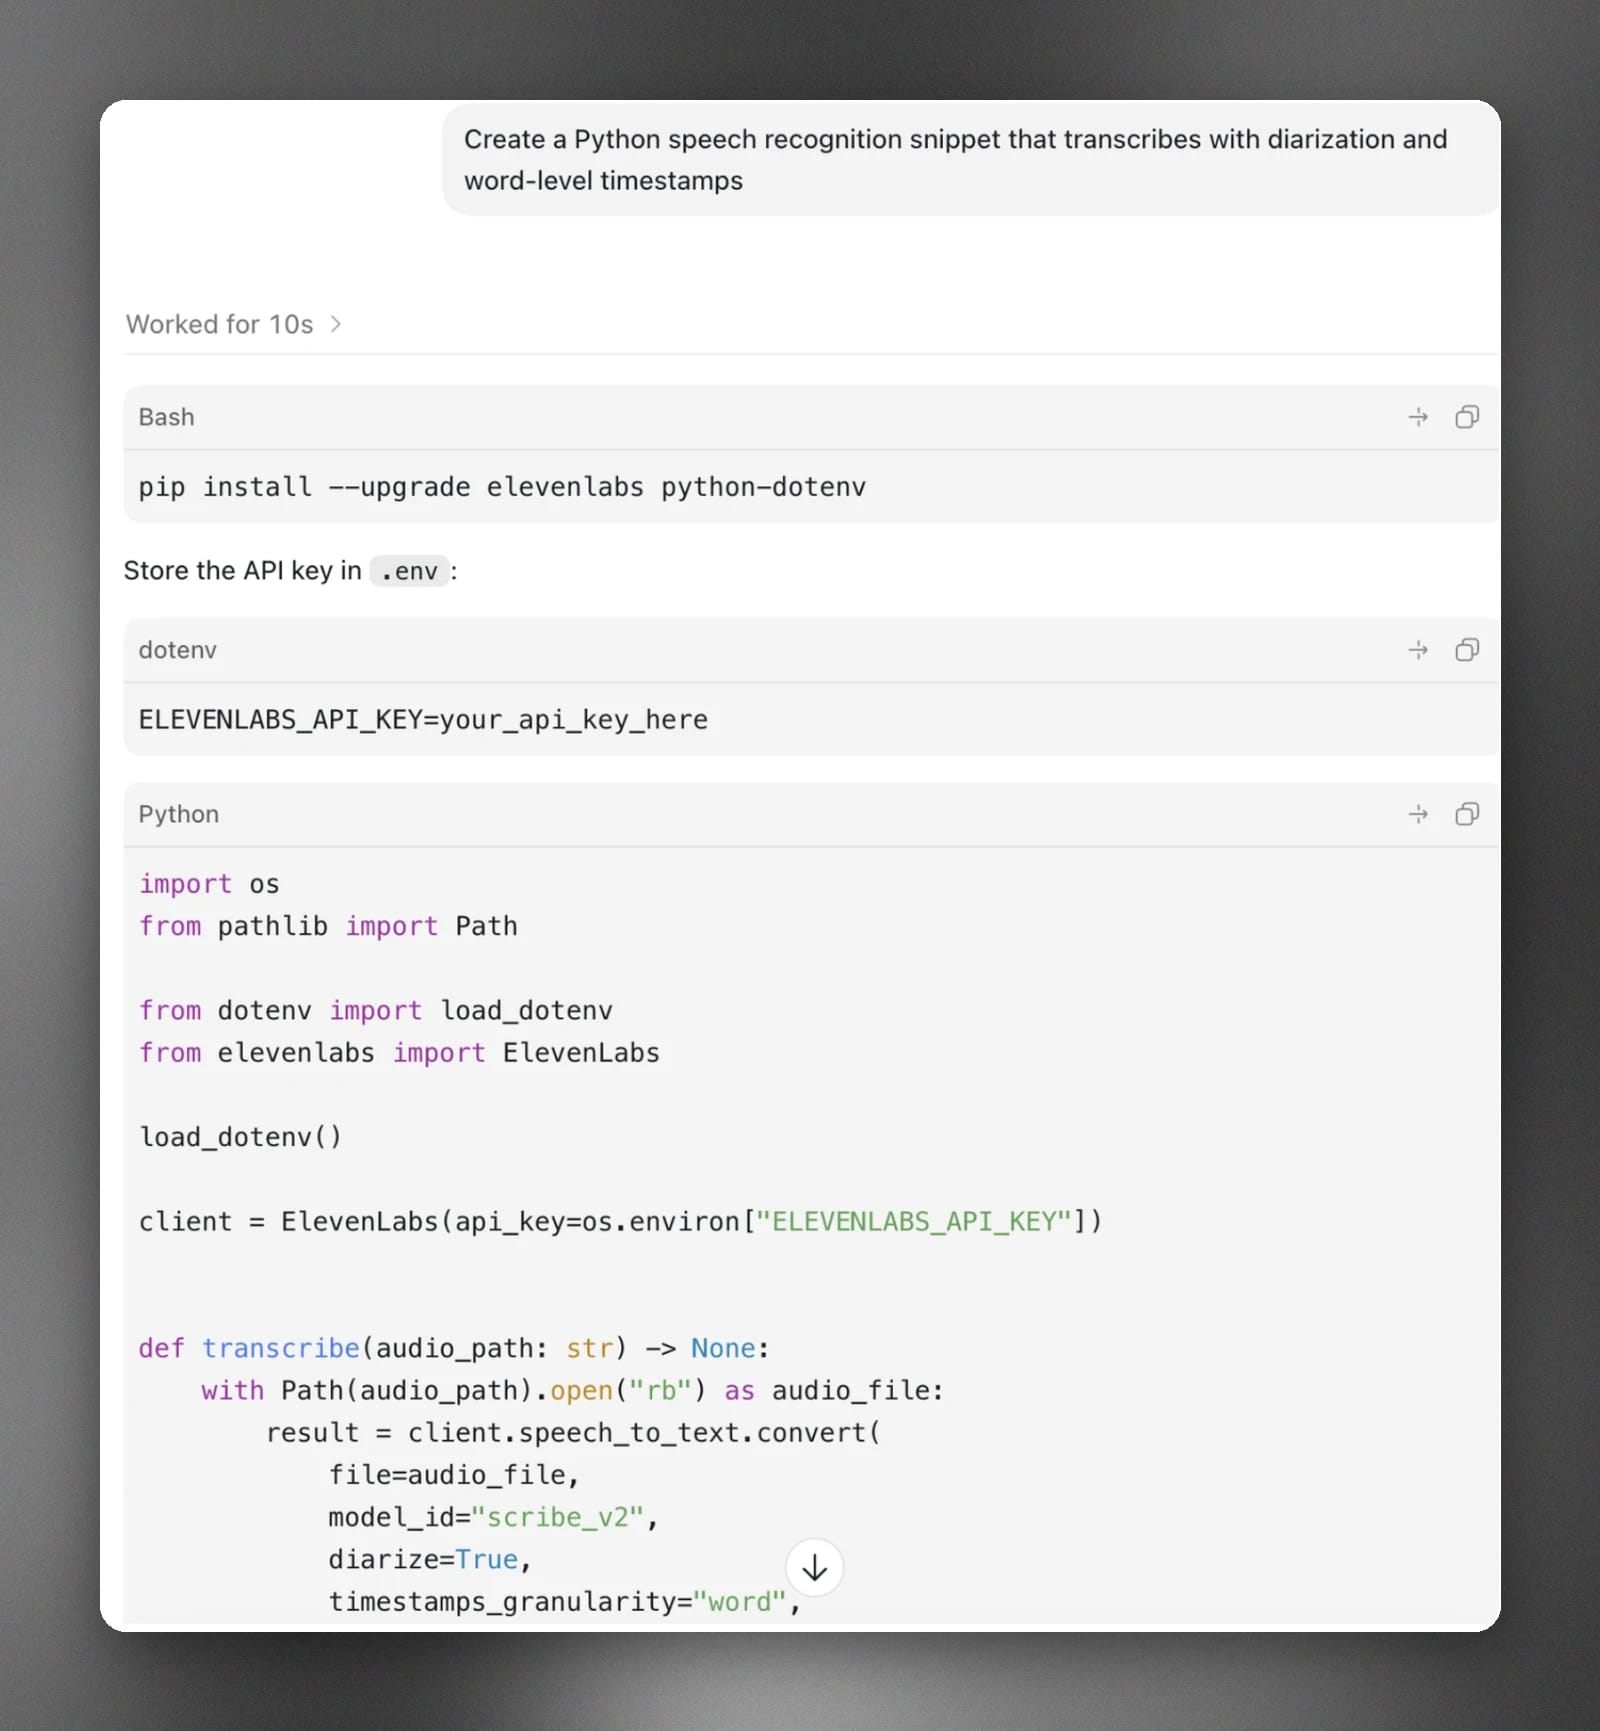
Por exemplo, se você digitar “Crie um trecho em Python para reconhecimento de fala que transcreva com diarização e timestamps no nível de palavra” no Codex, receberá um trecho semelhante ao abaixo.
Comece a usar o ElevenAPI para reconhecimento de fala
ElevenAPI permite acessar modelos avançados de Speech to Text para criar apps de reconhecimento de fala em Python.
Ao usar o ElevenAPI, você evita escrever código de integração do zero, o que atrasa a inovação do produto. Em vez disso, você usa SDKs que disponibilizam serviços de Speech to Text que atendem a requisitos de nível comercial, como sugestões de termos-chave, diarização e timestamps.
Obtenha sua chave de API da ElevenLabs agora e explore nossa documentação oficial para saber como a API funciona.
Perguntas frequentes

Jack Limebear faz parte do time de Growth, atuando como redator e estrategista de conteúdo no blog e nas páginas de insights. Antes da ElevenLabs, ele passou mais de dez anos liderando estratégias de conteúdo em organizações que vão de startups SaaS em rápido crescimento a empresas da Fortune 500. Ele é mestre em Literatura Inglesa pela Universidade de Cambridge.


