
Tutorial de reconhecimento de voz em JavaScript: crie uma UX por voz
- Escrito por
- Jack Limebear
- Publicado
- Última atualização
OuvirOuça este artigo
Implementar reconhecimento de voz em sites e apps baseados em navegador agora é mais fácil graças a APIs de Speech to Text (STT) nativas do navegador, como a Web Speech API. Desenvolvedores podem transmitir facilmente a entrada do microfone, analisar dados de áudio e processar transcrições com chamadas de API, sem precisar criar um servidor local de reconhecimento automático de voz.
A Web Speech API é uma API comum de reconhecimento de voz para implementar comandos de voz em JavaScript. Ela expõe métodos, argumentos e propriedades que permitem executar transcrições em tempo real em um navegador. No entanto, desenvolvedores podem achar a Web Speech API limitada para clientes web complexos.
Este guia mostra como configurar um app web simples de reconhecimento de voz em JavaScript com a Web Speech API, suas limitações e alternativas para criar clientes de transcrição em tempo real mais robustos.
Resumo
- A Web Speech API é uma API de Speech to Text nativa do navegador que envia o áudio do microfone a um serviço de nuvem de backend para processamento.
- Desenvolvedores usam a classe da API SpeechRecognition para criar aplicações de comandos de voz em JavaScript.
- Ao criar um app de reconhecimento de voz, considere a privacidade do usuário indicando que a gravação de áudio está em andamento.
- A Web Speech API tem várias limitações, incluindo inconsistência nas transcrições, dependência do navegador e falta de compreensão de intenção.
- A ElevenLabs oferece APIs de Speech to Text altamente precisas e prontas para produção, compatíveis com streaming do cliente e do servidor.
Como funciona a Web Speech API
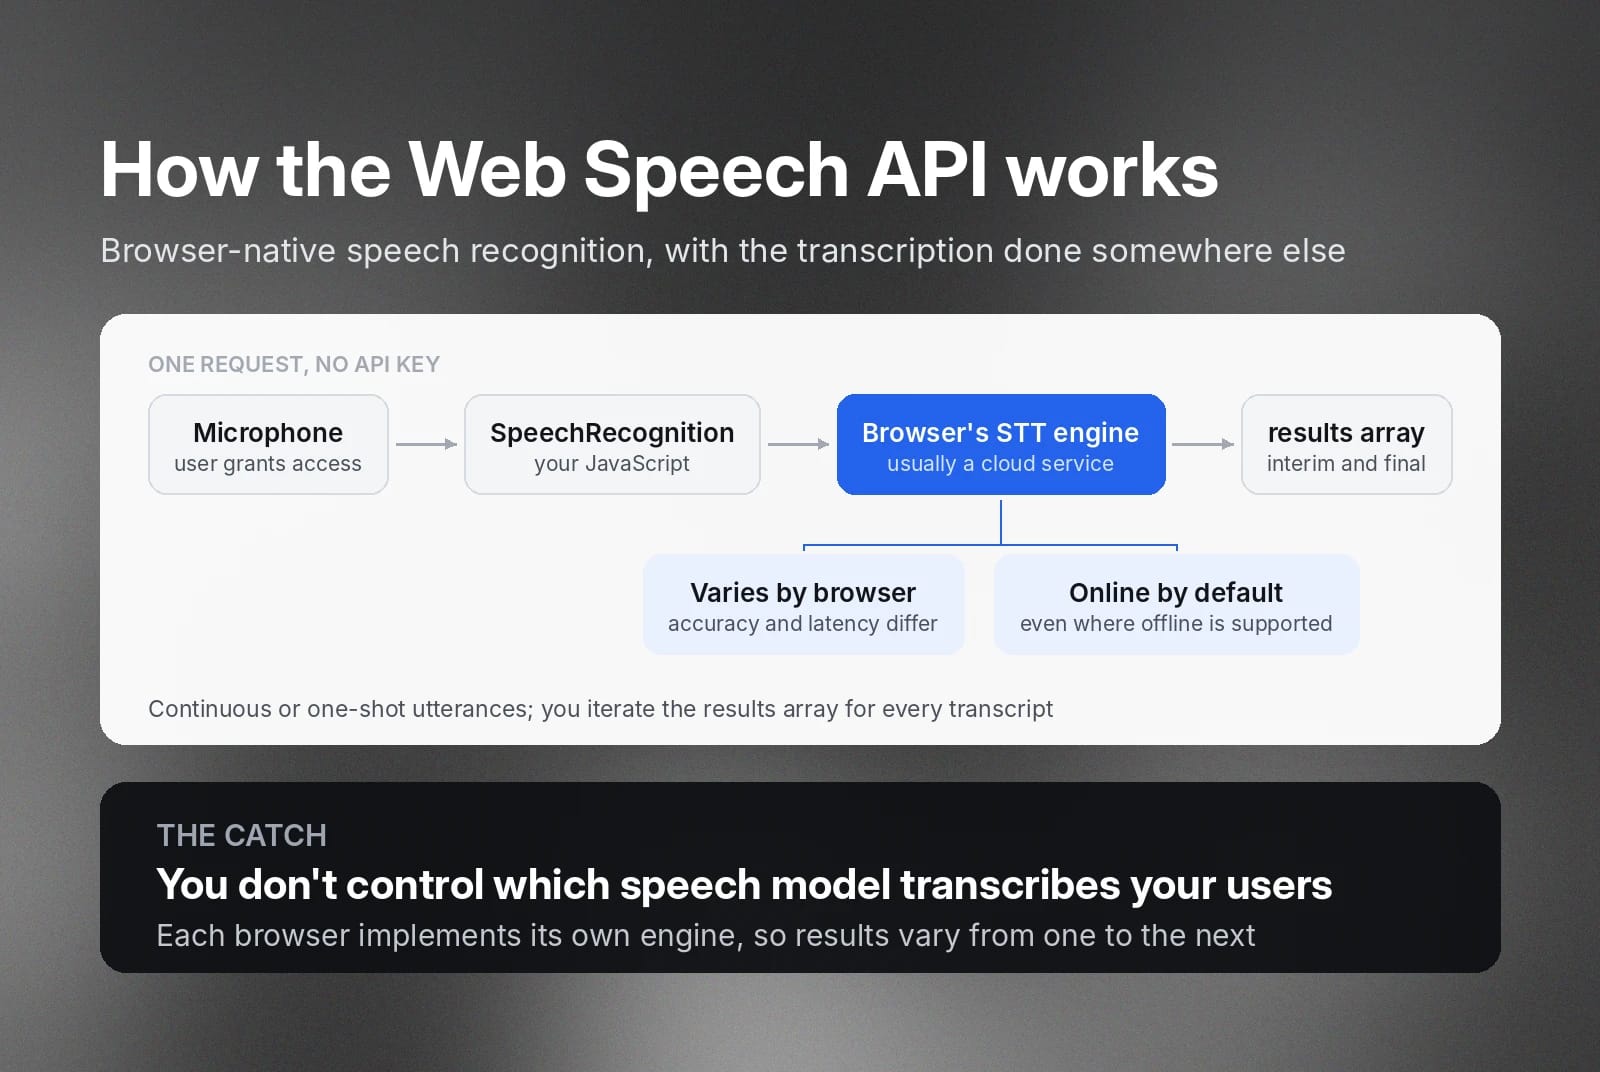
A Web Speech API oferece reconhecimento de voz nativo do navegador para desenvolvedores web, sem exigir um servidor local. Basicamente, a Web Speech API envia um fluxo de áudio do seu navegador para um serviço de nuvem de backend processar, analisar e converter o áudio em transcrições. Como ela depende do mecanismo de backend do navegador para executar a transcrição, os resultados variam entre navegadores.
Em geral, a Web Speech API exige uma conexão ativa com a internet para transcrever fluxos de áudio, especialmente se você estiver desenvolvendo para Chrome e Safari. No entanto, alguns navegadores já oferecem suporte a transcrição offline. Na transcrição offline, o navegador atua como mecanismo de Speech to Text, identificando fonemas e transformando-os em texto coerente.
Independentemente do navegador que você usa, os fundamentos da API são os mesmos.
- Você não precisa de uma chave de API para fazer uma solicitação de API.
- A Web Speech API aceita enunciados contínuos ou únicos.
- Ela retorna transcrições provisórias e finais.
No entanto, como cada navegador pode implementar o mecanismo de STT de modo diferente, a precisão e a latência podem variar.
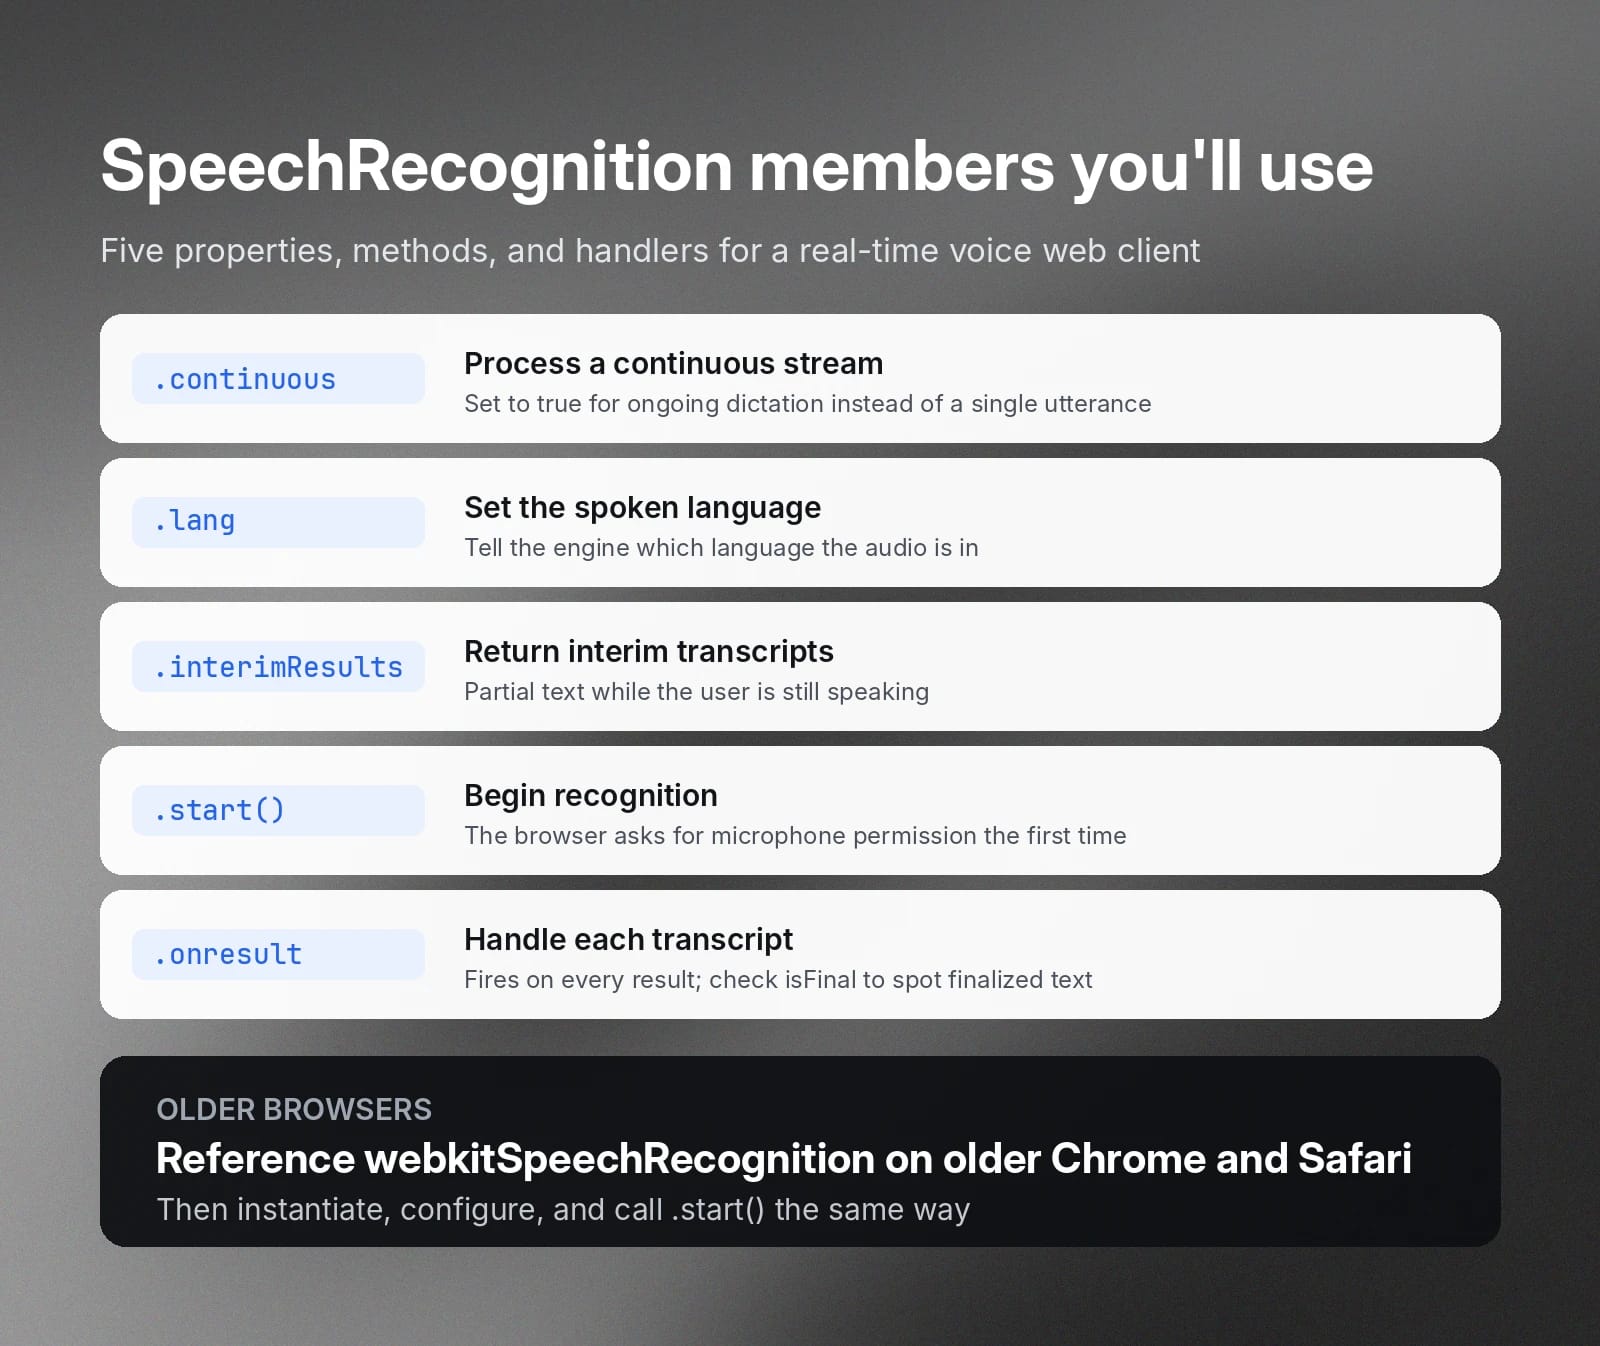
Para usar a Web Speech API, você inicializa a interface SpeechRecognition no seu código JavaScript. Depois, acessa métodos, atributos e manipuladores de eventos durante a programação. Veja alguns que você usará para criar um cliente web de pesquisa por voz.
- SpeechRecognition.continuous: Permite que o mecanismo de voz processe um fluxo contínuo quando definido como true.
- SpeechRecognition.lang: Define o idioma do áudio.
- SpeechRecognition.interimResults: Instrui o mecanismo a retornar transcrições provisórias.
- SpeechRecognition.start(): Inicia o processo de reconhecimento de voz.
- SpeechRecognition.onresult: Aceita um manipulador de eventos, que a API aciona quando termina de transcrever.
A Web Speech API retorna a transcrição em uma matriz de strings. Quando o mecanismo de STT retorna uma transcrição, provisória ou final, você pode encontrá-la na matriz results. Ela pode retornar uma ou mais strings. Portanto, você precisa iterar pelas strings de resultado para recuperar todo o texto transcrito.
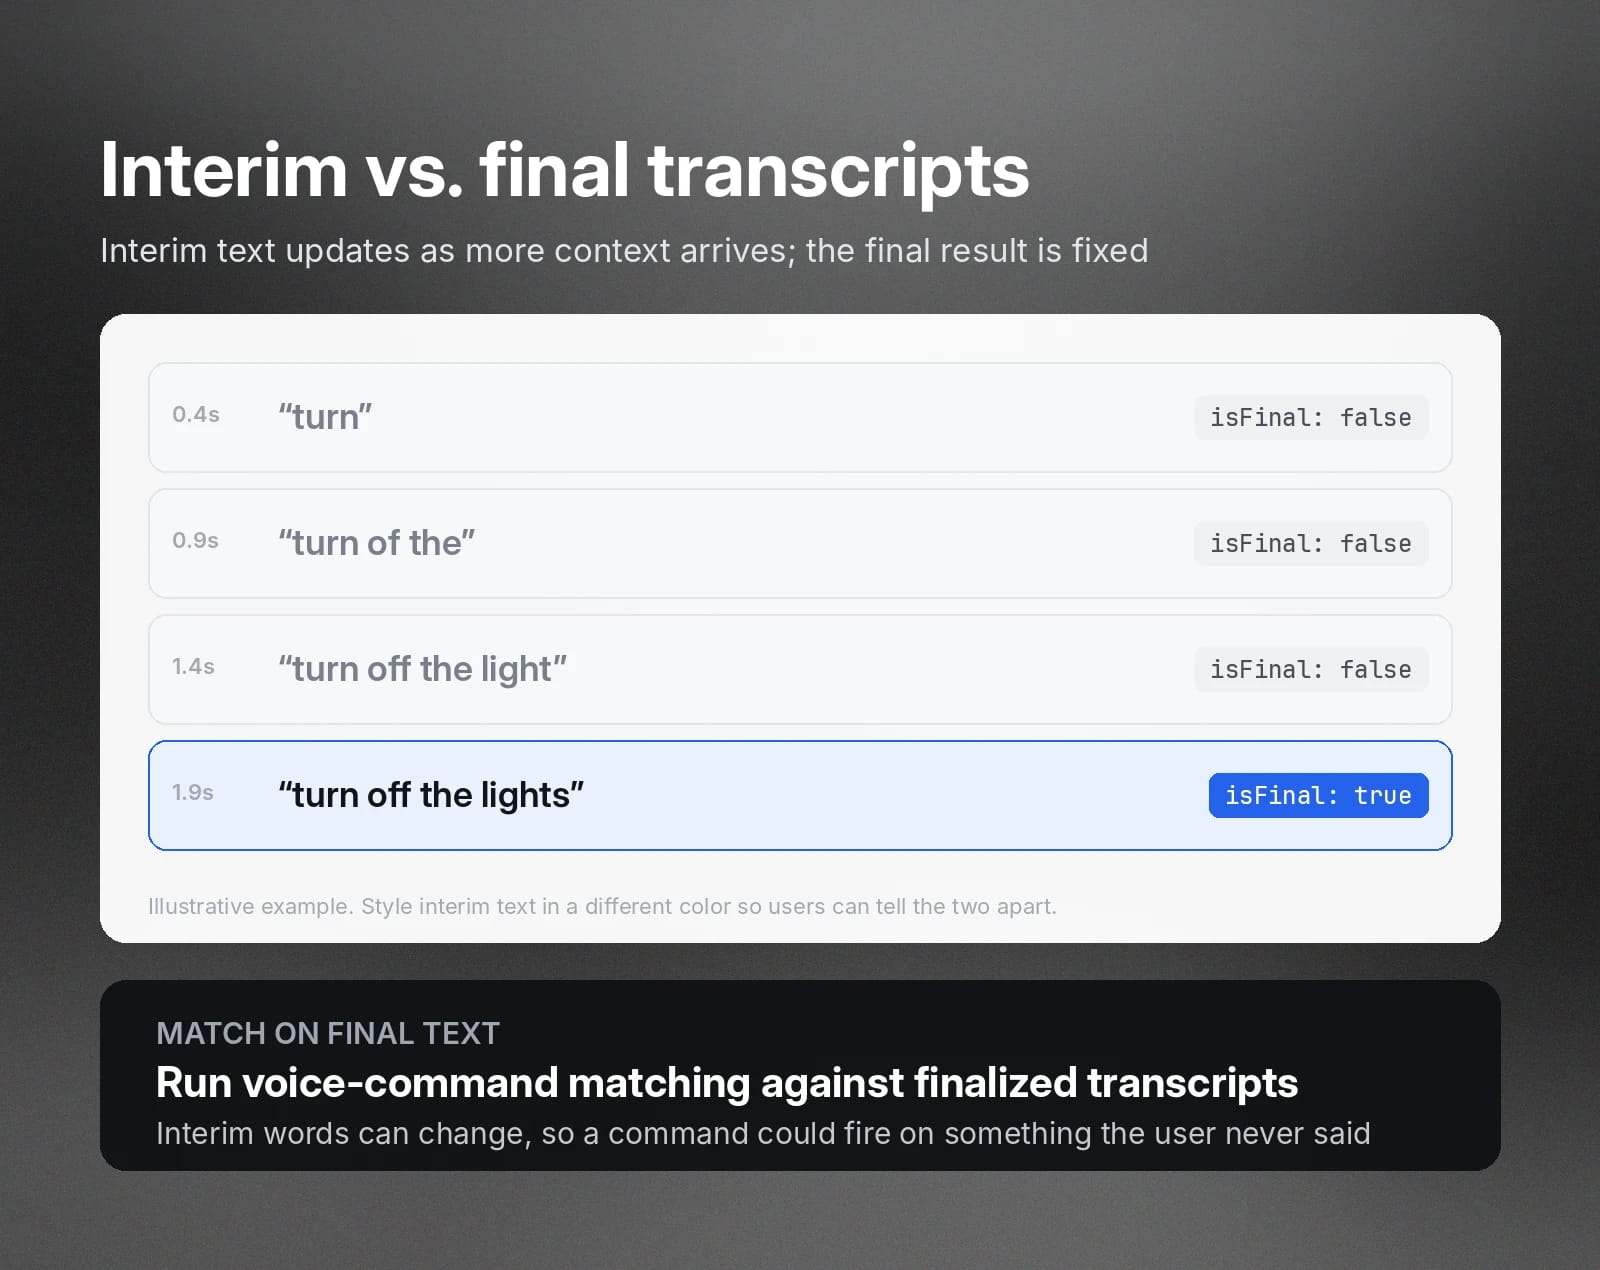
Observação: Se você ativou a transcrição provisória, verifique a propriedade isFinal para determinar se o texto é uma transcrição finalizada.
Crie um exemplo de reconhecimento de voz em JavaScript
Este exemplo usa a interface SpeechRecognition do JavaScript para criar um app web de transcrição em tempo real. A captura de tela abaixo mostra a página concluída.
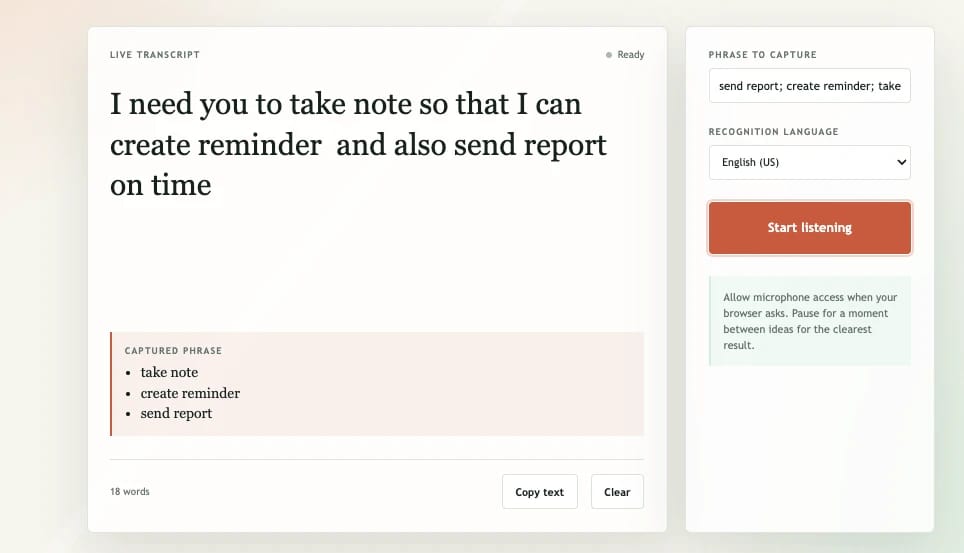
Na página de exemplo, um botão Iniciar escuta começa a gravação. À medida que o usuário fala, o navegador envia o áudio ao mecanismo de STT, aguarda a transcrição e exibe tanto o texto provisório quanto o final.
O exemplo também inclui um recurso de comandos de voz, que captura termos específicos listados pelo usuário. Ele compara a transcrição com uma lista de frases predefinidas no seu próprio código, o que é diferente do direcionamento por termos-chave em uma API de Speech to Text.
Os trechos abaixo mostram as partes principais deste exemplo.
Configure a API SpeechRecognition e solicite acesso ao microfone
Para usá-la no seu código, primeiro você precisa instanciar a classe SpeechRecognition. Se estiver usando uma versão mais antiga do Chrome ou Safari, faça referência a webkitSpeechRecognition.
Depois, crie uma instância de SpeechRecognition e configure o modo de streaming, o suporte a transcrição provisória e o idioma falado.
Em seguida, você pode começar a transcrever chamando o método .start().
Ao iniciar o processo de reconhecimento de voz pela primeira vez, o navegador pedirá permissão ao usuário. O usuário deve clicar em Permitir para iniciar a transcrição. Caso contrário, a API retornará o valor "not-allowed” no manipulador SpeechRecognitionErrorEvent handler.
Exiba transcrições ao vivo e resultados finais
Neste exemplo, exibimos a transcrição enquanto o usuário fala ao microfone. Para isso, adicionamos uma função ao evento onresult.
As transcrições provisórias não são finalizadas. Por isso, o texto exibido pode não corresponder exatamente às palavras que você falou. À medida que o mecanismo de STT recebe mais contexto das palavras seguintes, ele corrige a transcrição e a retorna na string.
Você também pode estilizar o texto provisório com uma cor diferente para destacá-lo da transcrição final. Este CSS faz isso:
Adicione comandos de voz em JavaScript
Adicione uma caixa de texto em que os usuários inserem as frases que desejam detectar, separadas por ponto e vírgula. (Como alternativa, você pode armazenar as frases em um arquivo JSON e carregá-las no seu código.)
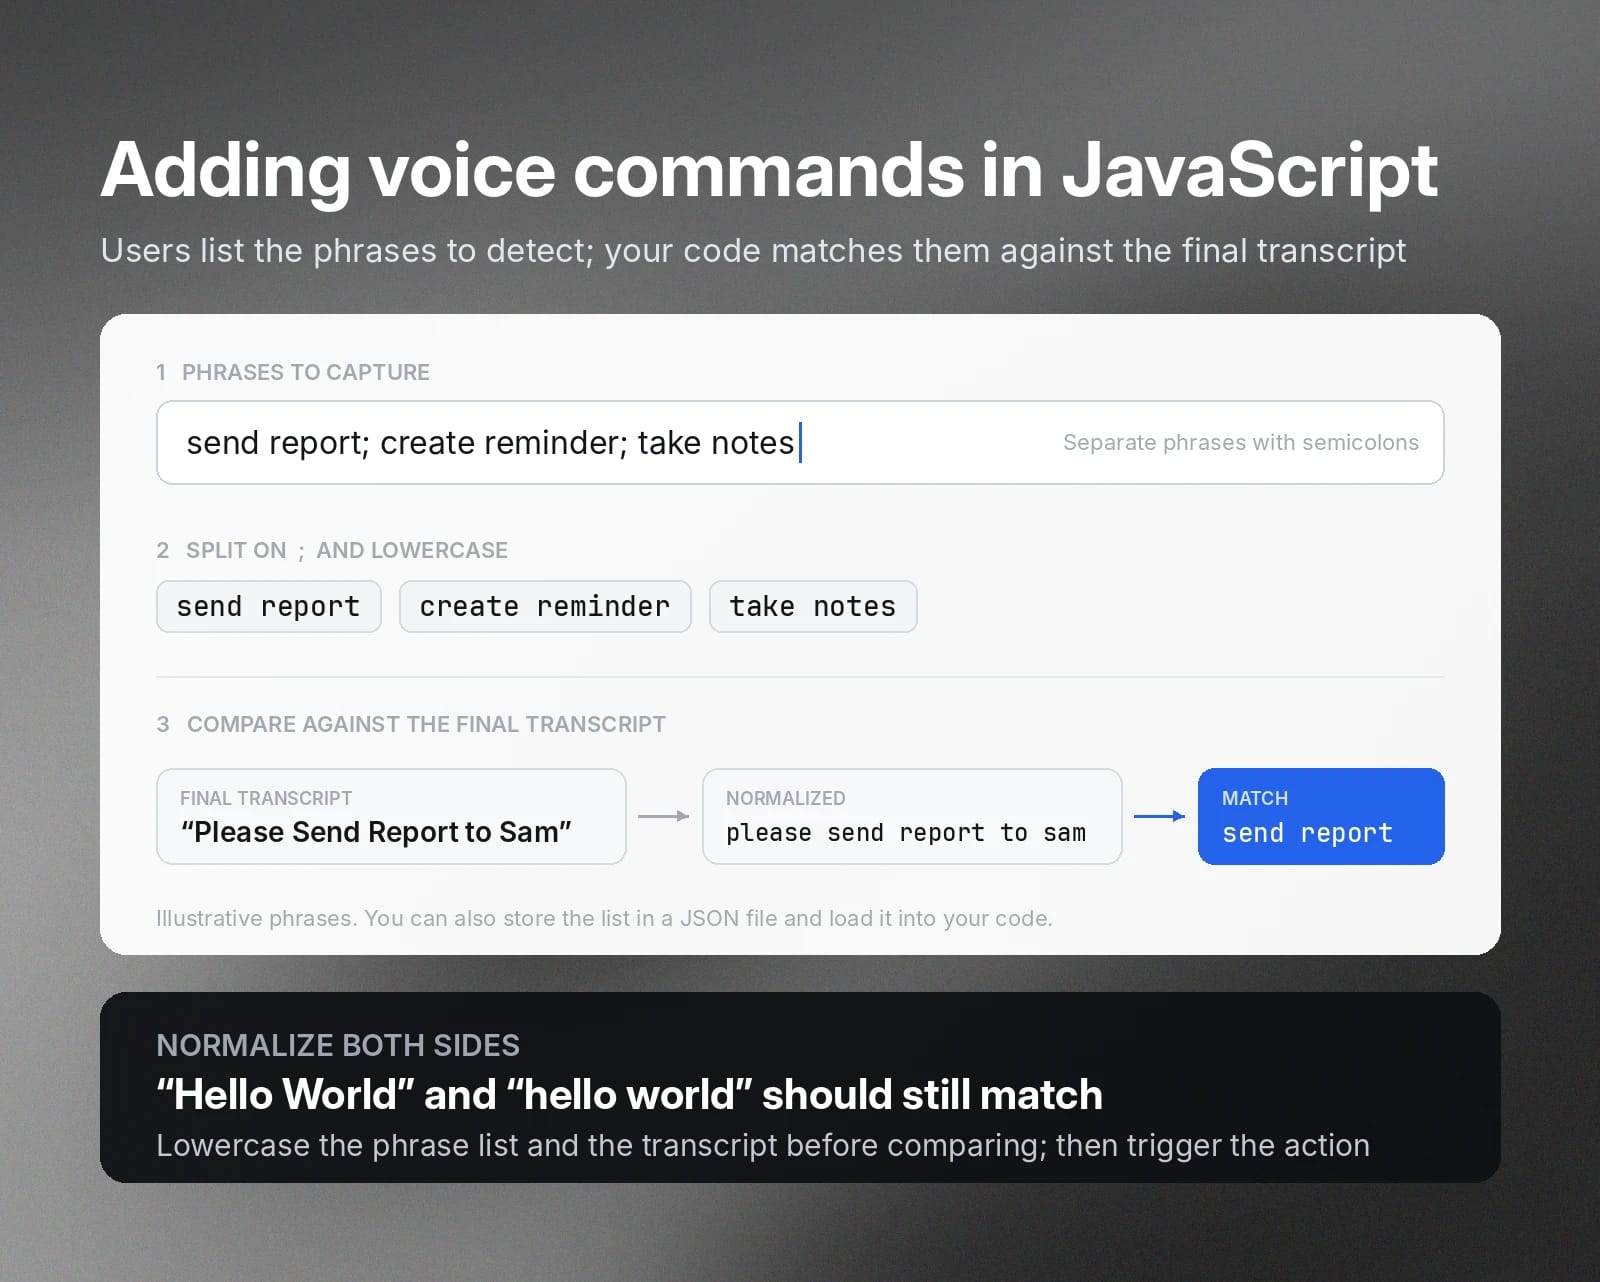
Depois, crie uma função que compare a transcrição final com a lista de frases. Ao fazer a correspondência de texto, normalize as duas listas convertendo-as para letras minúsculas. Isso é necessário porque os usuários podem usar maiúsculas em palavras, o que pode causar uma divergência mesmo que seja a mesma palavra. Por exemplo, “Hello World” e “hello world” devem resultar em uma correspondência, mesmo que uma delas tenha maiúsculas.
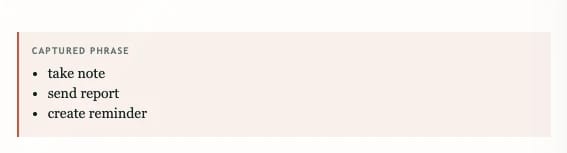
Sempre que o código recebe uma transcrição, ele percorre a lista de frases. Se houver uma correspondência, você aciona uma ação, como iniciar uma aplicação ou, neste caso, exibir a frase correspondente em um painel separado.
Lide com suporte de navegador, permissões e erros de reconhecimento
A Web Speech API torna o reconhecimento de Speech to Text em JavaScript acessível, mas nem sempre funciona sem falhas. Os usuários podem usar um navegador com suporte de backend limitado ou inexistente para a API SpeechRecognition. Em alguns casos, problemas de rede fazem a transcrição falhar.
Por isso, seu código precisa lidar com essas condições e avisar os usuários adequadamente.
Por exemplo, informe aos usuários que usem Chrome ou Edge, navegadores nos quais a API SpeechRecognition comprovadamente funciona.
Enquanto isso, para lidar com erros, associe uma função de tratamento de erros ao manipulador de eventos onerror e processe o respectivo código de erro.
Por exemplo,
Código de erro
Ação
not-allowed
Exiba um texto que instrua o usuário a verificar as configurações do navegador.
no-speech
Instrua o usuário a falar mais perto do microfone
network
Peça ao usuário para verificar a conexão com a internet
aborted
Informe ao usuário que o processo de reconhecimento de voz foi interrompido.
Torne o reconhecimento de voz em JavaScript acessível e atento à privacidade
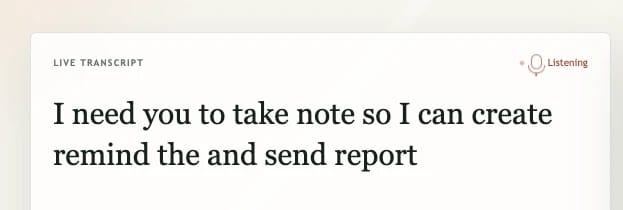
Ao integrar a Web Speech API, considere a privacidade. Sempre mostre um indicador visual ou verbal antes de o cliente web começar a gravar. Por exemplo, exiba um ícone de escuta como sinal visual enquanto o código de reconhecimento de voz em JavaScript envia ativamente o sinal do microfone ao mecanismo de Speech to Text.
Outra área à qual desenvolvedores devem prestar atenção é a privacidade de dados. Ao transcrever com a API SpeechRecognition, a API realiza a transcrição online por padrão. Mesmo que o navegador ofereça suporte a Speech to Text offline, a API tentará primeiro a transcrição online.
Essas especificações técnicas são essenciais quando você cria serviços de transcrição em que residência de dados, governança e conformidade são rigorosamente regulamentadas.
Saiba quando o reconhecimento de voz no navegador não é suficiente para produção
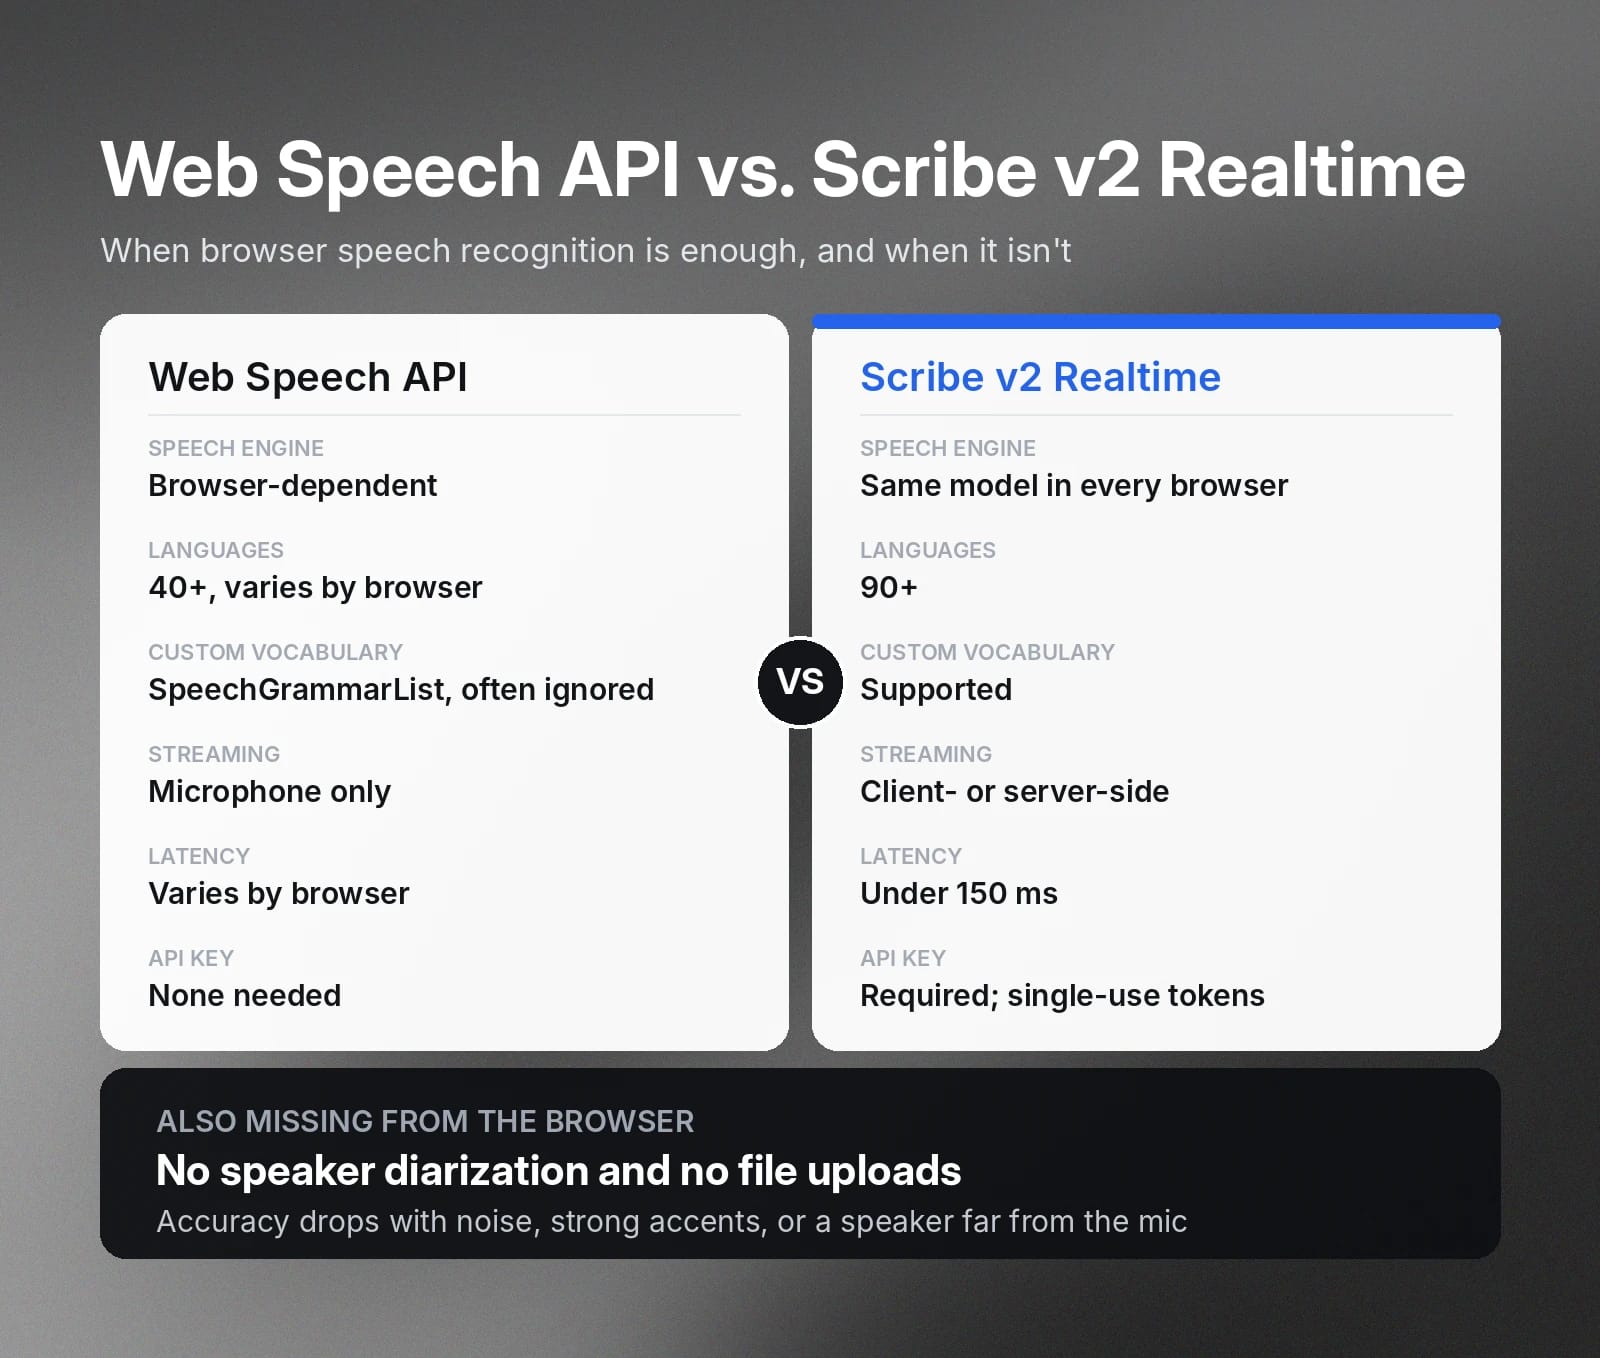
Mostramos as etapas para criar reconhecimento automático de voz para apps de voz baseados em navegador com a Web Speech API. A API torna os recursos de Speech to Text acessíveis a desenvolvedores JavaScript. No entanto, várias limitações restringem os casos de uso, especialmente em produtos web comerciais.
- Dependência do navegador: A transcrição depende muito do navegador do usuário. Desenvolvedores não têm controle sobre os modelos de voz específicos usados, o que resulta em desempenho inconsistente nas transcrições.
- Suporte limitado a idiomas: A API é compatível com mais de 40 idiomas, mas o número exato pode variar entre navegadores.
- Diarização de locutores: Você não consegue detectar quem está falando nem identificar locutores individuais na transcrição.
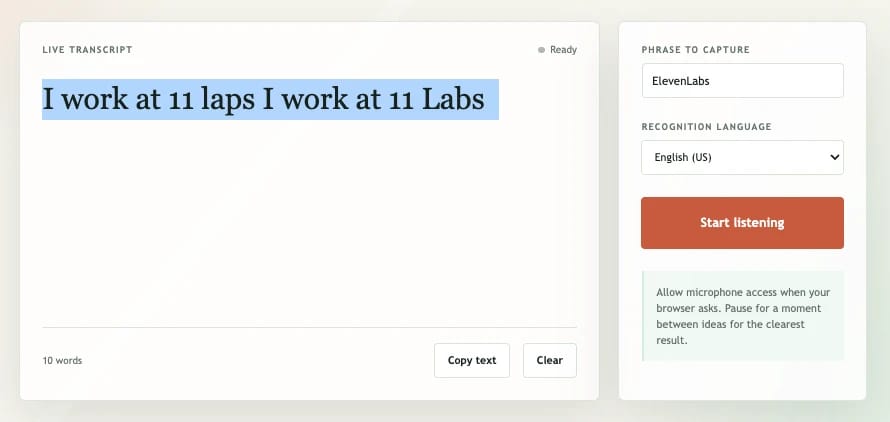
- Vocabulários personalizados: A API SpeechRecognition não oferece suporte confiável a vocabulários personalizados. Por exemplo, ela não consegue transcrever “ElevenLabs” com precisão. (A API SpeechRecognition oficial oferece uma interface de vocabulário personalizado usando SpeechGrammarList, mas os navegadores modernos geralmente a ignoram.)
- Precisão: A precisão da transcrição diminui quando o locutor está em um ambiente barulhento, tem um sotaque forte ou está longe do microfone.
- Streaming do servidor: Você só pode fazer streaming pelo microfone, pois a Web Speech API não é compatível com streaming do servidor nem com uploads manuais de arquivos de áudio.
Se essas limitações impedirem você de comercializar seu produto de reconhecimento de voz, recomendamos usar o ElevenLabs Scribe v2 Realtime.
O ElevenLabs Scribe v2 Realtime é um modelo de reconhecimento de voz que oferece transcrição em tempo real com alta precisão e latência inferior a 150 ms. Ele oferece suporte a mais de 90 idiomas, consistência independente de navegador e vocabulários personalizados. Com o ElevenLabs Scribe v2 Realtime, você pode executar streaming no cliente ou no servidor de acordo com a arquitetura do seu app web.
Tutorial de reconhecimento de voz em JavaScript com o ElevenLabs Scribe v2 Realtime
Criar um comando de voz em JavaScript com a ElevenLabs segue uma abordagem parecida. No entanto, você precisará criar uma chave de API da ElevenLabs para autorizar as solicitações de API. Veja abaixo etapas rápidas para criar um cliente web que faz streaming pelo microfone.
- Instale o SDK da ElevenLabs
- Crie um token de uso único para transmitir a chave de API sem expô-la
- Configure e conecte-se ao modelo Scribe v2 Realtime com os parâmetros desejados
- Crie manipuladores de eventos para processar transcrições e lidar com exceções
Para orientações detalhadas sobre o Scribe v2 Realtime, consulte nossa documentação oficial.
Comece a usar a ElevenAPI para Speech to Text em produção
ElevenAPI oferece modelos de nível de produção de Speech to Text para desenvolvimento de clientes web e servidores. Além do reconhecimento de voz em tempo real, desenvolvedores usam os modelos de Speech to Text da ElevenAPI para habilitar transcrição em lote com diarização de locutores, timestamps por palavra e processamento assíncrono.
Em vez de consultar continuamente o mecanismo de Speech to Text, você pode criar um webhook no painel da ElevenLabs e fornecer uma URL de callback, onde a API entrega a transcrição concluída.
Se você quer criar um cliente web ou app de servidor com reconhecimento automático de voz, a ElevenAPI oferece modelos de áudio que você pode integrar facilmente ao seu código.
Obtenha sua chave de API da ElevenLabs e explore a documentação da API para começar a desenvolver.
Perguntas frequentes

Jack Limebear faz parte do time de Growth, atuando como redator e estrategista de conteúdo no blog e nas páginas de insights. Antes da ElevenLabs, ele passou mais de dez anos liderando estratégias de conteúdo em organizações que vão de startups SaaS em rápido crescimento a empresas da Fortune 500. Ele é mestre em Literatura Inglesa pela Universidade de Cambridge.


