O que é Reconhecimento Automático de Fala (ASR)?
- Escrito por
- Jack Limebear
- Publicado
- Última atualização
OuvirOuça este artigo
Em 1952, o sistema de reconhecimento de fala mais avançado do mundo conseguia entender exatamente 9 palavras.
Cerca de 75 anos depois, o reconhecimento automático de fala (ASR) transcreve dezenas de idiomas em tempo real, alimentando desde os assistentes de voz no seu celular até as legendas que aparecem em vídeos ao vivo.
Este guia explora a tecnologia que reduziu a distância entre as versões de 1952 e as atuais, abordando o que é ASR, como ele converte fala em texto e como continua evoluindo até hoje.
Resumo:
- ASR significa reconhecimento automático de fala, a tecnologia que converte áudio falado em texto escrito.
- A primeira forma de ASR surgiu em 1952, e os sistemas de deep learning passaram a igualar referências humanas no fim da década de 2010.
- O ASR moderno usa redes neurais de ponta a ponta treinadas com milhões de horas de áudio.
- A taxa de erro de palavras (WER) é a métrica padrão de precisão, mas a latência, a qualidade da diarização e a compreensão contextual também são importantes no ASR de produção.
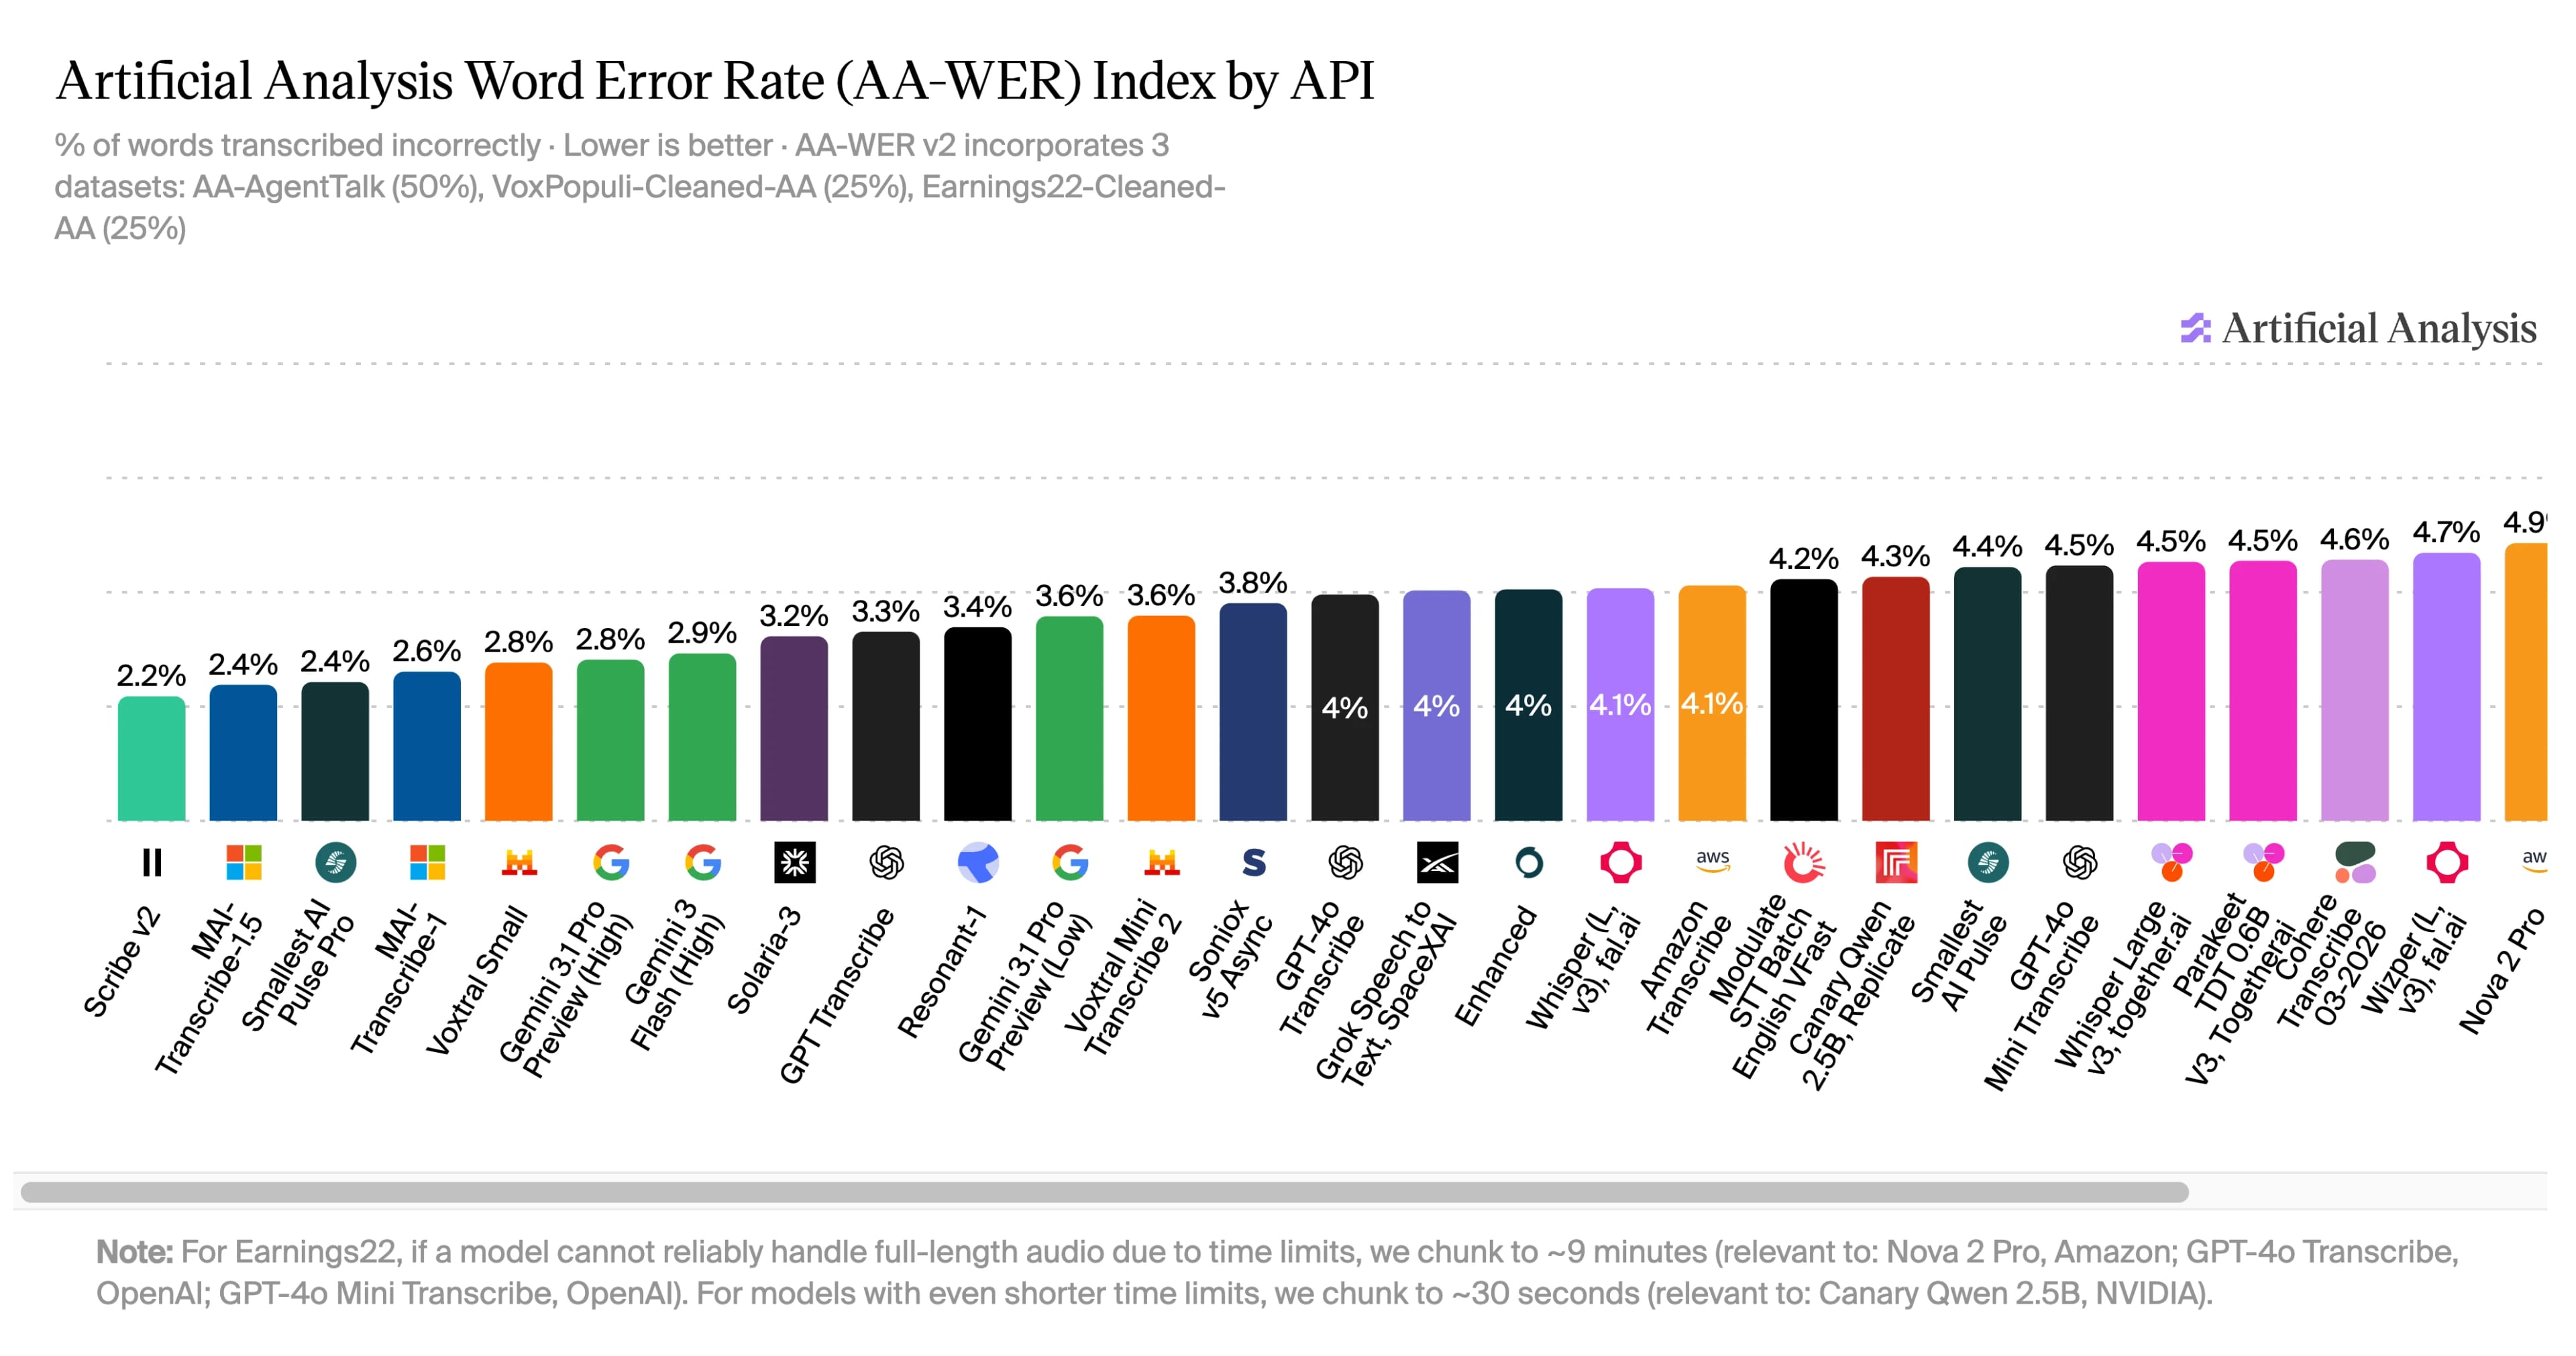
- A ElevenAPI oferece ASR de nível de produção para desenvolvedores, avaliado de forma independente pela Artificial Analysis com uma taxa de erro de palavras de 2,2%, a menor em seu índice (julho de 2026).
O que é reconhecimento automático de fala (ASR)?
O reconhecimento automático de fala, geralmente conhecido apenas pela sigla ASR, descreve um software que ouve a fala humana e a transforma em texto preciso e legível por máquinas. Também é conhecido como Speech to Text e reconhecimento de fala ou, em alguns casos, reconhecimento de fala por computador.
O ASR se tornou tão presente que você pode interagir com ele todos os dias sem perceber. Sempre que dita uma mensagem, faz uma pergunta a um assistente de voz, lê legendas em um vídeo ao vivo ou navega por um sistema de resposta de voz interativa por telefone, você está usando ASR.
Embora Speech to Text e ASR sejam frequentemente usados como sinônimos — e estejam intimamente relacionados —, não são exatamente a mesma coisa. ASR é a tecnologia que identifica o que foi dito, enquanto STT é a aplicação dessa tecnologia como ferramenta. O software de reconhecimento de voz funciona sobre o ASR e identifica quem disse determinada palavra, formando a base dos recursos de diarização de locutores.
São diferenças sutis, mas vale entendê-las se você pretende integrar sistemas de ASR/STT/reconhecimento de voz aos seus apps ou site.
Uma breve história da tecnologia de reconhecimento automático de fala
A tecnologia de reconhecimento automático de fala é muito mais antiga do que a maioria das pessoas imagina, com versões iniciais que remontam à década de 1950. Nos mais de 70 anos desde seu surgimento, o ASR passou por várias etapas importantes que formaram, em grande parte, a base de sua evolução histórica.
Estas são as principais eras pelas quais a tecnologia ASR passou:
- 1952 e o primeiro ASR: Em 1952, o Automatic Digit Recognizer, conhecido como AUDREY, foi criado pelos Bell Laboratories para compreender os dígitos de um a nove. A ferramenta tinha apenas cerca de 90% de precisão e só funcionava quando usada por seu inventor, o que a tornava extremamente limitada. Apesar de estar muito distante dos recursos modernos que conhecemos, simplesmente reconhecer os números de 1 a 9 já era um feito impressionante.
- Décadas de 1960 e 1970 e o vocabulário crescente do ASR: Nas décadas seguintes, laboratórios de todo o mundo, incluindo IBM, University College London e NEC, no Japão, conseguiram produzir modelos semelhantes ao AUDREY em diferentes contextos. Raj Reddy, um estudante de pós-graduação indiano em Stanford, criou um reconhecedor de vogais para seu projeto de doutorado, estabelecendo as bases do reconhecimento contínuo de fala sem a necessidade de pausar entre cada palavra. A DARPA (Defense Advanced Research Projects Agency) financiou pesquisas nesse período que levaram à Beam Search, um método de construção e decodificação de frases que foi fundamental para reconhecer mais de 1.000 palavras no total em 1976.
- Da década de 1980 ao início da de 2010, com avanços estatísticos: Em 1987, um aluno de Raj Reddy, então professor, combinou Modelos Ocultos de Markov com Beam Search, possibilitando ASRs que não exigiam treinamento com um único locutor específico. Essa inovação reduziu drasticamente o tempo de treinamento dos sistemas de reconhecimento de fala. Em 1997, a Dragon Systems lançou o primeiro ASR disponível comercialmente, chamado NaturallySpeaking Preferred. Ele conseguia reconhecer 100 palavras por minuto e vendeu bem.
- A era moderna e o deep learning: Na década de 2010, pesquisadores demonstraram que uma única rede neural treinada de ponta a ponta com áudio e transcrições superava um pipeline puramente estatístico. Com a chegada das redes neurais profundas, os ASRs puderam alcançar um desempenho próximo ao humano, com taxas de erro entre 5% e 10%. Nessa época, assistentes de voz como Alexa e Siri chegaram ao mercado.
Desde então, o ASR só se tornou mais preciso e mais amplamente utilizado. Em julho de 2026, a pesquisa independente da Artificial Analysis identificou o Scribe v2 da ElevenLabs como o modelo com a menor taxa de erro de palavras (WER) do setor, de apenas 2,2%.
Como o ASR funciona? Noções básicas da tecnologia Speech to Text
O ASR funciona capturando uma amostra de áudio, convertendo-a em uma representação numérica e usando um modelo treinado para prever a sequência de palavras mais provável que esses números representam. O ASR moderno realiza esse processo em tempo real, concluindo todo o fluxo de ponta a ponta em menos de um segundo.
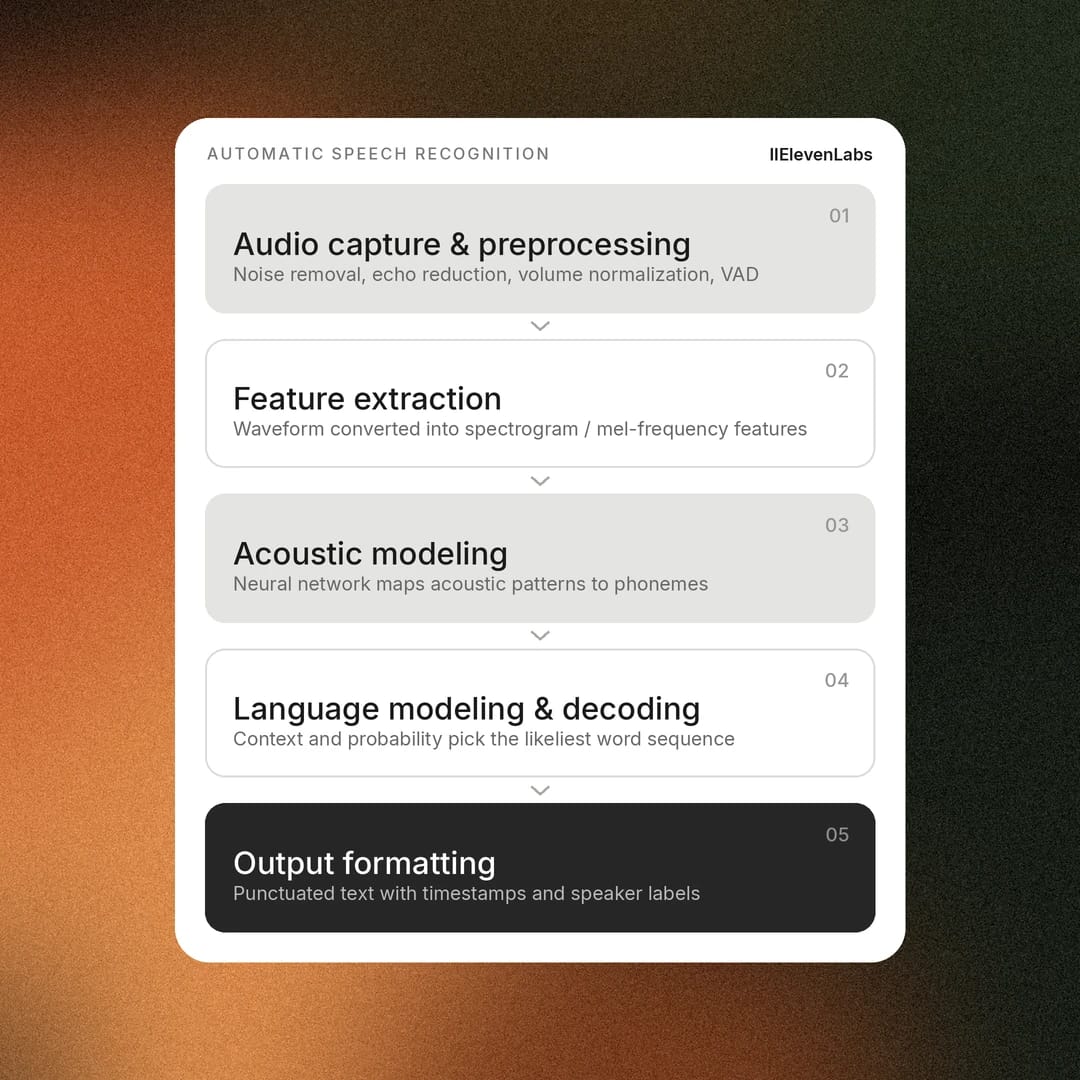
Há cinco etapas principais em um pipeline de ASR:
- Captura e pré-processamento de áudio: O sistema grava o sinal de áudio, remove ruídos de fundo, reduz o eco e normaliza os níveis de volume para melhorar a consistência. Dependendo do modelo, ele pode usar detecção de atividade de voz (VAD) para distinguir fala de silêncio ou sons de fundo antes de iniciar a transcrição.
- Extração de recursos: O áudio é convertido em uma representação numérica, normalmente um espectrograma ou recursos de frequência mel, que destacam com precisão as frequências e os padrões presentes na fala humana. Essa etapa transforma uma forma de onda bruta em dados que um modelo de machine learning consegue processar com eficiência.
- Modelagem acústica: Uma rede neural analisa os recursos da etapa anterior e prevê fonemas ou outras unidades de fala, aprendendo a relação entre padrões acústicos e linguagem falada. Os modelos modernos de ponta a ponta geralmente executam essa etapa junto com a compreensão de linguagem, em vez de tratá-la como uma fase totalmente separada.
- Modelagem e decodificação de linguagem: O sistema então avalia quais sequências de palavras são mais prováveis com base em regras como gramática, contexto e probabilidade matemática. Os dois últimos elementos são fundamentais, pois a transcrição IPA (Alfabeto Fonético Internacional) de duas frases pode ser semelhante, mesmo quando o contexto é completamente diferente. Por exemplo, “Recognize Speech” e “Wreck a nice peach” podem soar iguais, mas têm significados totalmente distintos. Se a precisão não for suficiente para decidir, o contexto ajudará o sistema a determinar a opção correta.
- Formatação da saída: Depois de determinar o conteúdo da fala, o texto final é transcrito com pontuação e letras maiúsculas. Metadados adicionais, como marcas de tempo por palavra e rótulos de locutor, criam transcrições mais detalhadas.
Ao longo dessas etapas principais, o modelo transforma os dados de áudio recebidos em uma transcrição escrita.
Sistemas híbridos tradicionais vs. ASR de deep learning de ponta a ponta
Embora o pipeline acima descreva como o ASR funciona, há, na prática, dois caminhos tecnológicos possíveis para a parte central desse pipeline.
Os sistemas legados encadeiam vários componentes: um modelo léxico que codifica a pronúncia das palavras, um modelo acústico que mapeia áudio para fonemas e um modelo de linguagem que prevê sequências prováveis de palavras. Cada componente exige conhecimento humano para ser desenvolvido, desde linguistas que criam dicionários de pronúncia manualmente até anotadores que alinham cada palavra à sua posição exata no áudio.
O deep learning de ponta a ponta reúne todos esses componentes em uma única rede neural. A rede mapeia áudio diretamente para texto, compreendendo implicitamente pronúncia, acústica e estatísticas de probabilidade linguística a partir de milhões de horas de áudios e transcrições pareados.
Vamos detalhar as diferenças entre as abordagens tradicionais e modernas da tecnologia ASR.
Como a precisão do ASR é medida: referências de taxa de erro de palavras (WER)
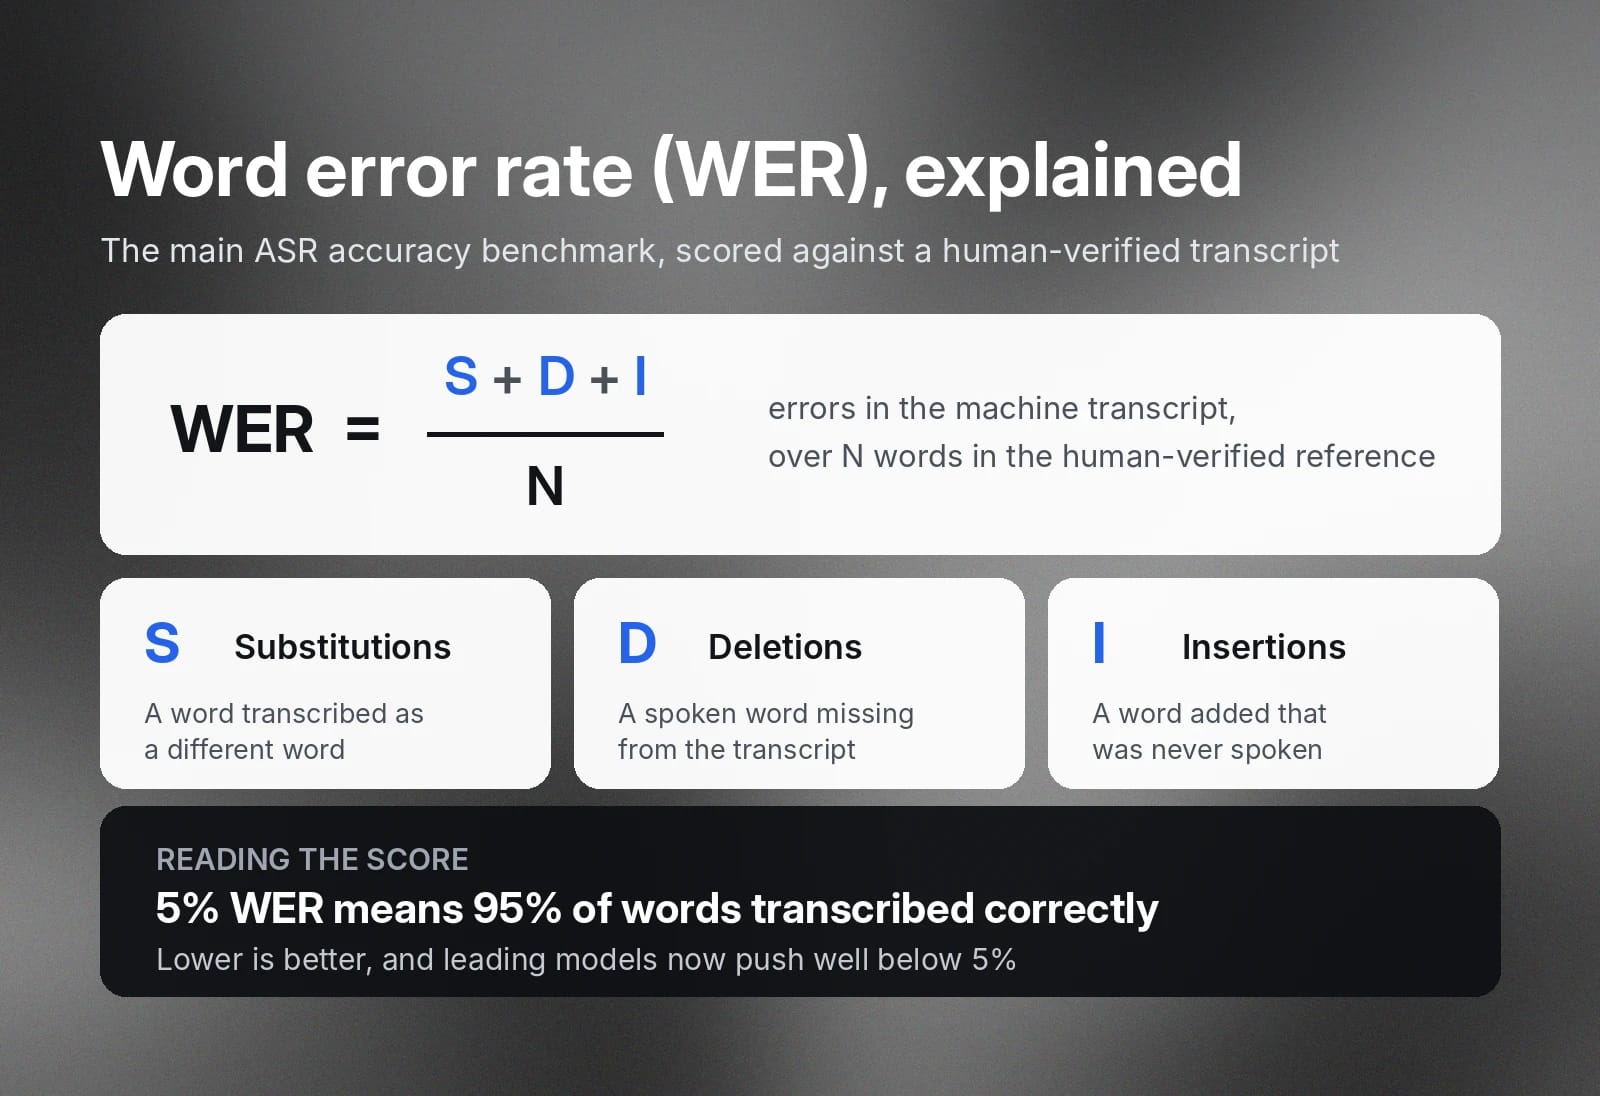
Em todos os workflows de Speech to Text e ASR, a taxa de erro de palavras (WER) é a principal métrica de precisão usada pelas empresas. Ela compara uma transcrição gerada por máquina com ASR a uma versão verificada por humanos. Há três tipos principais de erro: substituições, exclusões e inserções.
A fórmula da WER divide o total de erros pelo número de palavras na transcrição de referência. Uma WER de 5% significa que o sistema conseguiu transcrever 95% do texto com precisão, e a maioria dos principais modelos já busca taxas muito abaixo de 5%, cada vez mais próximas da perfeição.
Embora a WER seja uma referência útil, outros fatores também devem ser considerados ao determinar a eficácia de uma ferramenta de ASR:
- Precisão de formatação: O sistema consegue formatar corretamente strings fora do padrão? Por exemplo, um valor monetário como US$ 1.225 é exibido dessa forma ou escrito por extenso como “mil duzentos e vinte e cinco dólares”?
- Latência: Embora a precisão seja importante, uma ferramenta se torna inutilizável se levar alguns minutos para gerar uma transcrição simples. Mesmo sendo extremamente precisa, ela precisa equilibrar isso com baixa latência para ser útil.
- Robustez: Mesmo casos de uso com sotaques fortes ou ambientes ruidosos não devem reduzir significativamente a precisão do modelo.
- Qualidade da diarização: Os casos de uso com vários locutores dependem da atribuição correta de cada palavra ao locutor certo. Conseguir identificar diferentes locutores e rotulá-los corretamente contribui para o ASR, especialmente em setores com muitas pessoas falando, como tribunais.
Para mais informações, leia nosso guia completo sobre taxa de erro de palavras.
Principais benefícios do ASR para empresas modernas
O mercado global de reconhecimento de fala e voz deve crescer para mais de US$ 23,11 bilhões até 2030. A taxa de crescimento anual composta de 19,1% do mercado reflete o quanto essa tecnologia se disseminou em dispositivos comerciais. Todo celular moderno vem com teclado de ditado e assistente de voz, a maioria dos carros novos responde a comandos de voz, e alto-falantes ou assistentes inteligentes já estão presentes em casas do mundo todo.
Interagir com a tecnologia por voz agora é uma opção padrão para clientes em diferentes situações. Para as empresas, o ASR oferece desde a transcrição de chamadas de clientes até assistência para agentes de voz, integrando-se a processos e impulsionando a produtividade.
Estes são alguns dos principais benefícios do ASR para empresas modernas:
- Entrada e documentação mais rápidas: Há mais de 10 anos, Stanford publicou um estudo demonstrando que a tecnologia de reconhecimento de fala era quase três vezes mais rápida do que digitar em um teclado, mantendo uma taxa de erro menor. Para a grande maioria das pessoas, o ASR permite uma documentação mais rápida em workflows de transcrição e anotações por voz.
- Custos operacionais menores: Em muitos casos de uso que antes dependiam de horas de anotações manuais, a tecnologia ASR reduz drasticamente o custo de transcrições de alta qualidade. Processos judiciais, centrais de atendimento, clínicas de saúde e reuniões de negócios agora podem contar com sistemas ASR precisos, que criam anotações detalhadas e transcrições completas de conversas com diarização.
- Mais acessibilidade: A Organização Mundial da Saúde prevê que 2,5 bilhões de pessoas viverão com algum grau de perda auditiva até 2050. Legendas em tempo real fornecidas por ferramentas avançadas de ASR podem tornar reuniões digitais e mídias acessíveis aos usuários.
- Dados de voz pesquisáveis: Quando você transcreve automaticamente a fala com ASR, cada interação entre cliente e empresa fica totalmente registrada. Cada ligação de vendas, chamado de suporte, contato de potencial cliente ou reunião se torna um texto pesquisável e auditável. Especialmente na era da IA, disponibilizar contexto em um formato legível por máquina pode ajudar a criar bases de conhecimento amplas. Seja por funcionalidade ou conformidade, isso ajuda a manter as informações visíveis.
- Experiências do cliente sempre disponíveis: O ASR oferece uma das tecnologias fundamentais para agentes de voz, ajudando a viabilizar casos de uso de suporte automatizado que resolvem chamadas de clientes 24 horas por dia, 7 dias por semana, 365 dias por ano.
O reconhecimento automático de fala é tão predominante na tecnologia pelos muitos benefícios de incorporá-lo e pela diversidade dos casos de uso que ele oferece suporte. Seja na área médica ou na transcrição de chamadas de clientes para análise de sentimento, o ASR é uma tecnologia fundamental que você pode integrar e usar.
Aplicações populares de ASR em diferentes setores
O reconhecimento automático de fala é uma tecnologia central em inúmeros workflows e produtos. Ele atingiu um nível de presença tão amplo que os usuários muitas vezes nem pensam em como está integrado às tecnologias que usam.
Confira alguns casos de uso populares de ASR no mundo.
Atendimento ao cliente e centrais de contato
As centrais de contato foram pioneiras na adoção do ASR, usando-o para transcrever chamadas para garantia de qualidade e conformidade. Hoje, o ASR pode funcionar em tempo real para apresentar sugestões aos atendentes durante a conversa e transformar milhares de interações com clientes em dados que as equipes podem analisar.
Mídia e entretenimento
Emissoras e plataformas de streaming podem usar ASR para gerar legendas de conversas humanas em uma escala que transcritores humanos jamais conseguiriam acompanhar. Ele permite a transcrição em tempo real e também torna bibliotecas de vídeo e áudio totalmente pesquisáveis.
Saúde
Profissionais clínicos passam uma parcela surpreendente do dia com documentação e registros. O ASR ajuda a recuperar esse tempo, oferecendo aos médicos uma plataforma de STT médico na qual podem ditar suas anotações em tempo real.
Reuniões virtuais
As plataformas de reunião costumam oferecer algum tipo de anotação digital para transcrever conversas enquanto acontecem, sem que ninguém precise escolher entre participar e tomar notas. Serviços como o Google Meet até enviam essas transcrições com itens de ação destacados após cada reunião, ajudando a criar um índice pesquisável de informações.
Setor jurídico e conformidade
Em contextos jurídicos, registrar com precisão o que foi dito e por quem é uma exigência central em tribunais. Escritórios de advocacia usam plataformas de ASR para transcrever reuniões, audiências, chamadas de clientes e sessões judiciais com marcas de tempo precisas para referência futura.
Educação
Professores universitários podem fornecer uma transcrição gravada de suas aulas para ajudar os alunos a manter um registro das aulas que frequentaram. Para compreender e memorizar informações, os estudantes terão um recurso completo disponível como ponto de partida.
Onde o ASR se encaixa em um pipeline de agentes de voz
O ASR é uma parte padrão de diversas implementações tecnológicas. Na tecnologia de agentes de voz, ele é a primeira de três etapas mais amplas que funcionam em um ciclo contínuo.
- Ouvir (ASR): O agente captura fluxos de áudio recebidos e converte a fala em texto em tempo real. O ASR moderno processa o áudio continuamente à medida que chega, filtrando ruídos de fundo, lidando com interrupções, produzindo transcrições parciais e identificando quando cada pessoa está falando.
- Pensar (modelo de linguagem): Um modelo de linguagem de grande porte interpreta a transcrição, compreende a intenção do usuário, recupera informações de ferramentas e bases de conhecimento conectadas, mantém o contexto da conversa e determina a resposta ou ação mais adequada.
- Falar (Text to Speech): Um modelo de Text to Speech converte a resposta gerada pelo LLM em áudio natural e expressivo. Os sistemas TTS modernos podem ajustar ritmo, entonação, emoção e ênfase ao transmitir o áudio de volta para quem ligou à medida que ele é gerado, em vez de esperar pela resposta completa.
Latência de conversa se acumula em cada uma dessas etapas. O ASR por streaming começa a emitir palavras assim que são faladas, em vez de esperar uma enunciação terminar, para reduzir a latência. ElevenAgents usa isso como padrão para agentes de voz em tempo real, ajudando a criar uma experiência de agente altamente eficiente.
Desafios do ASR e como a tecnologia está evoluindo
Embora a tecnologia ASR tenha avançado muito desde suas origens em 1952, ainda há diversos desafios que podem reduzir sua precisão.
Abaixo estão alguns problemas que as ferramentas de ASR ainda enfrentam hoje:
- Sotaques e dialetos: Os dados de treinamento disponíveis geralmente se concentram em poucos idiomas e sotaques, tornando sotaques menos comuns ou idiomas falados por menos pessoas mais desafiadores para as ferramentas de ASR. Conjuntos de dados de treinamento ricos e diversificados são a solução nesse caso.
- Ruído de fundo e locutores sobrepostos: Ambientes com volumes variáveis ou muito ruído de fundo dificultam a identificação de palavras individuais em uma gravação. Locutores falando ao mesmo tempo podem causar efeito semelhante, reduzindo a precisão de uma transcrição de ASR.
- Vocabulário específico de domínio: Áreas com jargões ou siglas específicos precisam de dicionários e referências de domínio para melhorar a precisão. Medicina e direito são duas áreas em que ferramentas de ASR precisam de assistência adicional ou treinamento especializado.
- Privacidade e segurança: Em muitas jurisdições, os dados de voz são considerados dados pessoais. As empresas precisam estabelecer políticas claras de retenção e medidas de proteção para o tratamento dos dados de voz e para garantir a conformidade com regulamentações mais amplas.
Uma consideração mais ampla ao trabalhar com tecnologia ASR é o equilíbrio entre latência e precisão. Alguns casos de uso precisam equilibrar os dois fatores, enquanto áreas como a medicina provavelmente priorizariam a precisão acima de tudo.
Comece a usar a ElevenAPI para integrar ASR de nível de produção
ElevenAPI oferece reconhecimento automático de fala de nível de produção para seu produto por meio do Scribe v2, o modelo Speech to Text da ElevenLabs. O Scribe v2 oferece marcas de tempo por palavra, diarização de locutores, marcação de eventos de áudio e a precisão e a confiabilidade necessárias para aplicações em tempo real.
Explore a página do ElevenLabs Speech to Text para mais informações ou crie uma conta grátis para colocar uma API em funcionamento em minutos.
Perguntas frequentes sobre ASR

Jack Limebear faz parte do time de Growth, atuando como redator e estrategista de conteúdo no blog e nas páginas de insights. Antes da ElevenLabs, ele passou mais de dez anos liderando estratégias de conteúdo em organizações que vão de startups SaaS em rápido crescimento a empresas da Fortune 500. Ele é mestre em Literatura Inglesa pela Universidade de Cambridge.