
O que é latência de IA conversacional e o que a afeta?
- Escrito por
- Jack Limebear
- Publicado
- Última atualização
OuvirOuça este artigo
Para IA conversacional, a latência é o que separa bons aplicativos de aplicativos excelentes.
A IA conversacional é, por natureza, aspiracional. Ela busca reproduzir a mesma sensação de conversar com uma pessoa, espelhando a mesma variedade emocional, entonação e cadência. Se considerarmos também o atraso que parece “natural” entre o momento em que você para de falar e o início da resposta de um agente de IA, temos uma meta de latência baseada na forma como as pessoas realmente se comunicam.
Empresas que querem implementar agentes de IA conversacional em escala precisam reduzir essa latência o máximo possível para alcançar essa sensação natural. Este artigo explica o que é a latência da IA conversacional, o que causa atrasos em todo o pipeline e como reduzi-los em alto nível.
Resumo
- A latência da IA conversacional é o atraso total de ponta a ponta entre o momento em que um usuário para de falar e o momento em que ouve a primeira palavra do agente.
- Agentes com mais de 700 ms podem parecer pouco naturais, e aqueles acima de 1.200 ms têm altas taxas de abandono.
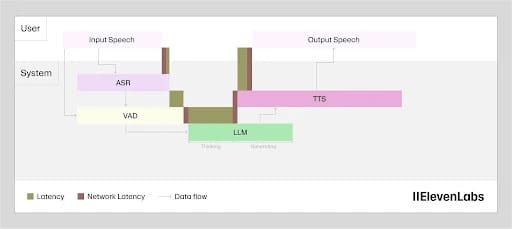
- A latência se acumula em cada etapa do pipeline de IA conversacional.
- O ElevenAgents gerencia todo o pipeline em uma arquitetura única e unificada, tornando a IA conversacional de baixa latência acessível para sua empresa.
O que é latência em IA conversacional?
A latência da IA conversacional se refere ao tempo total que um sistema leva para responder depois que você fala. Nos modelos de IA modernos, a latência é medida em ms. Nos bastidores, o valor total da latência é composto por vários processos separados, cada um responsável por uma parte do pipeline de ponta a ponta.
Um pipeline típico de IA conversacional funciona assim:
- Um usuário fala
- O áudio é transcrito por um modelo de Speech to Text
- A transcrição é enviada a um modelo de LLM, que produz uma resposta
- O texto do LLM é então sintetizado em áudio com um modelo de Text to Speech
- O áudio é então reproduzido para o usuário
Cada uma dessas etapas adiciona latência a um sistema de IA conversacional. Por isso, ao falar de latência, é importante esclarecer algumas siglas diferentes.
Latência de inferência do modelo
A latência de inferência do modelo é o tempo que um modelo leva para gerar uma saída, medido internamente e sem considerar fatores externos. É a medida específica do modelo que indica a rapidez com que o mecanismo funciona para entradas típicas. Por exemplo, o Flash v2.5 tem uma latência de inferência de cerca de 75 ms. Com isso, você pode comparar a velocidade dos modelos entre concorrentes.
Ainda assim, lembre-se de que esse não é o valor de latência que o usuário realmente percebe. Ele se refere especificamente ao tempo total que um modelo leva para gerar uma saída.
Tempo até o primeiro token do LLM
O tempo até o primeiro token (TTFT) de um modelo de linguagem grande (LLM) é o tempo total que ele leva para processar um prompt e gerar seu primeiro token de saída utilizável.
A geração de TTS começa quando o primeiro token chega do seu LLM. Portanto, essa métrica mede quanto tempo o LLM leva para começar a acionar seu modelo de TTS. Para a maioria dos sistemas de IA conversacional de ponta a ponta, o TTFT do LLM representa uma parcela significativa da latência total.
Tempo até o primeiro áudio do TTS (TTFA)
O tempo até o primeiro áudio (TTFA) do TTS mede o tempo entre a primeira solicitação de TTS e o momento em que o primeiro trecho de áudio realmente sai do modelo. É uma forma de descrever a latência de inferência, mas especificamente para mecanismos de TTS.
Tempo de ponta a ponta até o primeiro áudio (TTFA)
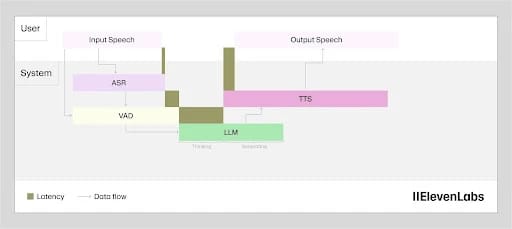
O TTFA de ponta a ponta é a latência total da IA conversacional. É a soma de todas as partes do pipeline, desde o reconhecimento de fala, o TTFT do LLM, o TTS e o TTFA até todas as transmissões de rede entre as etapas. Ao falar da latência da IA conversacional como um todo, esta é a métrica percebida pelo usuário.
Quando fala, o usuário espera pelo TTFA de ponta a ponta antes de ouvir qualquer resposta do seu agente. É uma medida holística, o que significa que melhorar qualquer parte do pipeline melhora essa métrica.
Por que a latência da IA conversacional é importante
Quando um usuário fala com seu agente de IA, a latência se torna um fator central na forma como ele percebe a experiência. Tempos de latência baixos reduzem quanto tempo o usuário precisa esperar por uma resposta, ajudando a conversa a parecer natural e seu agente a demonstrar capacidade.
Agentes com alta latência parecem artificiais e menos competentes, mesmo que a qualidade de suas respostas seja a mesma. Para as empresas, uma diferença de apenas algumas centenas de ms pode parecer uma eternidade, fazendo com que seu agente de suporte ao cliente pareça lento e ineficaz.
Veja alguns cenários que demonstram, na prática, por que a latência da IA conversacional é importante:
- Abaixo de 500 ms: Um agente conversacional parece responsivo e ágil. Os usuários podem nem perceber o atraso entre parar de falar e receber a primeira resposta, permitindo que a conversa flua sem interrupções.
- De 500 ms a 1.000 ms: O atraso entre o momento em que o usuário para de falar e recebe uma resposta pode se tornar perceptível. É só um pouco longo demais, então os usuários podem tentar se antecipar repetindo o que disseram ou fazendo uma pausa para verificar se o agente realmente os entendeu.
- Acima de 1.000 ms: Os atrasos começam a parecer lentos, com pausas que fazem alguns usuários sentirem que o agente de IA não acompanha totalmente a conversa. As transcrições podem mostrar interrupções ocasionais ou pedidos para falar com um atendente humano. Em alguns casos, os usuários podem abandonar a ligação.
Cada um desses limites se traduz em resultados reais para o negócio.
Na faixa mais baixa do espectro de latência, você terá um agente de atendimento ao cliente capaz de lidar naturalmente com perguntas recebidas e ajudar os usuários a resolver suas dúvidas sem ajuda adicional. Isso reduz a carga dos seus agentes humanos e mantém a satisfação do cliente alta. Na faixa mais alta do espectro, você frustrará os clientes com um agente que parece hesitar por tempo demais.
Em outro artigo, definimos os benchmarks de orçamento de latência para agentes de voz para demonstrar como é uma boa latência nos valores P50 e P95.
O que causa latência em IA conversacional?
Latência em IA conversacional é um termo que resume vários processos diferentes, e cada segmento contribui para o todo. Portanto, o gargalo para alcançar baixa latência é mais um problema de nível de sistema do que algo resolvido simplesmente escolhendo um modelo melhor. Afinal, vários modelos interagem no pipeline.
Para desenvolvedores, escrevemos um guia técnico detalhado sobre otimização da latência de agentes de voz que você pode usar para melhorar cada etapa do tempo de ponta a ponta até o primeiro áudio (TTFA).
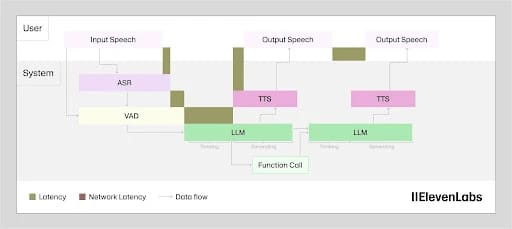
Além do pipeline principal, outros fatores, como telefonia e chamadas de função, também adicionam latência, embora não façam parte da infraestrutura interna do modelo.
Veja uma visão geral de todos os fatores que contribuem para a latência da IA conversacional.
Reconhecimento automático de fala
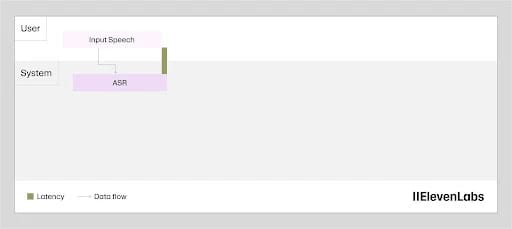
A latência do reconhecimento de fala não é o tempo necessário para gerar uma transcrição. O processo de transcrição é executado em segundo plano enquanto o usuário fala, então, quando a fala termina, o texto já está em grande parte pronto.
A latência aqui é, na verdade, o intervalo entre o fim da fala e o momento em que a transcrição é finalizada e passada para a próxima etapa. O Scribe v2 Realtime reduz esse intervalo para aproximadamente 150 ms, transmitindo continuamente para que a saída esteja pronta no instante em que o turno termina.
Alternância de turnos e detecção de fim de fala
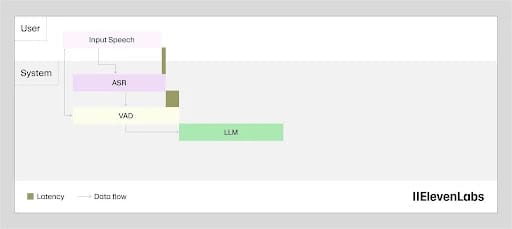
Um Detector de Atividade de Voz (VAD) fica entre o reconhecimento de fala e o modelo de linguagem. Seu trabalho é decidir quando o usuário realmente terminou de falar.
Para evitar erros, o VAD espera um limite de silêncio contínuo antes de declarar o fim do turno, e essa espera adiciona latência antes que o modelo de linguagem processe uma palavra. Essa pequena latência extra aumenta o tempo, mas também evita que o sistema comece a responder enquanto o usuário ainda está falando.
Tecnicamente, se todos os outros componentes da IA conversacional tivessem latência zero, a latência atribuída à alternância de turnos seria algo positivo. As pessoas fazem uma breve pausa antes de responder à fala. Uma máquina que faz uma pausa semelhante torna a interação mais realista. No entanto, como outros componentes da IA conversacional já geram latência, o ideal é mantê-la mínima.
Processamento do modelo de linguagem
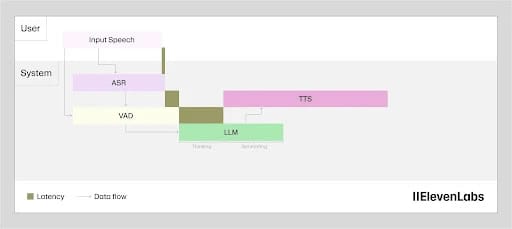
Quando a transcrição do mecanismo de Speech to Text (STT) está pronta, o modelo de linguagem gera uma resposta. A latência aqui é o tempo necessário para começar a gerar tokens, não para gerar a resposta completa. Esses tokens são transmitidos diretamente para a etapa de TTS à medida que chegam, então o TTFT é o que mais importa.
Além da escolha do modelo, tanto o tamanho do prompt quanto o da base de conhecimento afetam essa etapa. Quanto mais contexto o LLM precisa considerar, mais tempo ele leva. Ao projetar esses sistemas em escala, é importante encontrar o equilíbrio entre uma base de conhecimento útil e um prompt enxuto para manter a velocidade.
Síntese de fala
A latência do TTS é o tempo entre receber os primeiros tokens do modelo de linguagem e o início do áudio. Como os tokens chegam mais rápido do que a fala humana é reproduzida, o modelo de síntese nunca espera pela resposta completa. A latência do TTS é estritamente o tempo até o primeiro trecho de áudio.
Essa etapa costumava ser a maior contribuição individual para a latência da IA conversacional, pois modelos mais antigos levavam de 2 a 3 segundos para começar a gerar fala. O Flash v2.5 da ElevenLabs resolve isso diretamente, oferecendo síntese de fala com latência de ~75 ms e reduzindo esse gargalo de segundos para uma fração de segundo.
Latência de rede
Enviar dados de um local para outro sempre adiciona latência, e a distância geográfica só aumenta a latência de ida e volta na rede.
Como vários componentes trabalham juntos para fornecer uma resposta de ponta a ponta, uma latência significativa pode se acumular em diversos saltos de rede.
Chamada de função
As chamadas de função adicionam viagens de ida e volta da API na etapa do LLM. Uma consulta interna rápida adiciona dezenas de milissegundos, enquanto um processador de pagamentos ou sistema de estoque pode adicionar segundos. A quantidade de latência depende inteiramente do serviço chamado, o que torna essa a etapa mais difícil de otimizar diretamente.
O padrão mais eficaz é instruir o LLM a responder antes que a chamada da ferramenta seja concluída. Uma frase como “Vou verificar isso para você” mantém o usuário engajado enquanto a chamada externa é resolvida, em vez de deixar um silêncio. A resposta por voz começa enquanto a ferramenta é executada em paralelo.
Como reduzir a latência da IA conversacional
Reduzir a latência da IA conversacional exige abordar cada etapa do pipeline conforme seu impacto. Embora melhorias individuais afetem a latência, você precisará trabalhar no pipeline inteiro de forma holística para obter a maior mudança.
Veja alguns princípios que podem orientar a redução da latência da IA conversacional em alto nível:
- Seleção do modelo de TTS: Modelos de TTS otimizados para velocidade, como o Flash v2.5, usam arquiteturas diferentes dos modelos otimizados para qualidade, como o Eleven v3 e o Eleven v4. Para agentes de voz em tempo real, a escolha certa é o modelo de maior qualidade que atende à sua meta de latência, o que quase sempre significa um modelo otimizado para velocidade.
- Seleção do modelo de LLM: LLMs menores e mais rápidos geralmente produzem um tempo até o primeiro token menor do que os maiores. Escolher o LLM mais rápido que ainda atende ao seu padrão de qualidade para a tarefa é tão importante quanto a escolha do modelo de TTS.
- Streaming: O streaming de TTS retorna o áudio em trechos à medida que a síntese avança, para que o usuário ouça a primeira palavra enquanto o modelo ainda gera o restante. Esse conceito também se aplica à saída do LLM: iniciar a síntese de TTS na primeira frase enquanto o modelo de linguagem gera as próximas pode recuperar latência no pipeline.
- Prompt de sistema design: Os usuários podem simplificar prompts de sistema movendo instruções para procedimentos ou workflows, em vez de mantê-las em cada etapa de decisão. Isso reduz a quantidade de contexto sobre a qual o modelo precisa raciocinar a cada turno.
- Proteções: Executar proteções no modelo de streaming permite que a saída comece a ser reproduzida antes da conclusão da verificação, em vez de bloquear a reprodução até que ela termine.
- Alocação conjunta de modelos: Usar modelos alocados conjuntamente sempre que possível, como na stack do ElevenLabs Agents, mantém os componentes próximos e evita que a latência seja adicionada por saltos entre modelos hospedados separadamente.
- Geografia: A proximidade entre seus servidores e seus usuários pode reduzir significativamente a latência, pois diminui diretamente a contribuição da rede para o TTFA de ponta a ponta.
Além desses fatores, você pode usar este guia técnico sobre otimização de latência para mais detalhes.
Comece a usar IA conversacional de baixa latência com o ElevenAgents
A latência da IA conversacional é um fator muito importante ao criar e implementar agentes. Com o ElevenAgents, a otimização de latência já faz parte do processo. De técnicas de sobreposição para recuperar tempo a baixa latência de inferência em componentes individuais, o ElevenAgents cria stacks de IA conversacional de baixa latência para sua empresa.
No fim das contas, o objetivo é criar realismo. O usuário precisa sentir a facilidade de falar com uma pessoa enquanto aproveita os benefícios de um programa de computador. Ao otimizar os subprocessos, isso agora é possível.
Saiba mais sobre o ElevenAgents ou fale com vendas para começar hoje.
Perguntas frequentes sobre latência em IA conversacional

Jack Limebear faz parte do time de Growth, atuando como redator e estrategista de conteúdo no blog e nas páginas de insights. Antes da ElevenLabs, ele passou mais de dez anos liderando estratégias de conteúdo em organizações que vão de startups SaaS em rápido crescimento a empresas da Fortune 500. Ele é mestre em Literatura Inglesa pela Universidade de Cambridge.




