Como medir a IA conversacional: métricas essenciais para o sucesso
- Escrito por
- Jack Limebear
- Publicado
- Última atualização
OuvirOuça este artigo
As ferramentas de IA conversacional reduzem drasticamente o custo de oferecer suporte ao cliente 24 horas por dia. Elas fazem isso sem precisar manter uma equipe no turno da madrugada nem assumir os riscos de privacidade de dados ao terceirizar funções para outros países.
Mas a economia de custos só importa se um agente de IA consegue resolver os problemas dos clientes. Medir a IA conversacional com os indicadores-chave de desempenho certos mostra se ela está funcionando, especialmente para empresas que gerenciam um alto volume de solicitações de clientes.
Este artigo mostra como avaliar o fluxo conversacional e a precisão das respostas protege tanto a experiência do cliente quanto sua marca. Explicamos como as equipes de experiência do cliente realizam experimentos eficazes de teste A/B com saudações para quem liga. Você também verá como manter uma plataforma de IA conversacional confiável e multilíngue.
Resumo
- Medir sistematicamente a IA conversacional em métricas de qualidade, experiência e operação fornece os dados necessários para proteger a experiência do cliente.
- Ferramentas de avaliação automatizada acompanham e melhoram continuamente as métricas de IA conversacional em escala, enquanto profissionais fazem verificações pontuais regulares.
- Isolar uma variável específica por vez nos testes A/B facilita identificar exatamente o que deu errado, para que você implemente correções que tratem diretamente os problemas identificados.
- A melhoria contínua é necessária porque as empresas de IA atualizam com frequência os modelos subjacentes, o que muitas vezes faz chatbots antes confiáveis se comportarem de forma diferente em produção.
O que significa medir a IA conversacional e por que isso importa
Medir IA conversacional envolve avaliar sistematicamente quão bem seus agentes de IA testados ou implantados atendem às solicitações dos clientes e resolvem problemas. O objetivo é determinar com que eficácia seus sistemas automatizados conduzem conversas com várias interações no mundo real, com base nos padrões de desempenho que você definiu. Esses padrões geralmente refletem o quanto os modelos entendem a intenção do usuário, mantêm o tom da marca, fornecem respostas precisas e resolvem o problema com sucesso.
As avaliações de modelos podem parecer muito trabalho extra para um sistema criado para reduzir as tarefas da sua equipe. Mas, sem uma avaliação consistente, seria difícil saber o desempenho do modelo em casos de uso reais. Em outras palavras, você sabe que seu sistema de IA reduz os custos operacionais do suporte ao cliente, mas consegue confirmar se ele deixa os clientes satisfeitos ou os leva a buscar outras soluções?
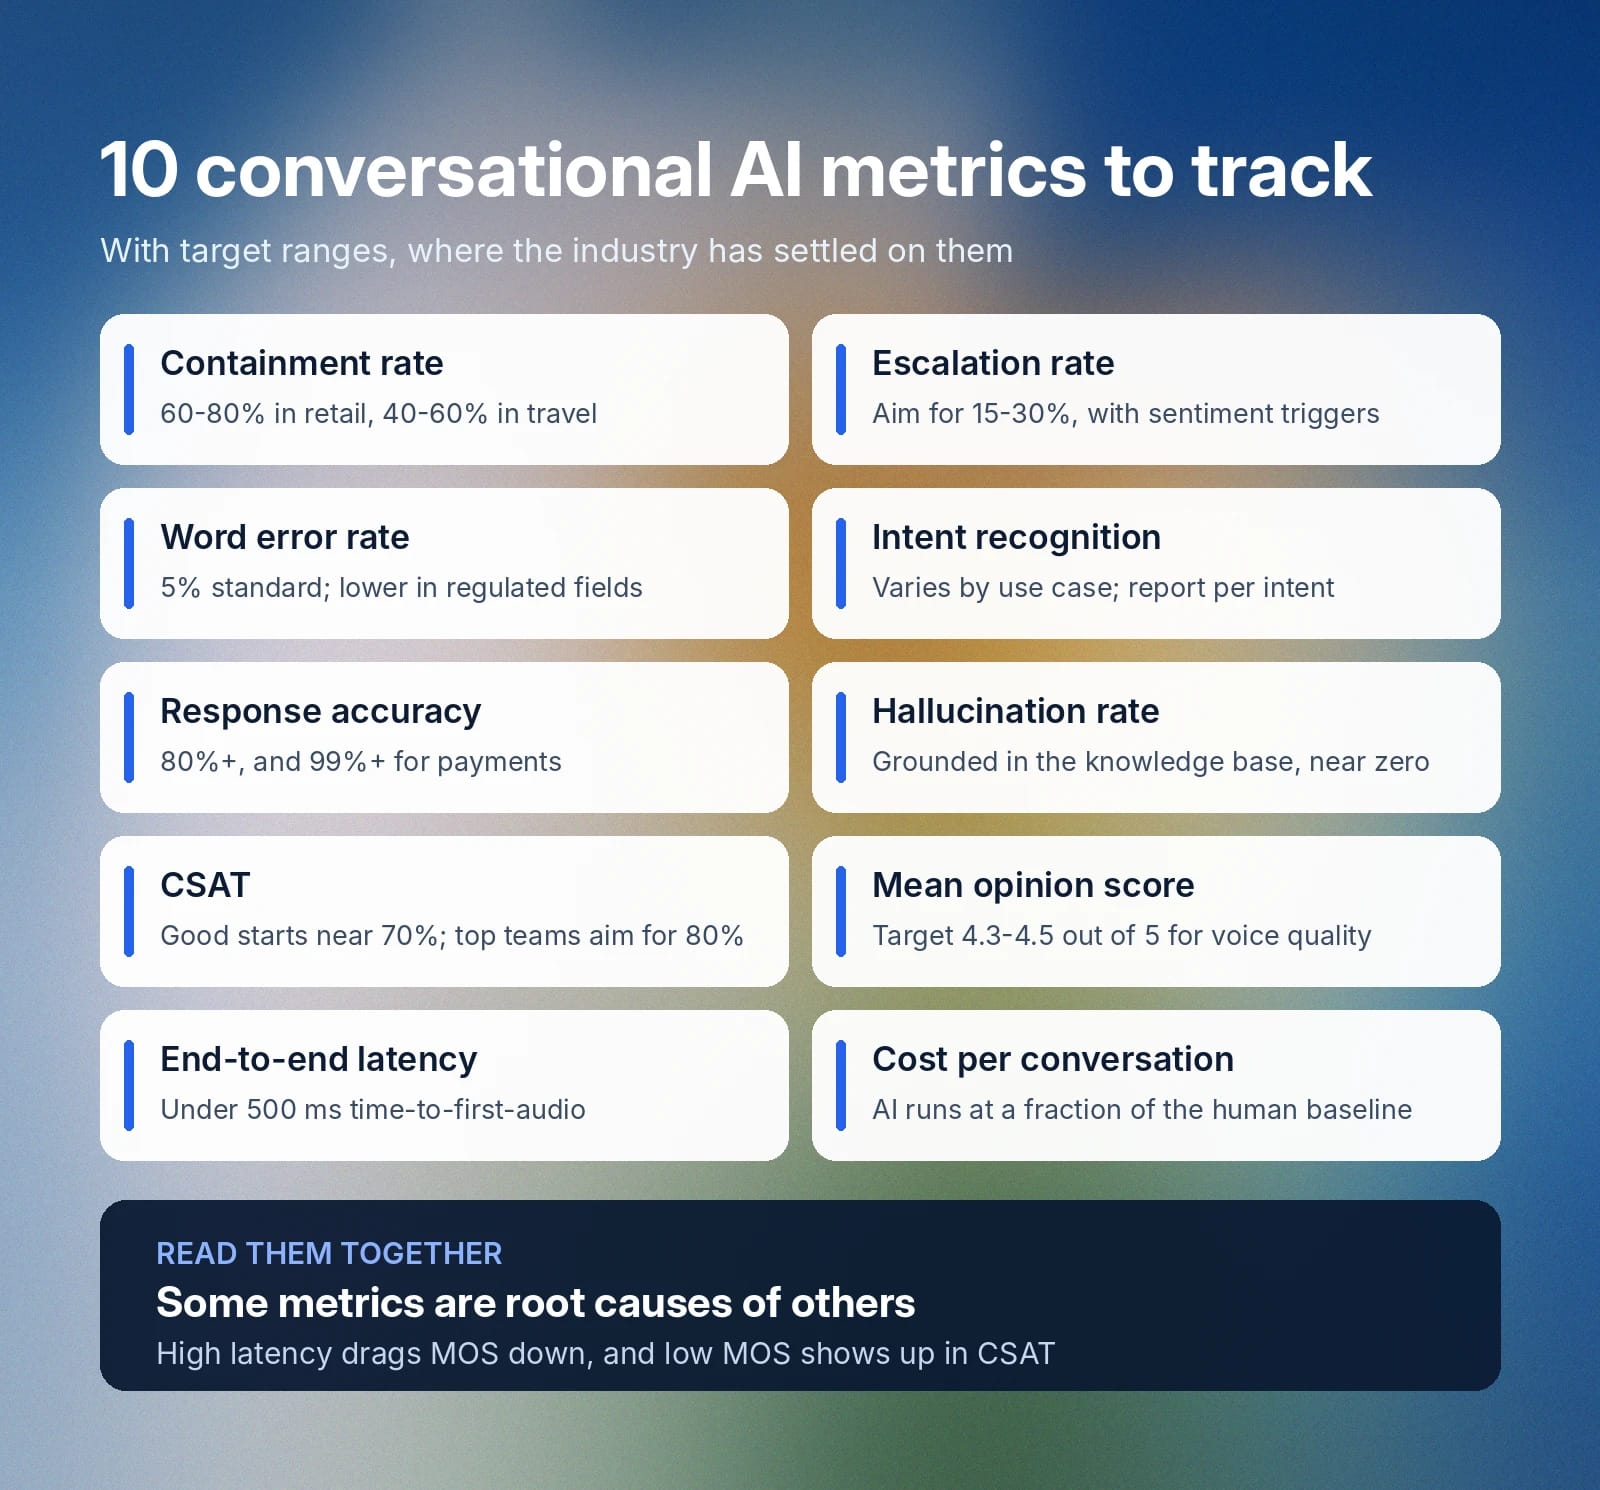
Uma medição abrangente exige analisar o modelo em três categorias principais:
- Qualidade: Avalie a precisão, a coerência e a relevância das respostas de uma IA com base na solicitação inicial do usuário. A principal pergunta é: a IA está acertando e dando as respostas corretas aos usuários ou está alucinando e cometendo erros?
- Experiência: Avalie a experiência do cliente, como a rapidez da resposta da IA e quantas interações ela precisou para dar uma resposta satisfatória. A principal pergunta é: a experiência parece natural e útil para o usuário ou robótica e frustrante?
- Operação: Determine se o sistema apresenta desempenho confiável e continua sendo uma solução econômica para suas necessidades de suporte ao cliente. As preocupações mais comuns incluem: o sistema tem alta disponibilidade e gera o retorno sobre o investimento necessário para justificar seu uso?
O sucesso é diferente para cada equipe, e os principais problemas enfrentados antes de automatizar o suporte têm um papel importante nessa definição. Por exemplo, se sua equipe tinha dificuldade para manter o suporte ao cliente 24 horas por dia, suporte ao cliente, a disponibilidade ininterrupta dos agentes de IA melhora facilmente o desempenho do suporte ao cliente. No entanto, cada uma dessas categorias é importante para o sucesso geral. Portanto, um sistema que está sempre online e raramente falha não fará muito pelos clientes se parecer robótico e alucinar respostas.
Principais métricas de IA conversacional para acompanhar
Acompanhe números claros e acionáveis para avaliar o desempenho dos agentes com os clientes e se sua implementação atual gera valor real para a empresa. A avaliação contínua também abre caminho para melhorias regulares. Quando você identifica exatamente os gargalos no seu workflow ou os pontos que precisam de ajustes, tem os dados necessários para tratar a causa raiz com eficácia.
Use estas métricas de IA conversacional como ponto de partida ao avaliar chamadas de voz e o desempenho de chatbots:
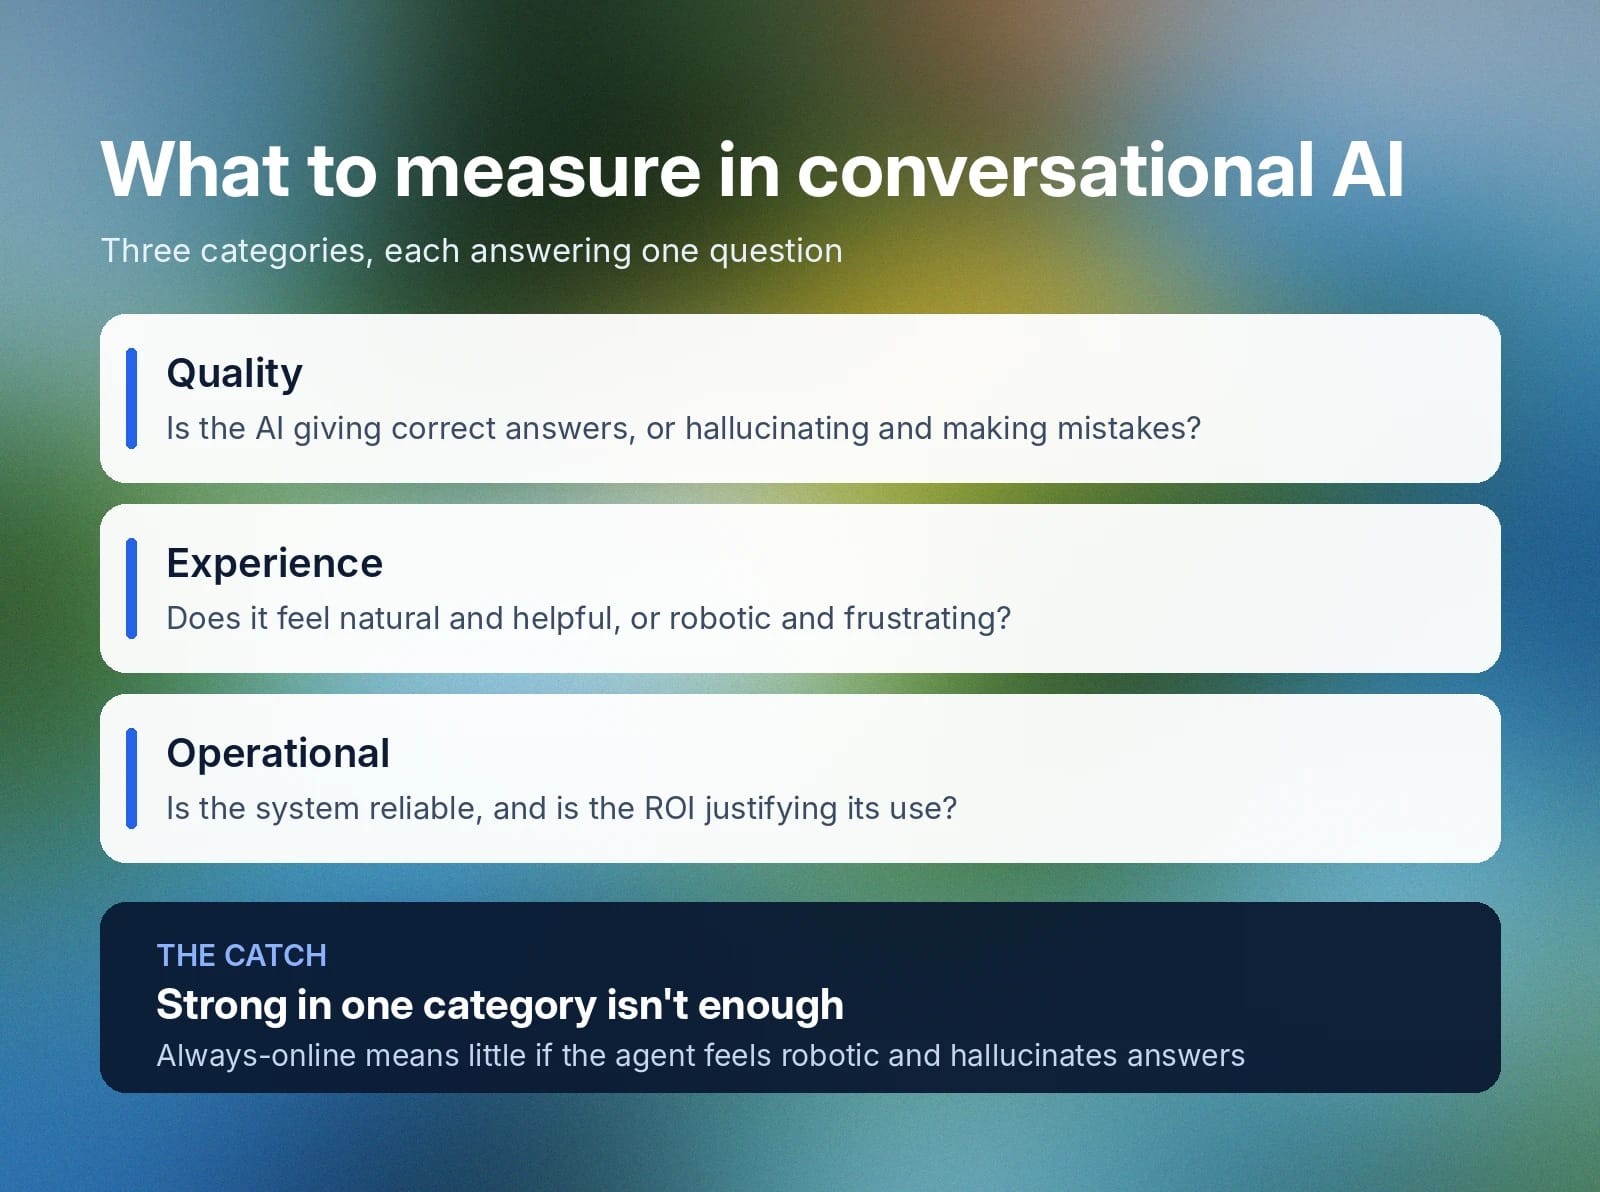
- Taxa de contenção: Acompanhe a porcentagem de solicitações totalmente resolvidas no canal automatizado. As metas variam conforme o setor, o contexto, os casos de uso e o tipo de bot. Por exemplo, 60–80% é bastante comum no varejo, enquanto os números ficam entre 40–60% em sites de viagem.
- Taxa de escalonamento: Meça com que frequência os agentes de IA atendem chamadas sem escaloná-las para uma pessoa. Empresas proativas definem limites automáticos para transferir chamadas a pessoas assim que o sentimento se torna negativo. Boas taxas de escalonamento variam conforme o setor e a complexidade da tarefa, mas busque 15–30%.
- Taxa de erro de palavras (WER): Acompanhe quão bem a IA “ouve” as palavras corretamente durante uma chamada ou transcrição. Um bom padrão do setor é 5%, mas você precisa de uma WER menor para casos de uso em áreas reguladas ou que lidam com informações sensíveis, como saúde, finanças e direito.
- Precisão no reconhecimento de intenção: Além das palavras, o bom desempenho de um agente de IA começa por entender com precisão o problema do usuário e o que ele precisa. As metas de precisão variam conforme o caso de uso e entre as categorias de intenção.
- Precisão das respostas: Determine com que confiabilidade o modelo fornece respostas verdadeiras e significativas. Isso é essencial para garantir que os clientes resolvam seus problemas. Dúvidas gerais de atendimento ao cliente exigem 80% ou mais, mas casos de uso sensíveis, como pagamentos, exigem 99% ou mais.
- Taxa de alucinação: Embora esteja estreitamente relacionada à precisão das respostas, a alucinação determina especificamente a precisão factual das respostas com base na base de conhecimento. Baixas taxas de alucinação são essenciais para oferecer ajuda e garantir que os modelos não façam promessas que a empresa não possa cumprir.
- Satisfação do cliente (CSAT): Colete o sentimento dos clientes com pesquisas após a chamada para determinar a satisfação. As empresas coletam esses dados usando uma escala de cinco pontos, mas costumam expressar os resultados em porcentagens. Segundo a SurveyMonkey, boas pontuações de CSAT geralmente começam em cerca de 70%, com algumas empresas buscando 80% ou mais.
- Pontuação média de opinião (MOS): Essa métrica centrada em pessoas também usa uma escala de cinco pontos, mas o objetivo é medir o quão natural soa a resposta da IA e a clareza da voz sintética. Busque uma MOS em torno de 4,3 a 4,5.
- Latência de voz de ponta a ponta: Calcule o atraso total entre o momento em que o usuário conclui sua solicitação e o início da resposta do agente. Agentes prontos para produção buscam um tempo de ponta a ponta até o primeiro áudio (TTFA) inferior a 500 milissegundos. O modelo ElevenLabs Flash v2.5 atualmente alcança uma latência interna de inferência do modelo de cerca de 75 ms. A latência real de ponta a ponta varia conforme fatores como sua localização e o tipo de endpoint usado.
- Custo por conversa: Meça o custo operacional total de cada interação automatizada com o cliente em comparação com atendimentos humanos. As conversas da ElevenLabs começam em 10 centavos por minuto, enquanto a remuneração média por hora de representantes de atendimento ao cliente indica que conversas humanas custam cerca de 32 centavos por minuto. Isso resulta em uma economia de aproximadamente 70%, embora os preços possam variar conforme o plano e o uso. Consulte a página de preços da ElevenLabs para ver os preços atuais.
Ao escolher as métricas que usará para medir o desempenho do seu modelo, considere as áreas mais importantes para seu setor e modelo de negócio. Por exemplo, precisão e factualidade são especialmente importantes em áreas como bancos e informações de pacientes, enquanto latência, MOS e taxas de escalonamento são mais relevantes para empresas que priorizam a experiência do cliente.
Observe que algumas métricas fornecem as causas raiz de outras. Por exemplo, uma alta latência provavelmente leva a uma pontuação MOS baixa e, como consequência, a uma baixa satisfação do cliente expressa em CSAT.
Como medir a precisão da IA conversacional
Meça a precisão do modelo criando um conjunto de teste de referência com cerca de 500 a 1.000 conversas históricas reais. Logs reais registram a linguagem natural e imperfeita que os dados sintéticos muitas vezes não incluem, como erros de digitação, gírias e erros dos usuários. Em seguida, avalie seu sistema com esses logs reais quanto ao reconhecimento de intenção, à precisão das respostas e à taxa de alucinação.
Execute avaliações automatizadas dessas interações usando um método de pontuação de LLM como avaliador. No entanto, sempre valide as pontuações automatizadas em relação a sistemas rotulados por humanos para garantir que estejam alinhadas. Em seguida, revisores humanos fazem verificações pontuais semanais para avaliar o desempenho do chatbot por meio de uma rubrica simples de três pontos:
- Correta: A resposta é factual, relevante no contexto e atende diretamente à intenção principal do usuário.
- Aceitável: A resposta é tecnicamente correta e útil, mas apresenta alguns pequenos problemas de estilo, frases pouco naturais ou formatação fora do padrão da marca.
- Incorreta: A resposta precisa de correção imediata porque contém erros factuais, alucinações graves ou interpreta completamente errado a intenção do usuário.
O ideal é usar um método por intenção para avaliar o modelo, pois agentes de IA têm bom desempenho em alguns contextos e falham completamente em outros. Usar números agregados faz com que áreas de alto desempenho escondam pontos fracos críticos.
Simplificamos esse workflow ao incluir os testes de Next Reply (Cenário) diretamente nos testes do ElevenAgents. O recurso Next Reply avalia a mensagem de acompanhamento enviada por um agente em vez da conversa completa com várias interações. No entanto, você fornece o histórico do chat que antecede o ponto de avaliação e pontua a resposta em relação aos padrões de política, tom e qualidade.
Como fazer testes A/B de respostas de IA conversacional
Os testes A/B coletam feedback do mundo real para evitar suposições sobre as preferências dos clientes. Em seguida, você usa esses dados empíricos para ajustar o desempenho do modelo de IA. Depois de acompanhar as métricas, sua equipe provavelmente terá uma lista de itens que deseja mudar ou experimentos para executar. No entanto, mudar várias coisas ao mesmo tempo dificulta entender o que funcionou e o que não funcionou.
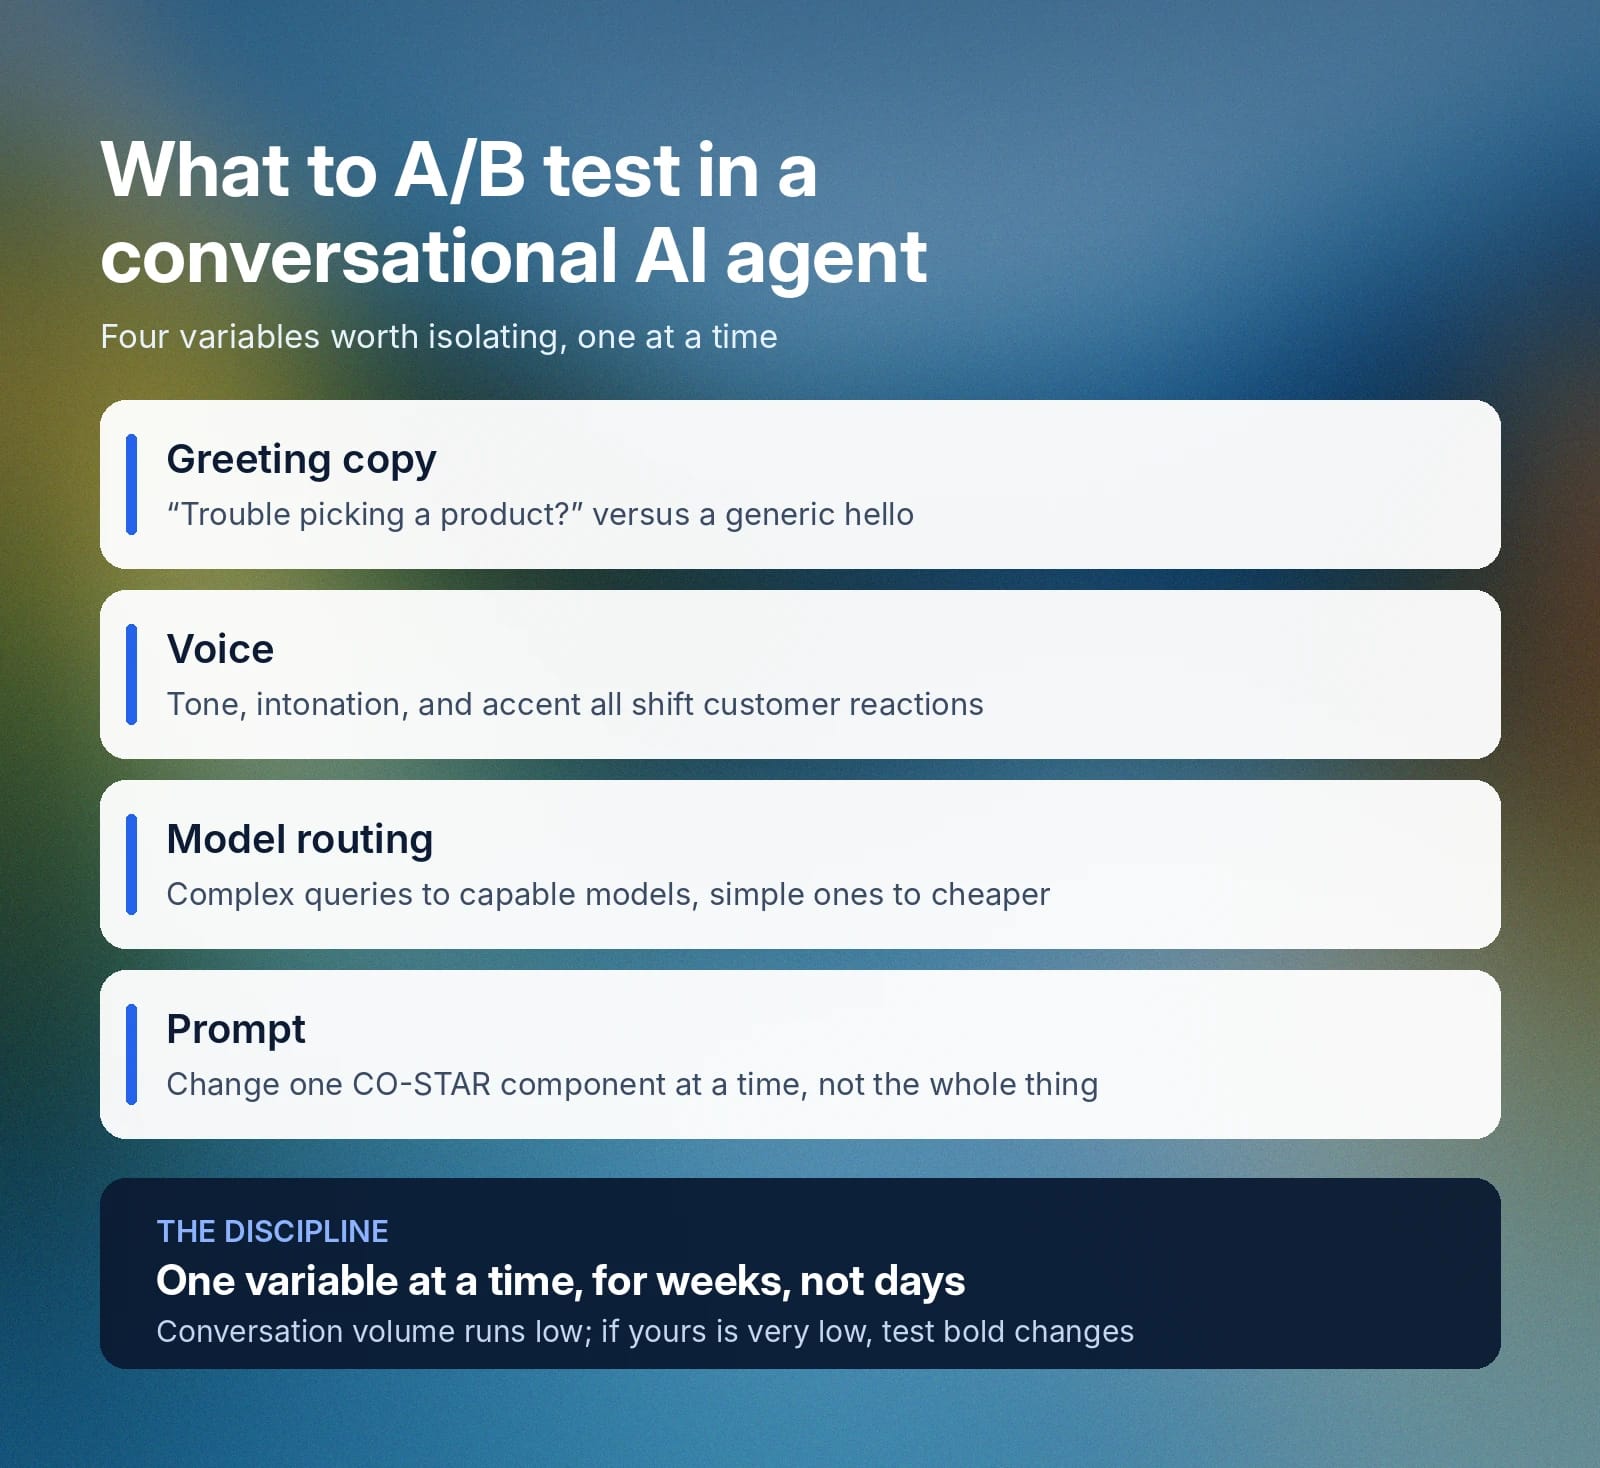
Portanto, executar um teste válido exige isolar uma variável específica por vez, mantendo constante o restante da base de conhecimento subjacente. Os possíveis elementos a variar incluem:
- Texto da saudação: Ajustar a mensagem de saudação inicial para algo específico, como “Olá! Está com dificuldade para escolher um produto?” em vez de apenas dizer “Olá, como posso ajudar?”
- Voz: Os clientes podem reagir de forma mais favorável a algumas vozes em determinadas circunstâncias, com base em masculinidade ou feminilidade, tom, entonação e até sotaque.
- Roteamento de modelos: Modelos altamente capazes costumam custar mais. Portanto, a opção eficiente e econômica é encaminhar adequadamente solicitações complexas e simples.
- Prompt: Os prompts têm vários componentes, então altere apenas um aspecto por vez, como o contexto, objetivo, estilo, tom, público ou modelo de resposta (CO-STAR).
As equipes também devem ajustar o cronograma dos testes. O tráfego conversacional costuma ser muito menor que as visualizações de páginas da web, então você precisará executar o teste por semanas, e não dias, para alcançar significância estatística. Se tiver um volume extremamente baixo, teste mudanças grandes e ousadas em vez de pequenos ajustes.
Um workflow prático também exige ferramentas de versionamento de agentes, comparação e reversão. Nós as incluímos diretamente no ElevenAgents.
Como testar um agente de IA conversacional antes da implantação
O atendimento ao cliente é um ponto de contato direto com as pessoas que impactam seus resultados financeiros, e a IA às vezes reage de maneira imprevisível a pequenas mudanças. Portanto, sempre teste um agente de IA conversacional novo ou revisado antes de lançá-lo em produção. Apenas fazer “testes de feeling” não é suficiente.
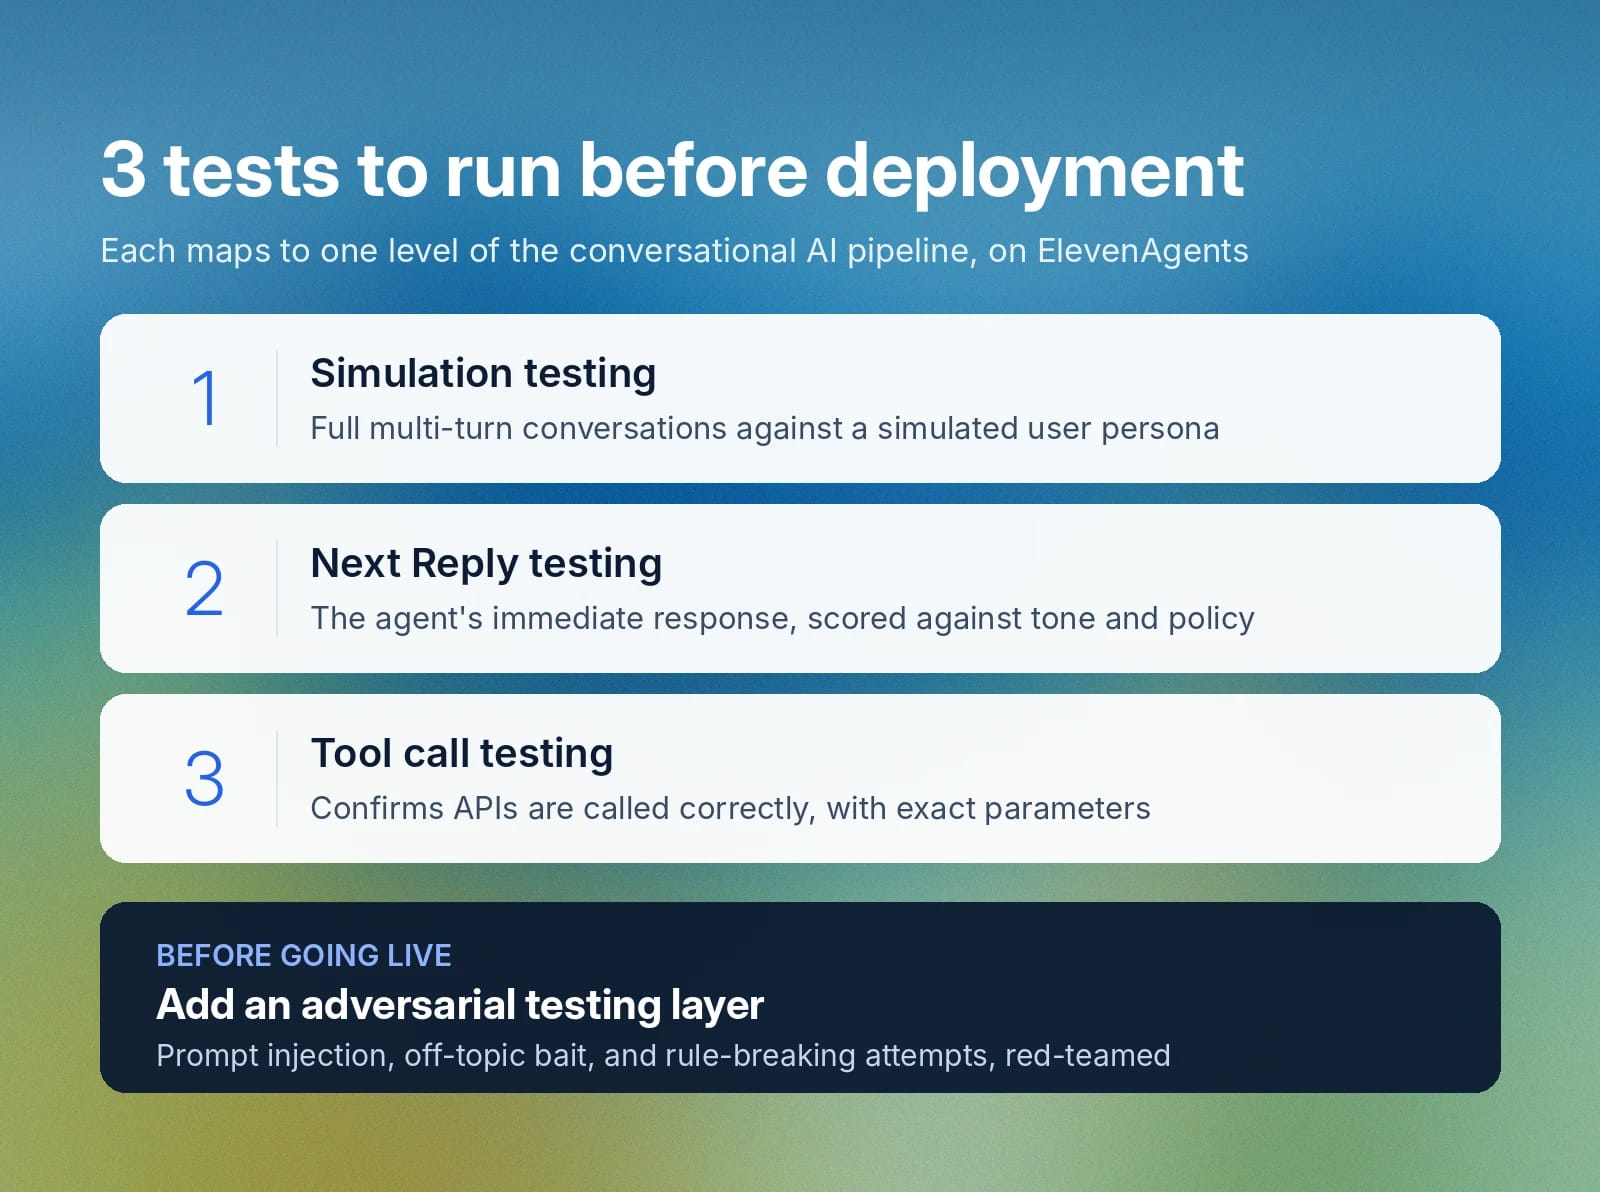
Criamos nosso framework de testes do ElevenAgents em torno de três tipos principais de teste, voltados a níveis específicos do seu pipeline de IA conversacional:
- Teste de simulação: Executa uma conversa com várias interações com um usuário simulado para confirmar se o diálogo atende aos níveis de desempenho esperados.
- Teste de Next Reply: Testa apenas as respostas imediatas do agente em relação a restrições específicas de tom, política ou outras, para confirmar a adequação e a precisão das respostas.
- Teste de chamadas de ferramentas: Garante que os agentes chamem corretamente as APIs conectadas e transmitam os parâmetros exatos necessários para consultas ou transferências críticas de banco de dados.
Com tantos invasores tentando fazer jailbreak de modelos para fins maliciosos, você também precisará de uma camada de testes adversariais antes de entrar em operação. Trabalhe com equipes de QA, engenheiros de prompt e profissionais de cibersegurança de red team para testar injeção de prompt, iscas fora de tópico e tentativas de violar regras.
Por fim, faça uma implantação gradual, lançando versões piloto para um pequeno grupo de usuários e monitorando seu comportamento no mundo real. Defina critérios rigorosos para a aprovação do modelo antes de liberá-lo para um grupo maior ou para toda a sua base de clientes. Lembre-se de atribuir a uma única pessoa responsável a supervisão do lançamento e criar um caminho de reversão caso um ajuste cause queda nas métricas de desempenho.
Como avaliar o desempenho de chatbots em produção
Antes de lançar seu modelo de IA conversacional, defina como é o sucesso para cada caso de uso. Isso é especialmente importante para aplicações em áreas altamente reguladas, em que precisão e privacidade de dados têm padrões mais elevados e requisitos mais rigorosos.
As respostas automatizadas facilitam testar modelos A/B em escala, mas testes objetivos exigem combinar isso à leitura pontual de transcrições e ao feedback de testadores humanos. Pessoas no processo identificam nuances de conversa que os modelos de IA deixam passar e peculiaridades nos dados que, de outra forma, se perderiam em números agregados. Uma estratégia de avaliação abrangente também envolve análise de sentimento e feedback direto dos usuários.
A melhoria contínua diferencia ainda mais os sistemas maduros que oferecem alto retorno sobre o investimento. Enquanto concorrentes tratam testes e monitoramento como tarefas separadas, um pipeline maduro combina os dois. Nesse caso, as falhas em produção alimentam diretamente seu conjunto de testes para treinar o próximo agente otimizado.
Ajustes regulares também se tornam necessários quando empresas de IA atualizam os modelos-base nos quais seu agente é executado. Essa mudança costuma fazer com que um prompt antes eficaz passe, de repente, a contribuir para respostas pouco confiáveis ou até inadequadas.
Incluímos esse ciclo de feedback diretamente em nossa plataforma. Use nossas ferramentas de análise de conversas para automatizar a coleta estruturada de dados e avaliar sentimentos com facilidade. Grandes organizações também usam nossa infraestrutura corporativa de IA conversacional para monitorar e escalar seus agentes globalmente com confiança.
Comece a usar o ElevenAgents para métricas de atendimento ao cliente
Lançar IA conversacional em escala com sucesso exige mais do que vozes de alta qualidade e modelos de baixa latência. Você precisa de um ecossistema integrado para projetar, criar, testar, implantar e ajustar workflows multiagente.
O ElevenAgents oferece a infraestrutura escalável de que você precisa. Sua equipe tem acesso a ferramentas como verificação de Next Reply, acompanhamento de sentimento e coleta automática de dados para monitorar e otimizar continuamente os modelos e obter os melhores resultados. Melhor ainda: você identifica regressões antes que elas cheguem aos seus clientes.
Tudo pronto para simplificar o processo de medir a IA conversacional? Explore nossos recursos de teste de agentes e veja como nossas equipes corporativas implantam agentes confiáveis que melhoram suas métricas de atendimento ao cliente.
Saiba mais sobre o ElevenAgents ou crie sua conta para começar hoje.
Perguntas frequentes sobre como medir a IA conversacional

Jack Limebear faz parte do time de Growth, atuando como redator e estrategista de conteúdo no blog e nas páginas de insights. Antes da ElevenLabs, ele passou mais de dez anos liderando estratégias de conteúdo em organizações que vão de startups SaaS em rápido crescimento a empresas da Fortune 500. Ele é mestre em Literatura Inglesa pela Universidade de Cambridge.